AIモデルのリスト 2026:ユースケース別 10の選択肢
モダリティ、機能、ユースケース別に分類された、この実用的なAIモデルのリストをご覧ください。価格、アクセス、最適なワークロードについて比較した10のカタログを掲載しています。
あなたのチームが1週間かけてモデルのページを読み込み、token価格を比較し、プロトタイプを構築したとしましょう。その後、誰かが代表的なドキュメントをアップロードしたところ、最も安価な候補が、そのドキュメント、指示、および期待される応答をcontext windowに収めることができないと判明しました。インテグレーションは機能します。しかし、モデルの選択は機能しません。
モデルカタログは、モデルの選択と同じではありません。一部のカタログは、ダウンロード可能なweightsを見つけるのに役立ちます。他のカタログは、測定されたパフォーマンスを比較したり、hosted inferenceを販売したり、モデルをcloud procurementに接続したり、ローカル実行用にモデルをパッケージ化したりします。それらを互換性があるものとして扱うと、時間を無駄にし、アプリケーションが機能するかどうかを決定する制約を隠してしまう可能性があります。
役立つAIモデルのリストは、特定の作業でどこから始めるべきかを教えてくれるはずです。
- モデルの発見とカスタマイズ: モデルカード、ファイル、ライセンス情報を含むディレクトリを使用します。
- 本番環境候補の比較: 独立した測定値を使用し、その後、独自のworkloadでテストします。
- hostedモデルの呼び出し: 明示的なモデル識別子とdeploymentの詳細を含むAPIカタログを使用します。
- オフラインでの実行: ローカルのruntimeカタログを使用し、ハードウェア要件を確認します。
テキストアプリケーションの場合、context lengthとtool supportは、候補を即座に排除する可能性があります。画像、動画、音声アプリケーションの場合、サポートされるinputs、output controls、およびasynchronous task handlingも同様に注意を払う必要があります。以下のオプションはそれぞれ異なる目的を果たすため、適切な開始点は、どのカタログが最も大きく見えるかよりも、次に何をすべきかにかかっています。
目次
- 1. UberLLM AIモデルカタログ
- 2. OpenRouter
- 3. Hugging Face Hub
- 4. Artificial Analysis
- 5. Replicate Explore
- 6. Microsoft Foundry Models
- 7. Amazon Bedrockモデルカタログ
- 8. Google Cloud Model Garden
- 9. Ollama Library
- 10. Google Gemini APIモデルリスト
- アクセス、価格の可視性、および制限によって10のモデルカタログがどのように異なるか
- ショートリストを動作する統合に変換する
1. UberLLM AI モデルカタログ
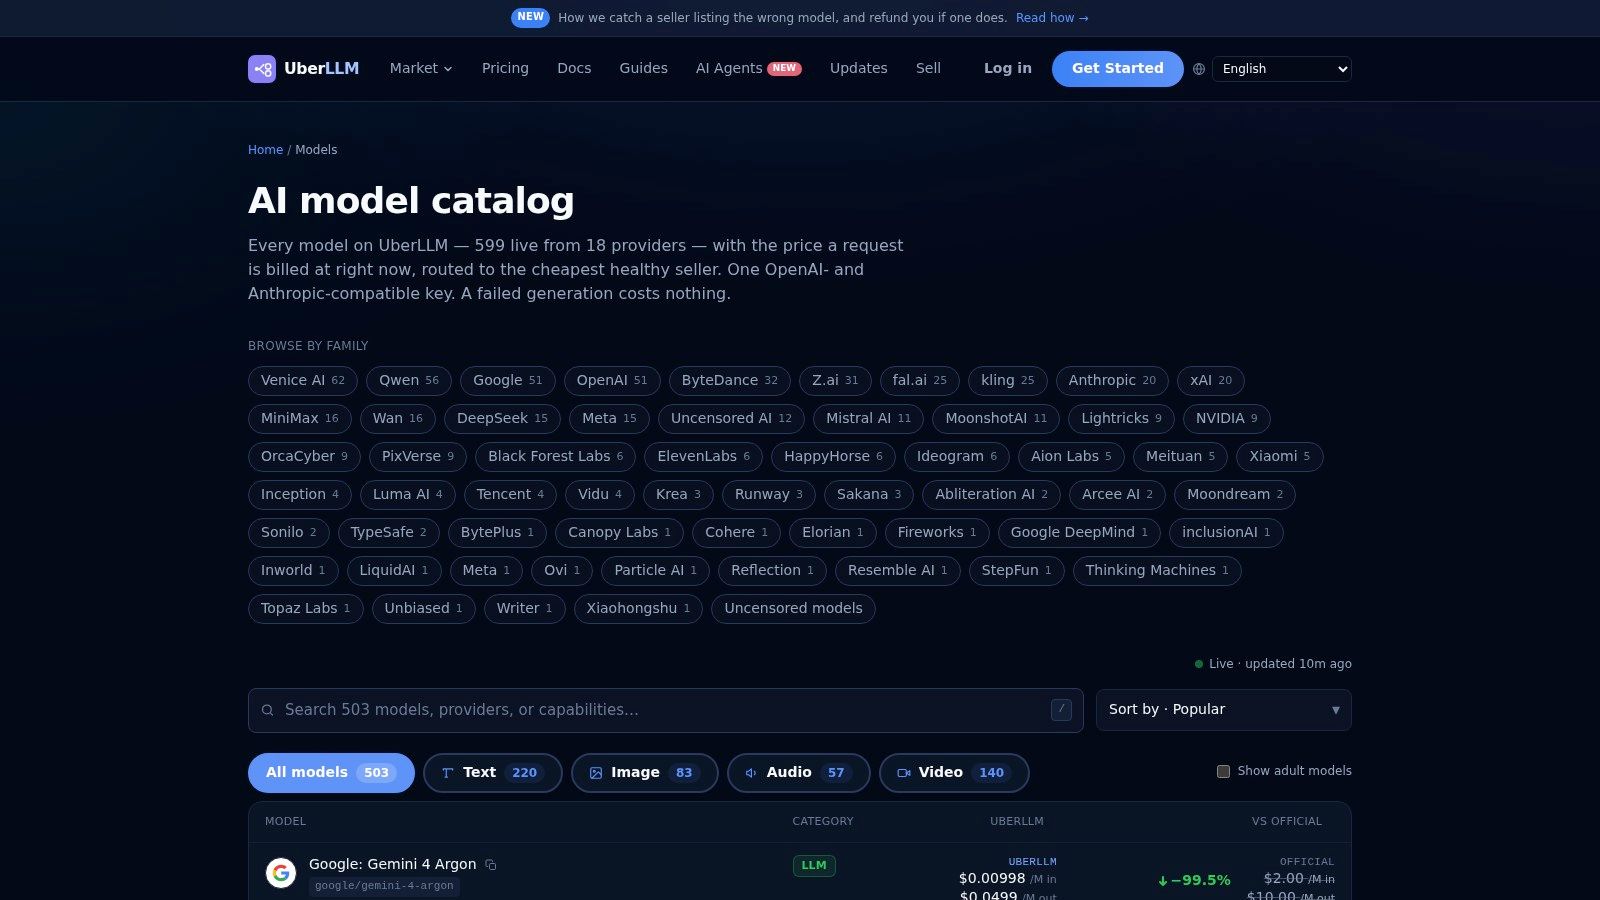
マーケットプレイスAPIを統合する前に、ホスト型オプションを比較するのに最適です。 UberLLM AI モデルカタログは、457種類のモデルを比較ページにまとめ、リアルタイムの価格、プロバイダー名、コンテキスト長、モデルタイプを表示します。単一のモデルファミリーだけでなく、テキストやメディアにわたる候補リストがある場合に役立ちます。
UberLLMでは、この発見プロセスをOpenAIおよびAnthropic互換のendpointに接続しています。開発者はモデルのidentifierを選択し、マーケットプレイスのルーティングが要求されたモデルの利用可能な販売者を選択します。この区別は重要です。モデルの機能とホストされたアクセスパスの両方を選択することになります。
選択する前に確認すべきこと
ドキュメント処理の場合、context lengthと最大output tokenを個別に比較してください。ソースマテリアルを受け入れるモデルでも、完全な結果を生成できないoutput limitがある場合があります。当社のモデルmetadataは両方のフィールドを公開しており、カタログはtoolsをサポートするモデルにマークを付けています。
- 強み: リアルタイムの価格とプロバイダー名により、プロバイダー間の候補リスト作成がよりスムーズになります。
- 便利なワークフロー: モダリティでフィルタリングし、制限を確認し、playgroundで代表的な出力を比較します。
- 制限: リストだけでは、あなたのextraction schema、coding task、またはvisual briefが成功するかどうかを判断できません。
表示されている最低価格を最終的な答えとして扱わないでください。テキストの場合、アプリケーションが生成するinputとoutputの組み合わせを推定し、メディアの場合、コストを比較する前に要求された生成configurationを確認してください。
実践的なルール: モデルのlimits、output quality、およびfailure behaviorがワークロードを満たしていることを確認してから選択してください。使用できない結果を生成する安価なリクエストは、有用な節約にはなりません。
価格と可用性は変更される可能性があるため、候補リストをモデル名のコレクションとして残すのではなく、テストで使用したidentifierとconfigurationを記録してください。
2. OpenRouter
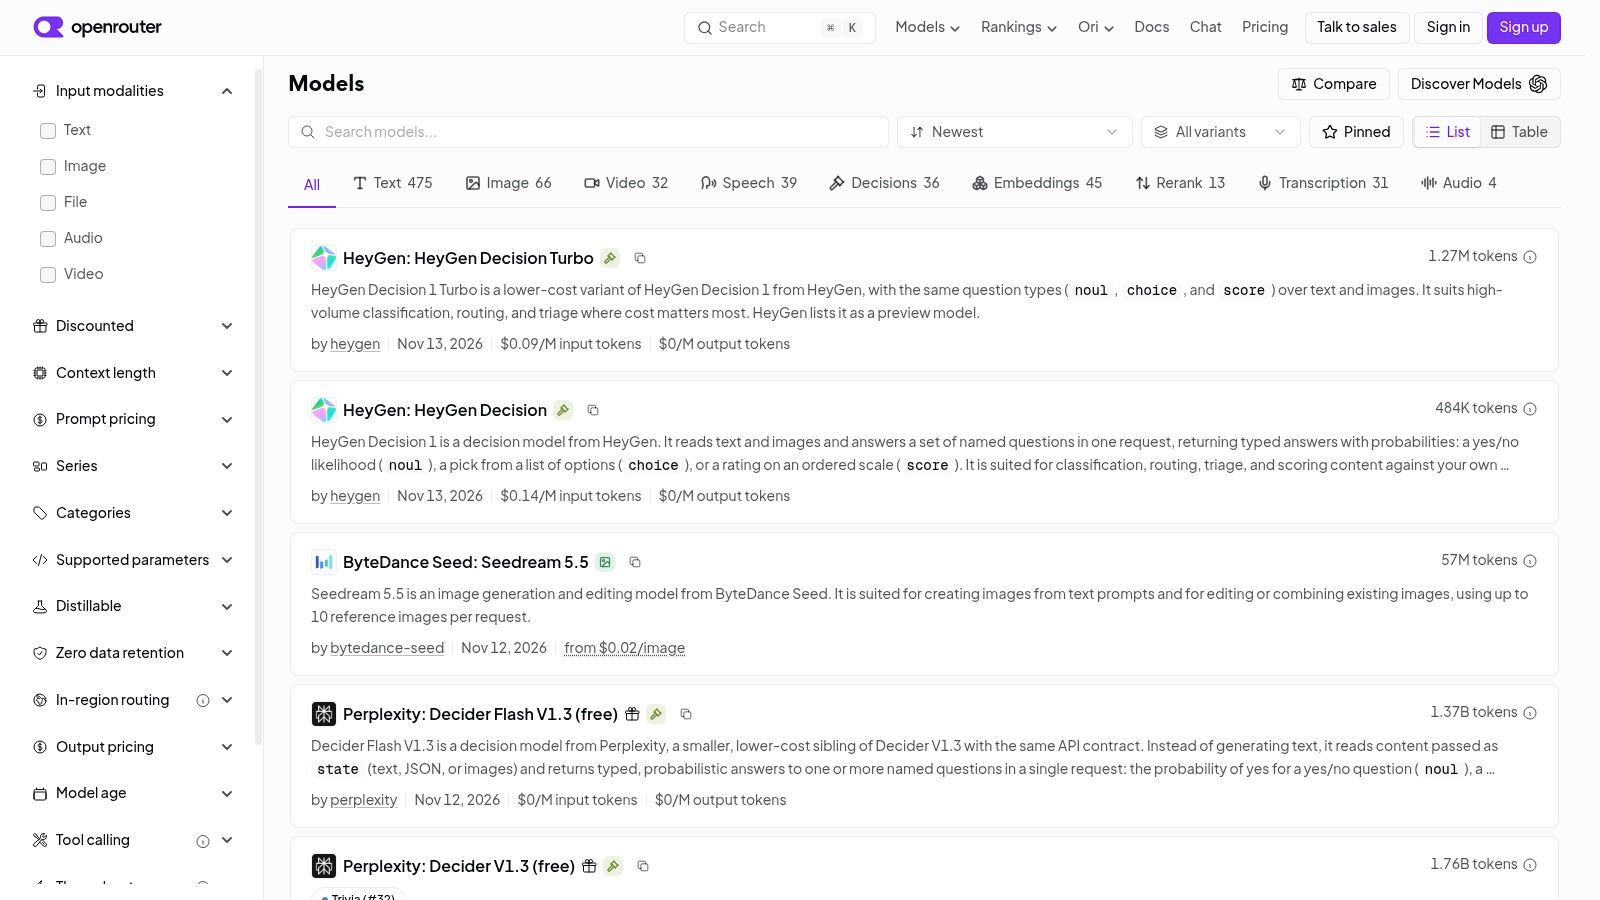
もし、個別のプロバイダー統合を構築せずにホスト型モデルを試すことが当面のタスクであれば、OpenRouterのモデルカタログは実用的な出発点です。検索可能なモデル仕様と共通のAPIを通じたアクセスを組み合わせています。
役立つ比較フィールドには、価格設定、コンテキスト長、モダリティ、機能が含まれます。これらは、単にテキストを受け入れるモデルと、アプリケーションが必要とする追加の入力や動作をサポートする候補を区別するのに役立ちます。同じインターフェースを通じて公開されているすべてのモデルが同じリクエストを受け入れると仮定するのではなく、個々のモデルページを確認してください。
どのような場合に適しているか
OpenRouterは、既存のアプリケーション内でホスト型候補を比較する開発者に適しています。選択したモデルを変更しながら、周囲の評価ハーネスを安定させることができますが、サポートされるパラメーターと出力動作は依然として検証が必要です。
- うまくいく点: 個別のプロバイダー統合をそれぞれ手配することなく、発見からAPI実験へと移行できること。
- うまくいかない点: カタログを、リストされているすべてのモデルの重みをダウンロードできるリポジトリとして扱うこと。
- 確認すべき点: 現在の利用可能性、モデル固有の価格設定、コンテキスト制限、および必要な機能。
コーディングエージェントの場合、スタンドアロンのコード回答の品質だけでなく、ツール呼び出しの引数と、ツール実行失敗後の回復をテストしてください。共通のAPIがあるからといって、エージェントの動作が互換性を持つわけではありません。
OpenRouterの代替サービスの比較は、異なるアクセスサービスを評価する際に役立ちます。その決定はモデル選択とは別にしてください。モデルとそれをホストするサービスは、異なる運用上のトレードオフをもたらします。
3.Hugging Face Hub
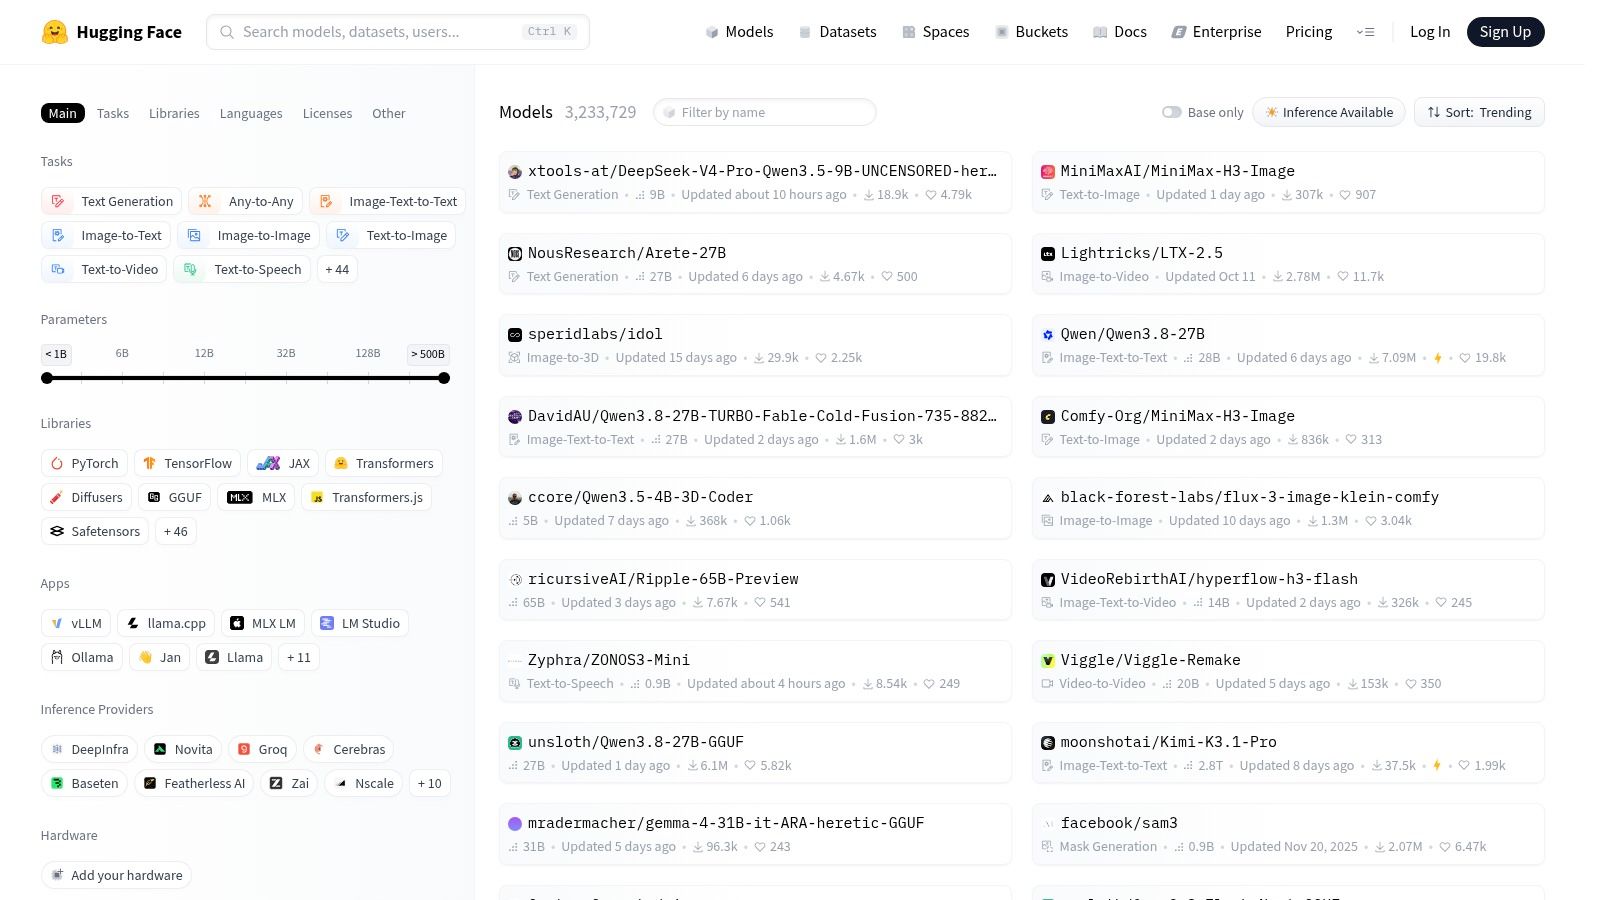
endpointだけでなく、weightsが必要な場合はHugging Faceから始めましょう。 Hugging Face Hubは、自分でカスタマイズ、検査、またはデプロイしたいモデルを見つけるのに特に役立ちます。
そのモデルページには、モデルカード、ダウンロード可能なファイル、実装例、ライセンスの詳細がまとめられています。そのため、ホストされたAPIメニューとは異なる種類のリソースです。単にリクエストで送信する識別子を決定するのではなく、アーティファクトとその要件を調査することになります。
モデル名以外も読みましょう
ダウンロードする前に、タスク、アーキテクチャ、サポートされているinference framework、およびライセンスを確認してください。次に、特に特殊なprompt templatesを持つfine-tunedモデルの場合、例が意図した用途と一致するかどうかを検査してください。
- 強み: テキスト、ビジョン、画像、オーディオのタスク全体で幅広い発見が可能です。
- トレードオフ: ドキュメントと評価の品質は公開元に依存します。
- デプロイの制約: ダウンロード可能なモデルが、マネージドAPIとして自動的に利用できるわけではありません。
例えば、文書処理チームは有望なvision-languageモデルを見つけるかもしれませんが、前処理、inference、および出力検証を組み立てる必要があります。リポジトリは利用可能なものを確立するのに役立ちますが、デプロイ作業をなくすものではありません。
weightsが公開されているからといって、無制限に使用できるわけではありません。 ダウンロードボタンから許可を推測するのではなく、実際のライセンスと関連する条件を読んでください。
基盤となるファイルへのアクセスが重要な場合は、研究やカスタマイズにHugging Faceを使用してください。もし今日の午後にホストされた応答を比較するだけでよいのであれば、APIカタログの方がより早く意味のあるテストにたどり着けるかもしれません。
4. 人工分析
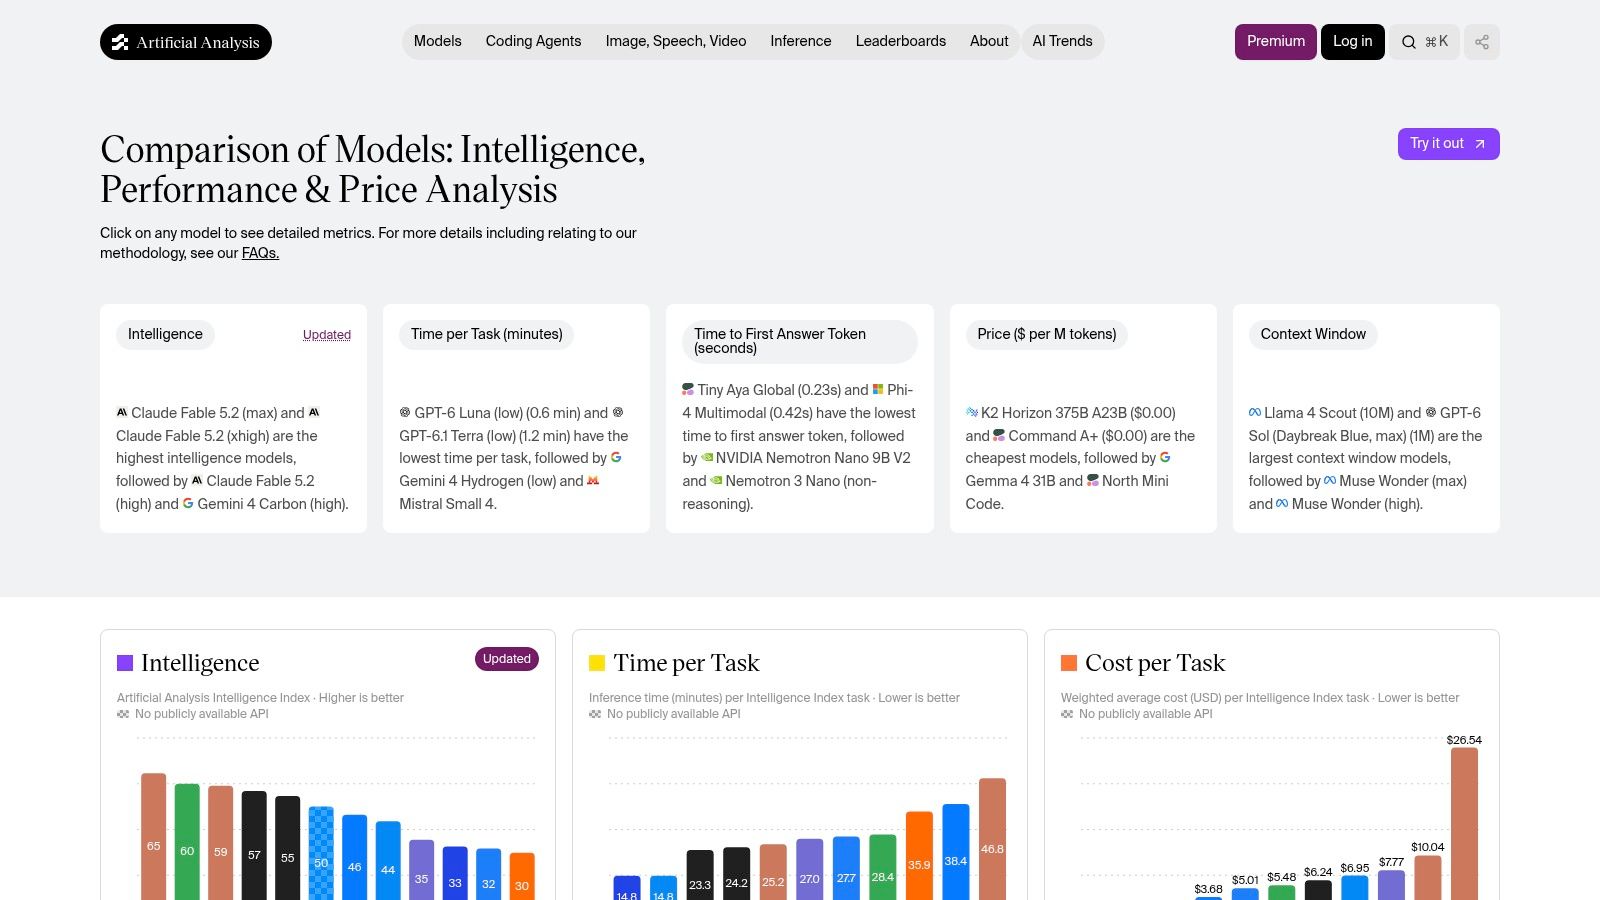
最も低い広告トークン価格を持つモデルはどれか、という問いは難しいものではありません。本当に難しいのは、許容できる総コストと完了時間で、あなたの品質要件を満たす候補がどれかを見つけることです。
人工分析は、知能、価格、タスクあたりの時間、最初の回答トークンまでのレイテンシー、コンテキストウィンドウサイズを含む指標を用いてモデルを比較します。そのタスクあたりのコストアプローチは、料金をワークロードに結びつけるため、トークン価格を単独で読むよりも候補を絞り込む上でより有用です。
ユーザーが体験する指標を比較する
対話型アシスタントの場合、最初のtokenまでの時間は重要ですが、エンドツーエンドの完了時間に取って代わるものではありません。バックグラウンドの抽出ジョブの場合、検証済みの完了と総費用は、テキストが最初に出現する速度よりも重要かもしれません。
- 用途: アプリケーションテストの前に、機能、コスト、速度のトレードオフを特定する。
- 不適切な用途: ベンチマークのリーダーが、あなたのプロンプトや言語で勝つと仮定する。
- アクセスに関する注意: 一部のデータセットや機能には、アカウントまたは有料アクセスが必要な場合があります。
リクエストあたりのコストだけでなく、成功したタスクあたりのコストを比較してください。あなた自身の評価には、リトライと拒否された出力を含めてください。
候補を絞り込む際には、LLM price indexが別の価格参照を提供します。いずれのindexを比較する際も、ワークロードの前提条件を明確にしておいてください。
人工分析は、すべてのモデルをダウンロードしたり、アプリケーションをデプロイしたりする場所ではありません。その役割は、候補を絞り込むことを改善することであり、それらの候補が本番環境の要件を満たすかどうかを決定するのは、あなた自身のハーネスに委ねられます。
5. Replicate Explore
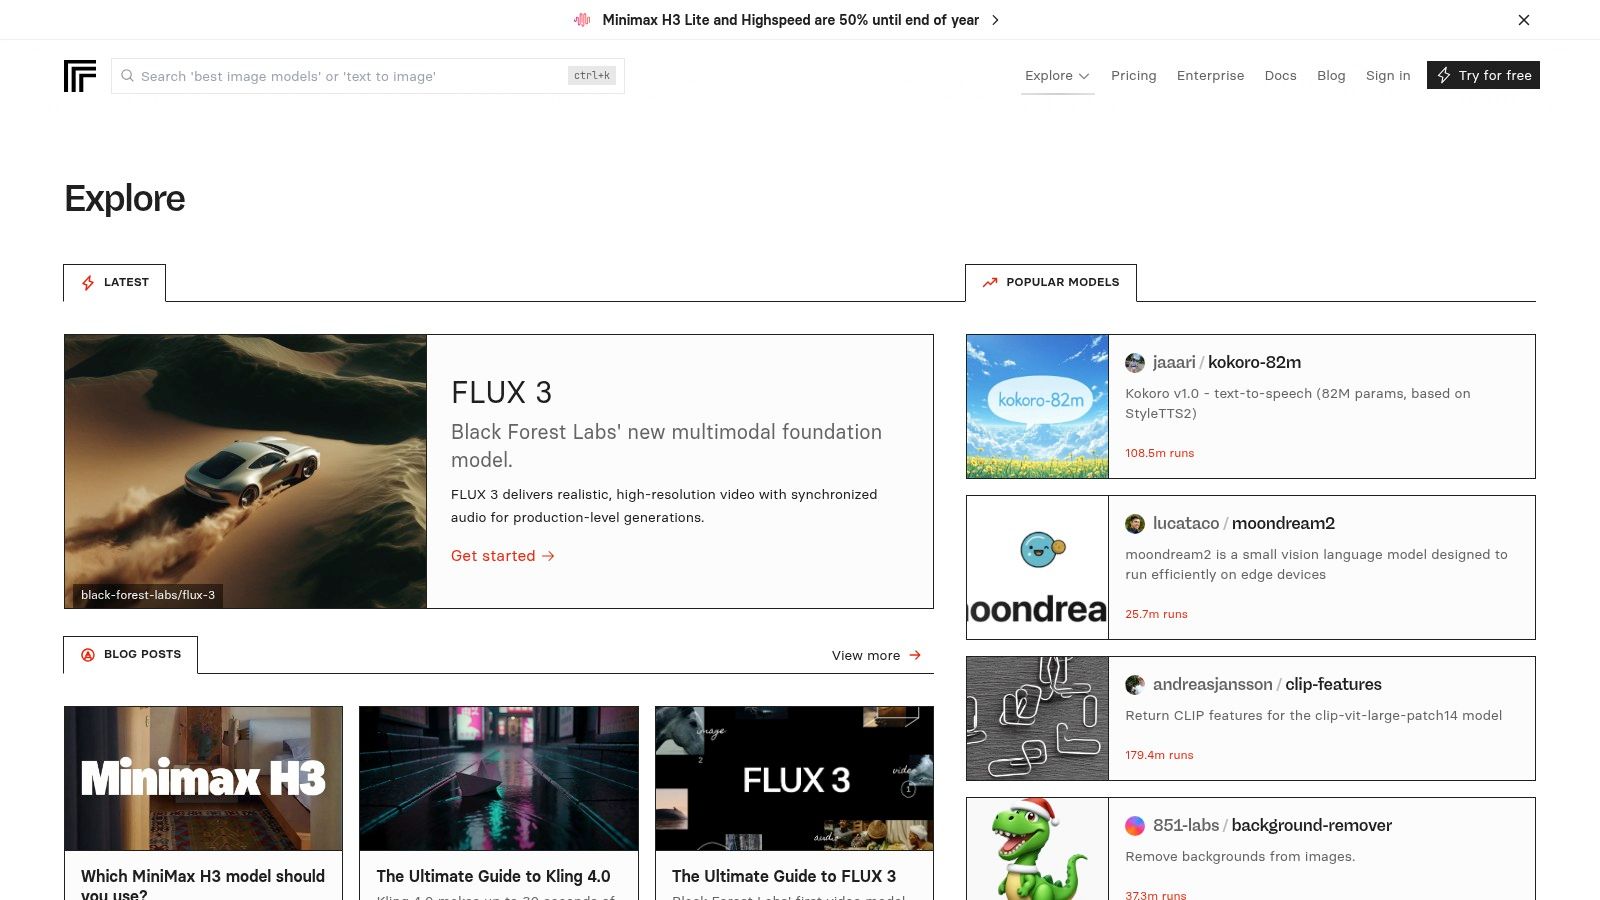
ビデオモデルをテストするには、言語モデルのリーダーボードを読むだけでは不十分です。受け入れられる入力、出力例、生成制御、そしてアプリケーションが完了した結果をどのように取得するかを調べる必要があります。
Replicate Exploreは、この実践的な発見、特に画像、ビデオ、オーディオ生成において役立ちます。モデルページでは、ホストされた実行パスとともに、例、入力定義、使用方法、および価格情報が提供されます。
独自のソース素材でテストする
画像からビデオへの変換では、モデルの洗練された例だけでなく、アプリケーションを代表する画像を使用してください。被写体の一貫性、動き、構図、そして出力が指示を尊重しているかを確認してください。音声の場合、名前、句読点、およびユーザーが提出する言語をテストしてください。
- 強み: ローカルでの推論を最初に設定することなく実験できます。
- 柔軟性: カスタムデプロイメントでは、ReplicateのパッケージングツールであるCogを使用できます。
- 制限事項: コミュニティ公開モデルは、メンテナンス、ドキュメント、およびサポートにおいて異なる場合があります。
それを基に構築する前に、リストが公式であり、活発にメンテナンスされているかを確認してください。また、モデルの価格設定は、テキストスタイルのtoken計算ではなく、ランタイムまたは生成された出力に依存する場合があるため、請求単位を注意深く読んでください。
生成モデルが許容できるメディアを生成できるかどうかを確認する必要がある場合、Replicateは強力な選択肢です。関連性のないモダリティ間で単一の正規化されたランキングとしてはあまり有用ではありません。音声モデルとビデオモデルでは異なる受け入れ基準が必要です。
6. Microsoft Foundry Models
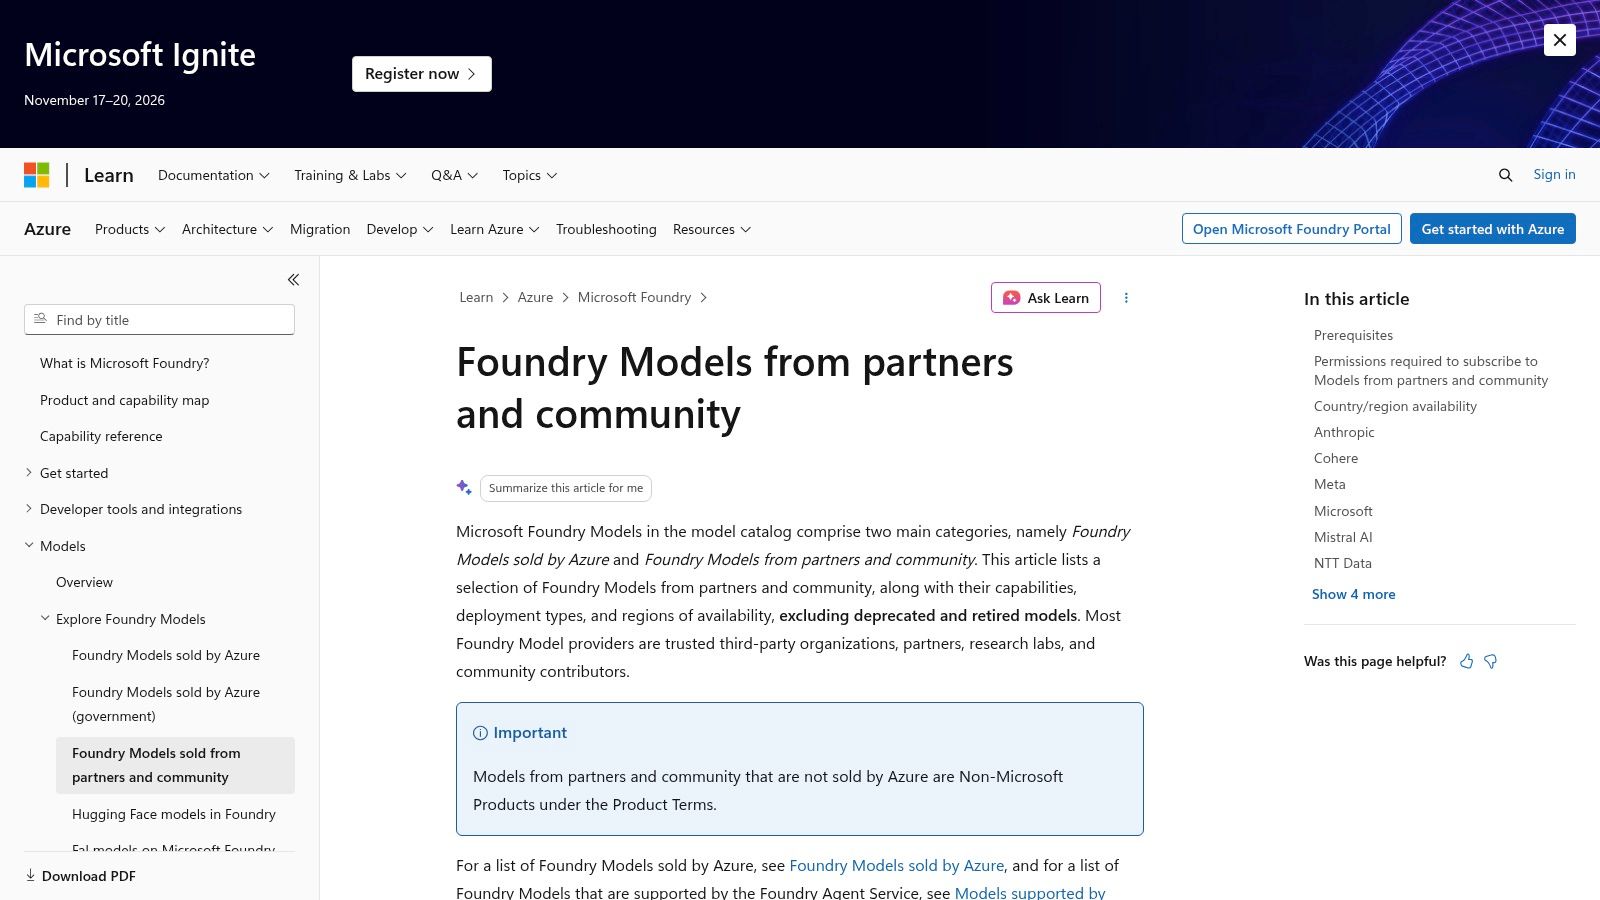
Azureベースのアプリケーションにとって、デプロイの適格性はモデルの機能性と同じくらい重要になることがあります。どんなに有望な候補でも、利用可能なデプロイ方法がアーキテクチャや運用地域に合致しなければ役に立ちません。
Microsoft Foundry Modelsは、モデルの発見とMicrosoftのクラウド環境を結びつけます。このカタログには、Microsoft、パートナー、コミュニティの提供するモデルが含まれており、タスク、機能、ライセンス、デプロイの選択肢に関連する情報が提供されています。
モデルと並行してデプロイパスを選択する
適格なモデルには、API-based、batch、provisioned、またはmanaged-computeといった異なるオプションがあります。カタログでモデルを見つけたからといって、すべてのホスティングおよび課金方法がそのモデルで利用できるとは限りません。
- 良い点: モデルの選択をAzureのデプロイ決定と連携させる必要があるチーム。
- 役立つ詳細: モデル固有のデプロイ情報と選択されたベンチマーク結果。
- 制約: 利用可能性、デプロイ方法、および価格は、モデルと地域によって異なる場合があります。
ドキュメント分析チームは、モデルの入力サポートと、デプロイするendpoint configurationの両方を調査する必要があります。実稼働環境で大幅に異なるサービング構成を使用する場合、デモンストレーションendpointのテストだけでは不十分です。
したがって、このカタログは発見ツールであると同時に、アーキテクチャリソースでもあります。目的のモデルがたまたまそこにあるからではなく、Azure統合が実際の要件である場合に利用してください。
プロバイダーに依存しない探索には、通常、プロバイダー横断的な比較ツールの方がより明確な出発点となります。実用的なクラウドデプロイパスを確立する準備ができたら、Foundryに戻ってください。
7. Amazon Bedrock モデルカタログ
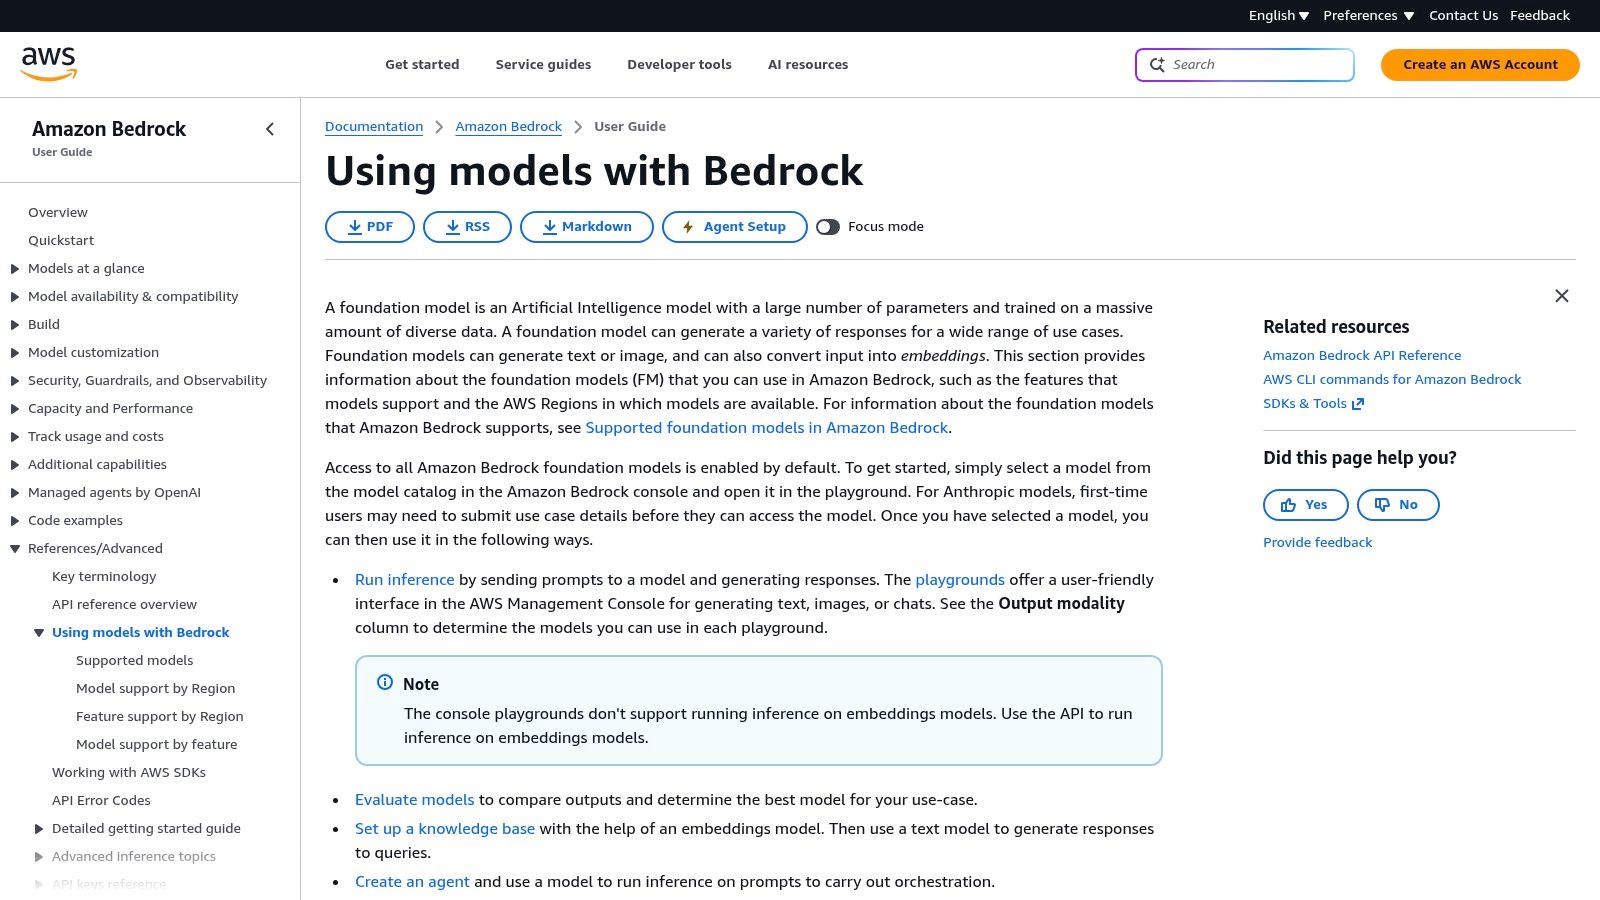
プロトタイプを構築する前に、リージョン別の利用可能性を確認してください。 これは、AWSアプリケーション向けにAmazon Bedrock モデルカタログを使用する際に最も役立つ習慣です。
このカタログは、サポートされている基盤モデルとその機能を特定します。チームは、AWSベースのアプリケーションに統合する前に、Bedrock コンソールプレイグラウンドでリージョン別の利用可能性を検査し、適格なモデルをテストできます。
調達とアクセスは選択の一部です
Bedrock は、アプリケーションがすでにAWSインフラ内で動作している場合に特に重要です。ただし、アカウント設定とリージョンアクセスは、意図した環境で目的のモデルが利用可能かどうかに影響を与える可能性があります。
- 機能するもの: サポートされているモデルの発見からAWSデプロイメントへの移行。
- 確認すべきこと: アカウントアクセス、意図するリージョン、サポートされている入力、および呼び出し要件。
- そうではないもの: ダウンロード可能または商用利用可能なすべてのAIモデルの中立的なインベントリ。
サポートアシスタントの場合、本番環境から送信する予定の同じ検索パッセージと指示をテストしてください。プレイグラウンドでの成功は、リクエストが機能することを示しますが、検索パイプライン、エラー処理、および出力パーサーが正しいことを示すものではありません。
Bedrock の強みは、AWSアプリケーションスタックとの連携です。その同じ方向性は、クラウド固有の統合にコミットすることなく、モデルオプションの広範な調査のみを望むチームにとっては制約となります。
評価で使用された正確なモデルとアクセス設定の記録を残してください。認識可能なモデルファミリー名だけでは、デプロイメントの決定を再現するには不十分です。
8. Google Cloud Model Garden
Google Cloud上で開発を行うチームは、モデルとその提供方法(サービングアレンジメント)を合わせて評価すべきです。適切なモデルファミリーを見つけることは始まりに過ぎません。デプロイメント構成が、それがアプリケーションにどのように適合するかを決定します。
Google Cloud Model Gardenは、Google CloudのAI環境内で、Google、サードパーティ、およびオープンモデルの提供物を横断して発見できます。無関係なローカルランタイム用にモデルをダウンロードするのではなく、次のステップがクラウドベースの開発である場合に最も役立ちます。
発見(ディスカバリー)をデプロイメントの前提から切り離す
コストや実装工数を見積もる前に、個々の提供物を検査してください。利用可能性と価格は、モデル、リージョン、およびサービス構成によって異なります。そのため、カタログエントリだけでは本番環境での適合性を確立できません。
- 最適な用途: Google Cloudアプリケーション向けのモデルを探索する。
- 利点: Googleおよび選択された外部の提供物が、同じクラウド指向の発見(ディスカバリー)ワークフロー内に表示されます。
- 制限: プロバイダーに依存しない調査やオフラインでの実験にはあまり便利ではありません。
画像分析サービスの場合、受け入れられる入力形式を確認し、その後、アプリケーションが実行する正確な前処理をテストしてください。サイズ変更、トリミング、ドキュメント変換は、最終的なデプロイメントだけでなく、評価にも含まれるべきです。
Model Gardenを、より狭いGemini APIモデルリストと混同しないでください。前者はより広範なクラウドモデルの発見(ディスカバリー)に役立ち、後者は特定のAPIエコシステム向けのファーストパーティの詳細を提供します。
チームがGoogle Cloudがデプロイメント計画の一部であることを知っている場合にModel Gardenを使用してください。そうでない場合は、モデルの要件から始め、既存のクラウドコンソールが時期尚早に候補リストを定義するのを避けてください。
9. Ollamaライブラリ
モデルを自分のマシンで実行することが要件であれば、ホスト型APIマーケットプレイスではなく、ランタイム指向のカタログから始めましょう。Ollamaライブラリは、Ollamaのローカルワークフローでサポートされているモデル、サイズ、バリアント、機能を見つけるのに役立ちます。
モデルサイズは有用な初期フィルターですが、完全なハードウェア見積もりではありません。コンテキストの使用量、ランタイムのオーバーヘッド、メモリを競合する他のアプリケーションも、その構成が快適に動作するかどうかに影響します。
実際のマシンでテストする
お使いのハードウェアに合った候補を選び、代表的な入力長で試してみてください。短いチャットプロンプトを処理できるモデルも、取得したドキュメントや長い会話を追加すると、実用的でなくなる可能性があります。
スタンフォード大学のAIインデックス効率に関する議論によると、3.8億パラメータを持つPhi-3-miniは、以前PaLMの540億パラメータが必要だったMMLUの同じ閾値に達したと報告されています。この比較は、パラメータ数だけでは品質ランキングにならないという実践的な教訓を裏付けています。
- 強み: ローカルで実行可能なモデルで手軽に実験できます。
- コストの違い: ローカル実行はホスト型APIの使用料を回避しますが、ハードウェアと運用には依然として費用がかかります。
- 制限: お使いのマシンとサポートされているフォーマットが、候補を絞り込みます。
ローカル実行は、自動的に完全なオフラインシステムになるわけではありません。検索、ロギング、ツール、その他のアプリケーションコンポーネントもローカルに留まるかどうかを確認してください。
Ollamaは、オフラインプロトタイプやハードウェア制約のある実験にとって有用な出発点です。品質、メモリ使用量、エンドツーエンドのレイテンシを検証する必要がなくなるわけではありません。
10. Google Gemini API モデル一覧
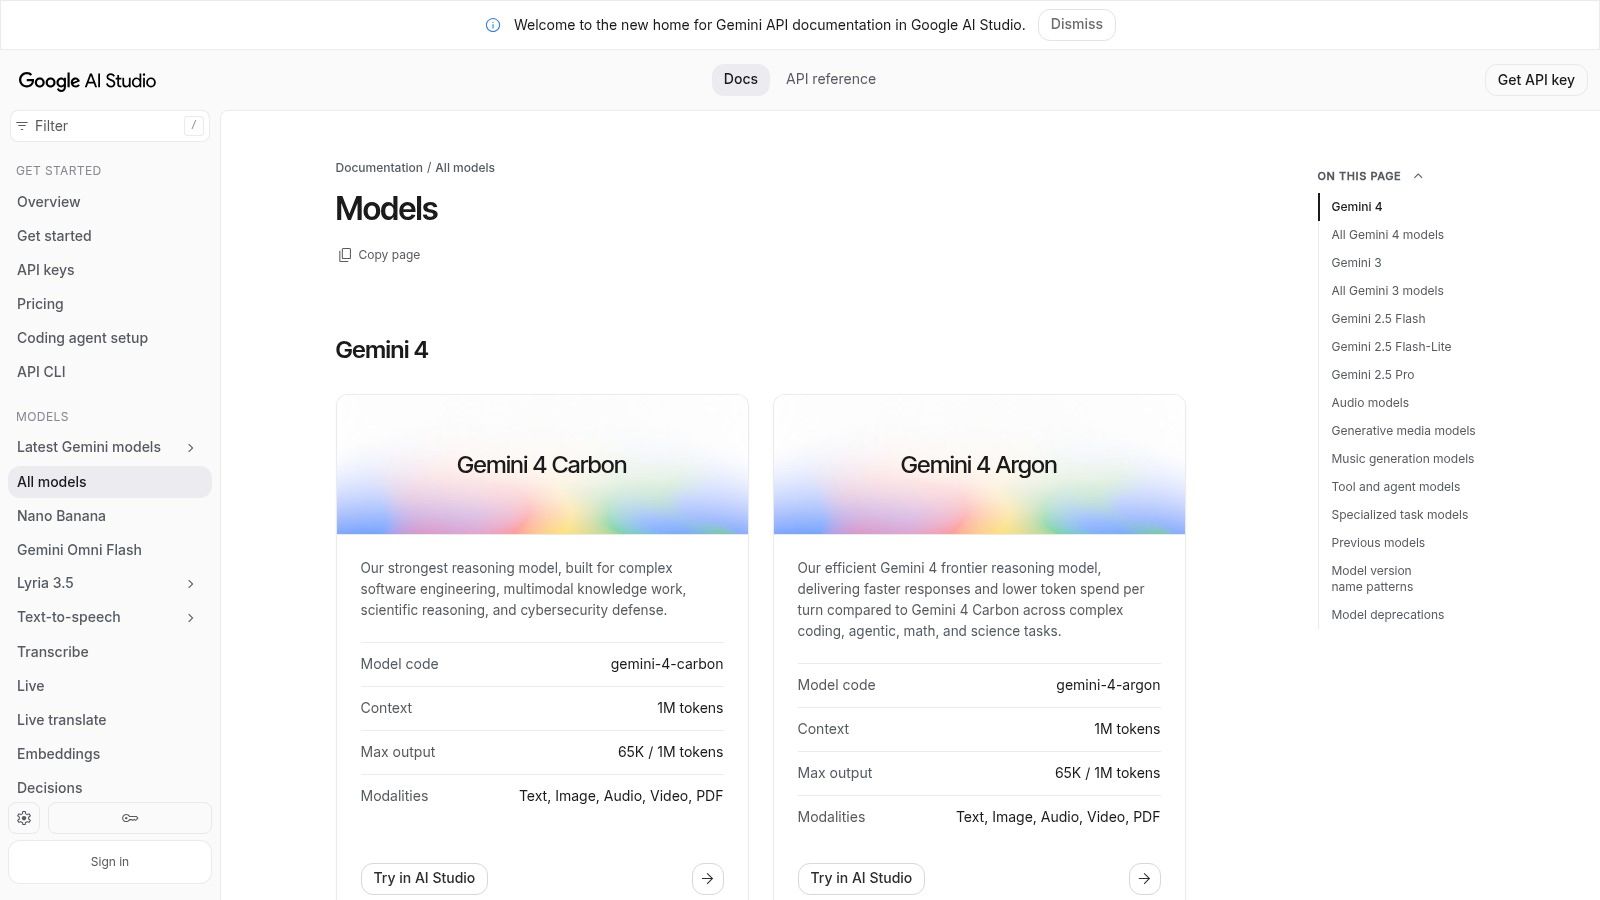
最適な選択肢は、時に最も限定的なものです。Gemini API をすでに選択している場合、公式の Gemini API モデル一覧を使用して、モデル識別子、説明、およびサポートされている機能を確認してください。
これは、ファーストパーティの実装ドキュメントであり、プロバイダー横断型の比較サービスではありません。モデルの発見と API ドキュメント、Google AI Studio を連携させ、選択したモデルファミリーを動作するリクエストに変換する必要がある場合に役立ちます。
正確な識別子を確認する
比較記事からコピーしたモデルファミリー名に基づいて構築しないでください。統合する前に、特定の識別子を確認し、サポートされている入力、出力、およびアクセス条件を検査してください。
- 強み: Gemini API を使用する開発者向けの直接的なモデル情報。
- 範囲の制限: すべての競合プロバイダーを比較する役には立ちません。
- 商用に関する注意点: 選択したモデルの現在の料金、アクセスティア、および利用資格条件を確認してください。
音声関連のアプリケーションの場合、すべての Gemini モデルが同じ機能を提供すると仮定するのではなく、特定のモデルが必要な音声ワークフローをサポートしているかどうかを確認してください。マルチモーダル入力とツール使用にも同様の注意を払ってください。
メンテナンスプロセスにもライフサイクルチェックを含めてください。Veo および Gemini API シャットダウンガイド] は、エンドポイントの依存関係と移行作業を確認する際に、関連性があります。
公式リストは、候補を絞り込んだ後の実装リファレンスとして最適です。有効なリクエストを作成するために必要な詳細を提供し、返された結果が製品の要件を満たしているかどうかは、ご自身の評価によって決定されます。
10つのモデルカタログがアクセス、料金の可視性、および制限によってどう異なるか
| 項目 | 最適な用途 | アクセスモデル | 料金の可視性 | 主な制限 |
|---|---|---|---|---|
| UberLLM AIモデルカタログ(推奨) | プロバイダー間のモデル比較 | 統合APIとマーケットプレイス | ライブ料金を掲載 | カタログはワークロード固有のパフォーマンスを予測しない |
| OpenRouter | プロバイダー間のモデル比較とアクセス | 1つのAPI keyで利用できるホスト型API | モデル料金を表示;現在の料金を確認してください | ホスト型APIであり、モデルの重みはダウンロード不可 |
| Hugging Face Hub | 研究、カスタマイズ、セルフホスティング | モデルのダウンロード;ホスティングは様々 | 料金は一貫して掲載されていない | モデルの品質とドキュメントは様々 |
| Artificial Analysis | ベンチマーク、コスト、速度の比較 | 研究および比較リソース;データAPI | API料金を表示;一部のアクセスは有料の場合あり | ベンチマークはあなたのワークロードを反映しない可能性がある |
| Replicate Explore | ホスト型生成モデルのテストと実行 | ホスト型モデルAPIとカスタムデプロイメント | モデル固有の料金;使用量によって異なる場合あり | コミュニティモデルの品質とサポートは様々 |
| Microsoft Foundry Models | Azureアプリケーション用のモデル選択 | Azureデプロイメントオプション | モデルとリージョンによって異なる | Azureユーザーに最適 |
| Amazon Bedrockモデルカタログ | AWSアプリケーション用のモデル検索 | AWS内のBedrockサービス | モデルとリージョンによって異なる | AWSおよびリージョンに依存するアクセス |
| Google Cloud Model Garden | Google Cloudデプロイメント用のモデル検索 | Google Cloud AIサービス | モデルと構成によって異なる | Google Cloudに特化 |
| Ollama Library | モデルをローカルで実行 | Ollamaによるローカル推論 | ホスト型料金なし;あなたのハードウェアを使用 | セットアップと適切なハードウェアが必要 |
| Google Gemini APIモデルリスト | Googleモデルでの構築 | Gemini APIとGoogle AI Studio | 料金ページは別;ティアは様々 | Googleモデルのみを対象 |
候補リストを実用的な統合にする
モダリティごとに2、3の妥当なモデルが見つかったら、それ以上探すのはやめましょう。チームが許容できる結果がどのようなものかを定義していない場合、候補を増やしても役に立ちません。比較を実行する前に、必要なcontext length、output limits、tool support、input formats、およびdeployment constraintsを書き出してください。
次に、同じプロンプトまたは生成タスクを各候補に送信します。テキスト抽出の場合、返されたschemaを検証し、抽出された値を期待される回答と比較します。コーディングの場合、生成された変更に対してテストを実行します。メディアの場合、最も印象的に見えるサンプルを選ぶのではなく、一貫したブリーフに基づいて出力をレビューしてください。
完全なアプリケーションパスを評価する
推論を取り巻く作業を含めてください。ドキュメント変換、retrieval、tool execution、polling、retries、output validationはすべて、それ以外は有能なモデルが使用可能かどうかを決定しうる要素です。
- 品質: 単に完了したrequestだけでなく、承認された結果を記録します。
- レイテンシー: 関連する場合、初期responseとend-to-endの完了の両方を測定します。
- コスト: retries、拒否された生成、および必要なfollow-up callsを含めます。
- 信頼性: timeouts、malformed outputs、利用できないendpointsを試します。
ブルッキングス研究所のAIモデル評価に関する議論]は、benchmark scoresがlatency、compute requirements、cost、safetyなどの実用的な懸念を省略しうる理由を説明しています。あなたの評価は、公開されたleaderboardをproduction acceptance testとして扱うのではなく、これらの懸念を明示的にすべきです。
テキスト、画像、ビデオ、オーディオのワークフロー全体で1つのendpointを望むチーム向けに、既存のOpenAIまたはAnthropic SDK設定のbase URLを互換性のあるAPI endpointに設定することで、UberLLMの統合を開始してください。UberLLM keyを使用し、既存のSDK interfaceと周辺コードを保持し、その後、model identifierを変更することで候補を切り替えます。各候補がサポートするparametersを検証し、すべてのモダリティがstreaming chat responseのように動作すると仮定するのではなく、メディアには適切な非同期task workflowを使用してください。
決定を再現可能にする
model identifier、prompt version、generation settings、evaluation inputs、およびacceptance resultsをまとめて保存してください。その記録により、別のengineerがテストを繰り返すことができ、後からのモデル変更の評価が容易になります。バージョン管理されていないscreenshotや、記憶に残っている出力品質の印象に頼るのは避けてください。
デフォルトモデルを選択し、アプリケーションがいつescalateするか、または安全にfailするかを定義してください。fallbackは、privacy constraintsやtool supportを含む同じ本質的な要件を満たしている場合にのみ有用です。最良のAIモデルリストとは、防御可能な統合決定に到達するのに役立ち、その後、再現可能なテストにつながるものです。
UberLLMは、統一されたAPIとプリペイド残高を通じて、開発者をサードパーティのテキスト、画像、ビデオ、音楽、音声モデルに接続します。UberLLM]にアクセスして、モデルの制限とライブ価格を比較し、playgroundで候補リストをテストし、アプリケーションの要件を満たす候補を統合してください。