Lista de Modelos de IA 2026: 10 Opciones por Caso de Uso
Explora esta práctica lista de modelos de IA por modalidad, capacidad y caso de uso, con 10 catálogos comparados en cuanto a precios, acceso y cargas de trabajo más adecuadas.
Imagina que tu equipo pasa una semana leyendo páginas de modelos, comparando precios de tokens y configurando un prototipo. Luego alguien sube un documento representativo y descubre que el candidato más barato no puede encajar el documento, las instrucciones y la respuesta esperada en su ventana de contexto. La integración funciona. La elección del modelo no.
Un catálogo de modelos no es lo mismo que una elección de modelo. Algunos catálogos te ayudan a descubrir pesos descargables. Otros comparan el rendimiento medido, venden inferencia alojada, conectan modelos a la adquisición en la nube o empaquetan modelos para ejecución local. Tratarlos como intercambiables hace perder tiempo y puede ocultar la restricción que determina si tu aplicación funciona.
Una lista de modelos de IA útil debería indicarte por dónde empezar para una tarea específica:
- Descubrir y personalizar modelos: Usa un directorio con tarjetas de modelo, archivos e información de licencias.
- Comparar candidatos para producción: Usa mediciones independientes, luego prueba tu propia workload.
- Llamar a modelos alojados: Usa un catálogo de API con identificadores de modelo explícitos y detalles de despliegue.
- Ejecutar sin conexión: Usa un catálogo de runtime local y verifica los requisitos de hardware.
Para aplicaciones de texto, la longitud del contexto y el soporte de herramientas podrían eliminar candidatos inmediatamente. Para aplicaciones de imagen, video y audio, las entradas soportadas, los controles de salida y el manejo de tareas asíncronas merecen igual atención. Las opciones a continuación sirven para diferentes propósitos, por lo que el punto de partida correcto depende menos de qué catálogo parezca el más grande y más de lo que necesitas hacer a continuación.
Tabla de Contenidos
- 1. Catálogo de modelos de IA de UberLLM
- 2. OpenRouter
- 3. Hugging Face Hub
- 4. Artificial Analysis
- 5. Replicate Explore
- 6. Microsoft Foundry Models
- 7. Catálogo de modelos de Amazon Bedrock
- 8. Google Cloud Model Garden
- 9. Ollama Library
- 10. Lista de modelos de la API de Google Gemini
- Cómo los 10 Catálogos de Modelos Difieren por Acceso, Visibilidad de Precios y Límites
- Convirtiendo una Lista Corta en una Integración Funcional
1. Catálogo de modelos de IA de UberLLM
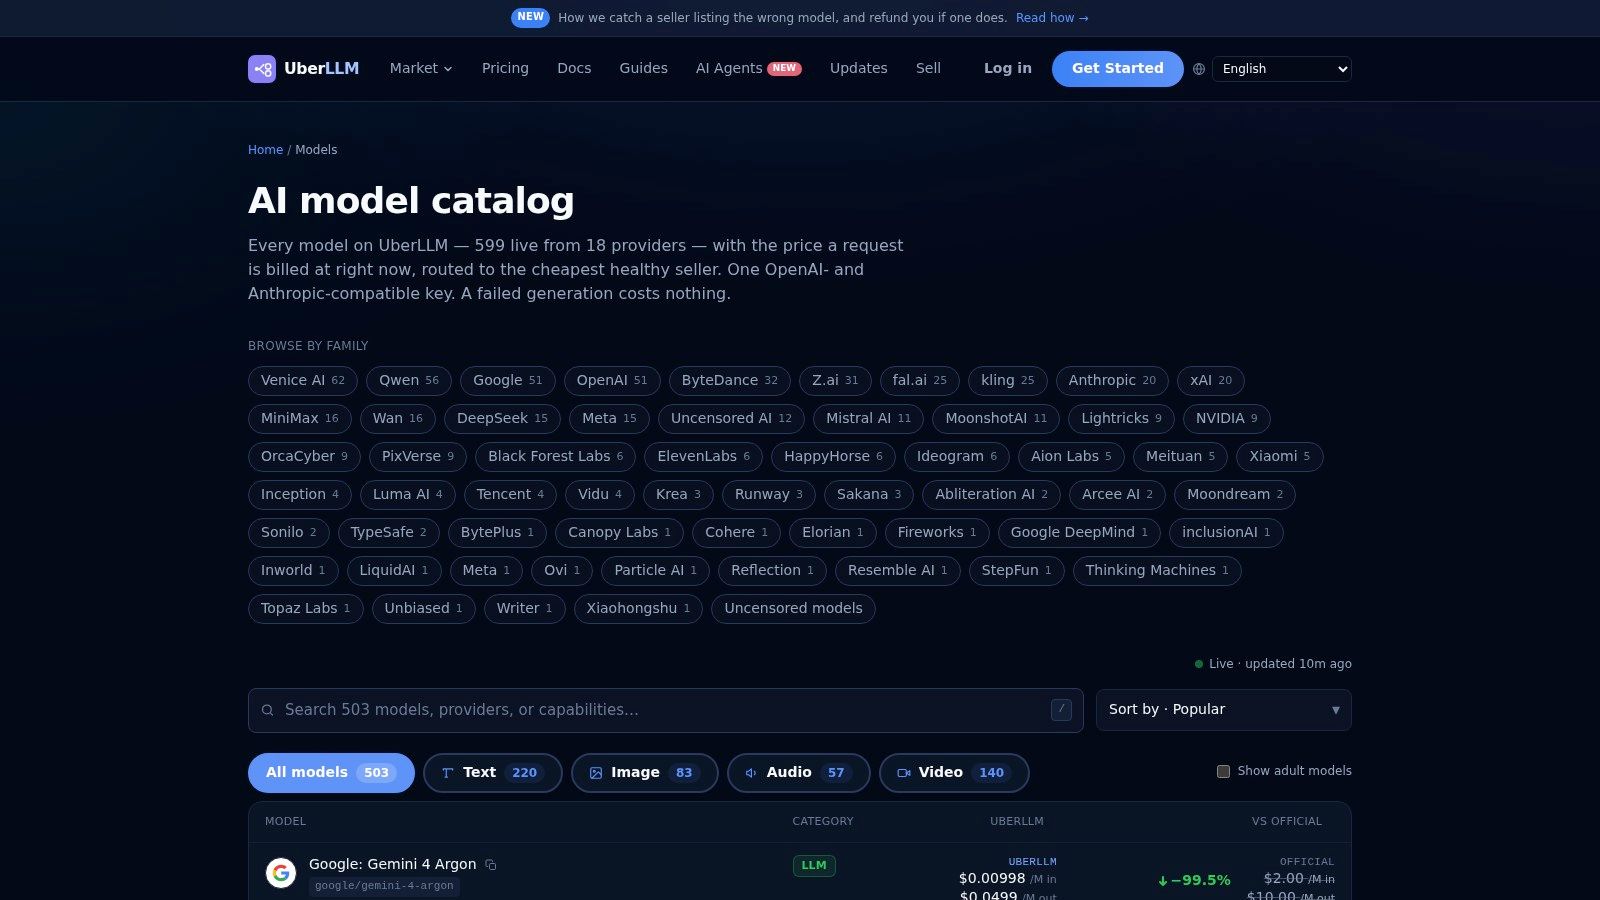
Ideal para comparar opciones alojadas antes de integrar una API de marketplace. El catálogo de modelos de IA de UberLLM reúne 457 modelos en una página de comparación con precios en tiempo real, nombres de proveedores, longitudes de contexto y tipos de modelo. Es útil cuando tu lista de preselección abarca texto y medios en lugar de una única familia de modelos.
En UberLLM, conectamos ese proceso de descubrimiento a un endpoint compatible con OpenAI y Anthropic. Los desarrolladores seleccionan un identificador de modelo, mientras que el enrutamiento del marketplace selecciona un vendedor disponible para el modelo solicitado. Esa distinción importa: estás eligiendo tanto las capacidades de un modelo como una ruta de acceso alojada.
Qué inspeccionar antes de elegir
Para el procesamiento de documentos, compara la longitud de contexto y los tokens de salida máximos por separado. Un modelo que acepta tu material de origen podría tener un límite de salida que le impida generar el resultado completo. Nuestros metadatos del modelo exponen ambos campos, y el catálogo marca los modelos que admiten herramientas.
- Ventaja: Los precios en tiempo real y los nombres de los proveedores hacen que la preselección entre proveedores sea menos fragmentada.
- Flujo de trabajo útil: Filtra por modalidad, inspecciona los límites y luego compara las salidas representativas en el playground.
- Limitación: Un listado no puede establecer si tu esquema de extracción, tarea de codificación o brief visual tendrá éxito.
No trates el precio más bajo mostrado como la respuesta final. Para texto, estima la combinación de entrada y salida que produce tu aplicación; para medios, inspecciona la configuración de generación solicitada antes de comparar los costos.
Regla práctica: Elige un modelo solo después de que sus límites, calidad de salida y comportamiento ante fallos satisfagan la carga de trabajo. Una solicitud barata que produce un resultado inutilizable no es un ahorro útil.
Los precios y la disponibilidad pueden cambiar, así que registra el identificador y la configuración utilizados en las pruebas en lugar de dejar tu lista de preselección como una colección de nombres de modelos.
2. OpenRouter
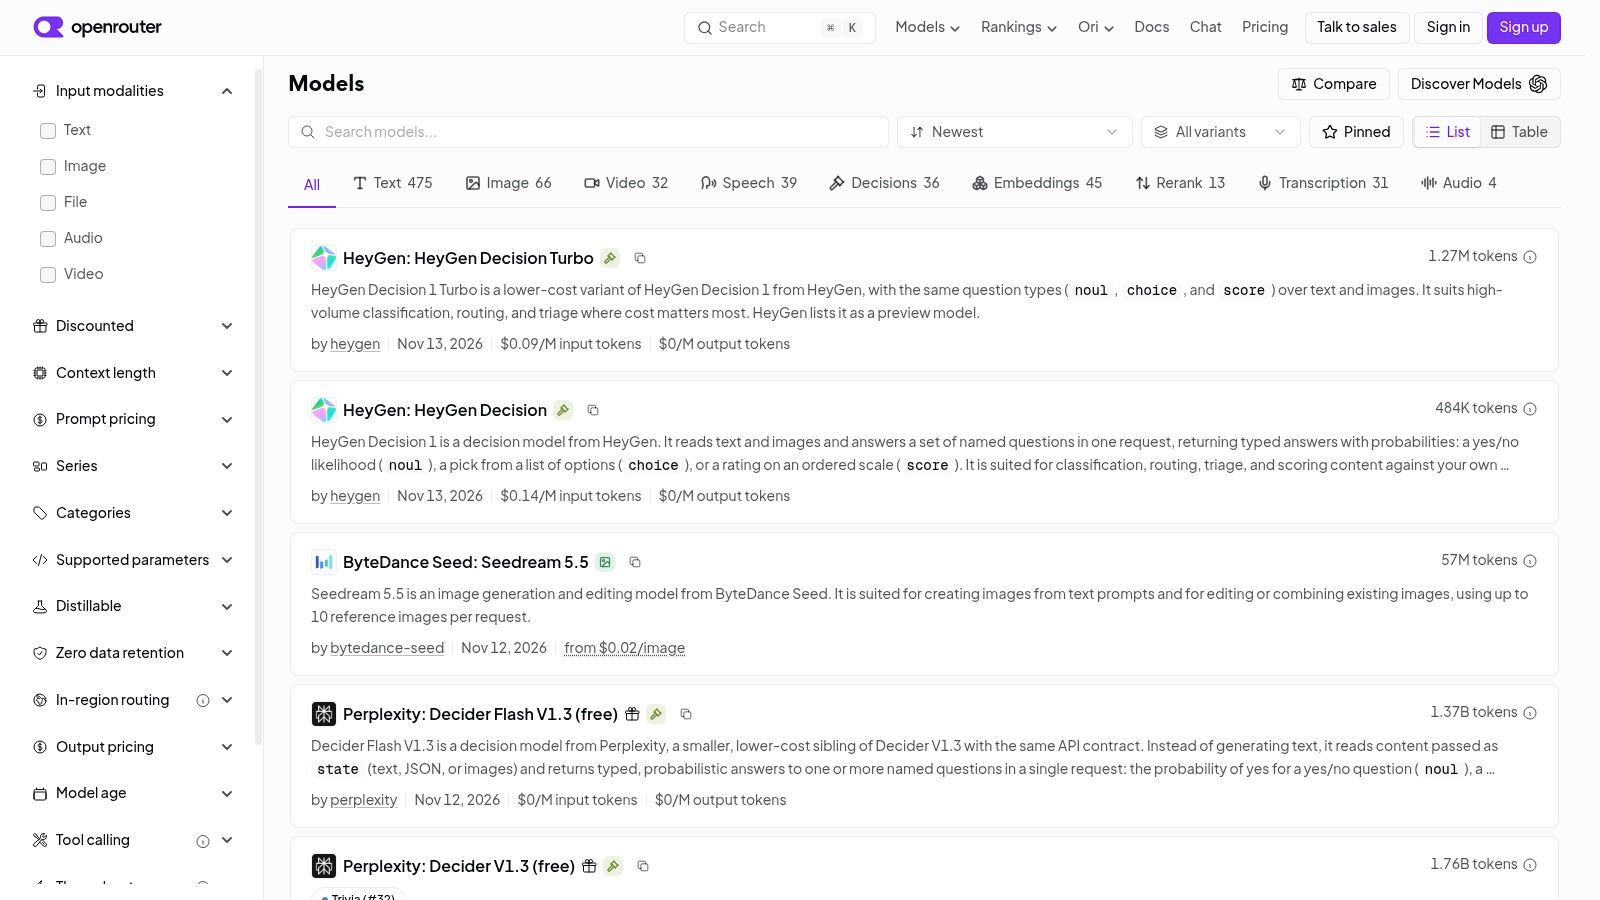
Si tu tarea inmediata es probar modelos alojados sin construir integraciones de proveedor separadas, el catálogo de modelos de OpenRouter es un punto de partida práctico. Combina especificaciones de modelos buscables con acceso a través de una API común.
Los campos de comparación útiles incluyen precios, longitud de contexto, modalidades y capacidades. Estos ayudan a distinguir los modelos que simplemente aceptan texto de los candidatos que soportan las entradas o comportamientos adicionales que tu aplicación requiere. Consulta la página individual del modelo en lugar de asumir que cada modelo expuesto a través de la misma interfaz acepta la misma solicitud.
¿Dónde encaja?
OpenRouter es adecuado para un desarrollador que compara candidatos alojados dentro de una aplicación existente. Puedes mantener estable el entorno de evaluación circundante mientras cambias el modelo seleccionado, aunque los parámetros soportados y el comportamiento de salida aún necesitan validación.
- Lo que funciona: Pasar del descubrimiento a la experimentación con la API sin organizar cada integración de proveedor por separado.
- Lo que no funciona: Tratar el catálogo como un repositorio donde se pueden descargar los pesos de cada modelo listado.
- Lo que hay que verificar: Disponibilidad actual, precios específicos del modelo, límites de contexto y capacidades requeridas.
Para un agente de codificación, prueba los argumentos de llamada a herramientas y la recuperación después de una ejecución fallida de la herramienta, no solo la calidad de una respuesta de código independiente. Una API común no hace que el comportamiento del agente sea intercambiable.
La comparación de alternativas de OpenRouter es útil al evaluar diferentes servicios de acceso. Mantén esa decisión separada de la selección del modelo: el modelo y el servicio que lo aloja introducen diferentes compensaciones operativas.
3. Hugging Face Hub
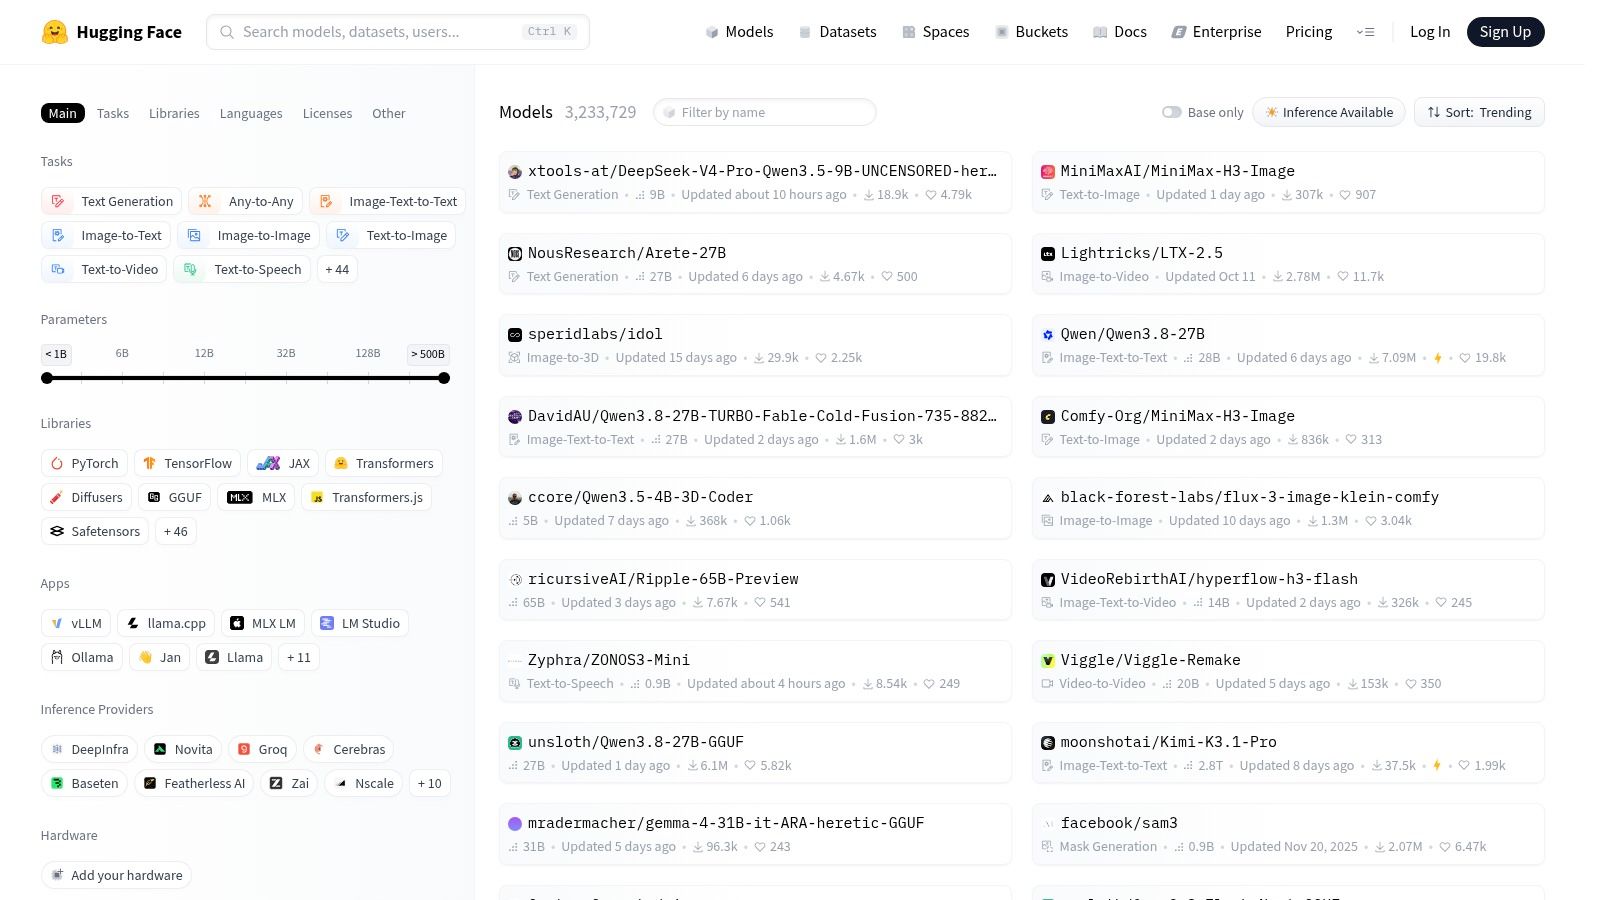
Empieza con Hugging Face cuando necesites pesos, no solo un endpoint. El Hugging Face Hub es particularmente útil para encontrar modelos que podrías personalizar, inspeccionar o desplegar tú mismo.
Sus páginas de modelo pueden combinar tarjetas de modelo, archivos descargables, ejemplos de implementación y detalles de licencia. Eso lo convierte en un tipo de recurso diferente de un menú de API alojado: estás investigando el artefacto y sus requisitos, no simplemente decidiendo qué identificador enviar en una solicitud.
Lee más allá del nombre del modelo
Verifica la tarea, la arquitectura, el framework de inferencia compatible y la licencia antes de descargar. Luego, inspecciona si los ejemplos coinciden con tu uso previsto, especialmente para modelos ajustados con plantillas de prompt especializadas.
- Ventaja: Amplia capacidad de descubrimiento en tareas de texto, visión, imagen y audio.
- Inconveniente: La calidad de la documentación y la evaluación depende del editor.
- Restricción de despliegue: Un modelo descargable no está automáticamente disponible como una API gestionada.
Por ejemplo, un equipo de procesamiento de documentos podría encontrar un modelo de visión-lenguaje prometedor, pero aún necesitaría ensamblar el preprocesamiento, la inferencia y la validación de la salida. El repositorio ayuda a establecer lo que está disponible; no elimina el trabajo de despliegue.
Los pesos abiertos tampoco significan uso sin restricciones. Lee la licencia real y las condiciones asociadas en lugar de inferir permisos del botón de descarga.
Usa Hugging Face para investigación y personalización cuando el acceso a los archivos subyacentes es importante. Si solo necesitas comparar respuestas alojadas esta tarde, un catálogo de API podría llevarte a una prueba significativa más rápido.
4. Análisis Artificial
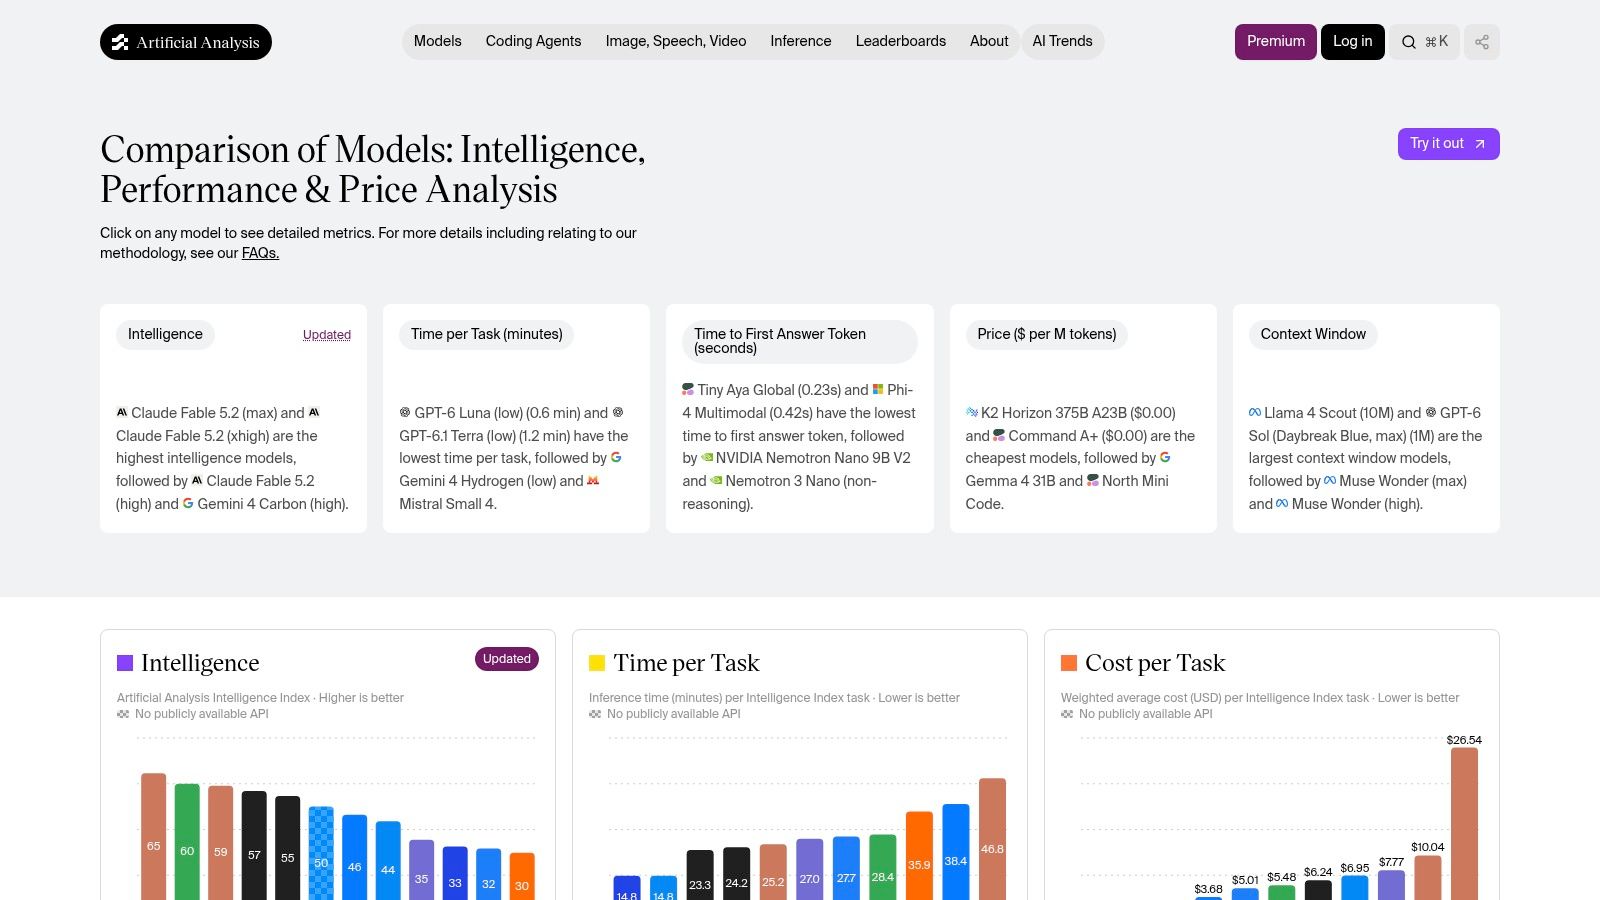
La pregunta difícil no es qué modelo tiene el precio de token anunciado más bajo. Es qué candidato cumple con tu requisito de calidad con un costo total y un tiempo de finalización aceptables.
Análisis Artificial compara modelos utilizando medidas que incluyen inteligencia, precio, tiempo por tarea, latencia al primer token de respuesta y tamaño de la ventana de contexto. Su enfoque de costo por tarea es más útil para la preselección que leer los precios de los token de forma aislada porque conecta los cargos a una carga de trabajo.
Compara la métrica que experimentan tus usuarios
Para un asistente interactivo, el tiempo hasta el primer token importa, pero no reemplaza el tiempo de finalización de principio a fin. Para un trabajo de extracción en segundo plano, la finalización validada y el gasto total pueden importar más que la velocidad a la que aparece el texto por primera vez.
- Úsalo para: Identificar las compensaciones entre capacidad, costo y velocidad antes de las pruebas de la aplicación.
- No lo uses para: Asumir que un líder de benchmark ganará con tus prompts o idioma.
- Advertencia de acceso: Algunos conjuntos de datos o características pueden requerir una cuenta o acceso de pago.
Compara el costo por tarea exitosa, no solo el costo por solicitud. Incluye los reintentos y las salidas rechazadas en tu propia evaluación.
El índice de precios de LLM proporciona otra referencia de precios al elaborar una preselección. Mantén visibles las suposiciones de carga de trabajo al comparar cualquier índice.
Análisis Artificial no es el lugar para descargar todos los modelos o desplegar tu aplicación. Su trabajo es mejorar la preselección, dejando que tu propio sistema determine si esos candidatos cumplen con los requisitos de producción.
5. Replicate Explore
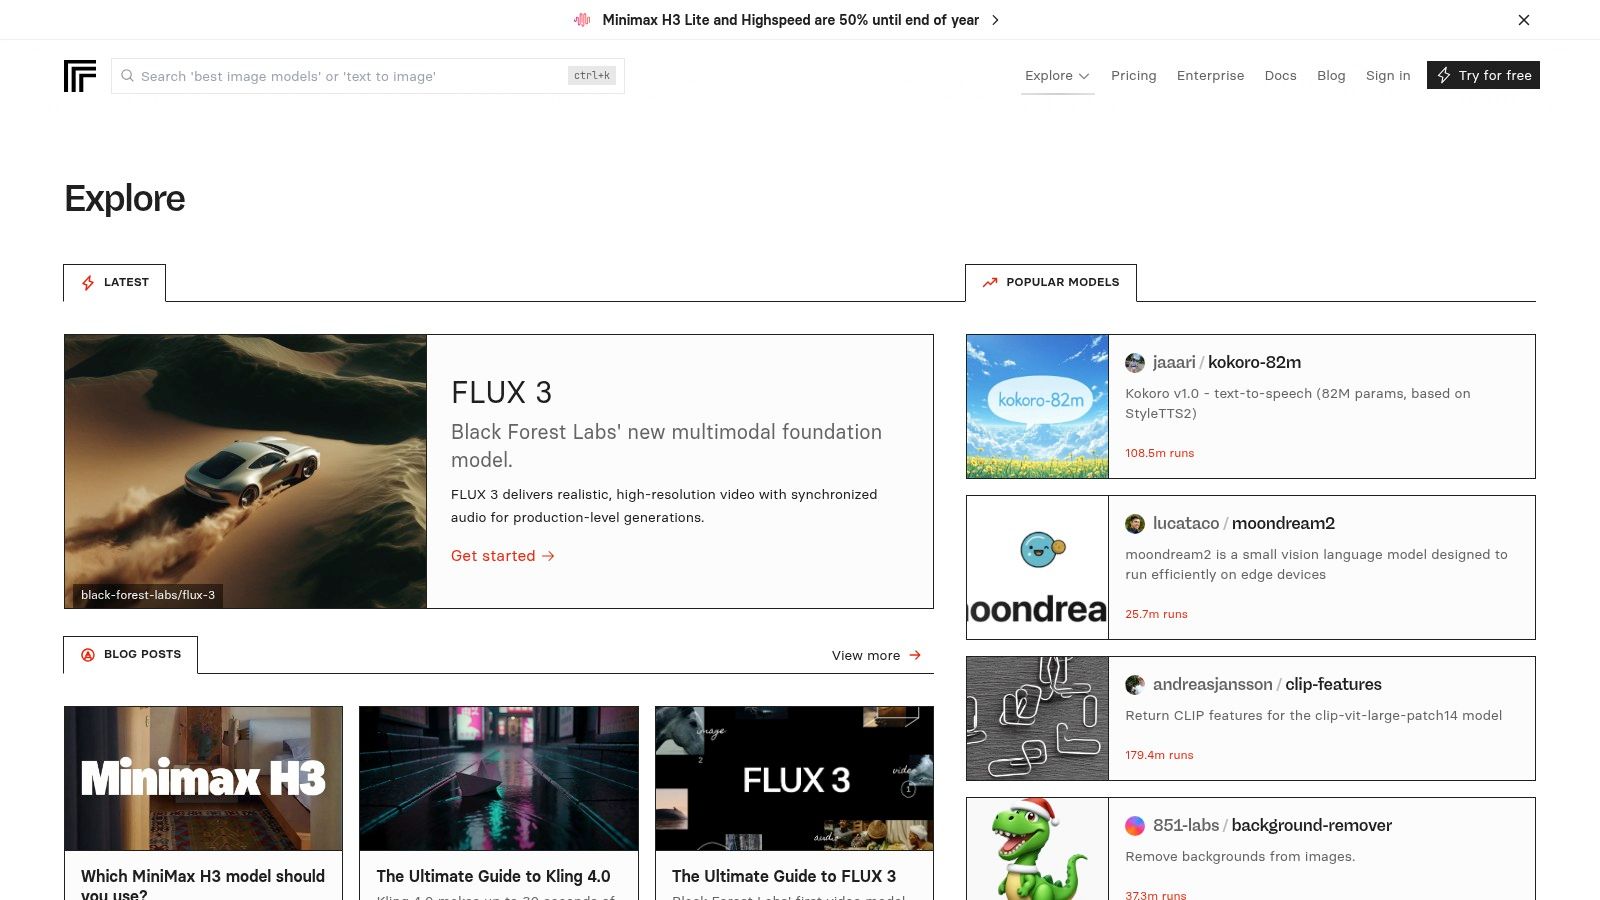
Probar un modelo de video requiere más que leer una tabla de clasificación de modelos de lenguaje. Necesitas inspeccionar las entradas aceptadas, los ejemplos de salida, los controles de generación y cómo la aplicación recupera un resultado completado.
Replicate Explore es útil para este descubrimiento práctico, particularmente en la generación de imágenes, video y audio. Las páginas de los modelos pueden proporcionar ejemplos, definiciones de entrada, instrucciones de uso y precios junto con una ruta de ejecución alojada.
Prueba con tu propio material de origen
Para imagen a video, usa una imagen representativa de tu aplicación, no solo los ejemplos pulidos del modelo. Verifica la consistencia del sujeto, el movimiento, la composición y si la salida respeta el encargo. Para el habla, prueba nombres, puntuación y los idiomas que tus usuarios envían.
- Ventaja: Puedes experimentar sin configurar primero la inferencia local.
- Flexibilidad: Las implementaciones personalizadas pueden usar Cog, la herramienta de empaquetado de Replicate.
- Limitación: Los modelos publicados por la comunidad pueden diferir en mantenimiento, documentación y soporte.
Inspecciona si un listado es oficial y se mantiene activamente antes de construir sobre él. Lee también la unidad de facturación con atención, ya que el precio del modelo puede depender del tiempo de ejecución o de la salida generada en lugar de un cálculo de tokens al estilo de texto.
Replicate es una opción sólida cuando necesitas ver si un modelo generativo puede producir medios aceptables. Es menos útil como una única clasificación normalizada entre modalidades no relacionadas: un modelo de habla y un modelo de video necesitan diferentes criterios de aceptación.
6. Microsoft Foundry Models
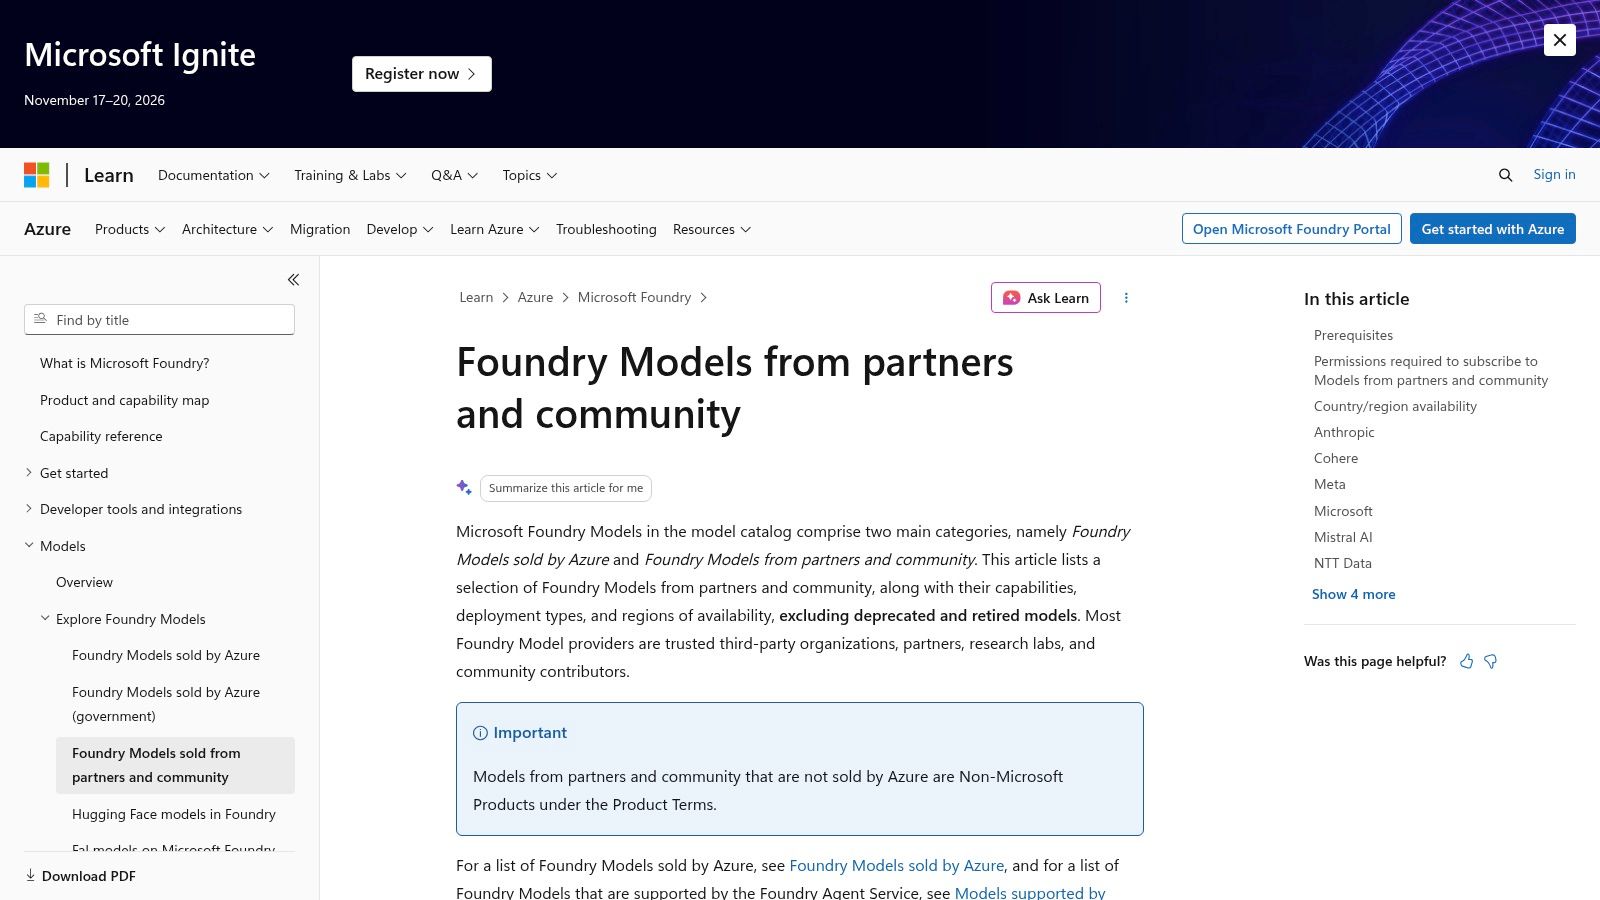
Para una aplicación basada en Azure, la elegibilidad de despliegue puede importar tanto como la capacidad del modelo. Un candidato prometedor no es útil si su método de despliegue disponible no se ajusta a tu arquitectura o región operativa.
Microsoft Foundry Models conecta el descubrimiento de modelos con el entorno de nube de Microsoft. El catálogo incluye ofertas de Microsoft, socios y la comunidad, con información relevante para tareas, capacidades, licencias y opciones de despliegue.
Elige la ruta de despliegue junto con el modelo
Los modelos elegibles pueden tener diferentes opciones API-based, batch, provisioned o managed-compute. No asumas que encontrar un modelo en el catálogo significa que cada enfoque de alojamiento y facturación está disponible para él.
- Ideal para: Equipos que necesitan que la selección de modelos se alinee con las decisiones de despliegue en Azure.
- Detalle útil: Información de despliegue específica del modelo y resultados de benchmark seleccionados.
- Restricción: La disponibilidad, los métodos de despliegue y el precio pueden variar según el modelo y la región.
Un equipo de análisis de documentos debería investigar tanto el soporte de entrada del modelo como la configuración del endpoint que desplegará. Probar un endpoint de demostración no es suficiente si la producción utilizará una disposición de servicio materialmente diferente.
El catálogo es, por lo tanto, un recurso de arquitectura además de una herramienta de descubrimiento. Úsalo cuando la integración con Azure sea un requisito real, no porque un modelo deseado aparezca allí por casualidad.
Para una exploración neutral de proveedores, una herramienta de comparación entre proveedores suele ser un punto de partida más claro. Vuelve a Foundry cuando estés listo para establecer la ruta práctica de despliegue en la nube.
7. Catálogo de modelos de Amazon Bedrock
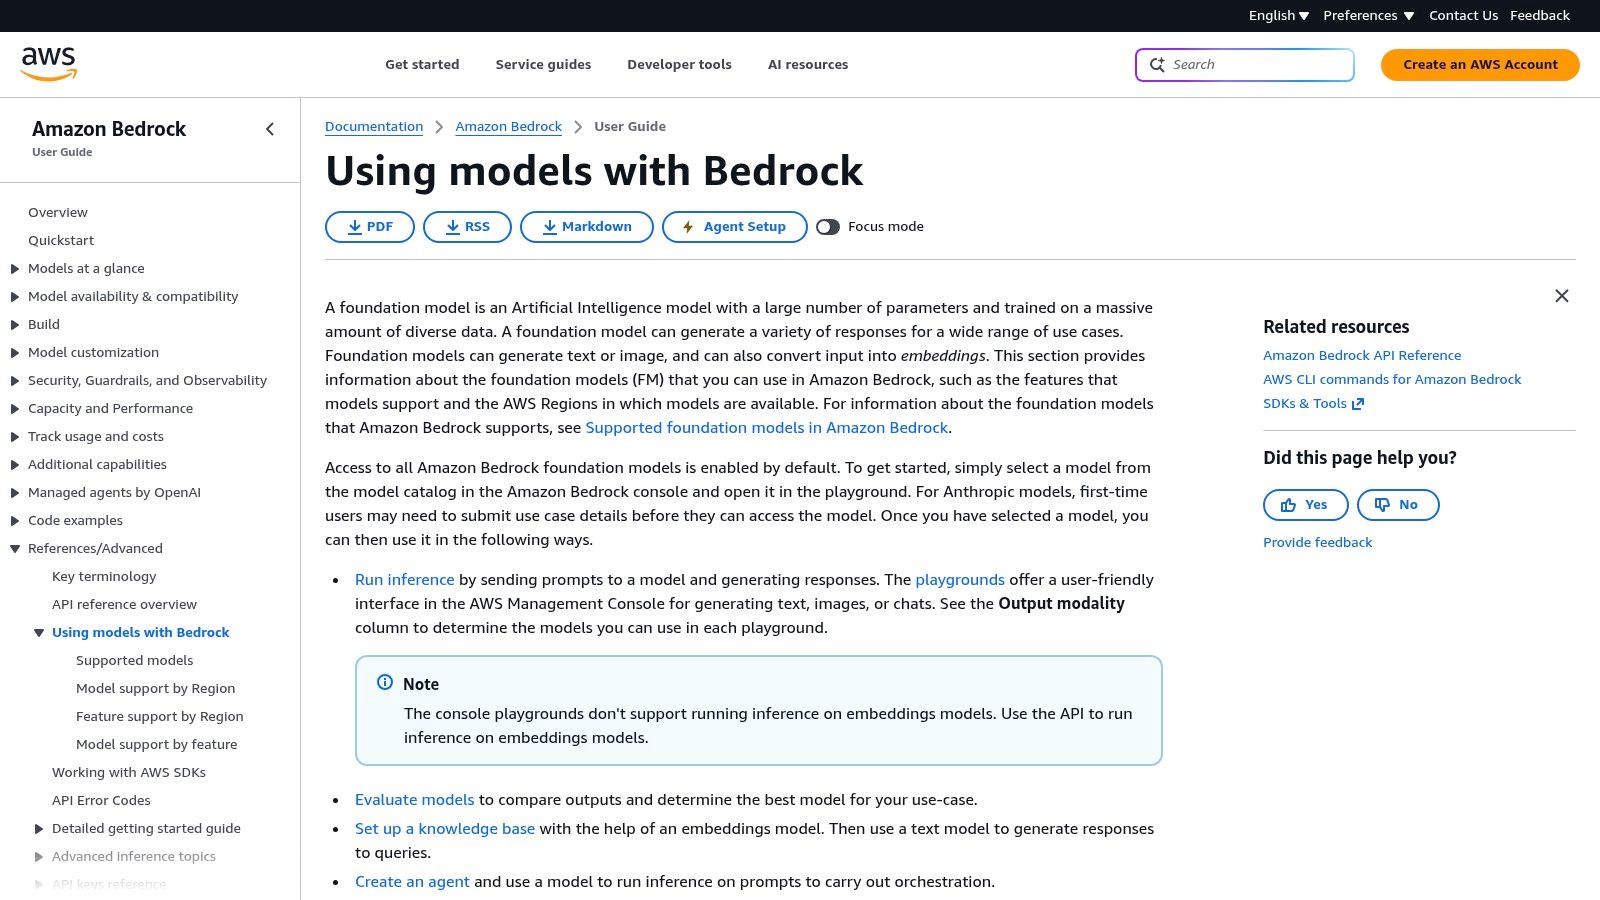
Verifique la disponibilidad regional antes de construir el prototipo. Ese es el hábito más útil al usar el catálogo de modelos de Amazon Bedrock para una aplicación de AWS.
El catálogo identifica los modelos fundacionales compatibles y sus capacidades. Los equipos pueden inspeccionar la disponibilidad regional y probar los modelos elegibles en el entorno de pruebas (playground) de la consola de Bedrock antes de integrarlos en una aplicación basada en AWS.
La adquisición y el acceso son parte de la elección
Bedrock es particularmente relevante cuando la aplicación ya opera dentro de la infraestructura de AWS. Sin embargo, la configuración de la cuenta y el acceso regional pueden afectar si el modelo que desea es utilizable en el entorno previsto.
- Lo que funciona: Pasar del descubrimiento de modelos compatibles a una implementación en AWS.
- Lo que hay que confirmar: Acceso a la cuenta, región prevista, entradas compatibles y requisitos de invocación.
- Lo que no es: Un inventario neutral de cada modelo de IA descargable o disponible comercialmente.
Para un asistente de soporte, pruebe los mismos pasajes de recuperación e instrucciones que planea enviar desde producción. El éxito en el entorno de pruebas (playground) establece que una solicitud puede funcionar; no establece que su retrieval pipeline, error handling y output parser sean correctos.
La fortaleza de Bedrock es su conexión con la pila de aplicaciones de AWS. Esa misma orientación es una limitación para los equipos que solo desean una visión general amplia de las opciones de modelos sin comprometerse con una integración específica de la nube.
Mantenga un registro del modelo exacto y la configuración de acceso utilizada en la evaluación. Un nombre de familia de modelo reconocible no es suficiente para reproducir una decisión de implementación.
8. Google Cloud Model Garden
Un equipo que desarrolle en Google Cloud debería evaluar el modelo y su configuración de servicio conjuntamente. Encontrar la familia de modelos adecuada es solo el principio; la configuración de despliegue determina cómo se adapta a la aplicación.
Google Cloud Model Garden ofrece descubrimiento de modelos de Google, de terceros y de código abierto dentro del entorno de IA de Google Cloud. Es más útil cuando el siguiente paso es el desarrollo basado en la nube, en lugar de descargar un modelo para un entorno de ejecución local no relacionado.
Separa el descubrimiento de las suposiciones de despliegue
Inspecciona la oferta individual antes de estimar el coste o el esfuerzo de implementación. La disponibilidad y el precio dependen del modelo, la región y la configuración del servicio, por lo que una entrada de catálogo por sí sola no establece la idoneidad para producción.
- Mejor uso: Explorar modelos para una aplicación de Google Cloud.
- Ventaja: Las ofertas de Google y de terceros seleccionados aparecen dentro del mismo flujo de trabajo de descubrimiento orientado a la nube.
- Limitación: Es menos conveniente para una investigación neutral de proveedores o experimentación offline.
Para un servicio de análisis de imágenes, confirma el formato de entrada aceptado y luego prueba el preprocesamiento exacto que realiza tu aplicación. El redimensionamiento, el recorte y la conversión de documentos pertenecen a la evaluación, no solo al despliegue final.
No confundas Model Garden con la lista más limitada de modelos de la API de Gemini. El primero ayuda con un descubrimiento más amplio de modelos en la nube; el segundo proporciona detalles propios para un ecosistema de API específico.
Usa Model Garden una vez que tu equipo sepa que Google Cloud forma parte del plan de despliegue. De lo contrario, empieza con los requisitos del modelo y evita que una consola de nube existente defina la lista corta prematuramente.
9. Biblioteca de Ollama
Si el requisito es ejecutar un modelo en tu propia máquina, empieza con un catálogo orientado al tiempo de ejecución en lugar de un mercado de API alojadas. La Biblioteca de Ollama ayuda a los usuarios a encontrar modelos, tamaños, variantes y capacidades compatibles para el flujo de trabajo local de Ollama.
El tamaño del modelo es un filtro inicial útil, pero no es una estimación completa del hardware. El uso del contexto, la sobrecarga del tiempo de ejecución y otras aplicaciones que compiten por la memoria también afectan si la configuración se ejecuta cómodamente.
Prueba la máquina real
Elige un candidato que se ajuste a tu hardware y luego pruébalo con longitudes de entrada representativas. Un modelo que maneja una instrucción de chat corta puede volverse impráctico cuando añades documentos recuperados o una conversación larga.
La discusión sobre la eficiencia del Índice de IA de Stanford informa que Phi-3-mini, con 3.8 mil millones de parámetros, alcanzó el mismo umbral MMLU declarado que anteriormente requería los 540 mil millones de parámetros de PaLM. Esa comparación respalda una lección práctica: el recuento de parámetros por sí solo no es una clasificación de calidad.
- Ventaja: Experimentación accesible con modelos ejecutables localmente.
- Distinción de costos: La ejecución local evita los cargos por uso de API alojadas, pero el hardware y la operación siguen costando dinero.
- Limitación: Tu máquina y los formatos compatibles restringen la lista de candidatos.
La ejecución local no es automáticamente un sistema completamente offline. Verifica si la recuperación, el registro (logging), las herramientas y otros componentes de la aplicación también permanecen locales.
Ollama es un punto de partida útil para prototipos offline y experimentos con restricciones de hardware. No elimina la necesidad de validar la calidad, el uso de memoria o la latencia de extremo a extremo.
10. Lista de modelos de la API de Google Gemini
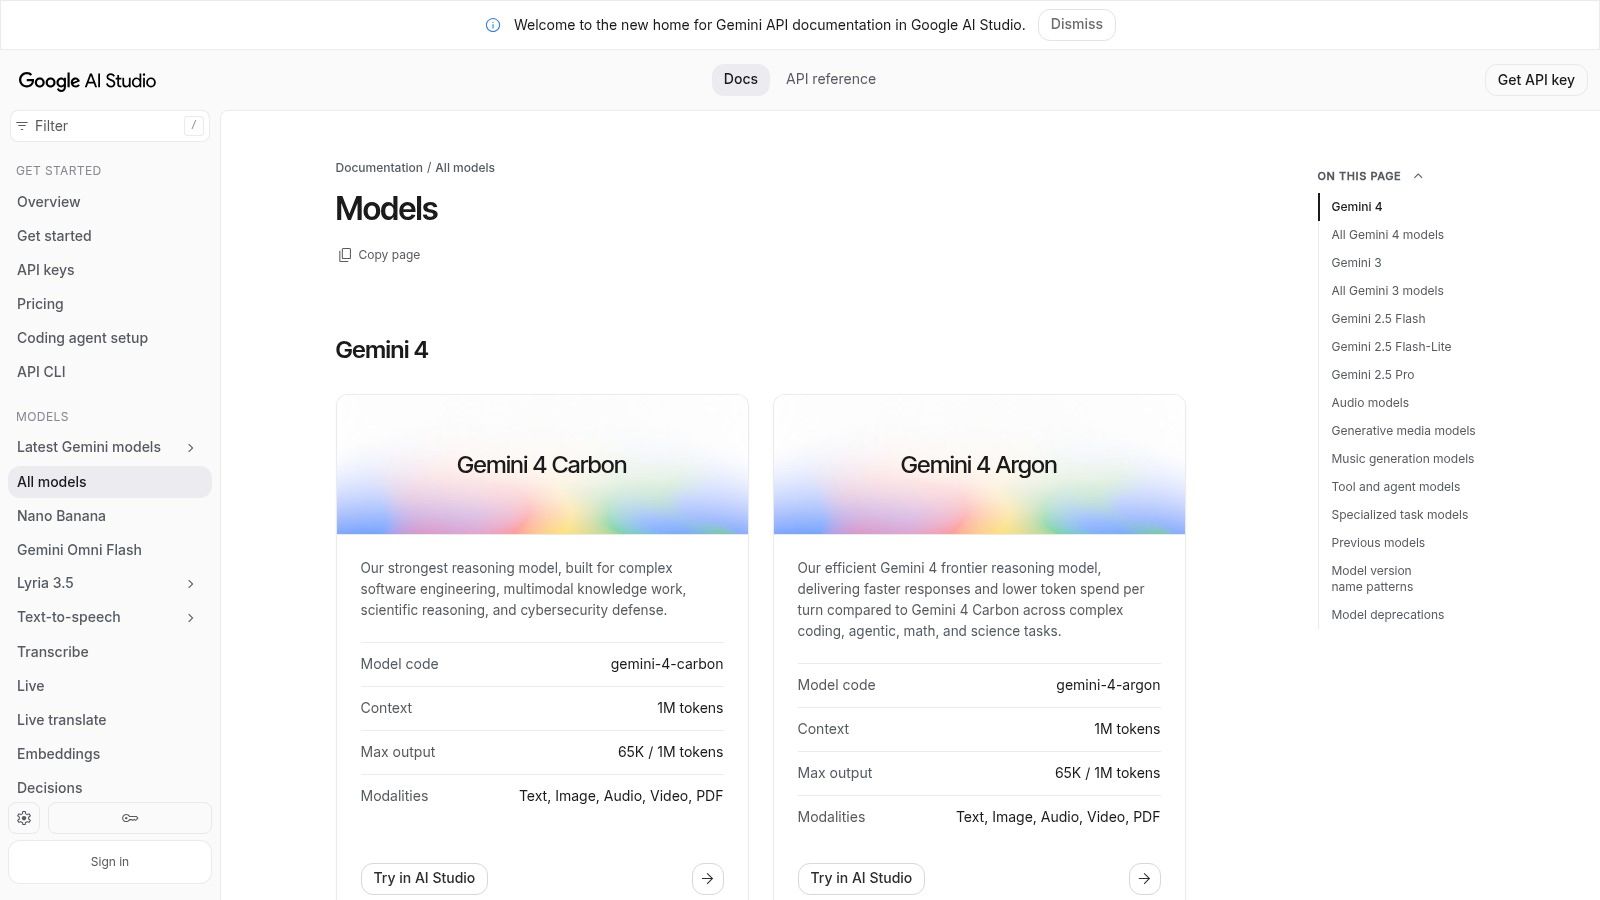
A veces, el camino correcto es el más estrecho. Si ya has elegido la API de Gemini, usa la lista oficial de modelos de la API de Gemini para confirmar los identificadores de modelo, las descripciones y las capacidades compatibles.
Esta es documentación de implementación de primera mano, no un servicio de comparación entre proveedores. Conecta el descubrimiento de modelos con la documentación de la API y Google AI Studio, lo que la hace útil cuando necesitas convertir una familia de modelos elegida en una solicitud funcional.
Verifica el identificador exacto
No desarrolles basándote en un nombre de familia de modelos copiado de un artículo de comparación. Confirma el identificador específico e inspecciona sus entradas, salidas y condiciones de acceso compatibles antes de integrar.
- Ventaja: Información directa del modelo para desarrolladores que usan la API de Gemini.
- Límite de alcance: No te ayudará a comparar todos los proveedores de la competencia.
- Advertencia comercial: Verifica el precio actual, el nivel de acceso y las condiciones de elegibilidad del modelo seleccionado.
Para una aplicación relacionada con audio, verifica si el modelo en particular es compatible con el flujo de trabajo de audio requerido en lugar de asumir que cada modelo de Gemini expone una funcionalidad idéntica. Aplica el mismo cuidado a las entradas multimodales y al uso de herramientas.
Mantén también las verificaciones del ciclo de vida en tu proceso de mantenimiento. La guía de cierre de la API de Veo y Gemini es relevante al revisar las dependencias de los endpoints y el trabajo de migración.
La lista oficial se utiliza mejor como referencia de implementación después de la preselección. Proporciona los detalles necesarios para realizar una solicitud válida, mientras que tu propia evaluación determina si los resultados devueltos cumplen con los requisitos del producto.
Cómo los 10 catálogos de modelos difieren por acceso, visibilidad de precios y límites
| Ítem | Ideal para | Modelo de acceso | Visibilidad de precios | Limitación principal |
|---|---|---|---|---|
| Catálogo de modelos de IA de UberLLM (Recomendado) | Comparar modelos de distintos proveedores | API unificada y marketplace | Precios en tiempo real listados | Los catálogos no predicen el rendimiento específico de la carga de trabajo |
| OpenRouter | Comparar y acceder a modelos de distintos proveedores | API alojada con una clave | Precios de modelos mostrados; verificar tarifas actuales | API alojada, no pesos de modelo descargables |
| Hugging Face Hub | Investigación, personalización y autoalojamiento | Descargas de modelos; el alojamiento varía | Precios no siempre listados | La calidad del modelo y la documentación varían |
| Artificial Analysis | Comparar benchmarks, costo y velocidad | Recurso de investigación y comparación; API de datos | Precios de API mostrados; algunos accesos pueden ser de pago | Los benchmarks pueden no reflejar tu carga de trabajo |
| Replicate Explore | Probar y ejecutar modelos generativos alojados | API de modelos alojados y despliegues personalizados | Precios específicos del modelo; pueden variar según el uso | La calidad y el soporte del modelo de la comunidad varían |
| Microsoft Foundry Models | Seleccionar modelos para aplicaciones de Azure | Opciones de despliegue de Azure | Varía según el modelo y la región | Más adecuado para usuarios de Azure |
| Amazon Bedrock model catalog | Encontrar modelos para aplicaciones de AWS | Servicios de Bedrock dentro de AWS | Varía según el modelo y la región | Acceso dependiente de AWS y la región |
| Google Cloud Model Garden | Encontrar modelos para despliegue en Google Cloud | Servicios de IA de Google Cloud | Varía según el modelo y la configuración | Orientado a Google Cloud |
| Ollama Library | Ejecutar modelos localmente | Inferencia local con Ollama | Sin precio de alojamiento; usa tu hardware | Requiere configuración y hardware adecuado |
| Google Gemini API model list | Construir con modelos de Google | API de Gemini y Google AI Studio | Página de precios separada; los niveles varían | Cubre solo modelos de Google |
Transforma una lista corta en una integración funcional
Deja de buscar una vez que tengas dos o tres modelos plausibles por modalidad. Más candidatos no ayudan si tu equipo no ha definido cómo es un resultado aceptable. Anota la longitud de contexto requerida, los límites de salida, el soporte de herramientas, los formatos de entrada y las restricciones de despliegue antes de ejecutar las comparaciones.
Luego, envía los mismos prompts o tareas de generación a cada candidato. Para la extracción de texto, valida el esquema devuelto y compara los valores extraídos con las respuestas esperadas. Para la codificación, ejecuta pruebas sobre los cambios generados; para los medios, revisa las salidas según un brief consistente en lugar de elegir la muestra que parezca más impresionante.
Evalúa la ruta completa de la aplicación
Incluye el trabajo que rodea la inferencia. La conversión de documentos, la recuperación, la ejecución de herramientas, el sondeo, los reintentos y la validación de la salida pueden determinar si un modelo, por lo demás capaz, es utilizable.
- Calidad: Registra los resultados aceptados, no solo las solicitudes completadas.
- Latencia: Mide tanto la respuesta inicial como la finalización de extremo a extremo cuando sea relevante.
- Costo: Incluye los reintentos, las generaciones rechazadas y las llamadas de seguimiento necesarias.
- Fiabilidad: Prueba los tiempos de espera, las salidas mal formadas y los endpoints no disponibles.
La discusión de Brookings sobre la evaluación de modelos de IA explica por qué las puntuaciones de los benchmarks pueden omitir preocupaciones prácticas como la latency, los compute requirements, el cost y la safety. Tu evaluación debe hacer explícitas esas preocupaciones en lugar de tratar una public leaderboard como una production acceptance test.
Para los equipos que desean un único endpoint para flujos de trabajo de texto, imagen, video y audio, inicia la integración de UberLLM configurando la base URL en tu configuración de SDK existente de OpenAI o Anthropic al API endpoint compatible. Usa una clave de UberLLM y conserva la interfaz de SDK existente y el código circundante, luego cambia de candidato modificando el model identifier. Valida los parámetros soportados por cada candidato y utiliza el flujo de trabajo de tareas asíncronas apropiado para medios en lugar de asumir que cada modalidad se comporta como una respuesta de chat en streaming.
Mantén la decisión reproducible
Almacena el model identifier, la prompt version, la generation settings, las evaluation inputs y los acceptance results juntos. Ese registro permite a otro ingeniero repetir la prueba y facilita la evaluación de cambios posteriores en el modelo. Evita depender de una captura de pantalla sin versión o de una impresión recordada de la calidad de la salida.
Elige un modelo predeterminado y define cuándo la aplicación debe escalar o fallar de forma segura. Un fallback solo es útil si cumple los mismos requisitos esenciales, incluyendo las restricciones de privacidad y el soporte de herramientas. La mejor lista de modelos de IA es la que te ayuda a tomar una decisión de integración defendible y luego da paso a pruebas repetibles.
UberLLM conecta a los desarrolladores con modelos de texto, imagen, video, música y voz de terceros a través de una API unificada y un saldo prepago. Visita UberLLM para comparar los límites de los modelos y los precios en vivo, probar tu lista corta en el playground e integrar los candidatos que cumplan con los requisitos de tu aplicación.