Modelos de Texto a Voz: Capacidades y Guía de Selección
Explore modelos de texto a voz según la entrada, salida, clonación de voz, métricas de calidad y reglas de consentimiento, con tablas y una lista de verificación de selección para 2026.
Las voces neuronales y generadas por IA representaron 67.90% de los ingresos del mercado de text-to-speech en 2024, según el informe de tendencias de la industria de Sonix. Eso mide los ingresos, no la fiabilidad. Para un desarrollador que elige modelos de text-to-speech, la pregunta más difícil es si una voz puede transmitir los nombres, códigos, instrucciones y diálogos emocionales que una aplicación envía.
Una demostración agradable no responde a esa pregunta. Trata la selección del modelo como un contrato de input-and-output, seguido de una evaluación con texto de producción. La arquitectura, la similitud de la voz y la naturalidad promedio importan, pero ninguna debería anular un fallo que cambie lo que el oyente entiende.
Tabla de Contenidos
- Capacidades, Entradas y Salidas de un Vistazo
- Familias de Arquitectura y lo que Significan
- Clonación de Voz, Escala y Cobertura de Idiomas
- Métricas de Calidad que van Más Allá del MOS
- Construyendo un Conjunto de Pruebas para Texto Difícil
- Emparejando Modelos con tu Caso de Uso
- Consentimiento, Divulgación y Uso Seguro de la Voz
- APIs Alojadas o Modelos Abiertos Autoalojados
- Preselecciona, Prueba y Aprueba
Capacidades, Entradas y Salidas de un Vistazo
| Capacidad | Entrada típica | Salida típica | Úsala cuando |
|---|---|---|---|
| TTS estándar | Texto sin formato | Archivo o flujo de audio | Necesites narración a partir de texto fijo o proporcionado por el usuario |
| TTS en streaming | Fragmentos de texto a medida que se generan | Fragmentos de audio en orden de reproducción | El audio debe empezar antes de que el texto completo esté listo |
| TTS controlado por marcado o estilo | Texto con SSML o etiquetas de estilo | Audio con pausas, énfasis o emoción definidos | La pronunciación y el ritmo deben controlarse |
| Clonación de voz | Texto más audio de referencia con consentimiento documentado | Audio con la voz del hablante de referencia | Debe reproducirse la voz de una marca o un usuario |
| TTS multilingüe | Texto en varios idiomas | Audio en cada idioma, con una o varias voces | Un producto sirve a usuarios en muchos idiomas |
TTS estándar es el contrato más sencillo: envía texto y recibe voz. Úsalo para narraciones preparadas, notificaciones y pasajes cuya redacción ya esté completa. Un archivo descargable es adecuado para la edición y el almacenamiento en caché; una respuesta en streaming puede evitar la espera del archivo de audio completo.
TTS en streaming requiere una inspección más detallada. Algunos servicios transmiten audio después de recibir una entrada de texto completa, mientras que otros también aceptan texto incremental. Si un asistente genera su respuesta progresivamente, confirma que la interfaz soporta esto último en lugar de asumir que el streaming significa ambas direcciones.
Síntesis controlada por marcado añade instrucciones de entrega. SSML, los controles de pronunciación y las etiquetas de estilo propietarias no son intercambiables, así que prueba la sintaxis exacta que acepta tu modelo seleccionado. Las instrucciones no soportadas podrían ser ignoradas, rechazadas o pronunciadas en voz alta.
La clonación añade una entrada de hablante de referencia, mientras que la síntesis multilingüe añade cobertura de idiomas. Ninguna incluye automáticamente a la otra: una voz preestablecida multilingüe no es necesariamente clonable, y una voz clonada no es necesariamente fiable en todos los idiomas soportados.
Elige el Contrato de Audio Antes de la Voz
WAV es un contenedor; PCM describe una representación de audio. PCM sin comprimir, a menudo empaquetado en WAV, es conveniente para la edición y el procesamiento. Las tuberías de telefonía necesitan la codificación, la configuración de canales y la frecuencia de muestreo que esperan sus sistemas posteriores, no solo un archivo con una extensión familiar.
MP3 y Opus son opciones de entrega comprimidas para navegadores y aplicaciones, sujetas al soporte del cliente. Selecciona un formato que tu reproductor pueda decodificar sin una etapa de conversión adicional. De lo contrario, el rendimiento de síntesis medido no describirá el retraso que experimentan los usuarios.
Frecuencia de muestreo especifica con qué frecuencia se muestrea el audio. Afecta al rango de frecuencia representado y, para audio sin comprimir con otros ajustes fijos, al tamaño del archivo. Aumentar la frecuencia de muestreo de salida no repara la pronunciación poco clara ni restaura detalles que el modelo nunca generó.
Antes de la integración, anota el contrato:
- Restricciones de entrada: Longitud de texto aceptada, marcado soportado y comportamiento de entrada incremental.
- Disponibilidad de voz: Idiomas requeridos, dialectos, voces preestablecidas y acceso a voces personalizadas.
- Requisitos de salida: Codificación, frecuencia de muestreo, canales y comportamiento de streaming.
- Comportamiento ante fallos: Cómo la aplicación maneja el texto rechazado, los flujos interrumpidos y las voces no disponibles.
Lee la tabla de izquierda a derecha: haz coincidir la entrada que tienes con la salida que necesitas, luego verifica si el caso de uso encaja. Una voz que suena excelente pero requiere un patrón de interacción incorrecto queda fuera de la lista de preseleccionados.
Familias de Arquitectura y lo que Significan
| Familia | Cómo genera el habla | Principal compromiso |
|---|---|---|
| Concatenativa | Une unidades de habla pregrabadas | Natural dentro del dominio grabado, débil fuera de él |
| Paramétrica estadística | Predice características acústicas, luego un vocoder renderiza el audio | Flexible, pero a menudo amortiguada |
| De forma de onda neuronal | Genera muestras de audio con una red neuronal | Alta naturalidad, computacionalmente pesada sin optimización |
| Neuronal basada en tokens | Predice códigos de audio discretos a partir de texto | Escala bien con los datos, necesita un control cuidadoso del estilo y el hablante |
Las amplias distinciones de pipeline se ilustran a continuación.
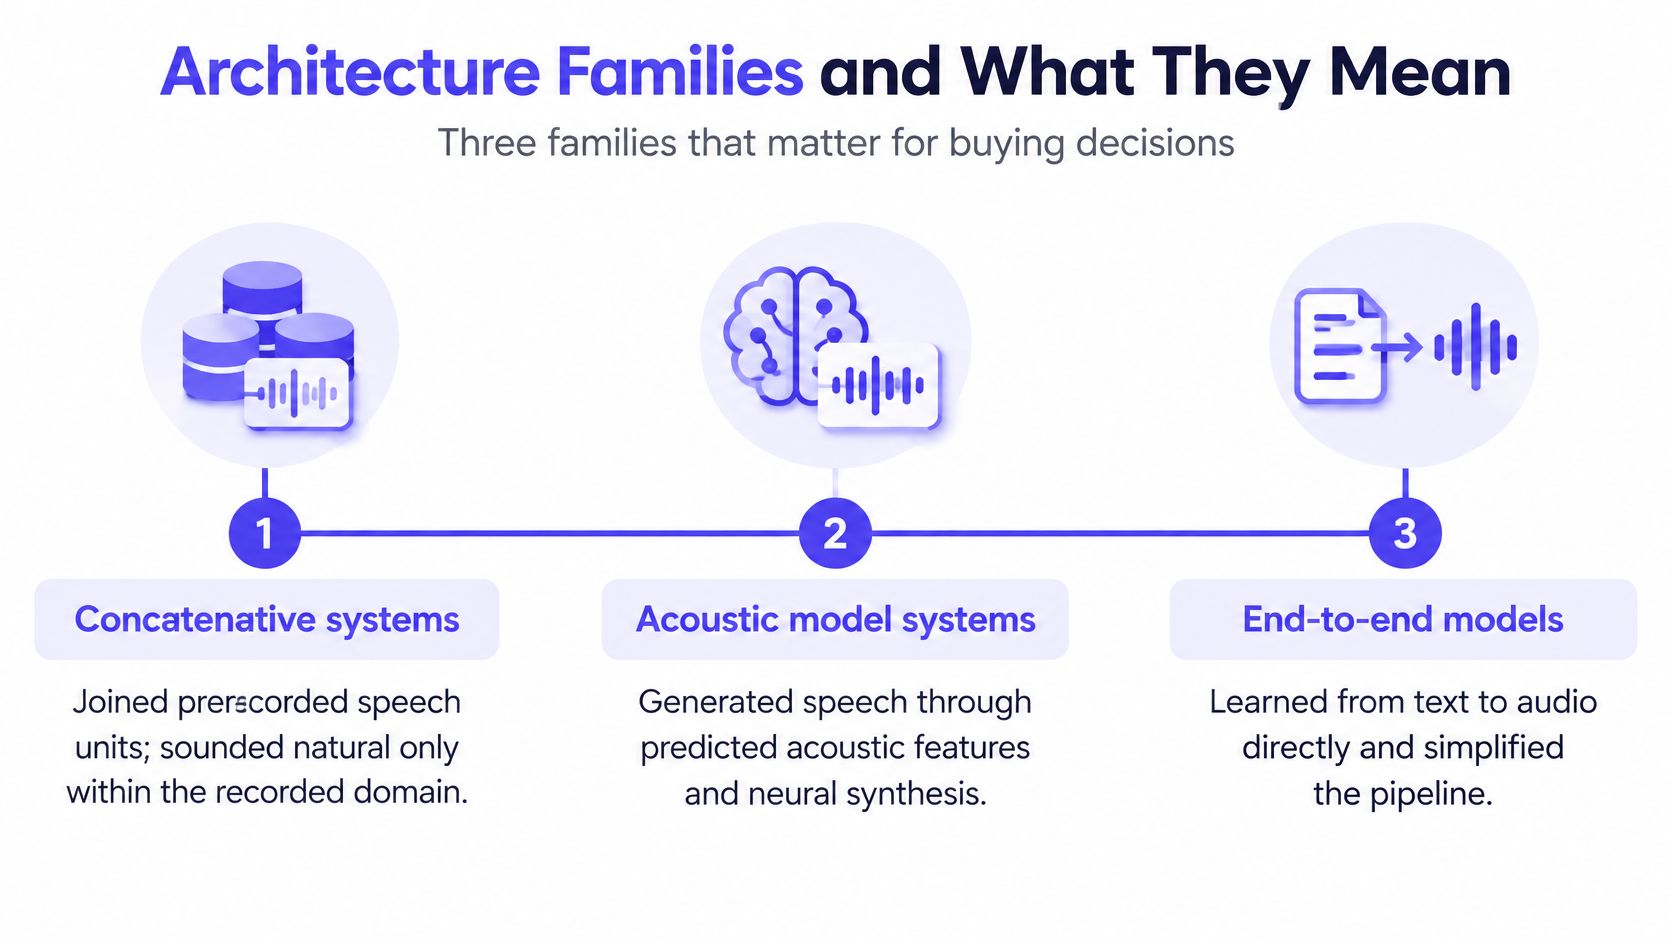
Los sistemas concatenativos ensamblan unidades grabadas, por lo que su flexibilidad está limitada por las grabaciones disponibles y las uniones entre ellas. Los sistemas paramétricos estadísticos, en cambio, predicen propiedades acústicas y luego renderizan el habla a través de un vocoder, intercambiando la reutilización directa de grabaciones por un pipeline de síntesis más controlable.
Un hito llegó con WaveNet en 2016: el artículo de WaveNet informó una reducción de más de 50% en la brecha de calidad entre los sistemas TTS existentes más potentes y el habla humana en sus evaluaciones de inglés estadounidense y chino mandarín. Ese hallazgo estableció la importancia de la generación de formas de onda neuronales, no una garantía de rendimiento universal para cada modelo neuronal posterior.
Los sistemas neuronales basados en tokens predicen representaciones de audio discretas que un decodificador convierte en sonido. Para las decisiones de compra, distinga esta representación de la interfaz del servicio: un producto de extremo a extremo aún puede contener varias etapas de procesamiento internas.
Lea las Tarjetas de Modelo como Descripciones de Pipeline
Busque spectrogram, vocoder, codec, audio tokens y detalles de acondicionamiento del hablante. Una etapa de spectrogram seguida de un vocoder sugiere un pipeline de modelo acústico; los códigos de audio discretos sugieren una generación basada en tokens. Las descripciones de entrenamiento ayudan a explicar el diseño, pero no reemplazan las pruebas de salida.
Para dispositivos con restricciones, compare la memoria real, el tiempo de ejecución (runtime) y la compatibilidad de hardware en lugar de asumir que lo antiguo significa más pequeño o lo nuevo significa solo en la nube (cloud-only). En implementaciones alojadas (hosted deployment), inspeccione la latencia entregada y los controles en lugar de inferirlos de la etiqueta de arquitectura.
El límite también importa para tareas adyacentes. Una guía de síntesis de voz cantada aborda un problema de control diferente: la prosodia hablada no es un sustituto del tempo y el tono musical explícitos.
Regla práctica: Use la arquitectura para comprender las posibles restricciones y las preguntas de diagnóstico útiles, no para declarar un ganador antes de escuchar.
Clonación de voz, escala y cobertura de idiomas
La clonación de voz separa la identidad del hablante de las palabras que se pronuncian. Evalúa esas dimensiones de forma independiente: una salida puede parecerse al hablante de referencia mientras pronuncia la frase con una emoción inadecuada.
Las principales rutas de clonación difieren en cómo establecen esa identidad.
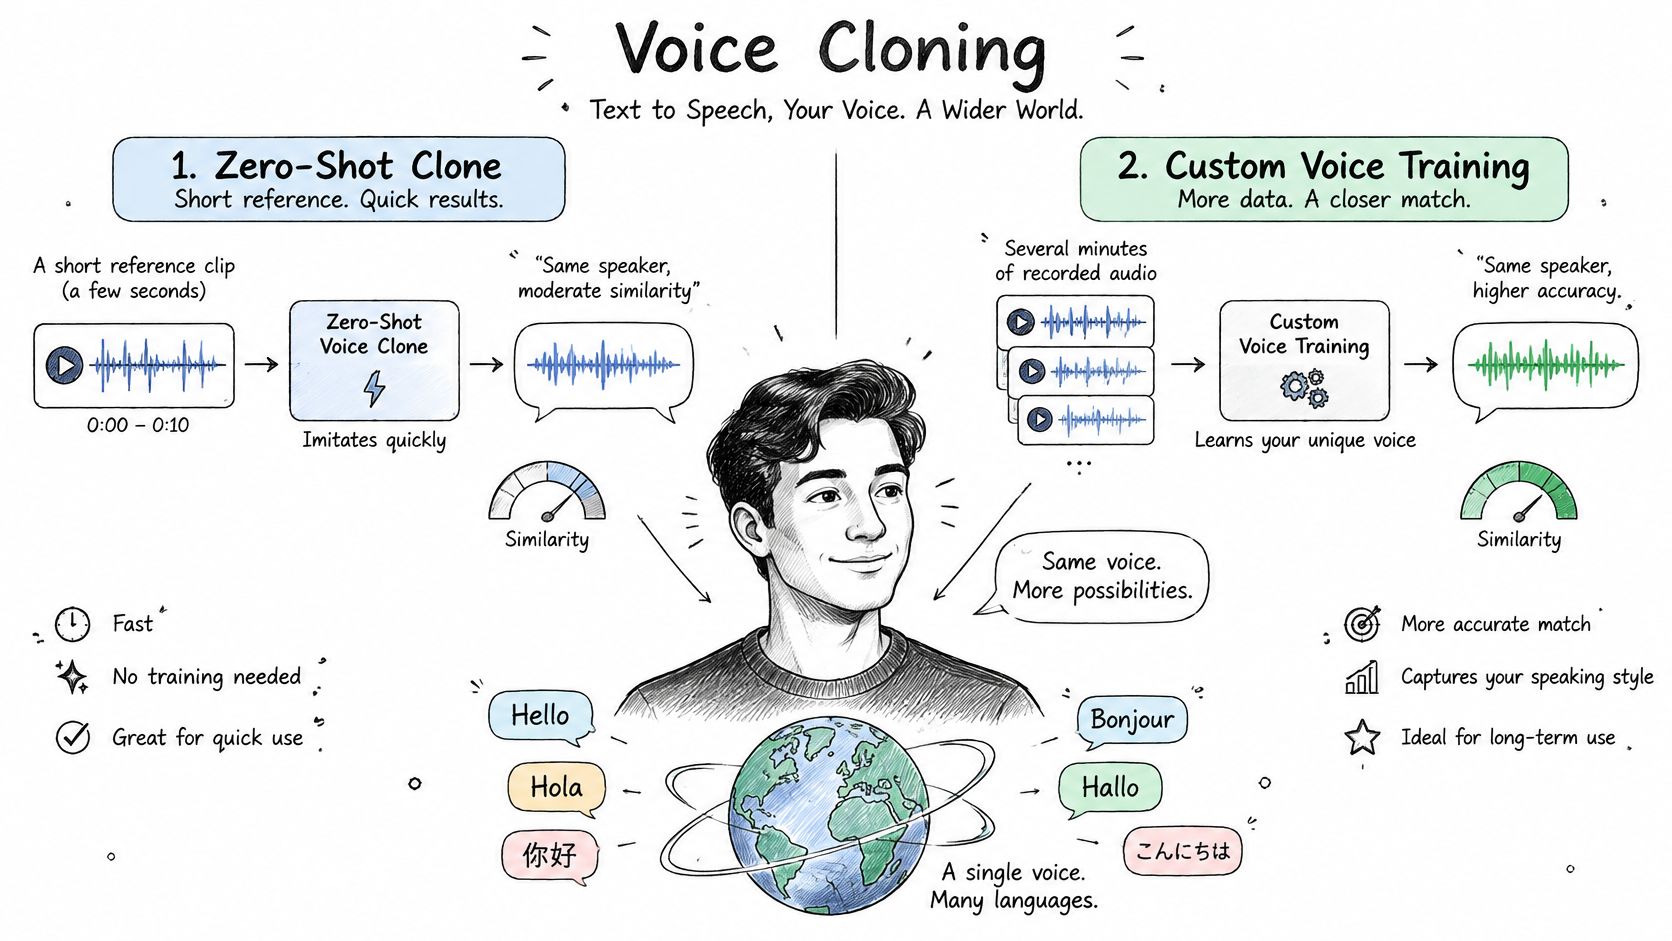
La clonación zero-shot condiciona la síntesis a un audio de referencia sin un trabajo de entrenamiento específico para el hablante. El entrenamiento de voces personalizadas adapta un modelo usando un conjunto de datos de hablante preparado. La primera reduce el trabajo de configuración; la segunda añade requisitos de grabación, preparación y entrenamiento, sin hacer que la similitud sea automática.
La calidad de la referencia merece una prueba propia. El ruido de fondo, las voces superpuestas, la colocación inconsistente del micrófono y estilos de locución muy diferentes pueden dificultar determinar qué debería conservar el sistema. Compara referencias limpias antes de atribuir por completo un resultado débil al modelo de síntesis.
Separa la similitud de la interpretación
Considera una comparación hipotética entre una referencia corta y neutra y una referencia más larga que contiene varias interpretaciones emocionales. Genera la misma frase de marketing animada a partir de cada una. Pregunta a quienes escuchan, por separado, si el hablante suena reconocible y si la interpretación animada suena adecuada.
No des por hecho que la referencia más larga tiene que ganar. Contiene más material, pero también introduce más variación; la pregunta útil es si el modelo conserva la identidad mientras sigue la interpretación solicitada.
Para una introducción audiovisual al tema, el siguiente video ofrece otro formato de visualización.
La escala aporta contexto, no una aprobación final. En su cobertura de 2024, TechCrunch informó de que BASE-large usó 100,000 horas de habla de dominio público para el entrenamiento y contenía 980 millones de parámetros. Esos totales no establecen cómo se comportará un acento, un hablante o un idioma en particular.
Cuando examines un listado de modelos TTS multilingües, convierte la capacidad anunciada en comprobaciones de aceptación concretas:
- Cobertura de idiomas: Evalúa cada idioma y dialecto requeridos con oyentes con fluidez.
- Estabilidad de la identidad: Compara al hablante en preguntas, afirmaciones y diálogos expresivos.
- Preparación para alternativas: Identifica una voz predefinida aprobada para clones no disponibles o no adecuados.
- Procedencia de la referencia: Conserva el identificador de la grabación y su registro de permisos asociado.
Una voz reconocible solo es útil cuando su interpretación sigue siendo comprensible y adecuada en los mensajes reales del producto.
Métricas de Calidad que Van Más Allá de MOS
Un benchmark puede ser reproducible sin ser representativo. El conjunto de datos LJSpeech contiene 13,100 clips que suman aproximadamente 24 horas, grabados por una única narradora de habla inglesa. Eso es útil para comparaciones controladas, pero el éxito dentro de ese ámbito no establece un rendimiento más amplio entre diferentes hablantes, acentos o estilos conversacionales.
La Puntuación Media de Opinión, o MOS, mide la calidad percibida según la valoración de los oyentes. Mantén las frases y las condiciones de escucha consistentes entre los modelos, oculta las identidades de los modelos y define la pregunta de valoración claramente. Un panel al que se le pregunta sobre la agradabilidad no está necesariamente evaluando si un código de producto se pronunció correctamente.
| Métrica | Qué mide | Cómo medirlo | Límite principal |
|---|---|---|---|
| MOS | Calidad percibida en una escala de escucha de deficiente a excelente | Un panel de escucha valora las mismas frases de cada modelo | No aísla errores de pronunciación o ritmo sin preguntas específicas |
| Inteligibilidad | Si los oyentes pueden reconocer las palabras | Transcribe la salida con un speech recognizer y compara con el texto previsto | Los errores del recognizer pueden ocultar errores de síntesis |
| Tiempo hasta el primer audio | Retraso antes de que el audio utilizable llegue o se reproduzca | Marca de tiempo del envío de la solicitud, la recepción del primer audio y la reproducción por separado | No dice nada sobre la calidad del habla |
| Factor en tiempo real | Tiempo de síntesis dividido por la duración del audio | Mide el tiempo de generación y divide por la duración de la salida | Cambia con el hardware, la carga y los límites de medición |
| Reproducibilidad | Consistencia en ejecuciones y versiones repetidas | Fija la configuración y los seeds expuestos, luego vuelve a ejecutar y compara | Algunos servicios no exponen seeds o version pins |
Define qué Incluye tu Cronómetro
Para el streaming, distingue el primer audio recibido de la primera reproducción audible. La transferencia de red, la decodificación y el buffering del reproductor pertenecen a la experiencia del usuario, incluso si ocurren fuera de la inferencia del modelo. Registra ambos al diagnosticar el retraso.
Para las pruebas de inteligibilidad, compara el habla reconocida con la forma hablada prevista, no ciegamente con los caracteres de entrada sin procesar. Una fecha hablada aceptable no coincidirá carácter por carácter con su notación escrita. Revisa manualmente los errores que involucren nombres, números y símbolos antes de tratar el recognizer como verdad absoluta.
Un promedio de calidad es la descripción de una prueba. No es un criterio de aceptación hasta que defines qué errores puede tolerar el producto.
Combina las comprobaciones automatizadas con la escucha. Las mediciones de tono por sí solas no describen el ritmo, el estrés o la intensidad, y las diferencias en la forma de onda no significan necesariamente que los oyentes perciban un cambio significativo.
Informa MOS, inteligibilidad, tiempo hasta el primer audio y factor en tiempo real conjuntamente. Incluye la versión del modelo, el entorno de ejecución, la configuración de la solicitud y los límites de medición para que otro ingeniero pueda interpretar el resultado.
Creación de un conjunto de pruebas para texto difícil
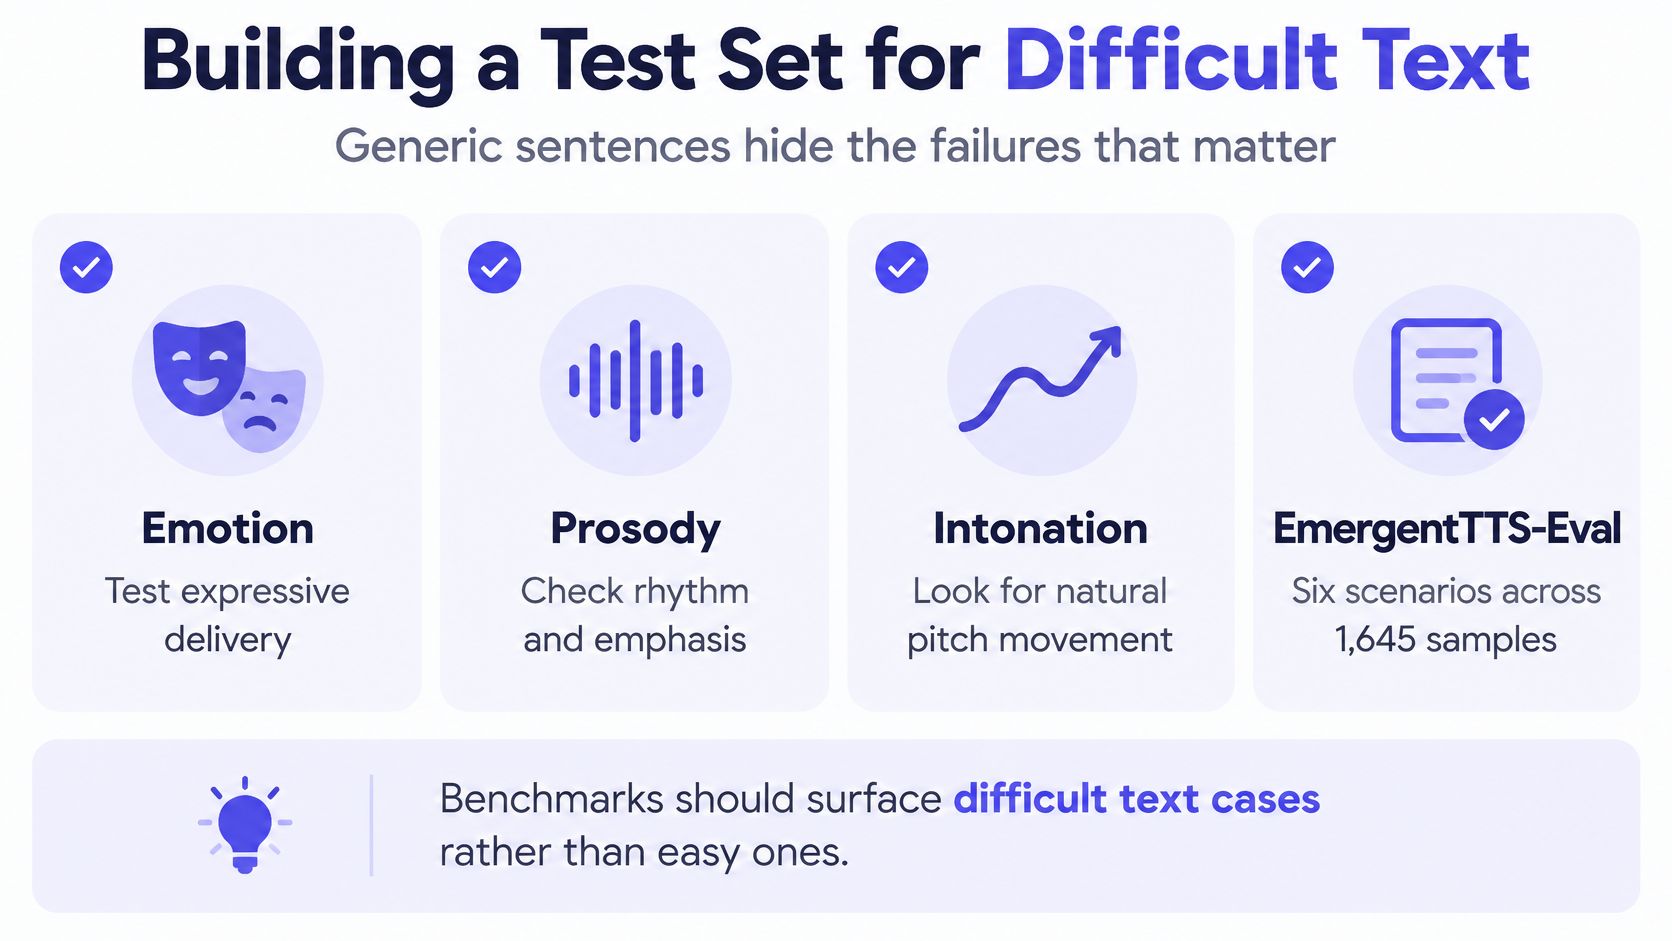
Las frases genéricas dan lugar a pruebas de aceptación débiles porque omiten el texto que requiere interpretación. EmergentTTS-Eval evalúa seis escenarios en 1,645 muestras, cubriendo emoción, prosodia, entonación y pronunciación; sus autores reportan una fuerte correlación entre la evaluación basada en modelos y las preferencias humanas.
Utiliza este enfoque más amplio sin tratar un benchmark externo como el conjunto de pruebas de tu producto. Tu aplicación tiene su propio vocabulario, formato y consecuencias para los errores.
Las categorías de evaluación a continuación ayudan a exponer fallos que los pasajes de lectura fácil no revelarían.
Incluye texto que cambia de significado al ser malinterpretado
- Nombres y ubicaciones: Nombres de productos, marcas, nombres personales, direcciones y códigos postales.
- Identificadores compactos: Acrónimos, referencias de cuenta, códigos de producto y abreviaturas ambiguas.
- Notación estructurada: Fechas, horas, URLs, fragmentos de código y fórmulas matemáticas.
- Cambios de idioma: Palabras extranjeras y pasajes en idiomas mezclados.
- Intención conversacional: Preguntas, tranquilidad, urgencia, desacuerdo y diálogo con carga emocional.
- Señales no verbales: Risas, suspiros y otras instrucciones de rendimiento compatibles.
Para cada elemento, registra la lectura prevista. Un código podría requerir el deletreo carácter por carácter, mientras que un acrónimo podría necesitar pronunciación como una palabra. Sin esa anotación, los oyentes pueden no estar de acuerdo sobre la corrección incluso cuando escuchan la misma salida.
Realiza una comparación repetible
- Recopila texto representativo. Extrae y anonimiza ejemplos de producción, luego etiquétalos por categoría. Incluye entradas poco comunes cuyo fallo tendría graves consecuencias.
- Genera salidas comparables. Mantén el formato, el rol de voz y las instrucciones de entrega equivalentes siempre que sea posible. Guarda la solicitud exacta y el identificador del modelo.
- Usa oyentes consistentes. Pide al mismo panel que evalúe la inteligibilidad, la pronunciación y la adecuación prosódica por separado. Mezcla el orden de los modelos.
- Captura el rendimiento por elemento. Registra el tiempo del primer audio y el factor en tiempo real junto con el texto asociado, en lugar de mantener solo un promedio por lote.
- Repite después de los cambios. Conserva una línea base aprobada e investiga las regresiones cuando cambie un proveedor, una configuración de voz o una regla de preprocesamiento.
Imagina que un mensaje de soporte contiene el apellido de un cliente y una fecha de cita. Una frase bellamente entregada que se equivoca en cualquiera de los dos debería perder frente a una alternativa menos expresiva pero precisa.
Reporta las tasas de fallo por categoría y gravedad. Una puntuación agregada puede ocultar la clase de error que debería bloquear la implementación.
Cómo elegir el modelo adecuado para tu caso de uso
| Caso de uso | Criterios más importantes | Qué probar primero |
|---|---|---|
| Mensajes de voz para atención al cliente | Tiempo hasta el primer audio, pronunciación de nombres y códigos de producto | Un mensaje realista que contenga un nombre y un código a través de la ruta de reproducción telefónica |
| Narración de audiolibros de formato largo | Prosodia entre párrafos, estabilidad en pasajes largos | Coherencia en un pasaje extendido con diálogos y cambios de escena |
| Accesibilidad y lectores de pantalla | Inteligibilidad, control fiable de la velocidad de habla | Claridad a la velocidad más rápida que los usuarios probablemente elijan |
| Doblaje de vídeo y medios | Rango emocional, sincronización con clips de referencia | Alineación con la duración y emoción del clip de referencia |
| Educación y formación | Pronunciación de términos técnicos, fórmulas y palabras extranjeras | Fórmulas, acrónimos y nombres extranjeros del material del curso |
La característica más potente de un modelo solo importa si es compatible con la tarea. La siguiente comparación ilustra las diferentes prioridades.
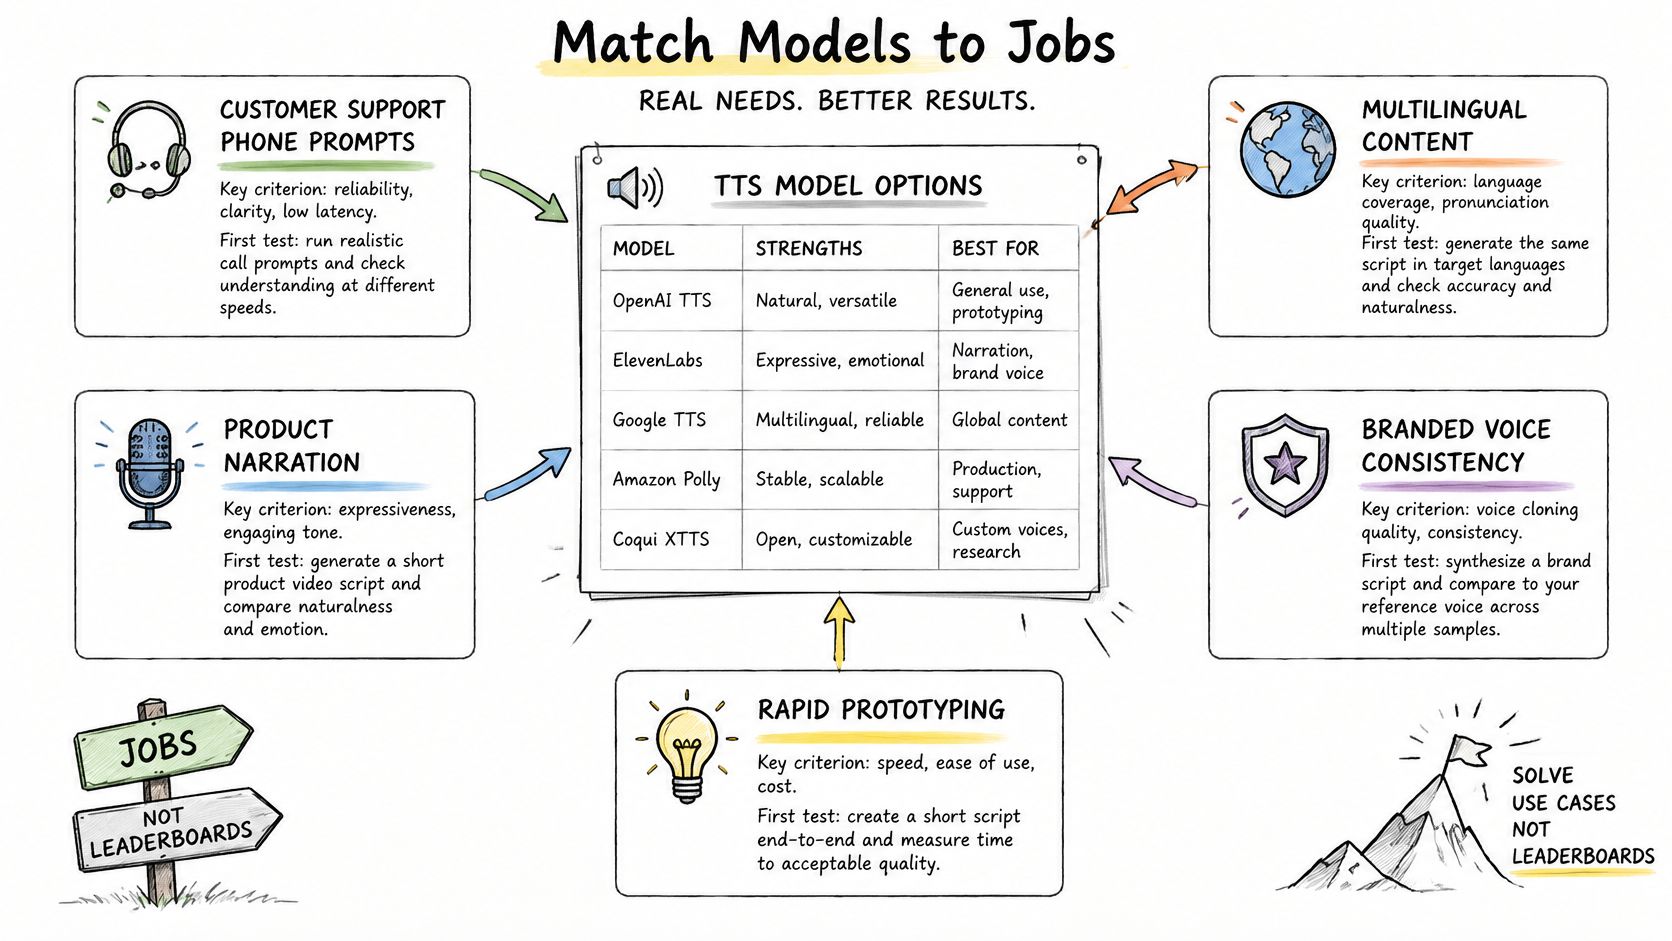
Para la atención al cliente, prueba la ruta telefónica real en lugar de revisar solo descargas con calidad de estudio. Para los audiolibros, escucha a través de los límites de los párrafos, los cambios de orador y la generación reanudada, porque las oraciones aisladas no ejercitan la continuidad.
La evaluación de accesibilidad debe incluir a las personas que usarán el resultado y sus controles de reproducción preferidos. El doblaje necesita una interpretación de referencia y restricciones de tiempo; la educación necesita una revisión del contenido por parte de expertos sobre la notación hablada prevista.
Aplica requisitos estrictos antes que preferencias
Si la latencia define la interacción, exige una interfaz de streaming adecuada antes de clasificar las voces. Una respuesta retrasada puede hacer que el diseño de la interacción falle, independientemente de su calidad final.
Si una identidad de orador específica es obligatoria, establece el permiso antes de crear clones de evaluación. No hagas de la autorización una preocupación solo de producción después de que el equipo se encariñe con una voz.
Si los códigos y las fechas transmiten el mensaje, prioriza su lectura correcta sobre la agradabilidad. Trata los errores críticos de pronunciación como bloqueadores en lugar de dejar que las altas puntuaciones de estilo los compensen.
Principio de selección: Clasifica los modelos aceptables después de aplicar los requisitos estrictos. No promedies un fallo descalificador en una puntuación que de otro modo sería atractiva.
Escribe esos requisitos antes de revisar los resultados. Por ejemplo, un narrador de cursos puede necesitar un vocabulario técnico fiable pero no streaming conversacional, mientras que un asistente de voz puede necesitar entrada de texto incremental pero no clonación. Esa distinción reduce la comparación sin depender de una clasificación universal.
Consentimiento, Divulgación y Uso Seguro de la Voz
La clonación de voz es una decisión de gobernanza, no solo una configuración de síntesis. La guía de TTS responsable describe la clasificación de la FCC de las voces de robocall generadas por IA como voces artificiales bajo la Ley de Protección al Consumidor Telefónico, lo que hace que las llamadas cubiertas sin el consentimiento previo requerido sean ilegales. No interpretes esto como una prohibición general de la narración sintética o como un permiso para cada uso que no sea de robocall.
La narración sintética ordinaria y la clonación que preserva la identidad requieren un escrutinio operativo diferente. Seleccionar una voz preestablecida con licencia no establece el derecho a imitar a una persona identificable. Para voces personalizadas, el permiso documentado del hablante debe ser un requisito de implementación.
Incorpora Controles en la Ruta de Solicitud
- Registra el permiso del hablante: Mantén el propósito autorizado, los canales permitidos, el alcance de uso y las condiciones de caducidad o revisión junto con el registro de voz.
- Rechaza la imitación no autorizada: Prohíbe la clonación de personas identificables sin permiso escrito y proporciona una forma de suspender voces en disputa.
- Aplica las reglas de divulgación: Etiqueta el habla sintética cuando la ley aplicable, la política de la plataforma o el contexto lo requieran.
- Preserva la auditabilidad: Registra el identificador del modelo, el identificador de voz, la hora de la solicitud y la referencia de autorización sin duplicar innecesariamente texto sensible.
- Mantén alternativas seguras: Aprueba voces de respaldo que no estén destinadas a imitar a individuos identificables.
- Conserva los metadatos del modelo: Almacena las fuentes de datos de entrenamiento divulgadas, las licencias, las restricciones de uso y la documentación de evaluación relevante.
Un registro de permiso también necesita un proceso de revocación. Decide quién puede deshabilitar una voz, cómo se maneja el audio en caché y qué sucede con el contenido programado cuando cambia la autorización.
Evalúa a Quién Sirve el Sistema
Prueba el rendimiento del acento, dialecto e idioma por separado. Un promedio global puede ocultar una mala experiencia para un grupo de hablantes particular, así que conserva los resultados a nivel de grupo donde la recopilación y el informe sean apropiados.
La gobernanza también debe seguir el enrutamiento. Si las solicitudes pueden llegar a diferentes proveedores, no asumas que una autorización de voz o un acuerdo de procesamiento se aplica a cada destino. Restringe el enrutamiento a combinaciones aprobadas de modelo, voz y términos de procesamiento.
Esta es una guía operativa general, no asesoramiento legal. Verifica las leyes y los requisitos contractuales que se aplican al hablante, la audiencia y la ubicación de implementación antes del lanzamiento.
APIs alojadas o modelos abiertos autoalojados
La implementación determina lo que controlas y lo que debes operar. Una API alojada traslada el servicio del modelo a un operador externo. El autoalojamiento otorga a tu equipo la responsabilidad del runtime, la capacidad, las actualizaciones y los controles de acceso.
Los pesos abiertos no significan automáticamente uso comercial sin restricciones, idoneidad para uso sin conexión (offline) o bajos requisitos de hardware. Inspecciona la licencia y los requisitos de runtime antes de invertir en la integración. Del mismo modo, un endpoint alojado no proporciona automáticamente versiones fijas o un acuerdo particular de residencia de datos.
| Criterio de decisión | API alojada | Modelo abierto autoalojado |
|---|---|---|
| Costo al volumen esperado | Cargos por uso más costos de integración y entrega | Cómputo, almacenamiento, capacidad ociosa y esfuerzo de ingeniería |
| Latencia bajo carga máxima | Incluye ruta de red y cola del lado del servicio | Depende del hardware aprovisionado y tu programación |
| Residencia de datos | Requiere revisión de las ubicaciones y términos de procesamiento | Puede permanecer dentro de la infraestructura que controlas |
| Gestión de versiones | Sujeto a las opciones de fijación y actualización del servicio | Tu equipo controla los artefactos y el momento del lanzamiento |
Compara el costo operativo total
La implementación alojada puede ser adecuada para la demanda variable y para equipos que no desean operar hardware de inferencia. Confirma la unidad de facturación, los límites de concurrencia y cómo se manejan los reintentos antes de estimar el costo. Un precio basado solo en caracteres no describe la factura completa de la aplicación.
El autoalojamiento puede ser adecuado para operaciones offline o requisitos que prohíben el envío de texto y grabaciones de referencia fuera de la infraestructura controlada. Aún requiere planificación de capacidad, monitoreo, actualizaciones de seguridad y un proceso de lanzamiento reproducible. Un modelo que se ejecuta en una estación de trabajo no está necesariamente listo para el tráfico de producción concurrente.
Trata la lista del modelo Qwen TTS como un punto de descubrimiento para un candidato, no como prueba de su idoneidad para un arreglo de alojamiento particular. Confirma el runtime real, la licencia y la interfaz para cualquier implementación que evalúes.
Prueba la ruta de servicio, no solo los pesos
Usa el mismo corpus anonimizado en candidatos alojados y autoalojados. Mantén el formato de reproducción y el cliente de prueba consistentes, luego mide bajo los patrones de concurrencia y solicitud que la aplicación espera.
Registra si la prueba incluye el inicio (startup), la carga (loading), la puesta en cola (queuing) y la conversión. De lo contrario, un benchmark local en caliente y una solicitud remota completa no son comparables.
Si tu conjunto de pruebas contiene información personal, revisa los términos de manejo de datos antes de transmitirla. Elimina los identificadores innecesarios incluso cuando el destino esté aprobado, y restringe el acceso a las grabaciones de referencia independientemente del texto ordinario de la aplicación.
Preselección, prueba y aprobación
Una preselección debe expresar requisitos, no familiaridad con la marca. Mantén los candidatos que cumplan el contrato de entrada, los idiomas requeridos, las restricciones operativas y las condiciones de autorización de voz. Excluye los modelos que no puedan satisfacer un requisito obligatorio antes de dedicarles tiempo de escucha.
Usa un procedimiento de lanzamiento que deje un registro de decisiones inspeccionable:
- Selecciona candidatos compatibles. Documenta por qué cada modelo encaja con las entradas y salidas requeridas. Separa las funciones obligatorias de las preferencias para que los revisores sepan qué se puede sacrificar.
- Ejecuta y revisa la suite de textos difíciles. Conserva las salidas sin procesar, las valoraciones de los oyentes y los registros de tiempos. Investiga los errores críticos en lugar de aceptar una puntuación agregada atractiva.
- Aprueba los derechos y las condiciones de procesamiento. Verifica la licencia del modelo, la autorización del audio de referencia y el uso previsto de cada voz personalizada. Asigna un responsable a las condiciones sin resolver.
- Congela la configuración aprobada. Fija las versiones cuando se admita, guarda la configuración de preprocesamiento y entrega, y exige pruebas de regresión cuando cambie la configuración de servicio.
Mantén la comodidad de la integración separada de la aceptación
UberLLM ofrece acceso a Claude, GPT, Gemini, DeepSeek y modelos de imagen, video y música mediante un endpoint compatible con OpenAI y Anthropic. Una API key común y un saldo prepago consolidan el acceso, y cambiar el identificador del modelo facilita comparar candidatos sin una integración de proveedor independiente para cada modelo; aun así, hay que revisar los parámetros de voz específicos de cada modelo.
Qwen3 0.6B TTS se ofrece a $0.035 por 1K caracteres, frente a un precio de lista de $0.0875 por 1K caracteres. Confirma el precio actual en el listado del proveedor antes de presupuestar, y compara costos solo entre los candidatos que cumplan los criterios de aceptación.
Exige una decisión de lanzamiento con responsable identificado
Asigna un responsable al registro de aprobación y conserva los ejemplos de audio aprobados. Registra las excepciones de forma explícita, incluidas las categorías de texto que requieran preprocesamiento, una voz de respaldo o revisión humana.
Una decisión de lanzamiento debe seguir siendo comprensible después de que las personas que realizaron la evaluación pasen a otro proyecto. La comprobación final es sencilla: ¿El modelo elegido supera la prueba de textos difíciles y el registro de consentimiento cubre todas las voces clonadas?
UberLLM ofrece una API unificada para comparar e integrar voz junto con otros tipos de modelos. Visita UberLLM para inspeccionar candidatos de voz y luego prueba tus nombres, códigos y diálogos emocionales anonimizados con los modelos que cumplan tus requisitos de entrada antes de elegir una configuración de producción.