Modelos de Precios de IA Explicados: Tokens, Tareas y Costos
Compara modelos de precios de IA: por token, por tarea, facturación por suscripción y por créditos, además de cómo estimar cuánto costará realmente tu inferencia.
Ya tienes una función de IA funcionando y ahora intentas ponerle precio. La tarifa por token del modelo parece manejable, pero la factura de staging incluye respuestas largas, reintentos, llamadas a herramientas y trabajos de vídeo que nunca produjeron algo usable. Multiplicar la tarifa anunciada por el tráfico previsto ya no te da un presupuesto creíble.
Los modelos de precios de IA describen cómo te cobran los proveedores. El coste por tarea completada te dice si la función es rentable. Necesitas ambas vistas: la unidad de facturación para conciliar cargos y el resultado final para comparar modelos, proveedores y márgenes de producto.
Tabla de Contenidos
- Seis modelos de precios de IA y cómo te factura cada uno
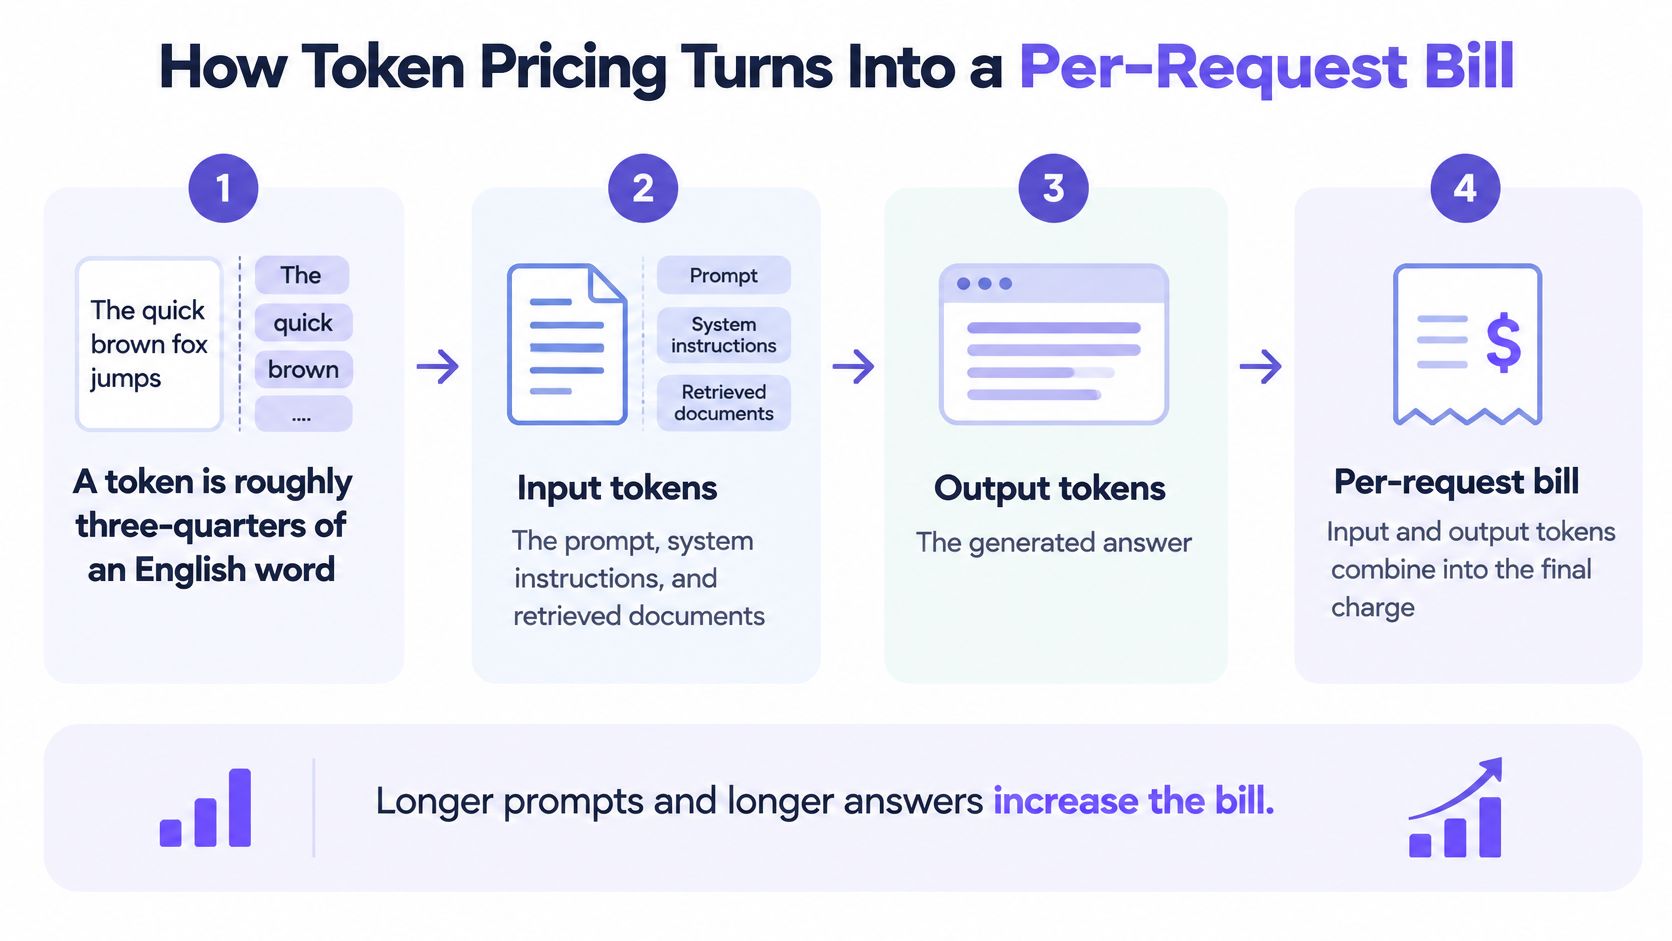
- Cómo el precio por token se convierte en una factura por solicitud
- Precios de medios para imágenes, vídeo y audio
- Por qué el coste por tarea completada supera al coste por token
- Por qué los precios de los modelos siguen bajando
- Cómo elegir entre créditos, suscripciones y facturación por uso
- Lista de verificación del proveedor más allá del precio de lista
- Confirma tu coste por tarea antes de comprometerte
Seis modelos de precios de IA y cómo te factura cada uno
La mayoría de los productos de IA facturan mediante una de seis estructuras. La tabla muestra la unidad de facturación, el encaje ideal y el riesgo principal de cada uno.
Modelos de precios de IA más comunes de un vistazo
| Modelo de precios | Cómo te cobran | Encaje ideal | Riesgo principal |
|---|---|---|---|
| Por token | Por millón de tokens de entrada y salida, con precios separados | Chat, programación, API de texto | La factura sube con la longitud de la respuesta |
| Por unidad multimedia | Por imagen, por segundo de vídeo o por trabajo de generación | Herramientas de imagen, vídeo, voz y música | La resolución y la duración cambian el precio unitario |
| Suscripción con cuotas | Cuota mensual fija con un límite de uso | Productos estables basados en asientos | Cargos por exceso o limitación tras el límite |
| Créditos prepago | Saldo que se descuenta por solicitud | Cargas de trabajo variables en varios proveedores | El saldo no usado puede caducar |
| Basado en resultados | Tarifa por tarea completada o caso resuelto | Agentes de soporte, flujos de trabajo con éxito claro | Definir el éxito es difícil |
| Híbrido | Suscripción base más uso medido o créditos | Productos con cargas de trabajo mixtas de texto y multimedia | Dos componentes de facturación que conciliar |
Ajusta la unidad a la carga de trabajo
La facturación por token encaja con cargas de trabajo de texto porque mide el material procesado y generado. Es útil para chat y programación, pero una instrucción para producir una explicación detallada puede cambiar la factura sin cambiar el número de solicitudes.
La facturación por unidad multimedia es más fácil de entender a primera vista: pagas por una imagen o por un trabajo de generación. La dificultad está en la definición de esa unidad, lo que incluye la resolución, la duración, los ajustes de calidad y el sonido.
Las suscripciones con cuotas funcionan cuando un equipo necesita acceso habitual y puede mantenerse dentro de una asignación predecible. Revisa qué ocurre al alcanzar el límite antes de tratar la suscripción como un coste operativo fijo.
Los créditos prepago hacen que el gasto salga de un saldo financiado. Encajan para experimentar con varios modelos, siempre que entiendas la caducidad, los reembolsos y cómo se traducen los créditos en uso real.
Los precios basados en resultados acercan el cargo al valor de negocio. Sin embargo, un flujo de trabajo de soporte necesita una prueba explícita de resolución, incluido qué ocurre cuando el cliente reabre el caso.
Los planes híbridos combinan acceso o una asignación incluida con consumo variable. Pueden adaptarse a cargas de trabajo mixtas, pero el equipo de finanzas debe conciliar tanto el cargo base como el componente medido.
Regla práctica: Identifica la unidad que factura el proveedor antes de comparar cualquier precio anunciado.
Una suscripción no es automáticamente más barata que la facturación por uso, y los créditos no son automáticamente un descuento. Traduce cada oferta a la carga de trabajo que pretendes ejecutar, incluida cualquier asignación que vayas a pagar pero no vayas a usar.
Cómo se convierte el precio por token en una factura por solicitud
Costo de la solicitud = (tokens de entrada ÷ tokens por unidad de precio × tarifa de entrada) + (tokens de salida ÷ tokens por unidad de precio × tarifa de salida).
Para los precios indicados por millón de tokens, usa un millón como divisor. Los tokens de entrada incluyen el prompt, las instrucciones del sistema, el historial de la conversación y los documentos recuperados. Los tokens de salida cubren la respuesta generada. Usa el tokenizer del modelo o los campos de uso devueltos en lugar de una aproximación por recuento de palabras, especialmente para código y texto multilingüe.
Las tarifas separadas importan. Un análisis de arXiv sobre precios de API informa que GPT-4 se lanzó en marzo de 2023 a $30 por millón de tokens de entrada y $60 por millón de tokens de salida. La generación requiere un cálculo distinto al de procesar un prompt, así que no asumas que las dos tarifas coinciden.
Calcula una solicitud con ambas tarifas
Considera una solicitud hipotética que contiene 2,000 tokens de entrada y 800 tokens de salida. Claude Opus 5.5 cuesta $4.00 de entrada y $20.00 de salida por millón de tokens a precio de lista, en comparación con $2.03 de entrada y $10.13 de salida en UberLLM.
| Componente | A precio de lista | A través de nuestro marketplace |
|---|---|---|
| Cálculo de entrada | 2,000 ÷ 1,000,000 × $4.00 | 2,000 ÷ 1,000,000 × $2.03 |
| Costo de entrada | $0.008 | $0.00406 |
| Cálculo de salida | 800 ÷ 1,000,000 × $20.00 | 800 ÷ 1,000,000 × $10.13 |
| Costo de salida | $0.016 | $0.008104 |
| Total | $0.024 | $0.012164, aproximadamente $0.012 |
Estos cálculos describen la solicitud hipotética, no un promedio para tu aplicación. Con un millón de solicitudes hipotéticas al mes con exactamente esa combinación de tokens, la diferencia es $11,836, o aproximadamente $12,000. Una longitud de salida diferente cambia el resultado.
El flujo de facturación hace que la distinción entre el tamaño del prompt y el tamaño de la respuesta sea más fácil de inspeccionar.
Crea tu estimación a partir de solicitudes reales
- Cuenta los tokens de entrada con tu plantilla de prompt y datos representativos de clientes. Incluye las instrucciones y el contexto recuperado.
- Estima los tokens de salida a partir de las respuestas aceptadas, no solo de la demostración exitosa más corta.
- Aplica cada tarifa por separado a su recuento de tokens correspondiente.
- Suma los resultados para obtener el cargo del modelo por esa solicitud.
- Multiplica por el volumen esperado, manteniendo separadas las clases de solicitudes cortas y largas.
El precio de modelo que mostramos describe lo que suele costar una solicitud, no un techo. Una solicitud nunca se factura por encima de un max_price o max_cost enviado con ella. Mantén esa distinción explícita en tu aplicación: una estimación ayuda a pronosticar el gasto, mientras que un techo por solicitud impone un límite.
Precios de medios para imágenes, video y audio
Precios de medios por unidad de muestra, de lista versus UberLLM
| Modelo | Unidad de facturación | Precio de lista | Precio UberLLM |
|---|---|---|---|
| Imagen Flux 2 Pro | Por imagen | $0.03 | $0.0075 |
| LTX 2.3 Texto a Video Rápido | Por trabajo | $0.06 | $0.045 |
| Veo 3.1 Texto a Video Completo | Por trabajo | $0.44 | $0.22 |
El precio de Flux es 75% más bajo, calculado a partir de los precios de imagen de lista. LTX es 25% más bajo, y Veo es 50% más bajo. Cada comparación se aplica solo al modelo nombrado y a la configuración coincidente, no a cada solicitud de imagen o video.
Los productos de medios a menudo facturan en unidades distintas a los tokens de texto. Un trabajo de generación, una imagen, una duración de audio o una duración de video se convierte en la unidad que necesitas normalizar. La elección del modelo y la configuración de salida determinan lo que esa unidad compra.
Compara configuraciones de generación idénticas
Un clip corto y barato no sustituye al recurso más largo y de mayor resolución que tu producto necesita. El sonido también importa: una vista previa silenciosa y un clip audiovisual terminado no son entregables equivalentes.
Antes de comparar proveedores, define con precisión:
- Modelo y tarea: Mantén la versión del modelo y el modo de generación idénticos, incluyendo texto a video versus imagen a video.
- Resolución y duración: Registra las dimensiones solicitadas y la duración del clip en lugar de depender del nombre de un modelo.
- Configuración de audio: Especifica si se incluye el sonido generado.
- Definición del trabajo: Confirma qué incluye un trabajo y si las extensiones, el escalado (upscaling) o las salidas adicionales requieren solicitudes separadas.
La guía de precios por segundo de la API de Veo ayuda a enmarcar las comparaciones basadas en la duración. No conviertas una cotización por trabajo en una tarifa por segundo hasta que sepas la duración que cubre esa cotización.
Una comparación de precios de medios solo es útil cuando ambos precios compran el mismo entregable.
Para el audio, distingue el habla generada de la transcripción y la generación de música. La duración del audio subido y la duración de la salida generada son medidas diferentes, así que registra la que el servicio facture.
Mantén un pequeño manifiesto de configuraciones junto a tu hoja de cálculo de precios: identificador del modelo, tarea, dimensiones, duración, audio y cualquier opción de calidad. Cotiza ese manifiesto con cada proveedor, luego guarda la cotización y la configuración juntas. Puedes repetir la comparación cuando los precios cambien sin comparar accidentalmente un producto diferente.
¿Por qué el costo por tarea completada supera al costo por token?
La tarifa de token más barata puede producir la tarea finalizada más cara. Un modelo que necesita correcciones repetidas, llamadas a herramientas innecesarias o reparación manual puede consumir tokens menos costosos mientras que cuesta más entregar un resultado utilizable.
La diferencia se hace visible cuando comparas una respuesta directa con un flujo de trabajo que sigue realizando acciones.
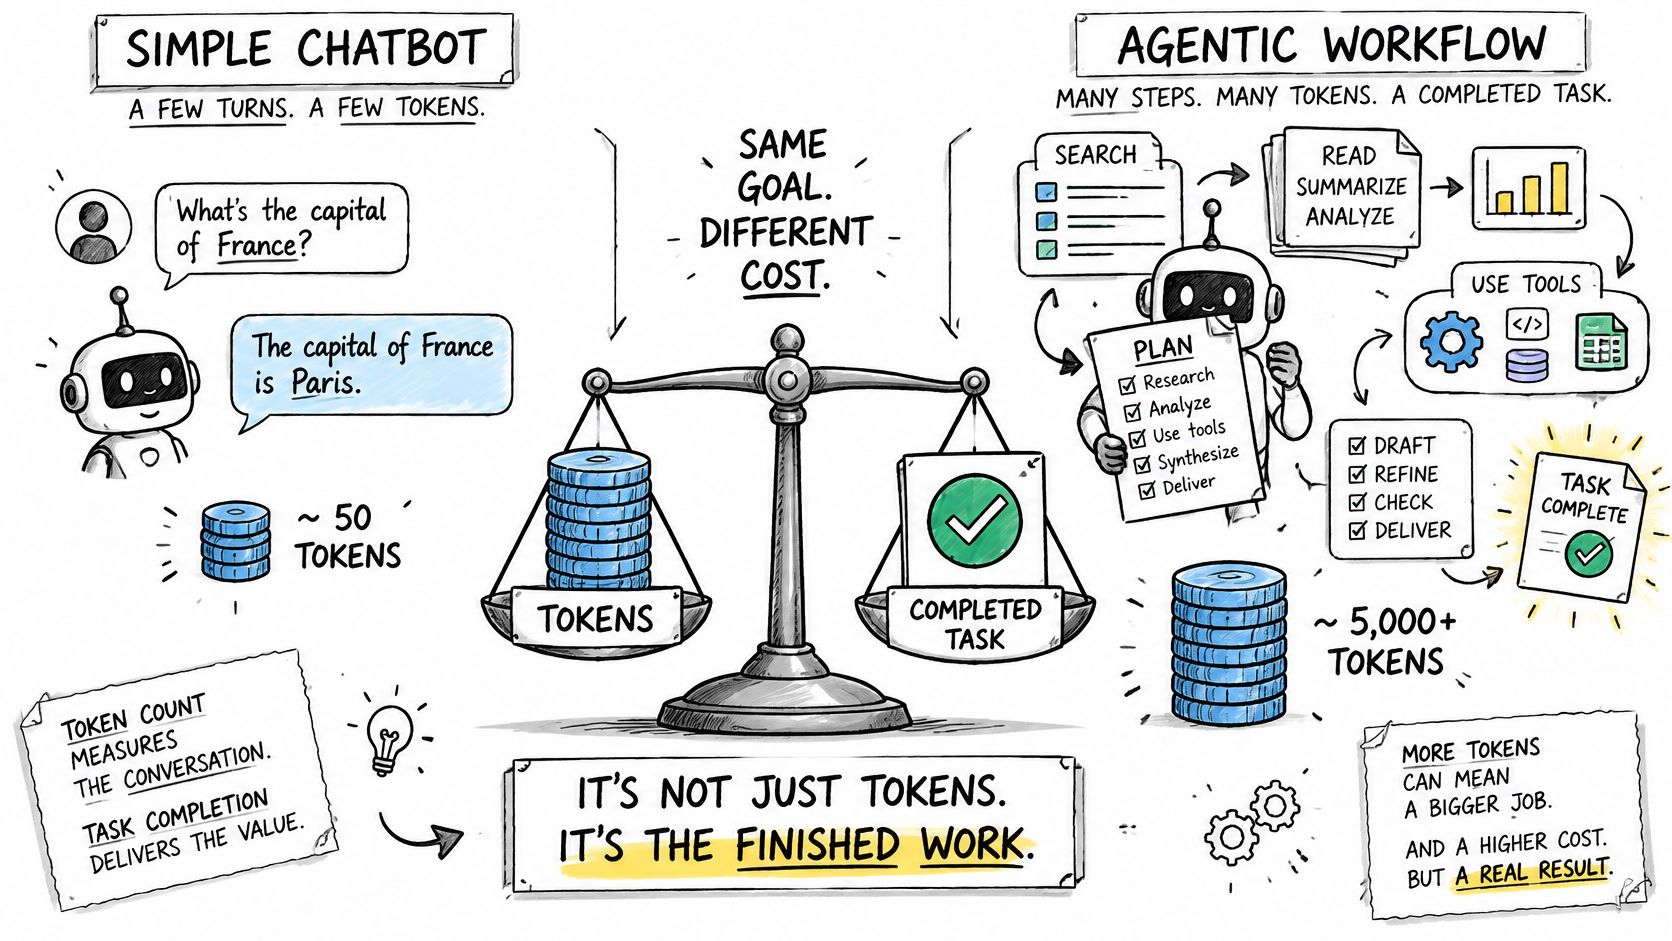
El análisis de costos de flujo de trabajo agéntico de Oometa describe flujos de trabajo agénticos que consumen 5–30 veces más tokens que una interacción de chatbot convencional y estima aproximadamente $0.001 para una llamada de chatbot simple versus $0.10–$1.00 para una tarea de agente de varios pasos. Trata esto como contexto, no como tu pronóstico: la planificación, recuperación, herramientas, reflexión y reintentos difieren según la implementación.
Incluye el trabajo fallido en el numerador
Costo por resultado exitoso = gasto total relacionado con la tarea ÷ tareas completadas con éxito.
En un lote hipotético, 1,000 intentos a $0.10 cada uno costaron $100. Si 800 tienen éxito, el costo por tarea resuelta es $0.125, no $0.10. Los intentos fallidos aún pertenecen al cálculo de costos.
Una segunda comparación hipotética muestra por qué los precios de etiqueta engañan:
| Modelo hipotético | Costo por intento | Tasa de éxito | Costo por éxito |
|---|---|---|---|
| Modelo de menor precio | $0.05 | 30% | Aproximadamente $0.167 |
| Modelo de mayor precio | $0.10 | 90% | Aproximadamente $0.111 |
Estos son ejemplos aritméticos, no el rendimiento medido del modelo. Asumen intentos comparables y una tasa de éxito sin cambios; tu evaluación debe establecer ambos.
El video proporciona otra forma de considerar los costos del flujo de trabajo.
Rastrea la longitud de salida, los reintentos, las soluciones alternativas impulsadas por la latencia y los cargos por solicitudes fallidas frente a un identificador de tarea compartido. Incluye los costos de herramientas o infraestructura cuando sean significativos, y distingue una respuesta de API de un éxito comercial.
Una respuesta de soporte que requiere que un empleado la reescriba no es equivalente a un ticket resuelto. Usa el resultado que tu cliente necesita: un caso resuelto, un clip aceptado o una tarea de codificación que pasa sus pruebas de aceptación.
¿Por qué los precios de los modelos siguen bajando?
El modelo más barato que iguala el rendimiento de nivel GPT-3.5 en MMLU cayó de aproximadamente $20 por millón de tokens en noviembre de 2022 a $0.07 en octubre de 2024, aproximadamente 286 veces más barato, según el resumen de Orb de las cifras reportadas por Stanford. El Informe del Índice de IA 2025 de Stanford describe la disminución del costo de inferencia igualado por capacidad durante ese período como más de 280 veces.
Esa comparación mantiene constante el umbral de referencia. No se limita a comparar un modelo capaz y caro con uno débil y más barato, aunque igualar un benchmark no garantiza un comportamiento equivalente en tu aplicación.
Presupuesto para una oferta cambiante, no una tarifa permanente
Arquitecturas más pequeñas, cuantificación, software de inferencia mejorado, hardware especializado y la competencia entre proveedores contribuyen a reducir los costos. Cada uno afecta una parte diferente de la economía: tamaño del modelo, precisión numérica, eficiencia de servicio, utilización del hardware o margen del proveedor.
Para los compradores, la implicación práctica es separar una suposición de precio de una suposición de calidad. Una tarifa más baja es útil solo si el candidato aún cumple con tus criterios de aceptación.
- Mantén un registro de precios con fecha: Guarda el identificador del modelo, las tarifas de entrada y salida, la unidad de facturación y la fecha en que los consultaste.
- Usa escenarios de presupuesto: Modela la demanda esperada junto con una carga de trabajo más pesada con salidas más largas y tareas más complejas.
- Programa revisiones: Revisa las tarifas trimestralmente e investiga las desviaciones materiales de la factura antes de la próxima revisión programada.
Un índice de precios de modelos puede ayudar a identificar candidatos que valga la pena volver a probar. No debe reemplazar el registro de precios adjunto a tus propios logs de solicitudes.
Nuestro precio listado se actualiza cada 5 minutos. Utiliza el precio de lista del proveedor multiplicado por la parte del precio de lista cobrada durante la hora de mayor precio negociado en el marketplace en las últimas 24 horas, y nunca es inferior a la oferta más barata.
Verifica los términos contractuales de cambio de precio por separado de tu calendario de revisiones. Un recordatorio en el calendario no convierte una tarifa variable en fija, y las disminuciones históricas no son garantía de que cada ruta se vuelva más barata.
Elegir entre créditos, suscripciones y facturación por uso
Un estudio de arXiv sobre precios de productos de IA encontró que las suscripciones con cuotas de uso eran el patrón de precios nativo de IA más común entre 52 productos; 25 ofrecían un nivel gratuito, prueba o créditos iniciales, mientras que 13 utilizaban precios de entrada de pago por uso. Ese patrón no establece un ganador universal. Muestra por qué la facturación de consumo puro no es la única estructura sensata.
La decisión se trata de quién asume el riesgo del uso variable. Una suscripción traslada parte del riesgo de la demanda hacia el proveedor, mientras que las estructuras prepago y de medición hacen que el consumo sea más visible para el comprador.
Utilice sus limitaciones operativas para elegir
| Pregunta | Lo que sugiere la respuesta |
|---|---|
| ¿El uso mensual es estable? | Una suscripción con una cuota utilizable puede simplificar la elaboración del presupuesto |
| ¿Utilizará varios proveedores o modalidades? | Un saldo prepago compartido puede reducir la financiación fragmentada |
| ¿Puede pronosticar el consumo de forma fiable? | La medición es más fácil de gestionar cuando las estimaciones de carga de trabajo son fiables |
| ¿Finanzas requiere un límite estricto? | Priorice los límites aplicables sobre las etiquetas de facturación |
El uso estable con un único proveedor apunta a una suscripción, siempre que la asignación se ajuste a su carga de trabajo real. No cuente la cuota no utilizada como valor y verifique si los excesos requieren aprobación o si ocurren automáticamente.
La demanda desigual en varios modelos apunta a créditos o uso medido. Los términos de vencimiento y de traspaso son importantes porque comprar capacidad que nunca usa puede anular un descuento aparente.
Separe la financiación de la facturación
Una billetera prepago describe cuándo financia el uso, no necesariamente cómo se tarifa cada solicitud. Del mismo modo, el pago por uso puede operar a través de un saldo prepago en lugar de una factura pospago.
No tenemos cuota mensual ni mínimo. Los clientes mantienen un único saldo y pagan a medida que usan. Nuestra opción de pago upto, ofrecida primero, hace que la billetera firme una cotización como límite; después de la respuesta, solo se toma el costo real, redondeado al siguiente millonésimo de dólar.
Elija la limitación con la que no puede transigir antes de elegir el plan.
Si esa limitación es un presupuesto fijo, inspeccione los controles de gasto. Si es un acceso predecible para un equipo estable, inspeccione la cuota y las reglas de exceso. Si es flexibilidad entre texto y medios, verifique si el mismo saldo admite los flujos de trabajo que pretende ejecutar.
Lista de verificación del proveedor más allá del precio publicado
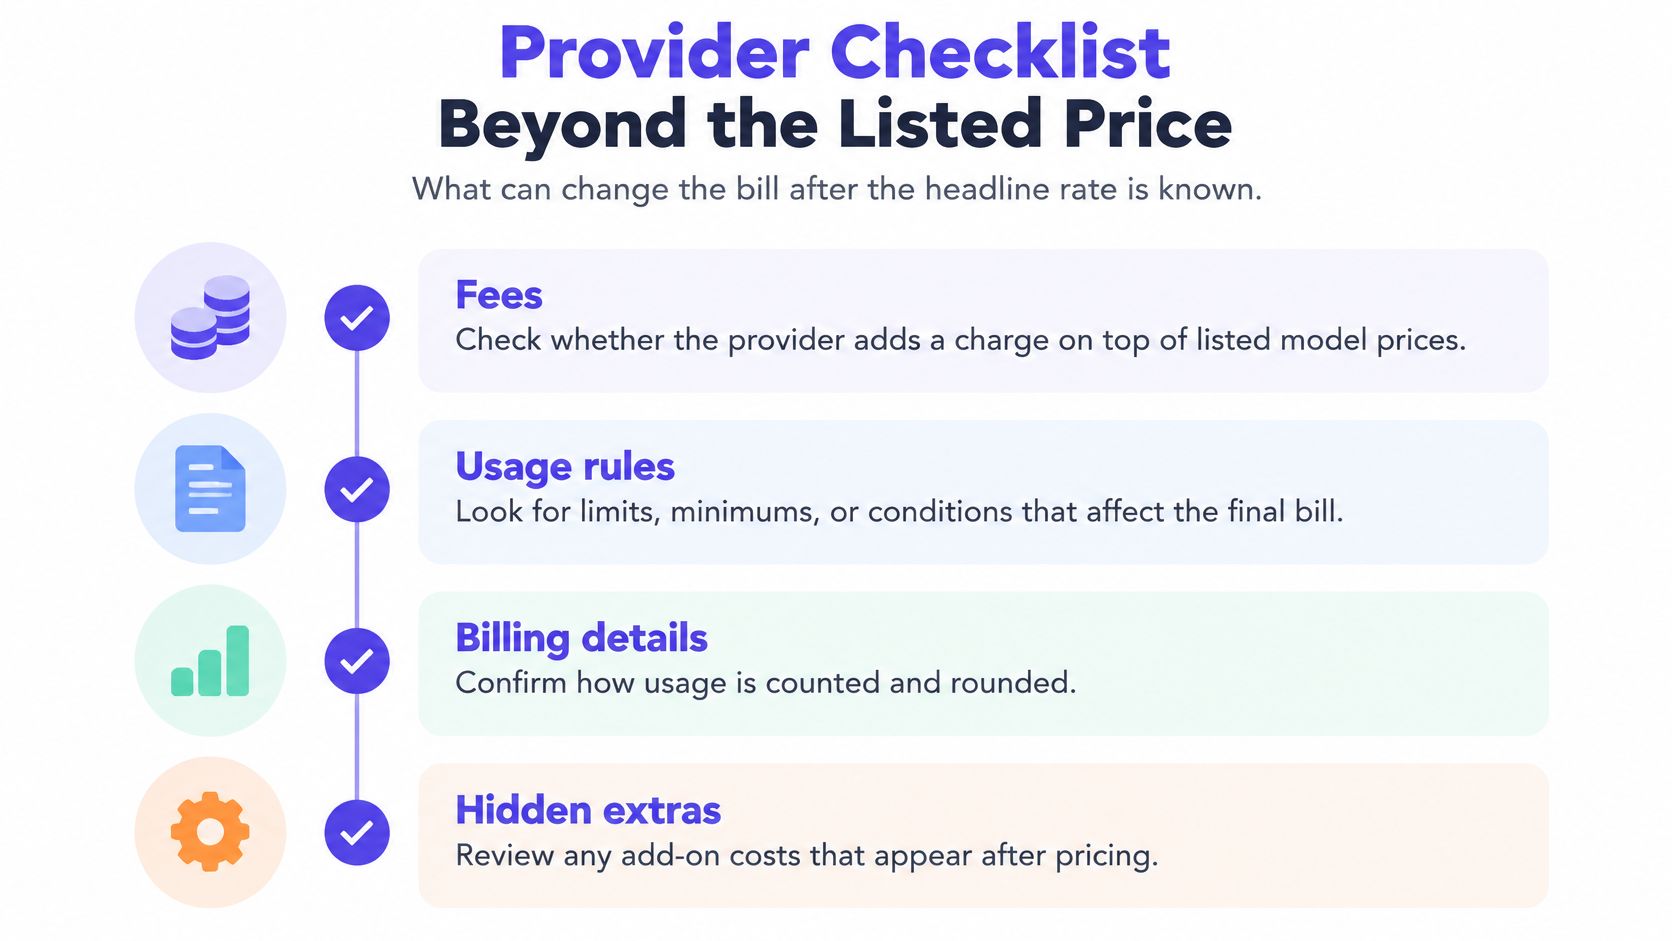
Una lista de tarifas no te dice todo lo necesario para conciliar una factura de producción. Prueba el comportamiento de la facturación, no solo la aritmética mostrada en un entorno de pruebas.
Usa esta lista de verificación para identificar los términos que necesitan una respuesta concreta.
Verifica la ruta de cobro
- Las tarifas son explícitas. No añadimos ninguna tarifa adicional sobre los precios de modelo publicados. Mantén los cargos de financiación separados de los cargos por solicitud al comparar el gasto total. Una mala respuesta es una cotización que excluye un recargo de plataforma no especificado.
- La base del cargo es rastreable. Cuando el proveedor informa lo que cobró por una llamada, facturamos exactamente esa cantidad. De lo contrario, la llamada cuesta sus tokens al precio publicado. Una mala respuesta es un total de factura que no se puede vincular al uso a nivel de solicitud o a los cargos informados.
- Las solicitudes fallidas tienen un tratamiento definido. Nuestras solicitudes y generaciones fallidas no cuestan nada. Sin embargo, una generación completada que no te guste no debería clasificarse automáticamente como un fallo técnico. Una mala respuesta deja la distinción indefinida.
Verifica la ruta de control
- Las claves proporcionan aislamiento. Nuestras API keys tienen alcance definido y son revocables, y se aplican límites de gasto por clave. Una llamada a la herramienta MCP se factura, limita y rechaza como la solicitud API equivalente. Una mala respuesta requiere deshabilitar cada servicio para detener una única integración comprometida.
- El comportamiento de fallback es comprensible. Movemos las solicitudes a otro vendedor saludable cuando un proveedor se vuelve lento o no disponible. Prueba el cargo resultante y el tiempo en tus logs. Un proveedor que no puede explicar si una ruta alternativa cambia el cargo te deja con un precio desconocido.
Para cargas de trabajo mixtas, inspecciona cómo una API unificada de texto, imagen y video expone el estado y los resultados de la tarea. Una solicitud de medios asíncrona necesita un identificador de tarea duradero para que el envío, la finalización y la facturación puedan conciliarse incluso cuando ocurren en diferentes momentos.
Ejecuta estas verificaciones contra tráfico de producción representativo, incluyendo timeouts, cancelaciones y trabajos fallidos. Una cuenta demo con prompts cortos y respuestas exitosas no revelará si tu contabilidad sobrevive a las condiciones que tu aplicación debe manejar.
Confirma Tu Costo por Tarea Antes de Comprometerte
Usa una evaluación acotada en lugar de migrar basándote únicamente en una tabla de precios. El propósito es descubrir qué opción ofrece resultados aceptables a un costo operativo aceptable, sin cambiar la carga de trabajo.
Realiza una comparación controlada
- Selecciona tareas representativas. Incluye solicitudes rutinarias, casos difíciles, contextos largos y entradas que previamente causaron problemas. Mantén el material sensible del cliente fuera de una evaluación a menos que su uso esté autorizado.
- Captura el registro de ejecución. Registra los input y output tokens, identificadores de tarea, reintentos, llamadas a herramientas, cargos y juicios de éxito. Registra el tiempo hasta un resultado utilizable, no solo el tiempo hasta la primera respuesta.
- Calcula la línea base actual. Divide todos los gastos relevantes por los resultados aceptados. Mantén las clases de tareas separadas para que las solicitudes fáciles no oculten una economía deficiente en trabajos difíciles.
- Prueba modelos alternativos. Conserva los prompts, inputs, permisos de herramientas y pruebas de aceptación. Con nuestro acceso API común, cambiar de modelo utiliza un identificador de modelo diferente, y cada solicitud se enruta al vendedor saludable más barato.
- Aplica un presupuesto de solicitudes. Elige límites apropiados para cada clase de tarea, y verifica cómo la aplicación maneja el rechazo o el trabajo incompleto. Un límite debe producir una experiencia de usuario controlada, no un error inexplicable.
- Compara los resultados operativos en conjunto. Evalúa el costo por éxito, la latencia y la tasa de fallos. Inspecciona los outputs reales donde la puntuación automatizada puede pasar por alto errores fácticos o trabajo incompleto.
- Realiza una prueba piloto antes de comprometerte. Envía una pequeña parte controlada del tráfico en vivo al candidato. Concilia los cargos facturados con tus logs durante la prueba piloto, y mantén una ruta de reversión hasta que tanto la calidad como la contabilidad sean fiables.
Haz que la decisión sea repetible
Escribe los criterios de aceptación antes de revisar los nombres y precios de los modelos. De lo contrario, es fácil excusar un output más débil porque un candidato parece más barato.
Mantén el conjunto de evaluación versionado, y añade nuevos casos de fallo a medida que la aplicación cambia. Programa la próxima revisión trimestralmente, con una nueva prueba anticipada cuando un cambio significativo en el modelo, los precios o el producto haga que la comparación existente no sea fiable.
La opción ganadora no es el modelo más barato de forma aislada. Es la configuración que completa tu carga de trabajo dentro de tus restricciones de calidad, latencia y presupuesto.
UberLLM ofrece una API key para modelos de texto y medios, un saldo prepago compartido y enrutamiento al vendedor saludable más barato para cada modelo solicitado. Visita UberLLM para comparar precios actuales, luego prueba tareas representativas y mide el costo de los resultados aceptados antes de mover el tráfico de producción.