Modèles de synthèse vocale : capacités et guide de sélection
Explorez les modèles de synthèse vocale par entrée, sortie, clonage vocal, indicateurs de qualité et règles de consentement, avec des tableaux et une liste de vérification de sélection pour 2026.
Les voix neuronales et générées par IA représentaient 67.90% des revenus du marché de la synthèse vocale en 2024, selon le rapport sur les tendances de l'industrie de Sonix. Cela mesure les revenus, pas la fiabilité. Pour un développeur qui choisit des modèles de synthèse vocale, la question plus difficile est de savoir si une voix peut restituer les noms, les codes, les instructions et les dialogues émotionnels qu'une application envoie.
Une démo agréable ne répond pas à cette question. Considérez la sélection de modèles comme un contrat d'entrée-sortie, suivi d'une évaluation du texte de production. L'architecture, la similarité vocale et la naturalité moyenne sont importantes, mais aucune ne devrait l'emporter sur un échec qui modifie ce que l'auditeur comprend.
Table des matières
- Capacités, entrées et sorties en un coup d'œil
- Familles d'architectures et leur signification
- Clonage vocal, échelle et couverture linguistique
- Mesures de qualité qui vont au-delà du MOS
- Construire un ensemble de test pour les textes difficiles
- Adapter les modèles à votre cas d'utilisation
- Consentement, divulgation et utilisation sûre de la voix
- API hébergées ou modèles ouverts auto-hébergés
- Présélectionnez, testez et validez
Fonctionnalités, Entrées et Sorties en un coup d'œil
| Fonctionnalité | Entrée typique | Sortie typique | Utilisez-la quand |
|---|---|---|---|
| TTS standard | Texte brut | Fichier audio ou flux | Vous avez besoin d'une narration à partir d'un texte fixe ou fourni par l'utilisateur |
| TTS en streaming | Morceaux de texte au fur et à mesure de leur génération | Morceaux audio dans l'ordre de lecture | L'audio doit commencer avant que le texte complet ne soit prêt |
| TTS contrôlé par balisage ou style | Texte avec SSML ou balises de style | Audio avec pauses, emphase ou émotion définies | La prononciation et le rythme doivent être contrôlés |
| Clonage de voix | Texte plus audio de référence avec consentement documenté | Audio dans la voix de l'orateur de référence | Une voix de marque ou d'utilisateur doit être reproduite |
| TTS multilingue | Texte en plusieurs langues | Audio dans chaque langue, avec une ou plusieurs voix | Un produit sert des utilisateurs dans de nombreuses langues |
Le TTS standard est le contrat le plus simple : soumettez du texte et recevez de la parole. Utilisez-le pour des narrations préparées, des notifications et des passages dont la formulation est déjà complète. Un fichier téléchargeable convient à l'édition et à la mise en cache ; une réponse en streaming peut éviter d'attendre le fichier audio entier.
Le TTS en streaming nécessite un examen plus approfondi. Certains services diffusent l'audio après avoir reçu une entrée de texte complète, tandis que d'autres acceptent également le texte incrémental. Si un assistant génère sa réponse progressivement, confirmez que l'interface prend en charge cette dernière option plutôt que de supposer que le streaming signifie les deux directions.
La synthèse contrôlée par balisage ajoute des instructions de livraison. SSML, les contrôles de prononciation et les balises de style propriétaires ne sont pas interchangeables, alors testez la syntaxe exacte acceptée par le modèle que vous avez sélectionné. Les instructions non prises en charge peuvent être ignorées, rejetées ou prononcées à voix haute.
Le clonage ajoute une entrée d'orateur de référence, tandis que la synthèse multilingue ajoute une couverture linguistique. Ni l'un ni l'autre n'inclut automatiquement l'autre : une voix préréglée multilingue n'est pas nécessairement clonable, et une voix clonée n'est pas nécessairement fiable dans toutes les langues prises en charge.
Choisissez le contrat audio avant la voix
WAV est un conteneur ; PCM décrit une représentation audio. Le PCM non compressé, souvent empaqueté en WAV, est pratique pour l'édition et le traitement. Les pipelines de téléphonie ont besoin de l'encoding, de la configuration des canaux et du sample rate que leurs systèmes en aval attendent, pas seulement d'un fichier avec une extension familière.
MP3 et Opus sont des options de livraison compressées pour les browsers et les applications, sous réserve de la prise en charge par le client. Sélectionnez un format que votre player peut decode sans étape de conversion supplémentaire. Sinon, les performances de synthèse mesurées ne décriront pas le délai que les utilisateurs subissent.
Le taux d'échantillonnage spécifie la fréquence à laquelle l'audio est échantillonné. Il affecte la plage de fréquences représentée et, pour l'audio non compressé avec d'autres paramètres fixes, la taille du fichier. Augmenter le taux d'échantillonnage de sortie ne répare pas une prononciation peu claire et ne restaure pas les détails que le modèle n'a jamais générés.
Avant l'intégration, notez le contrat :
- Contraintes d'entrée : Longueur de texte acceptée, balisage pris en charge et comportement d'entrée incrémentale.
- Disponibilité de la voix : Langues requises, dialectes, voix préréglées et accès aux voix personnalisées.
- Exigences de sortie : Encoding, taux d'échantillonnage, canaux et comportement de streaming.
- Comportement en cas d'échec : Comment l'application gère le texte rejeté, les flux interrompus et les voix indisponibles.
Lisez le tableau de gauche à droite : faites correspondre l'entrée que vous avez à la sortie dont vous avez besoin, puis vérifiez si le cas d'utilisation correspond. Une voix qui sonne excellent mais qui nécessite un modèle d'interaction incorrect n'a pas sa place dans la liste restreinte.
Familles d'architectures et ce qu'elles impliquent
| Famille | Comment elle génère la parole | Compromis principal |
|---|---|---|
| Concaténative | Assemble des unités de parole préenregistrées | Naturelle dans le domaine enregistré, faible en dehors |
| Paramétrique statistique | Prédit des caractéristiques acoustiques, puis un vocodeur rend l'audio | Flexible, mais souvent étouffée |
| Forme d'onde neuronale | Génère des échantillons audio avec un réseau neuronal | Grande naturalité, lourd en calcul sans optimisation |
| Neuronale basée sur des tokens | Prédit des codes audio discrets à partir du texte | S'adapte bien aux données, nécessite un contrôle minutieux du style et de l'orateur |
Les grandes distinctions de pipeline sont illustrées ci-dessous.
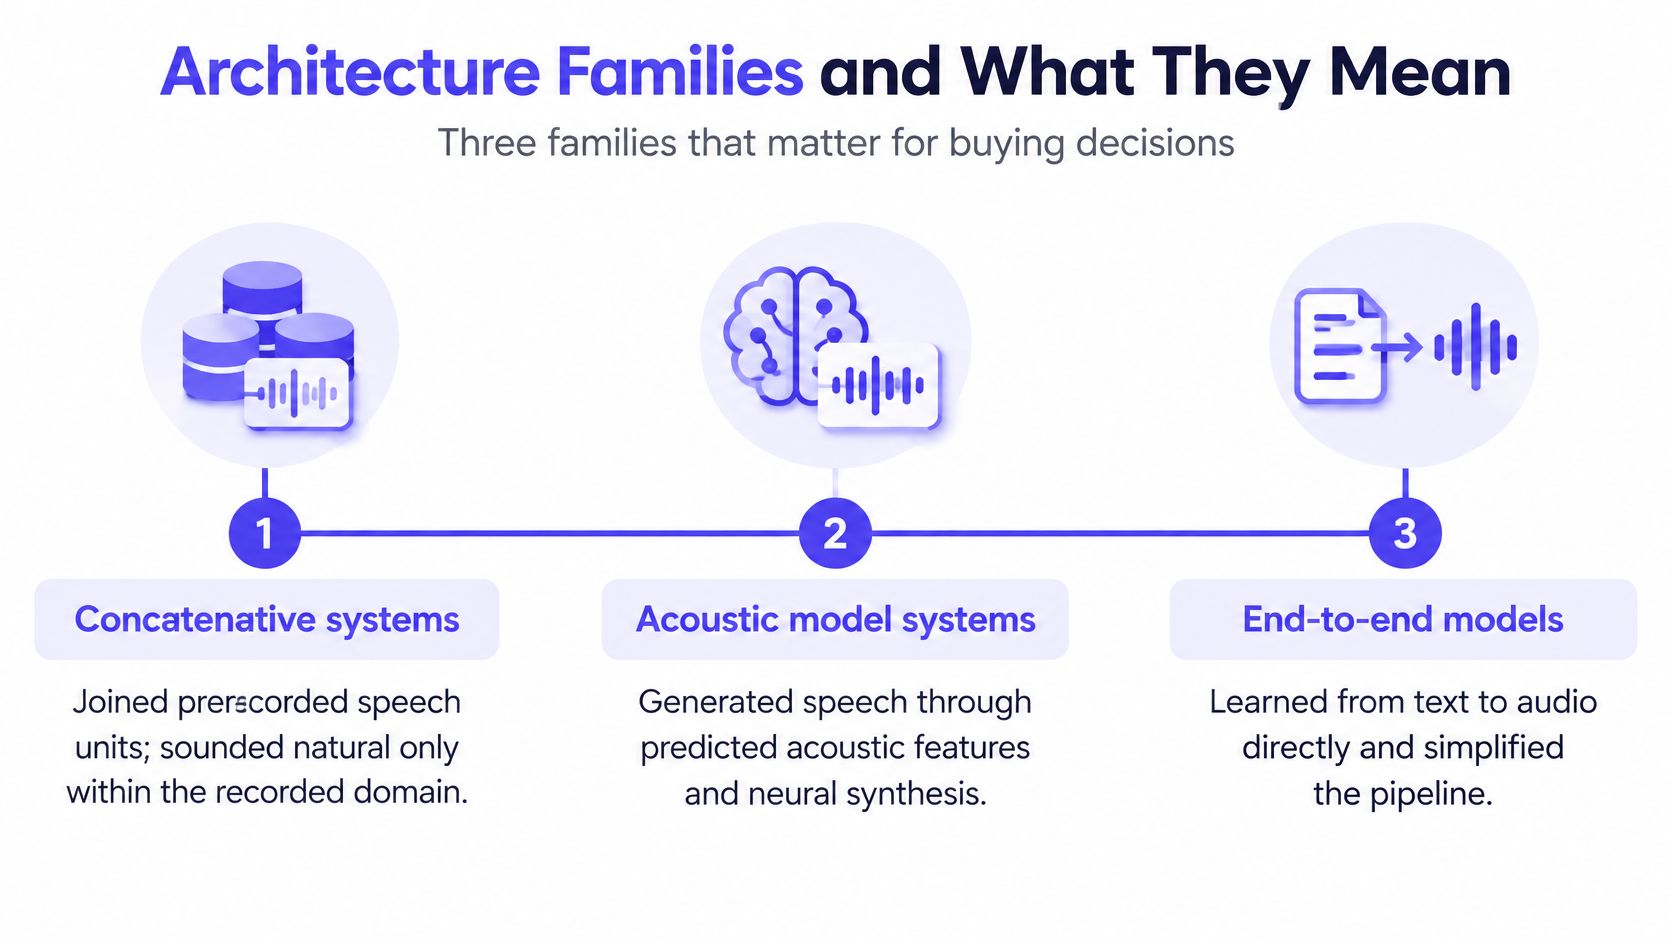
Les systèmes concaténatifs assemblent des unités enregistrées, leur flexibilité est donc limitée par les enregistrements disponibles et les jonctions entre eux. Les systèmes paramétriques statistiques, eux, prédisent des propriétés acoustiques, puis rendent la parole via un vocodeur, échangeant la réutilisation directe des enregistrements contre un pipeline de synthèse plus contrôlable.
Une étape majeure a été franchie avec WaveNet en 2016 : le papier WaveNet a rapporté une réduction de plus de 50% de l'écart de qualité entre les systèmes TTS existants les plus performants et la parole humaine dans ses évaluations en anglais américain et en mandarin. Cette découverte a établi l'importance de la génération de forme d'onde neuronale, et non une garantie de performance universelle pour chaque modèle neuronal ultérieur.
Les systèmes neuronaux basés sur des tokens prédisent des représentations audio discrètes qu'un décodeur transforme en son. Pour les décisions d'achat, distinguez cette représentation de l'interface de service : un produit de bout en bout peut toujours contenir plusieurs étapes de traitement internes.
Lisez les fiches de modèle comme des descriptions de pipeline
Recherchez les détails sur le spectrogramme, le vocodeur, le codec, les audio tokens et le conditionnement de l'orateur. Une étape de spectrogramme suivie d'un vocodeur suggère un pipeline de modèle acoustique ; les codes audio discrets suggèrent une génération basée sur des tokens. Les descriptions d'entraînement aident à expliquer la conception, mais elles ne remplacent pas les tests de sortie.
Pour les appareils contraints, comparez la mémoire réelle, le temps d'exécution et la compatibilité matérielle plutôt que de supposer que "plus ancien" signifie "plus petit" ou "plus récent" signifie "cloud uniquement". En déploiement hébergé, examinez la latence et les contrôles fournis plutôt que de les déduire de l'étiquette d'architecture.
La frontière est également importante pour les tâches adjacentes. Un guide de synthèse de voix chantée aborde un problème de contrôle différent : la prosodie parlée ne remplace pas le timing et la hauteur musicale explicites.
Règle pratique : Utilisez l'architecture pour comprendre les contraintes probables et les questions de diagnostic utiles, pas pour déclarer un gagnant avant d'écouter.
Clonage vocal, échelle et couverture linguistique
Le clonage vocal sépare l'identité de l'orateur des mots prononcés. Évaluez ces dimensions indépendamment : un résultat peut ressembler à l'orateur de référence tout en prononçant la phrase avec une émotion inappropriée.
Les principales méthodes de clonage diffèrent dans la manière dont elles établissent cette identité.
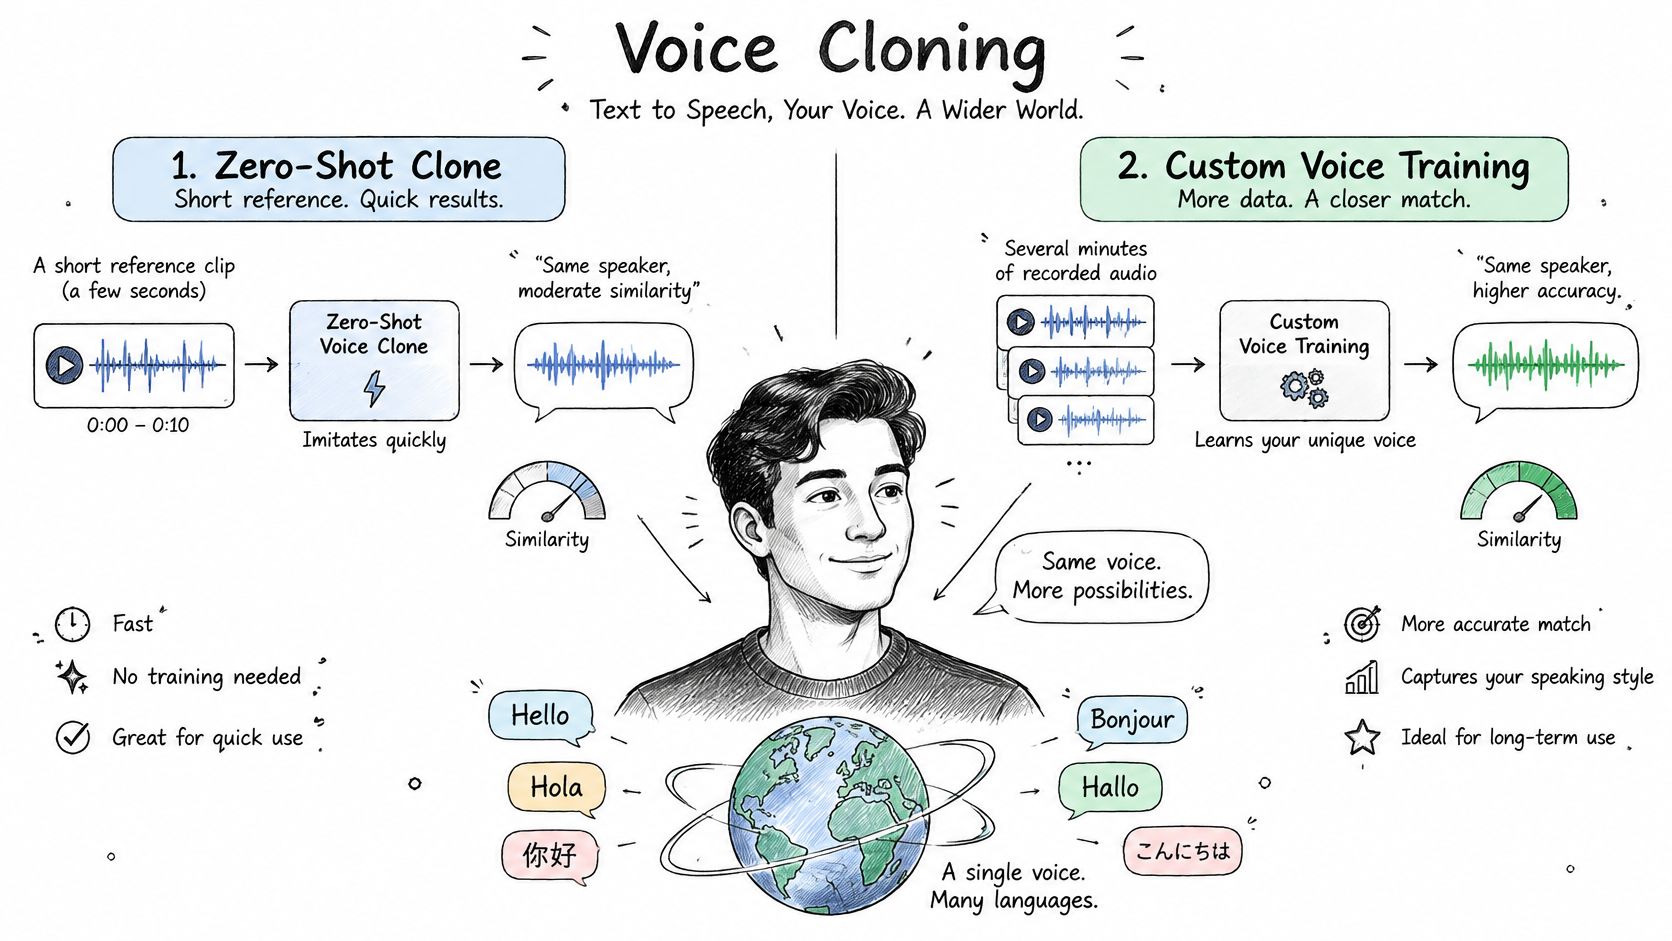
Le clonage zero-shot conditionne la synthèse sur un audio de référence sans travail d'entraînement distinct spécifique à l'orateur. L'entraînement vocal personnalisé adapte un modèle à l'aide d'un jeu de données d'orateur préparé. Le premier réduit le travail de configuration ; le second ajoute des exigences d'enregistrement, de préparation et d'entraînement, sans rendre la similarité automatique.
La qualité de la référence mérite son propre test. Le bruit de fond, les orateurs concurrents, le placement incohérent du microphone et les styles de prestation très différents peuvent rendre plus difficile de déterminer ce que le système doit préserver. Comparez des références propres avant d'attribuer un résultat faible entièrement au modèle de synthèse.
Séparer la similarité de la performance
Considérez une comparaison hypothétique entre une référence courte et neutre et une référence plus longue contenant plusieurs prestations émotionnelles. Générez la même phrase marketing entraînante à partir de chacune. Demandez aux auditeurs séparément si l'orateur est reconnaissable et si la prestation entraînante semble appropriée.
Ne supposez pas que la référence plus longue doit gagner. Elle contient plus de matériel, mais elle introduit aussi plus de variation ; la question utile est de savoir si le modèle préserve l'identité tout en suivant la performance demandée.
Pour une introduction audiovisuelle au sujet, la vidéo suivante offre un autre format de visionnage.
L'échelle fournit un contexte, pas une approbation. Dans sa couverture 2024, TechCrunch a rapporté que BASE-large a utilisé 100,000 heures de discours du domaine public pour l'entraînement et contenait 980 millions de paramètres. Ces totaux n'établissent pas comment un accent, un orateur ou une langue particulière se comportera.
Lors de l'examen d'une liste de modèles TTS multilingues, transformez la capacité annoncée en contrôles d'acceptation concrets :
- Couverture linguistique : Évaluez chaque langue et dialecte requis avec des auditeurs natifs.
- Stabilité de l'identité : Comparez l'orateur à travers les questions, les déclarations et le dialogue expressif.
- Préparation au repli : Identifiez une voix prédéfinie approuvée pour les clones indisponibles ou inappropriés.
- Provenance de la référence : Conservez l'identifiant de l'enregistrement et son dossier d'autorisation associé.
Une voix reconnaissable n'est utile que lorsque sa prestation reste compréhensible et appropriée à travers les messages réels du produit.
Mesures de qualité qui vont au-delà du MOS
Un benchmark peut être reproductible sans être représentatif. Le jeu de données LJSpeech contient 13,100 extraits totalisant environ 24 heures, enregistrés par une seule narratrice anglophone. C'est utile pour des comparaisons contrôlées, mais le succès dans ce cadre n'établit pas une performance plus large sur l'ensemble des locuteurs, des accents ou des styles de conversation.
Le Score d'Opinion Moyen, ou MOS, mesure la qualité perçue par les auditeurs. Maintenez les phrases et les conditions d'écoute cohérentes entre les modèles, masquez les identités des modèles et définissez clairement la question d'évaluation. Un panel interrogé sur l'agrément n'évalue pas nécessairement si un code produit a été prononcé correctement.
| Métrique | Ce qu'elle mesure | Comment la mesurer | Limite principale |
|---|---|---|---|
| MOS | Qualité perçue sur une échelle d'écoute de médiocre à excellente | Un panel d'écoute évalue les mêmes phrases de chaque modèle | N'isole pas les erreurs de prononciation ou de rythme sans questions ciblées |
| Intelligibilité | Si les auditeurs peuvent reconnaître les mots | Transcrire la sortie avec un reconnaisseur vocal et comparer avec le texte prévu | Les erreurs du reconnaisseur peuvent masquer les erreurs de synthèse |
| Temps avant le premier audio | Délai avant que l'audio utilisable n'arrive ou ne soit lu | Horodater séparément la soumission de la requête, la réception du premier audio et la lecture | Ne dit rien sur la qualité de la parole |
| Facteur temps réel | Temps de synthèse divisé par la durée de l'audio | Chronométrer la génération et diviser par la durée de la sortie | Varie avec le matériel, la charge et les limites de mesure |
| Reproductibilité | Cohérence entre les exécutions et les versions répétées | Fixer les paramètres exposés et les seeds, puis réexécuter et comparer | Certains services n'exposent pas les seeds ou les versions spécifiques |
Définissez ce que votre chronomètre inclut
Pour le streaming, distinguez le premier audio reçu du premier audio audible lu. Le transfert réseau, le décodage et la mise en mémoire tampon du lecteur appartiennent à l'expérience utilisateur, même s'ils se produisent en dehors de l'inférence du modèle. Enregistrez les deux lors du diagnostic du délai.
Pour les tests d'intelligibilité, comparez la parole reconnue à la forme parlée prévue, et non aveuglément aux caractères d'entrée bruts. Une date prononcée acceptable ne correspondra pas caractère par caractère à sa notation écrite. Examinez manuellement les erreurs impliquant des noms, des chiffres et des symboles avant de considérer le reconnaisseur comme la vérité terrain.
Une moyenne de qualité est une description d'un test. Ce n'est pas un critère d'acceptation tant que vous n'avez pas défini les erreurs que le produit peut tolérer.
Associez les vérifications automatisées à l'écoute. Les mesures de hauteur tonale seules ne décrivent pas le rythme, l'accentuation ou l'intensité, et les différences de forme d'onde ne signifient pas nécessairement que les auditeurs perçoivent un changement significatif.
Rapportez ensemble le MOS, l'intelligibilité, le temps avant le premier audio et le facteur temps réel. Incluez la version du modèle, l'environnement d'exécution, les paramètres de requête et les limites de mesure afin qu'un autre ingénieur puisse interpréter le résultat.
Créer un jeu de tests pour les textes difficiles
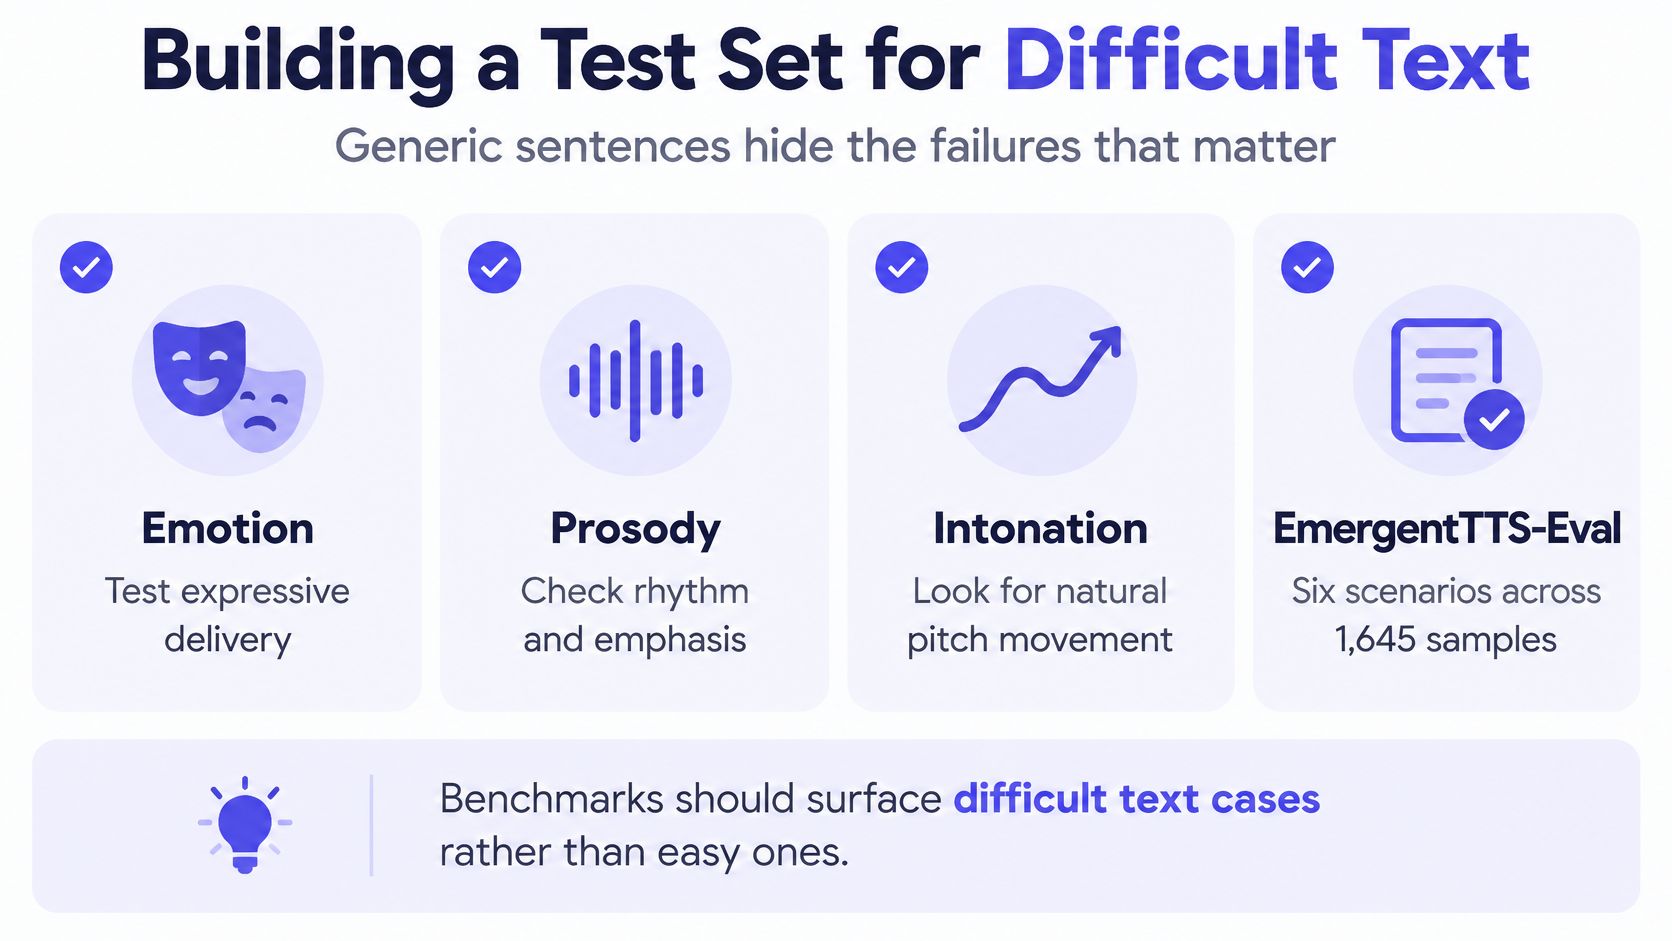
Les phrases génériques donnent des tests d'acceptation faibles car elles omettent le texte qui nécessite une interprétation. EmergentTTS-Eval évalue six scénarios sur 1,645 échantillons, couvrant l'émotion, la prosodie, l'intonation et la prononciation ; ses auteurs rapportent une forte corrélation entre le jugement basé sur le modèle et les préférences humaines.
Adoptez cette approche plus large sans considérer un benchmark externe comme la suite de tests de votre produit. Votre application a son propre vocabulaire, sa propre mise en forme et ses propres conséquences en cas d'erreurs.
Les catégories d'évaluation ci-dessous aident à révéler les échecs que les passages de lecture faciles ne mettront pas en évidence.
Inclure du texte qui change de sens lorsqu'il est mal lu
- Noms et lieux : Noms de produits, marques, noms personnels, adresses et codes postaux.
- Identifiants compacts : Acronymes, références de compte, codes produit et abréviations ambiguës.
- Notation structurée : Dates, heures, URL, fragments de code et formules mathématiques.
- Changements de langue : Mots étrangers et passages en langues mixtes.
- Intention conversationnelle : Questions, réassurance, urgence, désaccord et dialogues à forte charge émotionnelle.
- Indices non-verbaux : Rires, soupirs et autres instructions de performance prises en charge.
Pour chaque élément, enregistrez la lecture prévue. Un code pourrait nécessiter une épellation caractère par caractère, tandis qu'un acronyme pourrait avoir besoin d'être prononcé comme un mot. Sans cette annotation, les auditeurs peuvent ne pas être d'accord sur l'exactitude même lorsqu'ils entendent la même sortie.
Effectuer une comparaison reproductible
- Recueillez des textes représentatifs. Extrayez et anonymisez des exemples de production, puis étiquetez-les par catégorie. Incluez des entrées rares dont l'échec aurait de graves conséquences.
- Générez des sorties comparables. Gardez le format, le rôle vocal et les instructions de livraison équivalents lorsque c'est possible. Enregistrez la requête exacte et l'identifiant du modèle.
- Utilisez des auditeurs cohérents. Demandez au même panel d'évaluer séparément l'intelligibilité, la prononciation et l'adéquation prosodique. Mélangez l'ordre des modèles.
- Capturez la performance par élément. Enregistrez le temps du premier audio et le facteur temps réel avec le texte associé, plutôt que de ne conserver qu'une moyenne par lot.
- Répétez après les changements. Conservez une base de référence approuvée et étudiez les régressions lorsqu'un fournisseur, une configuration vocale ou une règle de prétraitement change.
Supposons qu'une invite de support contienne le nom de famille d'un client et une date de rendez-vous. Une phrase magnifiquement prononcée qui se trompe sur l'un ou l'autre devrait être inférieure à une alternative moins expressive mais précise.
Rapportez les taux d'échec par catégorie et par gravité. Un score agrégé peut masquer la classe d'erreur même qui devrait bloquer le déploiement.
Adapter les modèles à votre cas d'usage
| Cas d'usage | Critères essentiels | Ce qu'il faut tester en premier |
|---|---|---|
| Messages vocaux pour le support client | Temps avant le premier son, prononciation des noms et codes produit | Un message réaliste contenant un nom et un code via le chemin de lecture téléphonique |
| Narration de livres audio au format long | Prosodie sur plusieurs paragraphes, stabilité sur de longs passages | Cohérence sur un passage étendu avec dialogues et changements de scène |
| Accessibilité et lecteurs d'écran | Intelligibilité, contrôle fiable du débit de parole | Clarté au débit le plus rapide que les utilisateurs sont susceptibles de choisir |
| Doublage vidéo et médias | Gamme émotionnelle, synchronisation avec les clips de référence | Alignement avec la durée et l'émotion du clip de référence |
| Éducation et formation | Prononciation des termes techniques, formules et mots étrangers | Formules, acronymes et noms étrangers du matériel de cours |
La fonctionnalité la plus puissante d'un modèle n'est pertinente que si elle soutient la tâche. La comparaison suivante illustre les différentes priorités.
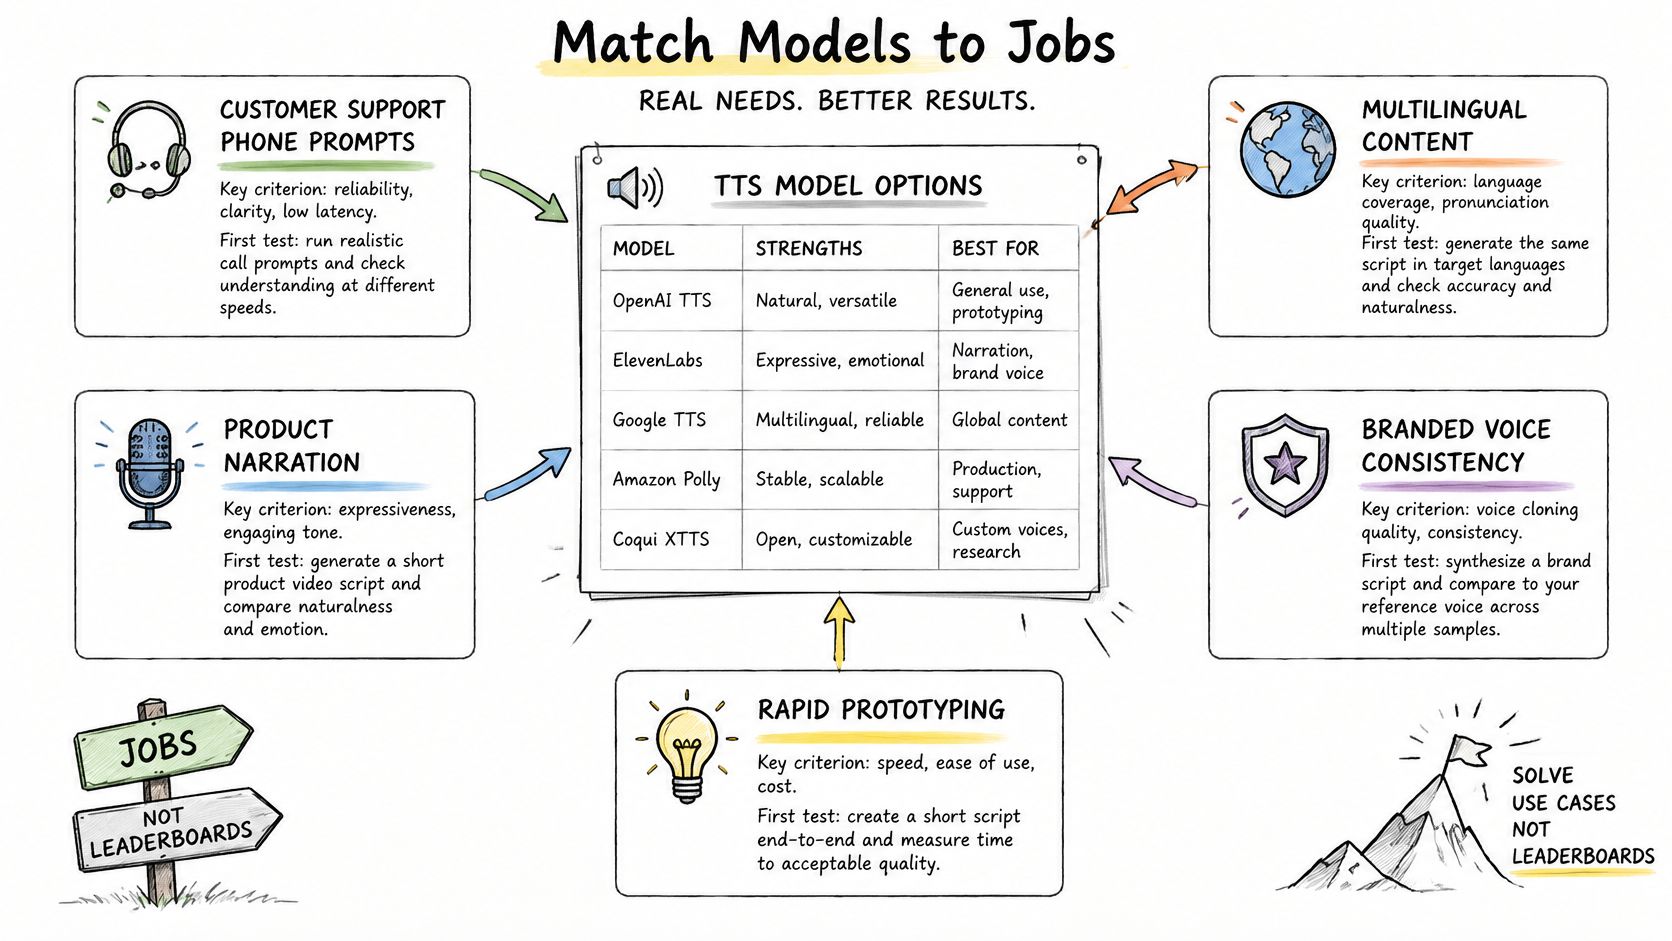
Pour le support client, testez le chemin téléphonique réel plutôt que de vous contenter d'examiner des téléchargements de qualité studio. Pour les livres audio, écoutez au-delà des limites de paragraphe, des changements de locuteur et de la génération reprise, car les phrases isolées n'exercent pas la continuité.
L'évaluation de l'accessibilité devrait inclure les personnes qui utiliseront le résultat et leurs commandes de lecture préférées. Le doublage nécessite une performance de référence et des contraintes de synchronisation ; l'éducation nécessite un examen par des experts du domaine de la notation parlée prévue.
Appliquer des critères éliminatoires avant les préférences
Si la latence définit l'interaction, exigez une interface de streaming adaptée avant de classer les voix. Une réponse retardée peut faire échouer la conception de l'interaction, quelle que soit sa qualité finale.
Si une identité de locuteur spécifique est obligatoire, obtenez l'autorisation avant de créer des clones d'évaluation. Ne faites pas de l'autorisation une préoccupation de production uniquement après que l'équipe se soit attachée à une voix.
Si les codes et les dates transmettent le message, privilégiez leur lecture correcte à l'agrément. Traitez les erreurs de prononciation critiques comme des bloqueurs plutôt que de laisser des scores de style élevés les compenser.
Principe de sélection : Classez les modèles acceptables après avoir appliqué les exigences strictes. Ne faites pas la moyenne d'un échec éliminatoire avec un score autrement attrayant.
Rédigez ces critères éliminatoires avant d'examiner les résultats. Par exemple, un narrateur de cours peut avoir besoin d'un vocabulaire technique fiable mais pas de streaming conversationnel, tandis qu'un assistant vocal peut avoir besoin d'une saisie de texte incrémentielle mais pas de clonage. Cette distinction affine la comparaison sans se fier à un classement universel.
Consentement, Divulgation et Utilisation Sûre de la Voix
Le clonage vocal est une décision de gouvernance, pas seulement un paramètre de synthèse. Le guide sur le TTS responsable décrit la classification par la FCC des voix de robocalls générées par l'IA comme des voix artificielles en vertu du Telephone Consumer Protection Act, rendant illégaux les appels concernés sans le consentement préalable requis. N'interprétez pas cela comme une interdiction générale de la narration synthétique ou comme une permission pour toute utilisation non-robocall.
La narration synthétique ordinaire et le clonage préservant l'identité exigent un examen opérationnel différent. Sélectionner une voix prédéfinie sous licence n'établit pas le droit d'imiter une personne identifiable. Pour les voix personnalisées, la permission documentée de l'orateur devrait être une exigence de déploiement.
Intégrer des Contrôles dans le Chemin de la Requête
- Enregistrer la permission de l'orateur : Conservez l'objectif autorisé, les canaux permis, l'étendue de l'utilisation et les conditions d'expiration ou de révision avec l'enregistrement vocal.
- Rejeter l'imitation non autorisée : Interdisez le clonage de personnes identifiables sans permission écrite et prévoyez un moyen de suspendre les voix contestées.
- Appliquer les règles de divulgation : Étiquetez la parole synthétique lorsque la loi applicable, la politique de la plateforme ou le contexte l'exige.
- Préserver l'auditabilité : Enregistrez l'identifiant du modèle, l'identifiant de la voix, l'heure de la requête et la référence d'autorisation sans dupliquer inutilement du texte sensible.
- Maintenir des alternatives sûres : Approuvez des voix de secours qui ne sont pas destinées à imiter des individus identifiables.
- Conserver les métadonnées du modèle : Stockez les sources de données d'entraînement divulguées, les licences, les restrictions d'utilisation et la documentation d'évaluation pertinente.
Un enregistrement de permission nécessite également un processus de révocation. Décidez qui peut désactiver une voix, comment l'audio mis en cache est géré et ce qu'il advient du contenu programmé lorsque l'autorisation change.
Évaluer Qui le Système Sert
Testez séparément les performances d'accent, de dialecte et de langue. Une moyenne globale peut masquer une mauvaise expérience pour un groupe d'orateurs particulier, alors conservez les résultats au niveau du groupe lorsque la collecte et le rapport sont appropriés.
La gouvernance doit également suivre le routage. Si les requêtes peuvent atteindre différents fournisseurs, ne supposez pas qu'une autorisation vocale ou un accord de traitement s'applique à chaque destination. Restreignez le routage aux combinaisons approuvées de modèle, de voix et de conditions de traitement.
Ceci est une orientation opérationnelle générale, pas un conseil juridique. Vérifiez les lois et les exigences contractuelles qui s'appliquent à l'orateur, au public et au lieu de déploiement avant la publication.
API hébergées ou modèles ouverts auto-hébergés
Le déploiement détermine ce que vous contrôlez et ce que vous devez opérer. Une API hébergée transfère le service du modèle à un opérateur externe. L'auto-hébergement confie à votre équipe la responsabilité de l'exécution (runtime), de la capacité, des mises à jour et des contrôles d'accès.
Les poids ouverts ne signifient pas automatiquement une utilisation commerciale illimitée, une adéquation hors ligne ou de faibles exigences matérielles. Examinez la licence et les exigences d'exécution (runtime) avant d'investir dans l'intégration. De même, un endpoint hébergé ne fournit pas automatiquement des versions fixes ou un arrangement particulier de résidence des données.
| Critère de décision | API hébergée | Modèle ouvert auto-hébergé |
|---|---|---|
| Coût au volume attendu | Frais d'utilisation plus coûts d'intégration et de livraison | Calcul (Compute), stockage, capacité inactive et effort d'ingénierie |
| Latence sous charge maximale | Inclut le chemin réseau et la mise en file d'attente côté service | Dépend du matériel provisionné et de votre planification |
| Résidence des données | Nécessite un examen des lieux et des conditions de traitement | Peut rester au sein de l'infrastructure que vous contrôlez |
| Gestion des versions | Soumis aux options d'épinglage et de mise à jour du service | Votre équipe contrôle les artefacts et le calendrier de déploiement |
Comparez le coût opérationnel global
Le déploiement hébergé peut convenir aux demandes variables et aux équipes qui ne souhaitent pas opérer de matériel d'inférence. Confirmez l'unité de facturation, les limites de concurrence et la manière dont les tentatives (retries) sont gérées avant d'estimer le coût. Un prix basé uniquement sur les caractères ne décrit pas la facture complète de l'application.
L'auto-hébergement peut convenir à un fonctionnement hors ligne ou à des exigences qui interdisent l'envoi de texte et d'enregistrements de référence en dehors d'une infrastructure contrôlée. Il nécessite toujours une planification de la capacité, une surveillance, des mises à jour de sécurité et un processus de publication reproductible. Un modèle qui s'exécute sur une station de travail n'est pas nécessairement prêt pour un trafic de production concurrent.
Considérez la liste du modèle Qwen TTS comme un point de découverte pour un candidat, et non comme une preuve de son adéquation à un arrangement d'hébergement particulier. Confirmez l'exécution (runtime) réelle, la licence et l'interface pour le déploiement que vous évaluez.
Testez le chemin de service, pas seulement les poids
Utilisez le même corpus anonymisé sur les candidats hébergés et auto-hébergés. Maintenez le format de lecture et le client de test cohérents, puis mesurez sous les modèles de concurrence et de requêtes que l'application attend.
Enregistrez si le test inclut le démarrage (startup), le chargement (loading), la mise en file d'attente (queuing) et la conversion. Sinon, un benchmark local "chaud" et une requête distante complète ne sont pas comparables.
Si votre ensemble de test contient des informations personnelles, examinez les conditions de traitement des données avant de les transmettre. Supprimez les identifiants inutiles même lorsque la destination est approuvée, et restreignez l'accès aux enregistrements de référence indépendamment du texte d'application ordinaire.
Présélectionner, Tester et Valider
Une présélection doit exprimer des exigences, et non une familiarité avec une marque. Gardez les candidats qui respectent le contrat d'entrée, les langues requises, les contraintes opérationnelles et les conditions d'autorisation vocale. Excluez les modèles qui ne peuvent pas satisfaire une exigence stricte avant de leur consacrer du temps d'écoute.
Utilisez une procédure de publication qui laisse un enregistrement de décision inspectable :
- Sélectionnez les candidats compatibles. Documentez pourquoi chaque modèle correspond aux entrées et sorties requises. Séparez les fonctionnalités obligatoires des préférences afin que les réviseurs sachent ce qui peut être négocié.
- Exécutez et examinez la suite de tests de textes difficiles. Conservez les sorties brutes, les jugements des auditeurs et les enregistrements de temps. Enquêtez sur les erreurs critiques au lieu d'accepter un score global attrayant.
- Approuvez les droits et les conditions de traitement. Vérifiez la licence du modèle, l'autorisation de l'audio de référence et l'utilisation prévue de chaque voix personnalisée. Attribuez un propriétaire aux conditions non résolues.
- Gelez la configuration approuvée. Épinglez les versions là où c'est pris en charge, enregistrez les paramètres de prétraitement et de livraison, et exigez des tests de régression lorsque la configuration de service change.
Séparez la commodité d'intégration de l'acceptation
UberLLM donne accès aux modèles Claude, GPT, Gemini, DeepSeek, ainsi qu'aux modèles d'images, de vidéos et de musique via un endpoint compatible OpenAI et Anthropic. Une clé API commune et un solde prépayé consolident l'accès, et le changement de l'identifiant du modèle permet des comparaisons de candidats sans intégration de fournisseur séparée pour chaque modèle ; les paramètres de parole spécifiques au modèle doivent toujours être vérifiés.
Qwen3 0.6B TTS est proposé à $0.035 par 1K caractères, contre un prix catalogue de $0.0875 par 1K caractères. Confirmez les prix actuels sur la liste du fournisseur avant d'établir votre budget, et ne comparez les coûts qu'entre les candidats qui répondent aux critères d'acceptation.
Exigez une décision de publication nommée
Attribuez un propriétaire à l'enregistrement de validation et conservez les exemples audio approuvés. Enregistrez explicitement les exceptions, y compris toutes les catégories de texte qui nécessitent un prétraitement, une voix de secours ou une révision humaine.
Une décision de publication doit rester compréhensible après que les personnes qui ont mené l'évaluation soient passées à un autre projet. La vérification finale est simple : Le modèle choisi réussit-il le test de texte difficile, et l'enregistrement de consentement couvre-t-il chaque voix clonée ?
UberLLM offre une API unifiée pour comparer et intégrer la parole aux autres types de modèles. Visitez UberLLM pour inspecter les candidats vocaux, puis faites passer vos noms, codes et dialogues émotionnels anonymisés à travers les modèles qui répondent à vos exigences d'entrée avant de choisir une configuration de production.