Modèles de tarification de l'IA expliqués : Tokens, tâches et coûts
Comparez les modèles de tarification de l'IA : par token, par tâche, par abonnement et par crédit, plus comment estimer ce que votre inférence coûtera réellement.
Vous avez une fonctionnalité d'IA qui fonctionne, et maintenant vous essayez de la tarifer. Le taux de token du modèle semble gérable, mais la facture de staging inclut de longues réponses, des retries, des tool calls et des jobs vidéo qui n'ont jamais produit quelque chose d'utilisable. Multiplier le taux affiché par votre trafic attendu ne vous donne plus un budget crédible.
Les modèles de tarification de l'IA décrivent comment les fournisseurs vous facturent. Le coût par tâche accomplie vous indique si la fonctionnalité est économique. Vous avez besoin des deux perspectives : l'unité de facturation pour rapprocher les frais, et le résultat final pour comparer les modèles, les fournisseurs et les marges produit.
Table des matières
- Six modèles de tarification de l'IA et comment chacun vous facture
- Comment la tarification par token se transforme en facture par requête
- Tarification des médias pour les images, la vidéo et l'audio
- Pourquoi le coût par tâche accomplie est supérieur au coût par token
- Pourquoi les prix des modèles continuent de baisser
- Choisir entre les crédits, les abonnements et la facturation à l'usage
- Liste de contrôle du fournisseur au-delà du prix affiché
- Confirmez votre coût par tâche avant de vous engager
Six modèles de tarification de l'IA et comment chacun vous facture
La plupart des produits d'IA facturent selon l'une des six structures suivantes. Le tableau présente l'unité de facturation, le cas d'utilisation idéal et le risque principal pour chacun.
Modèles de tarification courants de l'IA en un coup d'œil
| Modèle de tarification | Comment vous êtes facturé | Cas d'utilisation idéal | Risque principal |
|---|---|---|---|
| Par token | Par million de tokens d'entrée et de sortie, facturés séparément | Chat, coding, API de texte | La facture augmente avec la longueur de la réponse |
| Par unité média | Par image, par seconde de vidéo ou par tâche de génération | Outils d'image, de vidéo, de parole et de musique | La résolution et la durée modifient le prix unitaire |
| Abonnement avec quotas | Frais mensuels fixes avec un plafond d'utilisation | Produits stables, basés sur le nombre de sièges | Frais de dépassement ou limitation après le plafond |
| Crédits prépayés | Solde déduit par requête | Charges de travail variables sur plusieurs fournisseurs | Le solde non utilisé peut expirer |
| Basé sur le résultat | Frais par tâche accomplie ou cas résolu | Agents de support, flux de travail à succès clair | Définir le succès est difficile |
| Hybride | Abonnement de base plus utilisation mesurée ou crédits | Produits avec des charges de travail mixtes texte et média | Deux composantes de facturation à concilier |
Faire correspondre l'unité à la charge de travail
La facturation par token convient aux charges de travail textuelles car elle mesure le matériel traité et généré. Elle est utile pour le chat et le coding, mais une instruction de produire une explication détaillée peut modifier la facture sans changer le nombre de requêtes.
La facturation par unité média est plus facile à comprendre au premier coup d'œil : payez pour une image ou une tâche de génération. La difficulté réside dans la définition de cette unité, incluant la résolution, la durée, les paramètres de qualité et le son.
Les abonnements avec quotas fonctionnent lorsqu'une équipe a besoin d'un accès régulier et peut rester dans une allocation prévisible. Vérifiez ce qui se passe au plafond avant de considérer l'abonnement comme un coût d'exploitation fixe.
Les crédits prépayés placent les dépenses derrière un solde provisionné. Ils conviennent à l'expérimentation sur différents modèles, à condition de comprendre l'expiration, les remboursements et la façon dont les crédits se traduisent en utilisation réelle.
La tarification basée sur le résultat rapproche la facturation de la valeur commerciale. Un flux de travail de support nécessite cependant un test de résolution explicite, y compris ce qui se passe lorsque le client rouvre le cas.
Les plans hybrides combinent l'accès ou une allocation incluse avec une consommation variable. Ils peuvent s'adapter à des charges de travail mixtes, mais les finances doivent concilier à la fois le coût de base et la composante mesurée.
Règle pratique : Identifiez l'unité que le fournisseur facture avant de comparer tout prix affiché.
Un abonnement n'est pas automatiquement moins cher que la facturation à l'usage, et les crédits ne sont pas automatiquement une réduction. Traduisez chaque offre en fonction de la charge de travail que vous comptez exécuter, y compris toute allocation que vous paierez mais n'utiliserez pas.
Comment la tarification des tokens se traduit en facture par requête
Coût de la requête = (tokens d'entrée ÷ tokens par unité de tarification × taux d'entrée) + (tokens de sortie ÷ tokens par unité de tarification × taux de sortie).
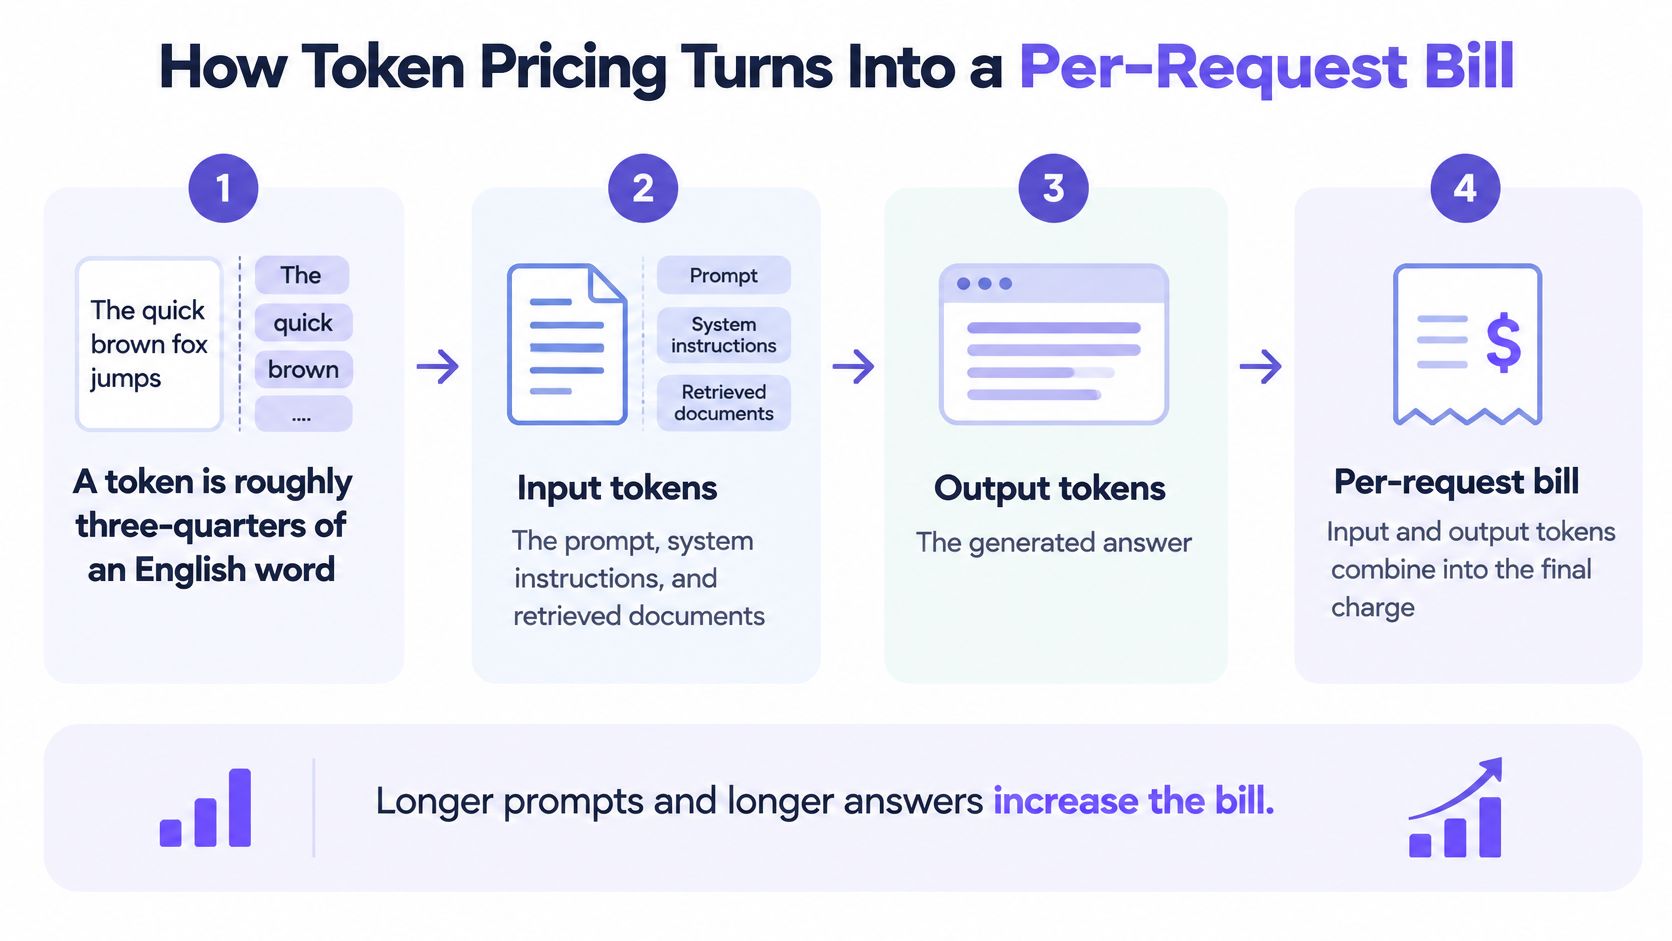
Pour les prix indiqués par million de tokens, utilisez un million comme diviseur. Les tokens d'entrée incluent le prompt, les instructions système, l'historique de conversation et les documents récupérés. Les tokens de sortie couvrent la réponse générée. Utilisez le tokenizer du modèle ou les champs d'utilisation retournés plutôt qu'une approximation par le nombre de mots, en particulier pour le code et le texte multilingue.
Des tarifs distincts sont importants. Une analyse arXiv de la tarification des API rapporte que GPT-4 a été lancé en mars 2023 à $30 par million de tokens d'entrée et $60 par million de tokens de sortie. La génération nécessite des calculs différents de ceux du traitement d'un prompt, ne supposez donc pas que les deux taux correspondent.
Passez une requête au travers des deux taux
Considérons une requête hypothétique contenant 2,000 tokens d'entrée et 800 tokens de sortie. Claude Opus 5.5 coûte $4.00 en entrée et $20.00 en sortie par million de tokens au prix catalogue, comparé à $2.03 en entrée et $10.13 en sortie sur UberLLM.
| Composant | Au prix catalogue | Via notre marketplace |
|---|---|---|
| Calcul d'entrée | 2,000 ÷ 1,000,000 × $4.00 | 2,000 ÷ 1,000,000 × $2.03 |
| Coût d'entrée | $0.008 | $0.00406 |
| Calcul de sortie | 800 ÷ 1,000,000 × $20.00 | 800 ÷ 1,000,000 × $10.13 |
| Coût de sortie | $0.016 | $0.008104 |
| Total | $0.024 | $0.012164, environ $0.012 |
Ces calculs décrivent la requête hypothétique, et non une moyenne pour votre application. Pour un million de requêtes hypothétiques par mois avec exactement ce mélange de tokens, la différence est de $11,836, soit environ $12,000. Une longueur de sortie différente modifie le résultat.
Le flux de facturation facilite l'inspection de la distinction entre la taille du prompt et la taille de la réponse.
Établissez votre estimation à partir de requêtes réelles
- Comptez les tokens d'entrée en utilisant votre modèle de prompt et des données client représentatives. Incluez les instructions et le contexte récupéré.
- Estimez les tokens de sortie à partir des réponses acceptées, pas seulement de la démonstration réussie la plus courte.
- Appliquez chaque taux séparément à son nombre de tokens correspondant.
- Additionnez les résultats pour obtenir le coût du modèle pour cette requête.
- Multipliez par le volume attendu, en gardant les classes de requêtes courtes et longues séparées.
Notre prix de modèle affiché décrit ce qu'une requête coûte typiquement, et non un plafond. Une requête n'est jamais facturée au-delà d'un max_price ou max_cost envoyé avec elle. Gardez cette distinction explicite dans votre application : une estimation aide à prévoir les dépenses, tandis qu'un plafond de requête impose une limite.
Tarification des médias pour les images, la vidéo et l'audio
Exemples de prix unitaires des médias, prix catalogue versus UberLLM
| Modèle | Unité de facturation | Prix catalogue | Prix UberLLM |
|---|---|---|---|
| Flux 2 image Pro | Par image | $0.03 | $0.0075 |
| LTX 2.3 Fast Text to Video | Par tâche | $0.06 | $0.045 |
| Veo 3.1 Full Text-to-Video | Par tâche | $0.44 | $0.22 |
Le prix Flux est 75% inférieur, calculé à partir des prix d'image indiqués. LTX est 25% inférieur, et Veo est 50% inférieur. Chaque comparaison s'applique uniquement au modèle nommé et au paramètre correspondant, et non à chaque demande d'image ou de vidéo.
Les produits multimédias sont souvent facturés en unités autres que les tokens de texte. Une tâche de génération, une image, une durée audio ou une durée vidéo devient l'unité que vous devez normaliser. Le choix du modèle et les paramètres de sortie déterminent ce que cette unité représente.
Comparer des paramètres de génération identiques
Un court clip bon marché ne remplace pas l'actif plus long et de plus haute résolution dont votre produit a besoin. Le son compte aussi : un aperçu silencieux et un clip audiovisuel fini ne sont pas des livrables équivalents.
Avant de comparer les fournisseurs, définissez précisément :
- Modèle et tâche : Gardez la version du modèle et le mode de génération identiques, y compris text-to-video versus image-to-video.
- Résolution et durée : Enregistrez les dimensions et la durée du clip demandées plutôt que de vous fier au nom d'un modèle.
- Paramètre audio : Spécifiez si le son généré est inclus.
- Définition de la tâche : Confirmez ce qu'une tâche inclut et si les extensions, l'upscaling ou les sorties supplémentaires nécessitent des demandes distinctes.
Le guide de prix par seconde de l'API Veo aide à encadrer les comparaisons basées sur la durée. Ne convertissez pas un devis par tâche en un tarif par seconde tant que vous ne connaissez pas la durée que ce devis couvre.
Une comparaison de prix média n'est utile que lorsque les deux prix achètent le même livrable.
Pour l'audio, distinguez la parole générée de la transcription et de la génération de musique. La durée de l'audio téléchargé et la durée de la sortie générée sont des mesures différentes, alors enregistrez celle que le service facture.
Conservez un petit manifeste de paramètres à côté de votre feuille de calcul de prix : identifiant du modèle, tâche, dimensions, durée, audio et toutes les options de qualité. Évaluez ce manifeste avec chaque fournisseur, puis enregistrez le devis et la configuration ensemble. Vous pouvez répéter la comparaison lorsque les prix changent sans comparer accidentellement un produit différent.
Pourquoi le coût par tâche accomplie l'emporte sur le coût par token
Le tarif de token le moins cher peut produire la tâche finie la plus coûteuse. Un modèle qui nécessite des corrections répétées, des appels d'outils inutiles ou une réparation manuelle peut consommer des tokens moins chers tout en coûtant plus cher pour fournir un résultat utilisable.
La différence devient visible lorsque vous comparez une réponse directe à un workflow qui continue de prendre des actions.
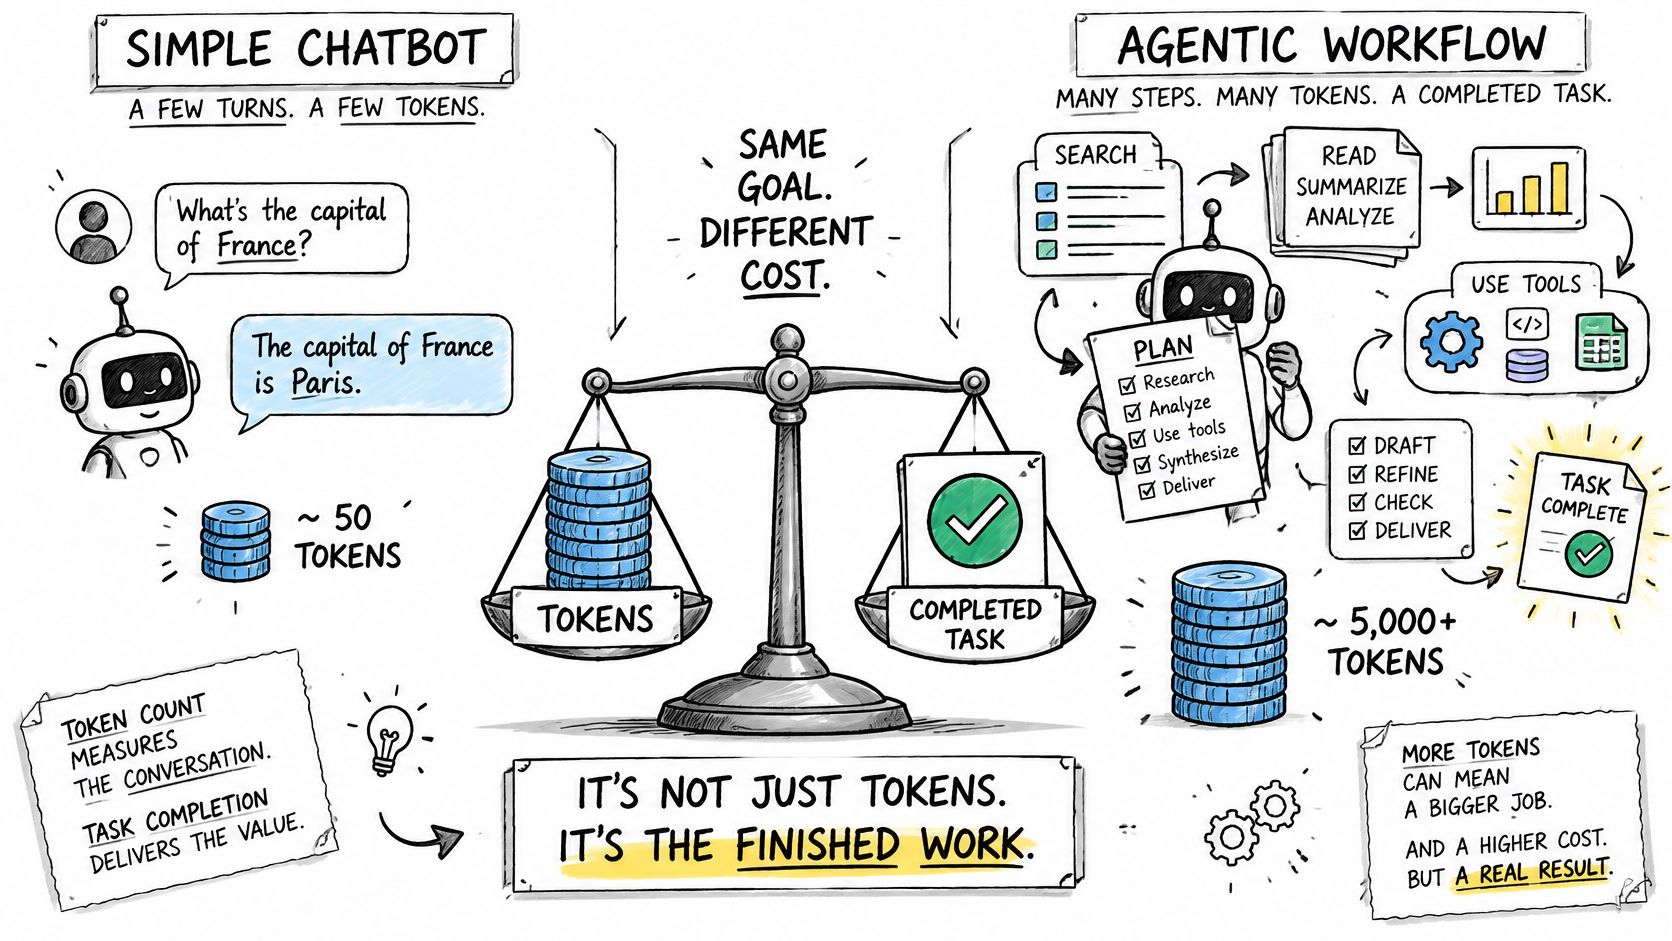
L'analyse des coûts des workflows agentiques d'Oometa décrit les workflows agentiques consommant 5–30 fois plus de tokens qu'une interaction de chatbot conventionnelle et estime environ $0.001 pour un appel de chatbot simple contre $0.10–$1.00 pour une tâche d'agent en plusieurs étapes. Considérez ces chiffres comme un contexte, pas comme votre prévision : la planification, la récupération, les outils, la réflexion et les tentatives diffèrent selon l'implémentation.
Incluez le travail infructueux dans le numérateur
Coût par résultat réussi = dépenses totales liées à la tâche ÷ tâches accomplies avec succès.
Dans un lot hypothétique, 1,000 tentatives à $0.10 chacune coûtent $100. Si 800 réussissent, le coût par tâche résolue est de $0.125, et non $0.10. Les tentatives infructueuses doivent toujours être incluses dans le calcul des coûts.
Une deuxième comparaison hypothétique montre pourquoi les prix affichés sont trompeurs :
| Modèle hypothétique | Coût par tentative | Taux de succès | Coût par succès |
|---|---|---|---|
| Modèle moins cher | $0.05 | 30% | Environ $0.167 |
| Modèle plus cher | $0.10 | 90% | Environ $0.111 |
Ce sont des exemples arithmétiques, pas des performances de modèle mesurées. Ils supposent des tentatives comparables et un taux de succès inchangé ; votre évaluation doit établir les deux.
La vidéo offre une autre façon de considérer les coûts de workflow.
Suivez la longueur de la sortie, les tentatives, les replis basés sur la latence et les frais pour les requêtes infructueuses par rapport à un identifiant de tâche partagé. Incluez les coûts d'outils ou d'infrastructure lorsqu'ils sont significatifs, et distinguez une réponse d'API d'un succès commercial.
Une réponse de support qui nécessite qu'un employé la réécrive n'équivaut pas à un ticket résolu. Utilisez le résultat dont votre client a besoin : un cas résolu, un clip accepté ou une tâche de codage qui passe ses tests d'acceptation.
Pourquoi les prix des modèles continuent de baisser
Le modèle le moins cher atteignant les performances de niveau GPT-3.5 sur MMLU est passé d'environ $20 par million de tokens en novembre 2022 à $0.07 en octobre 2024, soit environ 286 fois moins cher, selon le résumé d'Orb des chiffres rapportés par Stanford. Le Rapport sur l'indice de l'IA 2025 de Stanford décrit la baisse des coûts d'inférence à capacité équivalente sur cette période comme étant plus de 280 fois.
Cette comparaison maintient le seuil de référence constant. Elle ne compare pas simplement un modèle coûteux et performant à un modèle moins cher et plus faible, bien que l'atteinte d'un benchmark ne garantisse toujours pas un comportement équivalent sur votre application.
Budgétiser pour une offre changeante, pas un taux permanent
Des architectures plus petites, la quantification, l'amélioration des logiciels d'inférence, le matériel spécialisé et la concurrence entre les fournisseurs contribuent à la baisse des coûts. Chacun affecte une partie différente de l'économie : la taille du modèle, la précision numérique, l'efficacité de la diffusion, l'utilisation du matériel ou la marge du fournisseur.
Pour les acheteurs, l'implication pratique est de séparer une hypothèse de prix d'une hypothèse de qualité. Un taux plus bas n'est utile que si le candidat répond toujours à vos critères d'acceptation.
- Tenir un registre des prix daté : Enregistrez l'identifiant du modèle, les taux d'entrée et de sortie, l'unité de facturation et la date à laquelle vous les avez consultés.
- Utiliser des scénarios budgétaires : Modélisez la demande prévue en parallèle d'une charge de travail plus lourde avec des sorties plus longues et des tâches plus complexes.
- Planifier des révisions : Réexaminez les taux trimestriellement et enquêtez sur les écarts de facture importants avant la prochaine révision prévue.
Un indice de prix des modèles peut aider à identifier les candidats méritant d'être retestés. Il ne devrait pas remplacer le registre des prix joint à vos propres journaux de requêtes.
Notre prix affiché est mis à jour toutes les 5 minutes. Il utilise le prix catalogue du fournisseur multiplié par la part du prix catalogue facturée pendant l'heure la plus chère échangée sur le marché au cours des dernières 24 heures, et n'est jamais inférieur à l'offre la moins chère.
Vérifiez les conditions contractuelles de modification des prix séparément de votre calendrier de révision. Un rappel de calendrier ne rend pas un taux variable fixe, et les baisses historiques ne garantissent pas que chaque voie deviendra moins chère.
Choisir entre les crédits, les abonnements et la facturation à l'usage
Une étude arXiv sur la tarification des produits d'IA a révélé que les abonnements avec quotas d'utilisation constituaient le modèle de tarification natif de l'IA le plus répandu parmi 52 produits ; 25 proposaient un niveau gratuit, un essai ou des crédits de démarrage, tandis que 13 utilisaient une tarification d'entrée au fur et à mesure. Ce modèle n'établit pas de gagnant universel. Il montre pourquoi la facturation à la pure consommation n'est pas la seule structure sensée.
La décision porte sur qui assume le risque d'une utilisation variable. Un abonnement transfère une partie du risque de demande vers le fournisseur, tandis que les structures prépayées et mesurées rendent la consommation plus visible pour l'acheteur.
Utilisez vos contraintes opérationnelles pour choisir
| Question | Ce que la réponse suggère |
|---|---|
| L'utilisation mensuelle est-elle stable ? | Un abonnement avec un quota utilisable peut simplifier la budgétisation |
| Utiliserez-vous plusieurs fournisseurs ou modalités ? | Un solde prépayé partagé peut réduire le financement fragmenté |
| Pouvez-vous prévoir la consommation de manière fiable ? | La mesure est plus facile à gérer lorsque les estimations de charge de travail sont fiables |
| Les finances exigent-elles un plafond strict ? | Privilégiez les limites exécutoires aux étiquettes de facturation |
Une utilisation stable avec un seul fournisseur oriente vers un abonnement, à condition que l'allocation corresponde à votre charge de travail réelle. Ne considérez pas le quota inutilisé comme une valeur, et vérifiez si les dépassements nécessitent une approbation ou se produisent automatiquement.
Une demande inégale sur plusieurs modèles oriente vers les crédits ou la facturation à l'usage. Les conditions d'expiration et de report sont importantes car l'achat d'une capacité que vous n'utilisez jamais peut annuler une remise apparente.
Séparer le financement de la facturation
Un portefeuille prépayé décrit quand vous financez l'utilisation, pas nécessairement comment chaque requête est tarifée. De même, le paiement au fur et à mesure peut fonctionner via un solde prépayé plutôt qu'une facture post-payée.
Nous n'avons pas de frais mensuels et pas de minimum. Les clients conservent un seul solde et paient au fur et à mesure. Notre option de paiement upto, proposée en premier, fait signer au portefeuille un devis comme plafond ; après la réponse, seul le coût réel est prélevé, arrondi au millionième de dollar supérieur.
Choisissez la contrainte sur laquelle vous ne pouvez pas transiger avant de choisir le plan.
Si cette contrainte est un budget fixe, examinez les contrôles de dépenses. S'il s'agit d'un accès prévisible pour une équipe stable, examinez les règles de quota et de dépassement. S'il s'agit de flexibilité entre le texte et les médias, vérifiez si le même solde prend en charge les flux de travail que vous avez l'intention d'exécuter.
Liste de contrôle du fournisseur au-delà du prix affiché
Une grille tarifaire ne vous dit pas tout ce qu'il faut pour rapprocher une facture de production. Testez le comportement de facturation, pas seulement l'arithmétique affichée dans un environnement de test (playground).
Utilisez cette liste de contrôle pour identifier les conditions qui nécessitent une réponse concrète.
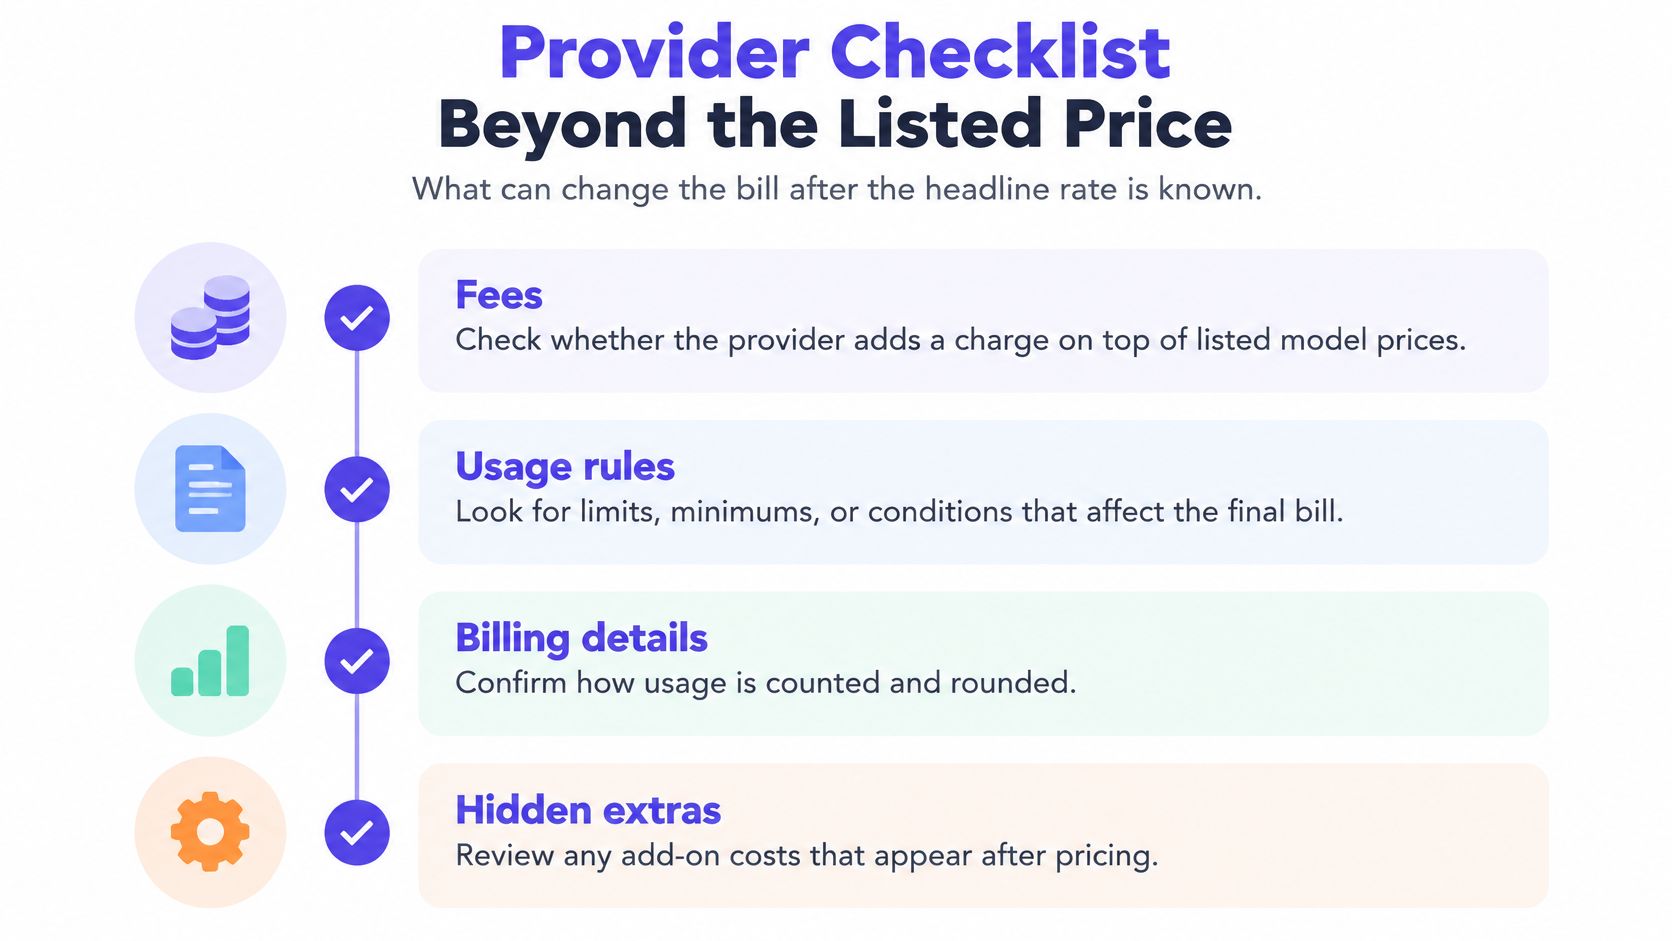
Vérifiez le chemin de facturation
- Les frais sont explicites. Nous n'ajoutons aucun frais en plus des prix des modèles affichés. Gardez les frais de financement séparés des frais de requête lors de la comparaison des dépenses totales. Une mauvaise réponse est un devis qui exclut une surtaxe de plateforme non spécifiée.
- La base de facturation est traçable. Lorsque le fournisseur indique ce qu'il a facturé pour un appel, nous facturons exactement ce montant. Sinon, l'appel coûte ses tokens au prix affiché. Une mauvaise réponse est un total de facture qui ne peut pas être lié à l'utilisation au niveau de la requête ou aux frais signalés.
- Les requêtes infructueuses ont un traitement défini. Nos requêtes et générations échouées ne coûtent rien. Une génération terminée que vous n'aimez pas, cependant, ne devrait pas être automatiquement classée comme un échec technique. Une mauvaise réponse laisse la distinction indéfinie.
Vérifiez le chemin de contrôle
- Les clés offrent une isolation. Nos API keys sont délimitées et révocables, et des limites de dépenses par clé s'appliquent. Un appel d'outil MCP est facturé, limité et refusé comme la requête API équivalente. Une mauvaise réponse exige de désactiver chaque service pour arrêter une seule intégration compromise.
- Le comportement de repli est compréhensible. Nous déplaçons les requêtes vers un autre vendeur sain lorsqu'un fournisseur devient lent ou indisponible. Testez la facturation et le timing résultants dans vos logs. Un fournisseur qui ne peut pas expliquer si un itinéraire alternatif modifie la facturation vous laisse avec un prix inconnu.
Pour les charges de travail mixtes, examinez comment une API unifiée de texte, d'image et de vidéo expose l'état et les résultats des tâches. Une requête média asynchrone nécessite un identifiant de tâche durable afin que la soumission, l'achèvement et la facturation puissent être rapprochés même lorsqu'ils se produisent à des moments différents.
Effectuez ces vérifications sur un trafic représentatif de production, y compris les timeouts, les annulations et les jobs échoués. Un compte de démonstration avec des prompts courts et des réponses réussies ne révélera pas si votre comptabilité survit aux conditions que votre application doit gérer.
Confirmez le coût par tâche avant de vous engager
Utilisez une évaluation bornée plutôt que de migrer en vous basant uniquement sur un tableau de prix. L'objectif est de découvrir quelle option fournit des résultats acceptables à un coût d'exploitation acceptable, sans modifier la charge de travail.
Menez une comparaison contrôlée
- Sélectionnez des tâches représentatives. Incluez les requêtes de routine, les cas difficiles, les contextes longs et les entrées qui ont précédemment posé problème. N'incluez pas de données client sensibles dans une évaluation, sauf si leur utilisation est autorisée.
- Capturez l'historique d'exécution. Enregistrez les tokens d'entrée et de sortie, les identifiants de tâche, les tentatives, les appels d'outils, les frais et les jugements de succès. Enregistrez le temps nécessaire pour obtenir un résultat utilisable, pas seulement le temps de la première réponse.
- Calculez la base de référence actuelle. Divisez toutes les dépenses pertinentes par les résultats acceptés. Gardez les classes de tâches séparées afin que les requêtes faciles ne masquent pas une mauvaise économie sur le travail difficile.
- Testez des modèles alternatifs. Préservez les prompts, les entrées, les permissions d'outils et les tests d'acceptation. Avec notre accès API commun, changer de modèle utilise un identifiant de modèle différent, et chaque requête est acheminée vers le vendeur sain le moins cher.
- Appliquez un budget de requêtes. Choisissez des limites appropriées à chaque classe de tâche et vérifiez comment l'application gère les refus ou le travail incomplet. Une limite doit produire une expérience utilisateur contrôlée, et non une erreur inexpliquée.
- Comparez les résultats opérationnels ensemble. Évaluez le coût par succès, la latency et le taux d'échec. Inspectez les sorties réelles lorsque la notation automatisée peut manquer des erreurs factuelles ou un travail incomplet.
- Pilotez avant de vous engager. Envoyez une petite part contrôlée du trafic réel au candidat. Rapprochez les frais facturés de vos logs pendant le pilote, et conservez un chemin de retour arrière jusqu'à ce que la qualité et la comptabilité soient fiables.
Rendez la décision reproductible
Notez les critères d'acceptation avant d'examiner les noms et les prix des modèles. Sinon, il est facile d'excuser une sortie plus faible parce qu'un candidat semble moins cher.
Maintenez l'ensemble d'évaluation versionné et ajoutez de nouveaux cas d'échec à mesure que l'application évolue. Planifiez la prochaine révision trimestriellement, avec un nouveau test plus tôt lorsqu'un changement significatif de modèle, de prix ou de produit rend la comparaison existante peu fiable.
L'option gagnante n'est pas le modèle le moins cher isolément. C'est la configuration qui complète votre charge de travail dans le respect de vos contraintes de qualité, de latency et de budget.
UberLLM offre une seule API key pour les modèles de texte et de média, un solde prépayé partagé et un routage vers le vendeur sain le moins cher pour chaque modèle demandé. Visitez UberLLM pour comparer les prix actuels, puis testez des tâches représentatives et mesurez le coût des résultats acceptés avant de déplacer le trafic de production.