Modelos de Texto para Fala: Capacidades e Guia de Seleção
Explore os modelos de texto para fala por entrada, saída, clonagem de voz, métricas de qualidade e regras de consentimento, com tabelas e um checklist de seleção para 2026.
Vozes neurais e geradas por IA representaram 67.90% da receita do mercado de síntese de voz em 2024, segundo relatório de tendências do setor da Sonix. Isso mede receita, não confiabilidade. Para um desenvolvedor escolhendo modelos de síntese de voz, a pergunta mais difícil é se uma voz consegue entregar os nomes, códigos, instruções e diálogos emocionais que uma aplicação envia.
Uma demo agradável não responde a essa pergunta. Trate a seleção de modelo como um contrato de entrada e saída, seguida de uma avaliação com textos de produção. Arquitetura, similaridade de voz e naturalidade média importam, mas nenhuma delas deve se sobrepor a uma falha que muda o que o ouvinte entende.
Sumário
- Capacidades, Entradas e Saídas em Resumo
- Famílias de Arquitetura e o Que Significam
- Clonagem de Voz, Escala e Cobertura de Idiomas
- Métricas de Qualidade Que Vão Além do MOS
- Construindo um Conjunto de Testes para Texto Difícil
- Combinando Modelos ao Seu Caso de Uso
- Consentimento, Divulgação e Uso Seguro da Voz
- APIs Hospedadas ou Modelos Abertos Auto-Hospedados
- Lista Curta, Teste e Aprovação Final
Capacidades, Entradas e Saídas em Resumo
| Capacidade | Entrada típica | Saída típica | Use quando |
|---|---|---|---|
| TTS Padrão | Texto simples | Arquivo de áudio ou stream | Você precisa de narração a partir de texto fixo ou fornecido pelo usuário |
| TTS por Streaming | Blocos de texto à medida que são gerados | Blocos de áudio na ordem de reprodução | O áudio deve começar antes que o texto completo esteja pronto |
| TTS controlado por Marcação ou Estilo | Texto com SSML ou tags de estilo | Áudio com pausas, ênfase ou emoção definidas | A pronúncia e o ritmo devem ser controlados |
| Clonagem de Voz | Texto mais áudio de referência com consentimento documentado | Áudio na voz do locutor de referência | Uma voz de marca ou de usuário deve ser reproduzida |
| TTS Multilíngue | Texto em vários idiomas | Áudio em cada idioma, com uma ou muitas vozes | Um produto atende usuários em muitos idiomas |
TTS Padrão é o contrato mais simples: envie texto e receba fala. Use-o para narrações preparadas, notificações e passagens cuja redação já está completa. Um arquivo para download é adequado para edição e caching; uma resposta por streaming pode evitar a espera pelo arquivo de áudio completo.
TTS por Streaming precisa de uma inspeção mais detalhada. Alguns serviços transmitem áudio após receber uma entrada de texto completa, enquanto outros também aceitam texto incremental. Se um assistente gera sua resposta progressivamente, confirme se a interface suporta esta última opção, em vez de assumir que streaming significa ambas as direções.
Síntese controlada por marcação adiciona instruções de entrega. SSML, controles de pronúncia e tags de estilo proprietárias não são intercambiáveis, então teste a sintaxe exata que seu modelo selecionado aceita. Instruções não suportadas podem ser ignoradas, rejeitadas ou faladas em voz alta.
A clonagem adiciona uma entrada de locutor de referência, enquanto a síntese multilíngue adiciona cobertura de idioma. Nenhuma inclui automaticamente a outra: uma voz predefinida multilíngue não é necessariamente clonável, e uma voz clonada não é necessariamente confiável em todos os idiomas suportados.
Escolha o Contrato de Áudio Antes da Voz
WAV é um contêiner; PCM descreve uma representação de áudio. PCM não compactado, frequentemente empacotado em WAV, é conveniente para edição e processamento. Pipelines de telefonia precisam da codificação, configuração de canal e taxa de amostragem que seus sistemas downstream esperam, não apenas um arquivo com uma extensão familiar.
MP3 e Opus são opções de entrega compactadas para navegadores e aplicativos, sujeitas ao suporte do cliente. Selecione um formato que seu player possa decodificar sem uma etapa extra de conversão. Caso contrário, seu desempenho de síntese medido não descreverá o atraso que os usuários experimentam.
Taxa de amostragem especifica a frequência com que o áudio é amostrado. Ela afeta a faixa de frequência representada e, para áudio não compactado com outras configurações fixas, o tamanho do arquivo. Aumentar a taxa de amostragem de saída não corrige pronúncias pouco claras nem restaura detalhes que o modelo nunca gerou.
Antes da integração, anote o contrato:
- Restrições de entrada: Comprimento de texto aceito, marcação suportada e comportamento de entrada incremental.
- Disponibilidade de voz: Idiomas, dialetos, vozes predefinidas e acesso a vozes personalizadas necessários.
- Requisitos de saída: Codificação, taxa de amostragem, canais e comportamento de streaming.
- Comportamento em caso de falha: Como o aplicativo lida com texto rejeitado, streams interrompidos e vozes indisponíveis.
Leia a tabela da esquerda para a direita: combine a entrada que você tem com a saída que você precisa e, em seguida, verifique se o caso de uso se encaixa. Uma voz que soa excelente, mas requer o padrão de interação errado, deve ficar fora da lista de pré-selecionados.
Famílias de arquitetura e o que elas significam
| Família | Como ela produz fala | Principal trade-off |
|---|---|---|
| Concatenativa | Une unidades de fala pré-gravadas | Natural dentro do domínio gravado, fraca fora dele |
| Paramétrica estatística | Prevê características acústicas e depois um vocoder renderiza o áudio | Flexível, mas muitas vezes abafada |
| Forma de onda neural | Gera amostras de áudio com uma rede neural | Alta naturalidade, computacionalmente pesada sem otimização |
| Neural baseada em tokens | Prevê códigos de áudio discretos a partir do texto | Escala bem com dados, exige controle cuidadoso de estilo e locutor |
As principais distinções de pipeline são ilustradas abaixo.
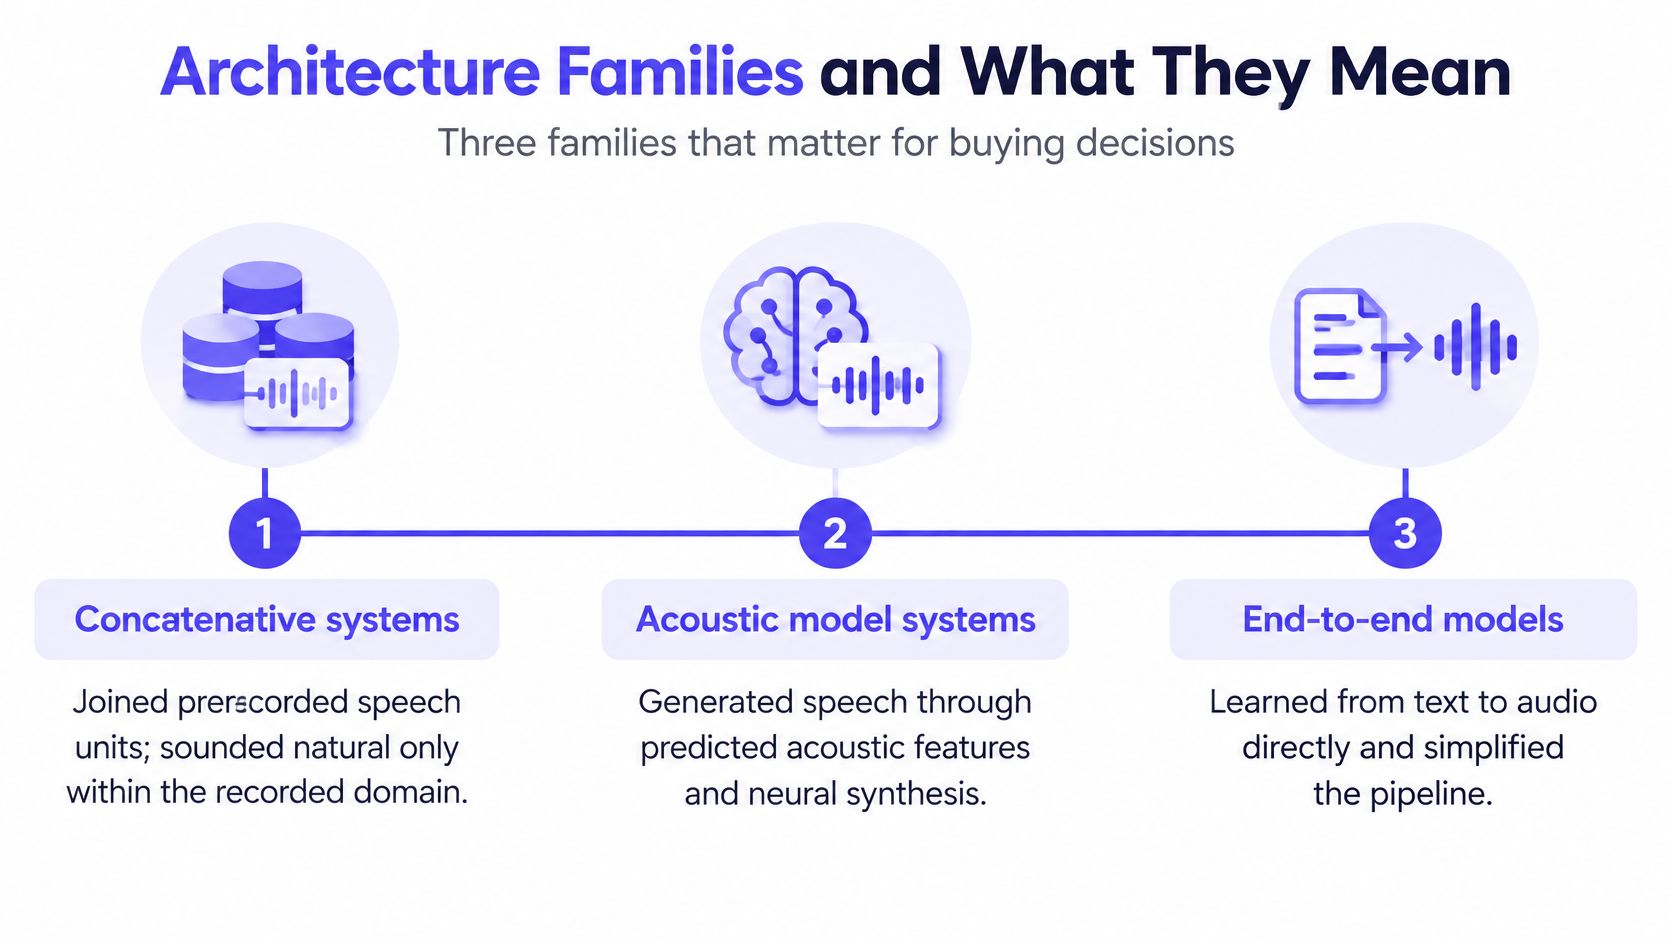
Sistemas concatenativos montam unidades gravadas, então sua flexibilidade é limitada pelas gravações disponíveis e pelas junções entre elas. Sistemas paramétricos estatísticos, em vez disso, preveem propriedades acústicas e depois renderizam a fala por meio de um vocoder, trocando o reúso direto de gravações por um pipeline de síntese mais controlável.
Um marco chegou com WaveNet em 2016: o artigo do WaveNet relatou uma redução de mais de 50% na lacuna de qualidade entre os sistemas TTS existentes mais fortes e a fala humana em suas avaliações de inglês americano e mandarim. Essa descoberta estabeleceu a importância da geração de forma de onda neural, não uma garantia universal de desempenho para todo modelo neural posterior.
Sistemas neurais baseados em tokens preveem representações de áudio discretas que um decodificador transforma em som. Para decisões de compra, diferencie essa representação da interface do serviço: um produto ponta a ponta ainda pode conter vários estágios internos de processamento.
Leia as fichas de modelo como descrições de pipeline
Procure por espectrograma, vocoder, codec, tokens de áudio e detalhes de condicionamento de locutor. Um estágio de espectrograma seguido por um vocoder sugere um pipeline de modelo acústico; códigos de áudio discretos sugerem geração baseada em tokens. Descrições de treinamento ajudam a explicar o design, mas não substituem o teste da saída.
Para dispositivos com restrições, compare memória, tempo de execução e compatibilidade de hardware reais em vez de assumir que mais antigo significa menor ou que mais novo significa exclusivo de nuvem. Em implantação hospedada, inspecione a latência e os controles entregues em vez de inferi-los do rótulo da arquitetura.
A fronteira também importa para tarefas adjacentes. Um guia de síntese de voz cantada aborda um problema de controle diferente: a prosódia falada não substitui timing musical e altura tonal explícitos.
Regra prática: Use a arquitetura para entender restrições prováveis e perguntas de diagnóstico úteis, não para declarar um vencedor antes de ouvir.
Clonagem de Voz, Escala e Cobertura de Idiomas
A clonagem de voz separa a identidade do falante das palavras que estão sendo faladas. Avalie essas dimensões de forma independente: uma saída pode se parecer com o falante de referência enquanto entrega a frase com uma emoção inadequada.
As principais rotas de clonagem diferem na forma como estabelecem essa identidade.
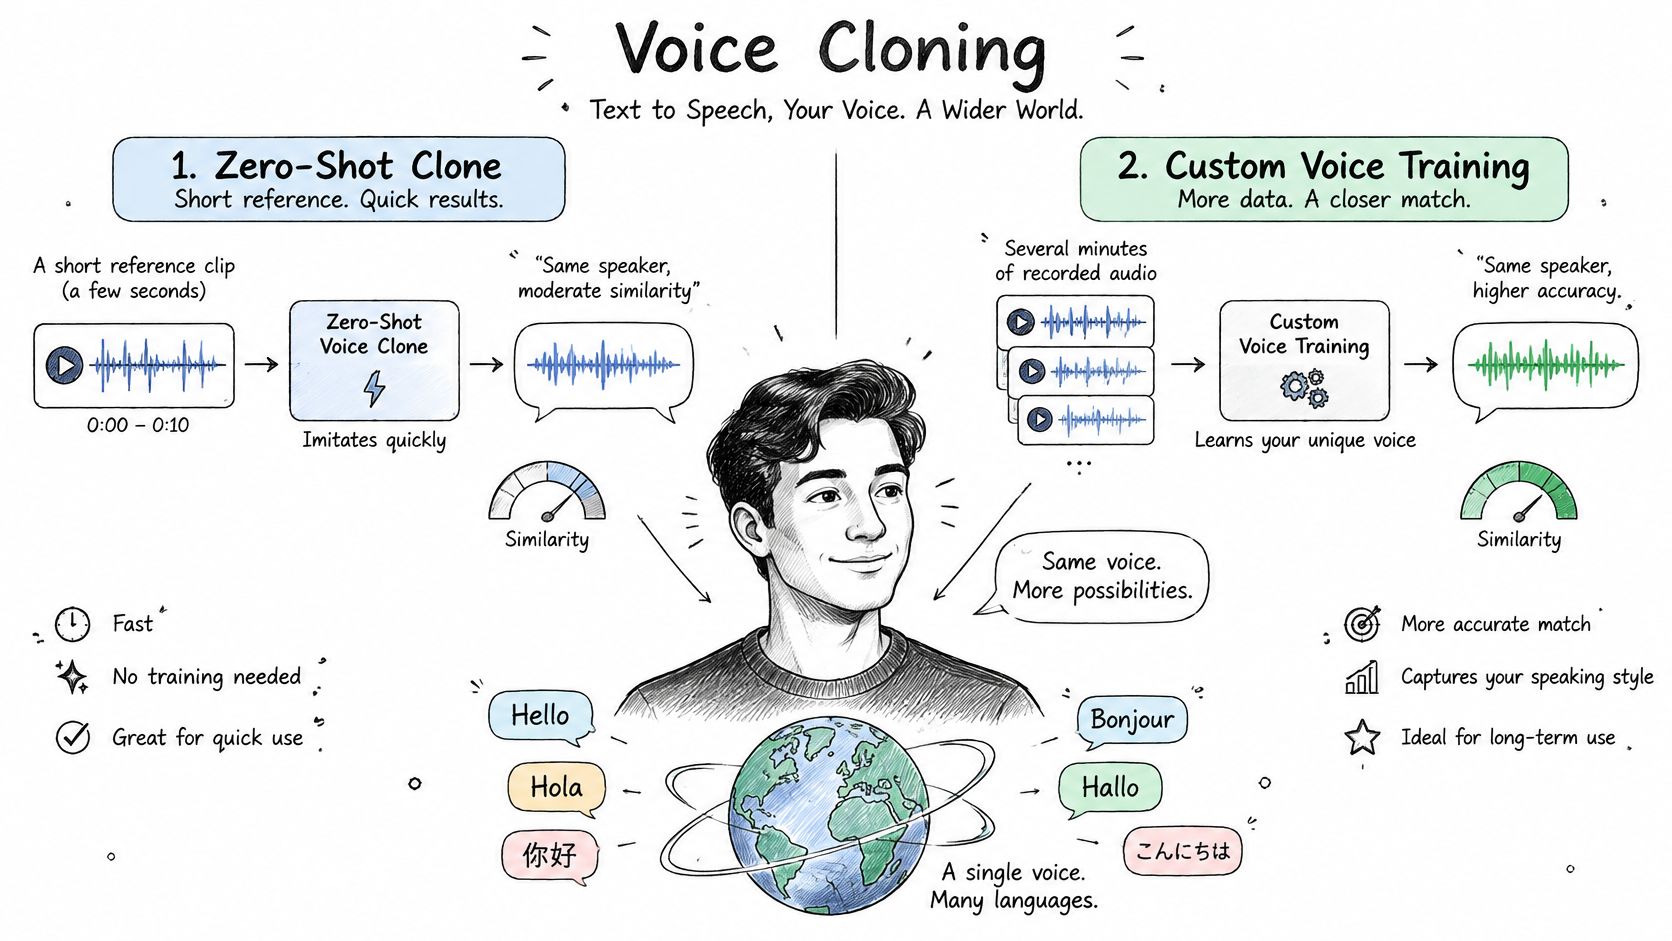
Clonagem zero-shot condiciona a síntese ao áudio de referência sem um trabalho de treinamento separado específico para o falante. Treinamento de voz personalizado adapta um modelo usando um conjunto de dados de falante preparado. O primeiro reduz o trabalho de configuração; o segundo adiciona requisitos de gravação, preparação e treinamento, sem tornar a semelhança automática.
A qualidade da referência merece um teste próprio. Ruído de fundo, falantes concorrentes, posicionamento inconsistente do microfone e estilos de entrega muito diferentes podem dificultar determinar o que o sistema deve preservar. Compare referências limpas antes de atribuir um resultado fraco inteiramente ao modelo de síntese.
Separe a semelhança do desempenho
Considere uma comparação hipotética entre uma referência curta e neutra e uma referência mais longa contendo várias entregas emocionais. Gere a mesma linha de marketing animada a partir de cada uma. Pergunte aos ouvintes, separadamente, se o falante soa reconhecível e se a entrega animada soa apropriada.
Não presuma que a referência mais longa deve vencer. Ela contém mais material, mas também introduz mais variação; a pergunta útil é se o modelo preserva a identidade enquanto segue o desempenho solicitado.
Para uma introdução audiovisual ao tema, o vídeo a seguir oferece outro formato de visualização.
A escala fornece contexto, não aprovação final. Em sua cobertura 2024, TechCrunch noticiou que o BASE-large usou 100,000 horas de fala em domínio público para treinamento e continha 980 milhões de parâmetros. Esses totais não estabelecem como um determinado sotaque, falante ou idioma se sairá.
Ao examinar uma listagem de modelo TTS multilíngue, transforme a capacidade anunciada em verificações de aceitação concretas:
- Cobertura de idiomas: Avalie cada idioma e dialeto necessários com ouvintes fluentes.
- Estabilidade da identidade: Compare o falante em perguntas, afirmações e diálogos expressivos.
- Prontidão para fallback: Identifique uma voz predefinida aprovada para clones indisponíveis ou inadequados.
- Proveniência da referência: Retenha o identificador da gravação e seu registro de permissão associado.
Uma voz reconhecível só é útil quando sua entrega permanece compreensível e apropriada nas mensagens reais do produto.
Métricas de qualidade que vão além do MOS
Um benchmark pode ser reproduzível sem ser representativo. O LJSpeech dataset contém 13,100 clipes que somam aproximadamente 24 horas, gravados por uma única narradora falante de inglês. Isso é útil para comparações controladas, mas o sucesso dentro desse escopo não estabelece desempenho mais amplo entre falantes, sotaques ou estilos de conversa.
O Mean Opinion Score, ou MOS, mede a qualidade percebida avaliada por ouvintes. Mantenha as frases e as condições de escuta consistentes entre os modelos, oculte as identidades dos modelos e defina a pergunta de avaliação com clareza. Um painel questionado sobre agradabilidade não está necessariamente avaliando se um código de produto foi falado corretamente.
| Métrica | O que mede | Como medir | Principal limite |
|---|---|---|---|
| MOS | Qualidade percebida em uma escala de escuta de ruim a excelente | Um painel de escuta avalia as mesmas frases de cada modelo | Não isola erros de pronúncia ou ritmo sem perguntas direcionadas |
| Inteligibilidade | Se os ouvintes conseguem reconhecer as palavras | Transcreva a saída com um reconhecedor de fala e compare com o texto pretendido | Erros do reconhecedor podem mascarar erros de síntese |
| Tempo até o primeiro áudio | Atraso antes de o áudio utilizável chegar ou tocar | Registre com carimbo de data/hora o envio da requisição, o recebimento do primeiro áudio e a reprodução separadamente | Não diz nada sobre a qualidade da fala |
| Fator de tempo real | Tempo de síntese dividido pela duração do áudio | Cronometre a geração e divida pela duração da saída | Muda com hardware, carga e limites de medição |
| Reprodutibilidade | Consistência entre execuções e versões repetidas | Fixe as configurações e sementes expostas, depois execute novamente e compare | Alguns serviços não expõem sementes ou fixações de versão |
Defina o que seu cronômetro inclui
Para streaming, diferencie o primeiro áudio recebido da primeira reprodução audível. Transferência de rede, decodificação e buffering do player fazem parte da experiência do usuário, mesmo que ocorram fora da inferência do modelo. Registre ambos ao diagnosticar atraso.
Para testes de inteligibilidade, compare a fala reconhecida com a forma falada pretendida, não cegamente com os caracteres brutos da entrada. Uma data falada aceitável não vai corresponder à sua notação escrita caractere por caractere. Revise manualmente erros envolvendo nomes, números e símbolos antes de tratar o reconhecedor como referência confiável.
Uma média de qualidade é uma descrição de um teste. Ela não é um critério de aceitação até você definir quais erros o produto consegue tolerar.
Combine verificações automatizadas com escuta. Medições de tom sozinhas não descrevem ritmo, ênfase ou intensidade, e diferenças de forma de onda não significam necessariamente que os ouvintes percebam uma mudança relevante.
Informe MOS, inteligibilidade, tempo até o primeiro áudio e fator de tempo real juntos. Inclua a versão do modelo, o ambiente de execução, as configurações da requisição e os limites de medição para que outro engenheiro possa interpretar o resultado.
Construindo um Conjunto de Testes para Texto Difícil
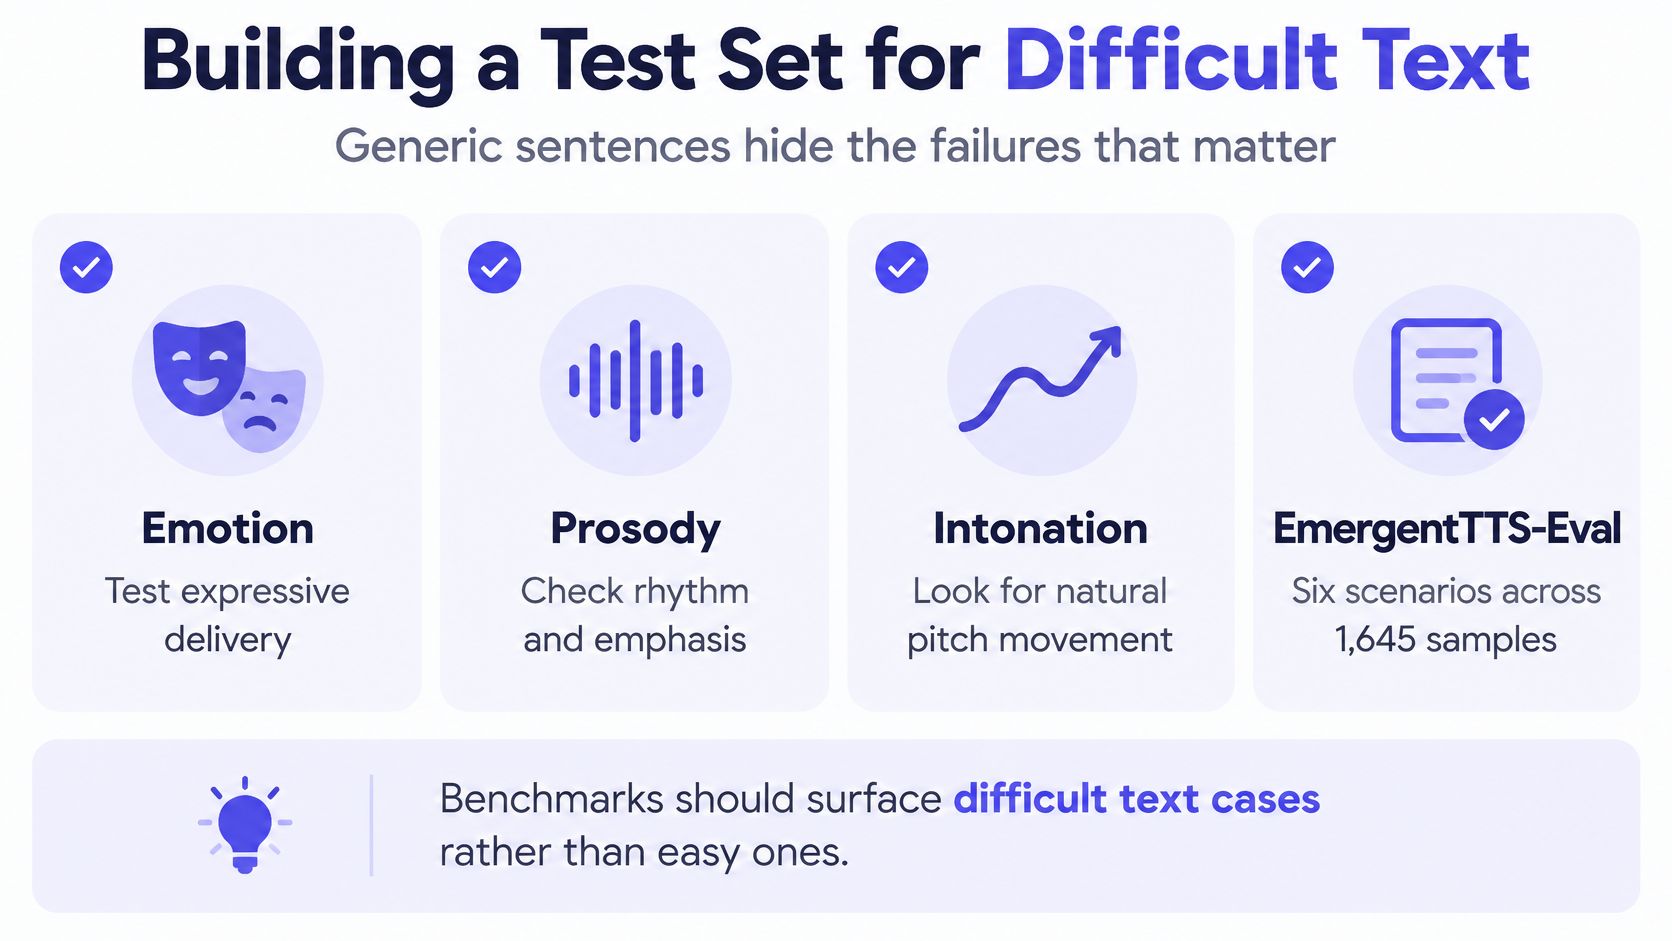
Frases genéricas tornam os testes de aceitação fracos porque omitem o texto que exige interpretação. EmergentTTS-Eval avalia seis cenários em 1,645 amostras, cobrindo emoção, prosódia, entonação e pronúncia; seus autores relatam forte correlação entre a avaliação baseada em modelo e as preferências humanas.
Use essa abordagem mais ampla sem tratar um benchmark externo como o conjunto de testes do seu produto. Sua aplicação tem seu próprio vocabulário, formatação e consequências para erros.
As categorias de avaliação abaixo ajudam a expor falhas que passagens de leitura fácil não revelariam.
Inclua Texto Que Muda de Significado Quando Mal Interpretado
- Nomes e locais: Nomes de produtos, marcas, nomes pessoais, endereços e códigos postais.
- Identificadores compactos: Acrônimos, referências de conta, códigos de produto e abreviações ambíguas.
- Notação estruturada: Datas, horas, URLs, fragmentos de código e fórmulas matemáticas.
- Mudanças de idioma: Palavras estrangeiras e passagens em idiomas mistos.
- Intenção conversacional: Perguntas, tranquilização, urgência, desacordo e diálogo carregado emocionalmente.
- Sinais não-verbais: Risadas, suspiros e outras instruções de performance suportadas.
Para cada item, registre a leitura pretendida. Um código pode exigir soletração caractere por caractere, enquanto um acrônimo pode precisar de pronúncia como uma palavra. Sem essa anotação, os ouvintes podem discordar sobre a correção mesmo quando ouvem a mesma saída.
Execute uma Comparação Repetível
- Colete texto representativo. Extraia e anonimize exemplos de produção, depois categorize-os. Inclua entradas incomuns cuja falha teria sérias consequências.
- Gere saídas comparáveis. Mantenha o formato, o papel da voz e as instruções de entrega equivalentes sempre que possível. Salve a requisição exata e o identificador do modelo.
- Use ouvintes consistentes. Peça ao mesmo painel para avaliar separadamente a inteligibilidade, a pronúncia e a adequação prosódica. Embaralhe a ordem dos modelos.
- Capture o desempenho por item. Registre o tempo do primeiro áudio e o fator em tempo real junto com o texto associado, em vez de manter apenas uma média de lote.
- Repita após as mudanças. Preserve uma linha de base aprovada e investigue regressões quando um provedor, configuração de voz ou regra de pré-processamento mudar.
Digamos que um prompt de suporte contenha o sobrenome de um cliente e uma data de agendamento. Uma frase lindamente entregue que erra qualquer um dos dois deve perder para uma alternativa menos expressiva, mas precisa.
Relate as taxas de falha por categoria e gravidade. Uma pontuação agregada pode ocultar a própria classe de erro que deveria bloquear a implantação.
Combinando Modelos ao Seu Caso de Uso
| Caso de uso | Critérios mais importantes | O que testar primeiro |
|---|---|---|
| Prompts de telefone para suporte ao cliente | Tempo para o primeiro áudio, pronúncia de nomes e códigos de produtos | Um prompt realista contendo um nome e um código através do caminho de reprodução telefônica |
| Narração de audiolivros de formato longo | Prosódia entre parágrafos, estabilidade em passagens longas | Consistência em uma passagem estendida com diálogos e mudanças de cena |
| Acessibilidade e leitores de tela | Inteligibilidade, controle confiável da taxa de fala | Clareza na taxa mais rápida que os usuários provavelmente escolherão |
| Dublagem de vídeo e mídia | Gama emocional, sincronização com clipes de referência | Alinhamento com a duração e emoção do clipe de referência |
| Educação e treinamento | Pronúncia de termos técnicos, fórmulas e palavras estrangeiras | Fórmulas, acrônimos e nomes estrangeiros do material do curso |
O recurso mais forte de um modelo só importa se ele apoiar o trabalho. A comparação a seguir ilustra as diferentes prioridades.
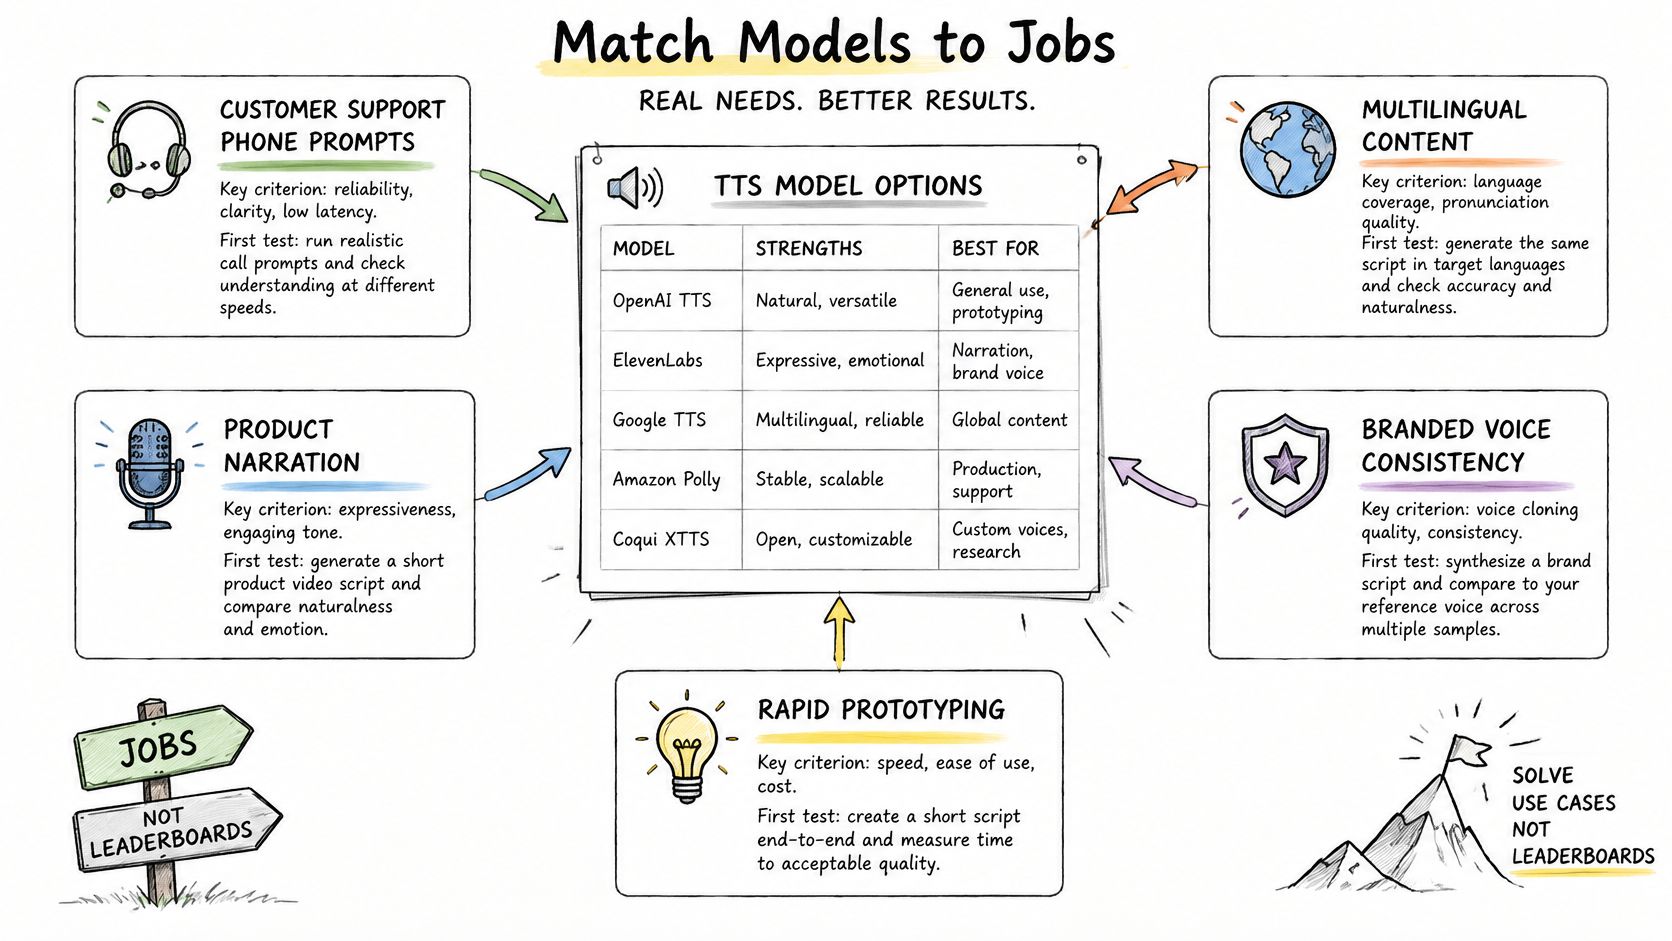
Para suporte ao cliente, teste o caminho telefônico real em vez de apenas revisar downloads com qualidade de estúdio. Para audiolivros, ouça através das fronteiras de parágrafos, mudanças de locutor e geração retomada, porque frases isoladas não exercitam a continuidade.
A avaliação de acessibilidade deve incluir as pessoas que usarão a saída e seus controles de reprodução preferidos. A dublagem precisa de uma performance de referência e restrições de tempo; a educação precisa de revisão do conteúdo da notação falada pretendida.
Aplique Requisitos Rígidos Antes das Preferências
Se a latência define a interação, exija uma interface de streaming adequada antes de classificar as vozes. Uma resposta atrasada pode falhar no design da interação, independentemente de sua qualidade eventual.
Se uma identidade de locutor específica for obrigatória, estabeleça a permissão antes de criar clones para avaliação. Não torne a autorização uma preocupação apenas de produção depois que a equipe se apegar a uma voz.
Se códigos e datas transmitem a mensagem, priorize a leitura correta deles em vez da agradabilidade. Trate erros críticos de pronúncia como bloqueadores, em vez de deixar que pontuações de estilo fortes os compensem.
Princípio de seleção: Classifique os modelos aceitáveis após aplicar os requisitos rígidos. Não faça uma média de uma falha desqualificante em uma pontuação de outra forma atraente.
Escreva esses requisitos antes de revisar os resultados. Por exemplo, um narrador de curso pode precisar de vocabulário técnico confiável, mas não de streaming conversacional, enquanto um assistente de voz pode precisar de entrada de texto incremental, mas sem clonagem. Essa distinção restringe a comparação sem depender de um ranking universal.
Consentimento, Divulgação e Uso Seguro da Voz
A clonagem de voz é uma decisão de governança, não apenas uma configuração de síntese. A orientação sobre TTS responsável descreve a classificação da FCC das vozes de robocall geradas por IA como vozes artificiais nos termos da Telephone Consumer Protection Act, tornando ilegais as chamadas abrangidas sem o consentimento prévio exigido. Não interprete isso como uma proibição geral à narração sintética nem como permissão para todo uso que não seja robocall.
Narração sintética comum e clonagem que preserva a identidade exigem escrutínio operacional diferente. Selecionar uma voz predefinida licenciada não estabelece o direito de imitar uma pessoa identificável. Para vozes personalizadas, a permissão documentada do falante deve ser um requisito de implantação.
Incorpore Controles ao Caminho da Solicitação
- Registre a permissão do falante: Mantenha a finalidade autorizada, os canais permitidos, o escopo de uso e as condições de expiração ou revisão junto ao registro da voz.
- Rejeite imitações não autorizadas: Proíba a clonagem de pessoas identificáveis sem permissão por escrito e ofereça uma forma de suspender vozes contestadas.
- Aplique regras de divulgação: Rotule a fala sintética quando a lei aplicável, a política da plataforma ou o contexto exigirem.
- Preserve a auditabilidade: Registre o identificador do modelo, o identificador da voz, o horário da solicitação e a referência de autorização sem duplicar desnecessariamente textos sensíveis.
- Mantenha alternativas seguras: Aprove vozes de reserva que não se destinam a imitar indivíduos identificáveis.
- Retenha metadados do modelo: Armazene fontes divulgadas de dados de treinamento, licenças, restrições de uso e documentação de avaliação relevante.
Um registro de permissão também precisa de um processo de revogação. Decida quem pode desativar uma voz, como o áudio em cache é tratado e o que acontece com conteúdo agendado quando a autorização muda.
Avalie Quem o Sistema Atende
Teste separadamente o desempenho de sotaque, dialeto e idioma. Uma média global pode mascarar uma experiência ruim para um grupo específico de falantes, então preserve resultados no nível do grupo quando a coleta e o relato forem apropriados.
A governança também precisa acompanhar o roteamento. Se as solicitações puderem chegar a diferentes provedores, não presuma que uma autorização de voz ou um acordo de processamento se aplique a todos os destinos. Restrinja o roteamento a combinações aprovadas de modelo, voz e termos de processamento.
Esta é uma orientação operacional geral, não aconselhamento jurídico. Verifique as leis e os requisitos contratuais aplicáveis ao falante, ao público e ao local de implantação antes do lançamento.
APIs Hospedadas ou Modelos Abertos Auto-Hospedados
A implantação determina o que você controla e o que você deve operar. Uma API hospedada move o serviço do modelo para um operador externo. A auto-hospedagem dá à sua equipe a responsabilidade pelo runtime, capacidade, atualizações e controles de acesso.
Pesos abertos não significam automaticamente uso comercial irrestrito, adequação offline ou baixos requisitos de hardware. Inspecione a licença e os requisitos de runtime antes de investir na integração. Da mesma forma, um endpoint hospedado não fornece automaticamente versões fixas ou um arranjo específico de residência de dados.
| Critério de decisão | API Hospedada | Modelo aberto auto-hospedado |
|---|---|---|
| Custo no volume esperado | Taxas de uso mais custos de integração e entrega | Esforço de computação, armazenamento, capacidade ociosa e engenharia |
| Latência sob carga de pico | Inclui caminho de rede e enfileiramento do lado do serviço | Depende do hardware provisionado e do seu agendamento |
| Residência de dados | Requer revisão dos locais e termos de processamento | Pode permanecer dentro da infraestrutura que você controla |
| Gerenciamento de versão | Sujeito às opções de fixação e atualização do serviço | Sua equipe controla os artefatos e o tempo de lançamento |
Compare o Custo Operacional Total
A implantação hospedada pode ser adequada para demanda variável e equipes que não desejam operar hardware de inferência. Confirme a unidade de faturamento, os limites de concorrência e como as novas tentativas são tratadas antes de estimar o custo. Um preço baseado em caracteres por si só não descreve a conta total da aplicação.
A auto-hospedagem pode ser adequada para operação offline ou requisitos que proíbem o envio de texto e gravações de referência para fora da infraestrutura controlada. Ainda requer planejamento de capacidade, monitoramento, atualizações de segurança e um processo de lançamento reproduzível. Um modelo que roda em uma workstation não está necessariamente pronto para tráfego de produção concorrente.
Trate a listagem do modelo Qwen TTS como um ponto de descoberta para um candidato, não como prova de sua adequação para um arranjo de hospedagem específico. Confirme o runtime, a licença e a interface reais para qualquer implantação que você avaliar.
Teste o Caminho de Serviço, Não Apenas os Pesos
Use o mesmo corpus anonimizado em candidatos hospedados e auto-hospedados. Mantenha o formato de reprodução e o cliente de teste consistentes, então meça sob os padrões de concorrência e requisição que a aplicação espera.
Registre se o teste inclui inicialização (startup), carregamento (loading), enfileiramento (queuing) e conversão. Caso contrário, um benchmark local aquecido e uma requisição remota completa não são comparáveis.
Se o seu conjunto de testes contiver informações pessoais, revise os termos de tratamento de dados antes de transmiti-lo. Remova identificadores desnecessários mesmo quando o destino for aprovado, e restrinja o acesso a gravações de referência independentemente do texto comum da aplicação.
Pré-seleção, Teste e Aprovação Final
Uma lista de candidatos deve expressar requisitos, não familiaridade com a marca. Mantenha os candidatos que atendem ao contrato de entrada, idiomas necessários, restrições operacionais e condições de autorização de voz. Exclua modelos que não conseguem satisfazer um requisito rigoroso antes de gastar tempo de escuta com eles.
Use um procedimento de lançamento que deixe um registro de decisão inspecionável:
- Selecione candidatos compatíveis. Documente por que cada modelo se encaixa nas entradas e saídas necessárias. Separe os recursos obrigatórios das preferências para que os revisores saibam o que pode ser negociado.
- Execute e revise o conjunto de testes de texto difícil. Mantenha as saídas brutas, os julgamentos dos ouvintes e os registros de tempo. Investigue erros críticos em vez de aceitar uma pontuação agregada atraente.
- Aprove os direitos e termos de processamento. Verifique a licença do modelo, a autorização de áudio de referência e o uso pretendido de cada voz personalizada. Atribua um responsável para condições não resolvidas.
- Congele a configuração aprovada. Fixe as versões onde houver suporte, salve as configurações de pré-processamento e entrega, e exija testes de regressão quando a configuração de serviço mudar.
Mantenha a Conveniência de Integração Separada da Aceitação
UberLLM oferece acesso a modelos Claude, GPT, Gemini, DeepSeek, e de imagem, vídeo e música através de um endpoint compatível com OpenAI e Anthropic. Uma API key comum e um saldo pré-pago consolidam o acesso, e a alteração do identificador do modelo suporta comparações de candidatos sem uma integração de provedor separada para cada modelo; parâmetros de fala específicos do modelo ainda precisam ser verificados.
Qwen3 0.6B TTS está listado a $0.035 por 1K caracteres, contra um preço de tabela de $0.0875 por 1K caracteres. Confirme os preços atuais na listagem do provedor antes de orçar, e compare os custos apenas entre os candidatos que atendem aos critérios de aceitação.
Exija uma Decisão de Lançamento Nomeada
Atribua um responsável ao registro de aprovação e preserve os exemplos de áudio aprovados. Registre as exceções explicitamente, incluindo quaisquer categorias de texto que exijam pré-processamento, uma voz de fallback ou revisão humana.
Uma decisão de lançamento deve permanecer compreensível depois que as pessoas que executaram a avaliação passarem para outro projeto. A verificação final é simples: O modelo escolhido passa no teste de texto difícil, e o registro de consentimento cobre todas as vozes clonadas?
UberLLM oferece uma API unificada para comparar e integrar fala juntamente com outros tipos de modelos. Visite UberLLM para inspecionar os candidatos de fala, então execute seus nomes, códigos e diálogos emocionais anonimizados através dos modelos que atendem aos seus requisitos de entrada antes de escolher uma configuração de produção.