Quanto Custa a Modelagem? Preços de Inferência de IA Explicados
Quanto Custa a Modelagem em 2026? Preços atuais de IA por token e por trabalho, uma fórmula de conta mensal e os custos ocultos que a alteram.
A criação de modelos de ponta e o uso de modelos no dia a dia têm economias bem diferentes: A análise de custos de treinamento da Epoch AI estima que o hardware representa 47%–67% dos custos de desenvolvimento de modelos de ponta, enquanto a energia representa apenas 2%–6%. Para desenvolvedores de aplicativos, porém, a questão relevante não é quanto custou para construir um modelo. É o que você pagará para completar uma tarefa útil, incluindo as solicitações que precisam de outra tentativa.
Sumário
- Preços Atuais para Modelos de Texto, Imagem e Vídeo
- Como Estimar uma Fatura Mensal de Modelo
- Fatores que Alteram os Custos de Inferência
- Por Que Tokens Mais Baratos Ainda Podem Significar Faturas Mais Altas
- Como a Confiabilidade e a Infraestrutura Alteram o Custo Real
- Defina Seu Orçamento Antes de Se Comprometer com um Modelo
Preços Atuais para Modelos de Texto, Imagem e Vídeo
Quanto custa a modelagem? Para inferência de IA, a resposta começa com a unidade de cobrança: texto usa tokens de entrada e saída, imagens usam imagens ou megapixels, e vídeo pode usar jobs. Este artigo cobre preços de uso para inferência, não orçamentos de treinamento. A estimativa relatada por Stanford para o treinamento do Gemini 1.0 Ultra foi de $192 milhões, de acordo com a apresentação de Voronoi da estimativa do AI Index, mas os clientes da API não pagam esse custo de desenvolvimento diretamente.
A tendência histórica é impressionante. O AI Index 2025 de Stanford mediu o custo de consultar um sistema que atinge desempenho de nível GPT-3.5 no MMLU caindo de aproximadamente $20 por milhão de tokens em novembro de 2022 para $0.07 até outubro de 2024. Essa é uma comparação específica de benchmark, não uma cotação atual para todos os modelos capazes.
Preços atuais por unidade por tipo de modelo
UberLLM lista preços de API por modelo em tempo real para 254 modelos, incluindo GPT, Claude, Gemini, DeepSeek, GLM, Qwen, Llama, Mistral e Kimi. Os preços de chat separam entrada de saída.
| Modelo | Unidade de cobrança | Preço UberLLM | Preço de tabela |
|---|---|---|---|
| Claude Opus 5.5, entrada | Por 1M tokens de entrada | $2.03 | $4.00 |
| Claude Opus 5.5, saída | Por 1M tokens de saída | $10.13 | $20.00 |
| Kimi K3, entrada | Por 1M tokens de entrada | $0.003 | $0.19 |
| Kimi K3, saída | Por 1M tokens de saída | $0.23 | $15.00 |
| FLUX 2 Pro imagem | Por imagem | $0.0075 | $0.03 |
| Nano Banana 2 imagem | Por imagem | $0.015 | $0.10 |
| FLUX.2 Klein 4B imagem | Por megapixel | $0.00015 | $0.015 |
| Veo 3.1 Texto-para-vídeo completo | Por job | $0.22 | $0.44 |
| Kling 3 Imagem-para-vídeo padrão | Por job | $0.063 | $0.084 |
| LTX 2.3 Texto-para-vídeo rápido | Por job | $0.045 | $0.06 |
| Runway Gen-4 Turbo | Por job | $0.0675 | Nenhum preço de tabela verificado disponível |
Use a comparação de preços da API de vídeo para verificar a oferta de jobs em tempo real antes de estimar os gastos com mídia. Um preço de job só é significativo junto com a configuração de saída que você pretende solicitar.
O preço listado é o que uma solicitação tipicamente custa, não um teto. Leia cada linha identificando a unidade que seu recurso consome e, em seguida, multiplique essa unidade pelo uso esperado. Não compare um preço por megapixel diretamente com um preço por imagem sem considerar as dimensões da imagem.
Como Estimar uma Fatura Mensal de Modelo
Construa a estimativa em torno das funcionalidades do produto, não de uma única alocação combinada de tokens. Uma conversa de suporte, extração de documentos e pré-visualização de vídeo consomem recursos diferentes, portanto, combiná-los muito cedo esconde qual funcionalidade precisa de atenção.
O cálculo começa com volume e uso medido.
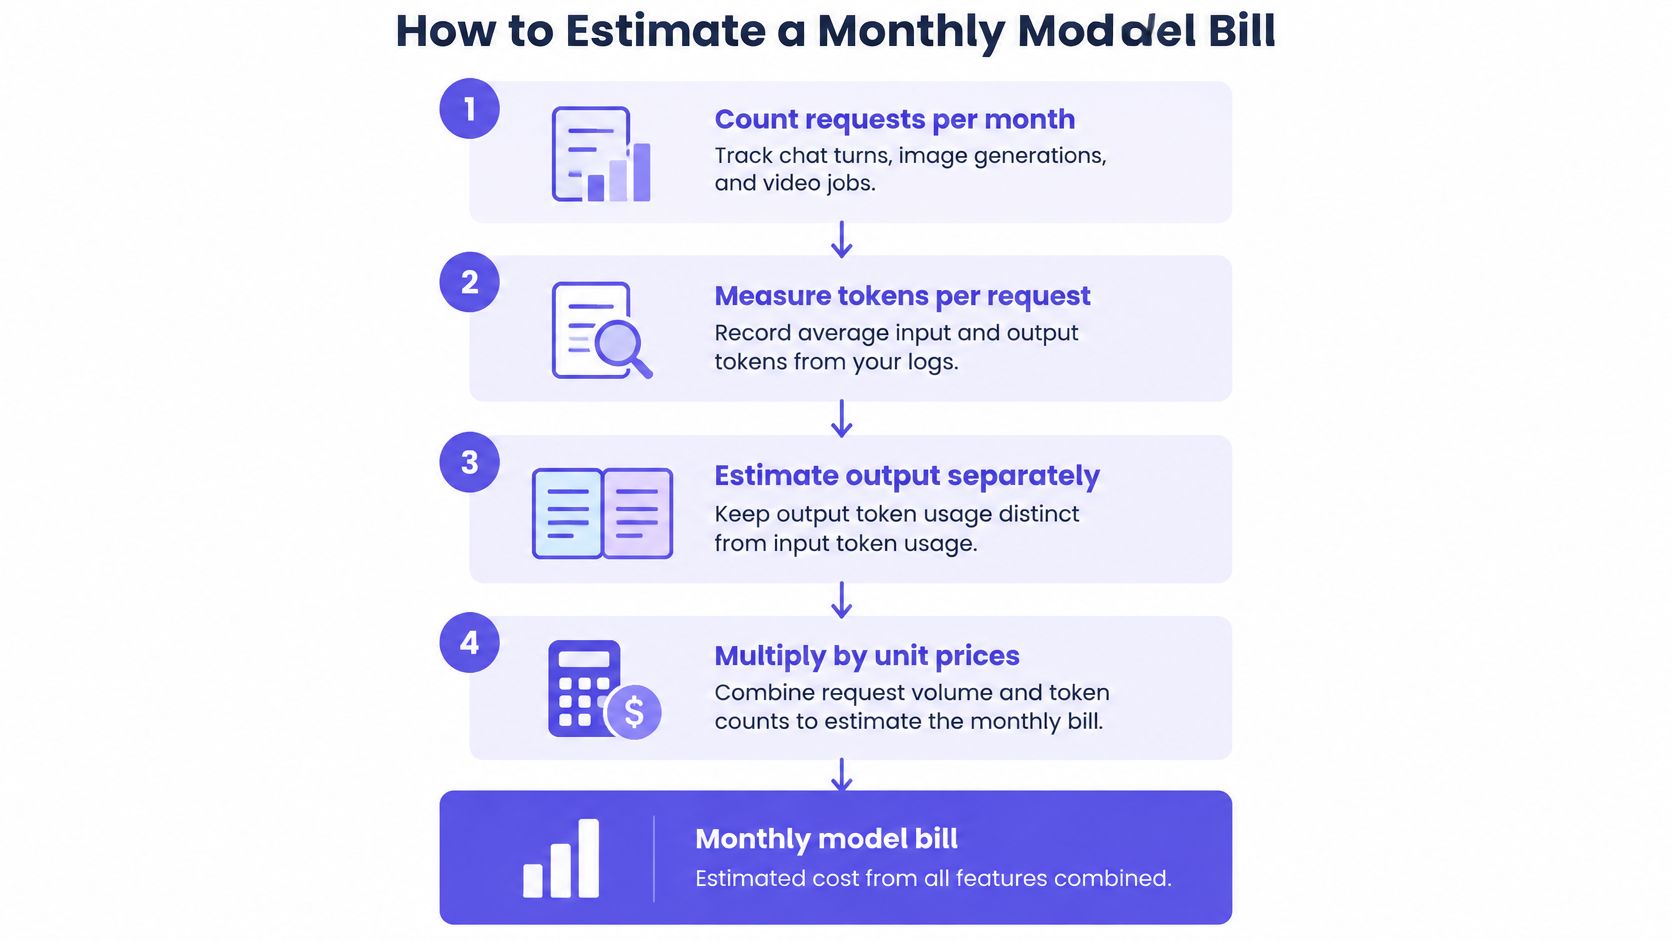
Conte as requisições por funcionalidade. Registre separadamente as rodadas de chat, chamadas de processamento de documentos, gerações de imagens e trabalhos de vídeo. Inclua chamadas em segundo plano, não apenas ações visíveis para os usuários.
Meça entrada e saída independentemente. Capture as contagens reais de tokens dos campos de uso da resposta e dos logs. Inclua instruções do sistema, histórico de conversas, passagens recuperadas e resultados de ferramentas na medição de entrada.
Aplique as taxas exatas do modelo. Multiplique os tokens de entrada mensais pela taxa de entrada e os tokens de saída mensais pela taxa de saída, usando o denominador de faturamento mostrado no catálogo. Registre o identificador do modelo ao lado de cada cálculo para que uma mudança de modelo não invalide a previsão.
Adicione unidades de mídia. Multiplique o volume de imagem, megapixel e trabalho de vídeo pelos seus preços correspondentes. Mantenha os trabalhos específicos de configuração separados, em vez de fazer a média de saídas não relacionadas.
Inclua tentativas extras. Distinga retentativas da aplicação, respostas rejeitadas-mas-geradas-com-sucesso e falhas do provedor. Nossas requisições ou gerações falhas não são cobradas, mas uma resposta entregue que sua aplicação rejeita ainda representa trabalho que seu fluxo de trabalho consumiu.
Considere os custos de financiamento. Não adicionamos nenhuma taxa sobre os preços listados dos modelos, e não há taxa mensal ou mínimo. Adições de saldo de cartão carregam uma taxa divulgada de 5.5% mais $0.50, então mantenha essa cobrança de financiamento separada dos gastos com requisições.
Transforme a estimativa em um orçamento utilizável
O cálculo básico de texto é:
Gasto mensal de texto = cobranças de tokens de entrada + cobranças de tokens de saída em todas as tentativas.
Em seguida, adicione os gastos com mídia e quaisquer serviços de aplicação de suporte. O guia para modelos de precificação de IA ajuda a distinguir as estruturas de faturamento antes de combiná-las.
Nosso exemplo mensal publicado totaliza $113.00, comparado com $400.00 no OpenRouter ou a preços oficiais, uma diferença de $287.00. Trate isso como uma carga de trabalho de exemplo, não uma previsão para uma aplicação com uma combinação de modelos ou volume de saída diferente.
Regra de orçamento: Mantenha um total mensal para cada funcionalidade, um custo médio por requisição e uma alocação separada para incertezas. Um único total de conta não consegue explicar por que os gastos mudaram.
Fatores Que Alteram os Custos de Inferência
Uma chamada de modelo se assemelha a uma corrida de táxi: a distância sozinha não determina a conta se o tempo de espera também importa. Para inferência, o volume de tokens é apenas parte do cálculo; o formato da carga de trabalho e os requisitos de serviço afetam os recursos necessários para entregar a resposta.
Fatores de custo e o que cada um faz com a conta
| Fator | Efeito no custo | O que fazer |
|---|---|---|
| Comprimento da saída | Respostas mais longas consomem mais saída faturada | Limite a saída e solicite formatos concisos |
| Nível do modelo | Maior capacidade pode ter um preço de token mais alto | Teste o modelo menos caro que atenda ao seu padrão de qualidade |
| Comprimento do contexto | Contextos de recuperação longos aumentam o tráfego de memória e reduzem o throughput | Envie apenas passagens recuperadas relevantes |
| Quantization | Menor precisão pode melhorar o throughput, mas afetar a qualidade | Avalie a precisão implantada em tarefas representativas |
| Unidade de faturamento | Imagens, megapixels e trabalhos de vídeo medem saídas diferentes | Combine a unidade com o entregável do seu produto |
| Nível de latência | Capacidade adequada para trabalho interativo pode ter um custo premium | Combine os requisitos de serviço com a tolerância do usuário |
| Gerações falhas | Tentativas adicionais consomem tempo e podem criar trabalho faturável | Separe falhas do provedor da rejeição em nível de aplicativo |
Um estudo de inferência em GPU de consumidor estimou custos apenas de eletricidade de $0.001–$0.005 por milhão de tokens para cargas de trabalho de API comuns, versus $0.14–$0.22 para geração aumentada por recuperação com 32K de contexto, e relatou que NVFP4 entregou cerca de 1.6 vezes o throughput de BF16 com 41% menos energia e uma perda de qualidade estimada em 2%–4%.
Essas são estimativas operacionais apenas de eletricidade, não preços de API para clientes. Elas excluem o restante do negócio de serviço e não são diretamente comparáveis com as taxas de entrada e saída faturadas na tabela de preços.
O auto-hospedagem precisa de seu próprio cálculo
Um benchmark de inferência LLaMA descobriu que servir um modelo 65B exigia aproximadamente 8–32 GPUs, com consumo de energia de inferência relatado de cerca de 300 watts a 1 kilowatt, dependendo da configuração de sharding. A auto-hospedagem, portanto, precisa de um cálculo de utilização, não apenas de uma estimativa de eletricidade: inclua hardware, memória, rede, operações e capacidade ociosa.
Use o rastreador de mudanças de preço de modelo ao revisar alternativas. Nós permitimos que você troque de modelo alterando o ID do modelo, mas a compatibilidade não estabelece qualidade equivalente.
Escolha o modelo mais barato que passe na sua própria avaliação, depois reduza o contexto e a saída desnecessários antes de negociar uma taxa mais baixa.
Por Que Tokens Mais Baratos Ainda Podem Significar Contas Mais Altas
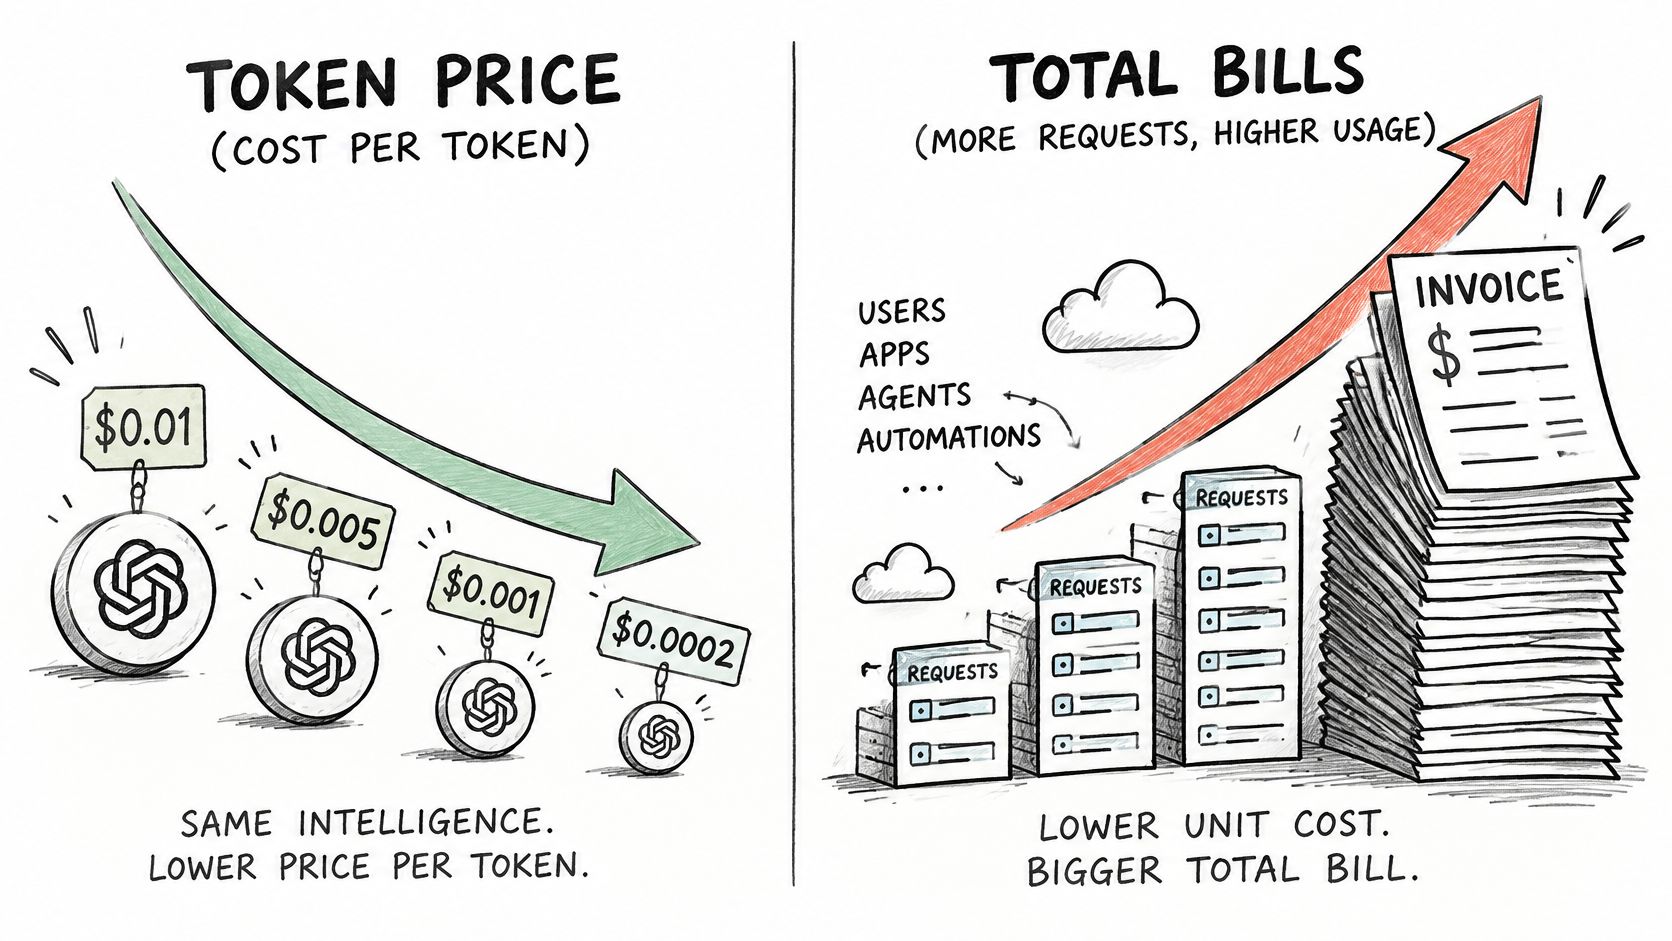
Uma estimativa na análise da TCS sobre gastos com IA generativa baseada em resultados relata que os custos por token diminuíram aproximadamente 1,000 vezes em três anos enquanto o gasto total com inferência continuou a aumentar, e observa que os tokens de saída geralmente custam três a seis vezes mais do que os tokens de entrada. Preços unitários mais baixos não garantem gastos menores com a aplicação.
A distinção é mais fácil de ver quando preço e uso se movem em direções opostas.
Compare o trabalho concluído, não gerações isoladas
Considere um fluxo de trabalho ilustrativo de extração de documentos. O modelo de preço mais baixo produz uma explicação prolixa em vez da resposta estruturada necessária, então sua aplicação envia uma solicitação de reparo. Se a resposta reparada ainda falhar na validação, o fluxo de trabalho escala para um modelo mais forte.
O modelo alternativo custa mais por token de saída, mas retorna um resultado estruturado aceitável imediatamente. Sua taxa unitária mais alta pode produzir um custo total de tarefa menor porque você evita o prompt de reparo, o contexto do documento repetido e a geração de fallback.
Esse resultado não é inevitável. É precisamente o que uma avaliação representativa deve determinar.
Custo por tarefa concluída = gasto total do fluxo de trabalho ÷ tarefas concluídas com sucesso.
Inclua retrieval, tool calls, guardrails e escalonamento humano quando eles pertencerem a esse fluxo de trabalho. Defina o sucesso antes de medir: uma resposta que chegou não é necessariamente uma resposta que seu produto pode usar.
Essa distinção também importa ao interpretar discussões mais amplas sobre a economia da IA.
Diagnostique o caminho caro
Acompanhe prompt length, output length, validation failures e fallback decisions junto com os gastos. Uma primeira tentativa barata pode continuar valendo a pena se resolver casos rotineiros e escalar os difíceis seletivamente. Torna-se um desperdício quando quase toda tarefa paga tanto pela tentativa inicial quanto pelo fallback.
Não remova verificações de qualidade apenas para melhorar a taxa de sucesso aparente. Isso muda a definição de sucesso em vez de reduzir o custo do trabalho útil.
Teste de decisão: Quanto custará um fluxo de trabalho aceito após saídas longas, retries e serviços de suporte, não apenas após sua primeira chamada de modelo?
Como a Confiabilidade e a Infraestrutura Afetam o Custo Real
Um preço de capa não garante que a capacidade adequada estará disponível quando sua aplicação precisar dela. Região, compromisso, requisitos de latência e tipo de capacidade afetam a comparação.
Um rastreador de preços de GPU e custos de inferência relatou preços de H100 de cerca de $0.34 por hora em instâncias spot a aproximadamente $3.46 por hora em média, juntamente com uma estimativa de $0.50–$3 por milhão de tokens de saída para serviço de capacidade comparável entre provedores, níveis de latência e janelas de contexto. Essas faixas descrevem diferentes condições de compra, não ofertas intercambiáveis.
Trabalho em lote e trabalho interativo precisam de capacidade diferente
Para processamento em lote, um endpoint barato pode ser aceitável mesmo quando os tempos de conclusão flutuam. Uma fila de classificação de documentos pode pausar ou reagendar o trabalho se a aplicação rastrear o estado da tarefa e evitar processamento duplicado. Pagar a mais por respostas imediatas pode agregar pouco valor.
Para produtos interativos, o mesmo endpoint pode ser uma má compra. Se os usuários abandonarem uma solicitação antes que ela termine, a geração tecnicamente bem-sucedida ainda pode falhar comercialmente. Um endpoint mais caro pode valer a pena quando reduz as tentativas relacionadas a timeouts, sessões abandonadas ou intervenções de suporte.
Compare ambas as opções sob concorrência representativa. Meça o tempo para o primeiro token, latência de conclusão, latência de cauda e conclusão de tarefas aceitas, em vez de depender de um teste de endpoint ocioso.
O roteamento altera a comparação operacional
Nós roteamos cada solicitação para o vendedor saudável mais barato e a movemos para outro vendedor saudável quando um provedor se torna lento ou indisponível. Isso reduz a necessidade de sua aplicação implementar cada caminho de recuperação específico do vendedor, mas você ainda deve testar o comportamento de ponta a ponta.
Se nenhum provedor puder servir um modelo, a API retorna 503 no_available_provider, e nada é cobrado. Para vídeo, a resposta informa o custo máximo que a tarefa pode ter antes do início da geração. Nenhum dos comportamentos elimina a necessidade de lidar com capacidade indisponível ou resultados atrasados em seu produto.
Defina estes valores antes de comparar endpoints:
- Meta de disponibilidade: Defina quando um recurso deve funcionar e qual comportamento degradado é aceitável.
- Meta de latência: Especifique o tempo de resposta que os usuários precisam, incluindo o comportamento de cauda lenta.
- Valor de failover: Decida quais interrupções justificam capacidade alternativa ou outro modelo.
- Teto de custo da tarefa: Defina o gasto máximo economicamente aceitável para um resultado aceito.
Uma comparação de aquisição útil mantém esses requisitos constantes. Caso contrário, você está comparando serviços diferentes através da mesma coluna de preço.
Defina Seu Orçamento Antes de Se Comprometer com um Modelo
Comprometa-se com um modelo somente depois de conseguir conectar seu preço a um orçamento de nível de recurso e a um teste de aceitação mensurável. Uma resposta promissora no playground é um ponto de partida, não uma evidência de que todo o fluxo de trabalho é econômico.
Estabeleça controles para a avaliação
Escolha a unidade de cobrança de cada recurso. Registre se o entregável consome input tokens, output tokens, imagens, megapixels ou jobs. Mantenha a configuração solicitada ao lado dessa unidade para que uma alteração nas dimensões da imagem ou nas configurações de vídeo acione uma revisão do orçamento.
Crie uma previsão de nível de recurso. Use o volume de solicitações observado e o uso de uma amostra representativa. Inclua o caminho de execução completo, incluindo processamento em segundo plano e chamadas de reparo direcionadas pelo aplicativo, em vez de estimar apenas a partir do prompt visível do usuário.
Envie um limite de preço com as solicitações. Use o controle
max_priceoumax_costaplicável. Uma request nunca é cobrada acima do valor que você envia, então um limite aplicável é mais útil do que assumir que o preço típico do catálogo é um máximo garantido.Aloque o saldo compartilhado deliberadamente. Um único saldo cobre modelos de texto, imagem, vídeo e música. Mantenha registros de gastos por recurso para que um experimento de mídia não oculte os fundos necessários para um fluxo de trabalho de texto estabelecido.
Avalie um modelo alternativo. Nossa API fornece uma key para cada modelo pelo preço de tabela ou menos. Altere o identificador do modelo mantendo as instruções da tarefa e os critérios de aceitação estáveis, e então compare os entregáveis resultantes em vez de selecionar a resposta que soa mais polida.
Execute um piloto de produção limitado. Escolha uma janela de revisão que capture tráfego rotineiro e difícil. Compare o custo medido por tarefa aceita com sua previsão antes de expandir o acesso ou aumentar a concorrência.
Investigue a diferença antes de trocar de provedor
Use o dashboard playground para comparar outputs e ajustar parâmetros antes da integração em produção. Para extração, inspecione a conformidade do schema e se os fields são suportados pelo documento. Para codificação, avalie se a alteração proposta satisfaz a tarefa e passa nas verificações relevantes.
Quando o custo medido exceder a previsão, verifique output length, retry behavior e context size primeiro. Em seguida, inspecione se seu aplicativo alterou a workload, como anexar históricos de conversas completos ou fornecer repetidamente os mesmos documentos. Não presuma que uma conta mais alta significa que a taxa listada aumentou.
Abra a tabela de preços ao vivo esta semana, identifique o recurso responsável pela maior parte do seu gasto e construa sua estimativa a partir do uso registrado. Atribua alguém para revisar os primeiros resultados medidos em relação a essa previsão.
UberLLM oferece uma API unificada e saldo pré-pago para acessar modelos de texto, imagem, vídeo e música, com controles de preço em nível de request. Visite UberLLM para comparar preços de modelos ao vivo, escolher um candidato para seu recurso de maior gasto e testar seu custo por tarefa concluída antes de se comprometer.