Wie viel kostet Modellierung? KI-Inferenzpreise erklärt
Wie viel kostet Modellierung in 2026? Aktuelle KI-Preise pro Token und pro Auftrag, eine monatliche Rechnungsformel und die versteckten Kosten, die sie beeinflussen.
Die Entwicklung von Frontier-Modellen und die alltägliche Nutzung von Modellen unterscheiden sich wirtschaftlich stark: Die Trainingskostenanalyse von Epoch AI schätzt, dass Hardware 47%–67% der Entwicklungskosten von Frontier-Modellen ausmacht, während Energie nur 2%–6% darstellt. Für Anwendungsentwickler ist jedoch die relevante Frage nicht, was ein Modell in der Entwicklung gekostet hat. Es ist, was Sie bezahlen, um eine nützliche Aufgabe zu erledigen, einschließlich der Anfragen, die einen weiteren Versuch benötigen.
Inhaltsverzeichnis
- Aktuelle Preise für Text-, Bild- und Videomodelle
- So schätzen Sie eine monatliche Modellrechnung ein
- Faktoren, die die Inferenzkosten beeinflussen
- Warum günstigere Tokens immer noch höhere Rechnungen bedeuten können
- Wie Zuverlässigkeit und Infrastruktur die tatsächlichen Kosten verschieben
- Legen Sie Ihr Budget fest, bevor Sie sich für ein Modell entscheiden
Aktuelle Preise für Text-, Bild- und Videomodelle
Was kostet die Modellnutzung? Für die KI-Inferenz beginnt die Antwort mit der Abrechnungseinheit: Text verwendet Eingabe- und Ausgabe-Tokens, Bilder verwenden Bilder oder Megapixel, und Video kann Jobs verwenden. Dieser Artikel behandelt Nutzungspreise für die Inferenz, nicht Trainingsbudgets. Stanfords gemeldete Schätzung für das Training von Gemini 1.0 Ultra betrug $192 Millionen, laut Voronois Präsentation der AI Index Schätzung, aber API-Kunden zahlen diese Entwicklungskosten nicht direkt.
Der historische Trend ist bemerkenswert. Der Stanford 2025 AI Index maß die Kosten für die Abfrage eines Systems, das GPT-3.5-Niveau-Leistung auf MMLU erreichte, die von ungefähr $20 pro Million Tokens im November 2022 auf $0.07 bis Oktober 2024 fielen. Das ist ein benchmarkspezifischer Vergleich, keine aktuelle Preisangabe für jedes leistungsfähige Modell.
Aktuelle Stückpreise nach Modelltyp
UberLLM listet Live-API-Preise pro Modell für 254 Modelle auf, darunter GPT, Claude, Gemini, DeepSeek, GLM, Qwen, Llama, Mistral und Kimi. Chat-Preise trennen Eingabe von Ausgabe.
| Modell | Abrechnungseinheit | UberLLM Preis | Listenpreis |
|---|---|---|---|
| Claude Opus 5.5, Eingabe | Pro 1M Eingabe-Tokens | $2.03 | $4.00 |
| Claude Opus 5.5, Ausgabe | Pro 1M Ausgabe-Tokens | $10.13 | $20.00 |
| Kimi K3, Eingabe | Pro 1M Eingabe-Tokens | $0.003 | $0.19 |
| Kimi K3, Ausgabe | Pro 1M Ausgabe-Tokens | $0.23 | $15.00 |
| FLUX 2 Pro image | Pro Bild | $0.0075 | $0.03 |
| Nano Banana 2 image | Pro Bild | $0.015 | $0.10 |
| FLUX.2 Klein 4B image | Pro Megapixel | $0.00015 | $0.015 |
| Veo 3.1 Full text-to-video | Pro Job | $0.22 | $0.44 |
| Kling 3 Standard image-to-video | Pro Job | $0.063 | $0.084 |
| LTX 2.3 Fast text-to-video | Pro Job | $0.045 | $0.06 |
| Runway Gen-4 Turbo | Pro Job | $0.0675 | Kein verifizierter Listenpreis verfügbar |
Nutzen Sie den Video-API-Preisvergleich, um das Live-Job-Angebot zu prüfen, bevor Sie die Medienausgaben schätzen. Ein Job-Preis ist nur in Verbindung mit der von Ihnen beabsichtigten Ausgabekonfiguration aussagekräftig.
Der angegebene Preis ist das, was eine Anfrage typischerweise kostet, nicht eine Obergrenze. Lesen Sie jede Zeile, indem Sie die Einheit identifizieren, die Ihr Feature verbraucht, und multiplizieren Sie diese Einheit dann mit der erwarteten Nutzung. Vergleichen Sie einen Megapixel-Preis nicht direkt mit einem Pro-Bild-Preis, ohne die Bildabmessungen zu berücksichtigen.
So schätzen Sie eine monatliche Modellrechnung
Erstellen Sie die Schätzung anhand von Produktfunktionen, nicht anhand einer einzigen, gemischten Token-Zulage. Ein Support-Gespräch, eine Dokumentenextraktion und eine Videovorschau verbrauchen unterschiedliche Ressourcen, daher verdeckt eine zu frühe Kombination, welche Funktion Aufmerksamkeit benötigt.
Die Berechnung beginnt mit Volumen und gemessener Nutzung.
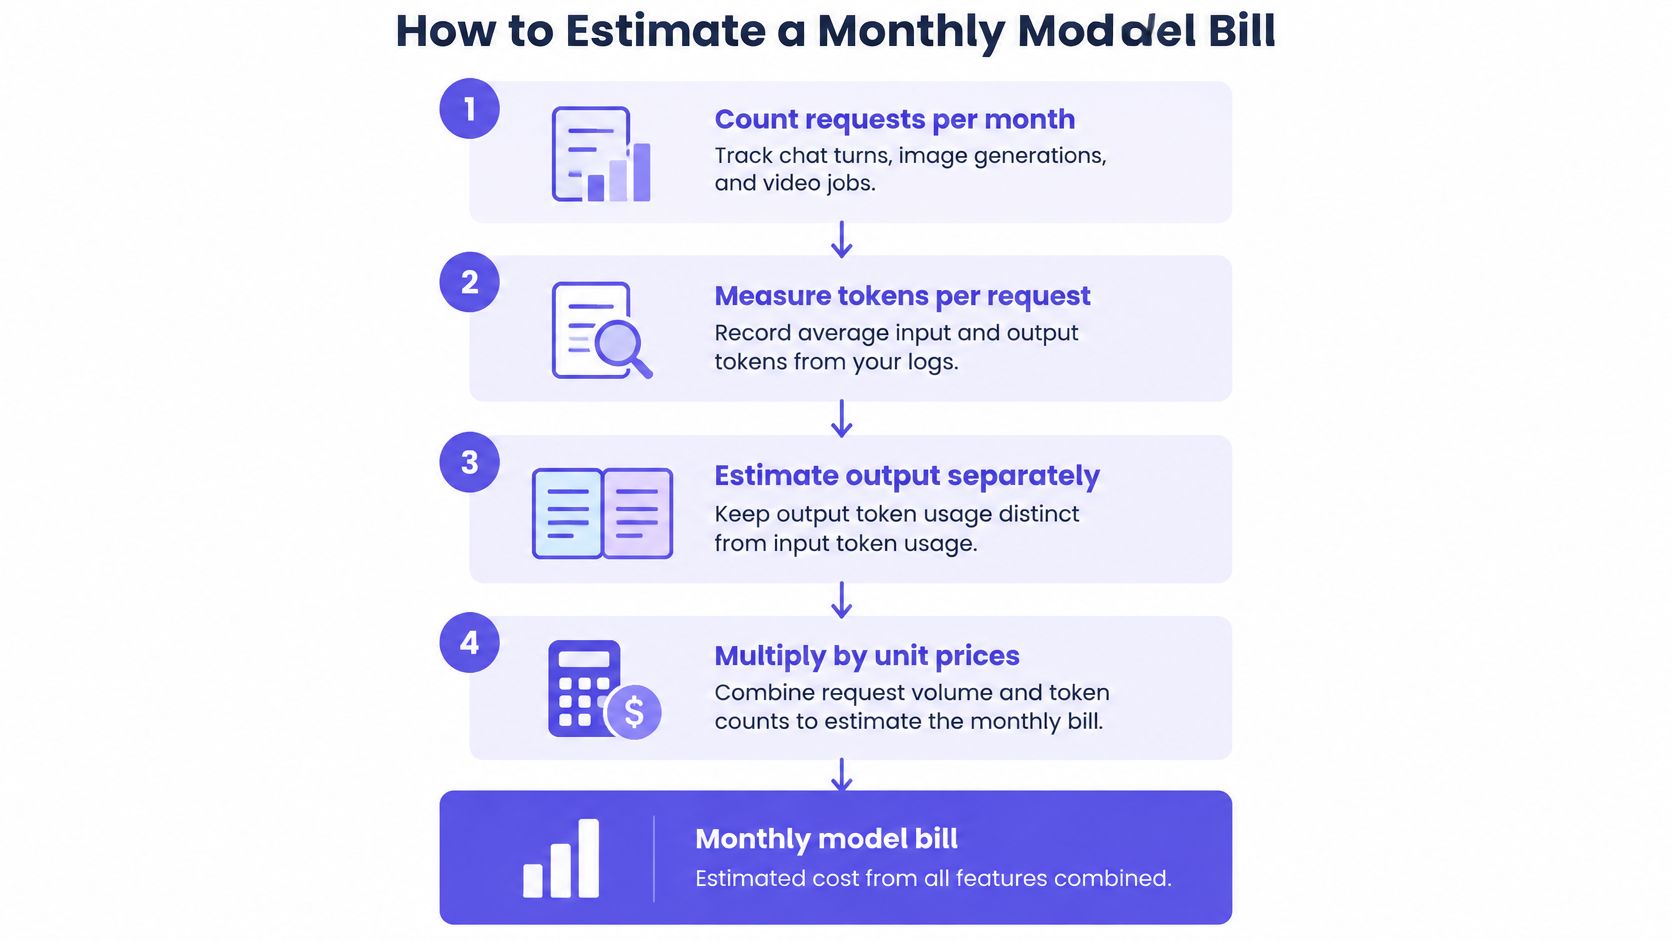
Anfragen nach Funktion zählen. Erfassen Sie Chat-Runden, Aufrufe zur Dokumentenverarbeitung, Bildgenerierungen und Videoaufträge separat. Fügen Sie Hintergrundaufrufe hinzu, nicht nur Aktionen, die für Benutzer sichtbar sind.
Input und Output unabhängig messen. Erfassen Sie die tatsächlichen Token-Anzahlen aus den Nutzungsfeldern und Protokollen der Antworten. Fügen Sie Systemanweisungen, Konversationsverlauf, abgerufene Passagen und Tool-Ergebnisse in die Input-Messung ein.
Die genauen Raten des Modells anwenden. Multiplizieren Sie die monatlichen Input-Tokens mit der Input-Rate und die monatlichen Output-Tokens mit der Output-Rate, unter Verwendung des im Katalog angegebenen Abrechnungsnenners. Notieren Sie den Modell-Identifikator neben jeder Berechnung, damit eine Modelländerung die Prognose nicht ungültig macht.
Medieneinheiten hinzufügen. Multiplizieren Sie das Volumen von Bildern, Megapixeln und Videoaufträgen mit den entsprechenden Preisen. Halten Sie konfigurationsspezifische Aufträge getrennt, anstatt nicht zusammenhängende Outputs zu mitteln.
Zusätzliche Versuche einbeziehen. Unterscheiden Sie zwischen Anwendungs-Wiederholungsversuchen, abgelehnten, aber erfolgreich generierten Antworten und Anbieterfehlern. Unsere fehlgeschlagenen Anfragen oder Generierungen werden nicht berechnet, aber eine gelieferte Antwort, die Ihre Anwendung ablehnt, stellt dennoch Arbeit dar, die Ihr Workflow verbraucht hat.
Finanzierungskosten berücksichtigen. Wir erheben keine Gebühr zusätzlich zu den gelisteten Modellpreisen, und es gibt keine monatliche Gebühr oder Mindestbetrag. Kartenaufladungen sind mit einer ausgewiesenen Gebühr von 5.5% plus $0.50 verbunden, daher halten Sie diese Finanzierungsgebühr getrennt von den Ausgaben für Anfragen.
Schätzung in ein nutzbares Budget verwandeln
Die grundlegende Textberechnung lautet:
Monatliche Textausgaben = Input-Token-Gebühren + Output-Token-Gebühren über alle Versuche hinweg.
Fügen Sie dann Medienausgaben und alle unterstützenden Anwendungsdienste hinzu. Der Leitfaden zu KI-Preismodellen hilft, Abrechnungsstrukturen zu unterscheiden, bevor Sie sie kombinieren.
Unser veröffentlichtes monatliches Beispiel beläuft sich auf insgesamt $113.00, verglichen mit $400.00 auf OpenRouter oder zu offiziellen Preisen, ein Unterschied von $287.00. Betrachten Sie dies als Beispiel-Workload, nicht als Vorhersage für eine Anwendung mit einer anderen Modellmischung oder einem anderen Output-Volumen.
Budgetierungsregel: Halten Sie eine monatliche Gesamtsumme für jede Funktion, einen durchschnittlichen Kosten pro Anfrage und eine separate Zulage für Unsicherheiten bereit. Eine einzelne Gesamtsumme des Kontos kann nicht erklären, warum sich die Ausgaben geändert haben.
Faktoren, die die Inferenzkosten beeinflussen
Ein Modellaufruf ähnelt einer Taxifahrt: Die Strecke allein bestimmt nicht die Rechnung, wenn auch die Wartezeit eine Rolle spielt. Bei der Inferenz ist das Token-Volumen nur ein Teil der Berechnung; die Form der Arbeitslast und die Bereitstellungsanforderungen beeinflussen die benötigten Ressourcen, um die Antwort zu liefern.
Kostenfaktoren und deren Auswirkung auf die Rechnung
| Faktor | Auswirkung auf die Kosten | Was zu tun ist |
|---|---|---|
| Ausgabelänge | Längere Antworten verbrauchen mehr abgerechnete Ausgabe | Ausgabe begrenzen und prägnante Formate anfordern |
| Modell-Stufe | Höhere Leistungsfähigkeit kann einen höheren Token-Preis bedeuten | Das günstigste Modell testen, das Ihre Qualitätsanforderungen erfüllt |
| Kontextlänge | Lange Retrieval-Kontexte erhöhen den Speicherverkehr und reduzieren den Durchsatz | Nur relevante abgerufene Passagen senden |
| Quantisierung | Geringere Präzision kann den Durchsatz verbessern, aber die Qualität beeinträchtigen | Die eingesetzte Präzision bei repräsentativen Aufgaben bewerten |
| Abrechnungseinheit | Bilder, Megapixel und Video-Jobs messen unterschiedliche Ausgaben | Die Einheit an das Lieferobjekt Ihres Produkts anpassen |
| Latenz-Stufe | Kapazität, die für interaktive Arbeit geeignet ist, kann einen Aufpreis kosten | Bereitstellungsanforderungen an die Benutzertoleranz anpassen |
| Fehlgeschlagene Generierungen | Zusätzliche Versuche verbrauchen Zeit und können abrechenbare Arbeit verursachen | Anbieterfehler von Ablehnungen auf Anwendungsebene trennen |
Eine Inferenzstudie zu Consumer-GPUs schätzte die reinen Stromkosten von $0.001–$0.005 pro Million Tokens für gewöhnliche API-Arbeitslasten, im Vergleich zu $0.14–$0.22 für Retrieval-Augmented Generation mit 32K Kontext, und berichtete, dass NVFP4 etwa 1.6-mal den BF16-Durchsatz mit 41% weniger Energie und einem geschätzten 2%–4% Qualitätsverlust lieferte.
Dies sind reine Stromkosten-Betriebsschätzungen, keine API-Preise für Kunden. Sie schließen den Rest des Bereitstellungsgeschäfts aus und sind nicht direkt mit den abgerechneten Eingabe- und Ausgaberaten in der Preistabelle vergleichbar.
Self-Hosting erfordert eine eigene Berechnung
Ein LLaMA-Inferenz-Benchmark ergab, dass der Betrieb eines 65B Modells etwa 8–32 GPUs erforderte, mit einem gemeldeten Inferenz-Stromverbrauch von etwa 300 Watt bis 1 Kilowatt, abhängig von der Sharding-Konfiguration. Self-Hosting erfordert daher eine Auslastungsberechnung, nicht nur eine Stromkostenschätzung: Berücksichtigen Sie Hardware, Speicher, Netzwerk, Betrieb und ungenutzte Kapazität.
Nutzen Sie den Modellpreis-Änderungs-Tracker bei der Überprüfung von Alternativen. Wir ermöglichen Ihnen den Modellwechsel durch Änderung der Modell-ID, aber Kompatibilität bedeutet nicht gleichwertige Qualität.
Wählen Sie das günstigste Modell, das Ihre eigene Bewertung besteht, reduzieren Sie dann unnötigen Kontext und Ausgabe, bevor Sie einen niedrigeren Preis verhandeln.
Warum günstigere Tokens trotzdem zu höheren Rechnungen führen können
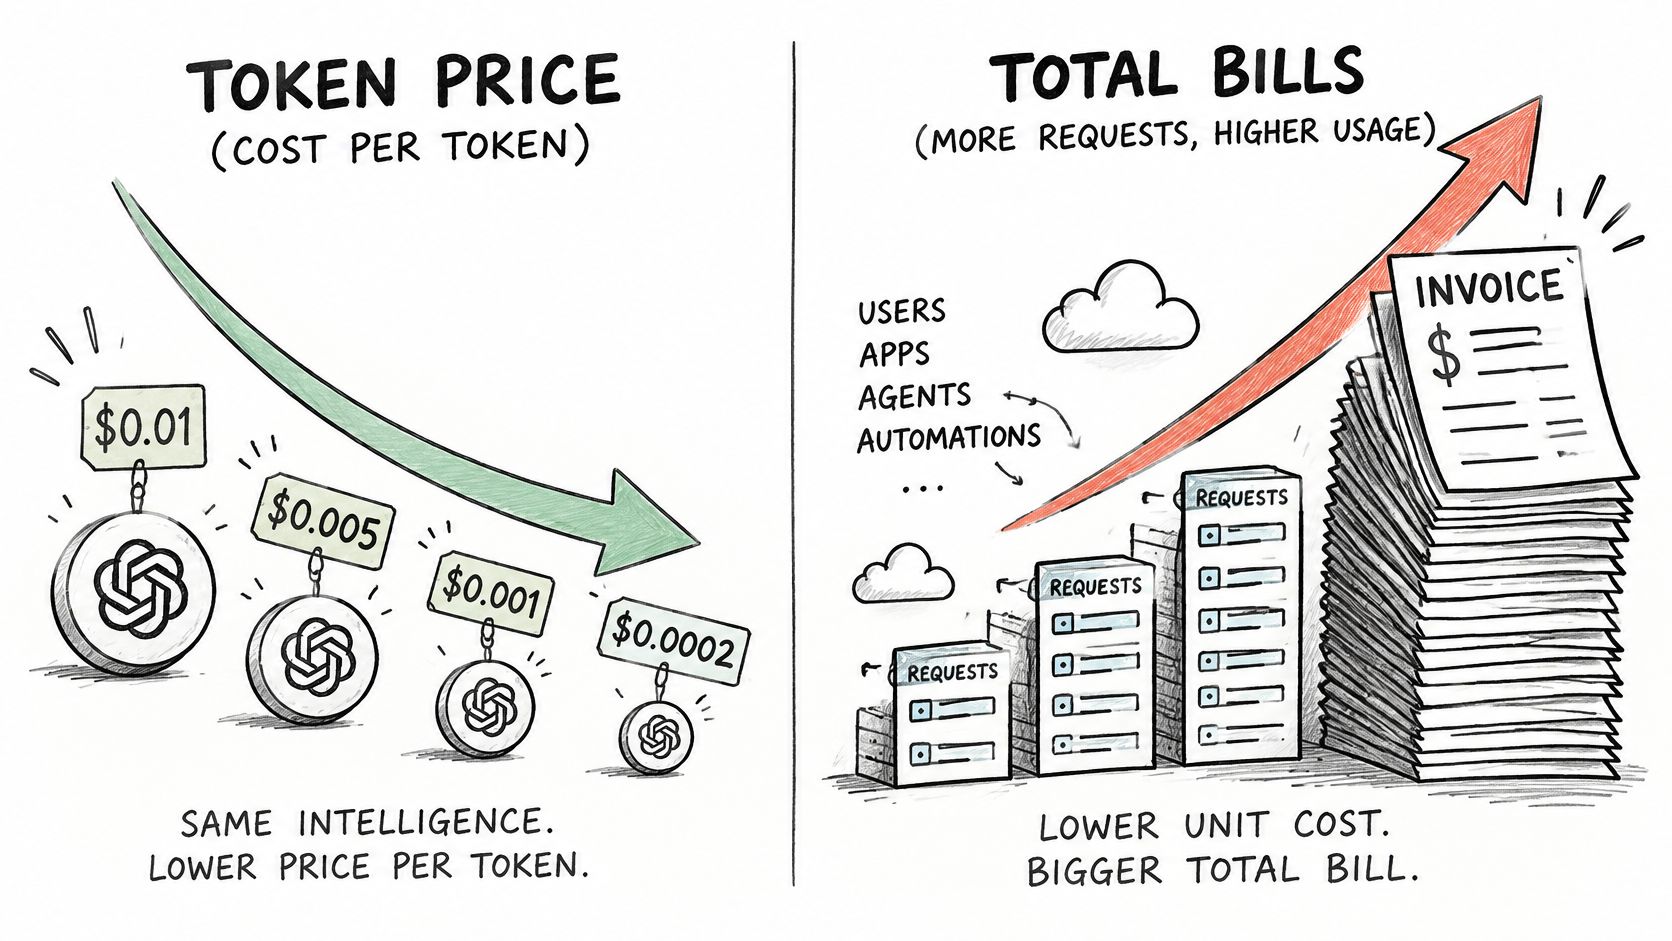
Eine Schätzung in TCS' Analyse der ergebnisbasierten Ausgaben für generative KI berichtet, dass die Kosten pro Token in etwa 1,000-fach über drei Jahre gesunken sind, während die gesamten Inferenz-Ausgaben weiter gestiegen sind, und stellt fest, dass Output-Tokens üblicherweise drei- bis sechsmal mehr kosten als Input-Tokens. Niedrigere Stückpreise garantieren keine geringeren Anwendungsausgaben.
Der Unterschied ist leichter zu erkennen, wenn sich Preis und Nutzung in entgegengesetzte Richtungen bewegen.
Vergleichen Sie abgeschlossene Arbeit, nicht isolierte Generierungen
Betrachten Sie einen beispielhaften Workflow zur Dokumentenextraktion. Das preisgünstigere Modell erzeugt eine ausführliche Erklärung anstelle der erforderlichen strukturierten Antwort, sodass Ihre Anwendung eine Reparaturanfrage sendet. Wenn die reparierte Antwort die Validierung immer noch nicht besteht, eskaliert der Workflow zu einem stärkeren Modell.
Das alternative Modell kostet mehr pro Output-Token, liefert aber sofort ein akzeptables strukturiertes Ergebnis. Sein höherer Stückpreis kann zu geringeren Gesamtkosten pro Aufgabe führen, da Sie den Reparatur-Prompt, den wiederholten Dokumentenkontext und die Fallback-Generierung vermeiden.
Dieses Ergebnis ist nicht unvermeidlich. Genau das sollte eine repräsentative Evaluierung feststellen.
Kosten pro abgeschlossener Aufgabe = Gesamtausgaben des Workflows ÷ erfolgreich abgeschlossene Aufgaben.
Beziehen Sie Retrieval, Tool calls, Guardrails und menschliche Eskalation ein, wenn sie zu diesem Workflow gehören. Definieren Sie Erfolg, bevor Sie messen: Eine eingegangene Antwort ist nicht unbedingt eine Antwort, die Ihr Produkt verwenden kann.
Dieser Unterschied ist auch wichtig bei der Interpretation breiterer Diskussionen über die KI-Ökonomie.
Den teuren Pfad diagnostizieren
Verfolgen Sie prompt length, output length, validation failures und fallback decisions zusammen mit den Ausgaben. Ein günstiger erster Versuch kann sich lohnen, wenn er Routinefälle löst und schwierige Fälle selektiv eskaliert. Er wird verschwenderisch, wenn fast jede Aufgabe sowohl den ersten Versuch als auch den Fallback bezahlt.
Entfernen Sie Qualitätsprüfungen nicht nur, um die scheinbare Erfolgsrate zu verbessern. Das ändert die Definition von Erfolg, anstatt die Kosten für nützliche Arbeit zu senken.
Entscheidungstest: Was kostet ein akzeptierter Workflow nach langen Outputs, Retries und unterstützenden Services, nicht nur nach seinem ersten Modellaufruf?
Wie Zuverlässigkeit und Infrastruktur die tatsächlichen Kosten verschieben
Ein angegebener Preis garantiert nicht, dass die passende Kapazität verfügbar ist, wenn Ihre Anwendung sie benötigt. Region, Verpflichtung, Latenzanforderungen und Kapazitätstyp beeinflussen alle den Vergleich.
Ein GPU-Preis- und Inferenzkosten-Tracker berichtete H100-Preise von etwa $0.34 pro Stunde für Spot-Instanzen bis zu durchschnittlich etwa $3.46 pro Stunde, zusammen mit einer Schätzung von $0.50–$3 pro Million Output-Tokens für vergleichbare Leistungsbereitstellung über Anbieter, Latenz-Tiers und Kontextfenster hinweg. Diese Spannen beschreiben unterschiedliche Einkaufsbedingungen, keine austauschbaren Angebote.
Batch-Arbeit und interaktive Arbeit benötigen unterschiedliche Kapazität
Für die Batch-Verarbeitung kann ein kostengünstiger endpoint akzeptabel sein, selbst wenn die Abschlusszeiten schwanken. Eine Warteschlange für die Dokumentenklassifizierung kann Aufgaben pausieren oder neu planen, wenn die Anwendung den Job-Status verfolgt und doppelte Verarbeitung verhindert. Zusätzliche Kosten für sofortige Antworten können wenig Mehrwert bieten.
Für interaktive Produkte kann derselbe endpoint ein schlechter Kauf sein. Wenn Benutzer eine Anfrage abbrechen, bevor sie abgeschlossen ist, kann eine technisch erfolgreiche Generierung kommerziell dennoch fehlschlagen. Ein teurerer endpoint kann sich lohnen, wenn er Timeout-bedingte Wiederholungsversuche, abgebrochene Sitzungen oder Support-Interventionen reduziert.
Vergleichen Sie beide Optionen unter repräsentativer Parallelität. Messen Sie die Zeit bis zum ersten token, die Abschlusslatenz, die Tail-Latenz und den Abschluss akzeptierter Aufgaben, anstatt sich auf einen Test mit einem untätigen endpoint zu verlassen.
Routing verändert den operativen Vergleich
Wir leiten jede Anfrage an den günstigsten, funktionierenden Anbieter weiter und verschieben sie zu einem anderen funktionierenden Anbieter, wenn ein Provider langsam oder nicht verfügbar wird. Das reduziert die Notwendigkeit für Ihre Anwendung, jeden anbieterspezifischen Wiederherstellungspfad zu implementieren, aber Sie sollten dennoch das End-to-End-Verhalten testen.
Wenn kein Provider ein Modell bereitstellen kann, gibt die API 503 no_available_provider zurück, und es wird nichts berechnet. Für Video gibt die Antwort an, wie viel der Job maximal kosten kann, bevor die Generierung beginnt. Keines dieser Verhaltensweisen eliminiert die Notwendigkeit, in Ihrem Produkt mit nicht verfügbarer Kapazität oder verzögerten Ergebnissen umzugehen.
Legen Sie diese Werte fest, bevor Sie endpoints vergleichen:
- Verfügbarkeitsziel: Definieren Sie, wann eine Funktion funktionieren muss und welches beeinträchtigte Verhalten akzeptabel ist.
- Latenzziel: Geben Sie die Antwortzeit an, die Benutzer benötigen, einschließlich des Verhaltens bei langsamen Enden (slow-tail behavior).
- Failover-Wert: Entscheiden Sie, welche Unterbrechungen eine alternative Kapazität oder ein anderes Modell rechtfertigen.
- Aufgabenkostenobergrenze: Legen Sie die maximal wirtschaftlich akzeptable Ausgabe für ein akzeptiertes Ergebnis fest.
Ein nützlicher Beschaffungsvergleich hält diese Anforderungen konstant. Andernfalls vergleichen Sie verschiedene Dienste anhand derselben Preiskategorie.
Legen Sie Ihr Budget fest, bevor Sie sich für ein Modell entscheiden
Entscheiden Sie sich erst für ein Modell, wenn Sie dessen Preis mit einem funktionsbezogenen Budget und einem messbaren Akzeptanztest verknüpfen können. Eine vielversprechende Playground-Antwort ist ein Ausgangspunkt, aber kein Beweis dafür, dass der gesamte Workflow wirtschaftlich ist.
Führen Sie Kontrollen für die Evaluierung ein
Wählen Sie die Abrechnungseinheit jeder Funktion. Halten Sie fest, ob das Ergebnis Input-Tokens, Output-Tokens, Bilder, Megapixel oder Jobs verbraucht. Führen Sie die angeforderte Konfiguration neben dieser Einheit, damit eine Änderung der Bildabmessungen oder Videoeinstellungen eine Budgetprüfung auslöst.
Erstellen Sie eine funktionsbezogene Prognose. Nutzen Sie das beobachtete Anfragevolumen und die Nutzung aus einer repräsentativen Stichprobe. Beziehen Sie den gesamten Ausführungspfad ein, einschließlich der Hintergrundverarbeitung und anwendungsgesteuerter Reparaturaufrufe, anstatt nur vom sichtbaren Prompt des Benutzers aus zu schätzen.
Senden Sie ein Preislimit mit Anfragen. Verwenden Sie die entsprechende
max_priceodermax_costKontrolle. Eine Anfrage wird niemals über dem von Ihnen gesendeten Wert abgerechnet, daher ist ein durchsetzbares Limit nützlicher, als anzunehmen, dass der typische Katalogpreis ein garantierter Höchstpreis ist.Teilen Sie das gemeinsame Guthaben bewusst zu. Ein Guthaben deckt Text-, Bild-, Video- und Musikmodelle ab. Führen Sie Ausgabenaufzeichnungen auf Funktionsebene, damit ein Medienexperiment die für einen etablierten Text-Workflow benötigten Mittel nicht verdeckt.
Evaluieren Sie ein alternatives Modell. Unsere API bietet einen API key für jedes Modell zum Listenpreis oder darunter. Ändern Sie den Modell-Identifikator, während Sie die Aufgabenanweisungen und Akzeptanzkriterien stabil halten, und vergleichen Sie dann die resultierenden Ergebnisse, anstatt die Antwort auszuwählen, die am ausgefeiltesten klingt.
Führen Sie einen begrenzten Produktionspilotlauf durch. Wählen Sie ein Überprüfungsfenster, das routinemäßigen und schwierigen Traffic erfasst. Vergleichen Sie die gemessenen Kosten pro akzeptierter Aufgabe mit Ihrer Prognose, bevor Sie den Zugriff erweitern oder die Parallelität erhöhen.
Untersuchen Sie den Unterschied, bevor Sie den Anbieter wechseln
Nutzen Sie den Dashboard-Playground, um Outputs zu vergleichen und Parameter anzupassen, bevor Sie die Produktion integrieren. Für die Extraktion prüfen Sie die Schema-Compliance und ob Felder vom Dokument unterstützt werden. Für das Coding bewerten Sie, ob die vorgeschlagene Änderung die Aufgabe erfüllt und die relevanten Prüfungen besteht.
Wenn die gemessenen Kosten die Prognose übersteigen, überprüfen Sie zuerst die Output-Länge, das Retry-Verhalten und die Context-Größe. Prüfen Sie dann, ob Ihre Anwendung die Workload geändert hat, z. B. durch das Anhängen vollständiger Konversationshistorien oder das wiederholte Bereitstellen derselben Dokumente. Gehen Sie nicht davon aus, dass eine höhere Rechnung bedeutet, dass der angegebene Tarif gestiegen ist.
Öffnen Sie diese Woche die Live-Preistabelle, identifizieren Sie die Funktion, die den größten Anteil Ihrer Ausgaben verursacht, und erstellen Sie deren Schätzung anhand der protokollierten Nutzung. Beauftragen Sie jemanden damit, die ersten gemessenen Ergebnisse mit dieser Prognose abzugleichen.
UberLLM bietet eine vereinheitlichte API und ein Prepaid-Guthaben für den Zugriff auf Text-, Bild-, Video- und Musikmodelle mit Preissteuerungen auf Anfrageebene. Besuchen Sie UberLLM, um Live-Modellpreise zu vergleichen, einen Kandidaten für Ihre Funktion mit den höchsten Ausgaben auszuwählen und dessen Kosten pro abgeschlossener Aufgabe zu testen, bevor Sie sich festlegen.