Hoeveel kost modelleren? Prijzen voor AI-inferentie uitgelegd
Hoeveel kost modelleren in 2026? Huidige AI-prijzen per token en per job, een formule voor de maandelijkse rekening, en de verborgen kosten die dit beïnvloeden.
De economie achter het creëren van frontier-modellen en het dagelijks gebruik van modellen verschilt sterk: De analyse van Epoch AI over trainingskosten schat dat hardware verantwoordelijk is voor 47%–67% van de ontwikkelingskosten van frontier-modellen, terwijl energie slechts 2%–6% vertegenwoordigt. Voor applicatieontwikkelaars is de relevante vraag echter niet wat het kostte om een model te bouwen. Het gaat erom wat je betaalt om een nuttige taak te voltooien, inclusief de verzoeken die een nieuwe poging vereisen.
Inhoudsopgave
- Huidige prijzen voor tekst-, beeld- en videomodellen
- Hoe een maandelijkse modelrekening te schatten
- Factoren die de kosten van inferentie beïnvloeden
- Waarom goedkopere tokens toch hogere rekeningen kunnen betekenen
- Hoe betrouwbaarheid en infrastructuur de werkelijke kosten verschuiven
- Stel uw budget in voordat u zich aan een model verbindt
Huidige Prijzen voor Tekst-, Afbeeldings- en Videomodellen
Hoeveel kost modellering? Voor AI-inferentie begint het antwoord met de factureringseenheid: tekst gebruikt invoer- en uitvoer-tokens, afbeeldingen gebruiken afbeeldingen of megapixels, en video kan jobs gebruiken. Dit artikel behandelt gebruiksprijzen voor inferentie, niet trainingsbudgetten. Stanford's gerapporteerde schatting voor de training van Gemini 1.0 Ultra was $192 miljoen, volgens Voronoi's presentatie van de AI Index-schatting, maar API-klanten betalen die ontwikkelingskosten niet direct.
De historische trend is opvallend. De Stanford 2025 AI Index mat de kosten van het opvragen van een systeem dat GPT-3.5-niveau prestaties behaalt op MMLU, dalend van ongeveer $20 per miljoen tokens in november 2022 naar $0.07 tegen oktober 2024. Dat is een benchmark-specifieke vergelijking, geen actuele prijsopgave voor elk capabel model.
Huidige prijzen per eenheid per modeltype
UberLLM toont live API-prijzen per model voor 254 modellen, waaronder GPT, Claude, Gemini, DeepSeek, GLM, Qwen, Llama, Mistral en Kimi. Chatprijzen scheiden invoer van uitvoer.
| Model | Factureringseenheid | UberLLM-prijs | Lijstprijs |
|---|---|---|---|
| Claude Opus 5.5, invoer | Per 1M input tokens | $2.03 | $4.00 |
| Claude Opus 5.5, uitvoer | Per 1M output tokens | $10.13 | $20.00 |
| Kimi K3, invoer | Per 1M input tokens | $0.003 | $0.19 |
| Kimi K3, uitvoer | Per 1M output tokens | $0.23 | $15.00 |
| FLUX 2 Pro afbeelding | Per image | $0.0075 | $0.03 |
| Nano Banana 2 afbeelding | Per image | $0.015 | $0.10 |
| FLUX.2 Klein 4B afbeelding | Per megapixel | $0.00015 | $0.015 |
| Veo 3.1 Full text-naar-video | Per job | $0.22 | $0.44 |
| Kling 3 Standard afbeelding-naar-video | Per job | $0.063 | $0.084 |
| LTX 2.3 Fast text-naar-video | Per job | $0.045 | $0.06 |
| Runway Gen-4 Turbo | Per job | $0.0675 | Geen geverifieerde lijstprijs beschikbaar |
Gebruik de video API-prijsvergelijking om het live job-aanbod te controleren voordat je mediabestedingen inschat. Een job-prijs is alleen zinvol in combinatie met de uitvoerconfiguratie die je van plan bent aan te vragen.
De vermelde prijs is wat een aanvraag doorgaans kost, geen maximum. Lees elke rij door de eenheid te identificeren die jouw functie verbruikt, en vermenigvuldig die eenheid vervolgens met het verwachte gebruik. Vergelijk een megapixelprijs niet direct met een prijs per afbeelding zonder rekening te houden met de afbeeldingsafmetingen.
Hoe een maandelijkse modelrekening te schatten
Baseer de schatting op productfuncties, niet op één gecombineerde token-toelage. Een ondersteuningsgesprek, documentextractie en videovoorbeeld verbruiken verschillende middelen, dus door ze te vroeg te combineren, wordt verborgen welke functie aandacht nodig heeft.
De berekening begint met volume en gemeten gebruik.
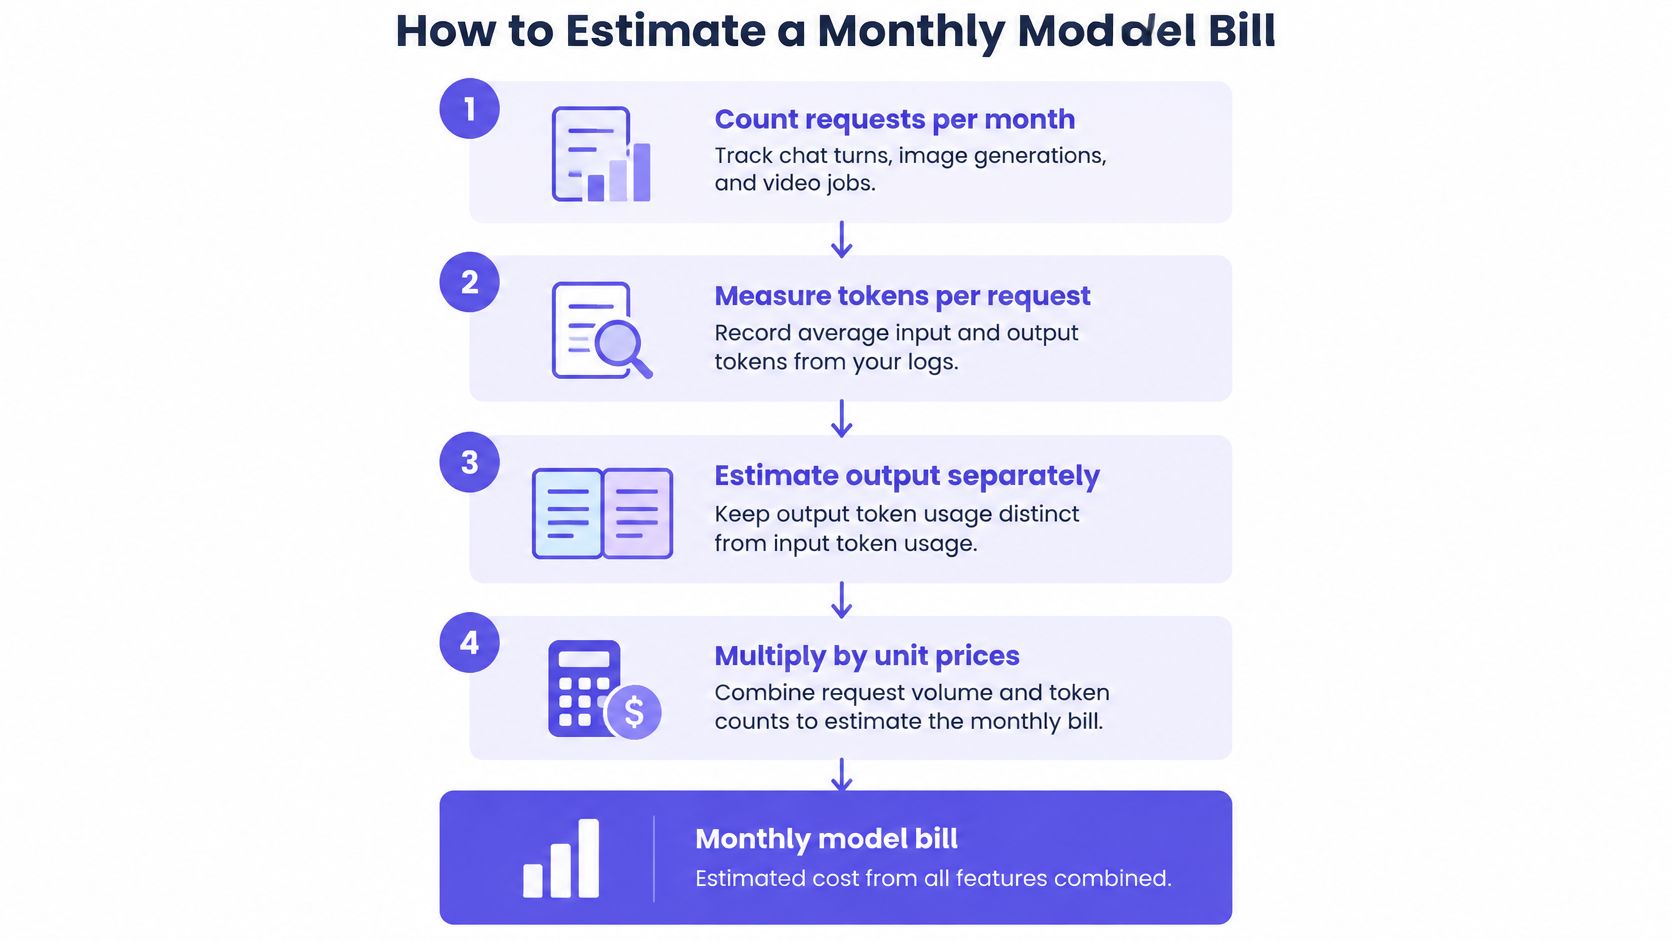
Tel verzoeken per functie. Registreer chatgesprekken, documentverwerkingsaanroepen, beeldgeneraties en videotaken afzonderlijk. Neem achtergrondaanroepen mee, niet alleen acties die zichtbaar zijn voor gebruikers.
Meet input en output onafhankelijk. Leg de werkelijke token-aantallen vast uit gebruiksvelden van antwoorden en logs. Neem systeeminstructies, gespreksgeschiedenis, opgehaalde passages en toolresultaten mee in de inputmeting.
Pas de exacte tarieven van het model toe. Vermenigvuldig maandelijkse input tokens met het inputtarief en maandelijkse output tokens met het outputtarief, gebruikmakend van de factureringsnoemer die in de catalogus wordt getoond. Noteer de model-ID naast elke berekening, zodat een modelwijziging de prognose niet ongeldig maakt.
Voeg media-eenheden toe. Vermenigvuldig het volume van afbeeldingen, megapixels en videotaken met hun bijbehorende prijzen. Houd configuratiespecifieke taken gescheiden in plaats van niet-gerelateerde outputs te middelen.
Neem extra pogingen mee. Onderscheid applicatie-retries, afgewezen-maar-succesvol-gegenereerde antwoorden en providerfouten. Onze mislukte verzoeken of generaties worden niet in rekening gebracht, maar een geleverd antwoord dat uw applicatie afwijst, vertegenwoordigt nog steeds werk dat uw workflow heeft verbruikt.
Houd rekening met financieringskosten. Wij voegen geen kosten toe bovenop de vermelde modelprijzen, en er is geen maandelijkse vergoeding of minimum. Kaartsaldo-aanvullingen brengen een bekendgemaakte 5.5% plus $0.50 vergoeding met zich mee, dus houd die financieringskosten gescheiden van de uitgaven voor verzoeken.
Maak van de schatting een bruikbaar budget
De basisberekening voor tekst is:
Maandelijkse tekstuitgaven = input-token kosten + output-token kosten over alle pogingen heen.
Voeg vervolgens mediabestedingen en eventuele ondersteunende applicatiediensten toe. De gids voor AI-prijsmodellen helpt factureringsstructuren te onderscheiden voordat u ze combineert.
Ons gepubliceerde maandelijkse voorbeeld bedraagt in totaal $113.00, vergeleken met $400.00 op OpenRouter of tegen officiële prijzen, een verschil van $287.00. Beschouw dat als een voorbeeldwerkbelasting, niet als een voorspelling voor een applicatie met een andere modelmix of outputvolume.
Budgetteringsregel: Houd een maandelijks totaal bij voor elke functie, een gemiddelde kostprijs per verzoek en een aparte toelage voor onzekerheid. Een enkel accounttotaal kan niet verklaren waarom de uitgaven zijn veranderd.
Factoren die de kosten van inferentie beïnvloeden
Een modelaanroep lijkt op een taxirit: alleen de afstand bepaalt de rekening niet als wachttijd ook meespeelt. Voor inferentie is het tokenvolume slechts een deel van de berekening; de vorm van de workload en de serving-vereisten beïnvloeden de middelen die nodig zijn om het antwoord te leveren.
Kostenfactoren en wat elk ervan met de rekening doet
| Factor | Effect op kosten | Wat te doen |
|---|---|---|
| Outputlengte | Langere antwoorden verbruiken meer gefactureerde output | Beperk output en vraag om beknopte formaten |
| Modelniveau | Hogere capaciteit kan een hogere tokenprijs met zich meebrengen | Test het minst dure model dat aan je kwaliteitseisen voldoet |
| Contextlengte | Lange retrieval-contexten verhogen het geheugenverkeer en verminderen de throughput | Stuur alleen relevante opgehaalde passages |
| Kwantisatie | Lagere precisie kan de throughput verbeteren, maar de kwaliteit beïnvloeden | Evalueer de geïmplementeerde precisie op representatieve taken |
| Facturatie-eenheid | Afbeeldingen, megapixels en videotaken meten verschillende outputs | Stem de eenheid af op de output van je product |
| Latentieniveau | Capaciteit geschikt voor interactief werk kan een premium met zich meebrengen | Stem serving-vereisten af op gebruikerstolerantie |
| Mislukte generaties | Extra pogingen kosten tijd en kunnen factureerbaar werk creëren | Scheid providerfouten van afwijzing op applicatieniveau |
Een inferentiestudie voor consumenten-GPU's schatte de elektriciteitskosten van $0.001–$0.005 per miljoen tokens voor gewone API-workloads, versus $0.14–$0.22 voor retrieval-augmented generation met 32K context, en rapporteerde dat NVFP4 ongeveer 1.6 keer de BF16 throughput leverde met 41% minder energie en een geschat 2%–4% kwaliteitsverlies.
Dit zijn schattingen van de operationele elektriciteitskosten, geen API-prijzen voor klanten. Ze sluiten de rest van de serving-activiteiten uit, en ze zijn niet direct vergelijkbaar met de gefactureerde input- en outputtarieven in de prijstabel.
Zelf-hosting heeft een eigen berekening nodig
Een LLaMA inferentie benchmark wees uit dat het serveren van een 65B model ruwweg 8–32 GPU's vereiste, met een gerapporteerd inferentie-stroomverbruik van ongeveer 300 watt tot 1 kilowatt, afhankelijk van de sharding-configuratie. Zelf-hosting heeft daarom een benuttingsberekening nodig, niet alleen een elektriciteitsschatting: neem hardware, geheugen, netwerken, operations en ongebruikte capaciteit mee.
Gebruik de modelprijs-wijzigingstracker bij het beoordelen van alternatieven. We laten je van model wisselen door de model-ID te wijzigen, maar compatibiliteit staat niet gelijk aan vergelijkbare kwaliteit.
Kies het goedkoopste model dat je eigen evaluatie doorstaat, verminder vervolgens onnodige context en output voordat je een lager tarief onderhandelt.
Waarom Goedkopere Tokens Toch Hogere Rekeningen Kunnen Betekenen
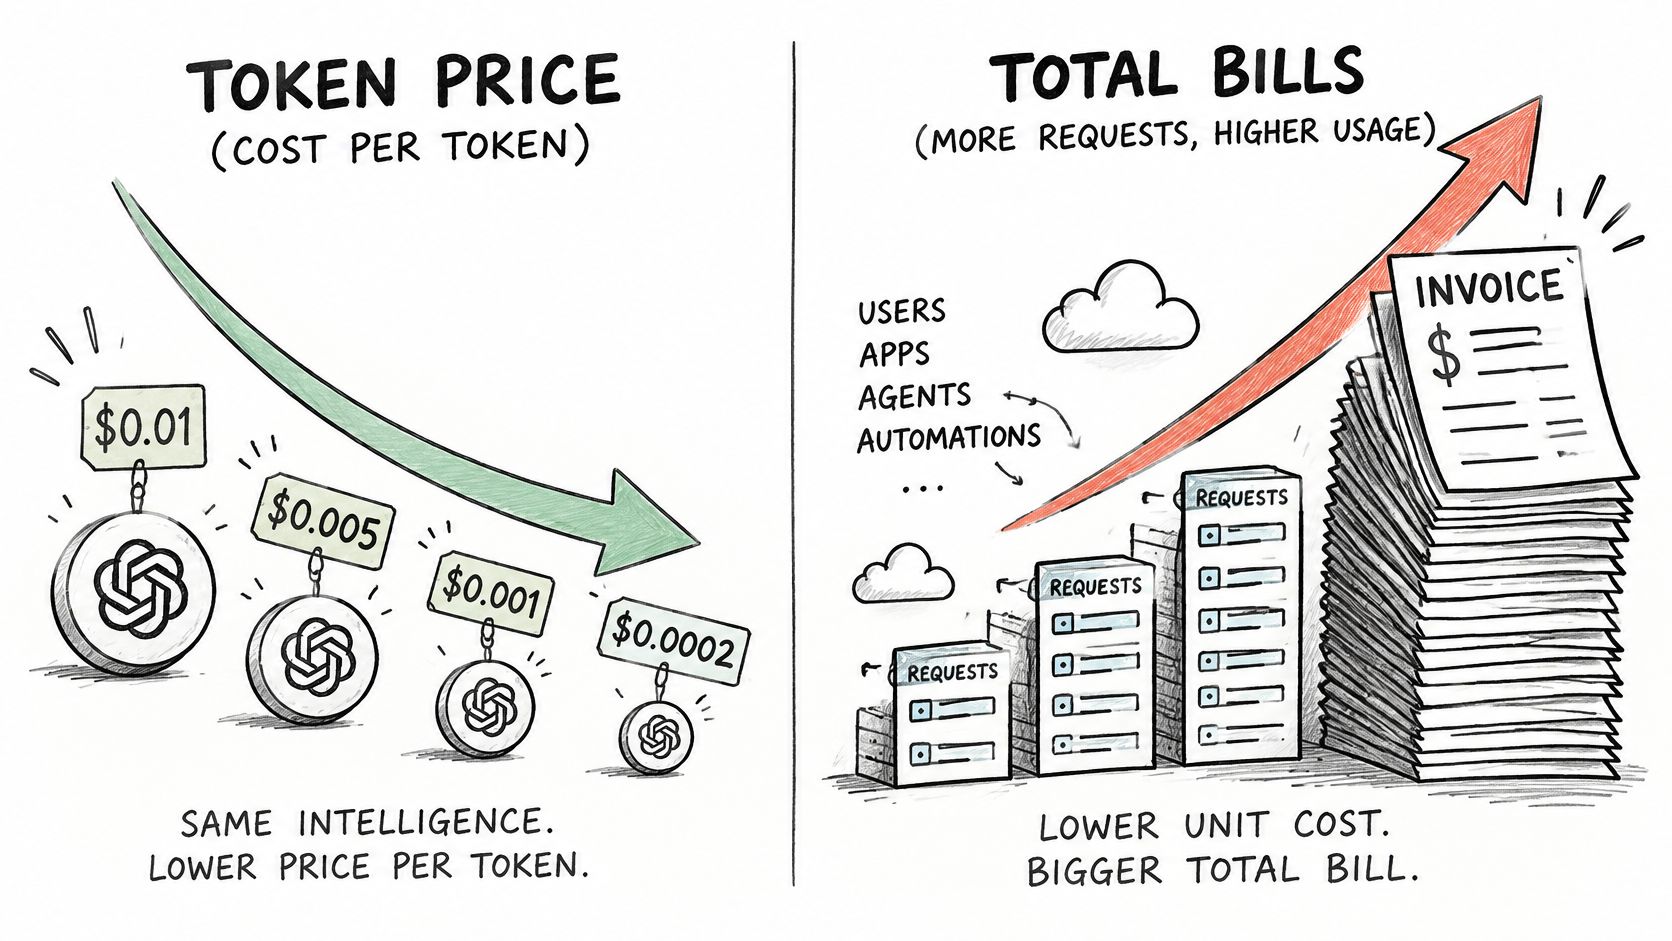
Een schatting in TCS's analyse van uitkomstgerichte generatieve AI-uitgaven meldt dat de kosten per token ruwweg 1,000 keer daalden over drie jaar terwijl de totale uitgaven aan inferentie bleven stijgen, en merkt op dat output tokens gewoonlijk drie tot zes keer meer kosten dan input tokens. Lagere eenheidsprijzen garanderen geen lagere applicatie-uitgaven.
Het onderscheid is gemakkelijker te zien wanneer prijs en gebruik in tegengestelde richtingen bewegen.
Vergelijk voltooid werk, niet geïsoleerde generaties
Overweeg een illustratieve workflow voor documentextractie. Het lager geprijsde model produceert een uitgebreide uitleg in plaats van de vereiste gestructureerde respons, dus uw applicatie dient een reparatieverzoek in. Als de gerepareerde respons nog steeds de validatie faalt, escaleert de workflow naar een sterker model.
Het alternatieve model kost meer per output token maar retourneert onmiddellijk een acceptabel gestructureerd resultaat. De hogere eenheidsprijs kan leiden tot lagere totale taakkosten omdat u de reparatieprompt, de herhaalde documentcontext en de fallback-generatie vermijdt.
Die uitkomst is niet onvermijdelijk. Het is precies wat een representatieve evaluatie zou moeten bepalen.
Kosten per voltooide taak = totale workflow-uitgaven ÷ succesvol voltooide taken.
Neem retrieval, tool calls, guardrails en human escalation mee wanneer deze tot die workflow behoren. Definieer succes voordat u meet: een antwoord dat is aangekomen, is niet noodzakelijkerwijs een antwoord dat uw product kan gebruiken.
Dit onderscheid is ook van belang bij het interpreteren van bredere discussies over AI-economie.
Diagnosticeer het dure pad
Volg prompt length, output length, validation failures en fallback decisions naast de uitgaven. Een goedkope eerste poging kan de moeite waard blijven als het routinetaken oplost en moeilijke taken selectief escaleert. Het wordt verspillend wanneer bijna elke taak betaalt voor zowel de initiële poging als de fallback.
Verwijder geen kwaliteitscontroles alleen om de schijnbare succesratio te verbeteren. Dat verandert de definitie van succes in plaats van de kosten van nuttig werk te verlagen.
Beslissingstest: Wat zal een geaccepteerde workflow kosten na lange outputs, retries en ondersteunende services, niet alleen na de eerste modeloproep?
Hoe betrouwbaarheid en infrastructuur de echte kosten verschuiven
Een geadverteerde prijs garandeert niet dat er voldoende capaciteit beschikbaar is wanneer uw applicatie die nodig heeft. Regio, afnameverplichting, latentievereisten en capaciteitstype beïnvloeden allemaal de vergelijking.
Een GPU-prijs- en inferentiekosten-tracker rapporteerde H100 prijzen van ongeveer $0.34 per uur voor spot-instances tot ruwweg $3.46 per uur gemiddeld, naast een schatting van $0.50–$3 per miljoen output-tokens voor vergelijkbare-capaciteit-serving over providers, latentie-tiers en context-vensters. Deze bereiken beschrijven verschillende aankoopvoorwaarden, geen uitwisselbare aanbiedingen.
Batchwerk en interactief werk vereisen verschillende capaciteit
Voor batchverwerking kan een voordelig endpoint acceptabel zijn, zelfs wanneer de voltooiingstijden fluctueren. Een documentclassificatie-wachtrij kan werk pauzeren of opnieuw plannen als de applicatie de taakstatus bijhoudt en dubbele verwerking voorkomt. Extra betalen voor onmiddellijke reacties voegt mogelijk weinig waarde toe.
Voor interactieve producten kan hetzelfde endpoint een slechte aankoop zijn. Als gebruikers een verzoek afbreken voordat het is voltooid, kan technisch succesvolle generatie commercieel alsnog mislukken. Een duurder endpoint kan de moeite waard zijn wanneer het timeout-gerelateerde herpogingen, afgebroken sessies of ondersteuningsinterventies vermindert.
Vergelijk beide opties onder representatieve gelijktijdigheid. Meet de tijd tot het eerste token, voltooiingslatentie, staartlatentie en voltooiing van geaccepteerde taken, in plaats van te vertrouwen op een test met een inactief endpoint.
Routering verandert de operationele vergelijking
We routeren elk verzoek naar de goedkoopste gezonde verkoper en verplaatsen het naar een andere gezonde verkoper wanneer een provider traag of onbeschikbaar wordt. Dat vermindert de noodzaak voor uw applicatie om elk verkoperspecifiek herstelpad te implementeren, maar u moet nog steeds het end-to-end gedrag testen.
Als geen enkele provider een model kan leveren, retourneert de API 503 no_available_provider, en wordt er niets in rekening gebracht. Voor video vermeldt het antwoord het maximale bedrag dat de taak kan kosten voordat de generatie begint. Geen van beide gedragingen elimineert de noodzaak om onbeschikbare capaciteit of vertraagde resultaten in uw product af te handelen.
Stel deze waarden in voordat u endpoints vergelijkt:
- Beschikbaarheidsdoel: Definieer wanneer een functie moet werken en welk verslechterd gedrag acceptabel is.
- Latentiedoel: Specificeer de reactietijd die gebruikers nodig hebben, inclusief traag-staartgedrag.
- Failover-waarde: Bepaal welke onderbrekingen alternatieve capaciteit of een ander model rechtvaardigen.
- Taakkostenplafond: Stel de maximaal economisch acceptabele uitgave in voor een geaccepteerd resultaat.
Een nuttige inkoopvergelijking houdt die vereisten constant. Anders vergelijkt u verschillende diensten via dezelfde prijsparameter.
Stel uw budget in voordat u zich aan een model bindt
Bind u pas aan een model nadat u de prijs ervan kunt koppelen aan een budget op functieniveau en een meetbare acceptatietest. Een veelbelovende reactie in de playground is een startpunt, geen bewijs dat de gehele workflow economisch is.
Voer controles in rond de evaluatie
Kies de factureringseenheid van elke functie. Noteer of de oplevering input tokens, output tokens, images, megapixels of jobs verbruikt. Houd de gevraagde configuratie naast die eenheid, zodat een wijziging in afbeeldingsdimensies of video settings een budgetcontrole activeert.
Stel een prognose op functieniveau op. Gebruik het waargenomen aanvraagvolume en gebruik van een representatieve steekproef. Neem het volledige uitvoeringspad mee, inclusief background processing en application-directed repair calls, in plaats van alleen te schatten op basis van de zichtbare prompt van de gebruiker.
Stuur een prijslimiet mee met aanvragen. Gebruik de toepasselijke
max_priceofmax_costcontrol. Een aanvraag wordt nooit gefactureerd boven de waarde die u meestuurt, dus een afdwingbare limiet is nuttiger dan aannemen dat de typische catalogusprijs een gegarandeerd maximum is.Wijs het gedeelde saldo bewust toe. Eén saldo dekt text, image, video en music models. Houd uitgavenoverzichten op functieniveau bij, zodat een media-experiment de benodigde fondsen voor een gevestigde text workflow niet verhult.
Evalueer een alternatief model. Onze API biedt één key voor elk model tegen de catalogusprijs of minder. Wijzig de model identifier terwijl u de task instructions en acceptance criteria stabiel houdt, en vergelijk vervolgens de resulterende opleveringen in plaats van de meest gepolijste klinkende antwoord te kiezen.
Voer een begrensde productiepilot uit. Kies een beoordelingsperiode die zowel routine- als moeilijk verkeer omvat. Vergelijk de gemeten kosten per geaccepteerde task met uw prognose voordat u de toegang uitbreidt of de concurrency verhoogt.
Onderzoek het verschil voordat u overstapt naar een andere provider
Gebruik de dashboard playground om outputs te vergelijken en parameters aan te passen vóór productie-integratie. Voor extraction, controleer schema compliance en of velden worden ondersteund door het document. Voor coding, evalueer of de voorgestelde wijziging voldoet aan de task en de relevante checks doorstaat.
Wanneer de gemeten kosten de prognose overschrijden, controleer dan eerst output length, retry behavior en context size. Controleer vervolgens of uw applicatie de workload heeft gewijzigd, zoals het toevoegen van volledige conversatiegeschiedenissen of het herhaaldelijk aanleveren van dezelfde documenten. Ga er niet vanuit dat een hogere rekening betekent dat het vermelde tarief is gestegen.
Open deze week de live pricing table, identificeer de functie die verantwoordelijk is voor het grootste deel van uw uitgaven, en stel de schatting op basis van logged usage op. Wijs iemand aan om de eerste gemeten resultaten te controleren aan de hand van die prognose.
UberLLM biedt een uniforme API en een prepaid saldo voor toegang tot text, image, video en music models, met request-level price controls. Bezoek UberLLM om live model prices te vergelijken, een kandidaat te kiezen voor uw functie met de hoogste uitgaven en de kosten per voltooide task te testen voordat u zich vastlegt.