AI Prijsmodellen Uitgelegd: Tokens, Taken en Kosten
Vergelijk AI prijsmodellen: per token, per taak, abonnementen en creditfacturering, plus hoe je kunt inschatten wat je inference echt zal kosten.
Je hebt een AI-functie werkend, en nu probeer je er een prijs voor te bepalen. Het token-tarief van het model lijkt beheersbaar, maar de factuur voor de staging-omgeving omvat lange antwoorden, retries, tool calls, en video jobs die nooit iets bruikbaars hebben opgeleverd. Het vermenigvuldigen van het basistarief met je verwachte verkeer levert je geen geloofwaardig budget meer op.
AI-prijsmodellen beschrijven hoe leveranciers je kosten in rekening brengen. Kosten per voltooide taak vertellen je of de functie economisch is. Je hebt beide perspectieven nodig: de billing unit om kosten af te stemmen, en het uiteindelijke resultaat om modellen, providers, en productmarges te vergelijken.
Inhoudsopgave
- Zes AI-prijsmodellen en hoe elk ervan u factureert
- Hoe token-prijzen resulteren in een factuur per verzoek
- Mediaprijzen voor afbeeldingen, video en audio
- Waarom kosten per voltooide taak beter zijn dan kosten per token
- Waarom modelprijzen blijven dalen
- Kiezen tussen credits, abonnementen en gebruiksfacturering
- Checklist voor providers buiten de vermelde prijs
- Bevestig uw kosten per taak voordat u zich vastlegt
Zes AI-prijsmodellen en hoe elk ervan je factureert
De meeste AI-producten factureren via een van de zes structuren. De tabel toont de facturatie-eenheid, de beste toepassing en het grootste risico voor elk model.
Veelvoorkomende AI-prijsmodellen in één oogopslag
| Prijsmodel | Hoe je wordt gefactureerd | Beste toepassing | Grootste risico |
|---|---|---|---|
| Per-token | Per miljoen input- en output-tokens, afzonderlijk geprijsd | Chat, coding, tekst-API's | Factuur stijgt met de lengte van het antwoord |
| Per-eenheid media | Per afbeelding, per seconde video, of per generatietaak | Afbeeldings-, video-, spraak- en muziekhulpmiddelen | Resolutie en duur veranderen de eenheidsprijs |
| Abonnement met quota | Vast maandelijks bedrag met een gebruiksbeperking | Stabiele, op zitplaatsen gebaseerde producten | Extra kosten of beperking na de limiet |
| Vooraf betaalde credits | Saldo wordt per verzoek afgeschreven | Variabele workloads bij verschillende providers | Ongebruikt saldo kan verlopen |
| Op resultaat gebaseerd | Kosten per voltooide taak of opgeloste zaak | Supportmedewerkers, workflows met duidelijke succesdefinities | Succes definiëren is moeilijk |
| Hybride | Basisabonnement plus gemeten gebruik of credits | Producten met gemengde tekst- en media-workloads | Twee facturatiecomponenten om af te stemmen |
Stem de eenheid af op de workload
Per-token billing past bij tekst-workloads omdat het de verwerkte en gegenereerde inhoud meet. Het is nuttig voor chat en coding, maar een instructie om een gedetailleerde uitleg te produceren kan de factuur veranderen zonder het aantal verzoeken te wijzigen.
Per-eenheid media billing is op het eerste gezicht gemakkelijker te begrijpen: betaal voor een afbeelding of generatietaak. De moeilijkheid zit in de definitie van die eenheid, inclusief resolutie, duur, kwaliteitsinstellingen en geluid.
Abonnementen met quota werken wanneer een team regelmatige toegang nodig heeft en binnen een voorspelbare toelage kan blijven. Controleer wat er gebeurt bij de limiet voordat je het abonnement als een vaste bedrijfskost beschouwt.
Vooraf betaalde credits plaatsen uitgaven achter een gefinancierd saldo. Ze zijn geschikt voor experimenten met verschillende modellen, mits je de vervaldatum, terugbetalingen en hoe credits zich vertalen naar daadwerkelijk gebruik begrijpt.
Op resultaat gebaseerde prijzen brengen de kosten dichter bij de bedrijfswaarde. Een support-workflow heeft echter een expliciete oplossingstest nodig, inclusief wat er gebeurt wanneer de klant de zaak heropent.
Hybride plannen combineren toegang of een inbegrepen toelage met variabel verbruik. Ze kunnen gemengde workloads aan, maar financiën moeten zowel de basiskosten als de gemeten component afstemmen.
Praktische regel: Identificeer de eenheid die de leverancier factureert voordat je een gepubliceerde prijs vergelijkt.
Een abonnement is niet automatisch goedkoper dan gebruiksfacturatie, en credits zijn niet automatisch een korting. Vertaal elk aanbod naar de workload die je van plan bent uit te voeren, inclusief eventuele toelage waarvoor je betaalt maar die je niet zult gebruiken.
Hoe tokenprijzen een factuur per verzoek worden
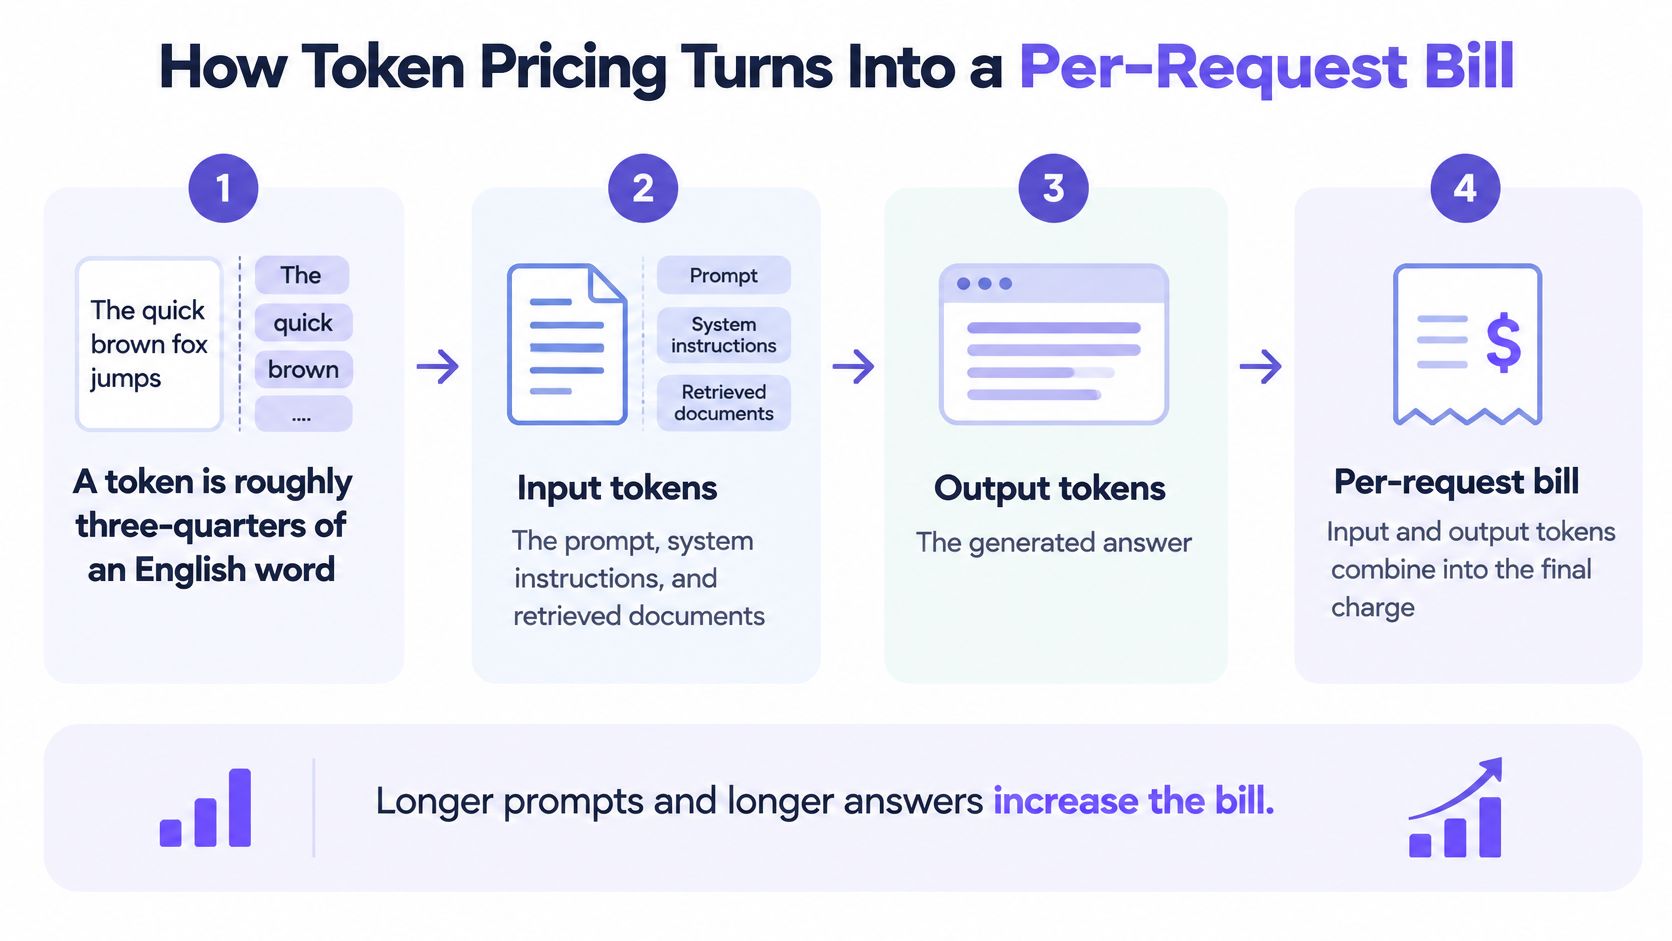
Verzoekkosten = (input tokens ÷ tokens per prijseenheid × input rate) + (output tokens ÷ tokens per prijseenheid × output rate).
Voor prijzen die per miljoen tokens worden vermeld, gebruikt u een miljoen als deler. Input tokens omvatten de prompt, systeeminstructies, gespreksgeschiedenis en opgehaalde documenten. Output tokens omvatten het gegenereerde antwoord. Gebruik de tokenizer van het model of de geretourneerde gebruiksvelden in plaats van een benadering op basis van woordtelling, vooral voor code en meertalige tekst.
Aparte tarieven zijn belangrijk. Een arXiv-analyse van API pricing meldt dat GPT-4 in maart 2023 werd gelanceerd voor $30 per miljoen input tokens en $60 per miljoen output tokens. Generatie vereist andere berekeningen dan het verwerken van een prompt, dus ga er niet van uit dat de twee tarieven overeenkomen.
Reken een verzoek door met beide tarieven
Overweeg een hypothetisch verzoek met 2,000 input tokens en 800 output tokens. Claude Opus 5.5 kost $4.00 input en $20.00 output per miljoen tokens tegen de catalogusprijs, vergeleken met $2.03 input en $10.13 output op UberLLM.
| Component | Tegen catalogusprijs | Via onze marktplaats |
|---|---|---|
| Inputberekening | 2,000 ÷ 1,000,000 × $4.00 | 2,000 ÷ 1,000,000 × $2.03 |
| Inputkosten | $0.008 | $0.00406 |
| Outputberekening | 800 ÷ 1,000,000 × $20.00 | 800 ÷ 1,000,000 × $10.13 |
| Outputkosten | $0.016 | $0.008104 |
| Totaal | $0.024 | $0.012164, ongeveer $0.012 |
Deze berekeningen beschrijven het hypothetische verzoek, niet een gemiddelde voor uw toepassing. Bij een hypothetisch miljoen verzoeken per maand met precies die tokenmix, is het verschil $11,836, of ruwweg $12,000. Een andere outputlengte verandert het resultaat.
De factureringsstroom maakt het onderscheid tussen promptgrootte en antwoordgrootte gemakkelijker te inspecteren.
Maak uw schatting op basis van daadwerkelijke verzoeken
- Tel input tokens met behulp van uw prompt-sjabloon en representatieve klantgegevens. Voeg instructies en opgehaalde context toe.
- Schat output tokens op basis van geaccepteerde antwoorden, niet alleen de kortste succesvolle demonstratie.
- Pas elk tarief toe afzonderlijk op het bijbehorende aantal tokens.
- Tel de resultaten op om de modelkosten voor dat verzoek te verkrijgen.
- Vermenigvuldig met het verwachte volume, waarbij korte en lange verzoekklassen gescheiden worden gehouden.
Onze vermelde modelprijs beschrijft wat een verzoek doorgaans kost, niet een plafond. Een verzoek wordt nooit gefactureerd boven een max_price of max_cost die ermee is meegestuurd. Houd dat onderscheid expliciet in uw toepassing: een schatting helpt bij het voorspellen van uitgaven, terwijl een verzoekplafond een limiet afdwingt.
Mediaprijzen voor afbeeldingen, video en audio
Voorbeeld van mediaprijzen per eenheid, lijst versus UberLLM
| Model | Facturatie-eenheid | Lijstprijs | UberLLM-prijs |
|---|---|---|---|
| Flux 2 Pro image | Per afbeelding | $0.03 | $0.0075 |
| LTX 2.3 Fast Text to Video | Per taak | $0.06 | $0.045 |
| Veo 3.1 Full Text-to-Video | Per taak | $0.44 | $0.22 |
De Flux-prijs is 75% lager, berekend op basis van de vermelde afbeeldingsprijzen. LTX is 25% lager, en Veo is 50% lager. Elke vergelijking is alleen van toepassing op het genoemde model en de overeenkomende instelling, niet op elke afbeelding- of videoverzoek.
Mediaproducten factureren vaak in andere eenheden dan text tokens. Een generatietaak, afbeelding, audioduur of videoduur wordt de eenheid die je moet normaliseren. De modelkeuze en uitvoerinstellingen bepalen wat die eenheid oplevert.
Vergelijk identieke generatie-instellingen
Een goedkope korte clip is geen vervanging voor de langere, hogere-resolutie asset die jouw product nodig heeft. Geluid is ook belangrijk: een stille preview en een afgewerkte audiovisuele clip zijn geen gelijkwaardige deliverables.
Voordat je providers vergelijkt, bepaal je:
- Model en taak: Houd de modelversie en generatiemodus identiek, inclusief text-to-video versus image-to-video.
- Resolutie en duur: Noteer de gevraagde afmetingen en cliplengte in plaats van te vertrouwen op de naam van een model.
- Audio-instelling: Geef aan of gegenereerd geluid is inbegrepen.
- Taakdefinitie: Bevestig wat een taak omvat en of extensies, upscaling of aanvullende outputs afzonderlijke verzoeken vereisen.
De Veo API prijs-per-seconde gids helpt bij het opzetten van duurgebaseerde vergelijkingen. Converteer een offerte per taak niet naar een prijs per seconde totdat je de duur weet die die offerte dekt.
Een mediaprijsvergelijking is alleen nuttig wanneer beide prijzen hetzelfde deliverable opleveren.
Voor audio, onderscheid gegenereerde spraak van transcriptie en muziekgeneratie. De duur van geüploade audio en de duur van gegenereerde output zijn verschillende metingen, dus noteer degene die de service factureert.
Houd een klein instellingenmanifest bij je prijzenoverzicht: model identifier, task, dimensions, duration, audio en eventuele kwaliteitsopties. Prijs dat manifest bij elke provider, en sla vervolgens de offerte en configuratie samen op. Je kunt de vergelijking herhalen wanneer prijzen veranderen zonder per ongeluk een ander product te vergelijken.
Waarom kosten per afgeronde taak beter zijn dan kosten per token
Het goedkoopste tarief per token kan de duurste afgeronde taak opleveren. Een model dat herhaalde correcties, onnodige tool-aanroepen of handmatige reparatie nodig heeft, kan goedkopere tokens verbruiken terwijl het meer kost om een bruikbaar resultaat te leveren.
Het verschil wordt zichtbaar wanneer je een direct antwoord vergelijkt met een workflow die steeds acties blijft uitvoeren.
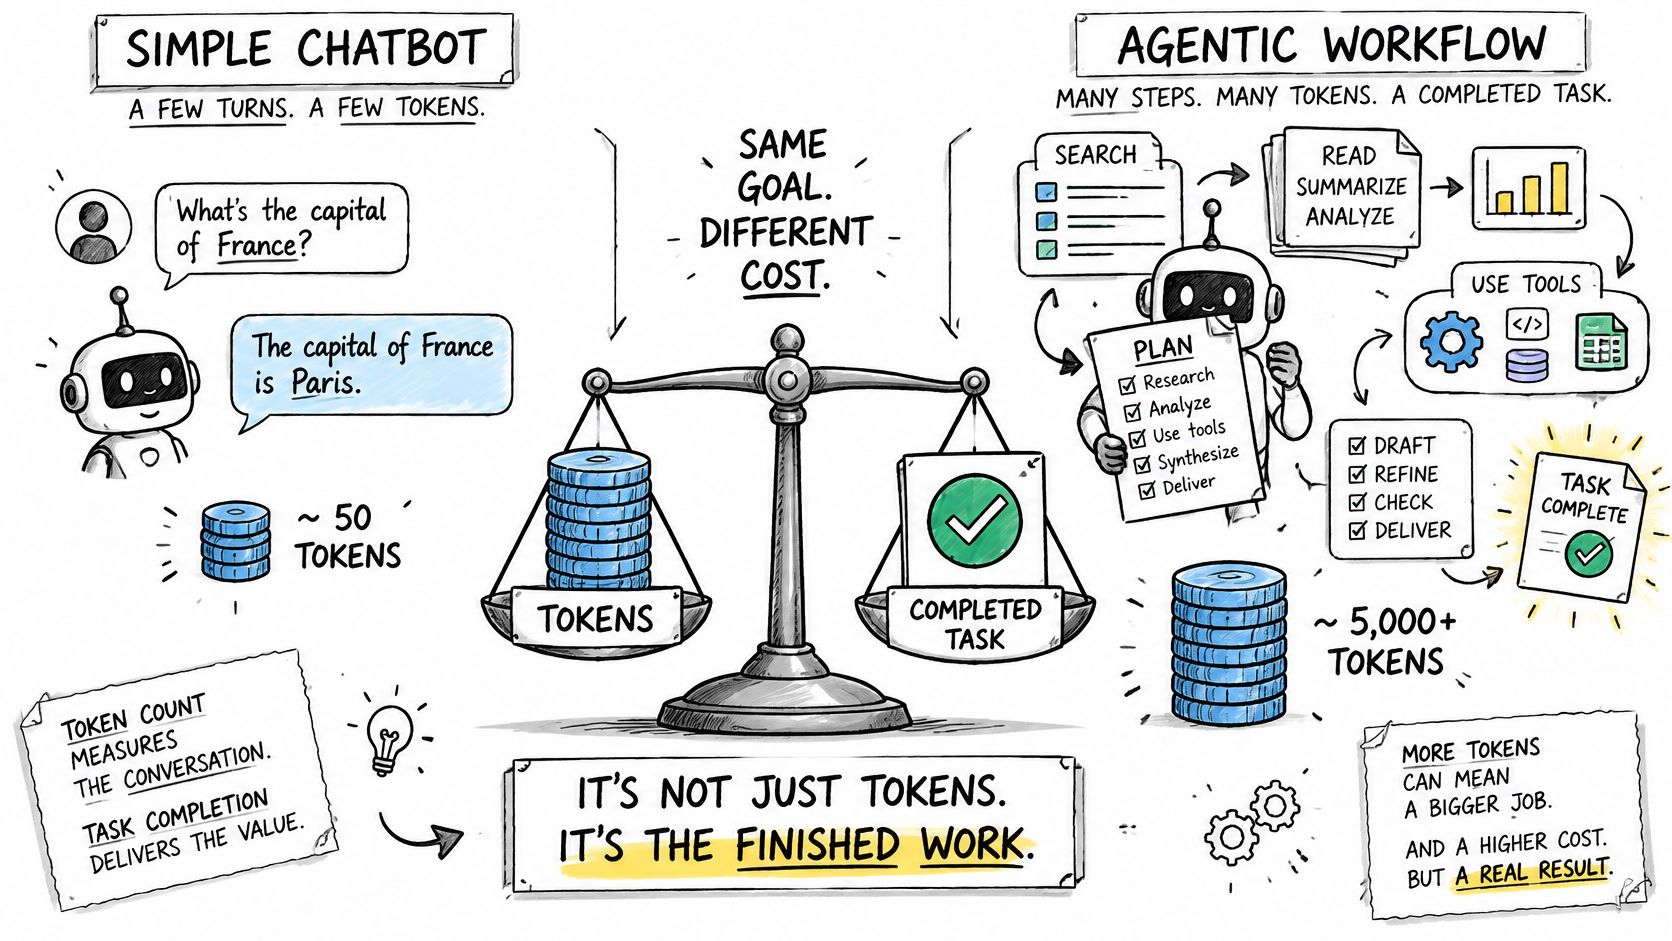
Oometa's kostenanalyse van agent-workflows beschrijft dat agentic workflows 5–30 keer meer tokens verbruiken dan een traditionele chatbotinteractie en schat ongeveer $0.001 voor een eenvoudige chatbot-aanroep versus $0.10–$1.00 voor een agenttaak in meerdere stappen. Zie die cijfers als context, niet als jouw prognose: planning, retrieval, tools, reflectie en retries verschillen per implementatie.
Zet onsuccesvol werk in de teller
Kosten per succesvolle uitkomst = totale taakgerelateerde uitgaven ÷ succesvol afgeronde taken.
In een hypothetische batch 1,000 pogingen van $0.10 per stuk kosten $100. Als 800 slagen, zijn de kosten per opgeloste taak $0.125, niet $0.10. De mislukte pogingen horen nog steeds bij de kostenberekening.
Een tweede hypothetische vergelijking laat zien waarom stickerprijzen misleiden:
| Hypothetisch model | Kosten per poging | Slagingspercentage | Kosten per succes |
|---|---|---|---|
| Goedkoper model | $0.05 | 30% | Ongeveer $0.167 |
| Duurder model | $0.10 | 90% | Ongeveer $0.111 |
Dit zijn rekenvoorbeelden, geen gemeten modelprestaties. Ze gaan uit van vergelijkbare pogingen en een ongewijzigd slagingspercentage; je evaluatie moet beide vaststellen.
De video biedt een andere manier om naar workflowkosten te kijken.
Houd outputlengte, retries, latency-gedreven fallbacks en kosten voor mislukte requests bij, gekoppeld aan een gedeelde taak-ID. Neem tool- of infrastructuurkosten mee wanneer ze belangrijk zijn, en maak onderscheid tussen een API-respons en een zakelijk succes.
Een supportantwoord dat een medewerker moet herschrijven, is niet gelijk aan een opgelost ticket. Gebruik de uitkomst die je klant nodig heeft: een opgeloste case, een geaccepteerde clip of een codetaak die de acceptatietests doorstaat.
Waarom modelprijzen blijven dalen
Het goedkoopste model dat GPT-3.5-prestatieniveau op MMLU evenaart, daalde van ongeveer $20 per miljoen tokens in november 2022 naar $0.07 in oktober 2024, ruwweg 286 keer goedkoper, volgens Orb's samenvatting van door Stanford gerapporteerde cijfers. Stanford's 2025 AI Index Report beschrijft de daling van de inferentiekosten voor vergelijkbare capaciteit in die periode als meer dan 280-voudig.
Die vergelijking houdt de benchmarkdrempel constant. Het vergelijkt niet zomaar een duur, capabel model met een goedkoper, zwak model, hoewel het evenaren van een benchmark nog steeds geen gelijkwaardig gedrag in uw toepassing garandeert.
Budgetteren voor veranderend aanbod, geen vast tarief
Kleinere architecturen, kwantisering, verbeterde inferentiesoftware, gespecialiseerde hardware en concurrentie tussen providers dragen bij aan lagere kosten. Elk beïnvloedt een ander deel van de economie: modelgrootte, numerieke precisie, serving-efficiëntie, hardwarebenutting of leveranciersmarge.
Voor kopers is de praktische implicatie om een prijsaanname te scheiden van een kwaliteitsaanname. Een lager tarief is alleen nuttig als de kandidaat nog steeds aan uw acceptatiecriteria voldoet.
- Houd een gedateerd prijsrecord bij: Sla de model-ID, input- en outputtarieven, factureringseenheid en de datum waarop u ze hebt gelezen op.
- Gebruik budgetscenario's: Modelleer de verwachte vraag naast een zwaardere werklast met langere outputs en complexere taken.
- Plan reviews in: Bekijk tarieven per kwartaal opnieuw en onderzoek materiële afwijkingen op facturen vóór de volgende geplande review.
Een modelprijsindex kan helpen bij het identificeren van kandidaten die het opnieuw testen waard zijn. Het mag het prijsrecord dat aan uw eigen verzoeklogboeken is gekoppeld niet vervangen.
Onze vermelde prijs wordt elke 5 minuten bijgewerkt. Deze gebruikt de catalogusprijs van de provider vermenigvuldigd met het aandeel van de catalogusprijs dat in rekening werd gebracht tijdens het duurste handelsuur van de marktplaats in de laatste 24 uur, en is nooit lager dan het goedkoopste aanbod.
Controleer contractuele prijsaanpassingsvoorwaarden afzonderlijk van uw reviewplanning. Een kalenderherinnering maakt een variabel tarief niet vast, en historische dalingen zijn geen garantie dat elke route goedkoper zal worden.
Kiezen tussen tegoeden, abonnementen en verbruiksfacturering
Een arXiv-studie naar de prijsstelling van AI-producten toonde aan dat abonnementen met gebruiksquota het grootste AI-native prijsmodel waren onder 52 producten; 25 bood een gratis laag, proefperiode of starttegoed aan, terwijl 13 een pay-as-you-go instapprijs hanteerde. Dit patroon wijst niet op een universele winnaar. Het laat zien waarom pure verbruiksfacturering niet de enige zinvolle structuur is.
De beslissing gaat over wie het risico van variabel gebruik draagt. Een abonnement verschuift een deel van het vraagrisico naar de leverancier, terwijl prepaid- en verbruiksafhankelijke structuren het verbruik zichtbaarder maken voor de koper.
Gebruik uw operationele beperkingen om te kiezen
| Vraag | Wat het antwoord suggereert |
|---|---|
| Is het maandelijkse gebruik stabiel? | Een abonnement met een bruikbaar quotum kan budgettering vereenvoudigen |
| Gebruikt u meerdere providers of modaliteiten? | Een gedeeld prepaid saldo kan gefragmenteerde financiering verminderen |
| Kunt u het verbruik betrouwbaar voorspellen? | Metering is eenvoudiger te beheren wanneer werklastschattingen betrouwbaar zijn |
| Vereist financiën een harde limiet? | Geef prioriteit aan afdwingbare limieten boven factuurlabels |
Stabiel gebruik bij één provider wijst op een abonnement, mits de toelage past bij uw werkelijke werklast. Tel ongebruikt quotum niet als waarde mee, en controleer of overschrijdingen goedkeuring vereisen of automatisch plaatsvinden.
Ongelijkmatige vraag over meerdere modellen wijst op tegoeden of verbruiksafhankelijk gebruik. Vervaldatum- en overdrachtsregels zijn belangrijk, want het kopen van capaciteit die u nooit gebruikt, kan een ogenschijnlijke korting tenietdoen.
Scheid financiering van facturering
Een prepaid wallet beschrijft wanneer u het gebruik financiert, niet noodzakelijkerwijs hoe elke aanvraag wordt geprijsd. Evenzo kan pay-as-you-go werken via een prepaid saldo in plaats van een postpaid factuur.
Wij hanteren geen maandelijkse kosten en geen minimum. Klanten behouden één saldo en betalen per gebruik. Onze upto betalingsoptie, die als eerste werd aangeboden, laat de wallet een offerte als plafond ondertekenen; na het antwoord wordt alleen de werkelijke kosten in rekening gebracht, afgerond naar het volgende miljoenste van een dollar.
Kies de beperking waarop u geen compromis kunt sluiten voordat u het plan kiest.
Als die beperking een vast budget is, controleer dan de uitgavencontroles. Als het voorspelbare toegang is voor een stabiel team, controleer dan de quotum- en overschrijdingsregels. Als het flexibiliteit is over tekst en media, controleer dan of hetzelfde saldo de workflows ondersteunt die u wilt uitvoeren.
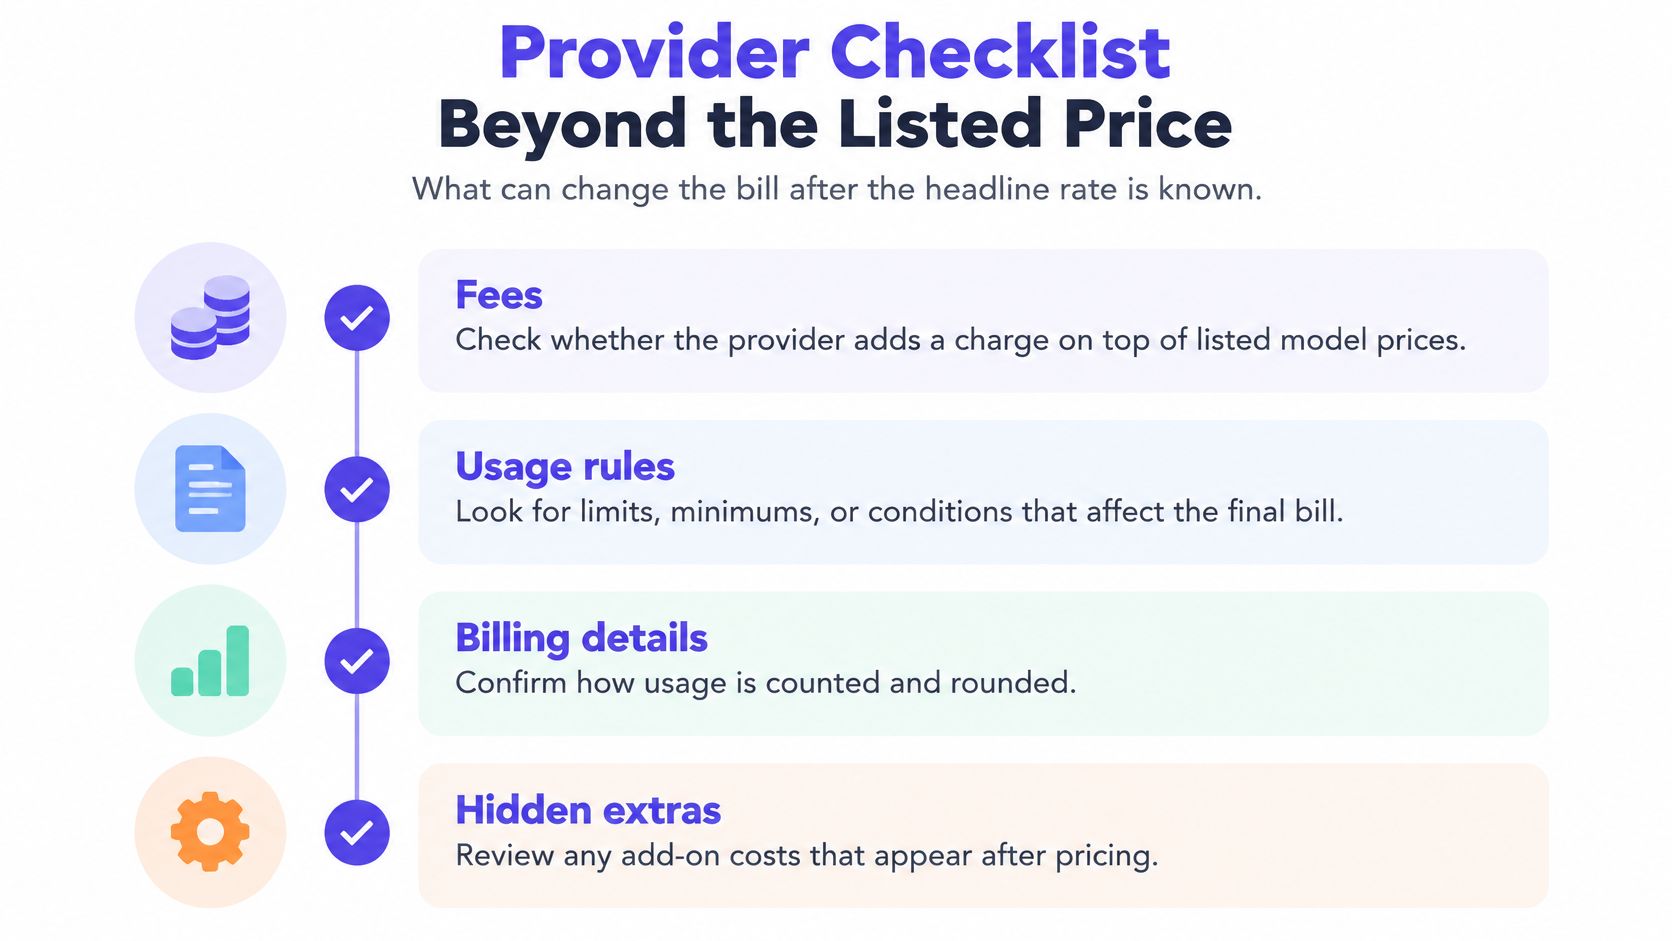
Aanbieder Checklist Voorbij de Vermelde Prijs
Een tariefkaart vertelt u niet alles wat nodig is om een productiefactuur af te stemmen. Test het facturatiegedrag, niet alleen de rekenkunde die in een playground wordt weergegeven.
Gebruik deze checklist om de voorwaarden te identificeren die een concreet antwoord nodig hebben.
Verifieer het facturatiepad
- Kosten zijn expliciet. Wij voegen geen kosten toe bovenop de vermelde modelprijzen. Houd financieringskosten gescheiden van aanvraagkosten bij het vergelijken van de totale uitgaven. Een slecht antwoord is een offerte die een ongespecificeerde platformtoeslag uitsluit.
- De kostenbasis is traceerbaar. Wanneer de aanbieder rapporteert wat het voor een oproep in rekening heeft gebracht, factureren wij precies dat bedrag. Anders kost de oproep zijn tokens tegen de vermelde prijs. Een slecht antwoord is een factuurtotaal dat niet kan worden gekoppeld aan gebruik op aanvraagniveau of gerapporteerde kosten.
- Mislukte aanvragen hebben een gedefinieerde behandeling. Onze mislukte aanvragen en generaties kosten niets. Een voltooide generatie die u echter niet bevalt, mag niet automatisch als een technische storing worden geclassificeerd. Een slecht antwoord laat het onderscheid ongedefinieerd.
Verifieer het controlepad
- Sleutels bieden isolatie. Onze API keys zijn gescopeerd en intrekbaar, en er gelden uitgavenlimieten per sleutel. Een MCP tool call wordt gefactureerd, beperkt en geweigerd zoals de equivalente API request. Een slecht antwoord vereist het uitschakelen van elke dienst om één gecompromitteerde integratie te stoppen.
- Fallback-gedrag is begrijpelijk. Wij verplaatsen aanvragen naar een andere gezonde verkoper wanneer een aanbieder traag of onbeschikbaar wordt. Test de resulterende kosten en timing in uw logs. Een aanbieder die niet kan uitleggen of een alternatieve route de kosten verandert, laat u achter met een onbekende prijs.
Voor gemengde workloads, inspecteer hoe een uniforme tekst-, beeld- en video-API de taakstatus en resultaten blootlegt. Een asynchrone media-aanvraag heeft een duurzame task identifier nodig, zodat indiening, voltooiing en facturering kunnen worden afgestemd, zelfs wanneer ze op verschillende tijdstippen plaatsvinden.
Voer deze controles uit op representatief productiegericht verkeer, inclusief timeouts, cancellations en failed jobs. Een demo-account met korte prompts en succesvolle antwoorden zal niet onthullen of uw boekhouding de omstandigheden overleeft die uw applicatie moet verwerken.
Controleer Uw Kosten per Taak Voordat U Zich Vastlegt
Voer een begrensde evaluatie uit in plaats van te migreren op basis van een prijstabel. Het doel is om te ontdekken welke optie acceptabele resultaten levert tegen acceptabele bedrijfskosten, zonder de werklast te wijzigen.
Voer een gecontroleerde vergelijking uit
- Selecteer representatieve taken. Neem routinematige verzoeken, moeilijke gevallen, lange context en invoer die eerder problemen veroorzaakten op. Houd gevoelig klantenmateriaal buiten een evaluatie, tenzij het gebruik ervan is geautoriseerd.
- Leg het uitvoeringsrecord vast. Log input en output tokens, taak-identifiers, herpogingen, tool calls, kosten en succesbeoordelingen. Registreer de tijd tot een bruikbaar resultaat, niet alleen de tijd tot de eerste reactie.
- Bereken de huidige basislijn. Deel alle relevante uitgaven door geaccepteerde resultaten. Houd taakklassen gescheiden, zodat eenvoudige verzoeken geen slechte economie verbergen bij moeilijk werk.
- Test alternatieve modellen. Behoud prompts, inputs, tool permissions en acceptance tests. Met onze gemeenschappelijke API access gebruikt het wisselen van modellen een andere model-identifier, en elke request wordt naar de goedkoopste gezonde verkoper gerouteerd.
- Pas een request budget toe. Kies limieten die geschikt zijn voor elke taakklasse, en controleer hoe de applicatie omgaat met weigering of onvolledig werk. Een limiet moet een gecontroleerde gebruikerservaring opleveren, geen onverklaarbare fout.
- Vergelijk operationele resultaten. Evalueer kosten per succes, latency en failure rate. Inspecteer de daadwerkelijke outputs waar geautomatiseerde scoring feitelijke fouten of onvolledig werk kan missen.
- Voer een pilot uit voordat u zich vastlegt. Stuur een klein, gecontroleerd deel van het live verkeer naar de kandidaat. Vergelijk gefactureerde kosten met uw logs tijdens de pilot, en houd een rollback path aan totdat zowel kwaliteit als boekhouding betrouwbaar zijn.
Maak de beslissing herhaalbaar
Schrijf de acceptatiecriteria op voordat u modelnamen en prijzen bekijkt. Anders is het gemakkelijk om zwakkere output te excuseren omdat een kandidaat goedkoper lijkt.
Houd de evaluatieset in versiebeheer en voeg nieuwe failure cases toe naarmate de applicatie verandert. Plan de volgende beoordeling per kwartaal, met een eerdere hertest wanneer een materiële model-, prijs- of productwijziging de bestaande vergelijking onbetrouwbaar maakt.
De winnende optie is niet het goedkoopste model op zichzelf. Het is de configuratie die uw werklast voltooit binnen uw kwaliteits-, latency- en budgetbeperkingen.
UberLLM biedt één API key voor tekst- en mediamodellen, een gedeeld prepaid saldo en routing naar de goedkoopste gezonde verkoper voor elk aangevraagd model. Bezoek UberLLM om de huidige prijzen te vergelijken, test vervolgens representatieve taken en meet de kosten van geaccepteerde resultaten voordat u productieverkeer verplaatst.