模型推理成本是多少?AI推理价格解析
在 2026 年,模型推理成本是多少?当前AI按token和按任务计费的价格、月度账单计算公式,以及影响其变化的隐藏成本。
前沿模型创建与日常模型使用具有截然不同的经济效益:Epoch AI 的训练成本分析估计硬件成本占前沿模型开发成本的 47%–67%,而能源仅占 2%–6%。然而,对于应用程序开发者而言,相关问题并非模型构建成本是多少,而是您将支付多少来完成一项有用的任务,包括需要再次尝试的请求。
目录
文本、图像和视频模型的当前价格
建模成本是多少? 对于AI推理,答案始于计费单位:文本使用输入和输出token,图像使用图像或百万像素,视频可以使用作业。本文涵盖的是推理的使用价格,而非训练预算。根据Voronoi对AI指数估算的介绍,斯坦福大学报告的Gemini 1.0 Ultra训练估算成本为**$192百万**,但API客户不直接支付该开发成本。
历史趋势令人瞩目。斯坦福 2025 AI指数衡量了在MMLU上达到GPT-3.5级别性能的系统查询成本,从2022年11月的大约每百万token $20下降到2024年10月的**$0.07**。这是一种基准特定的比较,并非所有有能力模型的当前报价。
按模型类型划分的当前单位价格
UberLLM列出了254个模型的实时API价格,包括GPT、Claude、Gemini、DeepSeek、GLM、Qwen、Llama、Mistral和Kimi。聊天价格将输入与输出分开计费。
| 模型 | 计费单位 | UberLLM价格 | 官方价格 |
|---|---|---|---|
| Claude Opus 5.5, 输入 | 每 1M 输入token | $2.03 | $4.00 |
| Claude Opus 5.5, 输出 | 每 1M 输出token | $10.13 | $20.00 |
| Kimi K3, 输入 | 每 1M 输入token | $0.003 | $0.19 |
| Kimi K3, 输出 | 每 1M 输出token | $0.23 | $15.00 |
| FLUX 2 Pro image | 每张图像 | $0.0075 | $0.03 |
| Nano Banana 2 image | 每张图像 | $0.015 | $0.10 |
| FLUX.2 Klein 4B image | 每百万像素 | $0.00015 | $0.015 |
| Veo 3.1 Full text-to-video | 每个作业 | $0.22 | $0.44 |
| Kling 3 Standard image-to-video | 每个作业 | $0.063 | $0.084 |
| LTX 2.3 Fast text-to-video | 每个作业 | $0.045 | $0.06 |
| Runway Gen-4 Turbo | 每个作业 | $0.0675 | 无已验证的官方价格 |
在估算媒体支出之前,请使用视频API价格比较查看实时作业报价。作业价格只有与您打算请求的输出配置结合起来才有意义。
所列价格是请求通常的成本,而非上限。阅读每一行时,请确定您的功能所消耗的单位,然后将该单位乘以预期使用量。在不考虑图像尺寸的情况下,不要直接将百万像素价格与每张图像价格进行比较。
如何估算月度模型费用
围绕产品功能来构建估算,而不是单一的混合 token 配额。客户支持对话、文档提取和视频预览消耗的资源各不相同,因此,过早地将它们合并会掩盖哪些功能需要关注。
计算始于用量和实际使用量。
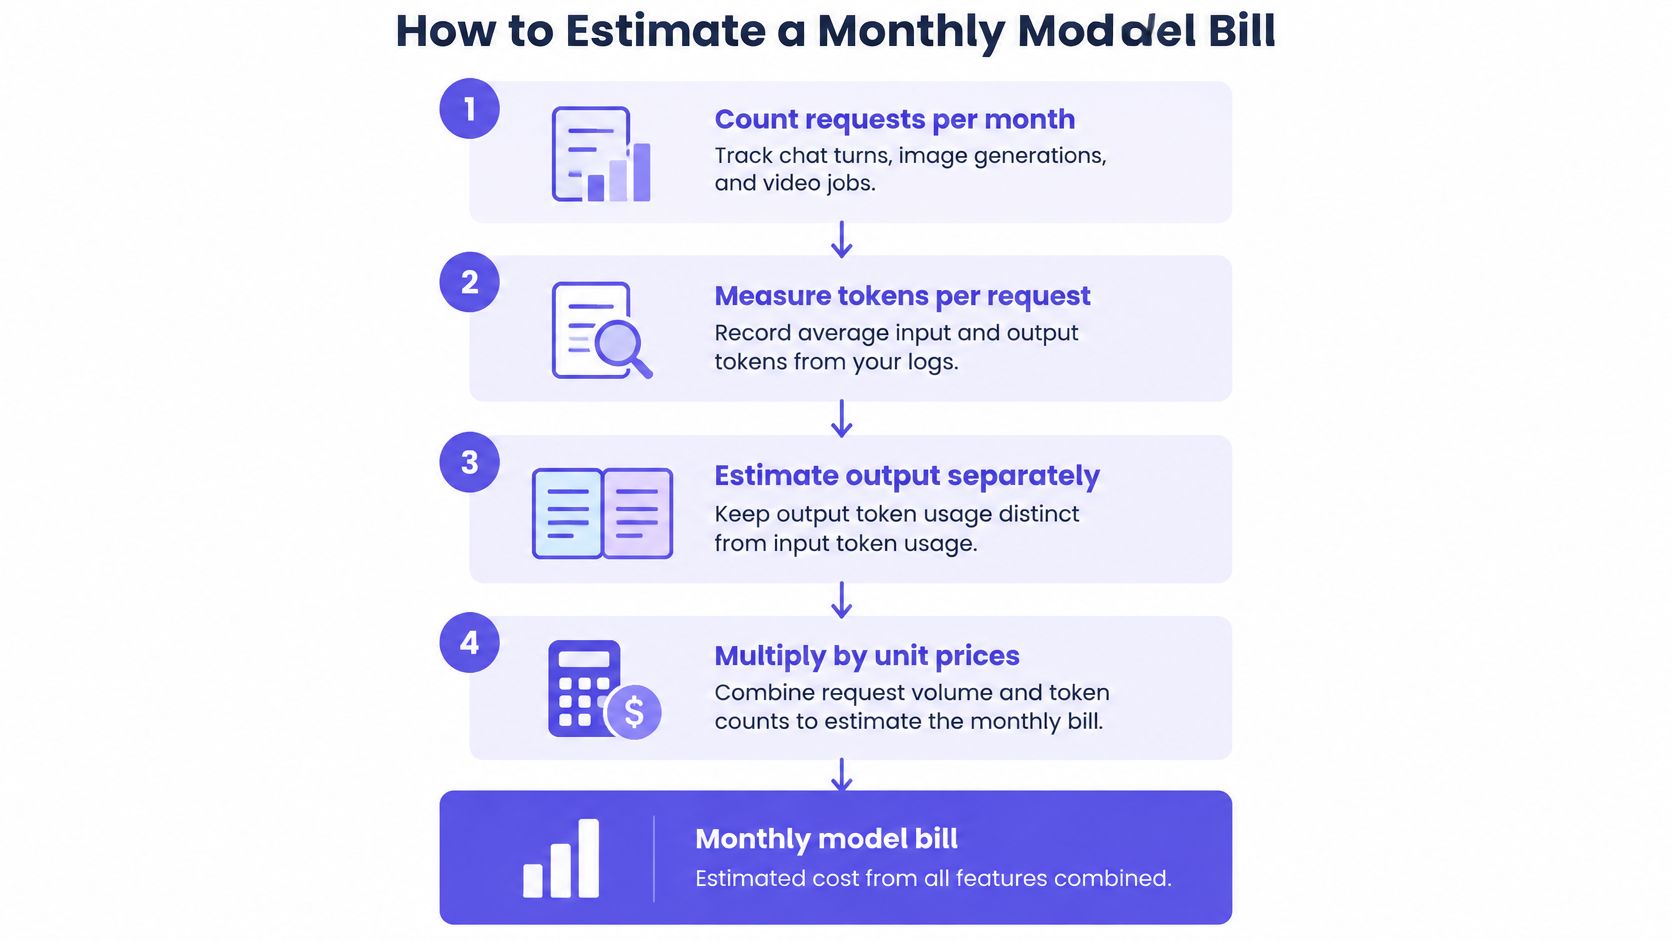
按功能统计请求。 分别记录聊天轮次、文档处理调用、图像生成和视频任务。包括后台调用,而不仅仅是用户可见的操作。
独立测量输入和输出。 从响应使用字段和日志中捕获实际 token 计数。在输入测量中包括系统指令、对话历史、检索到的段落和工具结果。
应用确切的模型费率。 将月度输入 token 乘以输入费率,将月度输出 token 乘以输出费率,使用目录中显示的计费分母。在每次计算旁边记录模型标识符,以免模型更改使预测失效。
添加媒体单位。 将图像、百万像素和视频任务的用量乘以其对应的价格。将特定配置的任务分开,而不是平均不相关的输出。
包括额外尝试。 区分应用程序重试、已生成但被拒绝的答案以及提供商故障。我们的失败请求或生成不收费,但您的应用程序拒绝的已交付答案仍然代表您的工作流程所消耗的工作量。
考虑资金成本。 我们在列出的模型价格之上不收取任何费用,也没有月费或最低消费。银行卡余额充值会产生已披露的 5.5% 加 $0.50 费用,因此,请将该资金费用与请求支出分开。
将估算转化为可用的预算
基本的文本计算公式是:
月度文本支出 = 所有尝试的输入 token 费用 + 输出 token 费用。
然后加上媒体支出和任何支持性应用程序服务。AI 定价模型指南] 有助于在合并它们之前区分计费结构。
我们公布的月度示例总计 $113.00,相比之下,在 OpenRouter 上或按官方价格则为 $400.00,相差 $287.00。请将其视为一个示例工作负载,而不是对具有不同模型组合或输出用量的应用程序的预测。
预算规则: 为每个功能保留一个月度总额、每个请求的平均成本以及一个单独的不确定性备用金。单一的账户总额无法解释支出为何发生变化。
影响推理成本的因素
模型调用类似于出租车费用:如果等待时间也很重要,那么仅仅距离并不能决定费用。对于推理而言,token 数量只是计算的一部分;工作负载的形态和提供服务的要求会影响提供答案所需的资源。
成本因素及其对费用的影响
| 因素 | 对成本的影响 | 应对措施 |
|---|---|---|
| 输出长度 | 更长的响应会消耗更多计费输出 | 限制输出并请求简洁格式 |
| 模型层级 | 更高的能力可能带来更高的 token 价格 | 测试满足您质量标准的最低成本模型 |
| 上下文长度 | 长检索上下文会增加内存流量并降低吞吐量 | 仅发送相关的检索段落 |
| 量化 | 较低的精度可以提高吞吐量但会影响质量 | 在代表性任务上评估部署的精度 |
| 计费单位 | 图像、像素和视频任务衡量不同的输出 | 将单位与您产品的交付物匹配 |
| 延迟层级 | 适用于交互式工作的容量可能需要支付额外费用 | 将服务要求与用户容忍度匹配 |
| 失败的生成 | 额外的尝试会消耗时间并可能产生计费工作 | 将提供商故障与应用程序级别的拒绝区分开 |
一项 消费级 GPU 推理研究 估计普通 API 工作负载的纯电力成本为每百万 token $0.001–$0.005,而使用 32K 上下文的检索增强生成则为 $0.14–$0.22,并报告称 NVFP4 提供了大约 BF16 吞吐量的 1.6 倍,同时能耗减少了 41%,估计质量损失为 2%–4%。
这些是纯电力运营估算,而非客户 API 价格。它们不包括其余的服务业务,并且不能与价格表中计费的输入和输出费率直接比较。
自托管需要单独计算
一项 LLaMA 推理基准测试 发现,服务一个 65B 模型大约需要 8–32 块 GPU,报告的推理功耗约为 300 瓦到 1 千瓦,具体取决于分片配置。因此,自托管需要进行利用率计算,而不仅仅是电力估算:包括硬件、内存、网络、运营和闲置容量。
在评估替代方案时,请使用 模型价格变动追踪器。我们允许您通过更改模型 ID 来切换模型,但兼容性并不意味着质量等同。
选择通过您自己评估的最便宜模型,然后在协商更低费率之前减少不必要的上下文和输出。
为什么更便宜的Token仍然可能意味着更高的账单
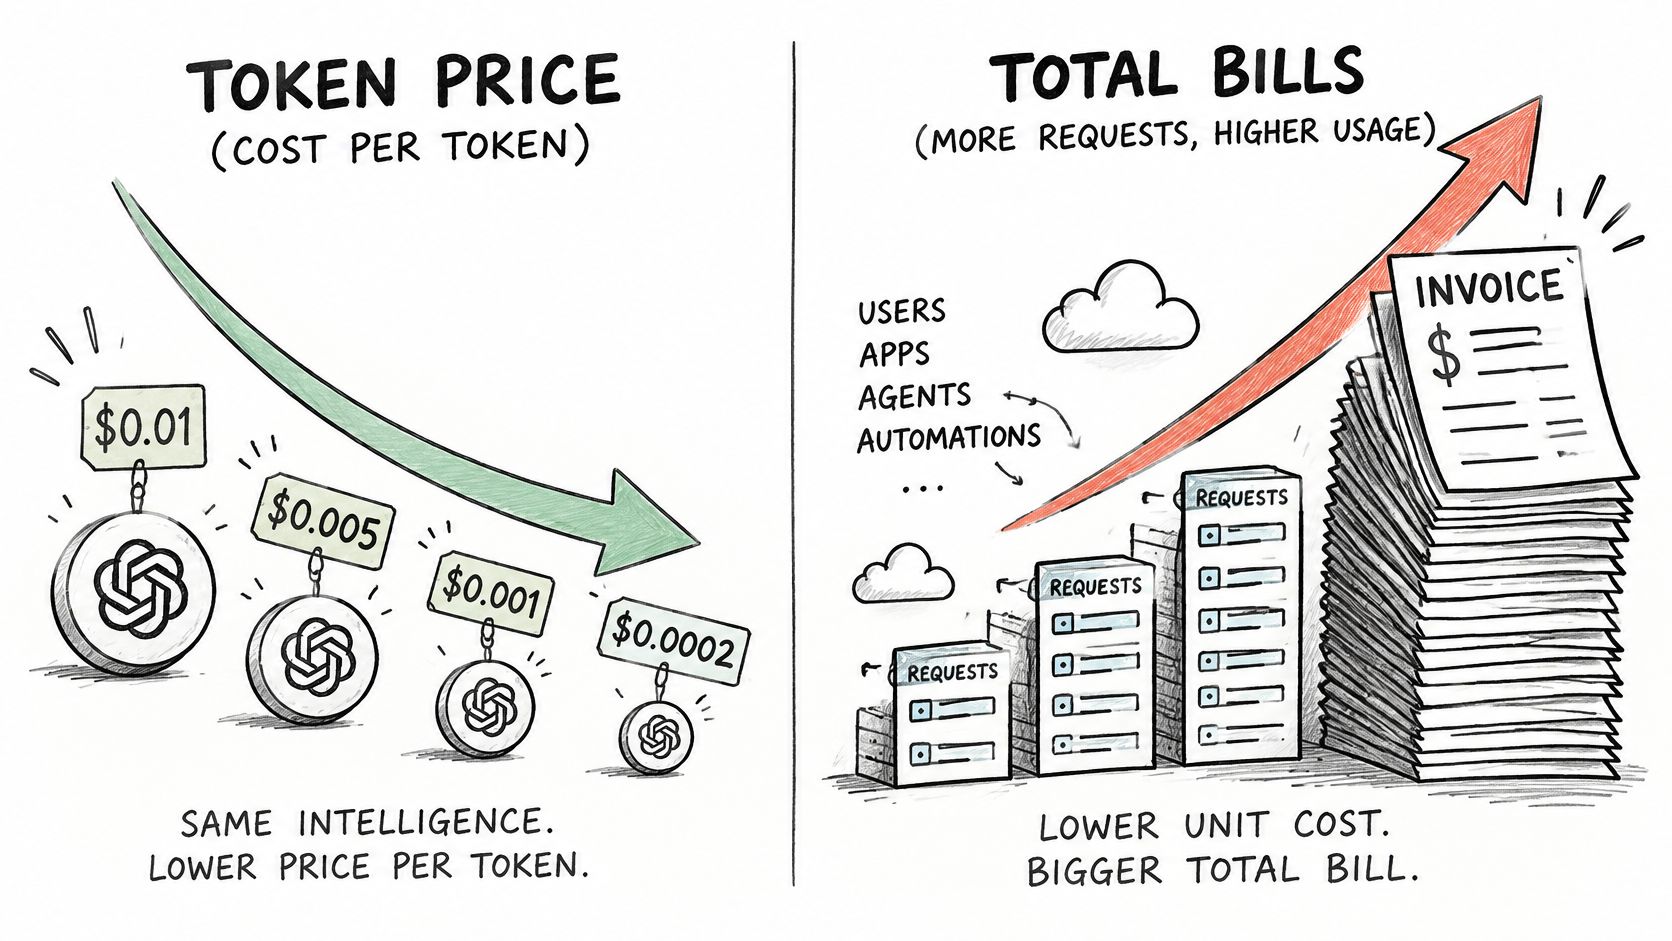
TCS 对基于结果的生成式AI支出的分析](https://www.tcs.com/insights/articles/generative-ai-spending-outcome-based-approach)报告称,每Token成本在**三年内下降了大约1,000倍**,而总推理支出却持续上升,并指出输出Token的成本通常是输入Token的**三到六倍**。更低的单位价格并不能保证更低的应用支出。
当价格和使用量走向相反时,这种区别更容易看清。
比较已完成的工作,而非孤立的生成
考虑一个说明性的文档提取工作流。价格较低的模型生成了冗长的解释,而非所需的结构化响应,因此您的应用程序会提交一个修复请求。如果修复后的响应仍然未能通过验证,工作流就会升级到更强大的模型。
替代模型每个输出Token的成本更高,但能立即返回可接受的结构化结果。其更高的单位费率可以产生更低的总任务成本,因为您避免了修复提示、重复的文档上下文和回退生成。
这种结果并非不可避免。这正是代表性评估应该确定的内容。
每完成任务成本 = 总工作流支出 ÷ 成功完成的任务数。
当检索、工具调用、护栏和人工升级属于该工作流时,请将其包含在内。在衡量之前定义成功:一个已到达的答案不一定是您的产品可以使用的答案。
在解释更广泛的AI经济学讨论时,这种区别也很重要。
诊断昂贵的路径
跟踪提示长度、输出长度、验证失败和回退决策以及支出。如果廉价的首次尝试能够解决常规情况并有选择地升级困难情况,那么它仍然是值得的。当几乎每个任务都为首次尝试和回退买单时,它就变得浪费了。
不要仅仅为了提高表面上的成功率而取消质量检查。那会改变成功的定义,而不是降低有用工作的成本。
决策测试: 一个被接受的工作流在长输出、重试和支持服务之后会花费多少,而不仅仅是其首次模型调用之后?
可靠性和基础设施如何影响实际成本
标示价格并不能保证在您的应用程序需要时提供足够的容量。区域、承诺、延迟要求和容量类型都会影响成本比较。
GPU 定价和推理成本跟踪器报告称,H100的价格从按需实例的每小时约 $0.34 到平均每小时约 $3.46,同时,对于跨提供商、延迟层级和上下文窗口的同等能力服务,估计每百万输出 token 的成本为 $0.50–$3。这些范围描述的是不同的购买条件,而非可互换的报价。
批处理工作和交互式工作需要不同的容量
对于批处理,即使完成时间波动,廉价的 endpoint 也可能是可接受的。如果应用程序跟踪作业状态并防止重复处理,文档分类队列可以暂停或重新安排工作。为即时响应支付额外费用可能价值不大。
对于交互式产品,相同的 endpoint 可能不是一个好的选择。如果用户在请求完成前放弃,技术上成功的生成在商业上仍然可能失败。当更昂贵的 endpoint 能够减少因超时导致的重试、废弃的会话或支持干预时,它是值得的。
在代表性并发条件下比较这两种选项。衡量首个 token 时间、完成延迟、尾部延迟和已接受任务的完成情况,而不是依赖空闲 endpoint 测试。
路由如何改变运营比较
当提供商变慢或不可用时,我们会将每个请求路由到最便宜的健康卖家,并将其转移到另一个健康的卖家。这减少了您的应用程序实现每个卖家特定恢复路径的需求,但您仍应测试端到端行为。
如果没有提供商可以服务某个模型,API 将返回 503 no_available_provider,并且不收取任何费用。对于视频,回复会说明在生成开始前该作业的最大成本。这两种行为都不能消除在您的产品中处理不可用容量或延迟结果的需求。
在比较 endpoint 之前,请设置以下值:
- 可用性目标: 定义功能何时必须工作以及何种降级行为是可接受的。
- 延迟目标: 指定用户所需的响应时间,包括慢尾行为。
- 故障转移值: 决定哪些中断需要备用容量或另一个模型。
- 任务成本上限: 设置已接受结果在经济上可接受的最大支出。
有用的采购比较会保持这些要求不变。否则,您将通过相同的价格栏比较不同的服务。
在决定使用模型前设定预算
只有当您能将模型的价格与功能级预算和可衡量的验收测试关联起来时,才能决定使用它。一个有前景的测试平台响应只是一个起点,而不是整个工作流程经济实惠的证据。
对评估进行控制
选择每个功能的计费单位。 记录交付物消耗的是输入token、输出token、图像、百万像素还是作业。将请求的配置与该单位放在一起,这样图像尺寸或视频设置的更改就会触发预算审查。
建立功能级预测。 使用观察到的请求量和来自代表性样本的使用情况。包括完整的执行路径,包括后台处理和应用程序定向的修复调用,而不是仅仅根据用户可见的提示进行估算。
随请求发送价格限制。 使用适用的
max_price或max_cost控制。请求的计费永远不会超过您发送的值,因此可强制执行的限制比假设典型的目录价格是保证的最大值更有用。审慎分配共享余额。 一个余额涵盖文本、图像、视频和音乐模型。维护功能级支出记录,这样媒体实验就不会掩盖已建立的文本工作流程所需的资金。
评估替代模型。 我们的API为每个模型提供一个key,价格为标价或更低。在保持任务说明和验收标准稳定的情况下更改模型标识符,然后比较产生的交付物,而不是选择听起来最完善的答案。
运行有界生产试点。 选择一个能捕捉常规和困难流量的审查窗口。在扩大访问或增加并发性之前,将每个已接受任务的测量成本与您的预测进行比较。
在切换提供商之前调查差异
在生产集成之前,使用仪表板测试平台比较输出并调整参数。对于提取任务,检查schema合规性以及文档是否支持字段。对于编码任务,评估提议的更改是否满足任务并通过相关检查。
当测量成本超出预测时,首先检查输出长度、重试行为和上下文大小。然后检查您的应用程序是否更改了工作负载,例如附加完整的对话历史记录或重复提供相同的文档。不要假设更高的账单意味着列出的费率增加了。
本周打开实时定价表,找出导致您支出最大份额的功能,并根据记录的使用情况建立其估算。指派专人根据该预测审查首次测量结果。
UberLLM提供统一的API和预付费余额,用于访问文本、图像、视频和音乐模型,并具有请求级价格控制。访问UberLLM]以比较实时模型价格,为您的最高支出功能选择一个候选模型,并在决定使用前测试其每个已完成任务的成本。