Quanto costa l'uso dei modelli? I prezzi dell'inferenza AI spiegati.
Quanto costa l'uso dei modelli in 2026? Prezzi attuali dell'AI per token e per job, una formula per la fattura mensile e i costi nascosti che la modificano.
La creazione di modelli di frontiera e l'utilizzo quotidiano dei modelli hanno dinamiche economiche molto diverse: L'analisi dei costi di addestramento di Epoch AI stima che l'hardware incida per 47%–67% sui costi di sviluppo dei modelli di frontiera, mentre l'energia rappresenta solo 2%–6%. Per gli sviluppatori di applicazioni, però, la questione rilevante non è quanto è costato costruire un modello. È quanto pagherai per completare un'attività utile, incluse le richieste che necessitano di un altro tentativo.
Indice
- Prezzi Attuali per Modelli di Testo, Immagine e Video
- Come Stimare una Fattura Mensile per i Modelli
- Fattori che Modificano i Costi di Inference
- Perché Token Più Economici Possono Comunque Significare Fatture Più Alte
- Come Affidabilità e Infrastruttura Spostano il Costo Reale
- Stabilisci il Tuo Budget Prima di Impegnarti con un Modello
Prezzi Attuali per Modelli di Testo, Immagini e Video
Quanto costa il modeling? Per l'inferenza AI, la risposta inizia con l'unità di fatturazione: il testo usa token di input e output, le immagini usano immagini o megapixel, e il video può usare job. Questo articolo copre i prezzi di utilizzo per l'inferenza, non i budget di training. La stima riportata da Stanford per il training di Gemini 1.0 Ultra era di $192 milioni, secondo la presentazione di Voronoi della stima dell'AI Index, ma i clienti API non pagano direttamente quel costo di sviluppo.
La tendenza storica è sorprendente. Lo Stanford 2025 AI Index ha misurato il costo di interrogare un sistema che raggiungeva prestazioni a livello di GPT-3.5 su MMLU, in calo da circa $20 per milione di token a novembre 2022 a $0.07 entro ottobre 2024. Questo è un confronto specifico per benchmark, non una quotazione attuale per ogni modello capace.
Prezzi attuali per unità per tipo di modello
UberLLM elenca i prezzi API live per modello per 254 modelli, inclusi GPT, Claude, Gemini, DeepSeek, GLM, Qwen, Llama, Mistral e Kimi. I prezzi delle chat separano l'input dall'output.
| Modello | Unità di fatturazione | Prezzo UberLLM | Prezzo di listino |
|---|---|---|---|
| Claude Opus 5.5, input | Per 1M token di input | $2.03 | $4.00 |
| Claude Opus 5.5, output | Per 1M token di output | $10.13 | $20.00 |
| Kimi K3, input | Per 1M token di input | $0.003 | $0.19 |
| Kimi K3, output | Per 1M token di output | $0.23 | $15.00 |
| FLUX 2 Pro image | Per immagine | $0.0075 | $0.03 |
| Nano Banana 2 image | Per immagine | $0.015 | $0.10 |
| FLUX.2 Klein 4B image | Per megapixel | $0.00015 | $0.015 |
| Veo 3.1 Full text-to-video | Per job | $0.22 | $0.44 |
| Kling 3 Standard image-to-video | Per job | $0.063 | $0.084 |
| LTX 2.3 Fast text-to-video | Per job | $0.045 | $0.06 |
| Runway Gen-4 Turbo | Per job | $0.0675 | Nessun prezzo di listino verificato disponibile |
Usa il confronto prezzi API video per controllare l'offerta di job live prima di stimare la spesa media. Un prezzo per job è significativo solo insieme alla configurazione di output che intendi richiedere.
Il prezzo elencato è ciò che una richiesta tipicamente costa, non un tetto massimo. Leggi ogni riga identificando l'unità che la tua funzionalità consuma, quindi moltiplica quell'unità per l'utilizzo previsto. Non confrontare un prezzo per megapixel direttamente con un prezzo per immagine senza tenere conto delle dimensioni dell'immagine.
Come Stimare una Fattura Mensile per i Modelli
Costruisci la stima attorno alle funzionalità del prodotto, non su un'unica assegnazione di token combinata. Una conversazione di supporto, l'estrazione di documenti e l'anteprima video consumano risorse diverse, quindi combinarle troppo presto nasconde quale funzionalità necessita di attenzione.
Il calcolo inizia con il volume e l'utilizzo misurato.
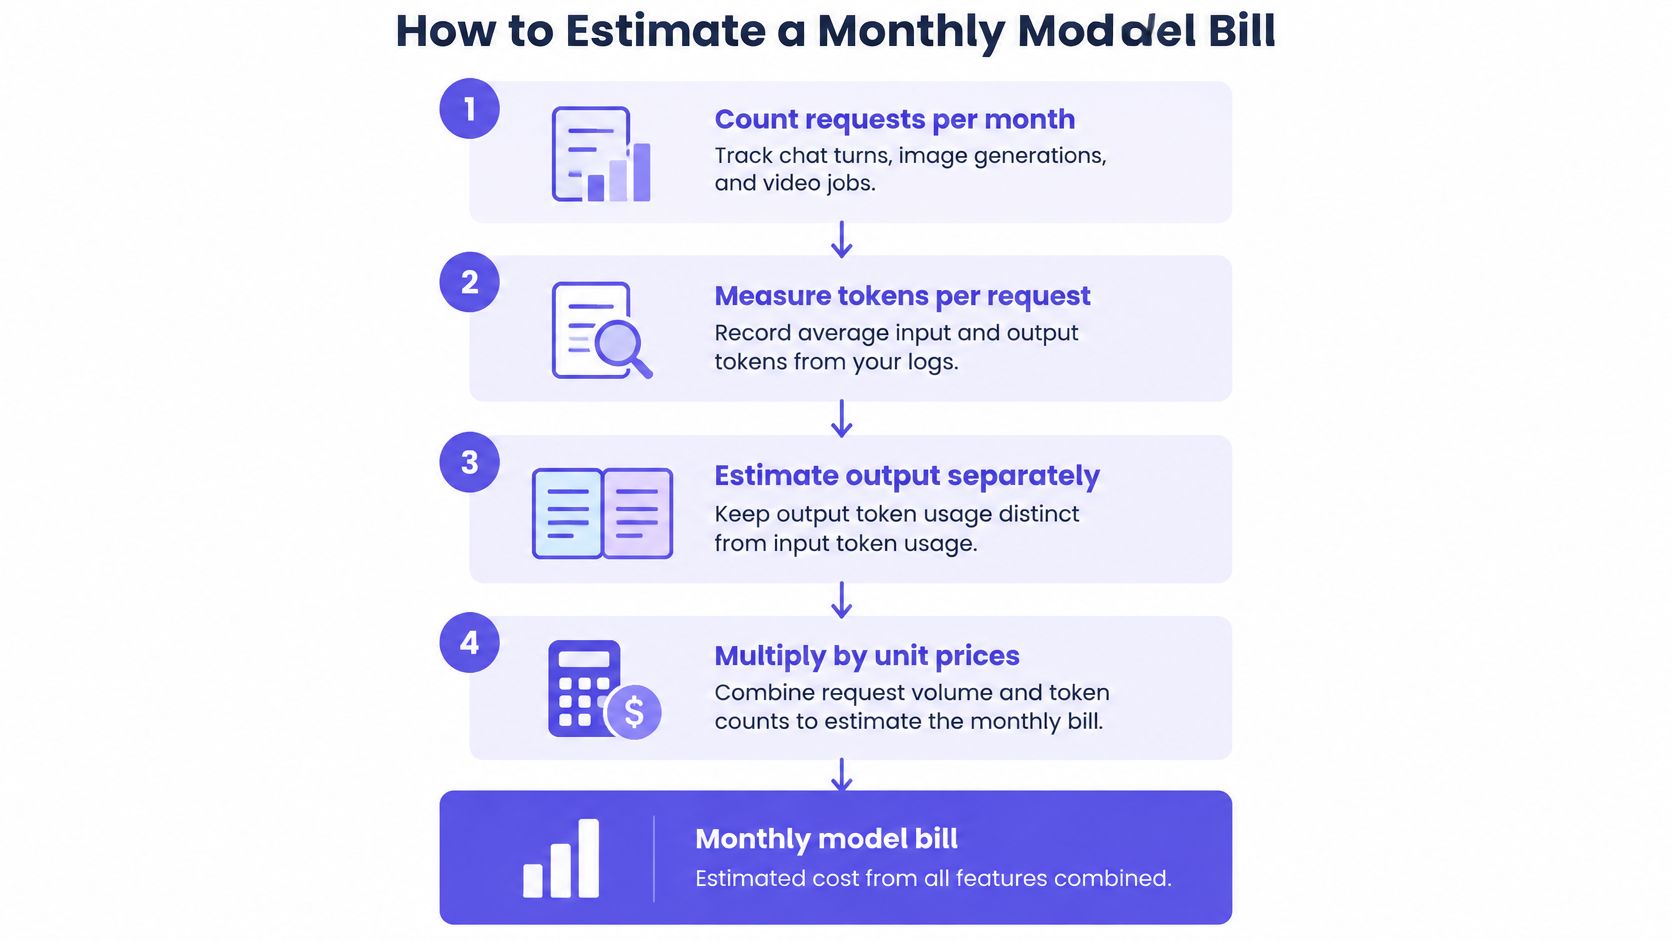
Conta le richieste per funzionalità. Registra separatamente i turni di chat, le chiamate di elaborazione documenti, le generazioni di immagini e i lavori video. Includi le chiamate in background, non solo le azioni visibili agli utenti.
Misura input e output in modo indipendente. Cattura i conteggi effettivi dei token dai campi di utilizzo della risposta e dai log. Includi istruzioni di sistema, cronologia delle conversazioni, passaggi recuperati e risultati degli strumenti nella misurazione dell'input.
Applica le tariffe esatte del modello. Moltiplica i token di input mensili per la tariffa di input e i token di output mensili per la tariffa di output, utilizzando il denominatore di fatturazione mostrato nel catalogo. Registra l'identificatore del modello accanto a ogni calcolo in modo che un cambio di modello non invalidi la previsione.
Aggiungi unità multimediali. Moltiplica il volume di immagini, megapixel e lavori video per i loro prezzi corrispondenti. Mantieni separati i lavori specifici per configurazione anziché fare una media di output non correlati.
Includi tentativi extra. Distingui i tentativi dell'applicazione, le risposte rifiutate ma generate con successo e i fallimenti del provider. Le nostre richieste o generazioni fallite non vengono addebitate, ma una risposta consegnata che la tua applicazione rifiuta rappresenta comunque un lavoro consumato dal tuo flusso di lavoro.
Tieni conto dei costi di finanziamento. Non aggiungiamo alcuna commissione oltre ai prezzi dei modelli elencati, e non ci sono costi mensili o minimi. Gli aggiustamenti del saldo della carta comportano una commissione dichiarata di 5.5% più $0.50, quindi mantieni tale costo di finanziamento separato dalla spesa per le richieste.
Trasforma la stima in un budget utilizzabile
Il calcolo base per il testo è:
Spesa mensile per il testo = costi dei token di input + costi dei token di output per tutti i tentativi.
Poi aggiungi la spesa per i media e qualsiasi servizio applicativo di supporto. La guida ai modelli di prezzo dell'IA aiuta a distinguere le strutture di fatturazione prima di combinarle.
Il nostro esempio mensile pubblicato ammonta a $113.00, rispetto a $400.00 su OpenRouter o ai prezzi ufficiali, una differenza di $287.00. Consideralo un carico di lavoro di esempio, non una previsione per un'applicazione con un mix di modelli o un volume di output diverso.
Regola di budgeting: Mantieni un totale mensile per ogni funzionalità, un costo medio per richiesta e un'allocazione separata per l'incertezza. Un singolo totale del conto non può spiegare perché la spesa è cambiata.
Fattori che modificano i costi di inferenza
Una chiamata a un modello assomiglia a una corsa in taxi: la distanza da sola non determina il conto se anche il tempo di attesa è rilevante. Per l'inferenza, il volume di token è solo una parte del calcolo; la forma del carico di lavoro e i requisiti di servizio influenzano le risorse necessarie per fornire la risposta.
Fattori di costo e come ciascuno incide sul conto
| Fattore | Effetto sul costo | Cosa fare |
|---|---|---|
| Lunghezza output | Risposte più lunghe consumano più output fatturato | Limita l'output e richiedi formati concisi |
| Livello del modello | Maggiore capacità può comportare un prezzo per token più elevato | Testa il modello meno costoso che soddisfa i tuoi standard di qualità |
| Lunghezza del contesto | Contesti di recupero lunghi aumentano il traffico di memoria e riducono il throughput | Invia solo passaggi recuperati pertinenti |
| Quantizzazione | Minore precisione può migliorare il throughput ma influire sulla qualità | Valuta la precisione implementata su attività rappresentative |
| Unità di fatturazione | Immagini, megapixel e lavori video misurano output diversi | Abbina l'unità al deliverable del tuo prodotto |
| Livello di latenza | La capacità adatta per il lavoro interattivo può comportare un costo aggiuntivo | Abbina i requisiti di servizio alla tolleranza dell'utente |
| Generazioni fallite | Tentativi aggiuntivi consumano tempo e possono creare lavoro fatturabile | Separa i fallimenti del provider dal rifiuto a livello di applicazione |
Uno studio sull'inferenza con GPU consumer ha stimato costi solo di elettricità di $0.001–$0.005 per milione di token per carichi di lavoro API ordinari, rispetto a $0.14–$0.22 per la generazione aumentata da recupero con 32K contesto, e ha riportato che NVFP4 ha fornito circa 1.6 volte il throughput di BF16 con 41% meno energia e una perdita di qualità stimata di 2%–4%.
Queste sono stime operative solo per l'elettricità, non prezzi API per i clienti. Escludono il resto del business di servizio e non sono direttamente confrontabili con le tariffe di input e output fatturate nella tabella dei prezzi.
L'auto-hosting richiede un proprio calcolo
Un benchmark di inferenza LLaMA ha rilevato che il servizio di un modello 65B richiedeva circa 8–32 GPU, con un consumo energetico di inferenza riportato di circa 300 watt a 1 kilowatt, a seconda della configurazione di sharding. L'auto-hosting richiede quindi un calcolo di utilizzo, non solo una stima dell'elettricità: includi hardware, memoria, networking, operazioni e capacità inattiva.
Usa il tracker delle modifiche ai prezzi dei modelli quando valuti le alternative. Ti permettiamo di cambiare modello modificando l'ID del modello, ma la compatibilità non stabilisce una qualità equivalente.
Scegli il modello più economico che supera la tua valutazione, quindi riduci il contesto e l'output non necessari prima di negoziare una tariffa inferiore.
Perché i token più economici possono comunque significare bollette più salate
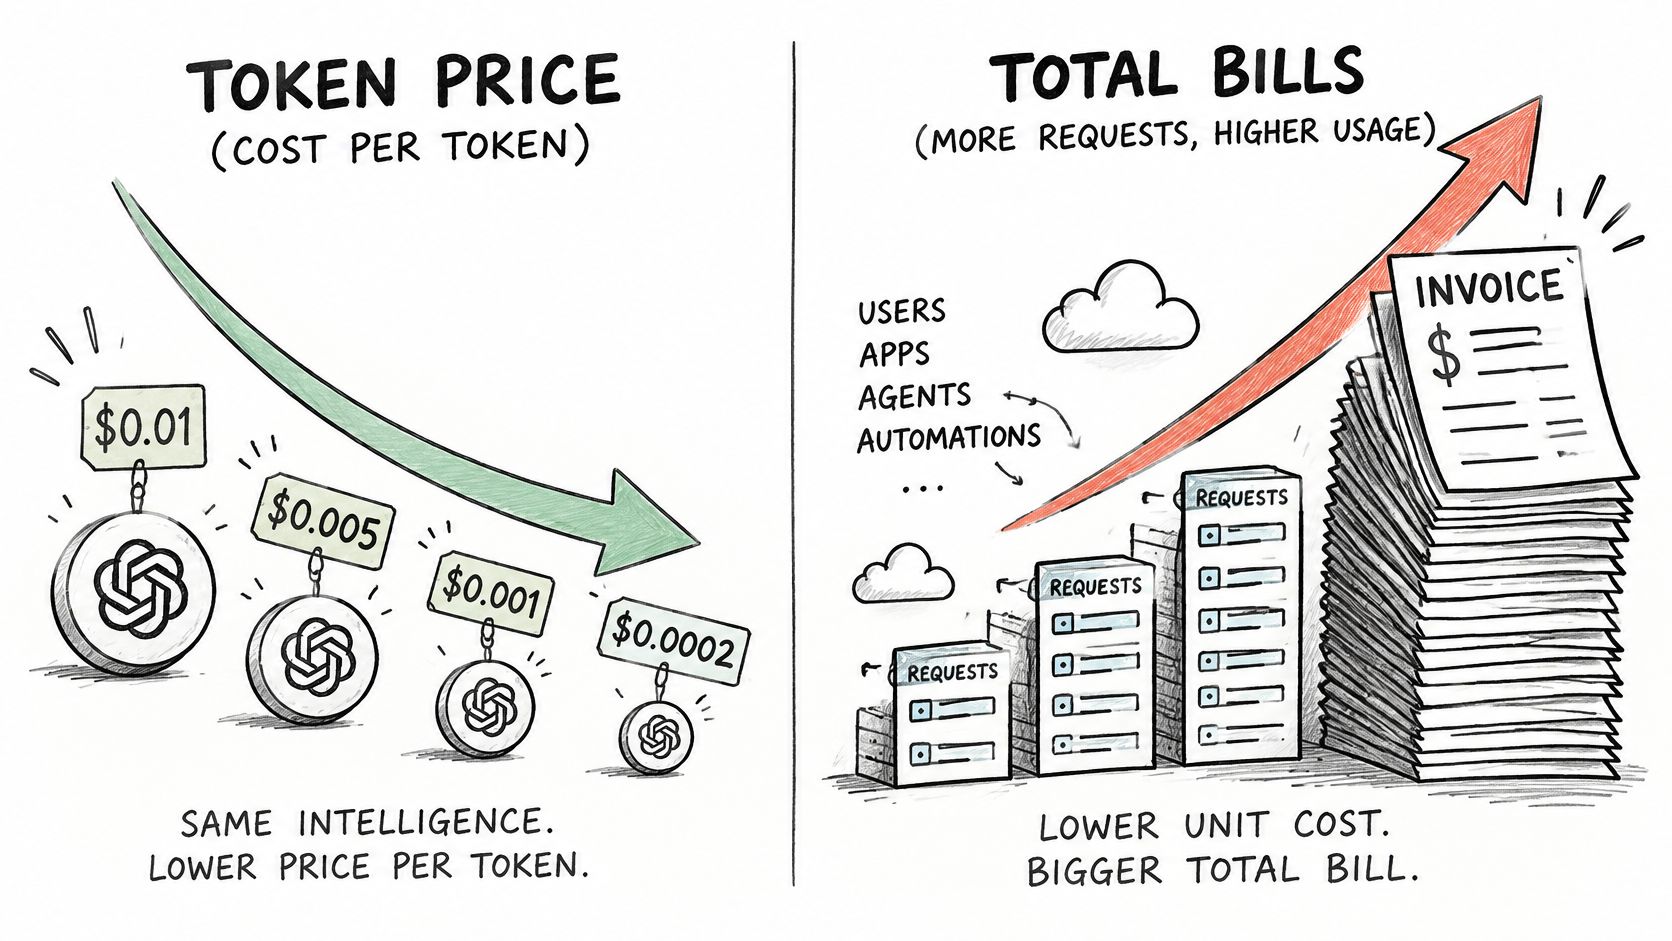
Una stima nell'analisi di TCS sulla spesa per l'AI generativa basata sui risultati riporta che i costi per token sono diminuiti di circa 1,000 volte in tre anni mentre la spesa totale per l'inferenza ha continuato a crescere, e osserva che i token di output costano comunemente da tre a sei volte di più rispetto ai token di input. Prezzi unitari più bassi non garantiscono una spesa applicativa inferiore.
La distinzione è più facile da vedere quando prezzo e utilizzo si muovono in direzioni opposte.
Confronta il lavoro completato, non le generazioni isolate
Considera un flusso di lavoro illustrativo per l'estrazione di documenti. Il modello a prezzo inferiore produce una spiegazione prolissa invece della risposta strutturata richiesta, quindi la tua applicazione invia una richiesta di riparazione. Se la risposta riparata fallisce ancora la convalida, il flusso di lavoro scala a un modello più potente.
Il modello alternativo costa di più per token di output ma restituisce immediatamente un risultato strutturato accettabile. Il suo tasso unitario più elevato può produrre un costo totale del compito inferiore perché eviti il prompt di riparazione, il contesto del documento ripetuto e la generazione di fallback.
Questo risultato non è inevitabile. È precisamente ciò che una valutazione rappresentativa dovrebbe determinare.
Costo per compito completato = spesa totale del flusso di lavoro ÷ compiti completati con successo.
Includi il recupero, le chiamate a strumenti, i guardrail e l'escalation umana quando appartengono a quel flusso di lavoro. Definisci il successo prima di misurare: una risposta che è arrivata non è necessariamente una risposta che il tuo prodotto può usare.
Questa distinzione è importante anche quando si interpretano discussioni più ampie sull'economia dell'AI.
Diagnostica il percorso costoso
Traccia la lunghezza del prompt, la lunghezza dell'output, i fallimenti di convalida e le decisioni di fallback insieme alla spesa. Un primo tentativo economico può rimanere utile se risolve casi di routine e scala selettivamente quelli difficili. Diventa uno spreco quando quasi ogni compito paga sia per il tentativo iniziale che per il fallback.
Non rimuovere i controlli di qualità solo per migliorare il tasso di successo apparente. Ciò cambia la definizione di successo piuttosto che ridurre il costo del lavoro utile.
Test decisionale: Quanto costerà un flusso di lavoro accettato dopo output lunghi, tentativi e servizi di supporto, non solo dopo la sua prima chiamata al modello?
Come affidabilità e infrastruttura modificano il costo reale
Un prezzo di copertina non garantisce che la capacità adeguata sarà disponibile quando la tua applicazione ne avrà bisogno. Regione, impegno, requisiti di latenza e tipo di capacità influenzano tutti il confronto.
Un tracker dei prezzi delle GPU e dei costi di inferenza ha riportato prezzi per H100 da circa $0.34 all'ora su istanze spot a circa $3.46 all'ora in media, insieme a una stima di $0.50–$3 per milione di token di output per un servizio di capacità comparabile tra provider, livelli di latenza e finestre di contesto. Questi intervalli descrivono diverse condizioni di acquisto, non offerte interscambiabili.
Il lavoro batch e il lavoro interattivo necessitano di capacità diverse
Per l'elaborazione batch, un endpoint economico può essere accettabile anche quando i tempi di completamento fluttuano. Una coda di classificazione documenti può mettere in pausa o riprogrammare il lavoro se l'applicazione traccia lo stato del job e previene l'elaborazione duplicata. Pagare un extra per risposte immediate potrebbe aggiungere poco valore.
Per i prodotti interattivi, lo stesso endpoint potrebbe essere un acquisto scadente. Se gli utenti abbandonano una richiesta prima che finisca, una generazione tecnicamente riuscita può comunque fallire commercialmente. Un endpoint più costoso può essere vantaggioso quando riduce i tentativi legati a timeout, le sessioni abbandonate o gli interventi di supporto.
Confronta entrambe le opzioni sotto una concorrenza rappresentativa. Misura il tempo al primo token, la latenza di completamento, la latenza di coda e il completamento delle attività accettate, piuttosto che affidarti a un test di endpoint inattivo.
Il routing modifica il confronto operativo
Instradiamo ogni richiesta al venditore sano più economico e la spostiamo a un altro venditore sano quando un provider diventa lento o non disponibile. Ciò riduce la necessità per la tua applicazione di implementare ogni percorso di recupero specifico del venditore, ma dovresti comunque testare il comportamento end-to-end.
Se nessun provider può servire un modello, l'API restituisce 503 no_available_provider, e nulla viene addebitato. Per i video, la risposta indica il costo massimo che il job può avere prima che inizi la generazione. Nessuno dei due comportamenti elimina la necessità di gestire capacità non disponibile o risultati ritardati nel tuo prodotto.
Imposta questi valori prima di confrontare gli endpoint:
- Obiettivo di disponibilità: Definisci quando una funzionalità deve funzionare e quale comportamento degradato è accettabile.
- Obiettivo di latenza: Specifica il tempo di risposta di cui gli utenti hanno bisogno, incluso il comportamento di coda lenta.
- Valore di failover: Decidi quali interruzioni giustificano capacità alternativa o un altro modello.
- Massimale di costo per attività: Imposta la spesa massima economicamente accettabile per un risultato accettato.
Un confronto utile per l'approvvigionamento mantiene costanti questi requisiti. Altrimenti, stai confrontando servizi diversi attraverso la stessa colonna di prezzo.
Imposta il tuo budget prima di impegnarti con un modello
Impegnati con un modello solo dopo aver collegato il suo prezzo a un budget a livello di funzionalità e a un test di accettazione misurabile. Una risposta promettente nel playground è un punto di partenza, non la prova che l'intero flusso di lavoro sia economico.
Applica controlli alla valutazione
Scegli l'unità di fatturazione di ogni funzionalità. Registra se il risultato consuma input tokens, output tokens, images, megapixels o jobs. Mantieni la configurazione richiesta accanto a quell'unità in modo che una modifica delle dimensioni dell'immagine o delle impostazioni video attivi una revisione del budget.
Crea una previsione a livello di funzionalità. Usa il volume di richieste osservato e l'utilizzo da un campione rappresentativo. Includi l'intero percorso di esecuzione, inclusi background processing e chiamate di riparazione dirette dall'applicazione, anziché stimare solo dal prompt visibile dell'utente.
Invia un limite di prezzo con le richieste. Usa il controllo
max_priceomax_costapplicabile. Una richiesta non viene mai fatturata al di sopra del valore che invii, quindi un limite applicabile è più utile che supporre che il prezzo di catalogo tipico sia un massimo garantito.Alloca il saldo condiviso deliberatamente. Un unico saldo copre modelli di testo, image, video e music. Mantieni registri di spesa a livello di funzionalità in modo che un esperimento multimediale non oscuri i fondi necessari per un flusso di lavoro di testo consolidato.
Valuta un modello alternativo. La nostra API fornisce una key per ogni modello al prezzo di listino o inferiore. Cambia l'identificatore del modello mantenendo stabili le istruzioni del task e i criteri di accettazione, quindi confronta i risultati ottenuti anziché selezionare la risposta che sembra più raffinata.
Esegui un pilot di produzione limitato. Scegli una finestra di revisione che catturi il traffico di routine e quello difficile. Confronta il costo misurato per task accettato con la tua previsione prima di espandere l'accesso o aumentare la concurrency.
Indaga la differenza prima di cambiare provider
Usa il playground della dashboard per confrontare gli output e regolare i parametri prima dell'integrazione in produzione. Per l'extraction, ispeziona la conformità dello schema e se i campi sono supportati dal documento. Per il coding, valuta se la modifica proposta soddisfa il task e supera i controlli pertinenti.
Quando il costo misurato supera la previsione, controlla prima output length, retry behavior e context size. Poi verifica se la tua applicazione ha modificato il carico di lavoro, ad esempio allegando cronologie complete di conversazioni o fornendo ripetutamente gli stessi documenti. Non dare per scontato che una fattura più alta significhi che la tariffa elencata sia aumentata.
Apri la tabella dei prezzi live questa settimana, identifica la funzionalità responsabile della quota maggiore della tua spesa e costruisci la sua stima dall'utilizzo registrato. Assegna qualcuno per rivedere i primi risultati misurati rispetto a quella previsione.
UberLLM offre una API unificata e un saldo prepagato per accedere a modelli di testo, image, video e music, con controlli di prezzo a livello di richiesta. Visita UberLLM per confrontare i prezzi dei modelli live, scegliere un candidato per la tua funzionalità con la spesa più alta e testare il suo costo per task completato prima di impegnarti.