Modelli di Prezzo dell'IA Spiegati: Tokens, Compiti e Costi
Confronta i modelli di prezzo dell'IA: per token, per compito, fatturazione ad abbonamento e a crediti, e come stimare quanto costerà realmente la tua inferenza.
Hai una funzionalità AI funzionante, e ora stai cercando di stabilirne il prezzo. La tariffa per token del modello sembra gestibile, ma la fattura di staging include risposte lunghe, retries, tool calls e lavori video che non hanno mai prodotto qualcosa di utilizzabile. Moltiplicare la tariffa di base per il traffico previsto non ti dà più un budget credibile.
I modelli di prezzo AI descrivono come i fornitori ti addebitano. Il costo per attività completata ti dice se la funzionalità è economica. Hai bisogno di entrambe le prospettive: l'unità di fatturazione per riconciliare gli addebiti, e il risultato finale per confrontare modelli, fornitori e margini di prodotto.
Indice
- Sei modelli di prezzo per l'IA e come ciascuno ti fattura
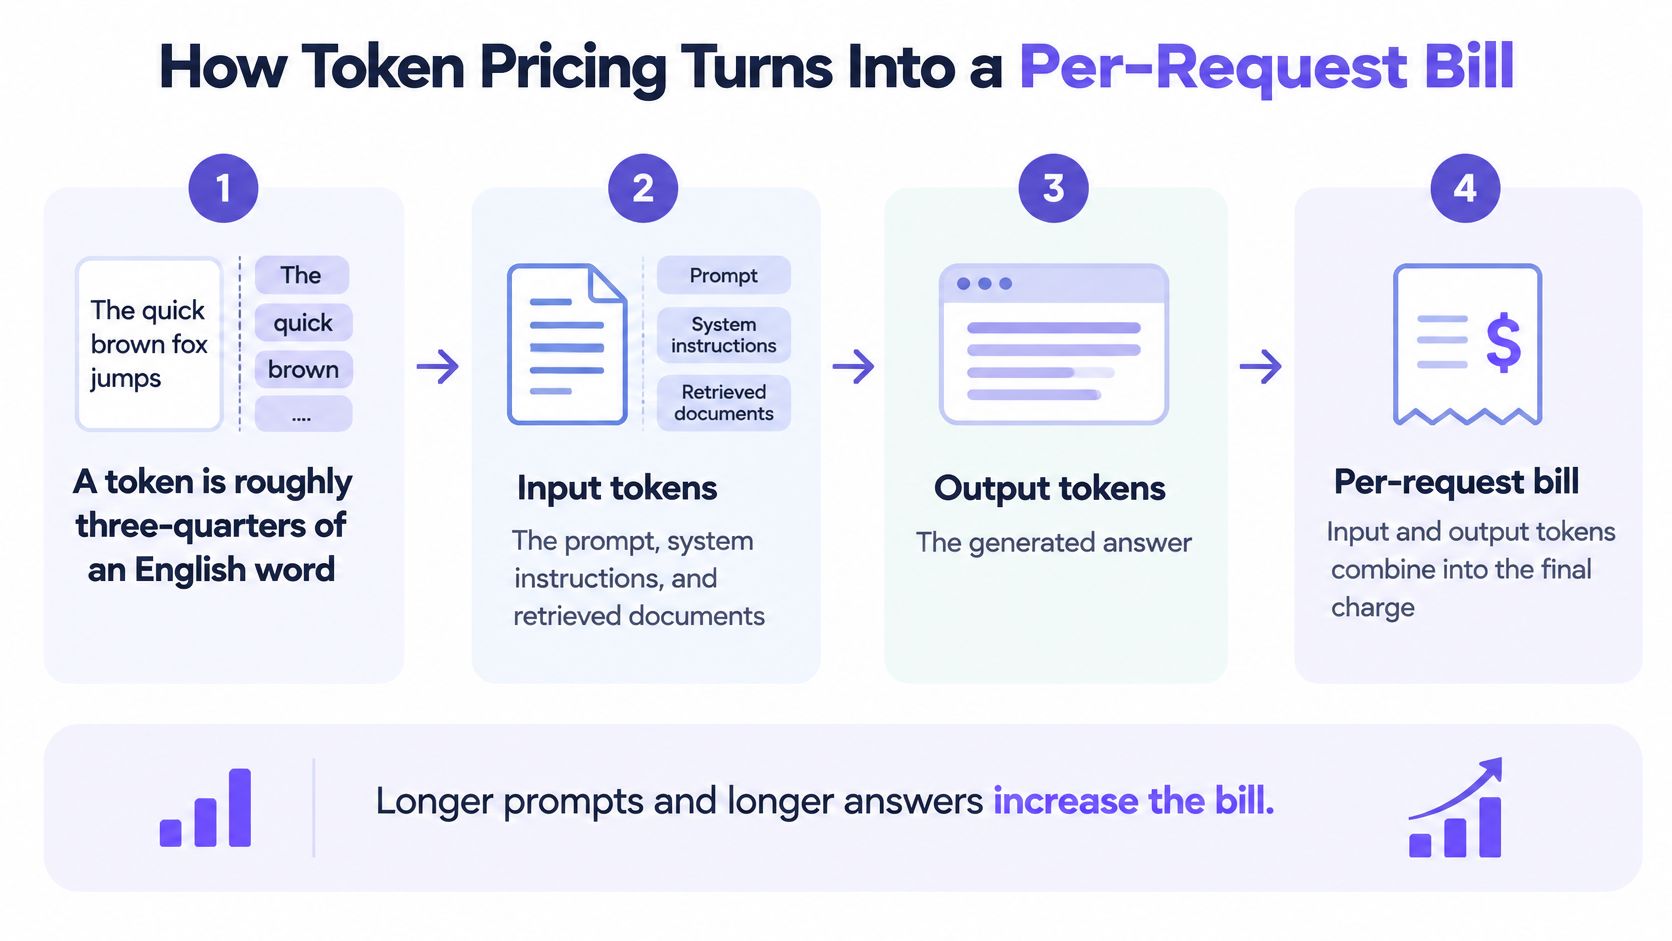
- Come il prezzo per token si trasforma in una fattura per richiesta
- Prezzi per media: immagini, video e audio
- Perché il costo per attività completata batte il costo per token
- Perché i prezzi dei modelli continuano a scendere
- Scegliere tra crediti, abbonamenti e fatturazione a consumo
- Checklist del fornitore oltre il prezzo di listino
- Conferma il tuo costo per attività prima di impegnarti
Sei modelli di prezzo per l'IA e come ognuno ti fattura
La maggior parte dei prodotti AI fattura tramite una delle sei strutture. La tabella mostra l'unità di fatturazione, il caso d'uso ideale e il rischio principale per ciascuno.
Modelli di prezzo comuni per l'IA a colpo d'occhio
| Modello di prezzo | Come ti viene addebitato | Caso d'uso ideale | Rischio principale |
|---|---|---|---|
| Per token | Per milioni di token di input e output, con prezzi separati | Chat, coding, API di testo | La fattura aumenta con la lunghezza della risposta |
| Per unità multimediale | Per immagine, per secondo di video o per lavoro di generazione | Strumenti per immagini, video, voce e musica | Risoluzione e durata modificano il prezzo unitario |
| Abbonamento con quote | Tariffa mensile fissa con un limite di utilizzo | Prodotti stabili, basati su licenza | Costi per eccesso di utilizzo o limitazione dopo il raggiungimento del limite |
| Crediti prepagati | Saldo scalato per richiesta | Carichi di lavoro variabili su più provider | Il saldo inutilizzato può scadere |
| Basato sul risultato | Tariffa per attività completata o caso risolto | Agenti di supporto, flussi di lavoro con successo chiaro | Definire il successo è difficile |
| Ibrido | Abbonamento base più utilizzo a consumo o crediti | Prodotti con carichi di lavoro misti di testo e media | Due componenti di fatturazione da riconciliare |
Abbina l'unità al carico di lavoro
La fatturazione per token si adatta ai carichi di lavoro testuali perché misura il materiale elaborato e generato. È utile per chat e coding, ma un'istruzione per produrre una spiegazione dettagliata può modificare la fattura senza cambiare il numero di richieste.
La fatturazione per unità multimediale è più facile da capire a prima vista: paghi per un'immagine o un lavoro di generazione. La difficoltà sta nella definizione di quell'unità, inclusi risoluzione, durata, impostazioni di qualità e audio.
Gli abbonamenti con quote funzionano quando un team necessita di accesso regolare e può rimanere entro un'allocazione prevedibile. Verifica cosa succede al raggiungimento del limite prima di considerare l'abbonamento come un costo operativo fisso.
I crediti prepagati mettono la spesa dietro un saldo finanziato. Sono adatti alla sperimentazione su diversi modelli, a condizione che tu comprenda la scadenza, i rimborsi e come i crediti si traducano in utilizzo effettivo.
Il prezzo basato sul risultato avvicina l'addebito al valore aziendale. Un flusso di lavoro di supporto necessita però di un test di risoluzione esplicito, inclusi gli scenari in cui il cliente riapre il caso.
I piani ibridi combinano l'accesso o un'allocazione inclusa con il consumo variabile. Possono gestire carichi di lavoro misti, ma la finanza deve riconciliare sia il costo base che la componente a consumo.
Regola pratica: Identifica l'unità che il fornitore fattura prima di confrontare qualsiasi prezzo di listino.
Un abbonamento non è automaticamente più economico della fatturazione a consumo, e i crediti non sono automaticamente uno sconto. Traduci ogni offerta nel carico di lavoro che intendi eseguire, inclusa qualsiasi allocazione che pagherai ma non utilizzerai.
Come la tariffazione dei token si trasforma in un costo per richiesta
Costo della richiesta = (token di input ÷ token per unità di prezzo × tariffa di input) + (token di output ÷ token per unità di prezzo × tariffa di output).
Per i prezzi quotati per milione di token, usa un milione come divisore. I token di input includono il prompt, le istruzioni di sistema, la cronologia della conversazione e i documenti recuperati. I token di output coprono la risposta generata. Usa il tokenizer del modello o i campi di utilizzo restituiti piuttosto che un'approssimazione del conteggio delle parole, specialmente per il codice e il testo multilingue.
Le tariffe distinte sono importanti. Un'analisi arXiv della tariffazione API riporta che GPT-4 è stato lanciato a marzo 2023 a $30 per milione di token di input e $60 per milione di token di output. La generazione richiede un calcolo diverso dall'elaborazione di un prompt, quindi non dare per scontato che le due tariffe corrispondano.
Elabora una richiesta con entrambe le tariffe
Considera una richiesta ipotetica contenente 2,000 token di input e 800 token di output. Claude Opus 5.5 costa $4.00 di input e $20.00 di output per milione di token al prezzo di listino, rispetto a $2.03 di input e $10.13 di output su UberLLM.
| Componente | Al prezzo di listino | Tramite il nostro marketplace |
|---|---|---|
| Calcolo input | 2,000 ÷ 1,000,000 × $4.00 | 2,000 ÷ 1,000,000 × $2.03 |
| Costo input | $0.008 | $0.00406 |
| Calcolo output | 800 ÷ 1,000,000 × $20.00 | 800 ÷ 1,000,000 × $10.13 |
| Costo output | $0.016 | $0.008104 |
| Totale | $0.024 | $0.012164, circa $0.012 |
Questi calcoli descrivono la richiesta ipotetica, non una media per la tua applicazione. A un ipotetico milione di richieste al mese con esattamente quella combinazione di token, la differenza è $11,836, o circa $12,000. Una diversa lunghezza dell'output cambia il risultato.
Il flusso di fatturazione rende più facile ispezionare la distinzione tra la dimensione del prompt e la dimensione della risposta.
Crea la tua stima da richieste reali
- Conta i token di input usando il tuo template di prompt e dati cliente rappresentativi. Includi istruzioni e contesto recuperato.
- Stima i token di output da risposte accettate, non solo dalla dimostrazione di successo più breve.
- Applica ogni tariffa separatamente al conteggio dei token corrispondente.
- Somma i risultati per ottenere l'addebito del modello per quella richiesta.
- Moltiplica per il volume atteso, mantenendo separate le classi di richieste brevi e lunghe.
Il nostro prezzo del modello elencato descrive quanto costa tipicamente una richiesta, non un limite massimo. Una richiesta non viene mai fatturata al di sopra di un max_price o max_cost inviato con essa. Mantieni esplicita questa distinzione nella tua applicazione: una stima aiuta a prevedere la spesa, mentre un limite massimo di richiesta impone un limite.
Prezzi dei media per immagini, video e audio
Esempi di prezzi unitari dei media: listino contro UberLLM
| Modello | Unità di fatturazione | Prezzo di listino | Prezzo UberLLM |
|---|---|---|---|
| Immagine Flux 2 Pro | Per immagine | $0.03 | $0.0075 |
| LTX 2.3 Fast Text to Video | Per lavoro | $0.06 | $0.045 |
| Veo 3.1 Full Text-to-Video | Per lavoro | $0.44 | $0.22 |
Il prezzo di Flux è inferiore del 75%, calcolato dai prezzi delle immagini di listino. LTX è inferiore del 25%, e Veo è inferiore del 50%. Ogni confronto si applica solo al modello specificato e alle impostazioni corrispondenti, non a ogni richiesta di immagine o video.
I prodotti multimediali spesso fatturano in unità diverse dai token di testo. Un lavoro di generazione, un'immagine, una durata audio o una durata video diventano l'unità che devi normalizzare. La scelta del modello e le impostazioni di output determinano cosa include tale unità.
Confronta impostazioni di generazione identiche
Un clip breve ed economico non sostituisce l'asset più lungo e ad alta risoluzione di cui il tuo prodotto ha bisogno. Anche l'audio è importante: un'anteprima silenziosa e un clip audiovisivo finito non sono deliverable equivalenti.
Prima di confrontare i fornitori, definisci con precisione:
- Modello e compito: Mantieni identici la versione del modello e la modalità di generazione, inclusi text-to-video rispetto a image-to-video.
- Risoluzione e durata: Registra le dimensioni richieste e la lunghezza del clip invece di affidarti al nome di un modello.
- Impostazione audio: Specifica se l'audio generato è incluso.
- Definizione del lavoro: Conferma cosa include un lavoro e se estensioni, upscaling o output aggiuntivi richiedono richieste separate.
La guida ai prezzi per secondo dell'API Veo aiuta a inquadrare i confronti basati sulla durata. Non convertire un preventivo per lavoro in una tariffa al secondo finché non conosci la durata che quel preventivo copre.
Un confronto dei prezzi dei media è utile solo quando entrambi i prezzi acquistano lo stesso deliverable.
Per l'audio, distingui il parlato generato dalla trascrizione e dalla generazione musicale. La durata dell'audio caricato e la durata dell'output generato sono misurazioni diverse, quindi registra quella che il servizio fattura.
Conserva un piccolo manifest delle impostazioni accanto al tuo foglio di calcolo dei prezzi: identificatore del modello, compito, dimensioni, durata, audio e qualsiasi opzione di qualità. Prezza quel manifest con ogni fornitore, quindi salva il preventivo e la configurazione insieme. Puoi ripetere il confronto quando i prezzi cambiano senza confrontare accidentalmente un prodotto diverso.
Perché il Costo per Attività Completata Supera il Costo per Token
La tariffa token più economica può produrre l'attività completata più costosa. Un modello che necessita di correzioni ripetute, chiamate a strumenti non necessarie o riparazioni manuali può consumare token meno costosi, ma costare di più per fornire un risultato utilizzabile.
La differenza diventa visibile quando si confronta una risposta diretta con un workflow che continua a intraprendere azioni.
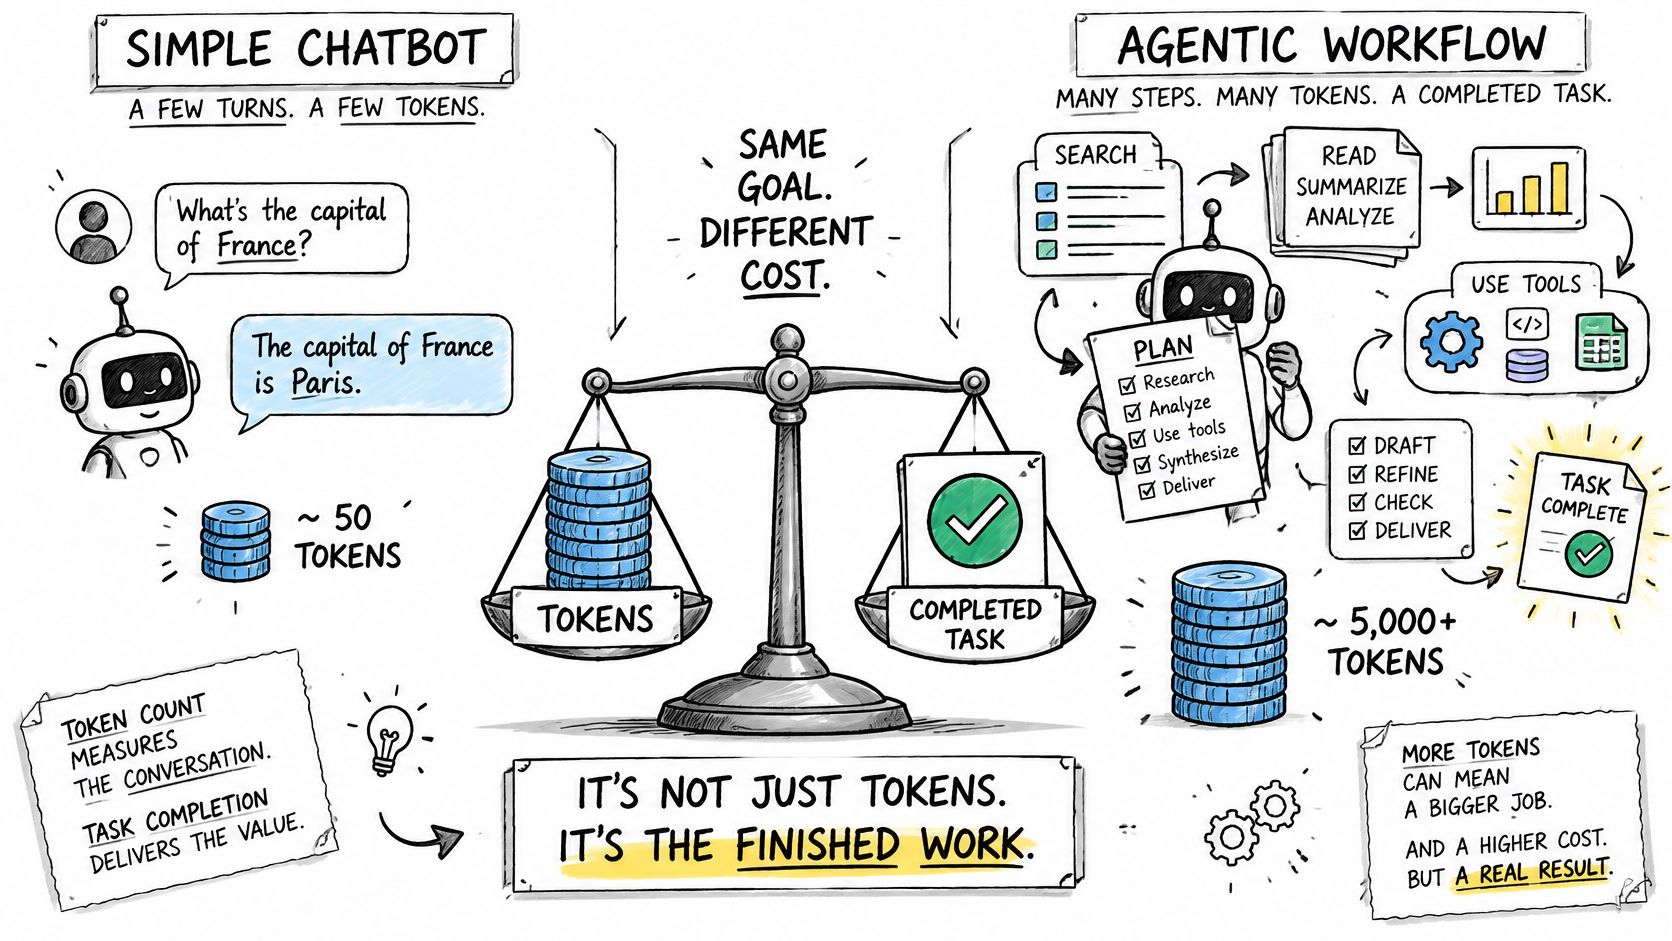
L'analisi dei costi del workflow agentico di Oometa descrive i workflow agentici che consumano 5–30 volte più token rispetto a un'interazione chatbot convenzionale e stima all'incirca $0.001 per una semplice chiamata chatbot contro $0.10–$1.00 per un'attività agente multi-step. Considerali come contesto, non come la tua previsione: pianificazione, recupero, strumenti, riflessione e tentativi differiscono in base all'implementazione.
Metti il lavoro non riuscito al numeratore
Costo per esito positivo = spesa totale relativa all'attività ÷ attività completate con successo.
In un lotto ipotetico, 1,000 tentativi a $0.10 ciascuno costano $100. Se 800 hanno successo, il costo per attività risolta è $0.125, non $0.10. I tentativi non riusciti rientrano comunque nel calcolo dei costi.
Un secondo confronto ipotetico mostra perché i prezzi di listino ingannano:
| Modello ipotetico | Costo per tentativo | Tasso di successo | Costo per successo |
|---|---|---|---|
| Modello a prezzo inferiore | $0.05 | 30% | Circa $0.167 |
| Modello a prezzo superiore | $0.10 | 90% | Circa $0.111 |
Questi sono esempi aritmetici, non prestazioni del modello misurate. Assumono tentativi comparabili e un tasso di successo invariato; la tua valutazione deve stabilire entrambi.
Il video offre un altro modo per considerare i costi del workflow.
Traccia output length, retries, latency-driven fallbacks e charges for unsuccessful requests rispetto a un identificatore di attività condiviso. Includi i costi degli strumenti o dell'infrastruttura quando sono rilevanti, e distingui una risposta API da un successo commerciale.
Una risposta di supporto che richiede a un dipendente di riscriverla non equivale a un ticket risolto. Usa il risultato di cui il tuo cliente ha bisogno: un caso risolto, un clip accettato o un'attività di codifica che supera i suoi test di accettazione.
Perché i prezzi dei modelli continuano a scendere
Il modello più economico che eguaglia le prestazioni a livello GPT-3.5 su MMLU è sceso da circa $20 per milione di token a novembre 2022 a $0.07 a ottobre 2024, circa 286 volte più economico, secondo il riepilogo di Orb dei dati riportati da Stanford. Il rapporto AI Index 2025 di Stanford descrive il calo del costo di inferenza, a parità di capacità, in quel periodo come più di 280 volte.
Questo confronto mantiene costante la soglia del benchmark. Non si limita a confrontare un modello costoso e capace con un modello più debole ed economico, sebbene eguagliare un benchmark non garantisca comunque un comportamento equivalente sulla tua applicazione.
Prevedi un budget per l'offerta variabile, non per una tariffa fissa
Architetture più piccole, quantizzazione, software di inferenza migliorato, hardware specializzato e la concorrenza tra i fornitori contribuiscono a ridurre i costi. Ognuno influisce su una parte diversa dell'economia: dimensione del modello, precisione numerica, efficienza di servizio, utilizzo dell'hardware o margine del fornitore.
Per gli acquirenti, l'implicazione pratica è separare un'ipotesi di prezzo da un'ipotesi di qualità. Una tariffa più bassa è utile solo se il candidato soddisfa ancora i tuoi criteri di accettazione.
- Mantieni un registro dei prezzi datato: Salva l'identificatore del modello, le tariffe di input e output, l'unità di fatturazione e la data in cui le hai lette.
- Usa scenari di budget: Modella la domanda prevista insieme a un carico di lavoro più pesante con output più lunghi e attività più complesse.
- Pianifica revisioni: Rivedi le tariffe trimestralmente e indaga su deviazioni significative delle fatture prima della prossima revisione programmata.
Un indice dei prezzi dei modelli può aiutare a identificare i candidati che vale la pena ritestare. Non dovrebbe sostituire il registro dei prezzi allegato ai tuoi log di richiesta.
Il nostro prezzo di listino si aggiorna ogni 5 minuti. Utilizza il prezzo di listino del fornitore moltiplicato per la quota del prezzo di listino addebitata durante l'ora di scambio più costosa del marketplace nelle ultime 24 ore, e non è mai inferiore all'offerta più economica.
Verifica i termini contrattuali di modifica del prezzo separatamente dal tuo programma di revisione. Un promemoria sul calendario non rende fissa una tariffa variabile, e i cali storici non sono una garanzia che ogni percorso diventerà più economico.
Scegliere tra Crediti, Abbonamenti e Fatturazione a Consumo
Uno studio arXiv sui prezzi dei prodotti AI ha rilevato che gli abbonamenti con quote di utilizzo erano il modello di prezzo nativo AI più diffuso tra 52 prodotti; 25 offrivano un piano gratuito, una prova o crediti iniziali, mentre 13 utilizzavano prezzi di ingresso pay-as-you-go. Questo modello non stabilisce un vincitore universale. Mostra perché la fatturazione a puro consumo non è l'unica struttura sensata.
La decisione riguarda chi si assume il rischio di un utilizzo variabile. Un abbonamento sposta parte del rischio di domanda verso il fornitore, mentre le strutture prepagate e a consumo rendono il consumo più visibile all'acquirente.
Usa i tuoi vincoli operativi per scegliere
| Domanda | Cosa suggerisce la risposta |
|---|---|
| L'utilizzo mensile è stabile? | Un abbonamento con una quota utilizzabile può semplificare la gestione del budget |
| Utilizzerai più fornitori o modalità? | Un saldo prepagato condiviso può ridurre i finanziamenti frammentati |
| Puoi prevedere il consumo in modo affidabile? | La misurazione è più facile da gestire quando le stime del carico di lavoro sono affidabili |
| La finanza richiede un limite massimo? | Dai priorità ai limiti applicabili rispetto alle etichette di fatturazione |
Un utilizzo stabile con un singolo fornitore indica un abbonamento, a condizione che l'allocazione si adatti al tuo carico di lavoro effettivo. Non considerare la quota inutilizzata come valore e verifica se gli extra richiedono approvazione o avvengono automaticamente.
Una domanda irregolare su più modelli indica crediti o utilizzo a consumo. I termini di scadenza e di riporto sono importanti perché l'acquisto di capacità che non utilizzi mai può annullare uno sconto apparente.
Separa il finanziamento dalla fatturazione
Un portafoglio prepagato descrive quando finanzi l'utilizzo, non necessariamente come viene prezzata ogni richiesta. Allo stesso modo, il pay-as-you-go può operare tramite un saldo prepagato anziché una fattura posticipata.
Non abbiamo nessun costo mensile e nessun minimo. I clienti mantengono un unico saldo e pagano a consumo. La nostra opzione di pagamento upto, offerta per prima, prevede che il portafoglio firmi un preventivo come massimale; dopo la risposta, viene addebitato solo il costo effettivo, arrotondato al milionesimo di dollaro successivo.
Scegli il vincolo su cui non puoi scendere a compromessi prima di scegliere il piano.
Se quel vincolo è un budget fisso, esamina i controlli di spesa. Se si tratta di accesso prevedibile per un team stabile, esamina le regole di quota e di superamento. Se si tratta di flessibilità tra testo e media, verifica se lo stesso saldo supporta i flussi di lavoro che intendi eseguire.
Checklist del Fornitore Oltre il Prezzo di Listino
Un listino prezzi non ti dice tutto ciò che serve per riconciliare una fattura di produzione. Verifica il comportamento di fatturazione, non solo l'aritmetica mostrata in un playground.
Usa questa checklist per identificare i termini che necessitano di una risposta concreta.
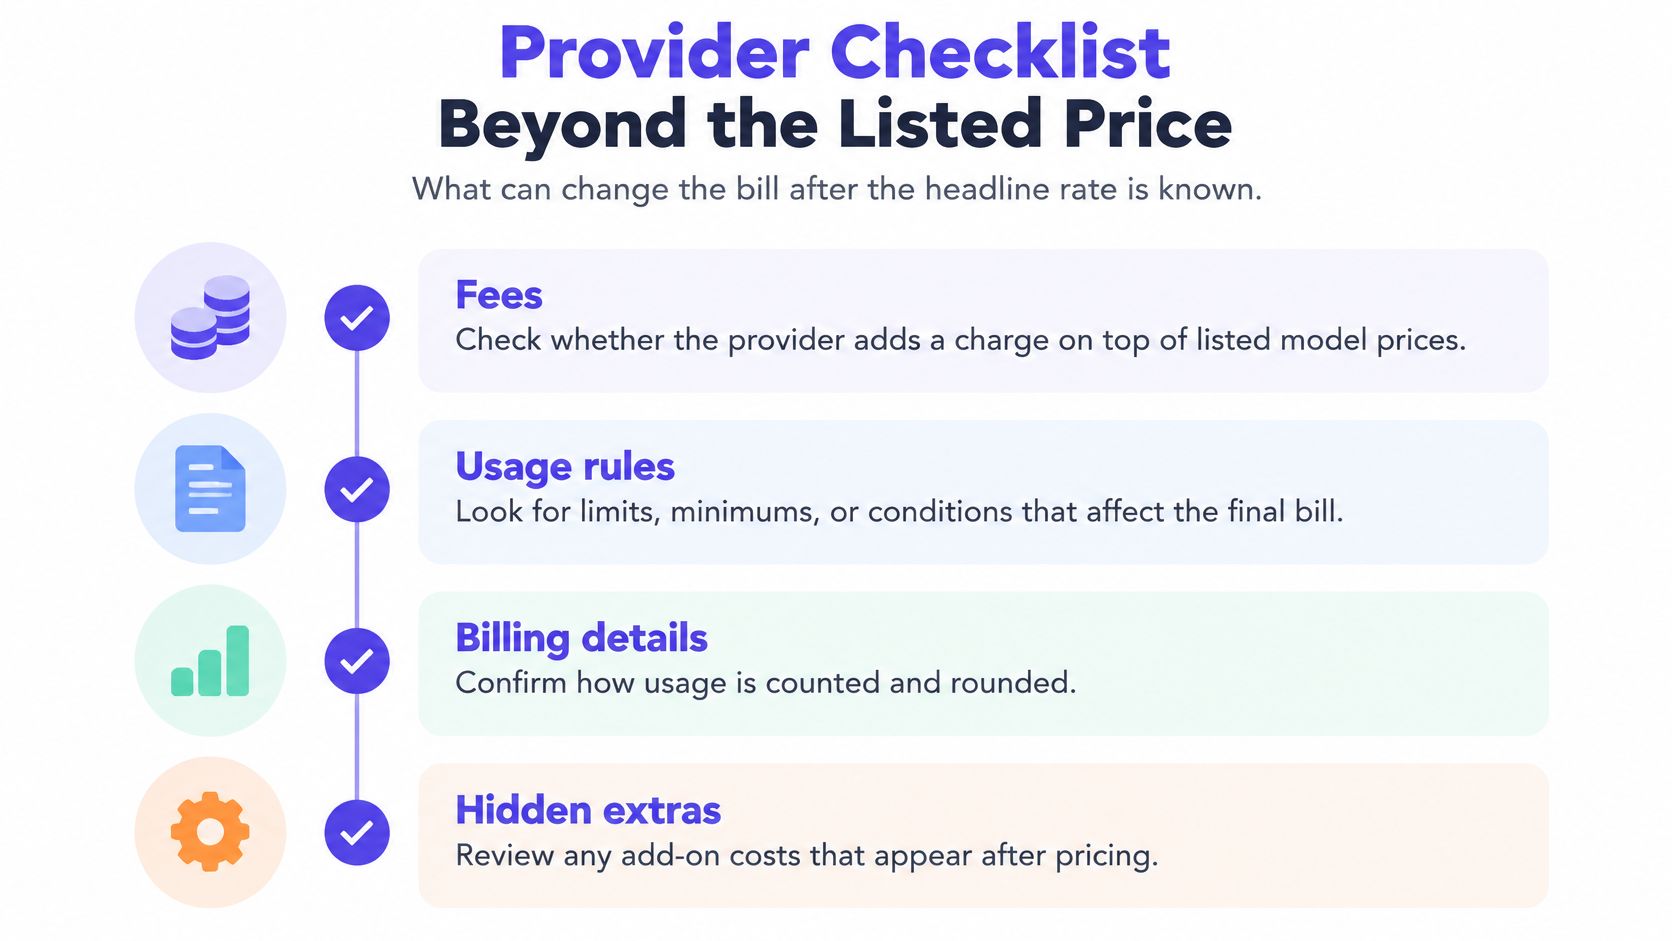
Verifica il percorso di addebito
- Le commissioni sono esplicite. Non aggiungiamo alcuna commissione oltre i prezzi di listino dei modelli. Mantieni i costi di finanziamento separati dai costi delle richieste quando confronti la spesa totale. Una risposta negativa è un preventivo che esclude un supplemento di piattaforma non specificato.
- La base di addebito è tracciabile. Quando il fornitore riporta ciò che ha addebitato per una chiamata, fatturiamo esattamente quell'importo. Altrimenti, la chiamata costa i suoi token al prezzo di listino. Una risposta negativa è un totale della fattura che non può essere collegato all'utilizzo a livello di richiesta o agli addebiti riportati.
- Le richieste non riuscite hanno un trattamento definito. Le nostre richieste e generazioni fallite non costano nulla. Una generazione completata che non ti piace, tuttavia, non dovrebbe essere automaticamente classificata come un fallimento tecnico. Una risposta negativa lascia la distinzione indefinita.
Verifica il percorso di controllo
- Le chiavi forniscono isolamento. Le nostre API key sono con ambito e revocabili, e si applicano limiti di spesa per chiave. Una chiamata a uno strumento MCP viene fatturata, limitata e rifiutata come l'equivalente richiesta API. Una risposta negativa richiede la disabilitazione di ogni servizio per fermare una singola integrazione compromessa.
- Il comportamento di fallback è comprensibile. Spostiamo le richieste a un altro venditore sano quando un fornitore diventa lento o non disponibile. Verifica l'addebito e i tempi risultanti nei tuoi log. Un fornitore che non sa spiegare se un percorso alternativo modifica l'addebito ti lascia con un prezzo sconosciuto.
Per carichi di lavoro misti, esamina come un'API unificata per testo, immagini e video espone lo stato e i risultati delle attività. Una richiesta di media asincrona necessita di un identificatore di attività duraturo affinché l'invio, il completamento e la fatturazione possano essere riconciliati anche quando avvengono in momenti diversi.
Esegui questi controlli su traffico rappresentativo a forma di produzione, inclusi timeout, cancellazioni e lavori falliti. Un account demo con prompt brevi e risposte riuscite non rivelerà se la tua contabilità sopravvive alle condizioni che la tua applicazione deve gestire.
Conferma il tuo costo per attività prima di impegnarti
Effettua una valutazione controllata piuttosto che migrare basandoti sulla forza di una tabella prezzi. Lo scopo è scoprire quale opzione offre risultati accettabili a un costo operativo accettabile, senza modificare il carico di lavoro.
Esegui un confronto controllato
- Seleziona attività rappresentative. Includi richieste di routine, casi difficili, contesti lunghi e input che in precedenza hanno causato problemi. Escludi materiale sensibile dei clienti da una valutazione a meno che il suo utilizzo non sia autorizzato.
- Acquisisci il record di esecuzione. Registra i token di input e output, gli identificatori delle attività, i tentativi, le chiamate agli strumenti, gli addebiti e i giudizi di successo. Registra il tempo per un risultato utilizzabile, non solo il tempo per la prima risposta.
- Calcola la baseline attuale. Dividi tutte le spese rilevanti per i risultati accettati. Mantieni le classi di attività separate in modo che le richieste facili non nascondano una scarsa economia sul lavoro difficile.
- Testa modelli alternativi. Conserva i prompt, gli input, i permessi degli strumenti e i test di accettazione. Con il nostro accesso API comune, il cambio di modello utilizza un identificatore di modello diverso e ogni richiesta viene instradata al venditore sano più economico.
- Applica un budget per le richieste. Scegli limiti appropriati per ogni classe di attività e verifica come l'applicazione gestisce il rifiuto o il lavoro incompleto. Un limite dovrebbe produrre un'esperienza utente controllata, non un errore inspiegabile.
- Confronta i risultati operativi insieme. Valuta il costo per successo, la latenza e il tasso di fallimento. Ispeziona gli output effettivi dove la valutazione automatizzata può mancare errori fattuali o lavoro incompleto.
- Fai un pilot prima di impegnarti. Invia una piccola quota controllata di traffico live al candidato. Riconcilia gli addebiti fatturati con i tuoi log durante il pilot e mantieni un percorso di rollback finché sia la qualità che la contabilità non sono affidabili.
Rendi la decisione ripetibile
Scrivi i criteri di accettazione prima di esaminare i nomi e i prezzi dei modelli. Altrimenti, è facile scusare un output più debole perché un candidato sembra più economico.
Mantieni il set di valutazione versionato e aggiungi nuovi casi di fallimento man mano che l'applicazione cambia. Pianifica la prossima revisione trimestralmente, con un nuovo test anticipato quando un cambiamento significativo del modello, dei prezzi o del prodotto rende inaffidabile il confronto esistente.
L'opzione vincente non è il modello più economico in isolamento. È la configurazione che completa il tuo carico di lavoro rispettando i tuoi vincoli di qualità, latenza e budget.
UberLLM offre una singola API key per modelli di testo e media, un saldo prepagato condiviso e l'instradamento al venditore sano più economico per ogni modello richiesto. Visita UberLLM per confrontare i prezzi attuali, quindi testa attività rappresentative e misura il costo dei risultati accettati prima di spostare il traffico di produzione.