モデリングのコストは? AI推論の価格を解説
2026におけるモデリングのコストは? 現在のAIのトークンごとおよびジョブごとの価格、月額料金の計算式、そしてそれを変動させる隠れたコスト。
フロンティアモデルの作成と日常的なモデルの使用では、経済性が大きく異なります。Epoch AIのトレーニングコスト分析]によると、フロンティアモデル開発コストの**47%–67%をハードウェアが占める一方、エネルギーはわずか2%–6%**です。しかし、アプリケーション開発者にとって重要な問いは、モデルの構築にかかった費用ではありません。再試行が必要なリクエストを含め、有用なタスクを完了するために支払う費用です。
目次
- テキスト、画像、動画モデルの現在の価格
- 月々のモデル利用料金の見積もり方法
- 推論コストを変える要因
- 安価なtokenでも請求額が高くなる理由
- 信頼性とインフラストラクチャが実質コストをどう変えるか
- モデルを決定する前に予算を設定する
テキスト、画像、動画モデルの現在の価格
モデリングの費用はどのくらいですか? AI推論の場合、答えは請求単位から始まります。テキストは入力および出力tokenを使用し、画像は画像またはmegapixelを使用し、動画はjobを使用できます。この記事では、トレーニング予算ではなく、推論の利用料金について説明します。Stanfordが報告したGemini 1.0 Ultraのトレーニング費用は、VoronoiのAI Index見積もりの発表によると、$192 millionと推定されていますが、APIのお客様がその開発費用を直接支払うことはありません。
過去の傾向は顕著です。Stanford 2025 AI Indexによると、MMLUでGPT-3.5レベルのパフォーマンスを達成するシステムへのクエリ費用は、2022年11月の約**$20** 100万tokenあたりから、2024年10月には**$0.07**にまで下落したと測定されています。これはベンチマークに特化した比較であり、すべての高性能モデルの現在の見積もりではありません。
モデルタイプ別の現在の単位あたり価格
UberLLMでは、GPT、Claude、Gemini、DeepSeek、GLM、Qwen、Llama、Mistral、Kimiを含む254モデルのリアルタイムAPI価格をモデルごとに掲載しています。チャットの価格は、入力と出力で分かれています。
| モデル | 請求単位 | UberLLM価格 | 定価 |
|---|---|---|---|
| Claude Opus 5.5, input | 1M入力tokenあたり | $2.03 | $4.00 |
| Claude Opus 5.5, output | 1M出力tokenあたり | $10.13 | $20.00 |
| Kimi K3, input | 1M入力tokenあたり | $0.003 | $0.19 |
| Kimi K3, output | 1M出力tokenあたり | $0.23 | $15.00 |
| FLUX 2 Pro image | 画像あたり | $0.0075 | $0.03 |
| Nano Banana 2 image | 画像あたり | $0.015 | $0.10 |
| FLUX.2 Klein 4B image | megapixelあたり | $0.00015 | $0.015 |
| Veo 3.1 Full text-to-video | jobあたり | $0.22 | $0.44 |
| Kling 3 Standard image-to-video | jobあたり | $0.063 | $0.084 |
| LTX 2.3 Fast text-to-video | jobあたり | $0.045 | $0.06 |
| Runway Gen-4 Turbo | jobあたり | $0.0675 | 確認済みの定価はありません |
メディア費用を見積もる前に、動画API価格比較を使用して、リアルタイムのjob提供状況を確認してください。job価格は、お客様がリクエストする出力構成と合わせて初めて意味を持ちます。
記載されている価格は、リクエストが通常かかる費用であり、上限ではありません。各行を、お客様の機能が消費する単位を特定し、その単位に予想される使用量を掛けて読み取ってください。画像の寸法を考慮せずに、megapixelあたりの価格を画像あたりの価格と直接比較しないでください。
月額モデル料金の見積もり方法
見積もりは、単一の合算トークン許容量ではなく、製品機能を中心に構築してください。サポート会話、ドキュメント抽出、ビデオプレビューはそれぞれ異なるリソースを消費するため、それらを早すぎる段階で組み合わせると、どの機能に注意が必要かが見えなくなります。
計算は、ボリュームと測定使用量から始まります。
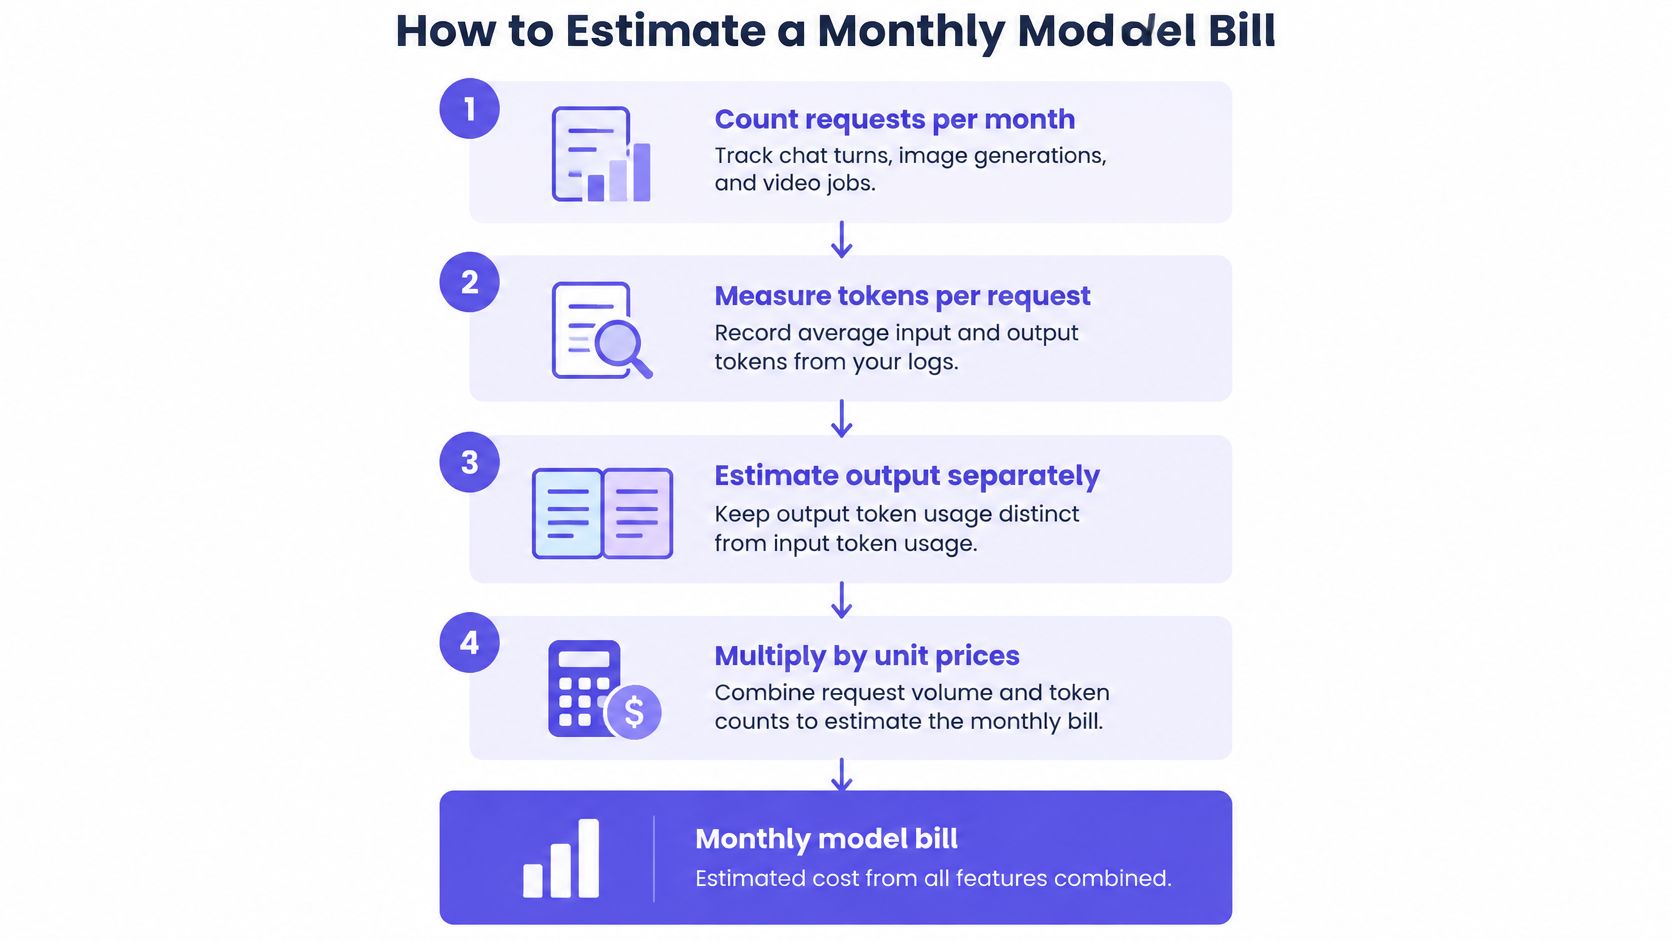
機能別にリクエストをカウントします。 チャットのやり取り、ドキュメント処理の呼び出し、画像生成、ビデオジョブを個別に記録します。ユーザーに表示されるアクションだけでなく、バックグラウンドでの呼び出しも含まれます。
入力と出力を個別に測定します。 レスポンスの使用量フィールドとログから実際のトークン数を取得します。入力測定には、システム指示、会話履歴、取得されたパッセージ、ツール結果を含めます。
正確なモデルの料金を適用します。 カタログに示されている請求単位を使用して、月間の入力トークンを入力レートで、月間の出力トークンを出力レートで乗算します。モデルの変更によって予測が無効にならないように、各計算の横にモデル識別子を記録します。
メディア単位を追加します。 画像、メガピクセル、ビデオジョブのボリュームをそれぞれの価格で乗算します。関連性のない出力を平均化するのではなく、設定固有のジョブは個別に管理します。
追加の試行を含めます。 アプリケーションのリトライ、拒否されたが正常に生成された回答、プロバイダーの障害を区別します。当社の失敗したリクエストや生成は課金されませんが、アプリケーションが拒否した配信済みの回答も、ワークフローが消費した作業を表します。
資金調達コストを考慮します。 記載されているモデル価格に上乗せ料金はなく、月額料金や最低料金もありません。カード残高の追加には、開示されている5.5% と $0.50 の手数料がかかるため、その資金調達費用をリクエストの費用とは別に管理してください。
見積もりを実用的な予算にする
基本的なテキスト計算は次のとおりです。
月間テキスト費用 = 全ての試行における入力トークン料金 + 出力トークン料金
次に、メディア費用と、サポートするアプリケーションサービスを追加します。AI料金モデルのガイド]は、それらを組み合わせる前に請求構造を区別するのに役立ちます。
当社の公開されている月間例は合計**$113.00で、OpenRouterまたは公式価格での$400.00と比較すると、$287.00**の差があります。これは異なるモデル構成や出力ボリュームを持つアプリケーションの予測ではなく、あくまでワークロードの例として扱ってください。
予算編成のルール: 各機能の月間合計、リクエストあたりの平均コスト、および不確実性に対する個別の許容量を維持してください。単一のアカウント合計では、支出が変化した理由を説明できません。
推論コストを変動させる要因
モデルの呼び出しはタクシー料金に似ています。走行距離だけで料金が決まるわけではなく、待ち時間も影響します。推論の場合、トークン量は計算の一部に過ぎません。ワークロードの形状と提供要件が、回答を提供するために必要なリソースに影響します。
コスト要因とそれぞれが料金に与える影響
| 要因 | コストへの影響 | 対策 |
|---|---|---|
| 出力長 | 応答が長くなると、より多くの課金対象出力が消費されます | 出力を制限し、簡潔な形式を要求する |
| モデルの階層 | 高い機能はより高いトークン価格を伴う可能性があります | 品質基準を満たす最も安価なモデルをテストする |
| コンテキスト長 | 長い検索コンテキストはメモリトラフィックを増加させ、スループットを低下させます | 関連する検索されたパッセージのみを送信する |
| Quantization | 低い精度はスループットを向上させる可能性がありますが、品質に影響します | 代表的なタスクで展開された精度を評価する |
| 課金単位 | 画像、メガピクセル、ビデオジョブは異なる出力を測定します | 単位を製品の成果物と一致させる |
| レイテンシーの階層 | 対話型作業に適した容量はプレミアムを要求する可能性があります | 提供要件をユーザーの許容範囲と一致させる |
| 失敗した生成 | 追加の試行は時間を消費し、課金対象の作業を生み出す可能性があります | プロバイダーの障害をアプリケーションレベルの拒否から分離する |
消費者向けGPU推論研究]は、通常のAPIワークロードの場合、電力のみのコストを100万トークンあたり$0.001–$0.005と推定しました。一方、32Kコンテキストでの検索拡張生成では**$0.14–$0.22であり、NVFP4がBF16スループットの約1.6倍を41%少ないエネルギーで提供し、推定2%–4%の品質損失**があったと報告しました。
これらは電力のみの運用コスト推定値であり、顧客のAPI価格ではありません。これらは提供ビジネスの残りの部分を除外しており、料金表の課金対象の入力および出力レートと直接比較することはできません。
セルフホスティングには独自の計算が必要です
LLaMA推論ベンチマーク]によると、65Bモデルの提供にはおよそ8–32個のGPUが必要でした。シャーディング構成に応じて、推論の消費電力は約300ワットから1キロワットと報告されています。したがって、セルフホスティングには電力推定だけでなく、利用率の計算が必要です。ハードウェア、メモリ、ネットワーキング、運用、アイドル容量を含めてください。
代替案を検討する際は、モデル価格変更トラッカー]を使用してください。モデルIDを変更することでモデルを切り替えることができますが、互換性は同等の品質を保証するものではありません。
独自の評価をクリアする最も安価なモデルを選択し、その後、不必要なコンテキストと出力を削減してから、より低い料金を交渉してください。
なぜトークンが安くても請求額が高くなることがあるのか
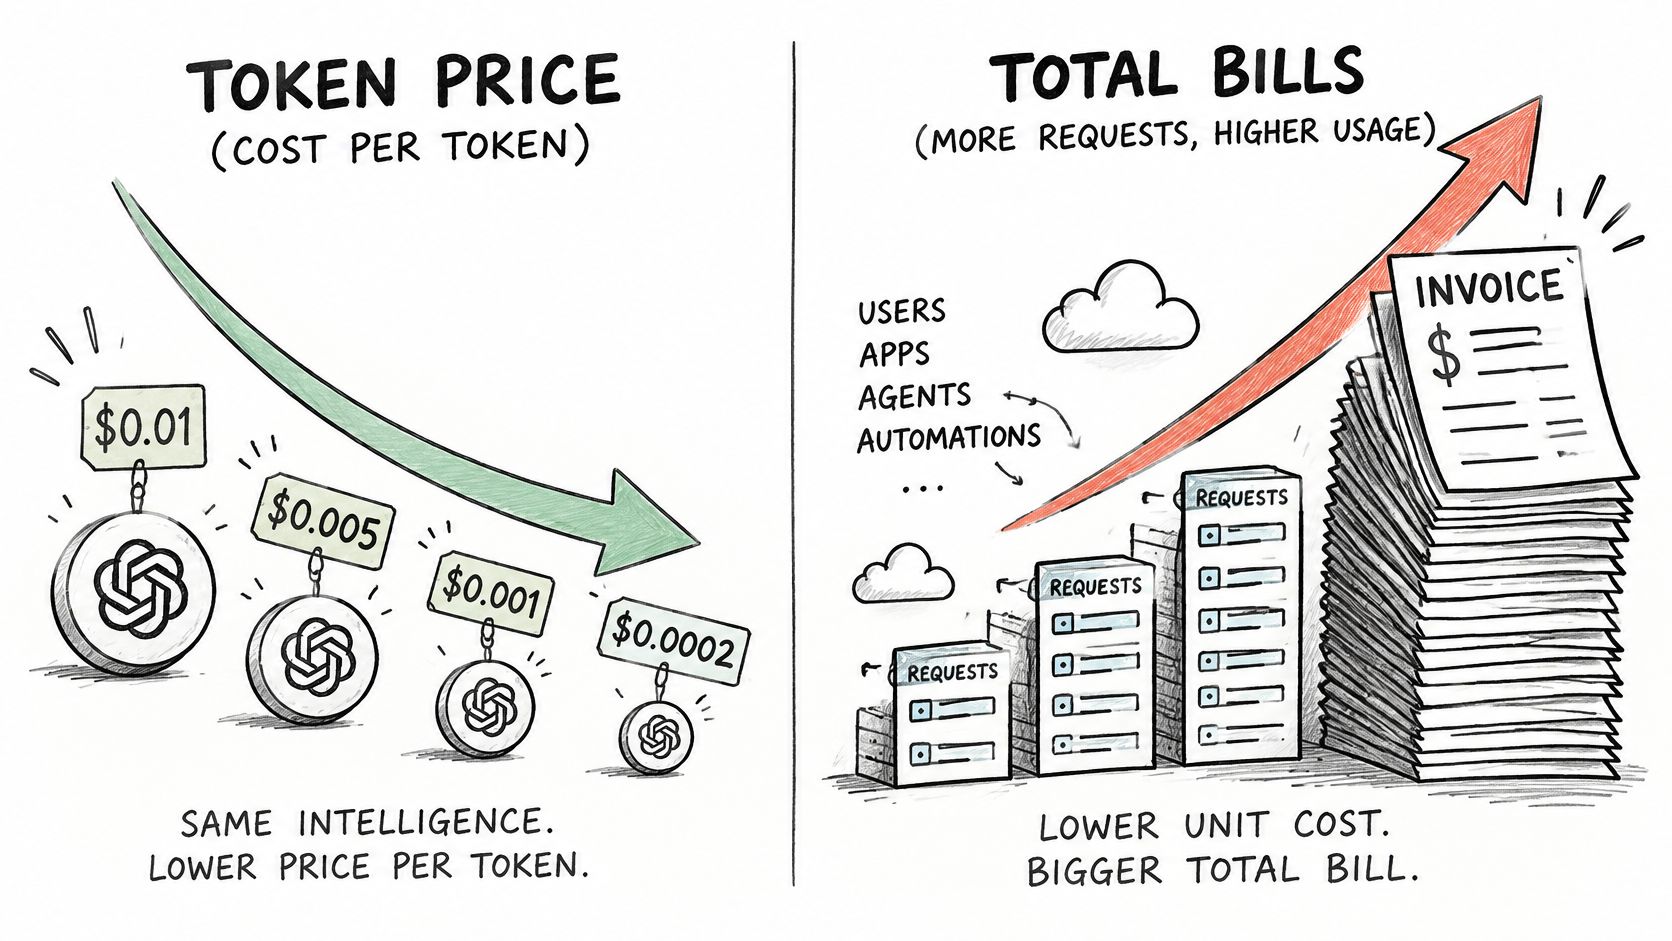
TCSの成果ベースの生成AI支出分析]のある試算によると、トークンあたりのコストは3年間で約1,000分の1に減少した一方で、推論にかかる総支出は増加し続け、出力トークンは入力トークンよりも一般的に3〜6倍高価であると指摘されています。単価が低いからといって、アプリケーションの支出が必ずしも低くなるとは限りません。
この違いは、価格と使用量が逆方向に動くときに、より明確になります。
個別の生成ではなく、完了した作業を比較する
文書抽出のワークフローを例に考えてみましょう。低価格のモデルが、必要な構造化された応答ではなく、冗長な説明を生成した場合、アプリケーションは修正リクエストを送信します。修正された応答がまだ検証に失敗する場合、ワークフローはより強力なモデルにエスカレートします。
代替モデルは出力トークンあたりのコストは高くなりますが、許容できる構造化された結果をすぐに返します。その高い単価でも、タスクの総コストを低く抑えることができます。なぜなら、修正プロンプト、繰り返される文書コンテキスト、およびフォールバック生成を回避できるからです。
この結果は必然ではありません。まさに代表的な評価で判断すべき点です。
完了したタスクあたりのコスト = ワークフローの総支出 ÷ 正常に完了したタスク数
検索、ツール呼び出し、ガードレール、および人間のエスカレーションがそのワークフローに属する場合は、それらを含めます。測定する前に成功を定義してください。届いた答えが、必ずしも製品が使用できる答えとは限りません。
この区別は、AI経済学に関するより広範な議論を解釈する際にも重要です。
高価な経路を診断する
支出と並行して、プロンプト長、出力長、検証失敗、フォールバック決定を追跡します。安価な最初の試みは、ルーティンなケースを解決し、難しいケースを選択的にエスカレートさせるのであれば、依然として価値があります。ほぼすべてのタスクが最初の試みとフォールバックの両方に費用を支払うようになると、無駄になります。
見かけの成功率を上げるためだけに品質チェックを削除しないでください。それは、有用な作業のコストを削減するのではなく、成功の定義を変えることになります。
意思決定テスト: 承認されたワークフローは、最初のモデル呼び出し後だけでなく、長い出力、再試行、およびサポートサービスの後、どれくらいの費用がかかるでしょうか?
信頼性とインフラストラクチャが実質コストをどう変えるか
見出し価格だけでは、アプリケーションが必要なときに適切なキャパシティが利用可能であるとは限りません。リージョン、コミットメント、レイテンシー要件、キャパシティタイプがすべて比較に影響します。
GPUの価格と推論コストのトラッカー]は、H100の価格がスポットインスタンスで約1時間あたり$0.34から平均で約1時間あたり$3.46であったと報告しました。また、プロバイダー、レイテンシーティア、コンテキストウィンドウを横断した同等機能のサービス提供について、100万出力トークンあたり$0.50–$3という見積もりも示しました。これらの範囲は、異なる購入条件を表しており、互換性のあるオファーではありません。
バッチ処理とインタラクティブ処理では異なるキャパシティが必要です
バッチ処理の場合、完了時間が変動しても、安価なエンドポイントで許容できる場合があります。アプリケーションがジョブの状態を追跡し、重複処理を防ぐ場合、ドキュメント分類キューは作業を一時停止したり、再スケジュールしたりできます。即時応答のために追加料金を支払っても、ほとんど価値がないかもしれません。
インタラクティブな製品の場合、同じエンドポイントでは不適切な購入となる可能性があります。ユーザーがリクエストが完了する前に放棄した場合、技術的には成功した生成であっても、商業的には失敗する可能性があります。タイムアウトによる再試行、放棄されたセッション、またはサポート介入を減らす場合、より高価なエンドポイントが価値のあるものとなることがあります。
代表的な同時実行数で両方のオプションを比較してください。アイドル状態のエンドポイントテストに頼るのではなく、最初のトークンまでの時間、完了レイテンシー、テールレイテンシー、および受け入れられたタスクの完了を測定してください。
ルーティングが運用上の比較を変える
当社は各リクエストを最も安価で健全な販売者にルーティングし、プロバイダーが遅くなったり利用できなくなったりした場合は、別の健全な販売者に移動します。これにより、アプリケーションが販売者固有のすべての回復パスを実装する必要性が減りますが、エンドツーエンドの動作は依然としてテストする必要があります。
プロバイダーがモデルを提供できない場合、APIは**503 no_available_provider**を返し、料金は発生しません。ビデオの場合、応答は生成が開始される前にジョブが最大でかかる費用を示します。どちらの動作も、製品内で利用できないキャパシティや遅延した結果を処理する必要性をなくすものではありません。
エンドポイントを比較する前に、これらの値を設定してください:
- 可用性目標: 機能がいつ動作する必要があるか、およびどのような劣化動作が許容されるかを定義します。
- レイテンシー目標: ユーザーが必要とする応答時間(スローテール動作を含む)を指定します。
- フェイルオーバー値: どの中断が代替キャパシティまたは別のモデルを正当化するかを決定します。
- タスクコスト上限: 受け入れられた結果に対して経済的に許容できる最大支出を設定します。
有用な調達比較では、これらの要件を一定に保ちます。そうでなければ、同じ価格列を通して異なるサービスを比較していることになります。
モデルを決定する前に予算を設定する
モデルの価格を機能レベルの予算と測定可能な受け入れテストに結びつけられるようになってから初めて、モデルを決定してください。有望なプレイグラウンドでの応答は出発点であり、ワークフロー全体が経済的であるという証拠ではありません。
評価に管理を設ける
各機能の請求単位を選択してください。 成果物がinput tokens、output tokens、images、megapixels、またはjobsのいずれを消費するかを記録してください。画像サイズや動画設定の変更が予算の見直しを促すように、要求された設定をその単位の横に保持してください。
機能レベルの予測を立ててください。 代表的なサンプルからの観測されたリクエスト量と使用量を使用してください。ユーザーが目にするpromptのみから見積もるのではなく、バックグラウンド処理やアプリケーションが指示する修復呼び出しを含む、完全な実行パスを含めてください。
リクエストに価格制限を送信してください。 該当する
max_priceまたはmax_costのコントロールを使用してください。リクエストは送信した値を超える請求はされないため、一般的なカタログ価格が保証された最大値であると仮定するよりも、強制力のある制限の方が有用です。共有残高を意図的に割り当ててください。 一つの残高でtext、image、video、musicモデルをカバーします。メディアの実験が、確立されたtextワークフローに必要な資金を不明瞭にしないように、機能レベルの支出記録を維持してください。
代替モデルを評価してください。 当社のAPIは、すべてのモデルに対して定価以下で一つのAPI keyを提供します。タスクの指示と受け入れ基準を安定させたままモデル識別子を変更し、最も洗練された回答に聞こえるものを選択するのではなく、結果として得られる成果物を比較してください。
範囲を定めた本番パイロットを実行してください。 定常的なトラフィックと困難なトラフィックの両方を捉えるレビュー期間を選択してください。アクセスを拡大したり、同時実行数を増やしたりする前に、受け入れられたタスクあたりの測定コストを予測と比較してください。
プロバイダーを切り替える前に違いを調査する
本番環境への統合前に、ダッシュボードのプレイグラウンドを使用して出力を比較し、パラメーターを調整してください。抽出の場合、スキーマの準拠と、フィールドがドキュメントによってサポートされているかどうかを検査してください。コーディングの場合、提案された変更がタスクを満たし、関連するチェックに合格するかどうかを評価してください。
測定コストが予測を超えた場合は、まずoutput length、retry behavior、context sizeを確認してください。次に、アプリケーションが完全な会話履歴を添付したり、同じドキュメントを繰り返し提供したりするなど、ワークロードを変更していないかを確認してください。請求額が高いからといって、表示されている料金が上がったと決めつけないでください。
今週、ライブ価格表を開き、支出の最大の割合を占める機能を特定し、ログに記録された使用量からその見積もりを作成してください。その予測に対して最初の測定結果をレビューする担当者を割り当ててください。
UberLLMは、text、image、video、musicモデルにアクセスするための統一されたAPIとプリペイド残高を、リクエストレベルの価格コントロールとともに提供します。UberLLM]にアクセスして、ライブモデルの価格を比較し、最も支出の多い機能の候補を選択し、決定する前に完了したタスクあたりのコストをテストしてください。