Berapa Biaya Pemodelan? Harga Inferensi AI Dijelaskan
Berapa Biaya Pemodelan di 2026? Harga AI per-token dan per-job saat ini, rumus tagihan bulanan, dan biaya tersembunyi yang mengubahnya.
Pembuatan model frontier dan penggunaan model sehari-hari memiliki perhitungan ekonomi yang sangat berbeda: analisis biaya pelatihan Epoch AI memperkirakan bahwa perangkat keras menyumbang 47%–67% dari biaya pengembangan model frontier, sementara energi hanya mewakili 2%–6%. Namun, bagi pengembang aplikasi, pertanyaan yang relevan bukanlah berapa biaya untuk membangun sebuah model. Melainkan berapa yang akan Anda bayar untuk menyelesaikan tugas yang berguna, termasuk permintaan yang memerlukan percobaan lain.
Daftar Isi
- Harga Saat Ini untuk Model Teks, Gambar, dan Video
- Cara Memperkirakan Tagihan Model Bulanan
- Faktor-faktor yang Mengubah Biaya Inferensi
- Mengapa Token yang Lebih Murah Masih Bisa Berarti Tagihan yang Lebih Tinggi
- Bagaimana Keandalan dan Infrastruktur Menggeser Biaya Nyata
- Tetapkan Anggaran Anda Sebelum Berkomitmen pada Model
Harga Saat Ini untuk Model Teks, Gambar, dan Video
Berapa biaya pemodelan? Untuk inferensi AI, jawabannya dimulai dengan unit penagihan: teks menggunakan token input dan output, gambar menggunakan gambar atau megapiksel, dan video dapat menggunakan job. Artikel ini membahas harga penggunaan untuk inferensi, bukan anggaran pelatihan. Estimasi yang dilaporkan Stanford untuk pelatihan Gemini 1.0 Ultra adalah $192 juta, menurut presentasi Voronoi tentang estimasi AI Index, tetapi pelanggan API tidak membayar biaya pengembangan tersebut secara langsung.
Tren historisnya mencolok. Stanford 2025 AI Index mengukur biaya kueri sistem yang mencapai kinerja tingkat GPT-3.5 pada MMLU turun dari sekitar $20 per juta token pada November 2022 menjadi $0.07 pada Oktober 2024. Itu adalah perbandingan khusus benchmark, bukan kutipan harga saat ini untuk setiap model yang mampu.
Harga per Unit Saat Ini berdasarkan Jenis Model
UberLLM mencantumkan harga API per model secara langsung untuk 254 model, termasuk GPT, Claude, Gemini, DeepSeek, GLM, Qwen, Llama, Mistral, dan Kimi. Harga chat memisahkan input dari output.
| Model | Unit penagihan | Harga UberLLM | Harga daftar |
|---|---|---|---|
| Claude Opus 5.5, input | Per 1M input tokens | $2.03 | $4.00 |
| Claude Opus 5.5, output | Per 1M output tokens | $10.13 | $20.00 |
| Kimi K3, input | Per 1M input tokens | $0.003 | $0.19 |
| Kimi K3, output | Per 1M output tokens | $0.23 | $15.00 |
| FLUX 2 Pro image | Per image | $0.0075 | $0.03 |
| Nano Banana 2 image | Per image | $0.015 | $0.10 |
| FLUX.2 Klein 4B image | Per megapixel | $0.00015 | $0.015 |
| Veo 3.1 Full text-to-video | Per job | $0.22 | $0.44 |
| Kling 3 Standard image-to-video | Per job | $0.063 | $0.084 |
| LTX 2.3 Fast text-to-video | Per job | $0.045 | $0.06 |
| Runway Gen-4 Turbo | Per job | $0.0675 | Tidak ada harga daftar terverifikasi yang tersedia |
Gunakan perbandingan harga API video untuk memeriksa penawaran job secara langsung sebelum memperkirakan pengeluaran media. Harga job hanya bermakna jika disertai dengan konfigurasi output yang ingin Anda minta.
Harga yang tercantum adalah apa yang sebuah permintaan biasanya butuhkan, bukan batas atas. Baca setiap baris dengan mengidentifikasi unit yang dikonsumsi fitur Anda, lalu kalikan unit tersebut dengan perkiraan penggunaan. Jangan membandingkan harga megapiksel secara langsung dengan harga per gambar tanpa memperhitungkan dimensi gambar.
Cara Memperkirakan Tagihan Model Bulanan
Buat perkiraan berdasarkan fitur produk, bukan satu alokasi token gabungan tunggal. Percakapan dukungan, ekstraksi dokumen, dan pratinjau video mengonsumsi sumber daya yang berbeda, jadi menggabungkannya terlalu dini menyembunyikan fitur mana yang membutuhkan perhatian.
Perhitungan dimulai dengan volume dan penggunaan terukur.
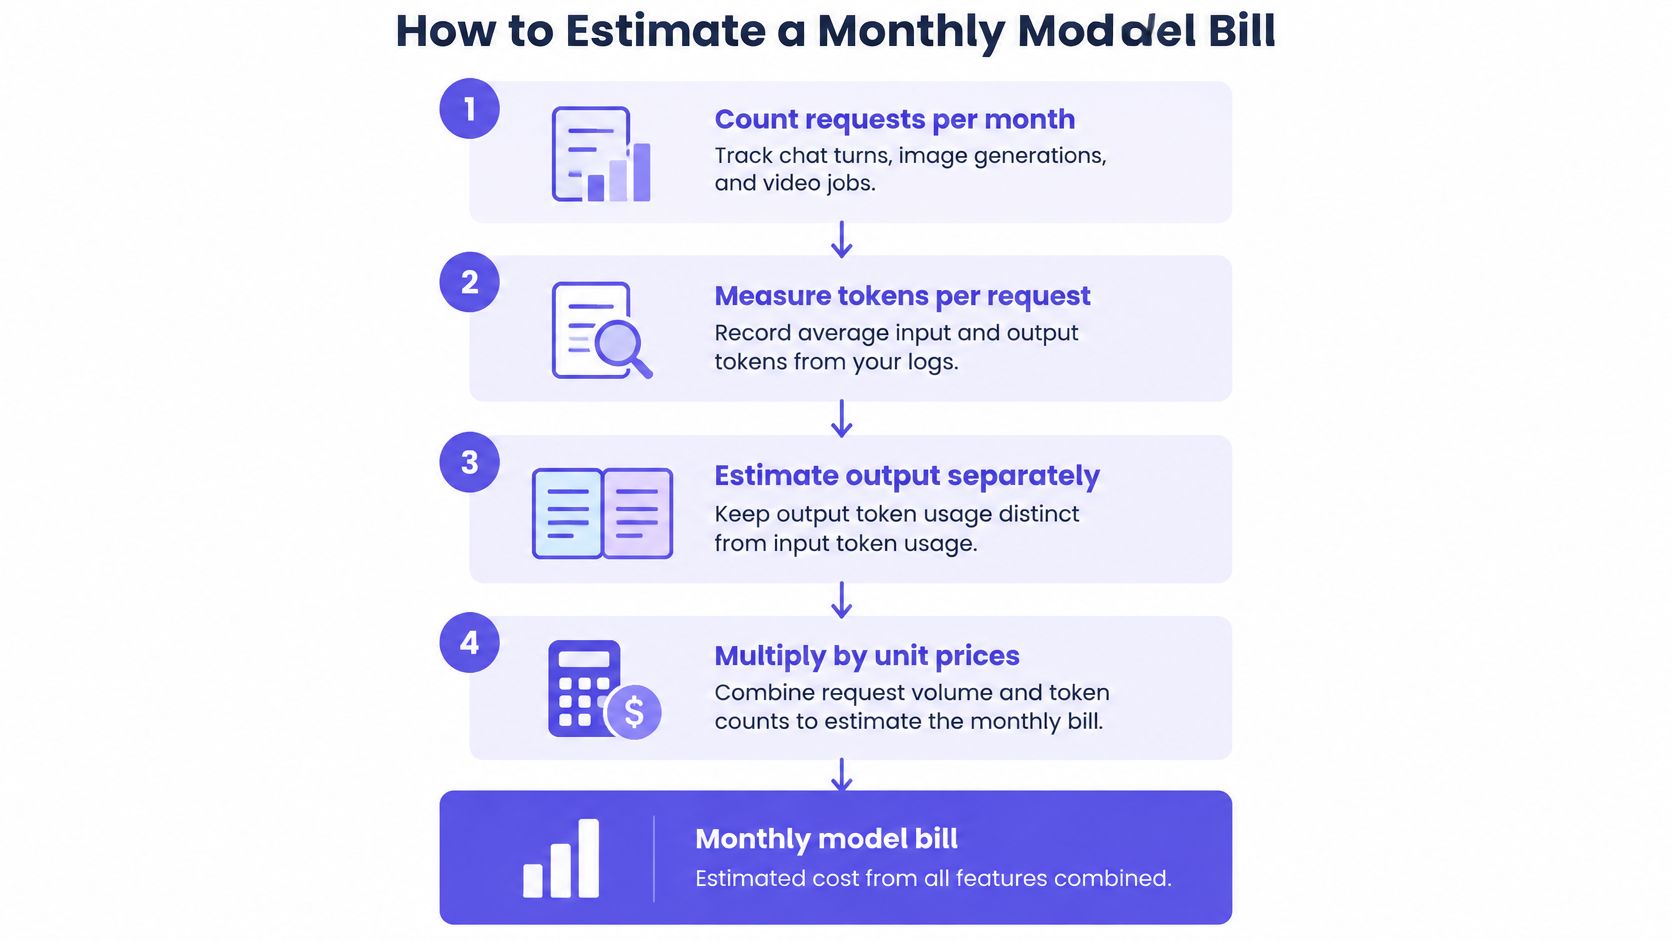
Hitung permintaan berdasarkan fitur. Catat giliran obrolan, panggilan pemrosesan dokumen, pembuatan gambar, dan pekerjaan video secara terpisah. Sertakan panggilan latar belakang, bukan hanya tindakan yang terlihat oleh pengguna.
Ukur input dan output secara independen. Ambil jumlah token aktual dari bidang penggunaan respons dan log. Sertakan instruksi sistem, riwayat percakapan, bagian yang diambil, dan hasil alat dalam pengukuran input.
Terapkan tarif model yang tepat. Kalikan token input bulanan dengan tarif input dan token output bulanan dengan tarif output, menggunakan penyebut penagihan yang ditampilkan di katalog. Catat pengidentifikasi model di samping setiap perhitungan agar perubahan model tidak membatalkan perkiraan.
Tambahkan unit media. Kalikan volume gambar, megapixel, dan pekerjaan video dengan harga yang sesuai. Pisahkan pekerjaan spesifik konfigurasi daripada merata-ratakan output yang tidak terkait.
Sertakan upaya tambahan. Bedakan percobaan ulang aplikasi, jawaban yang ditolak tetapi berhasil dibuat, dan kegagalan penyedia. Permintaan atau pembuatan kami yang gagal tidak dikenakan biaya, tetapi jawaban yang terkirim yang ditolak aplikasi Anda tetap mewakili pekerjaan yang dikonsumsi alur kerja Anda.
Perhitungkan biaya pendanaan. Kami tidak menambahkan biaya di atas harga model yang terdaftar, dan tidak ada biaya bulanan atau minimum. Penambahan saldo kartu dikenakan biaya 5.5% plus $0.50 yang diungkapkan, jadi pisahkan biaya pendanaan tersebut dari pengeluaran permintaan.
Ubah perkiraan menjadi anggaran yang dapat digunakan
Perhitungan teks dasar adalah:
Pengeluaran teks bulanan = biaya token input + biaya token output di semua upaya.
Kemudian tambahkan pengeluaran media dan layanan aplikasi pendukung lainnya. Panduan model harga AI] membantu membedakan struktur penagihan sebelum Anda menggabungkannya.
Contoh bulanan yang kami publikasikan berjumlah $113.00, dibandingkan dengan $400.00 di OpenRouter atau dengan harga resmi, selisih $287.00. Perlakukan itu sebagai beban kerja contoh, bukan prediksi untuk aplikasi dengan campuran model atau volume output yang berbeda.
Aturan penganggaran: Pertahankan total bulanan untuk setiap fitur, biaya rata-rata per permintaan, dan tunjangan terpisah untuk ketidakpastian. Total akun tunggal tidak dapat menjelaskan mengapa pengeluaran berubah.
Faktor-faktor yang Mempengaruhi Biaya Inferensi
Panggilan model mirip dengan tarif taksi: jarak saja tidak menentukan tagihan jika waktu tunggu juga penting. Untuk inferensi, volume token hanyalah bagian dari perhitungan; bentuk beban kerja dan persyaratan penyajian memengaruhi sumber daya yang dibutuhkan untuk memberikan jawaban.
Faktor biaya dan pengaruhnya terhadap tagihan
| Faktor | Dampak pada biaya | Yang harus dilakukan |
|---|---|---|
| Panjang output | Respons yang lebih panjang mengonsumsi lebih banyak output yang ditagih | Batasi output dan minta format yang ringkas |
| Tingkat model | Kemampuan yang lebih tinggi dapat memiliki harga token yang lebih tinggi | Uji model paling murah yang memenuhi standar kualitas Anda |
| Panjang konteks | Konteks pengambilan yang panjang meningkatkan lalu lintas memori dan mengurangi throughput | Kirim hanya bagian yang relevan yang diambil |
| Quantization | Presisi yang lebih rendah dapat meningkatkan throughput tetapi memengaruhi kualitas | Evaluasi presisi yang digunakan pada tugas-tugas representatif |
| Unit penagihan | Gambar, megapiksel, dan pekerjaan video mengukur output yang berbeda | Sesuaikan unit dengan hasil produk Anda |
| Tingkat latensi | Kapasitas yang cocok untuk pekerjaan interaktif dapat memiliki harga premium | Sesuaikan persyaratan penyajian dengan toleransi pengguna |
| Generasi yang gagal | Upaya tambahan menghabiskan waktu dan dapat menciptakan pekerjaan yang dapat ditagih | Pisahkan kegagalan penyedia dari penolakan tingkat aplikasi |
Sebuah studi inferensi GPU konsumen memperkirakan biaya listrik saja sebesar $0.001–$0.005 per juta token untuk beban kerja API biasa, dibandingkan $0.14–$0.22 untuk generasi yang diperkaya pengambilan dengan 32K konteks, dan melaporkan bahwa NVFP4 memberikan sekitar 1.6 kali throughput BF16 dengan 41% energi lebih sedikit dan perkiraan 2%–4% kehilangan kualitas.
Itu adalah perkiraan operasional hanya untuk listrik, bukan harga API pelanggan. Mereka tidak termasuk sisa bisnis penyajian, dan tidak dapat dibandingkan secara langsung dengan tarif input dan output yang ditagih dalam tabel harga.
Self-hosting membutuhkan perhitungannya sendiri
Sebuah benchmark inferensi LLaMA menemukan bahwa menyajikan model 65B membutuhkan sekitar 8–32 GPU, dengan konsumsi daya inferensi yang dilaporkan sekitar 300 watt hingga 1 kilowatt, tergantung pada konfigurasi sharding. Oleh karena itu, self-hosting membutuhkan perhitungan pemanfaatan, bukan hanya perkiraan listrik: sertakan perangkat keras, memori, jaringan, operasi, dan kapasitas idle.
Gunakan pelacak perubahan harga model saat meninjau alternatif. Kami memungkinkan Anda beralih model dengan mengubah ID model, tetapi kompatibilitas tidak menjamin kualitas yang setara.
Pilih model termurah yang lolos evaluasi Anda sendiri, lalu kurangi konteks dan output yang tidak perlu sebelum menegosiasikan tarif yang lebih rendah.
Mengapa Token yang Lebih Murah Masih Bisa Berarti Tagihan yang Lebih Tinggi
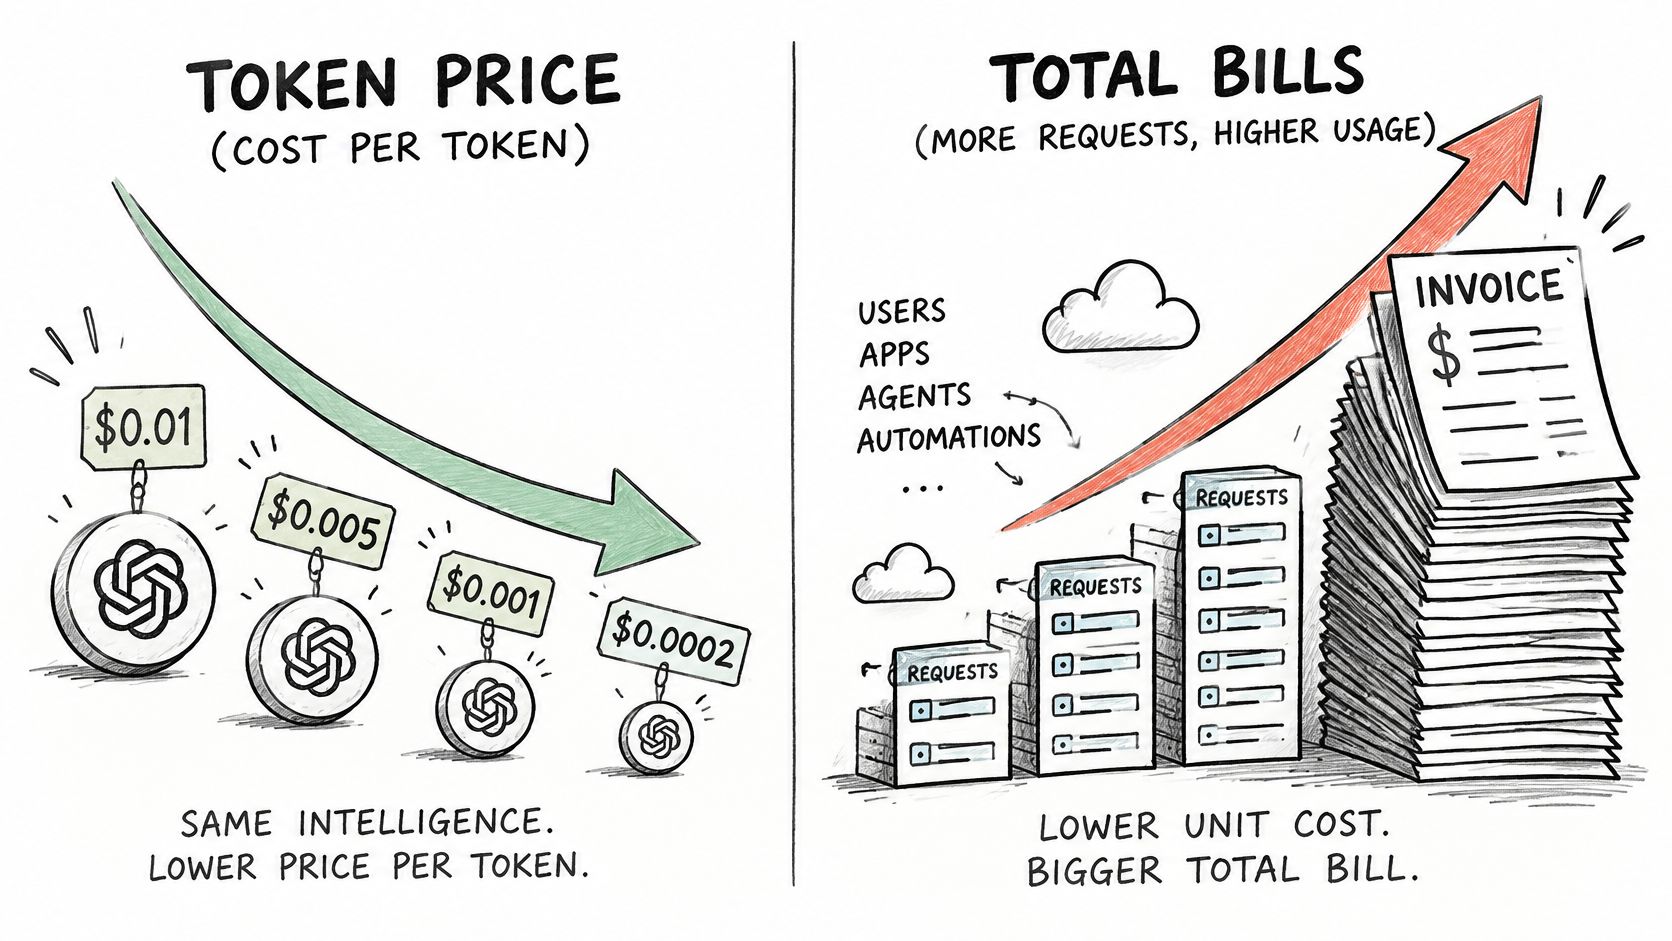
Satu perkiraan dalam analisis TCS tentang pengeluaran AI generatif berbasis hasil melaporkan bahwa biaya per-token menurun kira-kira 1,000 kali lipat selama tiga tahun sementara total pengeluaran inferensi terus meningkat, dan mencatat bahwa token output umumnya berharga tiga hingga enam kali lebih mahal daripada token input. Harga unit yang lebih rendah tidak menjamin pengeluaran aplikasi yang lebih rendah.
Perbedaan ini lebih mudah terlihat ketika harga dan penggunaan bergerak berlawanan arah.
Bandingkan pekerjaan yang selesai, bukan generasi yang terisolasi
Pertimbangkan alur kerja ekstraksi dokumen yang bersifat ilustratif. Model dengan harga lebih rendah menghasilkan penjelasan yang bertele-tele alih-alih respons terstruktur yang diperlukan, sehingga aplikasi Anda mengirimkan permintaan perbaikan. Jika respons yang diperbaiki masih gagal validasi, alur kerja akan ditingkatkan ke model yang lebih kuat.
Model alternatif berharga lebih mahal per token output tetapi segera mengembalikan hasil terstruktur yang dapat diterima. Tingkat unitnya yang lebih tinggi dapat menghasilkan biaya tugas total yang lebih rendah karena Anda menghindari prompt perbaikan, konteks dokumen yang berulang, dan generasi fallback.
Hasil itu tidak dapat dihindari. Justru itulah yang harus ditentukan oleh evaluasi yang representatif.
Biaya per tugas yang selesai = total pengeluaran alur kerja ÷ tugas yang berhasil diselesaikan.
Sertakan retrieval, tool calls, guardrails, dan eskalasi manusia ketika mereka termasuk dalam alur kerja tersebut. Definisikan keberhasilan sebelum mengukur: jawaban yang tiba belum tentu jawaban yang dapat digunakan produk Anda.
Perbedaan ini juga penting saat menafsirkan diskusi yang lebih luas tentang ekonomi AI.
Diagnosis jalur yang mahal
Lacak panjang prompt, panjang output, kegagalan validasi, dan keputusan fallback bersama dengan pengeluaran. Upaya pertama yang murah dapat tetap berharga jika menyelesaikan kasus rutin dan meningkatkan kasus sulit secara selektif. Ini menjadi sia-sia ketika hampir setiap tugas membayar untuk upaya awal dan fallback.
Jangan menghapus pemeriksaan kualitas hanya untuk meningkatkan tingkat keberhasilan yang terlihat. Itu mengubah definisi keberhasilan daripada mengurangi biaya pekerjaan yang bermanfaat.
Uji keputusan: Berapa biaya alur kerja yang diterima setelah output panjang, percobaan ulang, dan layanan pendukung, bukan hanya setelah panggilan model pertamanya?
Bagaimana Keandalan dan Infrastruktur Menggeser Biaya Sebenarnya
Harga yang tertera di awal tidak menjamin kapasitas yang sesuai akan tersedia saat aplikasi Anda membutuhkannya. Wilayah, komitmen, persyaratan latensi, dan jenis kapasitas semuanya memengaruhi perbandingan.
Pelacak harga GPU dan biaya inferensi melaporkan harga H100 mulai dari sekitar $0.34 per jam pada instans spot hingga sekitar $3.46 per jam rata-rata, bersamaan dengan perkiraan $0.50–$3 per juta output tokens untuk layanan dengan kemampuan sebanding di berbagai penyedia, tingkatan latensi, dan jendela konteks. Rentang tersebut menggambarkan kondisi pembelian yang berbeda, bukan penawaran yang dapat dipertukarkan.
Pekerjaan batch dan pekerjaan interaktif membutuhkan kapasitas yang berbeda
Untuk pemrosesan batch, sebuah endpoint yang murah mungkin dapat diterima bahkan ketika waktu penyelesaian berfluktuasi. Antrean klasifikasi dokumen dapat menjeda atau menjadwal ulang pekerjaan jika aplikasi melacak status pekerjaan dan mencegah pemrosesan duplikat. Membayar lebih untuk respons instan mungkin hanya menambah sedikit nilai.
Untuk produk interaktif, endpoint yang sama mungkin merupakan pembelian yang buruk. Jika pengguna membatalkan permintaan sebelum selesai, generasi yang secara teknis berhasil masih dapat gagal secara komersial. Endpoint yang lebih mahal dapat bermanfaat ketika mengurangi percobaan ulang terkait timeout, sesi yang ditinggalkan, atau intervensi dukungan.
Bandingkan kedua opsi di bawah konkurensi yang representatif. Ukur waktu hingga token pertama, latensi penyelesaian, latensi ekor, dan penyelesaian tugas yang diterima, daripada mengandalkan pengujian endpoint yang tidak aktif.
Routing mengubah perbandingan operasional
Kami mengarahkan setiap permintaan ke penjual sehat termurah dan memindahkannya ke penjual sehat lain ketika penyedia menjadi lambat atau tidak tersedia. Hal itu mengurangi kebutuhan aplikasi Anda untuk mengimplementasikan setiap jalur pemulihan khusus penjual, tetapi Anda tetap harus menguji perilaku end-to-end.
Jika tidak ada penyedia yang dapat melayani model, API mengembalikan 503 no_available_provider, dan tidak ada biaya yang dikenakan. Untuk video, balasan menyatakan biaya maksimum pekerjaan sebelum generasi dimulai. Kedua perilaku tersebut tidak menghilangkan kebutuhan untuk menangani kapasitas yang tidak tersedia atau hasil yang tertunda dalam produk Anda.
Tetapkan nilai-nilai ini sebelum membandingkan endpoint:
- Target Ketersediaan: Definisikan kapan suatu fitur harus berfungsi dan perilaku terdegradasi apa yang dapat diterima.
- Target Latensi: Tentukan waktu respons yang dibutuhkan pengguna, termasuk perilaku slow-tail.
- Nilai Failover: Putuskan interupsi mana yang membenarkan kapasitas alternatif atau model lain.
- Batas Biaya Tugas: Tetapkan pengeluaran maksimum yang dapat diterima secara ekonomis untuk hasil yang diterima.
Perbandingan pengadaan yang berguna menjaga persyaratan tersebut tetap konstan. Jika tidak, Anda membandingkan layanan yang berbeda melalui kolom harga yang sama.
Tetapkan Anggaran Anda Sebelum Anda Berkomitmen pada Model
Berkomitmen pada model hanya setelah Anda dapat menghubungkan harganya dengan anggaran tingkat fitur dan uji penerimaan yang terukur. Respons playground yang menjanjikan adalah titik awal, bukan bukti bahwa seluruh alur kerja itu ekonomis.
Terapkan Kontrol pada Evaluasi
Pilih unit penagihan setiap fitur. Catat apakah hasil akhir mengonsumsi input tokens, output tokens, images, megapixels, atau jobs. Simpan konfigurasi yang diminta di samping unit tersebut agar perubahan dimensi gambar atau pengaturan video memicu tinjauan anggaran.
Buat perkiraan tingkat fitur. Gunakan volume permintaan dan penggunaan yang diamati dari sampel representatif. Sertakan jalur eksekusi lengkap, termasuk background processing dan panggilan perbaikan yang diarahkan aplikasi, daripada memperkirakan hanya dari prompt yang terlihat oleh pengguna.
Kirim batas harga dengan permintaan. Gunakan kontrol
max_priceataumax_costyang berlaku. Permintaan tidak pernah ditagih di atas nilai yang Anda kirim, jadi batas yang dapat diberlakukan lebih berguna daripada mengasumsikan harga katalog tipikal adalah maksimum yang dijamin.Alokasikan saldo bersama dengan sengaja. Satu saldo mencakup model teks, gambar, video, dan musik. Pertahankan catatan pengeluaran tingkat fitur agar eksperimen media tidak mengaburkan dana yang dibutuhkan untuk alur kerja teks yang sudah mapan.
Evaluasi model alternatif. API kami menyediakan satu key untuk setiap model dengan harga daftar atau kurang. Ubah pengidentifikasi model sambil menjaga instruksi tugas dan kriteria penerimaan tetap stabil, lalu bandingkan hasil akhir yang dihasilkan daripada memilih jawaban mana pun yang terdengar paling halus.
Jalankan pilot produksi terbatas. Pilih jendela tinjauan yang menangkap lalu lintas rutin dan sulit. Bandingkan biaya terukur per tugas yang diterima dengan perkiraan Anda sebelum memperluas akses atau meningkatkan konkurensi.
Selidiki Perbedaannya Sebelum Beralih Penyedia
Gunakan dashboard playground untuk membandingkan output dan menyesuaikan parameter sebelum integrasi produksi. Untuk ekstraksi, periksa kepatuhan schema dan apakah fields didukung oleh dokumen. Untuk coding, evaluasi apakah perubahan yang diusulkan memenuhi tugas dan lolos pemeriksaan yang relevan.
Ketika biaya terukur melebihi perkiraan, periksa panjang output, perilaku percobaan ulang, dan ukuran konteks terlebih dahulu. Kemudian periksa apakah aplikasi Anda telah mengubah beban kerja, seperti melampirkan riwayat percakapan lengkap atau berulang kali menyediakan dokumen yang sama. Jangan berasumsi bahwa tagihan yang lebih tinggi berarti tarif yang terdaftar meningkat.
Buka tabel harga live minggu ini, identifikasi fitur yang bertanggung jawab atas bagian terbesar dari pengeluaran Anda, dan buat perkiraannya dari penggunaan yang dicatat. Tugaskan seseorang untuk meninjau hasil terukur pertama terhadap perkiraan tersebut.
UberLLM menawarkan API terpadu dan saldo prabayar untuk mengakses model teks, gambar, video, dan musik, dengan kontrol harga tingkat permintaan. Kunjungi UberLLM untuk membandingkan harga model live, pilih kandidat untuk fitur pengeluaran tertinggi Anda dan uji biayanya per tugas yang diselesaikan sebelum berkomitmen.