Combien coûte la modélisation ? Prix de l'inférence IA expliqués
Combien coûte la modélisation en 2026 ? Prix actuels de l'IA par token et par tâche, une formule de facture mensuelle, et les coûts cachés qui la modifient.
La création de modèles de pointe et l'utilisation quotidienne de modèles ont des économies très différentes : L'analyse des coûts de formation d'Epoch AI estime que le matériel représente 47%–67% des coûts de développement des modèles de pointe, tandis que l'énergie ne représente que 2%–6%. Cependant, pour les développeurs d'applications, la question pertinente n'est pas le coût de construction d'un modèle. C'est ce que vous paierez pour accomplir une tâche utile, y compris les requêtes qui demandent une nouvelle tentative.
Table des matières
- Prix actuels des modèles de texte, d'image et de vidéo
- Comment estimer une facture mensuelle de modèle
- Facteurs qui modifient les coûts d'inférence
- Pourquoi des tokens moins chers peuvent quand même signifier des factures plus élevées
- Comment la fiabilité et l'infrastructure modifient le coût réel
- Établissez votre budget avant de vous engager sur un modèle
Prix actuels pour les modèles de texte, d'image et de vidéo
Combien coûte la modélisation ? Pour l'inférence d'IA, la réponse commence par l'unité de facturation : le texte utilise des tokens d'entrée et de sortie, les images utilisent des images ou des mégapixels, et la vidéo peut utiliser des jobs. Cet article couvre les prix d'utilisation pour l'inférence, pas les budgets de formation. L'estimation rapportée par Stanford pour la formation de Gemini 1.0 Ultra était de $192 millions, selon la présentation de Voronoi de l'estimation de l'AI Index, mais les clients de l'API ne paient pas ce coût de développement directement.
La tendance historique est frappante. Le Stanford 2025 AI Index a mesuré que le coût d'interrogation d'un système atteignant des performances de niveau GPT-3.5 sur MMLU est passé d'environ $20 par million de tokens en novembre 2022 à $0.07 en octobre 2024. Il s'agit d'une comparaison spécifique à un benchmark, pas d'un devis actuel pour chaque modèle performant.
Prix unitaires actuels par type de modèle
UberLLM liste les prix API en direct par modèle pour 254 modèles, incluant GPT, Claude, Gemini, DeepSeek, GLM, Qwen, Llama, Mistral et Kimi. Les prix du chat séparent l'entrée de la sortie.
| Modèle | Unité de facturation | Prix UberLLM | Prix catalogue |
|---|---|---|---|
| Claude Opus 5.5, entrée | Par 1M tokens d'entrée | $2.03 | $4.00 |
| Claude Opus 5.5, sortie | Par 1M tokens de sortie | $10.13 | $20.00 |
| Kimi K3, entrée | Par 1M tokens d'entrée | $0.003 | $0.19 |
| Kimi K3, sortie | Par 1M tokens de sortie | $0.23 | $15.00 |
| FLUX 2 Pro image | Par image | $0.0075 | $0.03 |
| Nano Banana 2 image | Par image | $0.015 | $0.10 |
| FLUX.2 Klein 4B image | Par mégapixel | $0.00015 | $0.015 |
| Veo 3.1 Full text-to-video | Par job | $0.22 | $0.44 |
| Kling 3 Standard image-to-video | Par job | $0.063 | $0.084 |
| LTX 2.3 Fast text-to-video | Par job | $0.045 | $0.06 |
| Runway Gen-4 Turbo | Par job | $0.0675 | Aucun prix catalogue vérifié disponible |
Utilisez la comparaison des prix de l'API vidéo pour vérifier l'offre de jobs en direct avant d'estimer les dépenses médias. Le prix d'un job n'est significatif qu'en conjonction avec la configuration de sortie que vous avez l'intention de demander.
Le prix indiqué est ce qu'une requête coûte typiquement, pas un plafond. Lisez chaque ligne en identifiant l'unité que votre fonctionnalité consomme, puis multipliez cette unité par l'utilisation prévue. Ne comparez pas directement un prix par mégapixel avec un prix par image sans tenir compte des dimensions de l'image.
Comment estimer une facture mensuelle de modèle
Établissez l'estimation en fonction des fonctionnalités du produit, et non d'une allocation de tokens globale unique. Une conversation de support, l'extraction de documents et la prévisualisation vidéo consomment des ressources différentes, donc les combiner trop tôt masque la fonctionnalité qui nécessite une attention particulière.
Le calcul commence par le volume et l'utilisation mesurée.
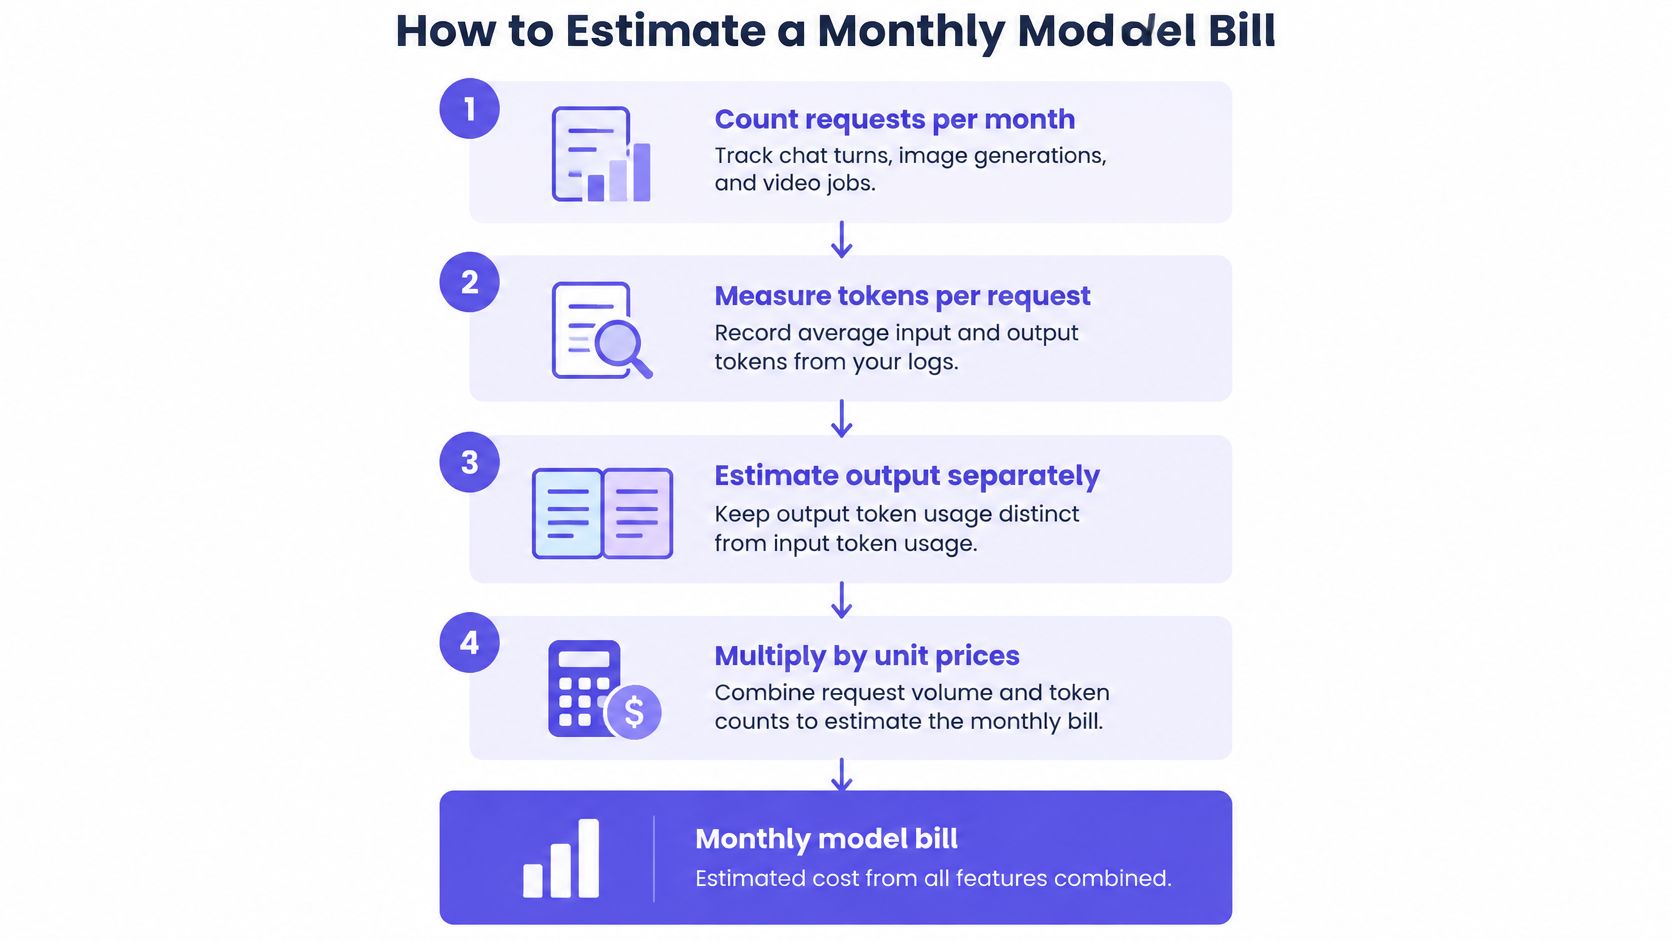
Comptez les requêtes par fonctionnalité. Enregistrez séparément les tours de chat, les appels de traitement de documents, les générations d'images et les tâches vidéo. Incluez les appels en arrière-plan, pas seulement les actions visibles par les utilisateurs.
Mesurez l'input et l'output indépendamment. Capturez les décomptes réels de tokens à partir des champs d'utilisation des réponses et des logs. Incluez les instructions système, l'historique des conversations, les passages récupérés et les résultats des outils dans la mesure de l'input.
Appliquez les tarifs exacts du modèle. Multipliez les tokens d'input mensuels par le taux d'input et les tokens d'output mensuels par le taux d'output, en utilisant le dénominateur de facturation indiqué dans le catalogue. Enregistrez l'identifiant du modèle à côté de chaque calcul afin qu'un changement de modèle n'invalide pas la prévision.
Ajoutez les unités média. Multipliez le volume d'images, de mégapixels et de tâches vidéo par leurs prix correspondants. Gardez les tâches spécifiques à la configuration séparées plutôt que de faire la moyenne d'outputs non liés.
Incluez les tentatives supplémentaires. Distinguez les retries d'application, les réponses rejetées mais générées avec succès et les échecs du fournisseur. Nos requêtes ou générations échouées ne sont pas facturées, mais une réponse livrée que votre application rejette représente toujours un travail consommé par votre workflow.
Tenez compte des coûts de financement. Nous n'ajoutons aucun frais en plus des prix des modèles listés, et il n'y a pas de frais mensuels ni de minimum. Les ajouts de solde de carte entraînent des frais divulgués de 5.5% plus $0.50, alors gardez ces frais de financement séparés des dépenses de requêtes.
Transformez l'estimation en un budget utilisable
Le calcul de texte de base est :
Dépenses mensuelles de texte = frais de tokens d'input + frais de tokens d'output pour toutes les tentatives.
Ajoutez ensuite les dépenses média et tous les services d'application de support. Le guide des modèles de tarification de l'IA aide à distinguer les structures de facturation avant de les combiner.
Notre exemple mensuel publié totalise $113.00, comparé à $400.00 sur OpenRouter ou aux prix officiels, soit une différence de $287.00. Considérez cela comme une charge de travail exemple, et non comme une prédiction pour une application avec un mix de modèles ou un volume d'output différent.
Règle budgétaire : Conservez un total mensuel pour chaque fonctionnalité, un coût moyen par requête et une allocation distincte pour l'incertitude. Un total de compte unique ne peut pas expliquer pourquoi les dépenses ont changé.
Facteurs qui modifient le coût de l'inférence
Un appel de modèle ressemble à une course de taxi : la distance seule ne détermine pas la facture si le temps d'attente compte aussi. Pour l'inférence, le volume de tokens n'est qu'une partie du calcul ; la forme de la charge de travail et les exigences de service affectent les ressources nécessaires pour fournir la réponse.
Facteurs de coût et leur impact sur la facture
| Facteur | Effet sur le coût | Que faire |
|---|---|---|
| Longueur de la sortie | Les réponses plus longues consomment plus de sortie facturée | Limitez la sortie et demandez des formats concis |
| Niveau du modèle | Une capacité supérieure peut entraîner un prix de token plus élevé | Testez le modèle le moins cher qui répond à vos exigences de qualité |
| Longueur du contexte | Les contextes de récupération longs augmentent le trafic mémoire et réduisent le débit | N'envoyez que les passages récupérés pertinents |
| Quantification | Une précision inférieure peut améliorer le débit mais affecter la qualité | Évaluez la précision déployée sur des tâches représentatives |
| Unité de facturation | Les images, les mégapixels et les tâches vidéo mesurent des sorties différentes | Adaptez l'unité au livrable de votre produit |
| Niveau de latence | La capacité adaptée au travail interactif peut entraîner un coût supplémentaire | Adaptez les exigences de service à la tolérance de l'utilisateur |
| Générations échouées | Les tentatives supplémentaires consomment du temps et peuvent générer du travail facturable | Séparez les échecs du fournisseur des rejets au niveau de l'application |
Une étude sur l'inférence avec GPU grand public a estimé les coûts d'électricité seule à $0.001–$0.005 par million de tokens pour les charges de travail API ordinaires, contre $0.14–$0.22 pour la génération augmentée par récupération avec un contexte de 32K, et a rapporté que NVFP4 a fourni environ 1.6 fois le débit de BF16 avec 41% moins d'énergie et une perte de qualité estimée de 2%–4%.
Ce sont des estimations de coûts d'exploitation basées uniquement sur l'électricité, et non des prix API client. Elles excluent le reste de l'activité de service, et ne sont pas directement comparables avec les tarifs d'entrée et de sortie facturés dans le tableau des prix.
L'auto-hébergement nécessite son propre calcul
Un benchmark d'inférence LLaMA a révélé que le service d'un modèle 65B nécessitait environ 8–32 GPU, avec une consommation d'énergie d'inférence rapportée d'environ 300 watts à 1 kilowatt, selon la configuration de sharding. L'auto-hébergement nécessite donc un calcul d'utilisation, et pas seulement une estimation d'électricité : incluez le matériel, la mémoire, le réseau, les opérations et la capacité inactive.
Utilisez le suivi des changements de prix des modèles lors de l'examen des alternatives. Nous vous permettons de changer de modèle en modifiant l'ID du modèle, mais la compatibilité n'établit pas une qualité équivalente.
Choisissez le modèle le moins cher qui passe votre propre évaluation, puis réduisez le contexte et la sortie inutiles avant de négocier un tarif inférieur.
Pourquoi des tokens moins chers peuvent quand même signifier des factures plus élevées
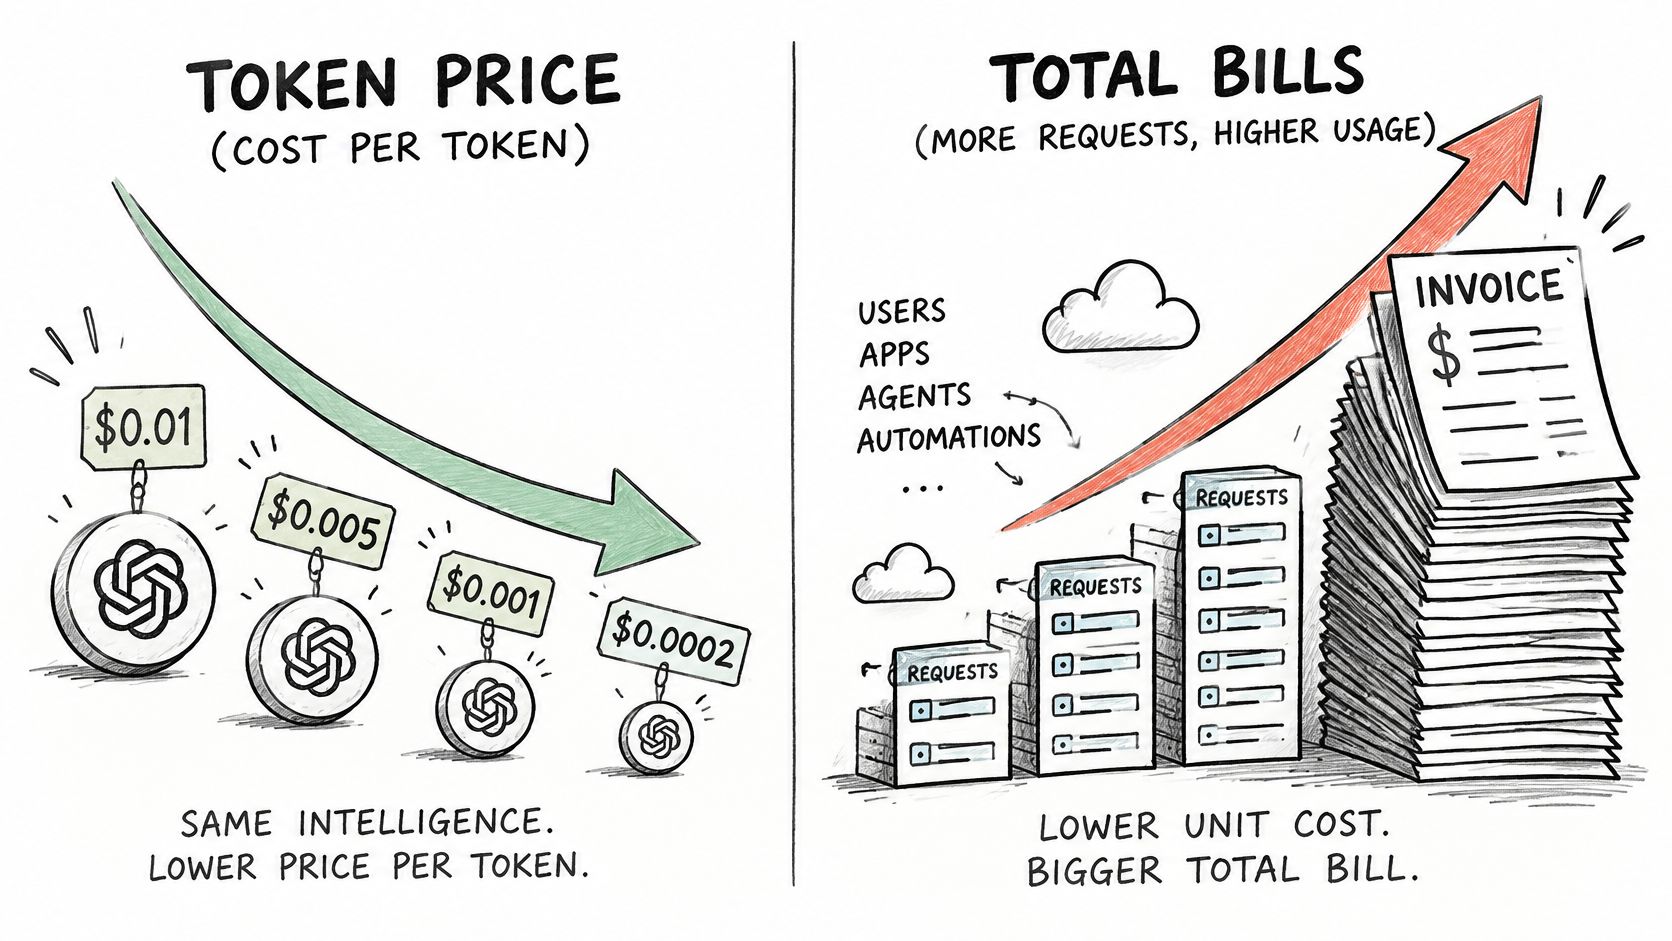
Une estimation dans l'analyse de TCS sur les dépenses d'IA générative basées sur les résultats rapporte que les coûts par token ont diminué d'environ 1,000 fois en trois ans tandis que les dépenses totales d'inférence ont continué d'augmenter, et note que les tokens de sortie coûtent généralement trois à six fois plus cher que les tokens d'entrée. Des prix unitaires plus bas ne garantissent pas des dépenses d'application plus faibles.
La distinction est plus facile à voir lorsque le prix et l'utilisation évoluent dans des directions opposées.
Comparez le travail accompli, pas les générations isolées
Considérez un flux de travail illustratif d'extraction de documents. Le modèle moins cher produit une explication verbeuse au lieu de la réponse structurée requise, de sorte que votre application soumet une demande de réparation. Si la réponse réparée échoue toujours à la validation, le flux de travail passe à un modèle plus puissant.
Le modèle alternatif coûte plus cher par token de sortie mais renvoie un résultat structuré acceptable immédiatement. Son taux unitaire plus élevé peut produire un coût total de tâche inférieur car vous évitez l'invite de réparation, le contexte de document répété et la génération de secours.
Ce résultat n'est pas inévitable. C'est précisément ce qu'une évaluation représentative devrait déterminer.
Coût par tâche accomplie = dépenses totales du flux de travail ÷ tâches accomplies avec succès.
Incluez la récupération, les appels d'outils, les garde-fous et l'escalade humaine lorsqu'ils appartiennent à ce flux de travail. Définissez le succès avant de mesurer : une réponse qui est arrivée n'est pas nécessairement une réponse que votre produit peut utiliser.
Cette distinction est également importante lors de l'interprétation des discussions plus larges sur l'économie de l'IA.
Diagnostiquez le chemin coûteux
Suivez la longueur de l'invite, la longueur de la sortie, les échecs de validation et les décisions de secours en parallèle des dépenses. Une première tentative bon marché peut rester rentable si elle résout les cas de routine et escalade sélectivement les cas difficiles. Elle devient un gaspillage lorsque presque chaque tâche paie à la fois pour la tentative initiale et pour le secours.
Ne supprimez pas les contrôles de qualité juste pour améliorer le taux de succès apparent. Cela modifie la définition du succès plutôt que de réduire le coût du travail utile.
Test de décision : Combien coûtera un flux de travail accepté après de longues sorties, des tentatives répétées et des services de support, et pas seulement après son premier appel de modèle ?
Comment la fiabilité et l'infrastructure modifient le coût réel
Un prix affiché ne garantit pas que la capacité appropriée sera disponible lorsque votre application en aura besoin. La région, l'engagement, les exigences de latence et le type de capacité affectent tous la comparaison.
Un outil de suivi des prix des GPU et des coûts d'inférence a rapporté des prix H100 allant d'environ $0.34 par heure sur les instances spot à environ $3.46 par heure en moyenne, ainsi qu'une estimation de $0.50–$3 par million de tokens de sortie pour un service de capacité comparable chez différents fournisseurs, niveaux de latence et fenêtres de contexte. Ces fourchettes décrivent des conditions d'achat différentes, et non des offres interchangeables.
Le travail par lots et le travail interactif nécessitent des capacités différentes
Pour le traitement par lots, un endpoint peu coûteux peut être acceptable même lorsque les temps d'achèvement fluctuent. Une file d'attente de classification de documents peut mettre en pause ou reprogrammer le travail si l'application suit l'état des tâches et empêche le traitement en double. Payer un supplément pour des réponses immédiates peut ajouter peu de valeur.
Pour les produits interactifs, le même endpoint peut être un mauvais achat. Si les utilisateurs abandonnent une requête avant qu'elle ne se termine, une génération techniquement réussie peut toujours échouer commercialement. Un endpoint plus coûteux peut être intéressant lorsqu'il réduit les tentatives liées aux timeouts, les sessions abandonnées ou les interventions du support.
Comparez les deux options sous une concurrence représentative. Mesurez le temps jusqu'au premier token, la latence d'achèvement, la latence de queue et l'achèvement des tâches acceptées, plutôt que de vous fier à un test d'endpoint inactif.
Le routage modifie la comparaison opérationnelle
Nous acheminons chaque requête vers le vendeur sain le moins cher et la déplaçons vers un autre vendeur sain lorsqu'un fournisseur devient lent ou indisponible. Cela réduit la nécessité pour votre application d'implémenter chaque chemin de récupération spécifique au vendeur, mais vous devriez toujours tester le comportement de bout en bout.
Si aucun fournisseur ne peut servir un modèle, l'API renvoie 503 no_available_provider, et rien n'est facturé. Pour la vidéo, la réponse indique le coût maximal du travail avant le début de la génération. Aucun de ces comportements n'élimine la nécessité de gérer la capacité indisponible ou les résultats retardés dans votre produit.
Définissez ces valeurs avant de comparer les endpoints :
- Objectif de disponibilité : Définissez quand une fonctionnalité doit fonctionner et quel comportement dégradé est acceptable.
- Objectif de latence : Spécifiez le temps de réponse dont les utilisateurs ont besoin, y compris le comportement de queue lente.
- Valeur de basculement : Décidez quelles interruptions justifient une capacité alternative ou un autre modèle.
- Plafond de coût de tâche : Fixez la dépense maximale économiquement acceptable pour un résultat accepté.
Une comparaison d'approvisionnement utile maintient ces exigences constantes. Sinon, vous comparez des services différents à travers la même colonne de prix.
Définissez Votre Budget Avant de Vous Engager sur un Modèle
Ne vous engagez sur un modèle qu'après avoir pu relier son prix à un budget au niveau des fonctionnalités et à un test d'acceptation mesurable. Une réponse prometteuse dans le playground est un point de départ, pas une preuve que l'ensemble du workflow est économique.
Mettez en place des contrôles autour de l'évaluation
Choisissez l'unité de facturation de chaque fonctionnalité. Enregistrez si le livrable consomme des input tokens, des output tokens, des images, des mégapixels ou des jobs. Conservez la configuration demandée à côté de cette unité afin qu'un changement de dimensions d'image ou de paramètres vidéo déclenche une révision du budget.
Établissez une prévision au niveau des fonctionnalités. Utilisez le volume de requêtes observé et l'utilisation d'un échantillon représentatif. Incluez le chemin d'exécution complet, y compris le traitement en arrière-plan et les appels de réparation dirigés par l'application, plutôt que d'estimer à partir de la seule invite visible de l'utilisateur.
Envoyez une limite de prix avec les requêtes. Utilisez le contrôle
max_priceoumax_costapplicable. Une requête n'est jamais facturée au-delà de la valeur que vous envoyez, donc une limite exécutoire est plus utile que de supposer que le prix catalogue typique est un maximum garanti.Allouez le solde partagé délibérément. Un seul solde couvre les modèles de texte, d'image, de vidéo et de musique. Maintenez des registres de dépenses au niveau des fonctionnalités afin qu'une expérience média n'occulte pas les fonds nécessaires à un workflow de texte établi.
Évaluez un modèle alternatif. Notre API fournit une key unique pour chaque modèle au prix catalogue ou moins. Modifiez l'identifiant du modèle tout en maintenant les instructions de la tâche et les critères d'acceptation stables, puis comparez les livrables résultants plutôt que de sélectionner la réponse qui semble la plus soignée.
Exécutez un pilote de production borné. Choisissez une fenêtre de révision qui capture le trafic routinier et difficile. Comparez le coût mesuré par tâche acceptée avec votre prévision avant d'étendre l'accès ou d'augmenter la concurrence.
Enquêtez sur la différence avant de changer de fournisseur
Utilisez le playground du tableau de bord pour comparer les outputs et ajuster les paramètres avant l'intégration en production. Pour l'extraction, inspectez la conformité au schéma et si les champs sont pris en charge par le document. Pour le coding, évaluez si le changement proposé satisfait la tâche et passe les vérifications pertinentes.
Lorsque le coût mesuré dépasse la prévision, vérifiez d'abord la longueur de l'output, le comportement de retry et la taille du context. Ensuite, vérifiez si votre application a modifié la charge de travail, par exemple en joignant des historiques de conversation complets ou en fournissant à plusieurs reprises les mêmes documents. Ne supposez pas qu'une facture plus élevée signifie que le tarif affiché a augmenté.
Ouvrez le tableau des prix en direct cette semaine, identifiez la fonctionnalité responsable de la plus grande part de vos dépenses et établissez son estimation à partir de l'utilisation enregistrée. Désignez quelqu'un pour examiner les premiers résultats mesurés par rapport à cette prévision.
UberLLM offre une API unifiée et un solde prépayé pour accéder aux modèles de texte, d'image, de vidéo et de musique, avec des contrôles de prix au niveau des requêtes. Visitez UberLLM pour comparer les prix des modèles en direct, choisir un candidat pour votre fonctionnalité la plus coûteuse et tester son coût par tâche accomplie avant de vous engager.