¿Cuánto Cuesta el Modelado? Precios de Inferencia de IA Explicados
¿Cuánto Cuesta el Modelado en 2026? Precios actuales de IA por token y por trabajo, una fórmula de factura mensual y los costos ocultos que la modifican.
La creación de modelos frontera y el uso diario de modelos tienen economías muy diferentes: El análisis de costos de entrenamiento de Epoch AI estima que el hardware representa entre 47%–67% de los costos de desarrollo de modelos frontera, mientras que la energía representa solo entre 2%–6%. Sin embargo, para los desarrolladores de aplicaciones, la pregunta relevante no es cuánto costó construir un modelo. Es lo que pagarás para completar una tarea útil, incluyendo las solicitudes que necesiten otro intento.
Tabla de Contenidos
- Precios Actuales para Modelos de Texto, Imagen y Video
- Cómo Estimar una Factura Mensual de Modelo
- Factores que Cambian los Costos de Inferencia
- Por Qué Tokens Más Baratos Aún Pueden Significan Facturas Más Altas
- Cómo la Fiabilidad y la Infraestructura Cambian el Costo Real
- Establece Tu Presupuesto Antes de Comprometerte con un Modelo
Precios Actuales para Modelos de Texto, Imagen y Video
¿Cuánto cuesta el modelado? Para la inferencia de IA, la respuesta comienza con la unidad de facturación: el texto usa tokens de entrada y salida, las imágenes usan imágenes o megapíxeles, y el video puede usar jobs. Este artículo cubre los precios de uso para inferencia, no los presupuestos de entrenamiento. La estimación reportada por Stanford para el entrenamiento de Gemini 1.0 Ultra fue de $192 millones, según la presentación de Voronoi de la estimación del Índice de IA, pero los clientes de la API no pagan ese costo de desarrollo directamente.
La tendencia histórica es sorprendente. El Índice de IA de Stanford 2025 midió que el costo de consultar un sistema que lograba un rendimiento a nivel de GPT-3.5 en MMLU cayó de aproximadamente $20 por millón de tokens en noviembre de 2022 a $0.07 en octubre de 2024. Esa es una comparación específica de un benchmark, no una cotización actual para cada modelo capaz.
Precios actuales por unidad según el tipo de modelo
UberLLM lista precios de API en vivo por modelo para 254 modelos, incluyendo GPT, Claude, Gemini, DeepSeek, GLM, Qwen, Llama, Mistral y Kimi. Los precios de chat separan la entrada de la salida.
| Modelo | Unidad de facturación | Precio UberLLM | Precio de lista |
|---|---|---|---|
| Claude Opus 5.5, entrada | Por 1M tokens de entrada | $2.03 | $4.00 |
| Claude Opus 5.5, salida | Por 1M tokens de salida | $10.13 | $20.00 |
| Kimi K3, entrada | Por 1M tokens de entrada | $0.003 | $0.19 |
| Kimi K3, salida | Por 1M tokens de salida | $0.23 | $15.00 |
| FLUX 2 Pro imagen | Por imagen | $0.0075 | $0.03 |
| Nano Banana 2 imagen | Por imagen | $0.015 | $0.10 |
| FLUX.2 Klein 4B imagen | Por megapíxel | $0.00015 | $0.015 |
| Veo 3.1 Full texto a video | Por job | $0.22 | $0.44 |
| Kling 3 Standard imagen a video | Por job | $0.063 | $0.084 |
| LTX 2.3 Fast texto a video | Por job | $0.045 | $0.06 |
| Runway Gen-4 Turbo | Por job | $0.0675 | No hay precio de lista verificado disponible |
Usa la comparación de precios de API de video para verificar la oferta de jobs en vivo antes de estimar el gasto en medios. El precio de un job solo tiene sentido junto con la configuración de salida que pretendes solicitar.
El precio listado es lo que una solicitud típicamente cuesta, no un techo. Lee cada fila identificando la unidad que tu característica consume, luego multiplica esa unidad por el uso esperado. No compares un precio por megapíxel directamente con un precio por imagen sin tener en cuenta las dimensiones de la imagen.
Cómo Estimar una Factura Mensual de Modelos
Construye la estimación en torno a las características del producto, no a una única asignación combinada de tokens. Una conversación de soporte, la extracción de documentos y la previsualización de vídeo consumen recursos diferentes, por lo que combinarlos demasiado pronto oculta qué característica necesita atención.
El cálculo comienza con el volumen y el uso medido.
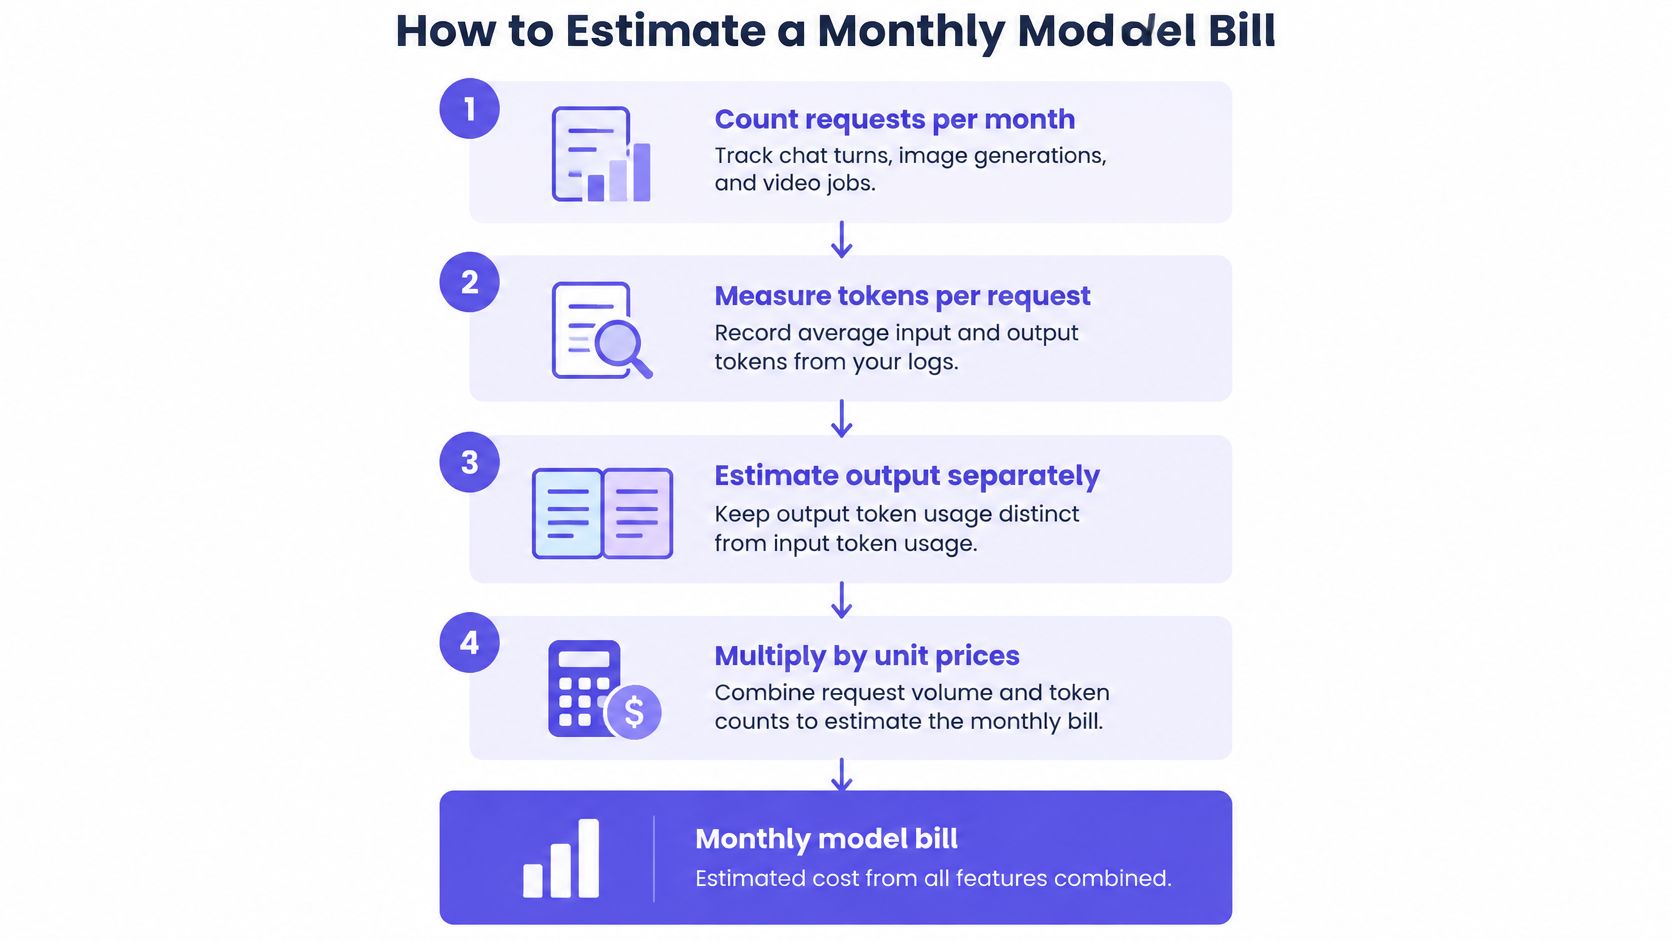
Cuenta las solicitudes por característica. Registra por separado los turnos de chat, las llamadas de procesamiento de documentos, las generaciones de imágenes y los trabajos de vídeo. Incluye las llamadas en segundo plano, no solo las acciones visibles para los usuarios.
Mide el input y el output de forma independiente. Captura los recuentos reales de token de los campos de uso de respuesta y los logs. Incluye las instrucciones del sistema, el historial de conversación, los pasajes recuperados y los resultados de las herramientas en la medición del input.
Aplica las tarifas exactas del modelo. Multiplica los tokens de input mensuales por la tarifa de input y los tokens de output mensuales por la tarifa de output, utilizando el denominador de facturación que se muestra en el catálogo. Registra el identificador del modelo junto a cada cálculo para que un cambio de modelo no invalide la previsión.
Añade unidades de medios. Multiplica el volumen de imágenes, megapíxeles y trabajos de vídeo por sus precios correspondientes. Mantén los trabajos específicos de configuración separados en lugar de promediar outputs no relacionados.
Incluye intentos adicionales. Distingue los reintentos de la aplicación, las respuestas rechazadas pero generadas con éxito y los fallos del proveedor. Nuestras solicitudes o generaciones fallidas no se cobran, pero una respuesta entregada que tu aplicación rechaza sigue representando trabajo que tu flujo de trabajo consumió.
Ten en cuenta los costes de financiación. No añadimos ninguna comisión sobre los precios de los modelos listados, y no hay cuota mensual ni mínimo. Las adiciones de saldo de tarjeta conllevan una comisión divulgada de 5.5% más $0.50, así que mantén ese cargo de financiación separado del gasto en solicitudes.
Convierte la estimación en un presupuesto utilizable
El cálculo básico de texto es:
Gasto mensual de texto = cargos por tokens de input + cargos por tokens de output en todos los intentos.
Luego añade el gasto en medios y cualquier servicio de aplicación de soporte. La guía de modelos de precios de IA ayuda a distinguir las estructuras de facturación antes de combinarlas.
Nuestro ejemplo mensual publicado asciende a un total de $113.00, en comparación con $400.00 en OpenRouter o a precios oficiales, una diferencia de $287.00. Trata esto como una carga de trabajo de ejemplo, no como una predicción para una aplicación con una mezcla de modelos o volumen de output diferente.
Regla de presupuestación: Mantén un total mensual para cada característica, un coste promedio por solicitud y una asignación separada para la incertidumbre. Un único total de cuenta no puede explicar por qué cambió el gasto.
Factores que cambian el costo de la inferencia
Una llamada a un modelo se parece a una tarifa de taxi: la distancia por sí sola no determina la factura si el tiempo de espera también importa. Para la inferencia, el volumen de tokens es solo una parte del cálculo; la forma de la carga de trabajo y los requisitos de servicio afectan los recursos necesarios para entregar la respuesta.
Factores de costo y cómo cada uno afecta la factura
| Factor | Efecto en el costo | Qué hacer |
|---|---|---|
| Longitud de la salida | Las respuestas más largas consumen más salida facturada | Limita la salida y solicita formatos concisos |
| Nivel del modelo | Mayor capacidad puede implicar un precio de token más alto | Prueba el modelo menos costoso que cumpla con tu estándar de calidad |
| Longitud del contexto | Los contextos de recuperación largos aumentan el tráfico de memoria y reducen el rendimiento | Envía solo pasajes recuperados relevantes |
| Cuantificación | Menor precisión puede mejorar el rendimiento pero afectar la calidad | Evalúa la precisión implementada en tareas representativas |
| Unidad de facturación | Las imágenes, los megapíxeles y los trabajos de video miden diferentes salidas | Haz coincidir la unidad con el entregable de tu producto |
| Nivel de latencia | La capacidad adecuada para el trabajo interactivo puede tener un costo adicional | Haz coincidir los requisitos de servicio con la tolerancia del usuario |
| Generaciones fallidas | Los intentos adicionales consumen tiempo y pueden generar trabajo facturable | Separa las fallas del proveedor de los rechazos a nivel de aplicación |
Un estudio de inferencia con GPU de consumidor estimó costos solo de electricidad de $0.001–$0.005 por millón de tokens para cargas de trabajo API ordinarias, frente a $0.14–$0.22 para generación aumentada por recuperación con 32K de contexto, e informó que NVFP4 entregó aproximadamente 1.6 veces el rendimiento de BF16 con 41% menos energía y una pérdida de calidad estimada de 2%–4%.
Esas son estimaciones operativas solo de electricidad, no precios de API para clientes. Excluyen el resto del negocio de servicio y no son directamente comparables con las tarifas de entrada y salida facturadas en la tabla de precios.
El autoalojamiento necesita su propio cálculo
Un benchmark de inferencia de LLaMA encontró que servir un modelo 65B requería aproximadamente 8–32 GPU, con un consumo de energía de inferencia reportado de aproximadamente 300 vatios a 1 kilovatios, dependiendo de la configuración de sharding. Por lo tanto, el autoalojamiento necesita un cálculo de utilización, no solo una estimación de electricidad: incluye hardware, memoria, redes, operaciones y capacidad inactiva.
Usa el rastreador de cambios de precios de modelos al revisar alternativas. Te permitimos cambiar de modelo modificando el ID del modelo, pero la compatibilidad no establece una calidad equivalente.
Elige el modelo más barato que pase tu propia evaluación, luego reduce el contexto y la salida innecesarios antes de negociar una tarifa más baja.
¿Por qué los tokens más baratos aún pueden significar facturas más altas?
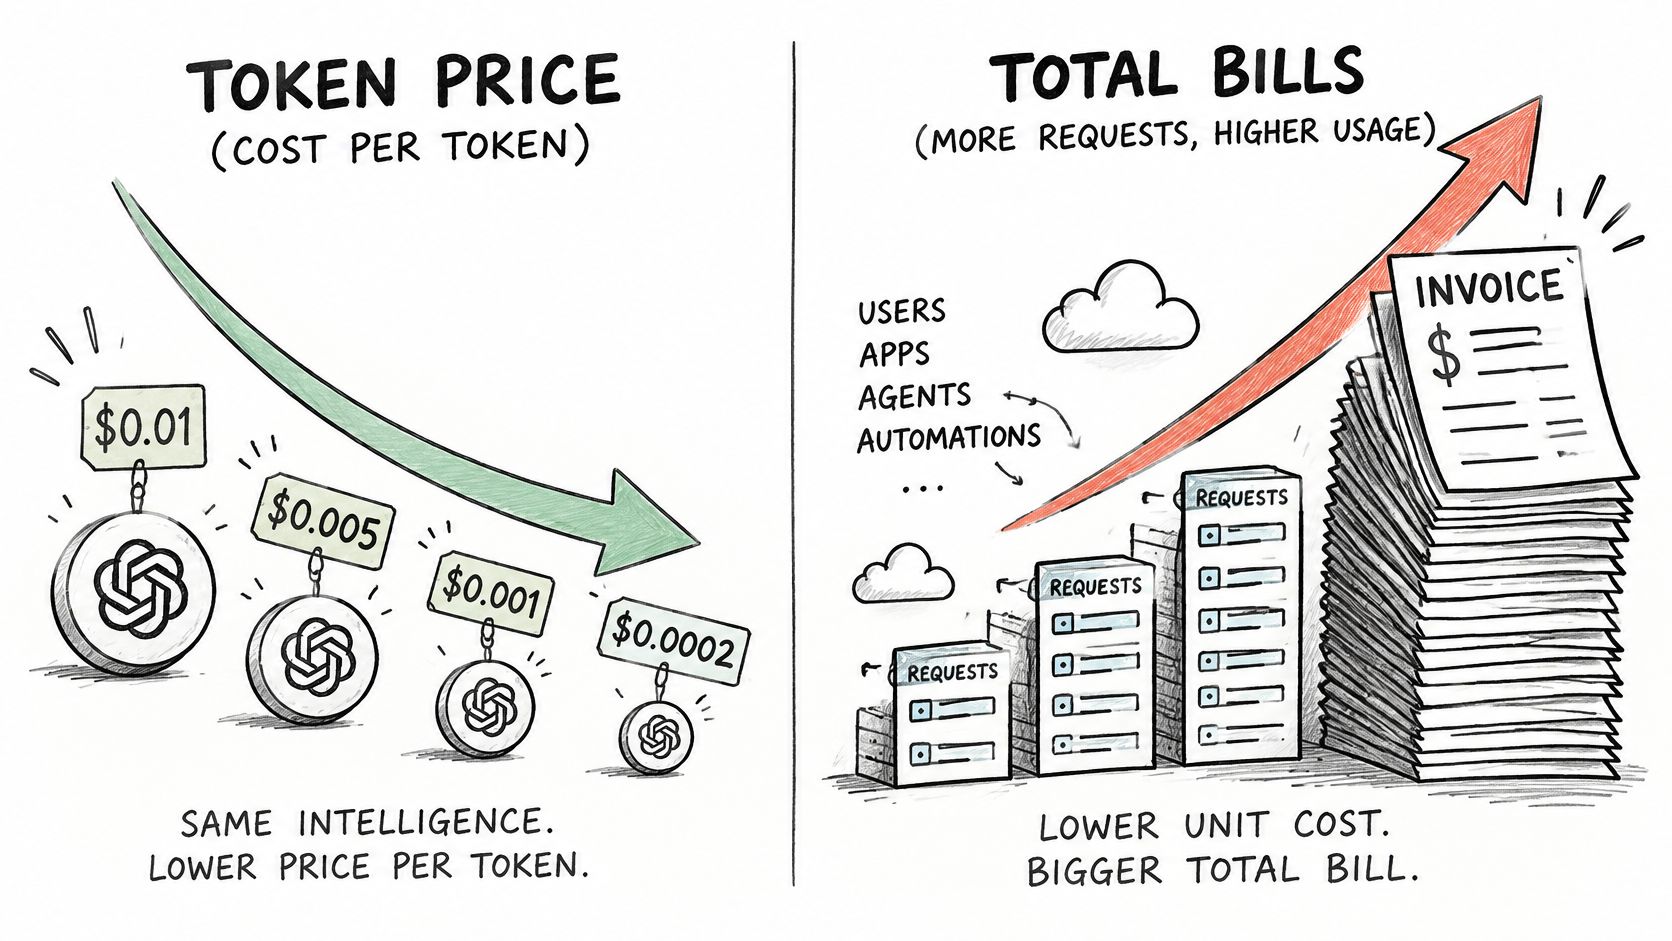
Una estimación en el análisis de TCS sobre el gasto en IA generativa basada en resultados informa que los costos por token disminuyeron aproximadamente 1,000 veces en tres años mientras que el gasto total en inferencia siguió aumentando, y señala que los tokens de salida suelen costar entre tres y seis veces más que los tokens de entrada. Precios unitarios más bajos no garantizan un menor gasto en la aplicación.
La distinción es más fácil de ver cuando el precio y el uso se mueven en direcciones opuestas.
Compara el trabajo completado, no las generaciones aisladas
Considera un flujo de trabajo ilustrativo de extracción de documentos. El modelo de menor precio produce una explicación prolija en lugar de la respuesta estructurada requerida, por lo que tu aplicación envía una solicitud de reparación. Si la respuesta reparada aún falla la validación, el flujo de trabajo escala a un modelo más potente.
El modelo alternativo cuesta más por token de salida, pero devuelve un resultado estructurado aceptable de inmediato. Su tarifa unitaria más alta puede producir un costo total de tarea más bajo porque evitas el prompt de reparación, el contexto repetido del documento y la generación de fallback.
Ese resultado no es inevitable. Es precisamente lo que una evaluación representativa debería determinar.
Costo por tarea completada = gasto total del flujo de trabajo ÷ tareas completadas con éxito.
Incluye retrieval, tool calls, guardrails y la escalada humana cuando pertenezcan a ese flujo de trabajo. Define el éxito antes de medir: una respuesta que llegó no es necesariamente una respuesta que tu producto pueda usar.
Esta distinción también importa al interpretar discusiones más amplias sobre la economía de la IA.
Diagnostica la ruta costosa
Rastrea la longitud del prompt, la longitud de la salida, los fallos de validación y las decisiones de fallback junto con el gasto. Un primer intento barato puede seguir siendo valioso si resuelve casos rutinarios y escala los difíciles de forma selectiva. Se vuelve un desperdicio cuando casi cada tarea paga tanto por el intento inicial como por el fallback.
No elimines los controles de calidad solo para mejorar la tasa de éxito aparente. Eso cambia la definición de éxito en lugar de reducir el costo del trabajo útil.
Prueba de decisión: ¿Cuánto costará un flujo de trabajo aceptado después de salidas largas, reintentos y servicios de soporte, no solo después de su primera llamada al modelo?
Cómo la fiabilidad y la infraestructura modifican el costo real
Un precio de lista no garantiza que la capacidad adecuada esté disponible cuando su aplicación la necesite. La región, el compromiso, los requisitos de latencia y el tipo de capacidad afectan la comparación.
Un rastreador de precios de GPU y costos de inferencia informó precios H100 desde aproximadamente $0.34 por hora en instancias spot hasta aproximadamente $3.46 por hora en promedio, junto con una estimación de $0.50–$3 por millón de tokens de salida para un servicio de capacidad comparable entre proveedores, niveles de latencia y ventanas de contexto. Esos rangos describen diferentes condiciones de compra, no ofertas intercambiables.
El trabajo por lotes y el trabajo interactivo necesitan diferente capacidad
Para el procesamiento por lotes, un endpoint económico puede ser aceptable incluso cuando los tiempos de finalización fluctúan. Una cola de clasificación de documentos puede pausar o reprogramar el trabajo si la aplicación rastrea el estado del trabajo y evita el procesamiento duplicado. Pagar extra por respuestas inmediatas puede añadir poco valor.
Para productos interactivos, el mismo endpoint puede ser una mala compra. Si los usuarios abandonan una solicitud antes de que finalice, una generación técnicamente exitosa aún puede fallar comercialmente. Un endpoint más caro puede valer la pena cuando reduce los reintentos relacionados con el tiempo de espera, las sesiones abandonadas o las intervenciones de soporte.
Compare ambas opciones bajo una concurrencia representativa. Mida el tiempo hasta el primer token, la latencia de finalización, la latencia de cola y la finalización de tareas aceptadas, en lugar de depender de una prueba de endpoint inactivo.
El enrutamiento cambia la comparación operativa
Enrutamos cada solicitud al vendedor saludable más económico y la movemos a otro vendedor saludable cuando un proveedor se vuelve lento o no está disponible. Esto reduce la necesidad de que su aplicación implemente cada ruta de recuperación específica del vendedor, pero aún así debe probar el comportamiento de extremo a extremo.
Si ningún proveedor puede servir un modelo, la API devuelve 503 no_available_provider, y no se cobra nada. Para video, la respuesta indica el costo máximo que puede tener el trabajo antes de que comience la generación. Ninguno de estos comportamientos elimina la necesidad de manejar la capacidad no disponible o los resultados retrasados en su producto.
Establezca estos valores antes de comparar endpoints:
- Objetivo de disponibilidad: Defina cuándo una función debe funcionar y qué comportamiento degradado es aceptable.
- Objetivo de latencia: Especifique el tiempo de respuesta que los usuarios necesitan, incluyendo el comportamiento de latencia de cola.
- Valor de conmutación por error: Decida qué interrupciones justifican una capacidad alternativa u otro modelo.
- Límite de costo por tarea: Establezca el gasto máximo económicamente aceptable para un resultado aceptado.
Una comparación de adquisición útil mantiene esos requisitos constantes. De lo contrario, estará comparando diferentes servicios a través de la misma columna de precios.
Establezca su presupuesto antes de decidirse por un modelo
Decídase por un modelo solo después de poder vincular su precio a un presupuesto a nivel de funcionalidad y a una prueba de aceptación medible. Una respuesta prometedora del playground es un punto de partida, no una prueba de que todo el flujo de trabajo sea económico.
Establezca controles para la evaluación
Elija la unidad de facturación de cada funcionalidad. Registre si el entregable consume input tokens, output tokens, images, megapixels o jobs. Mantenga la configuración solicitada junto a esa unidad para que un cambio en las dimensiones de la imagen o en la configuración de video active una revisión del presupuesto.
Elabore una previsión a nivel de funcionalidad. Utilice el volumen de solicitudes y el uso observados de una muestra representativa. Incluya la ruta de ejecución completa, incluyendo el procesamiento en segundo plano y las llamadas de reparación dirigidas por la aplicación, en lugar de estimar solo a partir del prompt visible del usuario.
Envíe un límite de precio con las solicitudes. Utilice el control
max_priceomax_costaplicable. Una solicitud nunca se factura por encima del valor que usted envía, por lo que un límite exigible es más útil que asumir que el precio de catálogo típico es un máximo garantizado.Asigne el saldo compartido deliberadamente. Un saldo cubre modelos de text, image, video y music. Mantenga registros de gastos a nivel de funcionalidad para que un experimento multimedia no oculte los fondos necesarios para un flujo de trabajo de texto establecido.
Evalúe un modelo alternativo. Nuestra API proporciona una key para cada modelo al precio de lista o menos. Cambie el identificador del modelo manteniendo estables las instrucciones de la tarea y los criterios de aceptación, luego compare los entregables resultantes en lugar de seleccionar la respuesta que suene más pulida.
Ejecute un piloto de producción acotado. Elija una ventana de revisión que capture el tráfico rutinario y difícil. Compare el costo medido por tarea aceptada con su previsión antes de ampliar el acceso o aumentar la concurrencia.
Investigue la diferencia antes de cambiar de proveedor
Utilice el dashboard playground para comparar salidas y ajustar parámetros antes de la integración en producción. Para la extracción, inspeccione el cumplimiento del schema y si los campos son compatibles con el documento. Para la codificación, evalúe si el cambio propuesto satisface la tarea y pasa las comprobaciones relevantes.
Cuando el costo medido exceda la previsión, verifique primero la output length, retry behavior y context size. Luego, inspeccione si su aplicación ha cambiado la carga de trabajo, como adjuntar historiales de conversación completos o suministrar repetidamente los mismos documentos. No asuma que una factura más alta significa que la tarifa listada aumentó.
Abra la tabla de precios en vivo esta semana, identifique la funcionalidad responsable de la mayor parte de su gasto y construya su estimación a partir del uso registrado. Asigne a alguien para que revise los primeros resultados medidos en comparación con esa previsión.
UberLLM ofrece una API unificada y un saldo prepago para acceder a modelos de text, image, video y music, con controles de precio a nivel de solicitud. Visite UberLLM para comparar precios de modelos en vivo, elija un candidato para su funcionalidad de mayor gasto y pruebe su costo por tarea completada antes de comprometerse.