Síntesis de Voz Cantada: Cómo Funciona y Dónde Falla
Aprende cómo la síntesis de voz cantada convierte letras y notas en audio cantado, qué controlan los datos de entrenamiento y los vocoders, y dónde aún se queda corta.
Has escrito una melodía, le has ajustado la letra y has cargado un cantante sintético. La primera reproducción es alentadora, hasta que una palabra pasa demasiado rápido, una nota sostenida suena metálica y el coro suena extrañamente inexpresivo. Esos problemas no tienen necesariamente la misma causa. Comprender dónde entra cada uno en la cadena de señal hace que arreglar la voz sea mucho menos un juego de adivinanzas.
Tabla de Contenidos
- ¿Qué es la síntesis de voz cantada y de dónde viene?
- Cómo un sistema de síntesis de voz cantada convierte una partitura en sonido
- Por qué los datos de entrenamiento deciden la calidad de una voz cantada
- Los modelos acústicos y los vocoders deciden dónde se gana la calidad
- Cómo juzgar un sistema de síntesis de voz cantada
- Usos prácticos, límites y brechas culturales
- Confirma los derechos antes de construir o comprar un modelo de canto
Qué es la síntesis de voz cantada y de dónde viene
La síntesis de voz cantada (SVS) genera audio cantado a partir de letras, una secuencia de notas con tonos y duraciones, y, en muchos sistemas, una identidad de cantante seleccionada. Imagina que eres un compositor con una melodía terminada pero sin un cantante disponible. Introduces las notas y las palabras para escuchar cómo la línea vocal encaja en tu arreglo.
Esto no es solo síntesis de voz con una pista de acompañamiento musical. Una frase hablada necesita un fraseo creíble, pero una frase cantada también debe seguir los tonos musicales, sostener las vocales y colocar las consonantes alrededor del ritmo. Una sílaba que es aceptable en una conversación puede sonar extraña cuando se estira a lo largo de una nota larga.
De fragmentos grabados a voces aprendidas
Los primeros enfoques utilizaban reglas y procesamiento de señales, seguidos por sistemas que ensamblaban unidades vocales grabadas. Los enfoques estadísticos y neuronales aprendieron posteriormente las relaciones entre las letras, las instrucciones musicales y la salida acústica, en lugar de depender únicamente de la unión de fragmentos.
Según el relato de Yamaha sobre el desarrollo de VOCALOID, el proyecto comenzó en febrero 2000 a través de la colaboración DAISY con la Universitat Pompeu Fabra de Barcelona, y el primer producto comercial apareció en 2004. Los desarrolladores necesitaron una base de datos de canto dedicada porque la entrada de computadora ordinaria y la tecnología de voz convencional no podían reproducir el canto de manera adecuada.
Cantantes virtuales como Hatsune Miku también ayudaron a convertir el canto sintético en un medio creativo centrado en personajes. La voz podía convertirse en parte de una identidad artística, no solo en una pista sustituta en una sesión de grabación.
Distinción útil: Generar una interpretación musical y controlar una melodía cantada nota por nota no son el mismo requisito.
Al navegar por un listado de modelos de generación musical, verifica los controles de entrada en lugar de asumir que cada herramienta musical acepta una partitura vocal. Para un sistema de canto utilizable, necesitas entender su cadena de señal, reconocer sus límites de calidad y establecer cómo se pueden evaluar y licenciar sus voces.
Cómo un sistema de síntesis de voz cantada convierte una partitura en sonido
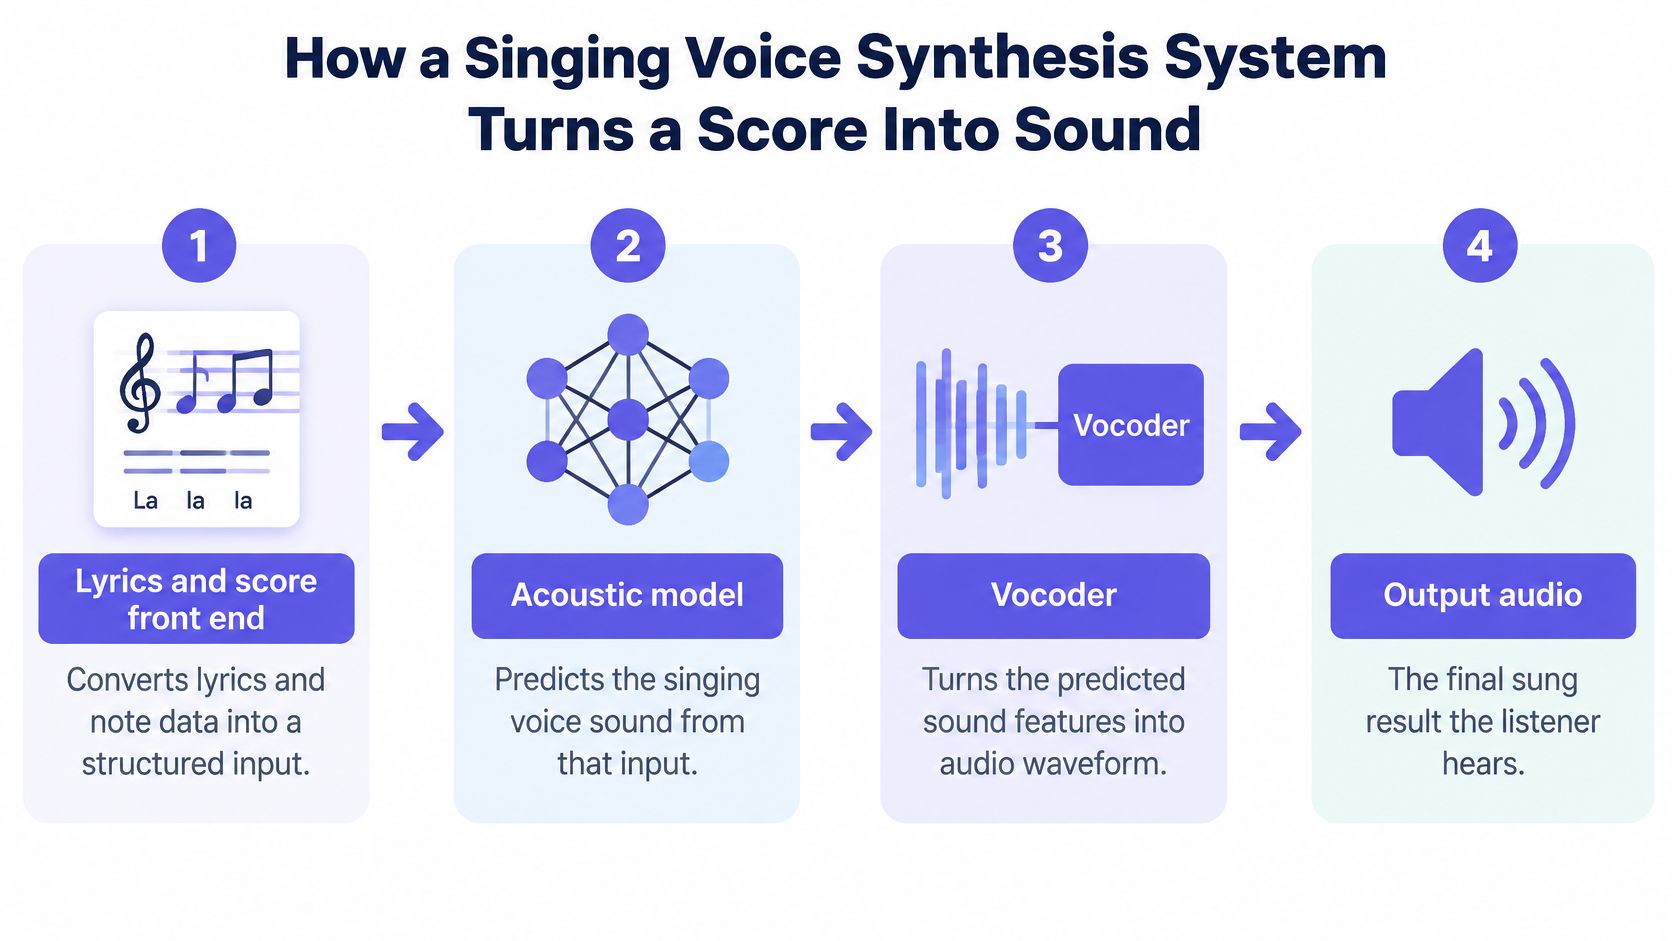
¿Qué entra y qué sale? En un flujo de trabajo controlado por partitura, la entrada es un conjunto de instrucciones musicales. La salida es una forma de onda que puedes reproducir, editar y mezclar.
Etapas del proceso en un sistema de síntesis de voz cantada
| Etapa | Entrada | Salida | Qué controla |
|---|---|---|---|
| Front end de letra y partitura | Letra, tono de nota y duración de nota | Secuencia de fonemas con temporización | Qué sonido se canta en qué tiempo |
| Modelo de duración y tono | Fonemas y partitura | Temporización a nivel de fotograma y curva de tono | Vibrato, ataques de nota y precisión del tono |
| Modelo acústico | Fonemas, temporización, tono e identidad del cantante | Mel-spectrogram | Timbre, forma de vocal y articulación |
| Vocoder | Mel-spectrogram | Forma de onda de audio | Claridad, respiración y artefactos audibles |
La ilustración muestra el flujo general, con las decisiones de duración y tono incorporadas en el proceso de predicción.
Convirtiendo palabras y notas en una interpretación
El front end descompone las letras en fonemas, los sonidos individuales del habla dentro de las palabras, y los asocia con las notas. Una sílaba escrita no es un único sonido ininterrumpido. En stay, las consonantes iniciales necesitan un tratamiento diferente de la vocal que lleva el tono sostenido.
Si el sistema asigna demasiado tiempo a las consonantes, la vocal puede llegar tarde. Si acorta la vocal para compensar, la palabra suena apresurada aunque la nota termine a tiempo. Empieza con la pronunciación y la colocación de fonemas cuando una letra suena rítmicamente incorrecta.
El modelo de duración y tono decide cómo se desarrollan esos sonidos a lo largo del tiempo. La nota especifica un tono objetivo, pero la curva de tono interpretada puede incluir una aproximación suave, un centro estable y vibrato hacia el final. Una curva perfectamente plana puede sonar rígida; una transición exagerada puede sonar como un scoop no intencionado.
Algunas herramientas aceptan datos de notas explícitos, mientras que otras generan o infieren una melodía a partir de entradas menos restringidas, incluyendo las letras. Esa diferencia determina si puedes reparar una nota particular directamente o debes solicitar otra interpretación.
Convirtiendo una descripción de interpretación en audio
El modelo acústico predice una representación como un mel-spectrogram, que describe cómo se distribuye la energía sonora a través de la frecuencia a lo largo del tiempo. Piensa en ello como un mapa cambiante del tono de la voz, no como un archivo de audio que ya puedas escuchar.
Características espectrales mal definidas pueden producir vocales apagadas, consonantes borrosas o una identidad vocal inestable. Pero la falta de brillo por sí sola no prueba que el modelo acústico sea el responsable. El generador de forma de onda final también puede oscurecer detalles útiles.
El vocoder convierte la representación predicha en muestras de sonido. Zumbidos, granularidad o texturas metálicas pueden originarse aquí, especialmente en vocales sostenidas expuestas.
Antes de editar, identifica si la herramienta acepta notas y qué controles afectan la etapa sospechosa. No intentes arreglar una consonante mal colocada con ecualización, o una forma de onda áspera reescribiendo una letra correctamente pronunciada.
¿Por qué los datos de entrenamiento deciden qué tan bien suena una voz cantada?
Grabar canto es solo una parte de la construcción de un conjunto de datos útil. Los desarrolladores también necesitan letras fiables, alineación de notas, sincronización de fonemas y anotaciones que distingan la expresión intencionada de los errores. Sin ese contexto, un modelo puede aprender un evento acústico sin aprender cuándo le corresponde.
La comparación de corpus en la encuesta de conjuntos de datos de canto ilustra la escala limitada y la cobertura de cantantes de varios recursos influyentes, resumidos a continuación.
Conjuntos de datos de canto por tamaño y cobertura
| Corpus | Cantantes | Horas | Qué Cubre |
|---|---|---|---|
| VocalSet | 20 | Aproximadamente 10.1 | Técnicas vocales, vocales y tonos variados, no canciones completas |
| NUS-48E | 12 | Aproximadamente 2.8 | Corpus pequeño con un grupo limitado de cantantes |
| MIR-1K | 19 | Aproximadamente 2.2 | Corpus pequeño con un grupo limitado de cantantes |
| CSD | 1 | Aproximadamente 4.9 | 100 canciones en dos idiomas de un solo cantante |
| SingNet | No especificado en el resumen citado | Aproximadamente 3,000 | Canto 'in-the-wild' y paquetes de samples en varios idiomas y estilos |
La preimpresión de SingNet informa 2,629 horas de canto 'in-the-wild' y 321 horas de paquetes de samples, sumando aproximadamente 3,000 horas. Esto representa una expansión sustancial en el material disponible, pero el tamaño de la colección no es un certificado de cobertura musical.
La cobertura importa tanto como la duración
El enfoque de VocalSet en técnicas, vocales y tonos lo hace útil para estudiar el comportamiento vocal. No lo hace intercambiable con un corpus de canciones completas y expresivamente fraseadas. Del mismo modo, una colección de un solo cantante puede ofrecer consistencia sin demostrar que un sistema se generalizará a través de diferentes identidades vocales.
Overfitting significa que un modelo se vuelve demasiado dependiente de los patrones en su material de entrenamiento. En la escucha práctica, eso podría significar una vocal familiar convincente pero una pronunciación desconocida torpe, o un resultado sólido en un estilo representado y un resultado poco convincente en otro lugar.
Para la selección del modelo, examine:
- Cobertura de cantantes: Busque rangos e identidades vocales documentados, no solo una duración total de grabación.
- Cobertura de idiomas: Verifique si su idioma de letra y las convenciones de pronunciación están representados.
- Cobertura musical: Distinga los ejercicios aislados de las frases completas, las transiciones y la expresión sostenida.
- Calidad de la anotación: Busque una explicación de cómo se alinearon las letras y las notas con las grabaciones.
La pregunta útil no es solo cuánto audio recopiló un desarrollador. Es qué tan cerca el material documentado coincide con la interpretación que usted necesita. La falta de documentación limita la confianza con la que puede aplicar una afirmación de calidad más allá de una demostración pulida.
Los modelos acústicos y los vocoders deciden dónde se gana la calidad
El generador de formas de onda puede alterar significativamente la calidad de canto percibida incluso cuando el predictor previo permanece igual. Eso convierte al vocoder en una elección de ingeniería, no solo un paso de exportación.
En un estudio controlado de síntesis neural de canto, los modelos acústicos basados en CNN superaron a las redes feed-forward correspondientes en pruebas de naturalidad, y reemplazar el vocoder MLSA tradicional con WaveNet mejoró ambas familias de modelos. El estudio se entrenó con 55 canciones infantiles japonesas y 55 canciones de J-pop, reservó cinco canciones de J-pop, y utilizó puntuaciones de opinión media de cinco puntos de 15 oyentes que evaluaron frases de prueba seleccionadas al azar. Esos resultados respaldan una comparación controlada, no una clasificación universal entre cantantes, idiomas o géneros.
Separa los errores de predicción de los errores de renderizado
Un modelo acústico puede predecir una estructura vocal incorrecta. Un vocoder puede renderizar una predicción razonable de forma deficiente. Ambos fallos pueden sonar artificiales, pero reemplazar el mismo componente no solucionará ambos.
Para un sistema modular, prueba el vocoder utilizando características acústicas extraídas de una grabación de referencia limpia. Esto es una prueba de resíntesis: estás comprobando qué tan bien la etapa de forma de onda reconstruye información que ya existe, en lugar de pedirle al predictor acústico que la invente.
Luego sintetiza a partir de la partitura. Si la resíntesis de referencia es clara pero la salida generada por la partitura es confusa, investiga las características predichas, la alineación y el acondicionamiento del tono. Si la reconstrucción de referencia ya suena granulada, aborda primero la compatibilidad del vocoder o de las características.
No reemplaces el modelo completo hasta que hayas comprobado si el defecto existe antes de la generación de la forma de onda.
Esta distinción también importa al evaluar herramientas de voz adyacentes. Una lista de modelos de texto a voz describe una tarea diferente; una salida de voz inteligible por sí sola no establece la calidad de nota sostenida o el control de la partitura.
Elige la fidelidad y la latencia para el trabajo real
Los vocoders autorregresivos tipo WaveNet generan audio secuencialmente, lo que puede aumentar la latencia. Alternativas más rápidas, incluyendo LPCNet, pueden ser más apropiadas cuando la reproducción inmediata importa.
Para el renderizado offline, puedes aceptar una espera más larga para preservar el detalle vocal. Para la composición interactiva, puedes preferir una vista previa rápida y reservar un renderizado de mayor calidad para la revisión.
Mide tanto el tiempo de generación como los artefactos que puedes escuchar bajo tu flujo de trabajo previsto. Un renderizado aislado hermoso es menos útil si interrumpe cada pequeña edición de melodía, mientras que una vista previa inmediata no debe confundirse con la mejor salida final que el sistema puede producir.
Cómo evaluar un sistema de síntesis de voz cantada
Una voz puede sonar natural aunque desafine, o seguir las notas con precisión aunque suene débil. Ninguna puntuación de calidad por sí sola describe el rendimiento completo. Necesitará los juicios de los oyentes junto con las mediciones de la señal generada.
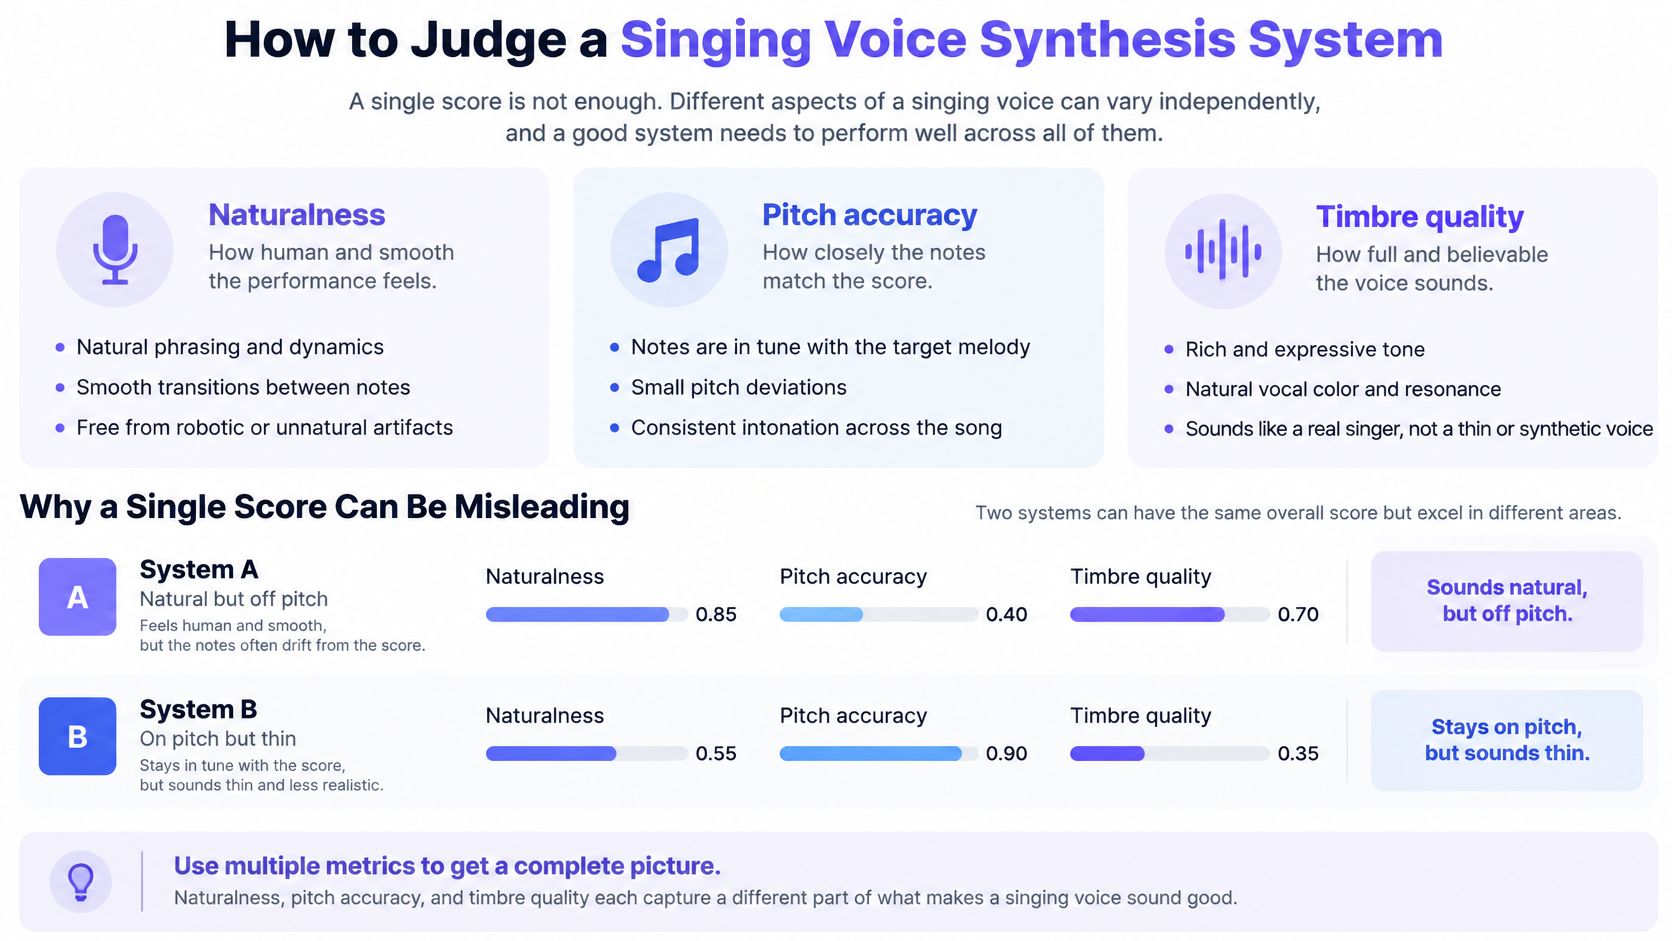
El artículo WeSinger 2 utiliza MOS, F0 RMSE (error cuadrático medio) y distorsión del mel-espectrograma para examinar aspectos complementarios de la calidad del canto. Su entrenamiento adversario condicional multi-cantante mejora el MOS respecto al sistema WeSinger anterior en Opencpop y Data-L, pero las ganancias comparativas difieren entre los conjuntos de datos, subrayando la importancia de las condiciones del cantante y del corpus.
Métricas para juzgar la calidad de la síntesis de voz cantada
| Métrica | Lo que detecta | Lo que no detecta |
|---|---|---|
| MOS | Calidad percibida general por los oyentes | Puede ocultar desviaciones de tono y detalles específicos del cantante |
| F0 RMSE | Error de tono, entonación y afinación | Respiración, pronunciación y timbre |
| MSD | Desajuste espectral relacionado con el timbre y la articulación | Si una frase suena expresiva o acorde al estilo |
Interprete las mediciones en conjunto
MOS, o puntuación media de opinión, resume las valoraciones de los oyentes. Es útil para preguntar si la gente prefiere el resultado general, pero la interpretación depende de lo que escucharon y de lo que se les pidió juzgar.
F0 RMSE mide el error en la frecuencia fundamental, la cantidad acústica asociada con el tono percibido. Ayuda a revelar problemas de afinación, pero no establece que las palabras sean inteligibles o que el tono vocal sea creíble.
MSD compara representaciones espectrales. Puede exponer diferencias relacionadas con la articulación y el timbre, pero igualar un espectrograma de referencia no es lo mismo que tomar una decisión artística convincente.
Comprobación auditiva: Audicione la voz sola antes de juzgarla dentro de una mezcla densa. El acompañamiento puede hacer que las consonantes débiles y los finales de nota inestables sean más difíciles de notar.
Cree un conjunto de evaluación que contenga canciones desconocidas y, donde el sistema los admita, cantantes no utilizados en el entrenamiento. Incluya vocales sostenidas, letras con muchas consonantes, cambios de registro y frases que requieran una sincronización expresiva deliberada.
Informe las métricas en conjunto, luego escuche específicamente la respiración, la pronunciación y la identidad vocal. Si un proveedor ofrece solo una puntuación de naturalidad destacada, trátela como evidencia sobre esa prueba de escucha, no como prueba de que su letra, cantante y arreglo funcionarán igual de bien.
Usos Prácticos, Límites y Brechas Culturales
Un compositor puede usar el canto sintético para comprobar si un estribillo es cantable antes de organizar una sesión. Un productor puede probar una armonía, mientras que un equipo de juego puede verificar cómo encaja la canción de un personaje en una escena. Estos son usos prácticos porque la interpretación generada ayuda a las personas a tomar una decisión de producción concreta.
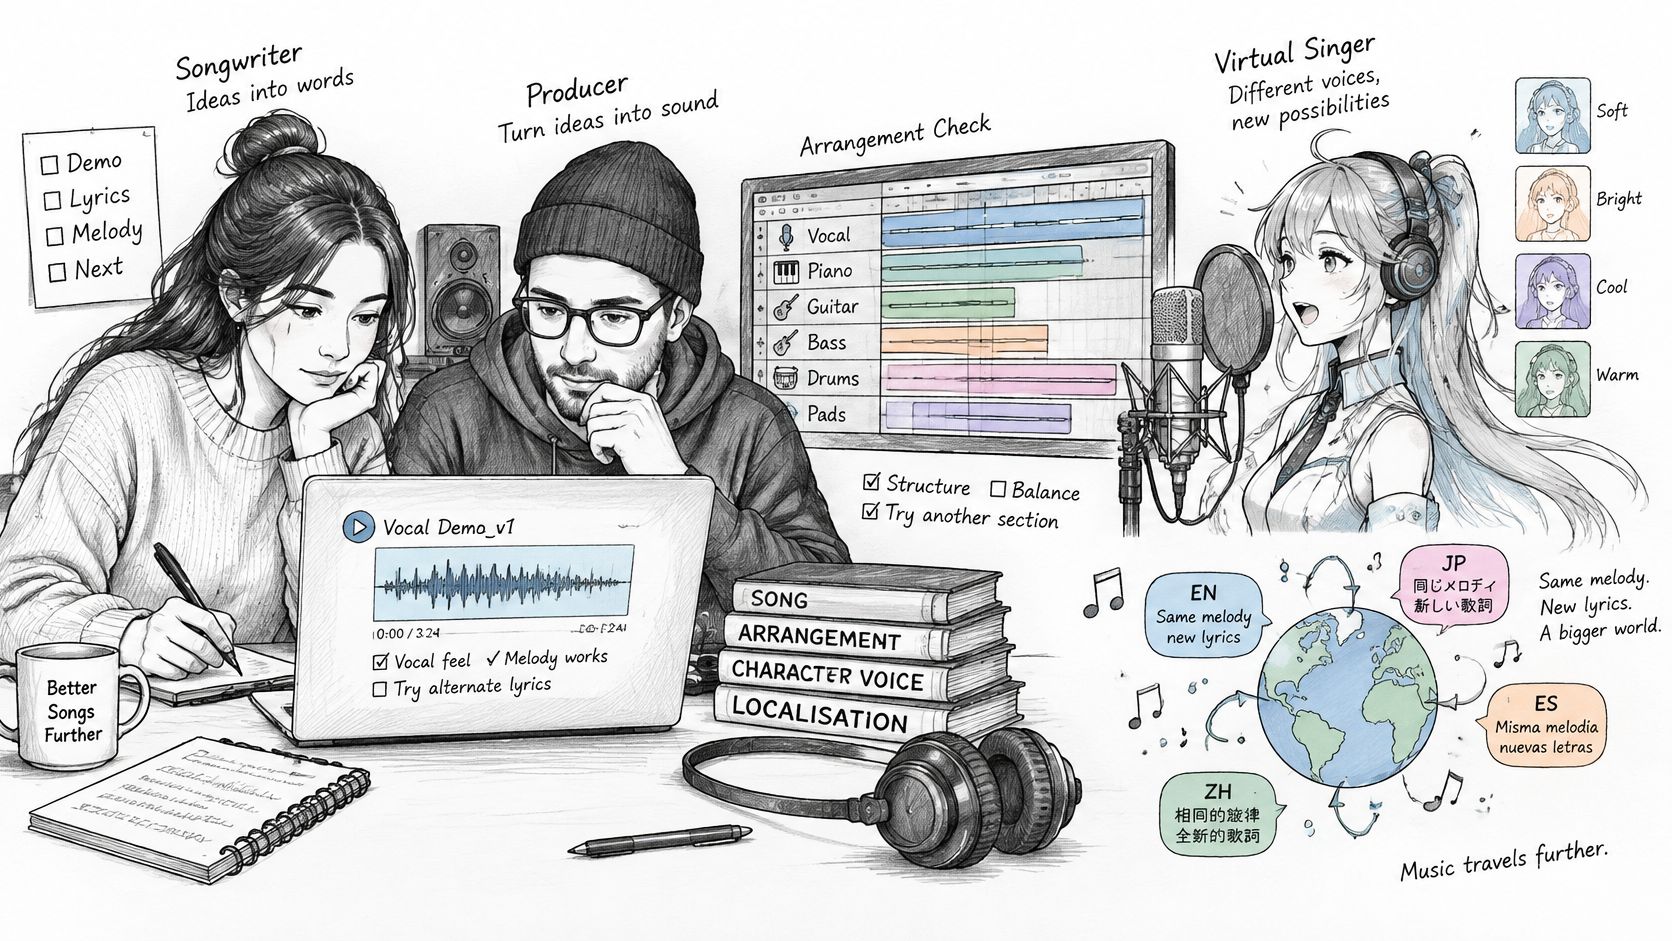
Los lanzamientos centrados en personajes y los prototipos de animación también pueden usar una estética vocal deliberadamente sintética. Para la creación de prototipos audiovisuales, una guía para hacer un video musical con IA puede ayudar a conectar el flujo de trabajo de audio con la producción visual, pero la voz aún necesita su propia revisión musical.
Pruebe la expresión, no solo las notas correctas
La localización es un ejemplo útil de cómo una tarea aparentemente simple se vuelve exigente. Mantener la melodía al cambiar de idioma significa encajar nuevas sílabas, patrones de acentuación y consonantes en una frase existente. Una traducción literal puede no ser adecuada como letra cantada.
La expresión culturalmente específica añade otra capa. El capítulo sobre el canto clásico indio describe la ornamentación en relación con la nota particular, el raga, el cantante y el contexto musical, detalles que las mediciones convencionales de tono e inteligibilidad pueden pasar por alto.
Use pruebas específicas en lugar de preguntar solo si el resultado suena humano:
- Ornamentación: Pida a un músico familiarizado con la tradición que juzgue el movimiento entre y alrededor de las notas.
- Cambio de código (Code-switching): Coloque un cambio de idioma dentro de una frase y verifique el acento, el énfasis y la continuidad de la identidad vocal.
- Palabras raras: Pruebe nombres y vocabulario lírico desconocido, luego pida a un hablante fluido que evalúe la pronunciación.
- Fraseo: Compare dónde el cantante generado respira, enfatiza una palabra o libera un final sostenido.
Verifique el origen por separado de la calidad
Una voz convincente no establece quién la interpretó. El informe del Instituto Nacional de Justicia sobre el Desafío inaugural de Detección de Deepfakes de Voz Cantada reporta 47 equipos participantes y una tasa de error igual del 1.65% del equipo principal en el entorno del desafío.
Ese resultado demuestra el rendimiento medido del detector bajo condiciones particulares, no una autenticación garantizada de un lanzamiento arbitrario. Trate la detección como una verificación más junto con los registros de procedencia, los archivos fuente y la autorización documentada.
El canto sintético es particularmente útil para borradores, prototipos y voces de personajes intencionales. Una voz comercial final, especialmente en un lanzamiento importante, necesita revisión humana para la expresión musical, la precisión del idioma, la identidad y la procedencia, en lugar de la aprobación basada únicamente en una demo que suena limpia.
Confirme los derechos antes de construir o comprar un modelo de canto
¿Quién ha autorizado la voz antes de que sea entrenada, clonada o publicada? Una grabación vocal puede involucrar a un intérprete, un propietario de la grabación, un letrista y un compositor. El permiso para una contribución no resuelve automáticamente las demás.
El artículo de AI & Society sobre la gobernanza de datos de canto advierte que una licencia Creative Commons estándar podría no proteger adecuadamente a los colaboradores de datos de canto, porque las grabaciones pueden contener tanto la voz de un intérprete como una canción protegida por derechos de autor. También distingue las reglas de uso justo de EE. UU. de la excepción de minería de texto y datos de la UE, en lugar de tratarlas como permisos intercambiables.
Ponga los usos permitidos por escrito
Utilice una lista de verificación de derechos antes de transferir grabaciones o integrar un modelo:
- Identifique los derechos relevantes. Documente los permisos relacionados con las grabaciones del cantante, las letras, la composición, la imagen y el lanzamiento comercial previsto. Registre quién puede autorizar cada uso en lugar de asumir que la persona que proporciona el archivo controla todo.
- Especifique las actividades del modelo. Indique si el acuerdo permite el entrenamiento, el ajuste fino (fine-tuning), la clonación de voz, la redistribución y el uso comercial posterior (downstream commercial use). Una licencia para publicar una pista de audio no debería convertirse en un permiso para construir un modelo de voz reutilizable.
- Lea los términos de la licencia. No confíe solo en una etiqueta Creative Commons. Verifique si los términos abordan la contribución del intérprete y la canción subyacente.
- Verifique la jurisdicción aplicable. Haga que un asesor legal calificado evalúe las reglas relevantes para las grabaciones, los colaboradores y la implementación (deployment). No trasplante una excepción de otro sistema legal a su acuerdo.
- Planifique lo que sucede después del entrenamiento. Defina los procedimientos de revocación, la eliminación del modelo, la atribución y el reparto de ingresos. Especifique quién maneja las solicitudes y qué recursos están disponibles técnica y contractualmente.
Mantenga la evidencia con los activos de producción
Mantenga un registro de permisos junto con el dataset o proyecto. Incluya la versión del acuerdo, los usos permitidos, los identificadores de la grabación original y cualquier restricción de distribución. Esto facilita la distinción entre una entrada autorizada y un archivo que simplemente llegó a una carpeta compartida.
La disponibilidad pública no es prueba de consentimiento o propiedad. Tampoco debe confundirse la promesa de eliminar una grabación con la capacidad demostrada de eliminar su influencia de un modelo ya entrenado.
Antes de construir o comprar un modelo de canto, obtenga términos por escrito que cubran cada derecho relevante, actividad permitida y obligación posterior al entrenamiento.
UberLLM es una API para modelos de texto, imagen, video, música y voz. Si está construyendo un flujo de trabajo de producción relacionado con el canto, visite UberLLM para explorar los listados de modelos y comparar sus inputs documentados con sus requisitos de control de partitura, salida de audio y tareas de medios circundantes.