노래 음성 합성: 작동 방식과 한계점
노래 음성 합성이 가사와 음표를 노래하는 오디오로 어떻게 변환되는지, 어떤 훈련 데이터와 보코더가 이를 제어하는지, 그리고 여전히 어떤 한계점이 있는지 알아보세요.
멜로디를 작곡하고, 가사를 붙이고, 합성 가수를 불러왔습니다. 첫 재생은 고무적입니다. 단어가 너무 빨리 지나가고, 길게 끄는 음이 금속성으로 변하며, 코러스가 이상하게 무표정하게 들릴 때까지는 말이죠. 이러한 문제들이 반드시 같은 원인을 가지고 있지는 않습니다. 각 문제가 신호 체인의 어느 지점에서 발생하는지 이해하면 보컬을 수정하는 것이 훨씬 덜 추측성 작업이 됩니다.
목차
- 노래 음성 합성(Singing Voice Synthesis)이란 무엇이며 어디서 왔는가
- 노래 음성 합성 시스템이 악보를 소리로 바꾸는 방법
- 훈련 데이터가 노래 음성의 품질을 결정하는 이유
- 음향 모델과 보코더가 품질을 결정하는 곳
- 노래 음성 합성 시스템을 평가하는 방법
- 실제 사용, 한계 및 문화적 격차
- 노래 모델을 구축하거나 구매하기 전에 권리 확인하기
노래 음성 합성(SVS)이란 무엇이며 어디서 왔는가
**노래 음성 합성(SVS)**은 가사, 음정과 길이(지속 시간)를 가진 음표 시퀀스, 그리고 많은 시스템에서 선택된 가수 아이덴티티로부터 노래하는 오디오를 생성합니다. 멜로디는 완성했지만 가수가 없는 작곡가라고 가정해 봅시다. 음표와 가사를 입력하여 보컬 라인이 편곡에 어떻게 어울리는지 들어볼 수 있습니다.
이것은 단순히 음악 반주가 있는 음성 합성이 아닙니다. 말하는 문장은 믿을 수 있는 구절 표현이 필요하지만, 노래하는 문장은 또한 음악적 음정을 따르고, 모음을 길게 유지하며, 박자 주변에 자음을 배치해야 합니다. 대화에서는 괜찮은 음절도 긴 음표에 걸쳐 늘어뜨리면 어색하게 들릴 수 있습니다.
녹음된 조각에서 학습된 목소리로
초기 접근 방식은 규칙과 신호 처리를 사용했으며, 이어서 녹음된 보컬 단위를 조립하는 시스템이 등장했습니다. 이후 통계적 및 신경망 접근 방식은 단순히 조각들을 이어 붙이는 방식에 의존하기보다는 가사, 음악적 지시, 음향 출력 간의 관계를 학습했습니다.
Yamaha의 VOCALOID 개발 기록에 따르면, 이 프로젝트는 바르셀로나 폼페우 파브라 대학교와의 DAISY 협력을 통해 2000년 2월에 시작되었으며, 첫 상용 제품은 2004년에 출시되었습니다. 일반적인 컴퓨터 입력과 기존 음성 기술로는 노래를 적절하게 재현할 수 없었기 때문에 개발자들은 전용 노래 데이터베이스가 필요했습니다.
하츠네 미쿠와 같은 가상 가수들은 또한 합성 노래를 캐릭터 중심의 창작 매체로 바꾸는 데 기여했습니다. 목소리는 단순히 녹음 세션의 대체 트랙이 아니라 예술적 아이덴티티의 일부가 될 수 있었습니다.
유용한 구분: 음악적 연주를 생성하는 것과 노래 멜로디를 음표 하나하나 제어하는 것은 동일한 요구 사항이 아닙니다.
음악 생성 모델 목록을 살펴볼 때, 모든 음악 도구가 보컬 악보를 받아들인다고 가정하기보다는 입력 제어 기능을 확인하세요. 사용 가능한 노래 시스템을 위해서는 해당 시스템의 신호 체인을 이해하고, 품질 한계를 인식하며, 목소리가 어떻게 평가되고 라이선스될 수 있는지 파악해야 합니다.
가창 음성 합성 시스템이 악보를 소리로 바꾸는 방법
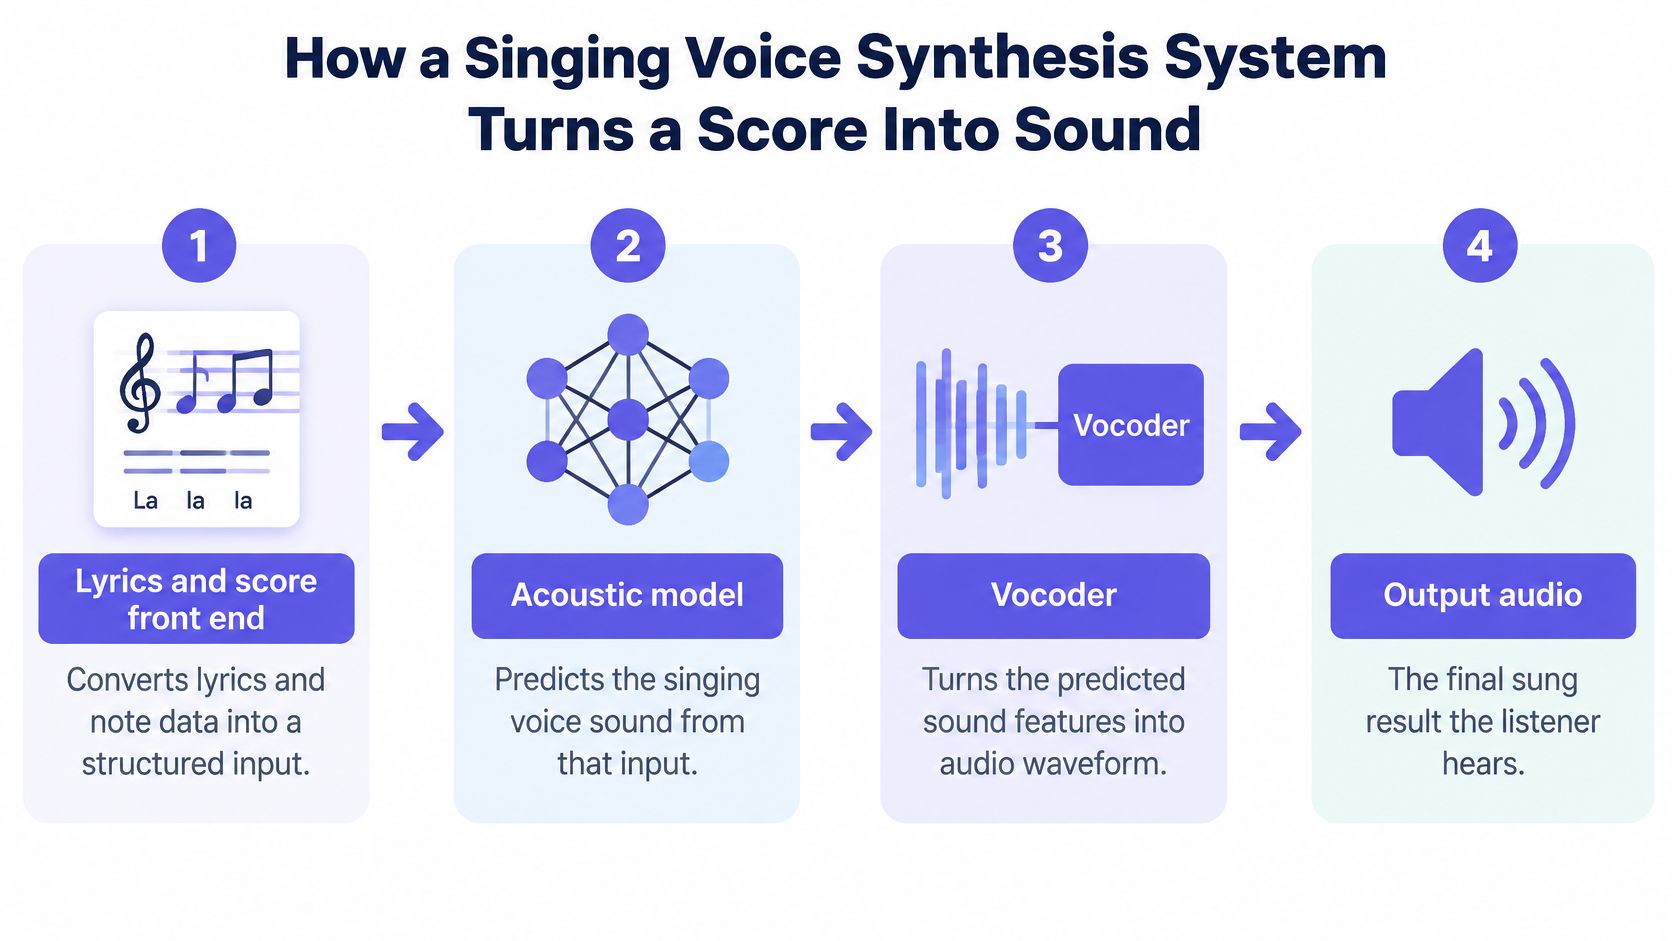
무엇이 입력되고, 무엇이 출력될까요? 악보로 제어되는 워크플로우에서 입력은 음악적 지시 세트입니다. 출력은 재생, 편집 및 믹싱할 수 있는 파형입니다.
가창 음성 합성 시스템의 파이프라인 단계
| 단계 | 입력 | 출력 | 제어 내용 |
|---|---|---|---|
| 가사 및 악보 프런트 엔드 | 가사, 음표 피치 및 음표 길이 | 타이밍이 있는 음소 시퀀스 | 어떤 소리가 어떤 박자에 불리는지 |
| 길이 및 피치 모델 | 음소 및 악보 | 프레임 수준 타이밍 및 피치 곡선 | 비브라토, 음표 어택 및 피치 정확도 |
| 음향 모델 | 음소, 타이밍, 피치 및 가수 정체성 | 멜 스펙트로그램 | 음색, 모음 형태 및 조음 |
| 보코더 | 멜 스펙트로그램 | 오디오 파형 | 선명도, 숨소리 및 가청 아티팩트 |
이 그림은 길이 및 피치 결정이 예측 프로세스에 통합된 더 넓은 흐름을 보여줍니다.
단어와 음표를 연주로 바꾸기
프런트 엔드는 가사를 단어 내 개별 음성 소리인 음소로 분해하고, 이를 음표와 연결합니다. 쓰여진 음절은 단일하고 끊김 없는 소리가 아닙니다. stay에서 시작하는 자음은 지속되는 피치를 전달하는 모음과 다르게 처리되어야 합니다.
시스템이 자음에 너무 많은 시간을 할당하면 모음이 늦게 도착할 수 있습니다. 보상하기 위해 모음을 단축하면 음표가 제시간에 끝나더라도 단어가 급하게 들립니다. 가사가 리듬적으로 잘못되었다고 느껴질 때 발음과 음소 배치부터 시작하세요.
길이 및 피치 모델은 이러한 소리가 시간의 흐름에 따라 어떻게 전개되는지 결정합니다. 음표는 목표 피치를 지정하지만, 연주된 피치 곡선은 부드러운 접근, 안정적인 중심, 그리고 끝 부분의 비브라토를 포함할 수 있습니다. 완벽하게 평평한 곡선은 딱딱하게 들릴 수 있고, 과장된 전환은 의도치 않은 스쿱처럼 들릴 수 있습니다.
일부 도구는 명시적인 음표 데이터를 허용하는 반면, 다른 도구는 가사를 포함하여 덜 제약적인 입력에서 멜로디를 생성하거나 추론합니다. 이러한 차이는 특정 음표를 직접 수정할 수 있는지 또는 다른 연주를 요청해야 하는지를 결정합니다.
연주 설명을 오디오로 바꾸기
음향 모델은 시간 경과에 따른 주파수 전반에 걸쳐 소리 에너지가 어떻게 분포하는지 설명하는 멜 스펙트로그램과 같은 표현을 예측합니다. 이미 들을 수 있는 오디오 파일이 아니라, 목소리 톤의 변화하는 지도라고 생각하세요.
잘 정의되지 않은 스펙트럼 특징은 둔한 모음, 흐릿한 자음 또는 불안정한 보컬 정체성을 생성할 수 있습니다. 그러나 둔함만으로는 음향 모델의 책임이라고 단정할 수 없습니다. 최종 파형 생성기도 유용한 세부 정보를 가릴 수 있습니다.
보코더는 예측된 표현을 사운드 샘플로 변환합니다. 윙윙거림, 거친 소리 또는 금속성 질감은 특히 노출된 지속 모음에서 여기에서 발생할 수 있습니다.
편집하기 전에, 도구가 음표를 허용하는지, 그리고 어떤 컨트롤이 의심되는 단계에 영향을 미치는지 확인하세요. 잘못 배치된 자음을 이퀄라이제이션으로 고치려 하거나, 올바르게 발음된 가사를 다시 작성하여 거친 파형을 수정하려 하지 마세요.
훈련 데이터가 노래 목소리의 품질을 결정하는 이유
노래 녹음은 유용한 데이터셋을 구축하는 과정의 일부일 뿐입니다. 개발자들은 또한 신뢰할 수 있는 가사, 음표 정렬, 음소 타이밍, 그리고 의도된 표현과 실수를 구별하는 주석이 필요합니다. 그러한 맥락이 없으면, 모델은 음향 이벤트를 언제 적절한지 배우지 않고도 학습할 수 있습니다.
노래 데이터셋 설문조사에 있는 코퍼스 비교는 여러 영향력 있는 자료들의 제한된 규모와 가수 커버리지를 보여주며, 아래에 요약되어 있습니다.
규모 및 커버리지별 노래 데이터셋
| 코퍼스 | 가수 | 시간 | 내용 |
|---|---|---|---|
| VocalSet | 20 | About 10.1 | 보컬 테크닉, 모음 및 다양한 음정, 전체 노래는 아님 |
| NUS-48E | 12 | About 2.8 | 제한된 가수 풀을 가진 소규모 코퍼스 |
| MIR-1K | 19 | About 2.2 | 제한된 가수 풀을 가진 소규모 코퍼스 |
| CSD | 1 | About 4.9 | 한 명의 가수가 두 가지 언어로 부른 100곡 |
| SingNet | 인용된 요약에 명시되지 않음 | About 3,000 | 다양한 언어와 스타일의 실제 노래 및 샘플 팩 |
SingNet 사전 출판물은 실제 노래 2,629시간과 샘플 팩 321시간을 보고하며, 총 약 3,000시간에 달합니다. 이는 사용 가능한 자료의 상당한 확장을 의미하지만, 수집 규모가 음악적 커버리지의 증명은 아닙니다.
커버리지는 길이만큼 중요합니다
VocalSet이 테크닉, 모음, 음정에 중점을 두는 것은 보컬 행동 연구에 유용하게 만듭니다. 그렇다고 해서 완전하고 표현력이 풍부하게 구절화된 노래 코퍼스와 상호 교환될 수 있는 것은 아닙니다. 마찬가지로, 단일 가수 컬렉션은 시스템이 다양한 보컬 아이덴티티에 걸쳐 일반화될 것임을 입증하지 않고도 일관성을 제공할 수 있습니다.
**과적합(Overfitting)**은 모델이 훈련 자료의 패턴에 너무 의존하게 되는 것을 의미합니다. 실제 청취에서 이는 익숙한 모음은 설득력 있지만 어색한 낯선 발음, 또는 특정 스타일에서는 강력한 결과가 나오지만 다른 곳에서는 설득력 없는 결과로 나타날 수 있습니다.
모델 선택 시 다음을 살펴보세요:
- 가수 커버리지: 단순히 총 녹음 시간뿐만 아니라 문서화된 음역대와 아이덴티티를 확인하세요.
- 언어 커버리지: 가사 언어와 발음 규칙이 표현되어 있는지 확인하세요.
- 음악적 커버리지: 단독 연습과 완전한 구절, 전환, 지속적인 표현을 구별하세요.
- 주석 품질: 가사와 음표가 녹음과 어떻게 정렬되었는지에 대한 설명을 찾아보세요.
유용한 질문은 개발자가 얼마나 많은 오디오를 수집했는지뿐만이 아닙니다. 그것은 문서화된 자료가 필요한 성능과 얼마나 밀접하게 일치하는지입니다. 문서가 부족하면 잘 다듬어진 데모를 넘어 품질 주장을 얼마나 확신할 수 있는지 제한됩니다.
음향 모델과 보코더가 품질을 좌우합니다
파형 생성기는 상위 예측기가 동일하게 유지되더라도 인지되는 노래 품질을 실질적으로 바꿀 수 있습니다. 이것이 보코더를 단순한 내보내기 단계가 아닌 엔지니어링 선택으로 만듭니다.
제어된 신경 노래 합성 연구에서 CNN 기반 음향 모델은 자연스러움 테스트에서 해당 피드포워드 네트워크보다 우수한 성능을 보였으며, 전통적인 MLSA 보코더를 WaveNet으로 대체하자 두 모델 계열 모두 개선되었습니다. 이 연구는 55곡의 일본 동요와 55곡의 J-pop 노래로 훈련되었고, 다섯 곡의 J-pop 노래를 제외했으며, 무작위로 선택된 테스트 구문을 평가하는 15명의 청취자로부터 5점 척도 평균 의견 점수를 사용했습니다. 이러한 결과는 가수, 언어 또는 장르 전반에 걸친 보편적인 순위가 아닌, 제어된 비교를 뒷받침합니다.
예측 오류와 렌더링 오류 분리하기
음향 모델은 잘못된 보컬 구조를 예측할 수 있습니다. 보코더는 합리적인 예측을 제대로 렌더링하지 못할 수 있습니다. 두 가지 실패 모두 인위적으로 들릴 수 있지만, 동일한 구성 요소를 교체한다고 해서 둘 다 해결되지는 않습니다.
모듈식 시스템의 경우, 깨끗한 참조 녹음에서 추출된 음향 특징을 사용하여 보코더를 테스트하십시오. 이것은 재합성 테스트입니다: 음향 예측기에게 정보를 만들도록 요청하는 대신, 파형 단계가 이미 존재하는 정보를 얼마나 잘 재구성하는지 확인하는 것입니다.
그런 다음 악보에서 합성하십시오. 참조 재합성은 명확하지만 악보 기반 출력이 흐릿하다면, 예측된 특징, 정렬 및 피치 컨디셔닝을 조사하십시오. 참조 재구성이 이미 거칠게 들린다면, 보코더 또는 특징 호환성을 먼저 해결하십시오.
파형 생성 전에 결함이 존재하는지 확인하기 전까지는 전체 모델을 교체하지 마십시오.
이러한 구분은 인접한 음성 도구를 평가할 때도 중요합니다. 텍스트 음성 변환 모델 목록은 다른 작업을 설명합니다. 명료한 음성 출력만으로는 지속음 품질이나 악보 제어를 확립할 수 없습니다.
실제 작업에 맞는 충실도와 지연 시간 선택하기
WaveNet과 같은 자기회귀 보코더는 오디오를 순차적으로 생성하여 지연 시간을 증가시킬 수 있습니다. LPCNet을 포함한 더 빠른 대안은 반응형 재생이 중요할 때 더 적합할 수 있습니다.
오프라인 렌더링의 경우, 보컬 디테일을 보존하기 위해 더 긴 대기 시간을 감수할 수 있습니다. 인터랙티브 작곡의 경우, 빠른 미리보기를 선호하고 더 높은 품질의 렌더링은 검토를 위해 남겨둘 수 있습니다.
의도한 워크플로우에서 생성 시간과 들리는 아티팩트를 모두 측정하십시오. 아름다운 단독 렌더링이라도 작은 멜로디 편집마다 방해한다면 유용성이 떨어지며, 반응형 미리보기가 시스템이 생성할 수 있는 최고의 최종 출력으로 오해되어서는 안 됩니다.
노래 음성 합성 시스템을 평가하는 방법
목소리가 음정에서 벗어나면서도 자연스럽게 들리거나, 음표를 정확하게 따르면서도 얇게 들릴 수 있습니다. 단 하나의 품질 점수로는 전체 성능을 설명할 수 없습니다. 생성된 신호 측정과 함께 청취자의 판단이 필요합니다.
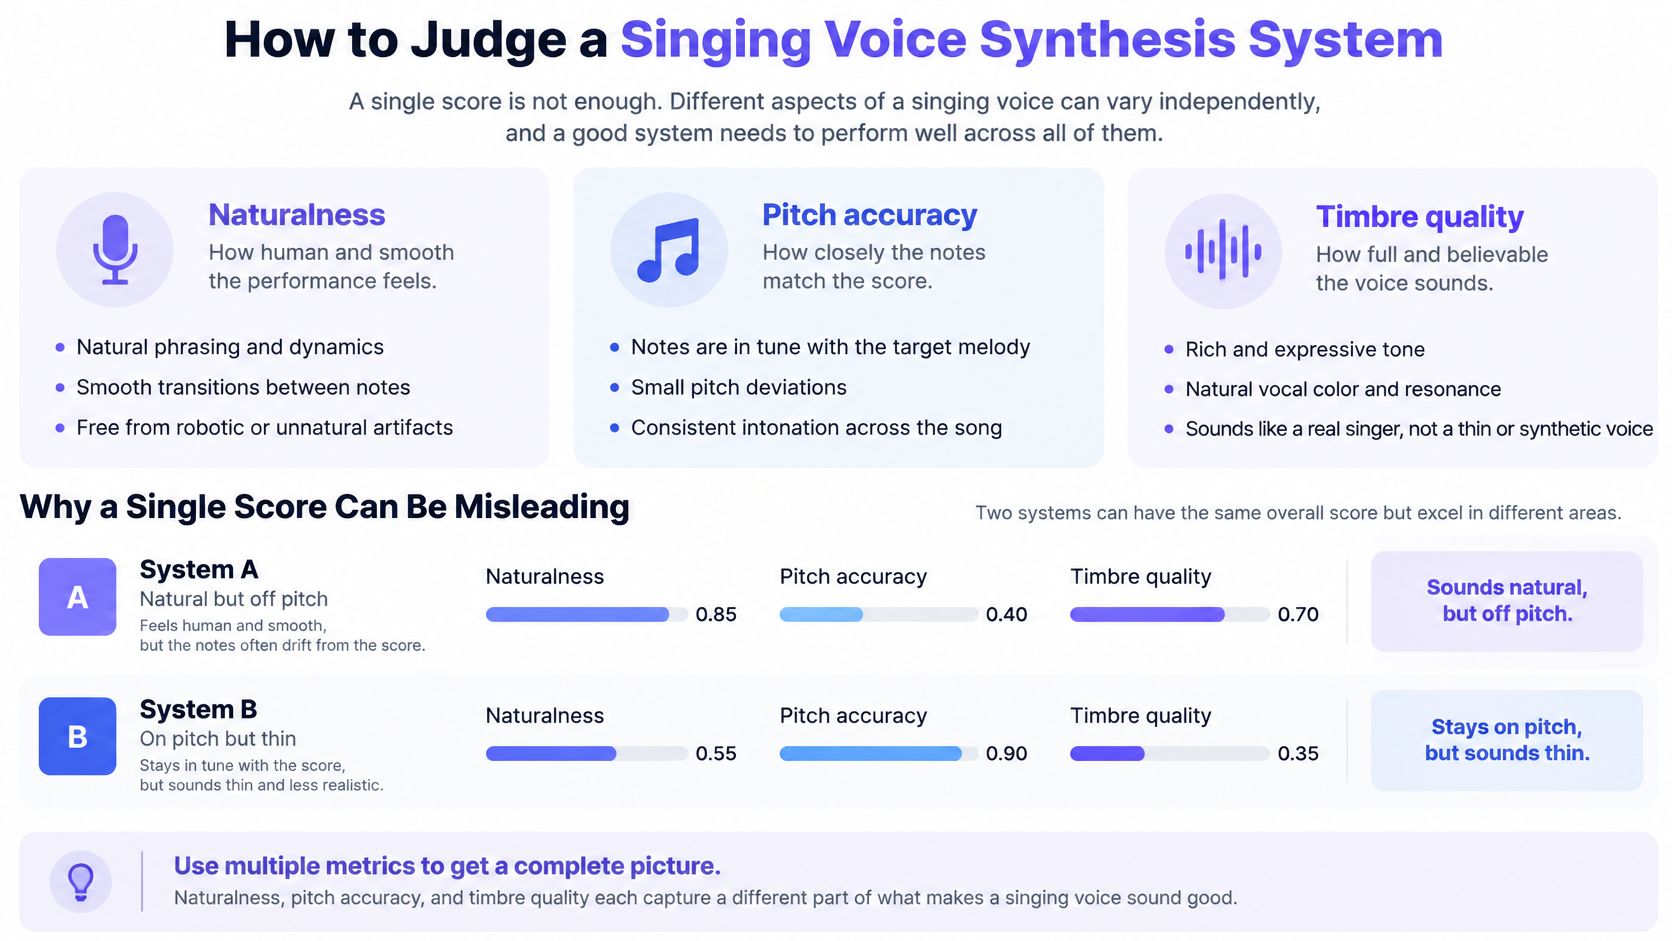
WeSinger 2 논문은 MOS, F0 제곱평균제곱근 오차, 멜 스펙트로그램 왜곡을 사용하여 노래 품질의 보완적인 측면을 검토합니다. 이 시스템의 다중 가수 조건부 적대적 훈련은 Opencpop 및 Data-L에서 이전 WeSinger 시스템보다 MOS를 향상시키지만, 데이터셋에 따라 비교 이득이 달라 가수 및 코퍼스 조건의 중요성을 강조합니다.
노래 음성 합성 품질 평가 지표
| 지표 | 포착하는 것 | 놓치는 것 |
|---|---|---|
| MOS | 청취자가 인지하는 전반적인 품질 | 음정 이탈 및 가수별 세부 사항을 숨길 수 있음 |
| F0 RMSE | 음정, 억양 및 튜닝 오류 | 숨소리, 발음 및 음색 |
| MSD | 음색 및 조음과 관련된 스펙트럼 불일치 | 구절이 표현력이 풍부하거나 스타일에 맞는지 여부 |
측정값을 함께 읽기
MOS, 즉 평균 의견 점수는 청취자 평가를 요약합니다. 사람들이 전반적인 결과를 선호하는지 묻는 데 유용하지만, 해석은 그들이 무엇을 들었고 무엇을 평가하도록 요청받았는지에 따라 달라집니다.
F0 RMSE는 인지된 음정과 관련된 음향량인 기본 주파수 오류를 측정합니다. 이는 튜닝 문제를 밝히는 데 도움이 되지만, 단어가 명료한지 또는 보컬 톤이 믿을 수 있는지 확립하지는 않습니다.
MSD는 스펙트럼 표현을 비교합니다. 이는 조음 및 음색과 관련된 차이를 드러낼 수 있지만, 참조 스펙트로그램과 일치시키는 것이 설득력 있는 예술적 선택을 하는 것과 같지는 않습니다.
청취 확인: 밀도 높은 믹스 안에서 보컬을 판단하기 전에 보컬만 들어보세요. 반주는 약한 자음과 불안정한 음표 끝을 알아차리기 어렵게 만들 수 있습니다.
익숙하지 않은 노래와, 시스템이 지원하는 경우, 보류된 가수를 포함하는 평가 세트를 구축하세요. 지속되는 모음, 자음이 많은 가사, 음역 변화, 의도적인 표현 타이밍이 필요한 구절을 포함하세요.
지표를 함께 보고한 다음, 숨소리, 발음 및 보컬 정체성을 특별히 들어보세요. 만약 공급업체가 헤드라인 자연스러움 점수만 제공한다면, 그것을 해당 청취 테스트에 대한 증거로 취급하고, 당신의 가사, 가수 및 편곡이 똑같이 잘 작동할 것이라는 증거로 여기지 마세요.
실용적인 용도, 한계 및 문화적 차이
작곡가는 세션을 준비하기 전에 합성 노래를 사용하여 코러스가 부르기 쉬운지 확인할 수 있습니다. 프로듀서는 하모니를 시연해 볼 수 있으며, 게임 팀은 캐릭터의 노래가 장면에 어떻게 어울리는지 테스트할 수 있습니다. 생성된 퍼포먼스가 사람들이 구체적인 제작 결정을 내리는 데 도움을 주기 때문에 이것들은 실용적인 용도입니다.
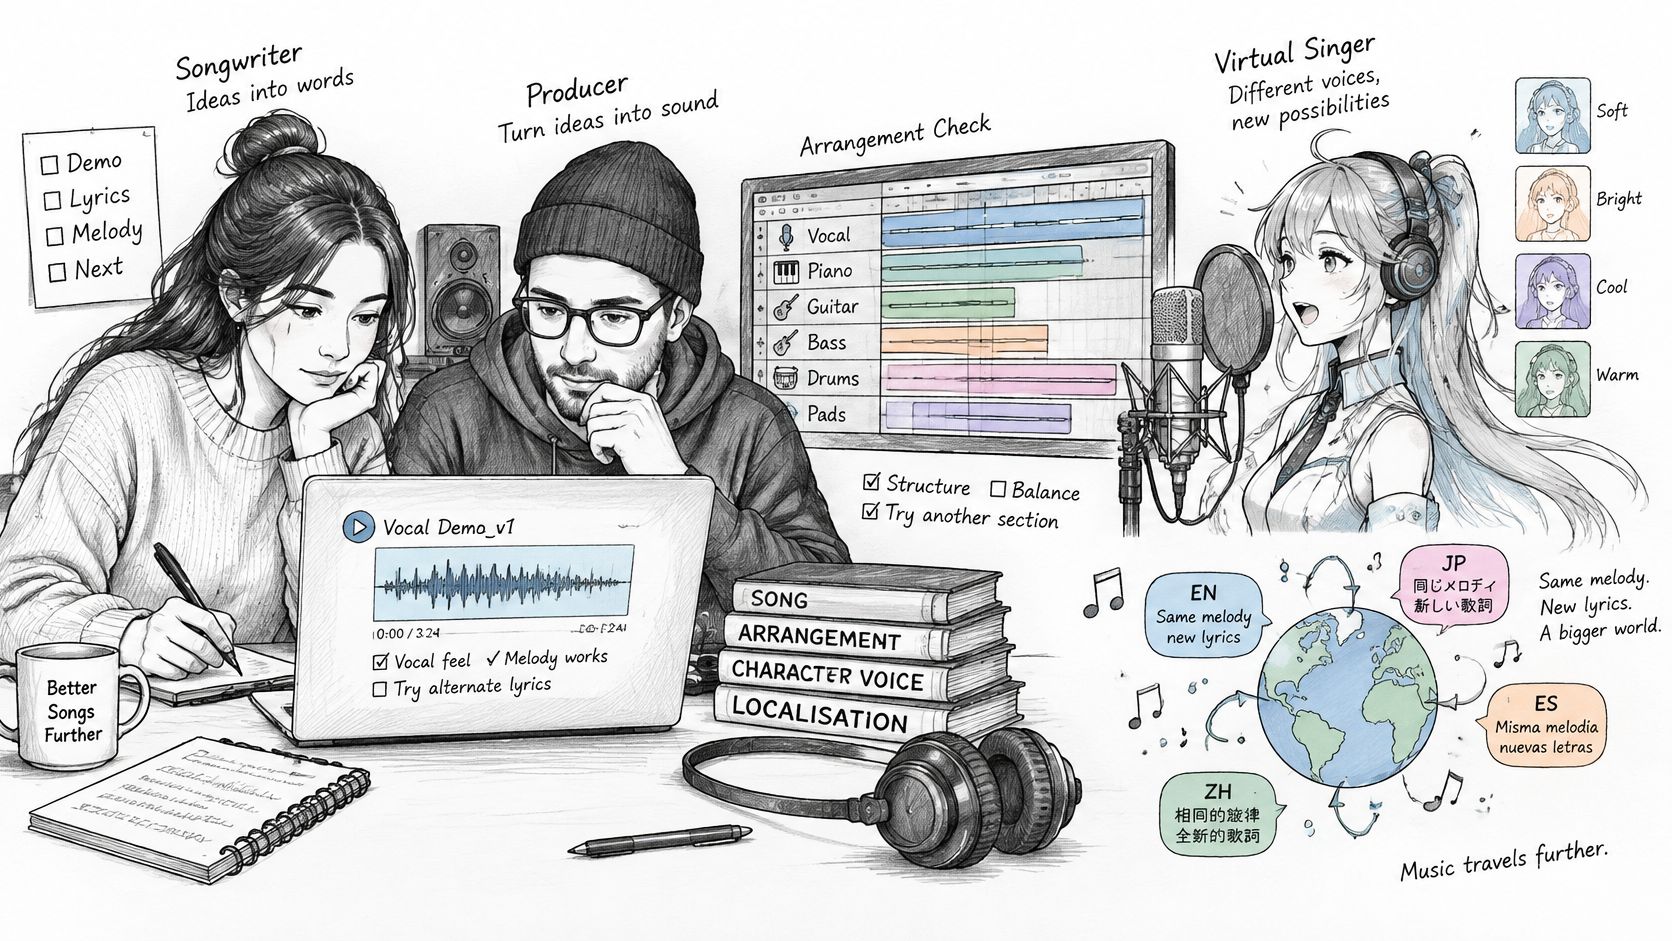
캐릭터 중심의 출시작과 애니메이션 프로토타입 또한 의도적으로 합성된 보컬 미학을 사용할 수 있습니다. 시청각 프로토타이핑을 위해 AI 뮤직 비디오 제작 가이드는 오디오 워크플로우를 시각적 제작과 연결하는 데 도움을 줄 수 있지만, 보컬은 여전히 자체적인 음악적 검토가 필요합니다.
단순히 정확한 음정뿐만 아니라 표현도 테스트하기
현지화는 겉보기에는 간단한 작업이 까다로워지는 유용한 예시입니다. 언어를 변경하면서 멜로디를 유지하는 것은 새로운 음절, 강세 패턴, 자음을 기존 구절에 맞춰 넣는 것을 의미합니다. 직역은 노래 가사로 부적합할 수 있습니다.
문화적으로 특정한 표현은 또 다른 층을 추가합니다. 인도 고전 성악에 대한 챕터는 특정 음정, 라가, 가수 및 음악적 맥락과 관련하여 장식을 설명하며, 이는 기존의 음정 및 명료도 측정으로는 놓칠 수 있는 세부 사항입니다.
결과가 인간처럼 들리는지 여부만 묻기보다는 목표 지향적인 테스트를 사용하십시오:
- 장식: 전통에 익숙한 음악가에게 음정 사이와 주변의 움직임을 판단하게 하십시오.
- 코드 스위칭: 구절 안에 언어 변경을 배치하고 억양, 강세 및 보컬 정체성의 연속성을 확인하십시오.
- 희귀 단어: 이름과 익숙하지 않은 가사 어휘를 테스트하고, 유창한 화자에게 발음을 평가하게 하십시오.
- 프레이징: 생성된 가수가 어디서 숨을 쉬는지, 단어를 강조하는지, 또는 지속되는 끝음을 풀어주는지 비교하십시오.
품질과 별개로 출처 확인하기
설득력 있는 보컬이 누가 그것을 불렀는지 확립하지는 않습니다. 국립사법연구소의 제1회 노래 음성 딥페이크 탐지 챌린지 보고서는 챌린지 환경에서 47개 참가 팀과 최고 팀의 **동등 오류율 1.65%**을 보고합니다.
그 결과는 특정 조건 하에서 측정된 탐지기 성능을 보여주는 것이지, 임의의 출시작에 대한 보장된 인증이 아닙니다. 탐지를 출처 기록, 소스 파일 및 문서화된 승인과 함께 하나의 확인 절차로 취급하십시오.
합성 노래는 초안, 프로토타입 및 의도적인 캐릭터 목소리에 특히 유용합니다. 최종 상업용 보컬, 특히 주요 출시작의 경우, 깨끗하게 들리는 데모만으로 승인하기보다는 음악적 표현, 언어 정확성, 정체성 및 출처에 대해 인간의 검토가 필요합니다.
노래 모델을 구축하거나 구매하기 전에 권리 확인
음성이 훈련, 복제 또는 출시되기 전에 누가 음성에 대한 권한을 부여했는지 확인해야 합니다. 보컬 녹음에는 연주자, 녹음 소유자, 작사가, 작곡가가 포함될 수 있습니다. 하나의 기여에 대한 허락이 다른 모든 것을 자동으로 해결하지는 않습니다.
노래 데이터 거버넌스에 대한 AI & Society 기사]는 표준 Creative Commons 라이선스가 노래 데이터 기여자들을 충분히 보호하지 못할 수 있다고 경고합니다. 녹음물에는 연주자의 목소리와 저작권으로 보호되는 노래가 모두 포함될 수 있기 때문입니다. 또한 미국 공정 사용 규칙과 EU 텍스트 및 데이터 마이닝 예외를 서로 교환 가능한 허락으로 취급하기보다는 구별합니다.
허용된 사용을 서면으로 명시
녹음물을 전송하거나 모델을 통합하기 전에 권리 체크리스트를 사용하세요:
- 관련 권리를 식별하세요. 가수의 녹음물, 가사, 작곡, 초상권, 그리고 의도된 상업적 출시에 관한 허락을 문서화하세요. 파일을 제공하는 사람이 모든 것을 통제한다고 가정하기보다는 각 사용을 누가 승인할 수 있는지 기록하세요.
- 모델 활동을 명시하세요. 계약이 훈련, 미세 조정, 음성 복제, 재배포 및 다운스트림 상업적 사용을 허용하는지 명시하세요. 오디오 트랙을 출판할 수 있는 라이선스가 재사용 가능한 음성 모델을 구축할 수 있는 허락이 되어서는 안 됩니다.
- 라이선스 약관을 읽으세요. Creative Commons 라벨에만 의존하지 마세요. 약관이 연주자의 기여와 원곡을 다루고 있는지 확인하세요.
- 적용 가능한 관할권을 확인하세요. 자격을 갖춘 변호사에게 녹음물, 기여자 및 배포에 관련된 규칙을 평가하도록 하세요. 다른 법률 시스템의 예외 조항을 귀하의 계약에 이식하지 마세요.
- 훈련 후 발생할 일을 계획하세요. 철회 절차, 모델 제거, 귀속 및 수익 공유를 정의하세요. 요청을 누가 처리하는지, 그리고 기술적으로나 계약적으로 어떤 구제책이 가능한지 명시하세요.
제작 자산과 함께 증거를 보관하세요
데이터셋 또는 프로젝트와 함께 허락 기록을 유지하세요. 계약 버전, 허용된 사용, 원본 녹음 식별자 및 배포 제한 사항을 포함하세요. 이를 통해 승인된 입력과 공유 폴더에 단순히 도착한 파일을 더 쉽게 구별할 수 있습니다.
공개적으로 이용 가능하다고 해서 동의나 소유권의 증거가 되는 것은 아닙니다. 또한 녹음물을 제거하겠다는 약속을 이미 훈련된 모델에서 그 영향력을 제거할 수 있는 입증된 능력과 혼동해서는 안 됩니다.
노래 모델을 구축하거나 구매하기 전에, 각 관련 권리, 허용된 활동 및 훈련 후 의무를 다루는 서면 약관을 확보하세요.
UberLLM은 텍스트, 이미지, 비디오, 음악 및 음성 모델을 위한 API입니다. 노래 관련 제작 워크플로를 구축하고 있다면, UberLLM]을 방문하여 모델 목록을 살펴보고 문서화된 입력값을 악보 제어, 오디오 출력 및 주변 미디어 작업에 대한 요구 사항과 비교해 보세요.