Sintesis Suara Bernyanyi: Cara Kerjanya dan Di Mana Kekurangannya
Pelajari bagaimana sintesis suara bernyanyi mengubah lirik dan not menjadi audio yang dinyanyikan, apa yang dikendalikan oleh data pelatihan dan vocoder, dan di mana ia masih memiliki kekurangan.
Anda telah menulis melodi, menyesuaikan liriknya, dan memuat penyanyi sintetis. Pemutaran pertama cukup menjanjikan, sampai sebuah kata melesat terlalu cepat, nada yang ditahan terdengar metalik, dan bagian chorus terdengar anehnya tanpa ekspresi. Masalah-masalah tersebut belum tentu memiliki penyebab yang sama. Memahami di mana setiap masalah masuk ke dalam rantai sinyal membuat perbaikan vokal jauh lebih mudah dan tidak lagi seperti permainan tebak-tebakan.
Daftar Isi
- Apa Itu Sintesis Suara Nyanyian dan Asal Mulanya
- Bagaimana Sistem Sintesis Suara Nyanyian Mengubah Partitur Menjadi Suara
- Mengapa Data Pelatihan Menentukan Kualitas Suara Nyanyian
- Model Akustik dan Vocoder Menentukan Kualitas Dihasilkan
- Cara Menilai Sistem Sintesis Suara Nyanyian
- Penggunaan Praktis, Batasan, dan Kesenjangan Budaya
- Konfirmasi Hak Sebelum Anda Membangun atau Membeli Model Nyanyian
Apa Itu Sintesis Suara Nyanyian dan Dari Mana Asalnya
Sintesis suara nyanyian (SVS) menghasilkan audio nyanyian dari lirik, urutan nada dengan tinggi dan durasi, dan, di banyak sistem, identitas penyanyi yang dipilih. Misalnya, Anda seorang penulis lagu dengan melodi yang sudah jadi tetapi tidak ada penyanyi yang tersedia. Anda memasukkan nada dan kata-kata untuk mendengar bagaimana baris vokal cocok dengan aransemen Anda.
Ini bukan hanya sintesis ucapan dengan trek latar musik. Kalimat yang diucapkan membutuhkan frasa yang meyakinkan, tetapi kalimat yang dinyanyikan juga harus mengikuti nada musik, mempertahankan vokal, dan menempatkan konsonan di sekitar ketukan. Suku kata yang dapat diterima dalam percakapan bisa terdengar canggung saat direntangkan di sepanjang nada panjang.
Dari fragmen rekaman hingga suara yang dipelajari
Pendekatan awal menggunakan aturan dan pemrosesan sinyal, diikuti oleh sistem yang merangkai unit vokal yang direkam. Pendekatan statistik dan neural kemudian mempelajari hubungan antara lirik, instruksi musik, dan keluaran akustik, daripada hanya mengandalkan penyambungan fragmen.
Menurut catatan Yamaha tentang pengembangan VOCALOID, proyek ini dimulai pada Februari 2000 melalui kolaborasi DAISY dengan Universitat Pompeu Fabra di Barcelona, dan produk komersial pertama muncul pada 2004. Para pengembang membutuhkan basis data nyanyian khusus karena input komputer biasa dan teknologi ucapan konvensional tidak dapat mereproduksi nyanyian dengan memadai.
Penyanyi virtual seperti Hatsune Miku juga membantu mengubah nyanyian sintetis menjadi medium kreatif yang berpusat pada karakter. Suara tersebut bisa menjadi bagian dari identitas artistik, bukan hanya trek pengganti dalam sesi rekaman.
Perbedaan penting: Menghasilkan pertunjukan musik dan mengontrol melodi nyanyian nada per nada bukanlah persyaratan yang sama.
Saat menelusuri daftar model penghasil musik, periksa kontrol input daripada berasumsi setiap alat musik menerima skor vokal. Untuk sistem nyanyian yang dapat digunakan, Anda perlu memahami rantai sinyalnya, mengenali batasan kualitasnya, dan menetapkan bagaimana suaranya dapat dievaluasi dan dilisensikan.
Bagaimana Sistem Sintesis Suara Nyanyian Mengubah Partitur Menjadi Suara
Apa yang masuk, dan apa yang keluar? Dalam alur kerja yang dikendalikan partitur, inputnya adalah serangkaian instruksi musik. Outputnya adalah bentuk gelombang yang dapat Anda putar, edit, dan campur.
Tahapan pipeline dalam sistem sintesis suara nyanyian
| Tahap | Input | Output | Apa yang Dikendalikan |
|---|---|---|---|
| Front end lirik dan partitur | Lirik, nada not dan durasi not | Urutan fonem dengan pengaturan waktu | Suara mana yang dinyanyikan pada ketukan mana |
| Model durasi dan nada | Fonem dan partitur | Pengaturan waktu tingkat frame dan kurva nada | Vibrato, serangan not dan akurasi nada |
| Model akustik | Fonem, pengaturan waktu, nada dan identitas penyanyi | Mel-spectrogram | Timbre, bentuk vokal dan artikulasi |
| Vocoder | Mel-spectrogram | Bentuk gelombang audio | Kejernihan, keheningan napas dan artefak yang terdengar |
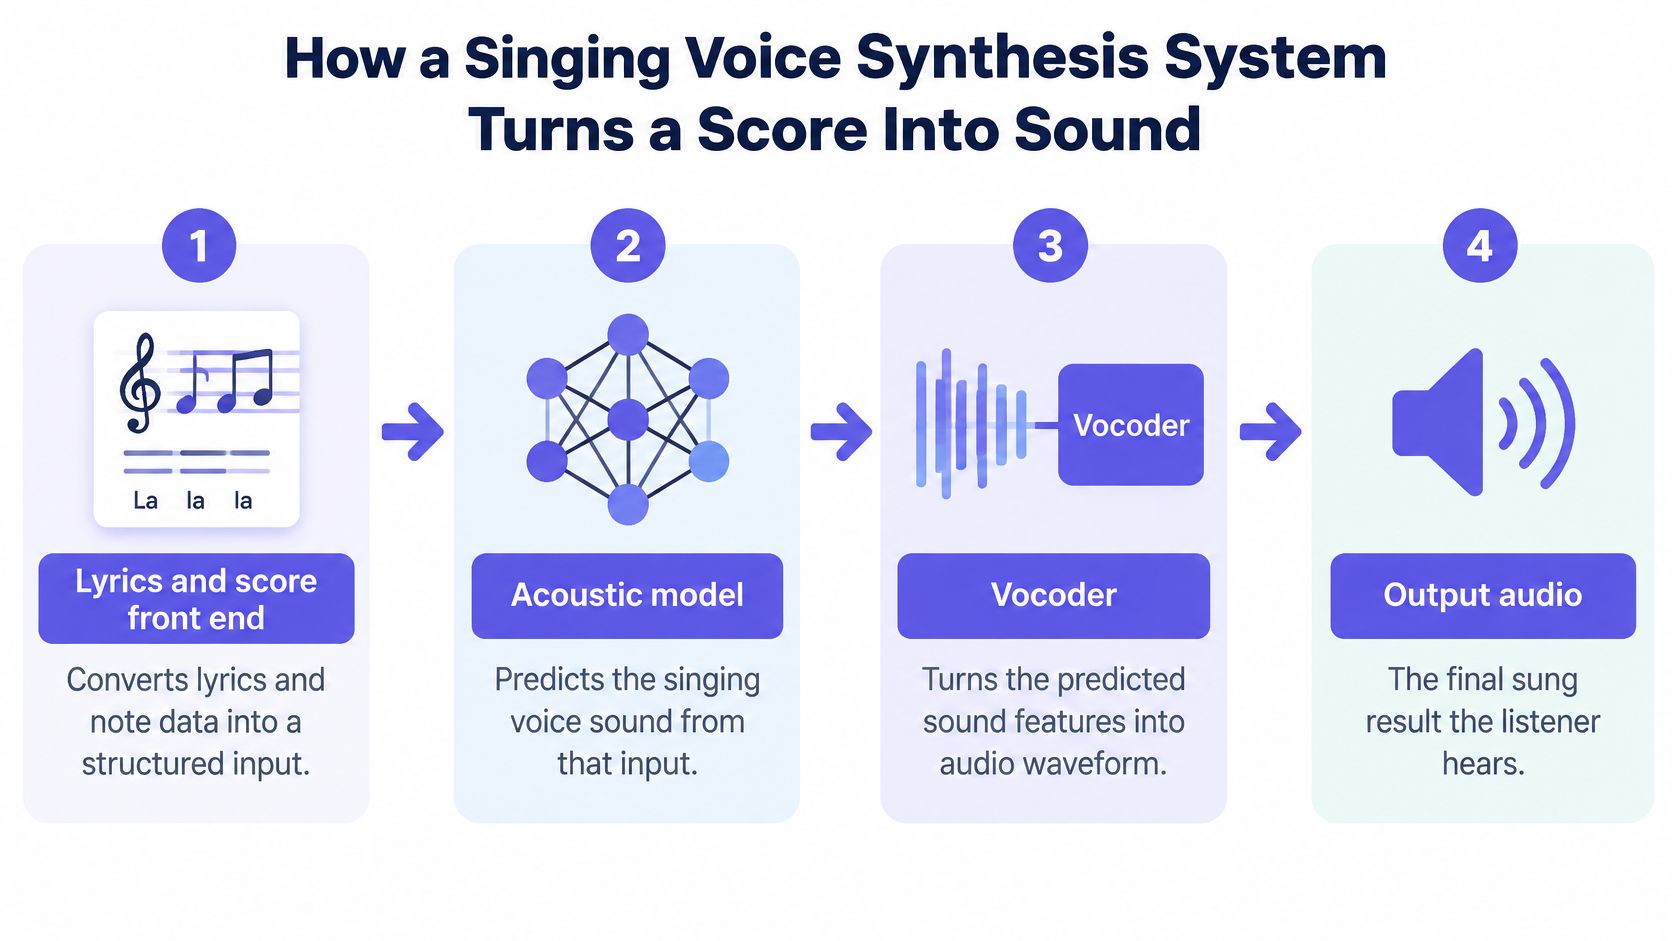
Ilustrasi ini menunjukkan alur yang lebih luas, dengan keputusan durasi dan nada yang digabungkan ke dalam proses prediksi.
Mengubah kata dan not menjadi sebuah penampilan
The front end memecah lirik menjadi fonem, yaitu suara ucapan individual dalam kata-kata, dan mengaitkannya dengan not. Sebuah suku kata tertulis bukanlah satu suara yang tidak terputus. Dalam stay, konsonan pembuka memerlukan perlakuan yang berbeda dari vokal yang membawa nada yang dipertahankan.
Jika sistem mengalokasikan terlalu banyak waktu untuk konsonan, vokal bisa datang terlambat. Jika memendekkan vokal untuk mengkompensasi, kata tersebut terdengar terburu-buru meskipun not berakhir tepat waktu. Mulailah dengan pengucapan dan penempatan fonem ketika sebuah lirik terasa salah secara ritmis.
The duration and pitch model memutuskan bagaimana suara-suara tersebut berkembang seiring waktu. Not menentukan target pitch, tetapi kurva pitch yang ditampilkan mungkin mencakup pendekatan yang lembut, pusat yang stabil, dan vibrato menjelang akhir. Kurva yang benar-benar datar bisa terdengar kaku; transisi yang berlebihan bisa terdengar seperti scoop yang tidak disengaja.
Beberapa alat menerima data not eksplisit, sementara yang lain menghasilkan atau menyimpulkan melodi dari input yang kurang terbatas, termasuk lirik. Perbedaan itu menentukan apakah Anda dapat memperbaiki not tertentu secara langsung atau harus meminta penampilan lain.
Mengubah deskripsi penampilan menjadi audio
The acoustic model memprediksi representasi seperti mel-spectrogram, yang menggambarkan bagaimana energi suara didistribusikan di seluruh frekuensi seiring waktu. Anggap saja sebagai peta nada suara yang berubah, bukan file audio yang sudah bisa Anda dengar.
Fitur spektral yang kurang terdefinisi dapat menghasilkan vokal yang tumpul, konsonan yang kabur, atau identitas vokal yang tidak stabil. Namun, ketumpulan saja tidak membuktikan bahwa model akustik bertanggung jawab. Generator bentuk gelombang akhir juga dapat mengaburkan detail yang berguna.
The vocoder mengubah representasi yang diprediksi menjadi sampel suara. Suara mendengung, kekasaran, atau tekstur metalik mungkin berasal dari sini, terutama pada vokal yang dipertahankan yang terekspos.
Sebelum mengedit, identifikasi apakah alat tersebut menerima not dan kontrol mana yang memengaruhi tahap yang dicurigai. Jangan mencoba memperbaiki konsonan yang salah tempat dengan equalization, atau bentuk gelombang yang kasar dengan menulis ulang lirik yang diucapkan dengan benar.
Mengapa Data Pelatihan Menentukan Seberapa Bagus Suara Nyanyian Terdengar
Merekam nyanyian hanyalah sebagian dari proses membangun dataset yang berguna. Pengembang juga memerlukan lirik yang andal, penyelarasan nada, pengaturan waktu fonem, dan anotasi yang membedakan ekspresi yang dimaksudkan dari kesalahan. Tanpa konteks tersebut, sebuah model mungkin mempelajari suatu peristiwa akustik tanpa mempelajari kapan seharusnya peristiwa itu terjadi.
Perbandingan korpus dalam survei dataset nyanyian mengilustrasikan skala terbatas dan cakupan penyanyi dari beberapa sumber daya berpengaruh, yang dirangkum di bawah ini.
Dataset nyanyian berdasarkan ukuran dan cakupan
| Korpus | Penyanyi | Jam | Apa yang Dicakup |
|---|---|---|---|
| VocalSet | 20 | Sekitar 10.1 | Teknik vokal, vokal dan nada bervariasi, bukan lagu lengkap |
| NUS-48E | 12 | Sekitar 2.8 | Korpus kecil dengan kumpulan penyanyi terbatas |
| MIR-1K | 19 | Sekitar 2.2 | Korpus kecil dengan kumpulan penyanyi terbatas |
| CSD | 1 | Sekitar 4.9 | 100 lagu dalam dua bahasa dari satu penyanyi |
| SingNet | Tidak disebutkan dalam ringkasan yang dikutip | Sekitar 3,000 | Nyanyian in-the-wild dan paket sampel lintas bahasa dan gaya |
Preprint SingNet melaporkan 2,629 jam nyanyian in-the-wild dan 321 jam dari paket sampel, dengan total sekitar 3,000 jam. Itu merupakan perluasan substansial dalam materi yang tersedia, tetapi ukuran koleksi bukanlah jaminan cakupan musikal.
Cakupan sama pentingnya dengan durasi
Fokus VocalSet pada teknik, vokal, dan nada membuatnya berguna untuk mempelajari perilaku vokal. Ini tidak membuatnya dapat dipertukarkan dengan korpus lagu-lagu lengkap yang diungkapkan secara ekspresif. Demikian pula, koleksi satu penyanyi dapat menawarkan konsistensi tanpa menunjukkan bahwa suatu sistem akan menggeneralisasi lintas identitas vokal.
Overfitting berarti sebuah model menjadi terlalu bergantung pada pola dalam materi pelatihannya. Dalam pendengaran praktis, itu mungkin berarti vokal familiar yang meyakinkan tetapi pengucapan asing yang canggung, atau hasil yang kuat dalam gaya yang terwakili dan hasil yang tidak meyakinkan di tempat lain.
Untuk pemilihan model, periksa:
- Cakupan penyanyi: Cari rentang vokal dan identitas yang didokumentasikan, bukan hanya durasi rekaman total.
- Cakupan bahasa: Periksa apakah bahasa lirik dan konvensi pengucapan Anda terwakili.
- Cakupan musikal: Bedakan latihan terisolasi dari frasa lengkap, transisi, dan ekspresi berkelanjutan.
- Kualitas anotasi: Cari penjelasan tentang bagaimana lirik dan nada diselaraskan dengan rekaman.
Pertanyaan yang berguna bukan hanya berapa banyak audio yang dikumpulkan oleh pengembang. Ini adalah seberapa dekat materi yang didokumentasikan cocok dengan performa yang Anda butuhkan. Dokumentasi yang hilang membatasi seberapa yakin Anda dapat menerapkan klaim kualitas di luar demonstrasi yang dipoles.
Model Akustik dan Vocoder Menentukan Kualitas Dicapai
Generator bentuk gelombang dapat secara signifikan mengubah kualitas nyanyian yang dipersepsikan bahkan ketika prediktor hulu tetap sama. Hal ini menjadikan vocoder sebagai pilihan rekayasa, bukan hanya langkah ekspor.
Dalam studi sintesis nyanyian neural terkontrol, model akustik berbasis CNN mengungguli jaringan feed-forward yang sesuai dalam uji kealamian, dan mengganti vocoder MLSA tradisional dengan WaveNet meningkatkan kedua keluarga model. Studi ini dilatih menggunakan 55 lagu anak-anak Jepang dan 55 lagu J-pop, menyisihkan lima lagu J-pop, dan menggunakan skor opini rata-rata lima poin dari 15 pendengar yang mengevaluasi frasa uji yang dipilih secara acak. Hasil-hasil tersebut mendukung perbandingan terkontrol, bukan peringkat universal di seluruh penyanyi, bahasa, atau genre.
Pisahkan kesalahan prediksi dari kesalahan rendering
Model akustik dapat memprediksi struktur vokal yang salah. Vocoder dapat merender prediksi yang masuk akal dengan buruk. Kedua kegagalan ini mungkin terdengar artifisial, tetapi mengganti komponen yang sama tidak akan memperbaiki keduanya.
Untuk sistem modular, uji vocoder menggunakan fitur akustik yang diekstraksi dari rekaman referensi yang bersih. Ini adalah uji resintesis: Anda memeriksa seberapa baik tahap bentuk gelombang merekonstruksi informasi yang sudah ada, daripada meminta prediktor akustik untuk menciptakannya.
Kemudian sintesis dari skor. Jika resintesis referensi jelas tetapi output berbasis skor keruh, selidiki fitur yang diprediksi, penyelarasan, dan pengkondisian nada. Jika rekonstruksi referensi sudah terdengar kasar, atasi vocoder atau kompatibilitas fitur terlebih dahulu.
Jangan ganti seluruh model sampai Anda memeriksa apakah cacat tersebut sudah ada sebelum generasi bentuk gelombang.
Perbedaan ini juga penting saat mengevaluasi alat suara yang berdekatan. Sebuah daftar model text-to-speech menjelaskan tugas yang berbeda; output ucapan yang dapat dimengerti saja tidak menetapkan kualitas nada yang dipertahankan atau kontrol skor.
Pilih fidelitas dan latensi untuk pekerjaan sebenarnya
Vocoder autoregresif mirip WaveNet menghasilkan audio secara berurutan, yang dapat meningkatkan latensi. Alternatif yang lebih cepat, termasuk LPCNet, mungkin lebih sesuai ketika pemutaran yang responsif penting.
Untuk rendering offline, Anda mungkin menerima penantian yang lebih lama untuk mempertahankan detail vokal. Untuk komposisi interaktif, Anda mungkin lebih memilih pratinjau cepat dan menyimpan render berkualitas lebih tinggi untuk ditinjau.
Ukur baik waktu generasi maupun artefak yang dapat Anda dengar di bawah alur kerja yang Anda inginkan. Render terisolasi yang indah kurang berguna jika mengganggu setiap pengeditan melodi kecil, sementara pratinjau yang responsif tidak boleh disalahartikan sebagai output akhir terbaik yang dapat dihasilkan sistem.
Bagaimana Menilai Sistem Sintesis Suara Nyanyian
Sebuah suara bisa terdengar alami meskipun melenceng dari nada, atau mengikuti nada dengan akurat meskipun terdengar tipis. Tidak ada satu pun skor kualitas yang dapat menggambarkan keseluruhan performa. Anda memerlukan penilaian pendengar di samping pengukuran sinyal yang dihasilkan.
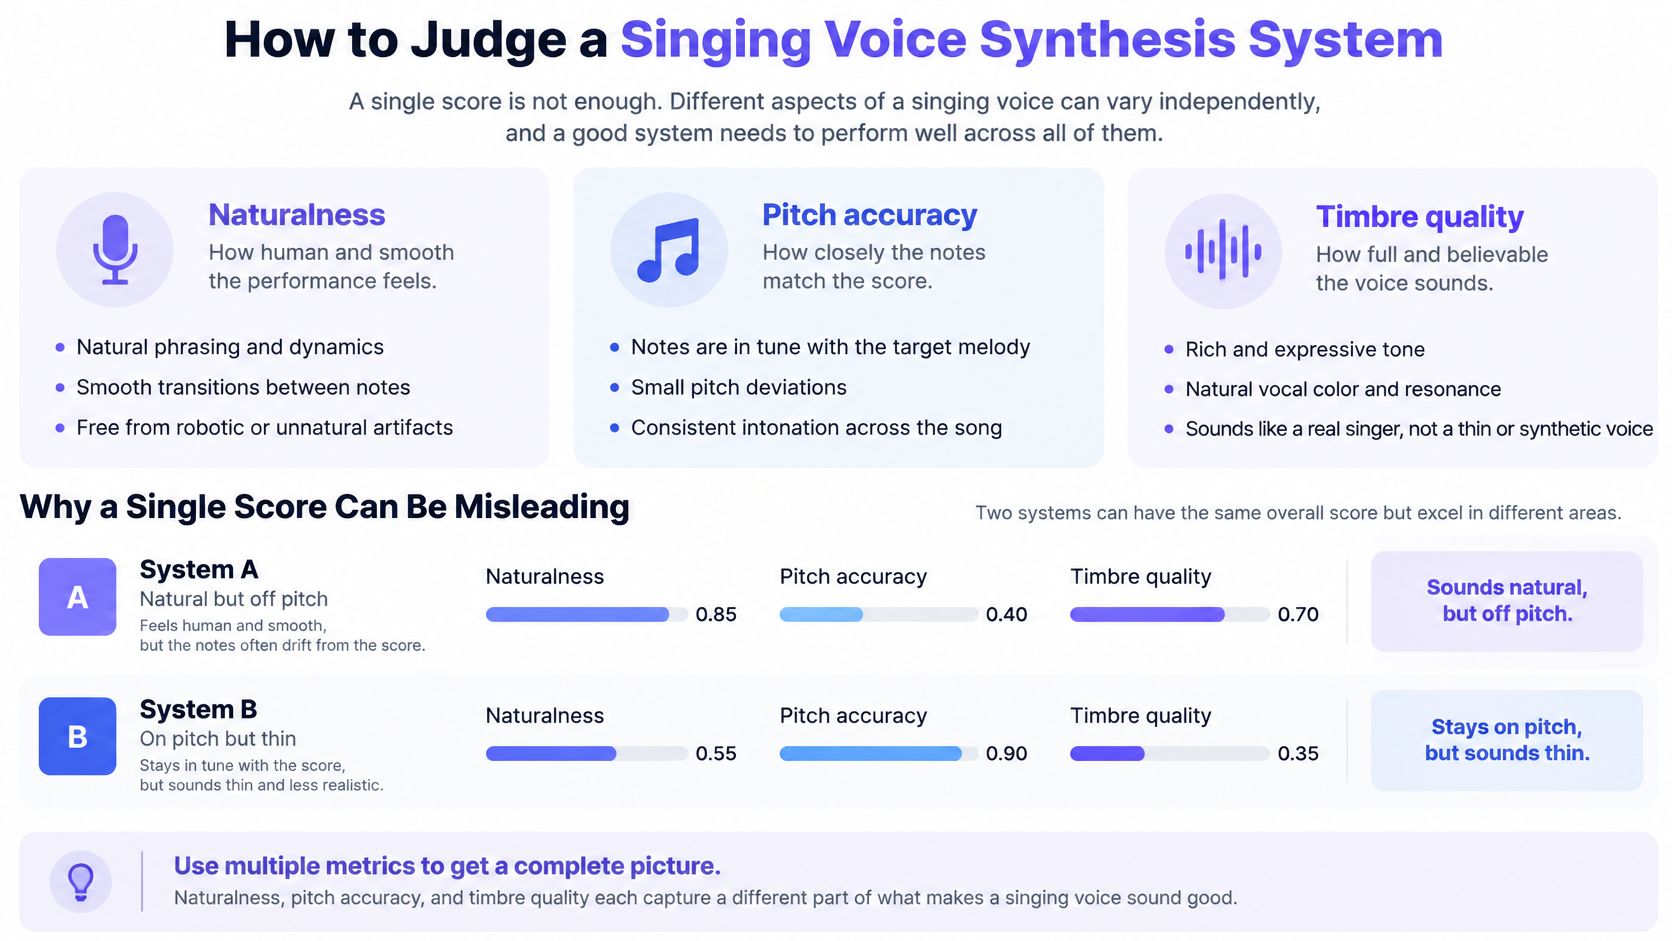
Makalah WeSinger 2 menggunakan MOS, F0 root-mean-square error, dan distorsi mel-spektrogram untuk menguji aspek komplementer dari kualitas nyanyian. Pelatihan adversarial kondisional multi-penyanyi mereka meningkatkan MOS dibandingkan sistem WeSinger sebelumnya pada Opencpop dan Data-L, tetapi peningkatan komparatif berbeda di seluruh dataset, menggarisbawahi pentingnya kondisi penyanyi dan korpus.
Metrik untuk menilai kualitas sintesis suara nyanyian
| Metrik | Apa yang Ditangkap | Apa yang Terlewat |
|---|---|---|
| MOS | Kualitas keseluruhan yang dirasakan pendengar | Dapat menyembunyikan pergeseran nada dan detail spesifik penyanyi |
| F0 RMSE | Kesalahan nada, intonasi, dan penyetelan | Kebernafasan, pengucapan, dan timbre |
| MSD | Ketidakcocokan spektral yang terkait dengan timbre dan artikulasi | Apakah sebuah frasa terasa ekspresif atau sesuai gaya |
Baca pengukuran secara bersamaan
MOS, atau mean opinion score, merangkum penilaian pendengar. Ini berguna untuk menanyakan apakah orang lebih menyukai hasil keseluruhan, tetapi interpretasi tergantung pada apa yang mereka dengar dan apa yang diminta untuk mereka nilai.
F0 RMSE mengukur kesalahan dalam frekuensi fundamental, kuantitas akustik yang terkait dengan nada yang dirasakan. Ini membantu mengungkapkan masalah penyetelan, tetapi tidak menetapkan bahwa kata-kata dapat dimengerti atau nada vokal dapat dipercaya.
MSD membandingkan representasi spektral. Ini dapat mengungkap perbedaan yang terkait dengan artikulasi dan timbre, tetapi mencocokkan spektrogram referensi tidak sama dengan membuat pilihan artistik yang meyakinkan.
Pengecekan pendengaran: Audisi vokal saja sebelum menilainya di dalam campuran yang padat. Iringan dapat membuat konsonan yang lemah dan akhiran nada yang tidak stabil lebih sulit diperhatikan.
Bangun set evaluasi yang berisi lagu-lagu yang tidak dikenal dan, jika sistem mendukungnya, penyanyi yang tidak termasuk dalam pelatihan. Sertakan vokal yang ditahan, lirik yang banyak konsonan, perubahan register, dan frasa yang memerlukan waktu ekspresif yang disengaja.
Laporkan metrik secara bersamaan, lalu dengarkan secara spesifik untuk kebernafasan, pengucapan, dan identitas vokal. Jika vendor hanya menawarkan skor kealamian utama, perlakukan itu sebagai bukti tentang uji pendengaran tersebut, bukan bukti bahwa lirik, penyanyi, dan aransemen Anda akan berfungsi sama baiknya.
Penggunaan Praktis, Batas, dan Kesenjangan Budaya
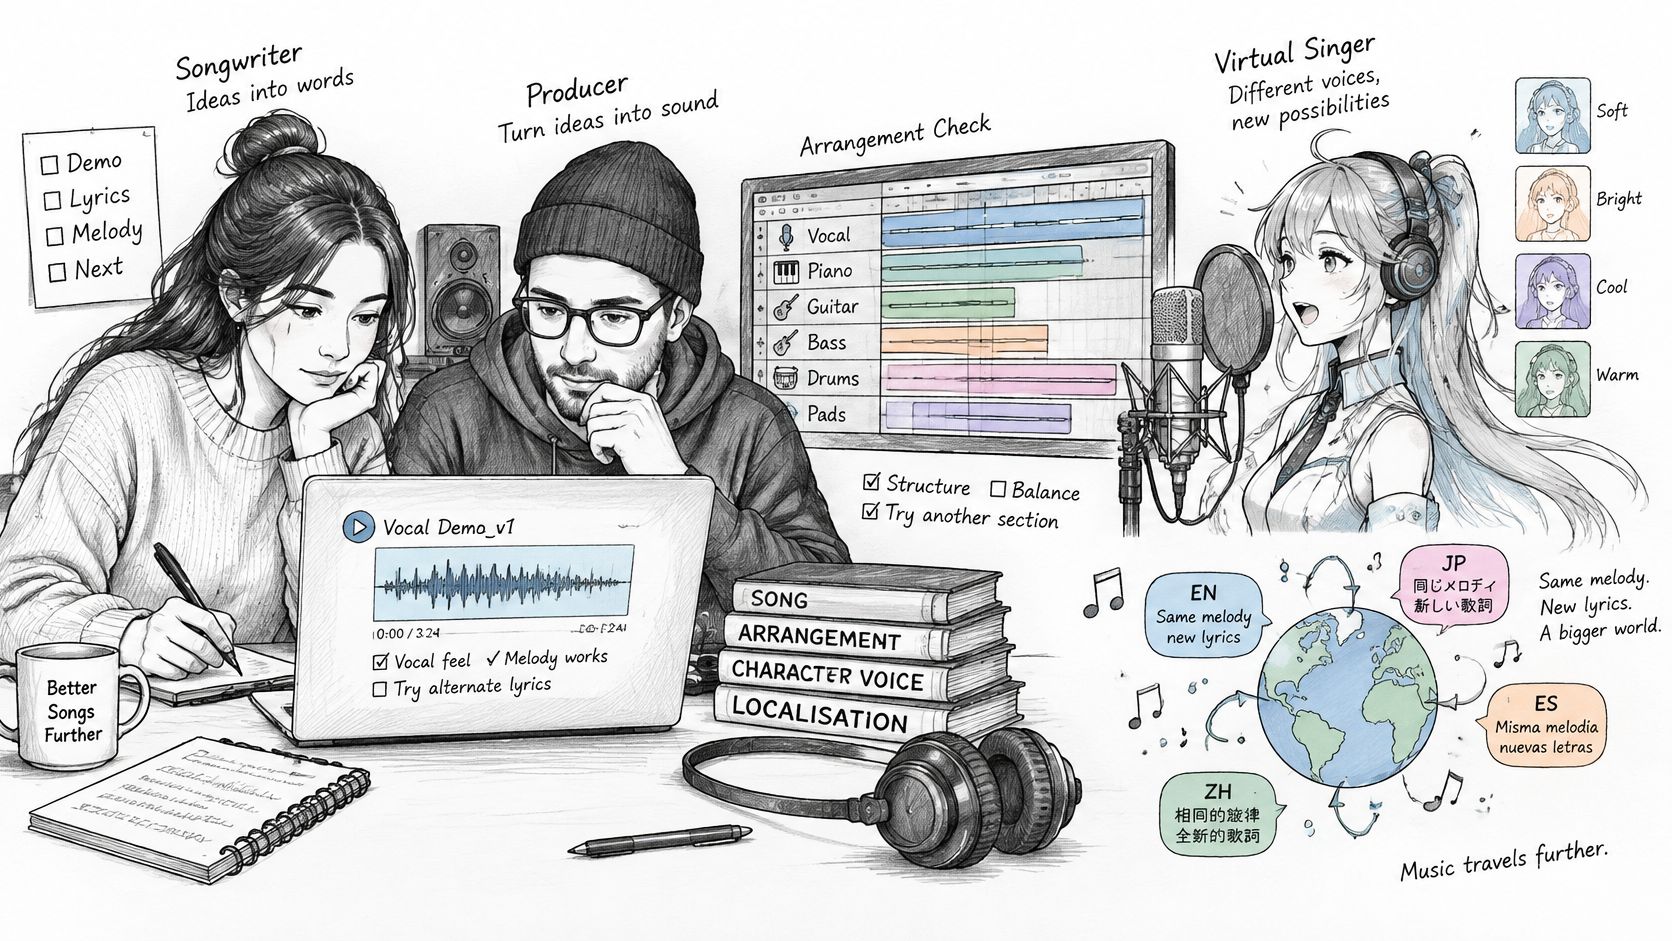
Seorang penulis lagu dapat menggunakan nyanyian sintetis untuk memeriksa apakah sebuah chorus dapat dinyanyikan sebelum mengatur sesi. Seorang produser dapat menguji harmoni, sementara tim game dapat menguji bagaimana lagu karakter cocok dengan sebuah adegan. Ini adalah penggunaan praktis karena performa yang dihasilkan membantu orang membuat keputusan produksi yang konkret.
Rilis yang berpusat pada karakter dan prototipe animasi juga dapat menggunakan estetika vokal yang sengaja disintetiskan. Untuk pembuatan prototipe audiovisual, panduan membuat video musik AI dapat membantu menghubungkan alur kerja audio ke produksi visual, tetapi vokal masih memerlukan tinjauan musiknya sendiri.
Uji ekspresi, bukan hanya nada yang benar
Lokalisasi adalah contoh yang berguna di mana tugas yang tampaknya sederhana menjadi menuntut. Mempertahankan melodi saat mengubah bahasa berarti menyesuaikan suku kata baru, pola tekanan, dan konsonan ke dalam frasa yang sudah ada. Terjemahan harfiah mungkin tidak cocok sebagai lirik yang dinyanyikan.
Ekspresi yang spesifik secara budaya menambah lapisan lain. Bab tentang nyanyian klasik India menjelaskan ornamen dalam kaitannya dengan nada tertentu, raga, penyanyi, dan konteks musik, detail yang mungkin terlewatkan oleh pengukuran nada dan inteligibilitas konvensional.
Gunakan tes yang ditargetkan daripada hanya bertanya apakah hasilnya terdengar seperti manusia:
- Ornamen: Minta seorang musisi yang akrab dengan tradisi untuk menilai pergerakan antara dan di sekitar nada.
- Pergantian kode: Tempatkan perubahan bahasa di dalam frasa dan periksa aksen, tekanan, dan kesinambungan identitas vokal.
- Kata-kata langka: Uji nama dan kosakata lirik yang tidak dikenal, lalu minta penutur fasih menilai pengucapan.
- Frasa: Bandingkan di mana penyanyi yang dihasilkan bernapas, menekankan sebuah kata, atau melepaskan akhiran yang dipertahankan.
Verifikasi asal terpisah dari kualitas
Vokal yang meyakinkan tidak membuktikan siapa yang menyanyikannya. Laporan National Institute of Justice tentang Tantangan Deteksi Deepfake Suara Nyanyian perdana melaporkan 47 tim peserta dan tingkat kesalahan yang sama sebesar 1.65% dari tim teratas dalam pengaturan tantangan tersebut.
Hasil tersebut menunjukkan kinerja detektor yang terukur di bawah kondisi tertentu, bukan jaminan autentikasi rilis acak. Perlakukan deteksi sebagai salah satu pemeriksaan bersama dengan catatan asal-usul, file sumber, dan otorisasi yang didokumentasikan.
Nyanyian sintetis sangat berguna untuk draf, prototipe, dan suara karakter yang disengaja. Vokal komersial akhir, terutama pada rilis besar, memerlukan tinjauan manusia untuk ekspresi musik, akurasi bahasa, identitas, dan asal-usul daripada persetujuan hanya berdasarkan demo yang terdengar bersih.
Konfirmasi Hak Sebelum Anda Membangun atau Membeli Model Bernyanyi
Siapa yang telah mengizinkan suara tersebut sebelum dilatih, dikloning, atau dirilis? Rekaman vokal dapat melibatkan seorang penampil, pemilik rekaman, penulis lirik, dan komposer. Izin terkait satu kontribusi tidak secara otomatis menyelesaikan yang lain.
Artikel AI & Society tentang tata kelola data nyanyian memperingatkan bahwa lisensi Creative Commons standar mungkin tidak cukup melindungi kontributor data nyanyian, karena rekaman dapat berisi suara seorang penampil dan lagu yang dilindungi hak cipta. Ini juga membedakan aturan penggunaan wajar AS dari pengecualian penambangan teks dan data UE daripada memperlakukannya sebagai izin yang dapat dipertukarkan.
Cantumkan Penggunaan yang Diizinkan secara Tertulis
Gunakan daftar periksa hak sebelum mentransfer rekaman atau mengintegrasikan model:
- Identifikasi hak-hak yang relevan. Dokumentasikan izin terkait rekaman penyanyi, lirik, komposisi, kemiripan, dan rilis komersial yang dimaksud. Catat siapa yang dapat mengizinkan setiap penggunaan daripada berasumsi bahwa orang yang menyediakan file mengendalikan segalanya.
- Spesifikasikan aktivitas model. Nyatakan apakah perjanjian mengizinkan pelatihan (training), fine-tuning, kloning suara (voice cloning), redistribusi, dan penggunaan komersial hilir. Lisensi untuk menerbitkan trek audio tidak boleh menjadi izin untuk membangun model suara yang dapat digunakan kembali.
- Baca ketentuan lisensi. Jangan hanya mengandalkan label Creative Commons. Periksa apakah ketentuan tersebut membahas kontribusi penampil dan lagu yang mendasarinya.
- Periksa yurisdiksi yang berlaku. Minta penasihat hukum yang berkualitas menilai aturan yang relevan dengan rekaman, kontributor, dan penerapan (deployment). Jangan memindahkan pengecualian dari sistem hukum lain ke dalam perjanjian Anda.
- Rencanakan apa yang terjadi setelah pelatihan. Definisikan prosedur pencabutan, penghapusan model, atribusi, dan pembagian pendapatan. Tentukan siapa yang menangani permintaan dan solusi apa yang tersedia secara teknis dan kontraktual.
Simpan Bukti Bersama Aset Produksi
Pertahankan catatan izin bersamaan dengan dataset atau proyek. Sertakan versi perjanjian, penggunaan yang diizinkan, pengidentifikasi rekaman sumber, dan batasan distribusi apa pun. Itu membuatnya lebih mudah untuk membedakan input yang diotorisasi dari file yang hanya tiba di folder bersama.
Ketersediaan publik bukanlah bukti persetujuan atau kepemilikan. Janji untuk menghapus rekaman juga tidak boleh disalahartikan dengan kemampuan yang ditunjukkan untuk menghilangkan pengaruhnya dari model yang sudah dilatih.
Sebelum membangun atau membeli model bernyanyi, dapatkan ketentuan tertulis yang mencakup setiap hak yang relevan, aktivitas yang diizinkan, dan kewajiban pasca-pelatihan.
UberLLM adalah API untuk model teks, gambar, video, musik, dan ucapan. Jika Anda membangun alur kerja produksi terkait nyanyian, kunjungi UberLLM untuk menjelajahi daftar model dan membandingkan input yang didokumentasikan dengan persyaratan Anda untuk kontrol skor, output audio, dan tugas media di sekitarnya.