Chi phí mô hình hóa là bao nhiêu? Giải thích về giá suy luận AI
Chi phí mô hình hóa trong 2026 là bao nhiêu? Giá AI hiện tại theo token và theo công việc, công thức tính hóa đơn hàng tháng và các chi phí ẩn có thể thay đổi nó.
Việc tạo ra các mô hình tiên tiến và việc sử dụng mô hình hàng ngày có những yếu tố kinh tế rất khác nhau: Phân tích chi phí đào tạo của Epoch AI ước tính rằng phần cứng chiếm 47%–67% chi phí phát triển mô hình tiên tiến, trong khi năng lượng chỉ chiếm 2%–6%. Tuy nhiên, đối với các nhà phát triển ứng dụng, câu hỏi quan trọng không phải là chi phí để xây dựng một mô hình là bao nhiêu. Mà là bạn sẽ trả bao nhiêu để hoàn thành một tác vụ hữu ích, bao gồm cả những yêu cầu cần thử lại.
Mục lục
- Giá hiện tại cho các mô hình văn bản, hình ảnh và video
- Cách ước tính hóa đơn mô hình hàng tháng
- Các yếu tố làm thay đổi chi phí suy luận
- Tại sao token rẻ hơn vẫn có thể dẫn đến hóa đơn cao hơn
- Độ tin cậy và cơ sở hạ tầng thay đổi chi phí thực tế như thế nào
- Đặt ngân sách của bạn trước khi cam kết với một mô hình
Giá hiện tại cho các Mô hình Văn bản, Hình ảnh và Video
Chi phí mô hình hóa là bao nhiêu? Đối với suy luận AI (AI inference), câu trả lời bắt đầu với đơn vị tính phí: văn bản sử dụng các token đầu vào và đầu ra, hình ảnh sử dụng hình ảnh hoặc megapixel, và video có thể sử dụng các job. Bài viết này đề cập đến giá sử dụng cho suy luận (inference), không phải ngân sách đào tạo. Ước tính được báo cáo của Stanford cho việc đào tạo Gemini 1.0 Ultra là $192 triệu, theo bài trình bày của Voronoi về ước tính AI Index, nhưng khách hàng API không phải trả trực tiếp chi phí phát triển đó.
Xu hướng lịch sử rất đáng chú ý. Chỉ số AI của Stanford 2025 đã đo lường chi phí truy vấn một hệ thống đạt hiệu suất cấp độ GPT-3.5 trên MMLU giảm từ khoảng $20 mỗi triệu token vào tháng 11 năm 2022 xuống còn $0.07 vào tháng 10 năm 2024. Đó là một so sánh cụ thể theo điểm chuẩn, không phải là báo giá hiện tại cho mọi mô hình có khả năng.
Giá mỗi đơn vị hiện tại theo loại mô hình
UberLLM liệt kê giá API trực tiếp theo từng mô hình cho 254 mô hình, bao gồm GPT, Claude, Gemini, DeepSeek, GLM, Qwen, Llama, Mistral và Kimi. Giá chat tách biệt đầu vào khỏi đầu ra.
| Mô hình | Đơn vị tính phí | Giá UberLLM | Giá niêm yết |
|---|---|---|---|
| Claude Opus 5.5, đầu vào | Mỗi 1M token đầu vào | $2.03 | $4.00 |
| Claude Opus 5.5, đầu ra | Mỗi 1M token đầu ra | $10.13 | $20.00 |
| Kimi K3, đầu vào | Mỗi 1M token đầu vào | $0.003 | $0.19 |
| Kimi K3, đầu ra | Mỗi 1M token đầu ra | $0.23 | $15.00 |
| FLUX 2 Pro hình ảnh | Mỗi hình ảnh | $0.0075 | $0.03 |
| Nano Banana 2 hình ảnh | Mỗi hình ảnh | $0.015 | $0.10 |
| FLUX.2 Klein 4B hình ảnh | Mỗi megapixel | $0.00015 | $0.015 |
| Veo 3.1 Full văn bản-thành-video | Mỗi job | $0.22 | $0.44 |
| Kling 3 Standard hình ảnh-thành-video | Mỗi job | $0.063 | $0.084 |
| LTX 2.3 Fast văn bản-thành-video | Mỗi job | $0.045 | $0.06 |
| Runway Gen-4 Turbo | Mỗi job | $0.0675 | Không có giá niêm yết được xác minh |
Sử dụng so sánh giá API video để kiểm tra các gói job trực tiếp trước khi ước tính chi tiêu truyền thông. Giá job chỉ có ý nghĩa khi đi kèm với cấu hình đầu ra mà bạn dự định yêu cầu.
Giá niêm yết là chi phí mà một yêu cầu thường tốn, không phải là mức trần. Đọc từng hàng bằng cách xác định đơn vị mà tính năng của bạn tiêu thụ, sau đó nhân đơn vị đó với mức sử dụng dự kiến. Đừng so sánh trực tiếp giá megapixel với giá mỗi hình ảnh mà không tính đến kích thước hình ảnh.
Cách ước tính hóa đơn mô hình hàng tháng
Xây dựng ước tính dựa trên các tính năng của sản phẩm, chứ không phải một khoản cấp phát token tổng hợp duy nhất. Một cuộc trò chuyện hỗ trợ, trích xuất tài liệu và xem trước video tiêu thụ các tài nguyên khác nhau, vì vậy việc kết hợp chúng quá sớm sẽ che giấu tính năng nào cần được chú ý.
Việc tính toán bắt đầu với khối lượng và mức sử dụng được đo lường.
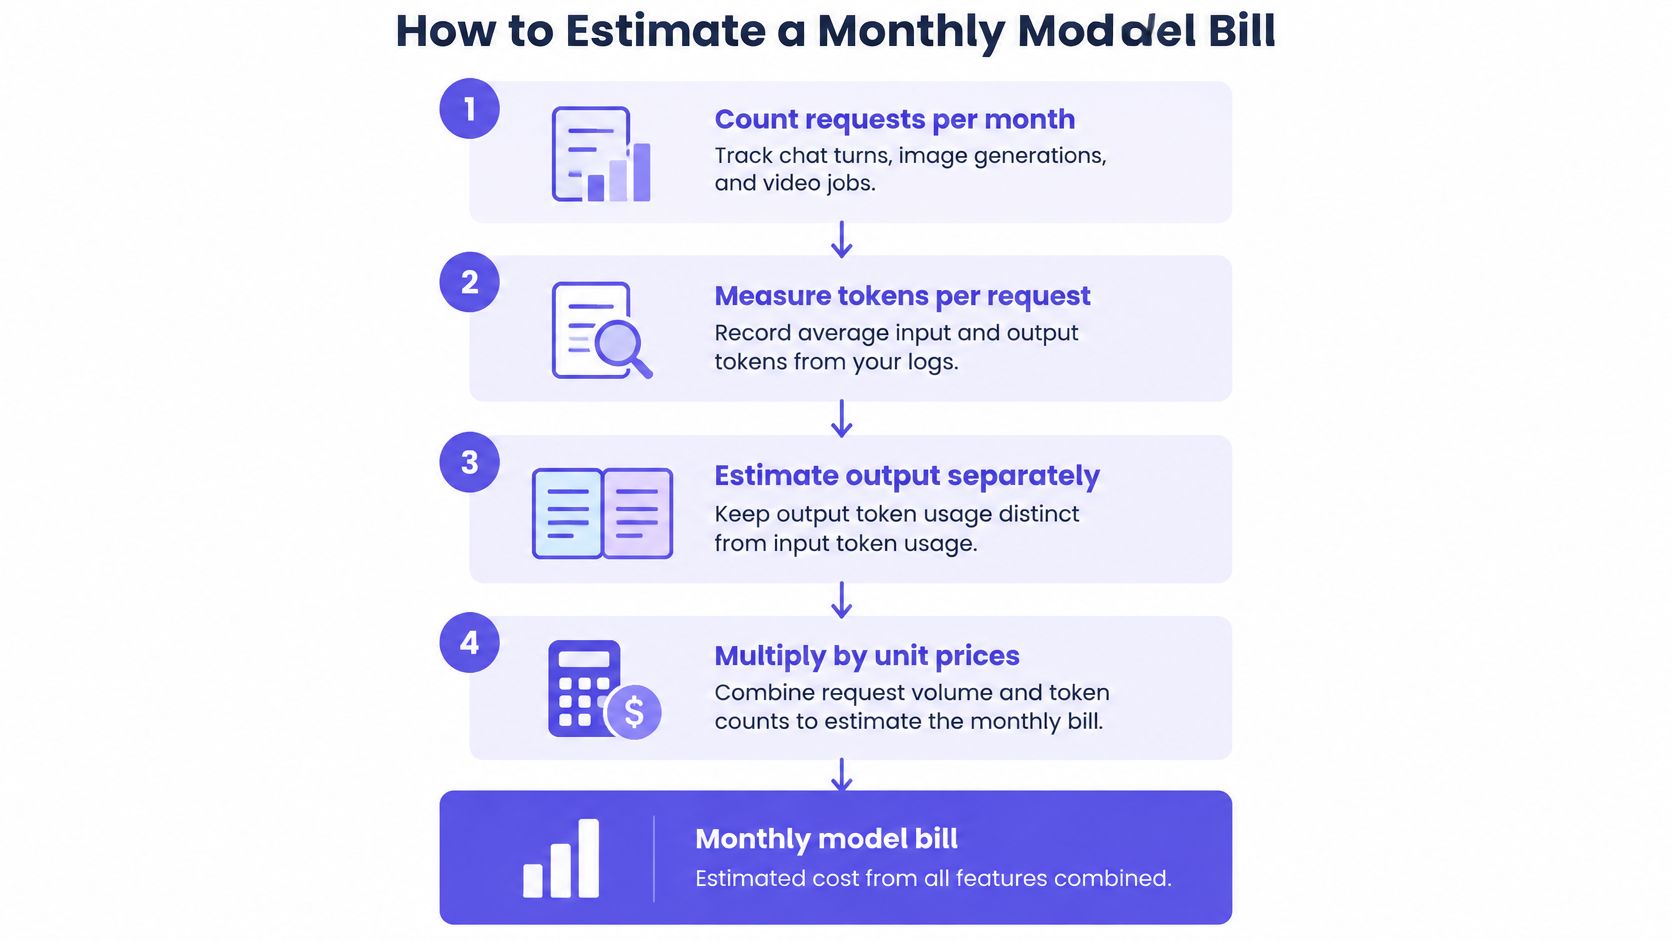
Đếm yêu cầu theo tính năng. Ghi lại các lượt trò chuyện, cuộc gọi xử lý tài liệu, tạo hình ảnh và công việc video một cách riêng biệt. Bao gồm các cuộc gọi nền, không chỉ các hành động hiển thị cho người dùng.
Đo lường đầu vào và đầu ra một cách độc lập. Thu thập số lượng token thực tế từ các trường sử dụng phản hồi và nhật ký. Bao gồm hướng dẫn hệ thống, lịch sử trò chuyện, các đoạn văn được truy xuất và kết quả công cụ trong phép đo đầu vào.
Áp dụng tỷ lệ chính xác của mô hình. Nhân số token đầu vào hàng tháng với tỷ lệ đầu vào và số token đầu ra hàng tháng với tỷ lệ đầu ra, sử dụng mẫu số thanh toán được hiển thị trong danh mục. Ghi lại mã định danh mô hình bên cạnh mỗi phép tính để việc thay đổi mô hình không làm mất hiệu lực dự báo.
Thêm đơn vị phương tiện. Nhân khối lượng hình ảnh, megapixel và công việc video với giá tương ứng của chúng. Giữ các công việc cụ thể theo cấu hình riêng biệt thay vì tính trung bình các đầu ra không liên quan.
Bao gồm các lần thử bổ sung. Phân biệt các lần thử lại của ứng dụng, các câu trả lời bị từ chối nhưng được tạo thành công và các lỗi của nhà cung cấp. Các yêu cầu hoặc lần tạo thất bại của chúng tôi không bị tính phí, nhưng một câu trả lời đã được gửi mà ứng dụng của bạn từ chối vẫn thể hiện công việc mà quy trình làm việc của bạn đã tiêu thụ.
Tính đến chi phí cấp vốn. Chúng tôi không thêm phí nào ngoài giá mô hình đã niêm yết, và không có phí hàng tháng hay mức tối thiểu. Việc nạp số dư thẻ có một khoản phí 5.5% cộng $0.50 đã được công bố, vì vậy hãy giữ khoản phí cấp vốn đó tách biệt khỏi chi tiêu yêu cầu.
Biến ước tính thành một ngân sách có thể sử dụng được
Phép tính văn bản cơ bản là:
Chi tiêu văn bản hàng tháng = phí token đầu vào + phí token đầu ra trên tất cả các lần thử.
Sau đó thêm chi tiêu phương tiện và bất kỳ dịch vụ ứng dụng hỗ trợ nào. Hướng dẫn về các mô hình định giá AI](https://uberllm.dev/guides/ai-pricing-models) giúp phân biệt các cấu trúc thanh toán trước khi bạn kết hợp chúng.
Ví dụ hàng tháng được công bố của chúng tôi tổng cộng là $113.00, so với $400.00 trên OpenRouter hoặc theo giá chính thức, một sự khác biệt $287.00. Hãy coi đó là một khối lượng công việc ví dụ, chứ không phải là một dự đoán cho một ứng dụng có sự kết hợp mô hình hoặc khối lượng đầu ra khác.
Quy tắc lập ngân sách: Giữ tổng số hàng tháng cho từng tính năng, chi phí trung bình cho mỗi yêu cầu và một khoản dự phòng riêng cho sự không chắc chắn. Tổng số tài khoản duy nhất không thể giải thích tại sao chi tiêu thay đổi.
Các Yếu Tố Thay Đổi Chi Phí Inference
Một lần gọi mô hình giống như cước taxi: quãng đường không phải là yếu tố duy nhất quyết định hóa đơn nếu thời gian chờ cũng quan trọng. Đối với inference, số lượng token chỉ là một phần của phép tính; hình dạng khối lượng công việc và yêu cầu phục vụ ảnh hưởng đến tài nguyên cần thiết để đưa ra câu trả lời.
Các yếu tố chi phí và tác động của từng yếu tố đến hóa đơn
| Yếu tố | Ảnh hưởng đến chi phí | Nên làm gì |
|---|---|---|
| Độ dài đầu ra | Phản hồi dài hơn tiêu thụ nhiều đầu ra được tính phí hơn | Giới hạn đầu ra và yêu cầu định dạng ngắn gọn |
| Cấp độ mô hình | Khả năng cao hơn có thể đi kèm với giá token cao hơn | Kiểm tra mô hình ít tốn kém nhất đáp ứng tiêu chuẩn chất lượng của bạn |
| Độ dài ngữ cảnh | Ngữ cảnh truy xuất dài làm tăng lưu lượng bộ nhớ và giảm thông lượng | Chỉ gửi các đoạn truy xuất có liên quan |
| Lượng tử hóa | Độ chính xác thấp hơn có thể cải thiện thông lượng nhưng ảnh hưởng đến chất lượng | Đánh giá độ chính xác đã triển khai trên các tác vụ đại diện |
| Đơn vị tính phí | Hình ảnh, megapixel và công việc video đo lường các đầu ra khác nhau | Ghép đơn vị với sản phẩm bàn giao của bạn |
| Cấp độ độ trễ | Dung lượng phù hợp cho công việc tương tác có thể có giá cao hơn | Ghép các yêu cầu phục vụ với khả năng chịu đựng của người dùng |
| Tạo lỗi | Các lần thử bổ sung tiêu tốn thời gian và có thể tạo ra công việc có thể tính phí | Phân biệt lỗi nhà cung cấp với từ chối ở cấp độ ứng dụng |
Một nghiên cứu inference trên GPU tiêu dùng ước tính chi phí chỉ riêng điện năng là $0.001–$0.005 mỗi triệu token cho các khối lượng công việc API thông thường, so với $0.14–$0.22 cho việc tạo được tăng cường truy xuất với ngữ cảnh 32K, và báo cáo rằng NVFP4 mang lại thông lượng cao gấp khoảng 1.6 lần BF16 với ít năng lượng hơn 41% và ước tính mất chất lượng 2%–4%.
Đó là ước tính chi phí vận hành chỉ riêng điện năng, không phải giá API cho khách hàng. Chúng không bao gồm phần còn lại của hoạt động kinh doanh phục vụ, và chúng không thể so sánh trực tiếp với tỷ lệ đầu vào và đầu ra được tính phí trong bảng giá.
Tự lưu trữ cần phép tính riêng
Một điểm chuẩn inference LLaMA cho thấy việc phục vụ một mô hình 65B yêu cầu khoảng 8–32 GPU, với mức tiêu thụ điện năng inference được báo cáo khoảng 300 watt đến 1 kilowatt, tùy thuộc vào cấu hình phân mảnh. Do đó, tự lưu trữ cần một phép tính về mức độ sử dụng, không chỉ là ước tính điện năng: bao gồm phần cứng, bộ nhớ, mạng, vận hành và dung lượng nhàn rỗi.
Sử dụng công cụ theo dõi thay đổi giá mô hình khi xem xét các lựa chọn thay thế. Chúng tôi cho phép bạn chuyển đổi mô hình bằng cách thay đổi ID mô hình, nhưng khả năng tương thích không đảm bảo chất lượng tương đương.
Chọn mô hình rẻ nhất vượt qua đánh giá của riêng bạn, sau đó giảm ngữ cảnh và đầu ra không cần thiết trước khi đàm phán mức giá thấp hơn.
Tại sao token rẻ hơn vẫn có thể dẫn đến hóa đơn cao hơn
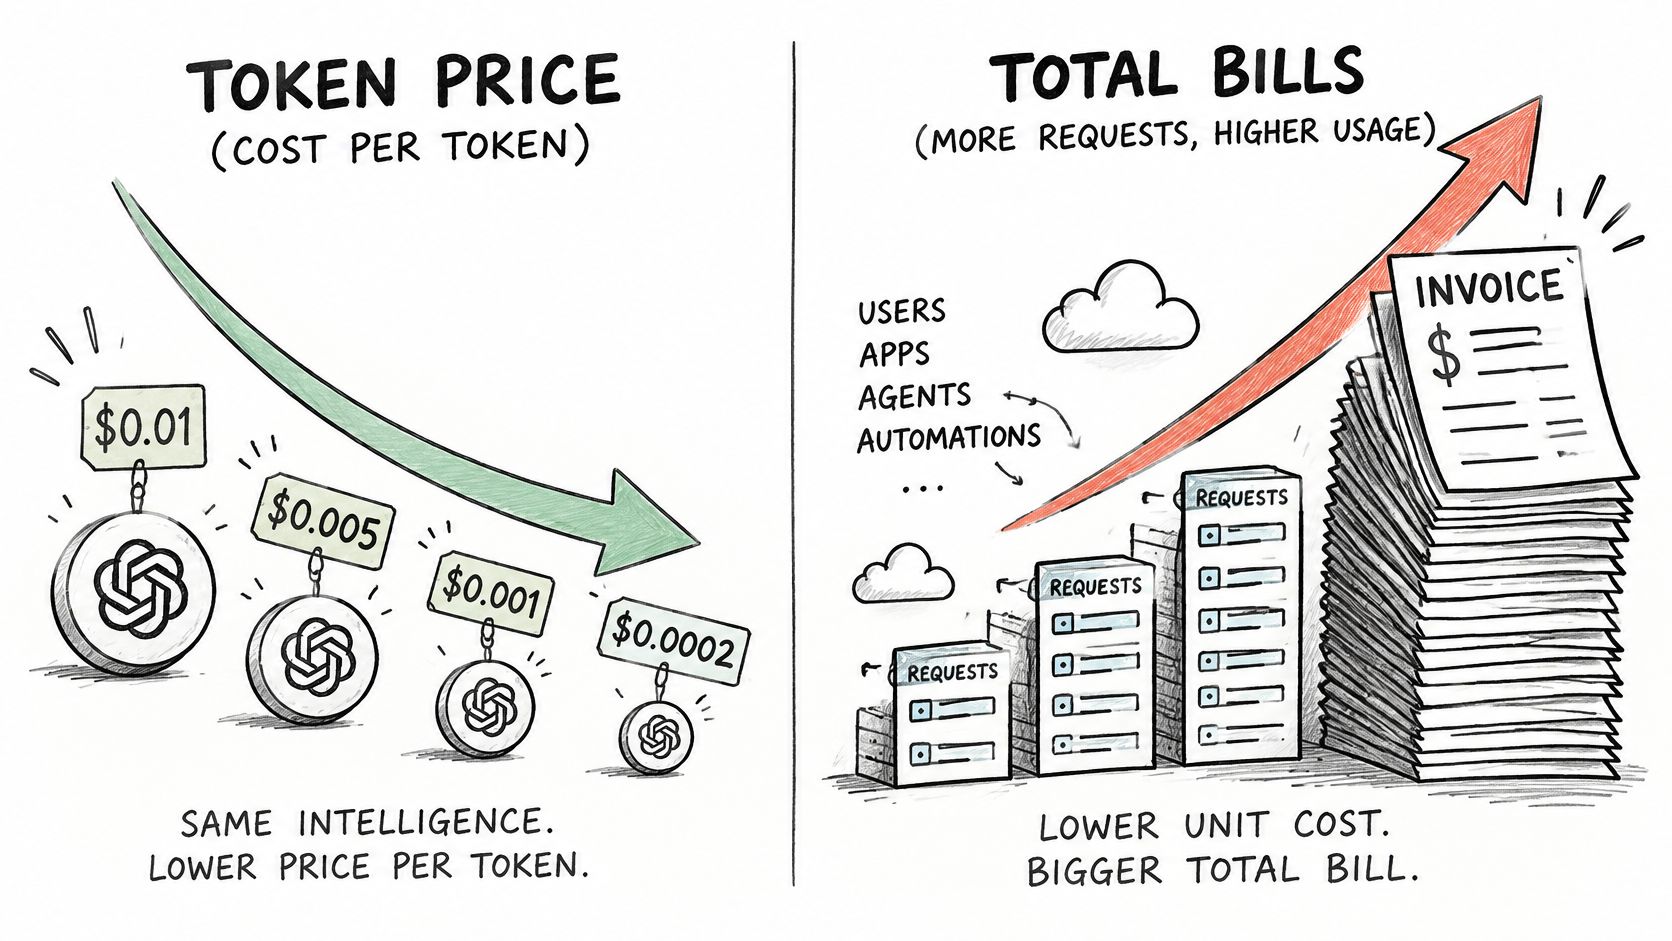
Một ước tính trong phân tích của TCS về chi tiêu AI tạo sinh dựa trên kết quả báo cáo rằng chi phí mỗi token đã giảm khoảng gấp 1,000 lần trong ba năm trong khi tổng chi tiêu suy luận tiếp tục tăng, và lưu ý rằng token đầu ra thường có giá cao hơn gấp ba đến sáu lần so với token đầu vào. Giá đơn vị thấp hơn không đảm bảo chi tiêu ứng dụng thấp hơn.
Sự khác biệt này dễ nhận thấy hơn khi giá cả và mức sử dụng di chuyển theo hướng ngược lại.
So sánh công việc đã hoàn thành, không phải các lần tạo riêng lẻ
Hãy xem xét một quy trình làm việc minh họa về trích xuất tài liệu. Mô hình giá thấp hơn tạo ra một giải thích dài dòng thay vì phản hồi có cấu trúc theo yêu cầu, vì vậy ứng dụng của bạn gửi yêu cầu sửa chữa. Nếu phản hồi đã sửa vẫn không vượt qua xác thực, quy trình làm việc sẽ được chuyển lên một mô hình mạnh hơn.
Mô hình thay thế tốn nhiều chi phí hơn cho mỗi token đầu ra nhưng trả về kết quả có cấu trúc chấp nhận được ngay lập tức. Tỷ lệ đơn vị cao hơn của nó có thể tạo ra tổng chi phí nhiệm vụ thấp hơn vì bạn tránh được lời nhắc sửa chữa, ngữ cảnh tài liệu lặp lại và việc tạo dự phòng.
Kết quả đó không phải là điều không thể tránh khỏi. Đó chính xác là điều mà một đánh giá đại diện nên xác định.
Chi phí cho mỗi nhiệm vụ hoàn thành = tổng chi tiêu quy trình làm việc ÷ số nhiệm vụ hoàn thành thành công.
Bao gồm truy xuất, gọi công cụ, rào chắn bảo vệ và leo thang con người khi chúng thuộc về quy trình làm việc đó. Xác định thành công trước khi đo lường: một câu trả lời đã đến không nhất thiết là một câu trả lời mà sản phẩm của bạn có thể sử dụng.
Sự khác biệt này cũng quan trọng khi diễn giải các cuộc thảo luận rộng hơn về kinh tế học AI.
Chẩn đoán con đường tốn kém
Theo dõi độ dài lời nhắc, độ dài đầu ra, lỗi xác thực và quyết định dự phòng cùng với chi tiêu. Một lần thử đầu tiên rẻ tiền vẫn có thể đáng giá nếu nó giải quyết các trường hợp thông thường và leo thang các trường hợp khó một cách có chọn lọc. Nó trở nên lãng phí khi gần như mọi nhiệm vụ đều phải trả tiền cho cả lần thử ban đầu và lần dự phòng.
Đừng loại bỏ các kiểm tra chất lượng chỉ để cải thiện tỷ lệ thành công rõ ràng. Điều đó thay đổi định nghĩa về thành công thay vì giảm chi phí cho công việc hữu ích.
Kiểm tra quyết định: Một quy trình làm việc được chấp nhận sẽ tốn bao nhiêu chi phí sau các đầu ra dài, các lần thử lại và các dịch vụ hỗ trợ, chứ không chỉ sau lần gọi mô hình đầu tiên của nó?
Độ tin cậy và hạ tầng thay đổi chi phí thực tế như thế nào
Một mức giá niêm yết không đảm bảo rằng dung lượng phù hợp sẽ có sẵn khi ứng dụng của bạn cần. Khu vực, cam kết, yêu cầu về độ trễ và loại dung lượng đều ảnh hưởng đến việc so sánh.
Một công cụ theo dõi giá GPU và chi phí suy luận đã báo cáo giá H100 từ khoảng $0.34 mỗi giờ trên các phiên bản spot đến khoảng $3.46 mỗi giờ trung bình, cùng với ước tính $0.50–$3 mỗi triệu token đầu ra cho dịch vụ có khả năng tương đương trên các nhà cung cấp, cấp độ độ trễ và cửa sổ ngữ cảnh. Các phạm vi đó mô tả các điều kiện mua khác nhau, không phải các ưu đãi có thể thay thế cho nhau.
Công việc theo lô và công việc tương tác cần dung lượng khác nhau
Đối với xử lý theo lô, một endpoint không đắt có thể chấp nhận được ngay cả khi thời gian hoàn thành dao động. Một hàng đợi phân loại tài liệu có thể tạm dừng hoặc lên lịch lại công việc nếu ứng dụng theo dõi trạng thái công việc và ngăn chặn xử lý trùng lặp. Trả thêm tiền cho các phản hồi tức thì có thể không mang lại nhiều giá trị.
Đối với các sản phẩm tương tác, cùng một endpoint có thể là một lựa chọn kém. Nếu người dùng từ bỏ một yêu cầu trước khi nó hoàn thành, việc tạo ra thành công về mặt kỹ thuật vẫn có thể thất bại về mặt thương mại. Một endpoint đắt hơn có thể đáng giá khi nó giảm các lần thử lại do hết thời gian chờ, các phiên bị bỏ dở hoặc các can thiệp hỗ trợ.
So sánh cả hai tùy chọn dưới mức độ đồng thời đại diện. Đo thời gian đến token đầu tiên, độ trễ hoàn thành, độ trễ đuôi và hoàn thành tác vụ được chấp nhận, thay vì dựa vào thử nghiệm endpoint nhàn rỗi.
Định tuyến thay đổi so sánh vận hành
Chúng tôi định tuyến mỗi yêu cầu đến nhà cung cấp khỏe mạnh rẻ nhất và chuyển nó sang một nhà cung cấp khỏe mạnh khác khi một nhà cung cấp trở nên chậm hoặc không khả dụng. Điều đó giảm nhu cầu ứng dụng của bạn phải triển khai mọi đường dẫn phục hồi dành riêng cho từng nhà cung cấp, nhưng bạn vẫn nên kiểm tra hành vi đầu cuối.
Nếu không có nhà cung cấp nào có thể phục vụ một mô hình, API sẽ trả về 503 no_available_provider, và không có gì được tính phí. Đối với video, phản hồi nêu rõ chi phí tối đa mà công việc có thể tốn trước khi quá trình tạo bắt đầu. Cả hai hành vi này đều không loại bỏ nhu cầu xử lý dung lượng không khả dụng hoặc kết quả bị trì hoãn trong sản phẩm của bạn.
Đặt các giá trị này trước khi so sánh các endpoint:
- Mục tiêu khả dụng: Xác định khi nào một tính năng phải hoạt động và hành vi suy giảm nào là chấp nhận được.
- Mục tiêu độ trễ: Chỉ định thời gian phản hồi mà người dùng cần, bao gồm cả hành vi đuôi chậm.
- Giá trị chuyển đổi dự phòng: Quyết định những gián đoạn nào biện minh cho dung lượng thay thế hoặc một mô hình khác.
- Mức trần chi phí tác vụ: Đặt mức chi tiêu tối đa chấp nhận được về mặt kinh tế cho một kết quả được chấp nhận.
Một so sánh mua sắm hữu ích sẽ giữ các yêu cầu đó không đổi. Nếu không, bạn đang so sánh các dịch vụ khác nhau thông qua cùng một cột giá.
Đặt Ngân Sách Trước Khi Cam Kết Với Một Mô Hình
Chỉ cam kết với một mô hình sau khi bạn có thể liên kết giá của nó với ngân sách cấp tính năng và một bài kiểm tra chấp nhận có thể đo lường được. Một phản hồi đầy hứa hẹn từ sân chơi chỉ là điểm khởi đầu, không phải bằng chứng cho thấy toàn bộ quy trình làm việc là tiết kiệm.
Đặt các kiểm soát xung quanh việc đánh giá
Chọn đơn vị thanh toán của từng tính năng. Ghi lại xem sản phẩm bàn giao tiêu thụ input tokens, output tokens, hình ảnh, megapixel hay jobs. Giữ cấu hình yêu cầu bên cạnh đơn vị đó để thay đổi về kích thước hình ảnh hoặc cài đặt video sẽ kích hoạt việc xem xét ngân sách.
Xây dựng dự báo cấp tính năng. Sử dụng khối lượng yêu cầu và mức sử dụng đã quan sát được từ một mẫu đại diện. Bao gồm toàn bộ đường dẫn thực thi, kể cả xử lý nền và các cuộc gọi sửa chữa do ứng dụng định hướng, thay vì chỉ ước tính từ lời nhắc hiển thị của người dùng.
Gửi giới hạn giá cùng với các yêu cầu. Sử dụng kiểm soát
max_pricehoặcmax_costáp dụng. Một yêu cầu không bao giờ được tính phí vượt quá giá trị bạn gửi, vì vậy một giới hạn có thể thực thi hữu ích hơn là giả định giá danh mục điển hình là mức tối đa được đảm bảo.Phân bổ số dư chung một cách có chủ đích. Một số dư bao gồm các mô hình văn bản, hình ảnh, video và âm nhạc. Duy trì hồ sơ chi tiêu cấp tính năng để một thử nghiệm truyền thông không làm lu mờ số tiền cần thiết cho một quy trình làm việc văn bản đã được thiết lập.
Đánh giá một mô hình thay thế. API của chúng tôi cung cấp một key cho mọi mô hình với giá niêm yết hoặc thấp hơn. Thay đổi định danh mô hình trong khi giữ nguyên hướng dẫn nhiệm vụ và tiêu chí chấp nhận, sau đó so sánh các sản phẩm bàn giao thu được thay vì chọn câu trả lời nào nghe có vẻ trau chuốt nhất.
Chạy thử nghiệm sản xuất có giới hạn. Chọn một khoảng thời gian xem xét nắm bắt được lưu lượng truy cập thông thường và khó khăn. So sánh chi phí đo được trên mỗi nhiệm vụ được chấp nhận với dự báo của bạn trước khi mở rộng quyền truy cập hoặc tăng đồng thời.
Điều tra sự khác biệt trước khi chuyển đổi nhà cung cấp
Sử dụng sân chơi trên bảng điều khiển để so sánh đầu ra và điều chỉnh các tham số trước khi tích hợp sản xuất. Đối với trích xuất, hãy kiểm tra sự tuân thủ schema và liệu các trường có được tài liệu hỗ trợ hay không. Đối với mã hóa, hãy đánh giá xem thay đổi được đề xuất có đáp ứng nhiệm vụ và vượt qua các kiểm tra liên quan hay không.
Khi chi phí đo được vượt quá dự báo, hãy kiểm tra output length, retry behavior và context size trước tiên. Sau đó, kiểm tra xem ứng dụng của bạn có thay đổi khối lượng công việc hay không, chẳng hạn như đính kèm toàn bộ lịch sử cuộc trò chuyện hoặc liên tục cung cấp cùng một tài liệu. Đừng cho rằng hóa đơn cao hơn có nghĩa là tỷ lệ niêm yết đã tăng.
Mở bảng giá trực tiếp trong tuần này, xác định tính năng chịu trách nhiệm cho phần lớn chi tiêu của bạn và xây dựng ước tính của nó từ mức sử dụng đã ghi lại. Chỉ định ai đó để xem xét các kết quả đo được đầu tiên so với dự báo đó.
UberLLM cung cấp một API thống nhất và số dư trả trước để truy cập các mô hình văn bản, hình ảnh, video và âm nhạc, với các kiểm soát giá cấp yêu cầu. Truy cập UberLLM để so sánh giá mô hình trực tiếp, chọn một ứng cử viên cho tính năng có chi tiêu cao nhất của bạn và kiểm tra chi phí của nó trên mỗi nhiệm vụ hoàn thành trước khi cam kết.