KI-Preismodelle erklärt: Tokens, Aufgaben und Kosten
Vergleichen Sie KI-Preismodelle: pro Token, pro Aufgabe, Abonnement- und Guthabenabrechnung, sowie wie Sie abschätzen können, was Ihre Inferenz wirklich kosten wird.
Sie haben eine AI-Funktion am Laufen und versuchen nun, sie zu bepreisen. Die token-Rate des Modells scheint überschaubar, aber die Staging-Rechnung enthält lange Antworten, retries, tool calls und Video-Jobs, die nie etwas Brauchbares produziert haben. Die Multiplikation des Listenpreises mit Ihrem erwarteten Traffic ergibt kein glaubwürdiges Budget mehr.
AI-Preismodelle beschreiben, wie Anbieter Ihnen Kosten berechnen. Die Kosten pro abgeschlossener Aufgabe sagen Ihnen, ob die Funktion wirtschaftlich ist. Sie benötigen beide Perspektiven: die Abrechnungseinheit, um die Kosten abzugleichen, und das fertige Ergebnis, um Modelle, Anbieter und Produktmargen zu vergleichen.
Inhaltsverzeichnis
- Sechs KI-Preismodelle und wie jedes davon Sie abrechnet
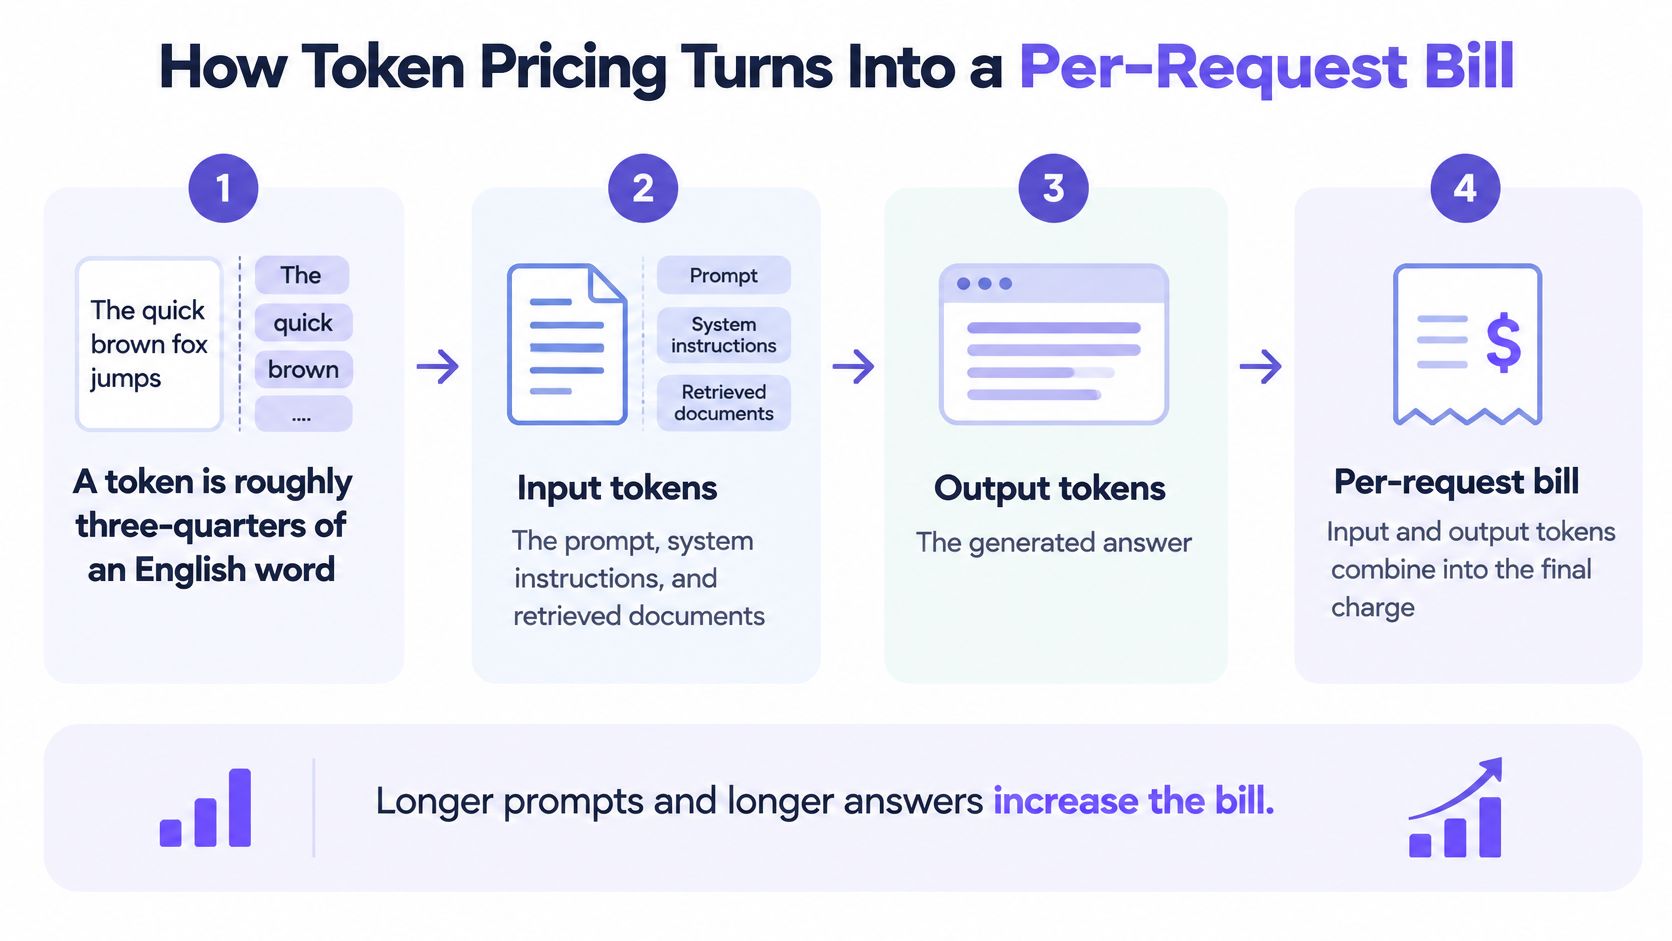
- Wie die Token-Preisgestaltung zu einer Abrechnung pro Anfrage wird
- Medienpreise für Bilder, Video und Audio
- Warum Kosten pro abgeschlossener Aufgabe besser sind als Kosten pro Token
- Warum Modellpreise weiter sinken
- Wählen zwischen Credits, Abonnements und nutzungsbasierter Abrechnung
- Anbieter-Checkliste jenseits des Listenpreises
- Bestätigen Sie Ihre Kosten pro Aufgabe, bevor Sie sich festlegen
Sechs KI-Preismodelle und wie jedes davon abgerechnet wird
Die meisten KI-Produkte werden über eine von sechs Strukturen abgerechnet. Die Tabelle zeigt die Abrechnungseinheit, den besten Anwendungsfall und das Hauptrisiko für jedes Modell.
Gängige KI-Preismodelle auf einen Blick
| Preismodell | Wie abgerechnet wird | Bester Anwendungsfall | Hauptrisiko |
|---|---|---|---|
| Pro Token | Pro Million Eingabe- und Ausgabe-Tokens, separat bepreist | Chat, Programmierung, Text-APIs | Rechnung steigt mit der Antwortlänge |
| Pro Medieneinheit | Pro Bild, pro Videosekunde oder pro Generierungsauftrag | Bild-, Video-, Sprach- und Musiktools | Auflösung und Dauer ändern den Stückpreis |
| Abonnement mit Kontingenten | Feste monatliche Gebühr mit einer Nutzungsobergrenze | Stabile, sitzbasierte Produkte | Zusätzliche Gebühren oder Drosselung nach Erreichen der Obergrenze |
| Prepaid-Guthaben | Guthaben wird pro Anfrage abgebucht | Variable Arbeitslasten über mehrere Anbieter hinweg | Ungenutztes Guthaben kann verfallen |
| Ergebnisbasiert | Gebühr pro abgeschlossener Aufgabe oder gelöstem Fall | Support-Agenten, Workflows mit klarem Erfolg | Erfolg zu definieren ist schwierig |
| Hybrid | Basisabonnement plus gemessene Nutzung oder Guthaben | Produkte mit gemischten Text- und Medien-Arbeitslasten | Zwei Abrechnungskomponenten, die abgeglichen werden müssen |
Die Einheit an die Arbeitslast anpassen
Die Token-basierte Abrechnung eignet sich für Text-Arbeitslasten, da sie das verarbeitete und generierte Material misst. Sie ist nützlich für Chat und Programmierung, aber eine Anweisung zur Erstellung einer detaillierten Erklärung kann die Rechnung ändern, ohne die Anzahl der Anfragen zu beeinflussen.
Die Medieneinheit-basierte Abrechnung ist auf den ersten Blick leichter zu verstehen: Man zahlt für ein Bild oder einen Generierungsauftrag. Die Schwierigkeit liegt in der Definition dieser Einheit, einschließlich Auflösung, Dauer, Qualitätseinstellungen und Ton.
Abonnements mit Kontingenten funktionieren, wenn ein Team regelmäßigen Zugriff benötigt und innerhalb einer vorhersehbaren Freimenge bleiben kann. Prüfen Sie, was bei Erreichen der Obergrenze passiert, bevor Sie das Abonnement als feste Betriebskosten betrachten.
Prepaid-Guthaben decken Ausgaben durch ein finanziertes Guthaben ab. Sie eignen sich für Experimente mit verschiedenen Modellen, vorausgesetzt, Sie verstehen Verfall, Rückerstattungen und wie sich Guthaben in tatsächliche Nutzung umwandeln.
Die ergebnisbasierte Preisgestaltung rückt die Kosten näher an den Geschäftswert. Ein Support-Workflow benötigt jedoch einen expliziten Auflösungstest, einschließlich dessen, was passiert, wenn der Kunde den Fall erneut öffnet.
Hybridpläne kombinieren den Zugriff oder eine enthaltene Freimenge mit variablem Verbrauch. Sie können gemischte Arbeitslasten aufnehmen, aber die Finanzabteilung muss sowohl die Grundgebühr als auch die gemessene Komponente abgleichen.
Praktische Regel: Ermitteln Sie die Einheit, die der Anbieter abrechnet, bevor Sie einen beworbenen Preis vergleichen.
Ein Abonnement ist nicht automatisch günstiger als eine nutzungsbasierte Abrechnung, und Guthaben sind nicht automatisch ein Rabatt. Übersetzen Sie jedes Angebot in die Arbeitslast, die Sie ausführen möchten, einschließlich jeder Freimenge, für die Sie bezahlen, die Sie aber nicht nutzen werden.
Wie die Token-Preisgestaltung zu einer Abrechnung pro Anfrage wird
Anfragekosten = (input tokens ÷ tokens pro Preiseinheit × input rate) + (output tokens ÷ tokens pro Preiseinheit × output rate).
Für Preise, die pro Million Tokens angegeben werden, verwenden Sie eine Million als Divisor. Input tokens umfassen den Prompt, Systemanweisungen, den Konversationsverlauf und abgerufene Dokumente. Output tokens decken die generierte Antwort ab. Verwenden Sie den Tokenizer des Modells oder die zurückgegebenen Nutzungsfelder anstelle einer Wortzählungs-Approximation, insbesondere für Code und mehrsprachigen Text.
Separate Raten sind wichtig. Eine arXiv-Analyse der API pricing berichtet, dass GPT-4 im März 2023 mit $30 pro Million input tokens und $60 pro Million output tokens gestartet ist. Die Generierung erfordert eine andere Berechnung als die Verarbeitung eines Prompts, nehmen Sie also nicht an, dass die beiden Raten übereinstimmen.
Eine Anfrage mit beiden Raten durchrechnen
Betrachten Sie eine hypothetische Anfrage, die 2,000 input tokens und 800 output tokens enthält. Claude Opus 5.5 kostet $4.00 input und $20.00 output pro Million tokens zum Listenpreis, verglichen mit $2.03 input und $10.13 output auf UberLLM.
| Komponente | Zum Listenpreis | Über unseren Marktplatz |
|---|---|---|
| Input-Berechnung | 2,000 ÷ 1,000,000 × $4.00 | 2,000 ÷ 1,000,000 × $2.03 |
| Input-Kosten | $0.008 | $0.00406 |
| Output-Berechnung | 800 ÷ 1,000,000 × $20.00 | 800 ÷ 1,000,000 × $10.13 |
| Output-Kosten | $0.016 | $0.008104 |
| Gesamt | $0.024 | $0.012164, ungefähr $0.012 |
Diese Berechnungen beschreiben die hypothetische Anfrage, nicht einen Durchschnitt für Ihre Anwendung. Bei einer hypothetischen Million Anfragen pro Monat mit genau dieser Token-Mischung beträgt der Unterschied $11,836, oder grob $12,000. Eine andere Output-Länge ändert das Ergebnis.
Der Abrechnungsfluss macht die Unterscheidung zwischen Prompt-Größe und Antwort-Größe einfacher zu überprüfen.
Erstellen Sie Ihre Schätzung anhand tatsächlicher Anfragen
- Zählen Sie input tokens mithilfe Ihrer Prompt-Vorlage und repräsentativer Kundendaten. Fügen Sie Anweisungen und abgerufenen Kontext hinzu.
- Schätzen Sie output tokens aus akzeptierten Antworten, nicht nur aus der kürzesten erfolgreichen Demonstration.
- Wenden Sie jede Rate separat auf die entsprechende Token-Anzahl an.
- Addieren Sie die Ergebnisse, um die Modellgebühr für diese Anfrage zu erhalten.
- Multiplizieren Sie mit dem erwarteten Volumen, wobei kurze und lange Anfrageklassen getrennt gehalten werden.
Unser gelisteter Modellpreis beschreibt, was eine Anfrage typischerweise kostet, nicht eine ceiling. Eine Anfrage wird niemals über einem max_price oder max_cost abgerechnet, das mit ihr gesendet wurde. Halten Sie diese Unterscheidung in Ihrer Anwendung explizit: Eine Schätzung hilft, Ausgaben zu prognostizieren, während ein request ceiling eine Grenze durchsetzt.
Medienpreise für Bilder, Video und Audio
Beispiel-Medienpreise pro Einheit, Listenpreis versus UberLLM
| Modell | Abrechnungseinheit | Listenpreis | UberLLM Preis |
|---|---|---|---|
| Flux 2 Pro Bild | Pro Bild | $0.03 | $0.0075 |
| LTX 2.3 Fast Text-zu-Video | Pro Job | $0.06 | $0.045 |
| Veo 3.1 Full Text-zu-Video | Pro Job | $0.44 | $0.22 |
Der Flux-Preis ist 75% niedriger, berechnet aus den gelisteten Bildpreisen. LTX ist 25% niedriger, und Veo ist 50% niedriger. Jeder Vergleich gilt nur für das genannte Modell und die passende Einstellung, nicht für jede Bild- oder Videoanfrage.
Medienprodukte werden oft in anderen Einheiten als Text-tokens abgerechnet. Ein Generierungs-job, ein Bild, eine Audio-Dauer oder eine Video-Dauer wird zur Einheit, die Sie normalisieren müssen. Die Modellwahl und die Ausgabeeinstellungen bestimmen, was diese Einheit beinhaltet.
Identische Generierungseinstellungen vergleichen
Ein günstiger kurzer Clip ist kein Ersatz für das längere, höherauflösende Asset, das Ihr Produkt benötigt. Auch der Ton ist wichtig: Eine stumme Vorschau und ein fertiger audiovisueller Clip sind keine gleichwertigen Lieferobjekte.
Bevor Sie Anbieter vergleichen, legen Sie fest:
- Modell und Aufgabe: Halten Sie die Modellversion und den Generierungsmodus identisch, einschließlich Text-zu-Video versus Bild-zu-Video.
- Auflösung und Dauer: Notieren Sie die angeforderten Dimensionen und die Clip-Länge, anstatt sich auf den Namen eines Modells zu verlassen.
- Audio-Einstellung: Geben Sie an, ob generierter Ton enthalten ist.
- Job-Definition: Bestätigen Sie, was ein job beinhaltet und ob Erweiterungen, upscaling oder zusätzliche Ausgaben separate Anfragen erfordern.
Der Veo API Preis-pro-Sekunde-Leitfaden hilft, dauerbasierte Vergleiche zu gestalten. Wandeln Sie ein Pro-job-Angebot nicht in einen Pro-Sekunde-Tarif um, bevor Sie die Dauer kennen, die dieses Angebot abdeckt.
Ein Medienpreisvergleich ist nur dann nützlich, wenn beide Preise dasselbe Lieferobjekt beinhalten.
Bei Audio unterscheiden Sie generierte Sprache von Transkription und Musikgenerierung. Die Dauer des hochgeladenen Audios und die Dauer der generierten Ausgabe sind unterschiedliche Messungen, notieren Sie also, welche davon der Dienst abrechnet.
Führen Sie ein kleines Einstellungs-manifest neben Ihrer Preis-Tabelle: Modell-identifier, Aufgabe, Dimensionen, Dauer, Audio und alle Qualitätsoptionen. Preisen Sie dieses manifest bei jedem Anbieter ein, speichern Sie dann das Angebot und die Konfiguration zusammen. Sie können den Vergleich wiederholen, wenn sich die Preise ändern, ohne versehentlich ein anderes Produkt zu vergleichen.
Warum Kosten pro abgeschlossener Aufgabe Kosten pro Token schlagen
Der günstigste Token-Preis kann zur teuersten fertigen Aufgabe führen. Ein Modell, das wiederholte Korrekturen, unnötige Tool-Aufrufe oder manuelle Reparaturen benötigt, mag weniger teure Tokens verbrauchen, während es mehr kostet, ein nutzbares Ergebnis zu liefern.
Der Unterschied wird sichtbar, wenn Sie eine direkte Antwort mit einem Workflow vergleichen, der ständig Aktionen ausführt.
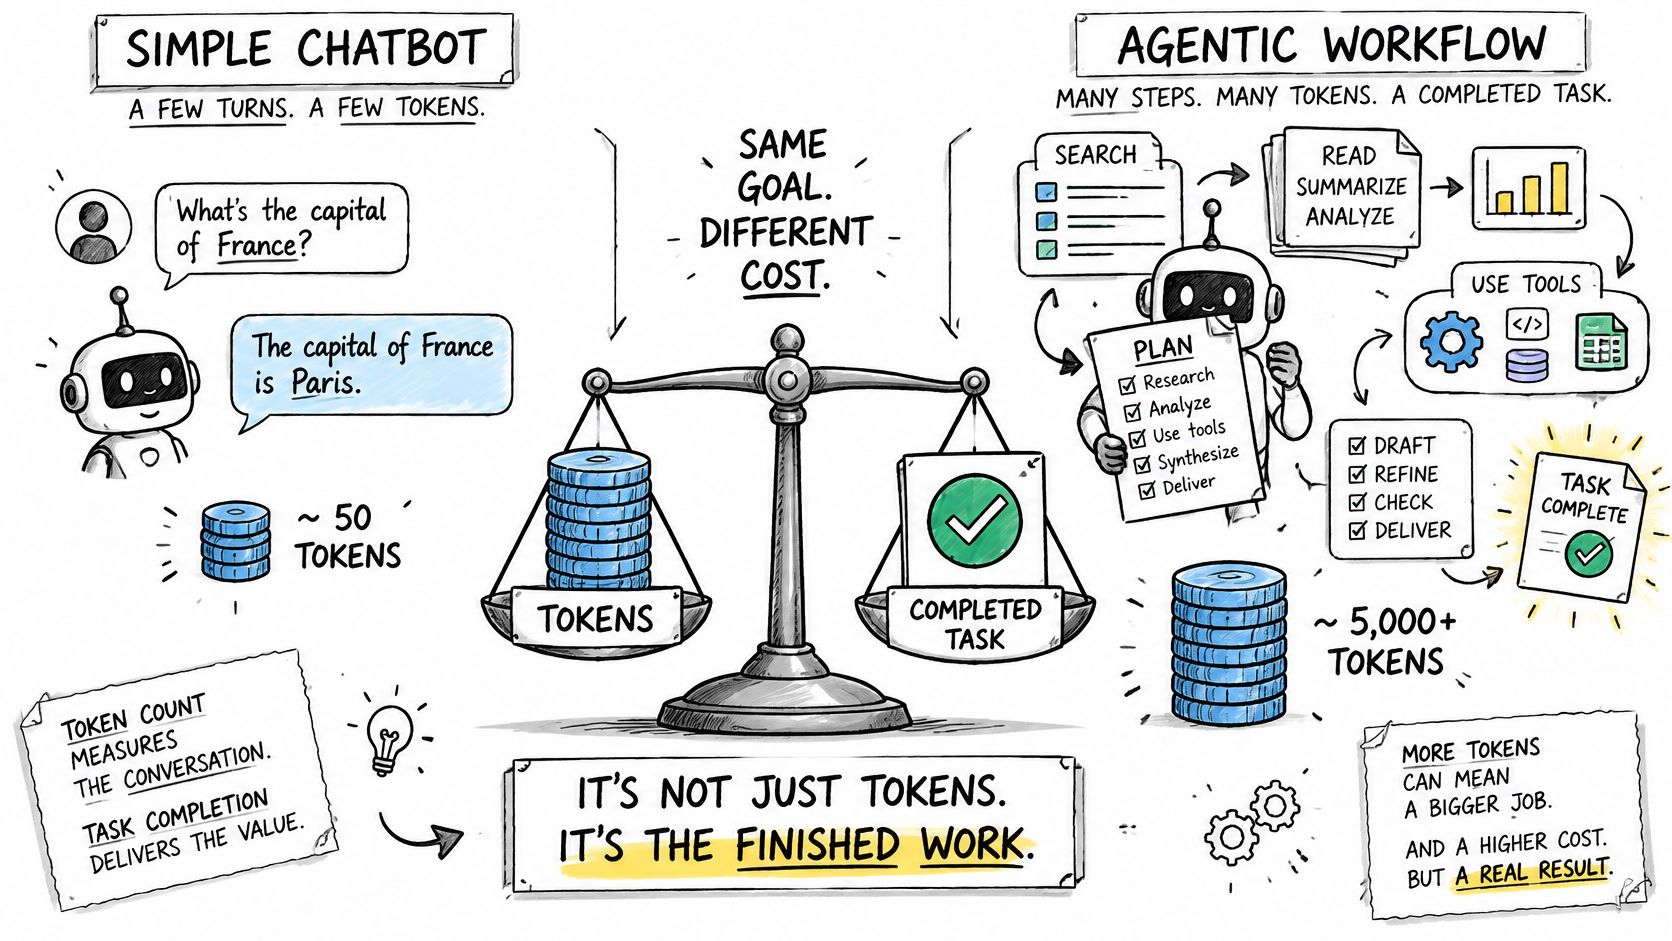
Oometas Kostenanalyse für Agenten-Workflows beschreibt, dass agentenbasierte Workflows 5–30 Mal mehr Tokens verbrauchen als eine herkömmliche Chatbot-Interaktion und schätzt grob $0.001 für einen einfachen Chatbot-Aufruf gegenüber $0.10–$1.00 für eine mehrstufige Agentenaufgabe. Betrachten Sie dies als Kontext, nicht als Ihre Prognose: Planung, Retrieval, Tools, Reflexion und Wiederholungsversuche unterscheiden sich je nach Implementierung.
Setzen Sie erfolglose Arbeit in den Zähler
Kosten pro erfolgreichem Ergebnis = Gesamtausgaben für die Aufgabe ÷ erfolgreich abgeschlossene Aufgaben.
In einem hypothetischen Batch kosten 1,000 Versuche zu je $0.10 $100. Wenn 800 erfolgreich sind, betragen die Kosten pro gelöster Aufgabe $0.125, nicht $0.10. Die erfolglosen Versuche gehören immer noch in die Kostenberechnung.
Ein zweiter hypothetischer Vergleich zeigt, warum Listenpreise irreführend sind:
| Hypothetisches Modell | Kosten pro Versuch | Erfolgsrate | Kosten pro Erfolg |
|---|---|---|---|
| Günstigeres Modell | $0.05 | 30% | Etwa $0.167 |
| Teureres Modell | $0.10 | 90% | Etwa $0.111 |
Dies sind arithmetische Beispiele, keine gemessene Modellleistung. Sie gehen von vergleichbaren Versuchen und einer unveränderten Erfolgsrate aus; Ihre Bewertung muss beides feststellen.
Das Video bietet eine weitere Möglichkeit, Workflow-Kosten zu betrachten.
Verfolgen Sie Ausgabelänge, Wiederholungsversuche, latenzbedingte Fallbacks und Gebühren für erfolglose Anfragen anhand einer gemeinsamen Aufgabenkennung. Berücksichtigen Sie Tool- oder Infrastrukturkosten, wenn sie wesentlich sind, und unterscheiden Sie eine API response von einem Geschäftserfolg.
Eine Support-Antwort, die ein Mitarbeiter umschreiben muss, ist nicht gleichbedeutend mit einem gelösten Ticket. Nutzen Sie das Ergebnis, das Ihr Kunde benötigt: einen gelösten Fall, einen akzeptierten Clip oder eine Programmieraufgabe, die ihre Akzeptanztests besteht.
Warum die Modellpreise weiter sinken
Das günstigste Modell, das eine Leistung auf GPT-3.5-Niveau bei MMLU erreichte, fiel von ungefähr $20 pro Million Tokens im November 2022 auf $0.07 im Oktober 2024, was ungefähr 286-mal billiger ist, laut Orbs Zusammenfassung der von Stanford gemeldeten Zahlen. Stanfords 2025 AI Index Report beschreibt den Rückgang der Inferenzkosten für vergleichbare Fähigkeiten in diesem Zeitraum als mehr als 280-fach.
Dieser Vergleich hält den Benchmark-Schwellenwert konstant. Er vergleicht nicht nur ein teures, leistungsfähiges Modell mit einem billigeren, schwächeren Modell, obwohl das Erreichen eines Benchmarks immer noch kein äquivalentes Verhalten in Ihrer Anwendung garantiert.
Budget für sich änderndes Angebot, nicht für einen festen Tarif
Kleinere Architekturen, Quantisierung, verbesserte Inferenz-Software, spezialisierte Hardware und der Wettbewerb unter den Anbietern tragen zu niedrigeren Kosten bei. Jeder Faktor beeinflusst einen anderen Teil der Wirtschaftlichkeit: Modellgröße, numerische Präzision, Serving-Effizienz, Hardware-Auslastung oder die Marge des Anbieters.
Für Käufer bedeutet dies praktisch, eine Preisannahme von einer Qualitätsannahme zu trennen. Ein niedrigerer Tarif ist nur dann nützlich, wenn der Kandidat immer noch Ihre Akzeptanzkriterien erfüllt.
- Führen Sie eine datierte Preisaufzeichnung: Speichern Sie den Modell-Identifier, die Input- und Output-Raten, die Abrechnungseinheit und das Datum der Ablesung.
- Nutzen Sie Budgetszenarien: Modellieren Sie die erwartete Nachfrage zusammen mit einer höheren Arbeitslast mit längeren Outputs und komplexeren Aufgaben.
- Planen Sie Überprüfungen: Überprüfen Sie die Tarife vierteljährlich und untersuchen Sie wesentliche Rechnungsabweichungen vor der nächsten geplanten Überprüfung.
Ein Modellpreisindex kann helfen, Kandidaten zu identifizieren, die eine erneute Prüfung wert sind. Er sollte die Preisaufzeichnung, die Ihren eigenen Request-Logs beigefügt ist, nicht ersetzen.
Unser gelisteter Preis aktualisiert sich alle 5 Minuten. Er verwendet den Listenpreis des Anbieters, multipliziert mit dem Anteil des Listenpreises, der während der teuersten gehandelten Stunde des Marktplatzes in den letzten 24 Stunden berechnet wurde, und ist niemals niedriger als das günstigste Angebot.
Überprüfen Sie vertragliche Preisänderungsbedingungen getrennt von Ihrem Überprüfungsplan. Eine Kalendererinnerung macht einen variablen Tarif nicht fest, und historische Rückgänge sind keine Garantie dafür, dass jede Route billiger wird.
Die Wahl zwischen Guthaben, Abonnements und nutzungsbasierter Abrechnung
Eine arXiv-Studie zur Preisgestaltung von KI-Produkten fand heraus, dass Abonnements mit Nutzungskontingenten das größte KI-native Preismodell unter 52 Produkten waren; 25 boten einen kostenlosen Tarif, eine Testphase oder Startguthaben an, während 13 Pay-as-you-go-Einstiegspreise nutzten. Dieses Muster etabliert keinen universellen Gewinner. Es zeigt, warum eine reine Verbrauchsabrechnung nicht die einzig sinnvolle Struktur ist.
Bei der Entscheidung geht es darum, wer das Risiko der variablen Nutzung trägt. Ein Abonnement verlagert einen Teil des Nachfragerisikos auf den Anbieter, während Prepaid- und nutzungsbasierte Strukturen den Verbrauch für den Käufer sichtbarer machen.
Nutzen Sie Ihre operativen Einschränkungen zur Auswahl
| Frage | Was die Antwort nahelegt |
|---|---|
| Ist die monatliche Nutzung stabil? | Ein Abonnement mit einem nutzbaren Kontingent kann die Budgetplanung vereinfachen |
| Werden Sie mehrere Anbieter oder Modalitäten nutzen? | Ein gemeinsames Prepaid-Guthaben kann fragmentierte Finanzierungen reduzieren |
| Können Sie den Verbrauch zuverlässig prognostizieren? | Metering ist einfacher zu verwalten, wenn Arbeitslastschätzungen zuverlässig sind |
| Benötigt die Finanzabteilung eine feste Obergrenze? | Priorisieren Sie durchsetzbare Limits gegenüber Abrechnungsbezeichnungen |
Stabile Nutzung bei einem einzigen Anbieter deutet auf ein Abonnement hin, vorausgesetzt, das Kontingent passt zu Ihrer tatsächlichen Arbeitslast. Zählen Sie ungenutztes Kontingent nicht als Wert, und prüfen Sie, ob Überschreitungen eine Genehmigung erfordern oder automatisch erfolgen.
Ungleichmäßige Nachfrage über mehrere Modelle hinweg deutet auf Guthaben oder nutzungsbasierte Abrechnung hin. Ablauf- und Übertragungsbedingungen sind wichtig, da der Kauf von Kapazität, die Sie nie nutzen, einen scheinbaren Rabatt zunichtemachen kann.
Finanzierung von Abrechnung trennen
Ein Prepaid-Wallet beschreibt, wann Sie die Nutzung finanzieren, nicht unbedingt, wie jede Anfrage bepreist wird. Ebenso kann Pay-as-you-go über ein Prepaid-Guthaben statt einer nachträglichen Rechnung erfolgen.
Wir haben keine monatliche Gebühr und keinen Mindestbetrag. Kunden behalten ein Guthaben und zahlen nach Verbrauch. Unsere zuerst angebotene upto Zahlungsoption lässt das Wallet ein Angebot als Obergrenze unterzeichnen; nach der Antwort wird nur der tatsächliche Betrag abgebucht, aufgerundet auf den nächsten Millionstel Dollar.
Wählen Sie die Einschränkung, bei der Sie keine Kompromisse eingehen können, bevor Sie den Plan wählen.
Wenn diese Einschränkung ein festes Budget ist, prüfen Sie die Ausgabenkontrollen. Wenn es sich um vorhersehbaren Zugang für ein stabiles Team handelt, prüfen Sie die Kontingent- und Überschreitungsregeln. Wenn es um Flexibilität über Text und Medien hinweg geht, prüfen Sie, ob dasselbe Guthaben die Workflows unterstützt, die Sie ausführen möchten.
Anbieter-Checkliste jenseits des Listenpreises
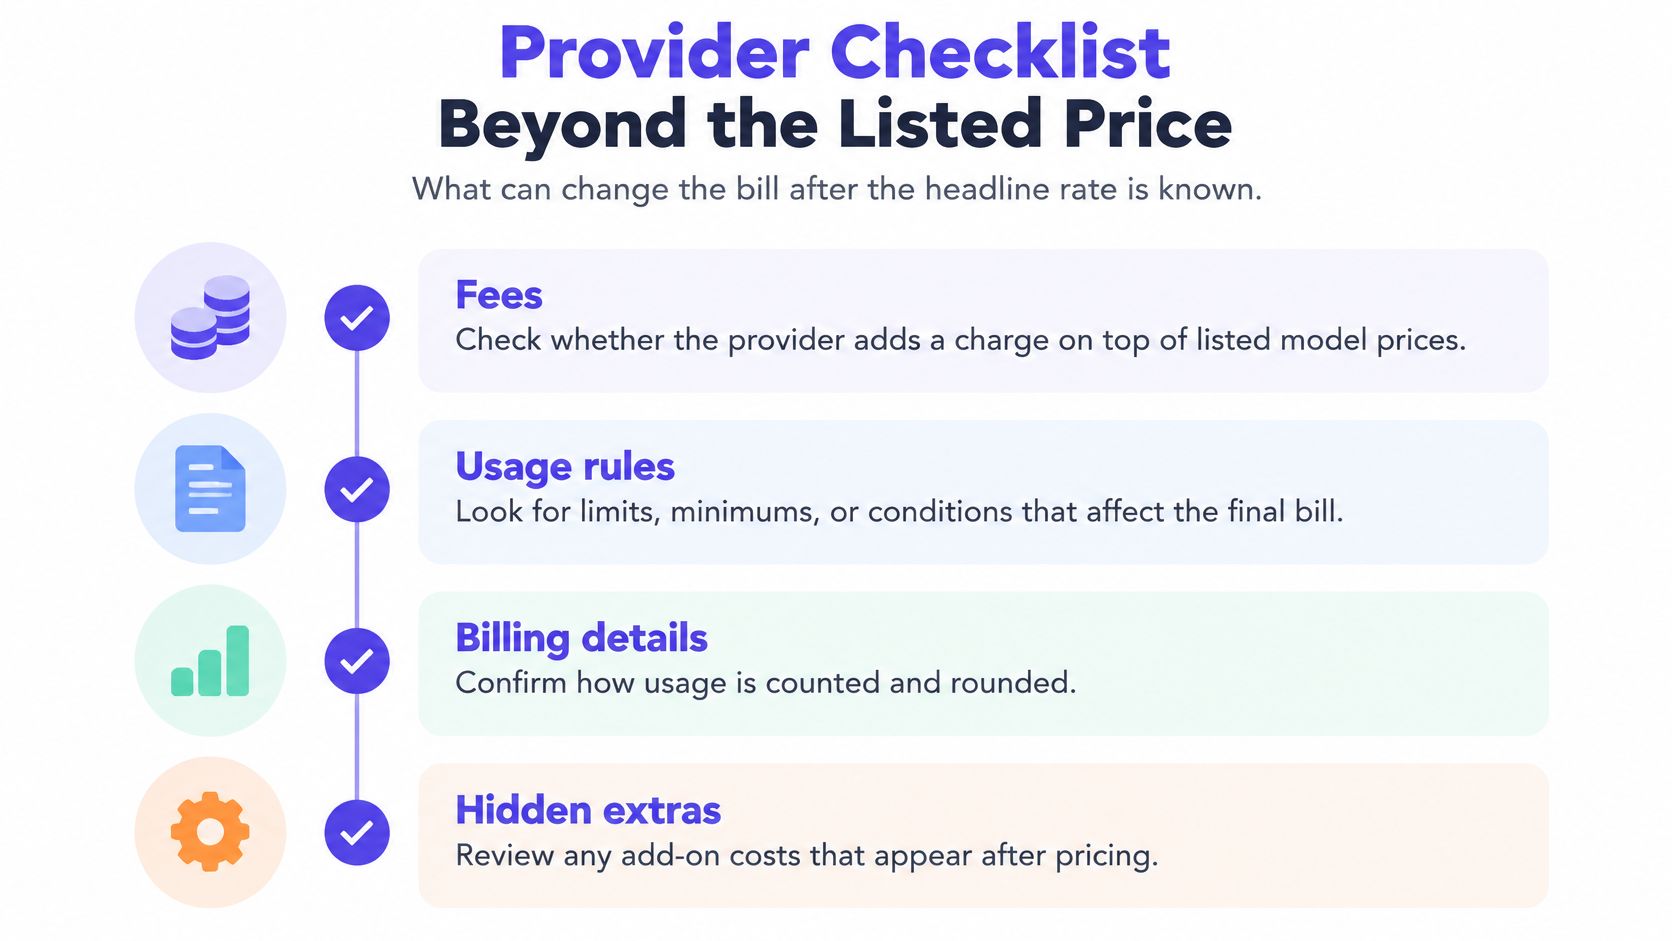
Eine Preisliste verrät nicht alles, was Sie zur Abstimmung einer Produktionsrechnung benötigen. Testen Sie das Abrechnungsverhalten, nicht nur die im Playground angezeigte Arithmetik.
Nutzen Sie diese Checkliste, um die Bedingungen zu identifizieren, die eine konkrete Antwort erfordern.
Den Abrechnungspfad überprüfen
- Gebühren sind explizit. Wir erheben keine zusätzlichen Gebühren auf die gelisteten Modellpreise. Halten Sie Finanzierungsgebühren von Anforderungsgebühren getrennt, wenn Sie die Gesamtausgaben vergleichen. Eine schlechte Antwort ist ein Angebot, das einen nicht spezifizierten Plattformzuschlag ausschließt.
- Die Abrechnungsgrundlage ist nachvollziehbar. Wenn der Anbieter meldet, was er für einen Aufruf berechnet hat, stellen wir genau diesen Betrag in Rechnung. Andernfalls kostet der Aufruf seine ⟦token⟧ zum gelisteten Preis. Eine schlechte Antwort ist eine Rechnungsgesamtsumme, die nicht mit der Nutzung auf Anforderungsebene oder den gemeldeten Gebühren verknüpft werden kann.
- Fehlgeschlagene Anfragen haben eine definierte Behandlung. Unsere fehlgeschlagenen Anfragen und Generierungen kosten nichts. Eine abgeschlossene Generierung, die Ihnen jedoch nicht gefällt, sollte nicht automatisch als technischer Fehler klassifiziert werden. Eine schlechte Antwort lässt die Unterscheidung undefiniert.
Den Kontrollpfad überprüfen
- Schlüssel bieten Isolation. Unsere ⟦API⟧-Schlüssel sind bereichsbezogen und widerrufbar, und es gelten Ausgabenlimits pro Schlüssel. Ein ⟦MCP⟧-Tool-Aufruf wird abgerechnet, begrenzt und abgelehnt wie die entsprechende ⟦API⟧-Anfrage. Eine schlechte Antwort erfordert das Deaktivieren jedes Dienstes, um eine einzelne kompromittierte Integration zu stoppen.
- Fallback-Verhalten ist verständlich. Wir leiten Anfragen an einen anderen funktionierenden Anbieter weiter, wenn ein Provider langsam oder nicht verfügbar wird. Testen Sie die resultierende Abrechnung und das Timing in Ihren Logs. Ein Anbieter, der nicht erklären kann, ob eine alternative Route die Abrechnung ändert, lässt Sie mit einem unbekannten Preis zurück.
Für gemischte Workloads prüfen Sie, wie eine vereinheitlichte Text-, Bild- und Video-⟦API⟧ den Aufgabenstatus und die Ergebnisse offenlegt. Eine asynchrone Medienanfrage benötigt einen dauerhaften Aufgabenidentifikator, damit Übermittlung, Abschluss und Abrechnung abgeglichen werden können, selbst wenn sie zu unterschiedlichen Zeiten erfolgen.
Führen Sie diese Prüfungen mit repräsentativem, produktionsähnlichem Traffic durch, einschließlich Timeouts, Abbrüchen und fehlgeschlagenen Jobs. Ein Demo-Konto mit kurzen Prompts und erfolgreichen Antworten wird nicht aufzeigen, ob Ihre Buchhaltung die Bedingungen übersteht, die Ihre Anwendung bewältigen muss.
Bestätigen Sie Ihre Kosten pro Aufgabe, bevor Sie sich festlegen
Nutzen Sie eine begrenzte Evaluierung, anstatt aufgrund einer Preistabelle zu migrieren. Ziel ist es herauszufinden, welche Option akzeptable Ergebnisse zu akzeptablen Betriebskosten liefert, ohne die Arbeitslast zu ändern.
Führen Sie einen kontrollierten Vergleich durch
- Wählen Sie repräsentative Aufgaben aus. Fügen Sie Routineanfragen, schwierige Fälle, lange Kontexte und Eingaben hinzu, die zuvor Probleme verursacht haben. Halten Sie sensible Kundenmaterialien von einer Evaluierung fern, es sei denn, deren Verwendung ist autorisiert.
- Erfassen Sie die Ausführungsaufzeichnung. Protokollieren Sie Eingabe- und Ausgabe-tokens, Aufgaben-IDs, Wiederholungsversuche, Tool-Aufrufe, Gebühren und Erfolgsbeurteilungen. Erfassen Sie die Zeit bis zu einem nutzbaren Ergebnis, nicht nur die Zeit bis zur ersten Antwort.
- Berechnen Sie die aktuelle Basislinie. Teilen Sie alle relevanten Ausgaben durch akzeptierte Ergebnisse. Halten Sie Aufgabenklassen getrennt, damit einfache Anfragen keine schlechte Wirtschaftlichkeit bei schwieriger Arbeit verdecken.
- Testen Sie alternative Modelle. Bewahren Sie Prompts, Eingaben, Tool-Berechtigungen und Akzeptanztests auf. Mit unserem gemeinsamen API-Zugang verwendet das Wechseln von Modellen eine andere Modell-ID, und jede Anfrage wird an den günstigsten gesunden Anbieter weitergeleitet.
- Wenden Sie ein Anfragebudget an. Wählen Sie für jede Aufgabenklasse geeignete Limits und überprüfen Sie, wie die Anwendung Ablehnungen oder unvollständige Arbeiten handhabt. Ein Limit sollte eine kontrollierte Benutzererfahrung erzeugen, keinen unerklärlichen Fehler.
- Vergleichen Sie die Betriebsergebnisse gemeinsam. Bewerten Sie Kosten pro Erfolg, Latenz und Fehlerrate. Überprüfen Sie die tatsächlichen Ausgaben, wo die automatisierte Bewertung sachliche Fehler oder unvollständige Arbeiten übersehen kann.
- Führen Sie einen Pilotversuch durch, bevor Sie sich festlegen. Leiten Sie einen kleinen, kontrollierten Anteil des Live-Traffics an den Kandidaten weiter. Gleichen Sie die abgerechneten Gebühren während des Pilotversuchs mit Ihren Protokollen ab und halten Sie einen Rollback-Pfad bereit, bis sowohl Qualität als auch Abrechnung zuverlässig sind.
Machen Sie die Entscheidung wiederholbar
Schreiben Sie die Akzeptanzkriterien auf, bevor Sie Modellnamen und Preise überprüfen. Andernfalls ist es leicht, schwächere Ergebnisse zu entschuldigen, weil ein Kandidat billiger aussieht.
Halten Sie den Evaluierungssatz versioniert und fügen Sie neue Fehlerfälle hinzu, wenn sich die Anwendung ändert. Planen Sie die nächste Überprüfung vierteljährlich, mit einem früheren erneuten Test, wenn eine wesentliche Modell-, Preis- oder Produktänderung den bestehenden Vergleich unzuverlässig macht.
Die beste Option ist nicht das isoliert billigste Modell. Es ist die Konfiguration, die Ihre Arbeitslast innerhalb Ihrer Qualitäts-, Latenz- und Budgetbeschränkungen abschließt.
UberLLM bietet einen API key für Text- und Medienmodelle, ein gemeinsames Prepaid-Guthaben und die Weiterleitung an den günstigsten gesunden Anbieter für jedes angefragte Modell. Besuchen Sie UberLLM, um aktuelle Preise zu vergleichen, testen Sie dann repräsentative Aufgaben und messen Sie die Kosten der akzeptierten Ergebnisse, bevor Sie den Produktions-Traffic verschieben.