Modelos de Preços de IA Explicados: Tokens, Tarefas e Custos
Compare modelos de preços de IA: por token, por tarefa, assinatura e cobrança por crédito, além de como estimar o custo real da sua inferência.
Você tem um recurso de IA funcionando e agora está tentando precificá-lo. A taxa de token do modelo parece gerenciável, mas a fatura de staging inclui respostas longas, retries, tool calls e trabalhos de vídeo que nunca produziram algo utilizável. Multiplicar a taxa principal pelo seu tráfego esperado não lhe dá mais um orçamento crível.
Modelos de precificação de IA descrevem como os fornecedores cobram você. O custo por tarefa concluída informa se o recurso é econômico. Você precisa de ambas as visões: a unidade de cobrança para conciliar as despesas e o resultado final para comparar modelos, provedores e margens de produto.
Sumário
- Seis Modelos de Preços de IA e Como Cada Um Te Cobra
- Como o Preço por Token se Transforma em uma Cobrança por Requisição
- Preços de Mídia para Imagens, Vídeo e Áudio
- Por Que o Custo por Tarefa Concluída Supera o Custo por Token
- Por Que os Preços dos Modelos Continuam Caindo
- Escolhendo Entre Créditos, Assinaturas e Cobrança por Uso
- Checklist do Provedor Além do Preço Listado
- Confirme Seu Custo por Tarefa Antes de Se Comprometer
Seis Modelos de Precificação de IA e Como Cada Um Te Cobra
A maioria dos produtos de IA cobra através de uma de seis estruturas. A tabela mostra a unidade de cobrança, a melhor adequação e o principal risco para cada uma.
Modelos comuns de precificação de IA em resumo
| Modelo de precificação | Como você é cobrado | Melhor adequação | Principal risco |
|---|---|---|---|
| Por token | Por milhão de tokens de entrada e saída, precificados separadamente | Chat, coding, APIs de texto | A conta aumenta com o comprimento da resposta |
| Por unidade de mídia | Por imagem, por segundo de vídeo ou por trabalho de geração | Ferramentas de imagem, vídeo, fala e música | Resolução e duração alteram o preço da unidade |
| Assinatura com cotas | Taxa mensal fixa com um limite de uso | Produtos estáveis, baseados em licenças | Cobranças por excesso ou limitação após o limite |
| Créditos pré-pagos | Saldo debitado por solicitação | Cargas de trabalho variáveis em vários provedores | Saldo não utilizado pode expirar |
| Baseado em resultados | Taxa por tarefa concluída ou caso resolvido | Agentes de suporte, fluxos de trabalho de sucesso claro | Definir o sucesso é difícil |
| Híbrido | Assinatura base mais uso medido ou créditos | Produtos com cargas de trabalho mistas de texto e mídia | Dois componentes de cobrança para conciliar |
Adeque a unidade à carga de trabalho
A cobrança por token adequa-se a cargas de trabalho de texto porque mede o material processado e gerado. É útil para chat e coding, mas uma instrução para produzir uma explicação detalhada pode alterar a conta sem alterar o número de solicitações.
A cobrança por unidade de mídia é mais fácil de entender à primeira vista: pague por uma imagem ou trabalho de geração. A dificuldade é a definição dessa unidade, incluindo resolução, duração, configurações de qualidade e som.
Assinaturas com cotas funcionam quando uma equipe precisa de acesso regular e pode permanecer dentro de uma franquia previsível. Verifique o que acontece no limite antes de tratar a assinatura como um custo operacional fixo.
Créditos pré-pagos vinculam os gastos a um saldo financiado. Eles se adequam à experimentação entre modelos, desde que você entenda a expiração, os reembolsos e como os créditos se traduzem em uso real.
A precificação baseada em resultados coloca a cobrança mais próxima do valor de negócio. Um fluxo de trabalho de suporte precisa de um teste de resolução explícito, no entanto, incluindo o que acontece quando o cliente reabre o caso.
Planos híbridos combinam acesso ou uma franquia incluída com consumo variável. Eles podem acomodar cargas de trabalho mistas, mas o financeiro deve conciliar tanto a cobrança base quanto o componente medido.
Regra prática: Identifique a unidade que o fornecedor cobra antes de comparar qualquer preço de destaque.
Uma assinatura não é automaticamente mais barata do que a cobrança por uso, e os créditos não são automaticamente um desconto. Traduza cada oferta para a carga de trabalho que você pretende executar, incluindo qualquer franquia pela qual você pagará, mas não usará.
Como o Preço por Token se Transforma em uma Cobrança por Requisição
Custo da requisição = (tokens de entrada ÷ tokens por unidade de precificação × taxa de entrada) + (tokens de saída ÷ tokens por unidade de precificação × taxa de saída).
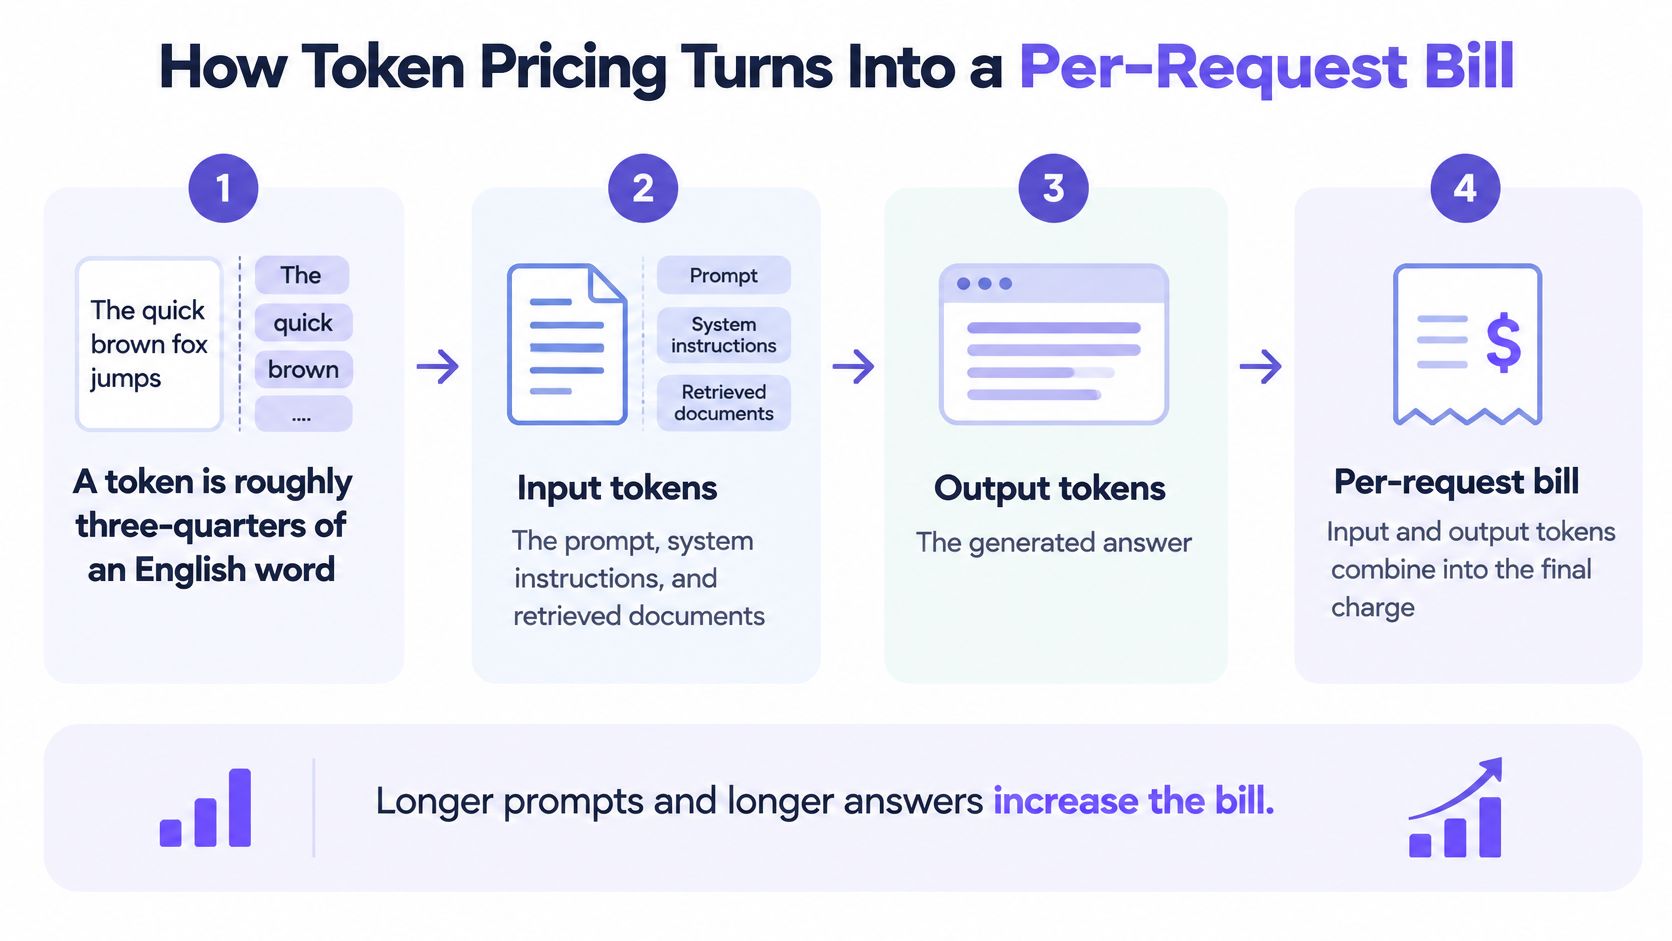
Para preços cotados por milhão de tokens, use um milhão como divisor. Os tokens de entrada incluem o prompt, instruções do sistema, histórico da conversa e documentos recuperados. Os tokens de saída cobrem a resposta gerada. Use o tokenizer do modelo ou os campos de uso retornados, em vez de uma aproximação de contagem de palavras, especialmente para código e texto multilíngue.
Taxas separadas importam. Uma análise arXiv de precificação de API relata que o GPT-4 foi lançado em março de 2023 a $30 por milhão de tokens de entrada e $60 por milhão de tokens de saída. A geração requer computação diferente do processamento de um prompt, então não presuma que as duas taxas coincidam.
Calcule uma requisição usando ambas as taxas
Considere uma requisição hipotética contendo 2,000 tokens de entrada e 800 tokens de saída. O Claude Opus 5.5 custa $4.00 de entrada e $20.00 de saída por milhão de tokens ao preço de tabela, em comparação com $2.03 de entrada e $10.13 de saída no UberLLM.
| Componente | Ao preço de tabela | Através do nosso marketplace |
|---|---|---|
| Cálculo de entrada | 2,000 ÷ 1,000,000 × $4.00 | 2,000 ÷ 1,000,000 × $2.03 |
| Custo de entrada | $0.008 | $0.00406 |
| Cálculo de saída | 800 ÷ 1,000,000 × $20.00 | 800 ÷ 1,000,000 × $10.13 |
| Custo de saída | $0.016 | $0.008104 |
| Total | $0.024 | $0.012164, aproximadamente $0.012 |
Esses cálculos descrevem a requisição hipotética, não uma média para sua aplicação. Em um milhão de requisições hipotéticas por mês com exatamente essa combinação de tokens, a diferença é de $11,836, ou aproximadamente $12,000. Um comprimento de saída diferente altera o resultado.
O fluxo de cobrança torna a distinção entre o tamanho do prompt e o tamanho da resposta mais fácil de inspecionar.
Construa sua estimativa a partir de requisições reais
- Conte os tokens de entrada usando seu modelo de prompt e dados representativos do cliente. Inclua instruções e contexto recuperado.
- Estime os tokens de saída a partir de respostas aceitas, não apenas da demonstração bem-sucedida mais curta.
- Aplique cada taxa separadamente à sua contagem de tokens correspondente.
- Adicione os resultados para obter a cobrança do modelo para aquela requisição.
- Multiplique pelo volume esperado, mantendo as classes de requisições curtas e longas separadas.
Nosso preço de modelo listado descreve o que uma requisição geralmente custa, não um teto. Uma requisição nunca é cobrada acima de um max_price ou max_cost enviado com ela. Mantenha essa distinção explícita em sua aplicação: uma estimativa ajuda a prever gastos, enquanto um teto de requisição impõe um limite.
Preços de Mídia para Imagens, Vídeo e Áudio
Exemplo de preços de mídia por unidade, tabela versus UberLLM
| Modelo | Unidade de cobrança | Preço de tabela | Preço UberLLM |
|---|---|---|---|
| Flux 2 Pro image | Por imagem | $0.03 | $0.0075 |
| LTX 2.3 Fast Text to Video | Por trabalho | $0.06 | $0.045 |
| Veo 3.1 Full Text-to-Video | Por trabalho | $0.44 | $0.22 |
O preço do Flux é 75% mais baixo, calculado a partir dos preços de imagem listados. O LTX é 25% mais baixo, e o Veo é 50% mais baixo. Cada comparação se aplica apenas ao modelo nomeado e à configuração correspondente, não a cada solicitação de imagem ou vídeo.
Produtos de mídia frequentemente cobram em unidades diferentes de tokens de texto. Um trabalho de geração, imagem, duração de áudio ou duração de vídeo se torna a unidade que você precisa normalizar. A escolha do modelo e as configurações de saída determinam o que essa unidade compra.
Compare configurações de geração idênticas
Um clipe curto e barato não substitui o ativo mais longo e de maior resolução que seu produto precisa. O som também importa: uma prévia silenciosa e um clipe audiovisual finalizado não são entregáveis equivalentes.
Antes de comparar provedores, defina:
- Modelo e tarefa: Mantenha a versão do modelo e o modo de geração idênticos, incluindo texto-para-vídeo versus imagem-para-vídeo.
- Resolução e duração: Registre as dimensões solicitadas e o comprimento do clipe em vez de depender do nome de um modelo.
- Configuração de áudio: Especifique se o som gerado está incluído.
- Definição do trabalho: Confirme o que um trabalho inclui e se extensões, upscaling ou saídas adicionais exigem solicitações separadas.
O guia de preço por segundo da API Veo ajuda a enquadrar comparações baseadas em duração. Não converta uma cotação por trabalho em uma taxa por segundo até saber a duração que essa cotação cobre.
Uma comparação de preços de mídia só é útil quando ambos os preços compram o mesmo entregável.
Para áudio, distinga fala gerada de transcrição e geração de música. A duração do áudio carregado e a duração da saída gerada são medidas diferentes, então registre aquela que o serviço cobra.
Mantenha um pequeno manifesto de configurações junto à sua planilha de preços: identificador do modelo, tarefa, dimensões, duração, áudio e quaisquer opções de qualidade. Precifique esse manifesto com cada provedor e, em seguida, salve a cotação e a configuração juntas. Você pode repetir a comparação quando os preços mudarem sem comparar acidentalmente um produto diferente.
Por que o Custo por Tarefa Concluída Supera o Custo por Token
A taxa de token mais barata pode produzir a tarefa finalizada mais cara. Um modelo que precisa de correção repetida, chamadas de ferramentas desnecessárias ou reparo manual pode consumir tokens menos caros enquanto custa mais para entregar um resultado utilizável.
A diferença se torna visível quando você compara uma resposta direta com um workflow que continua realizando ações.
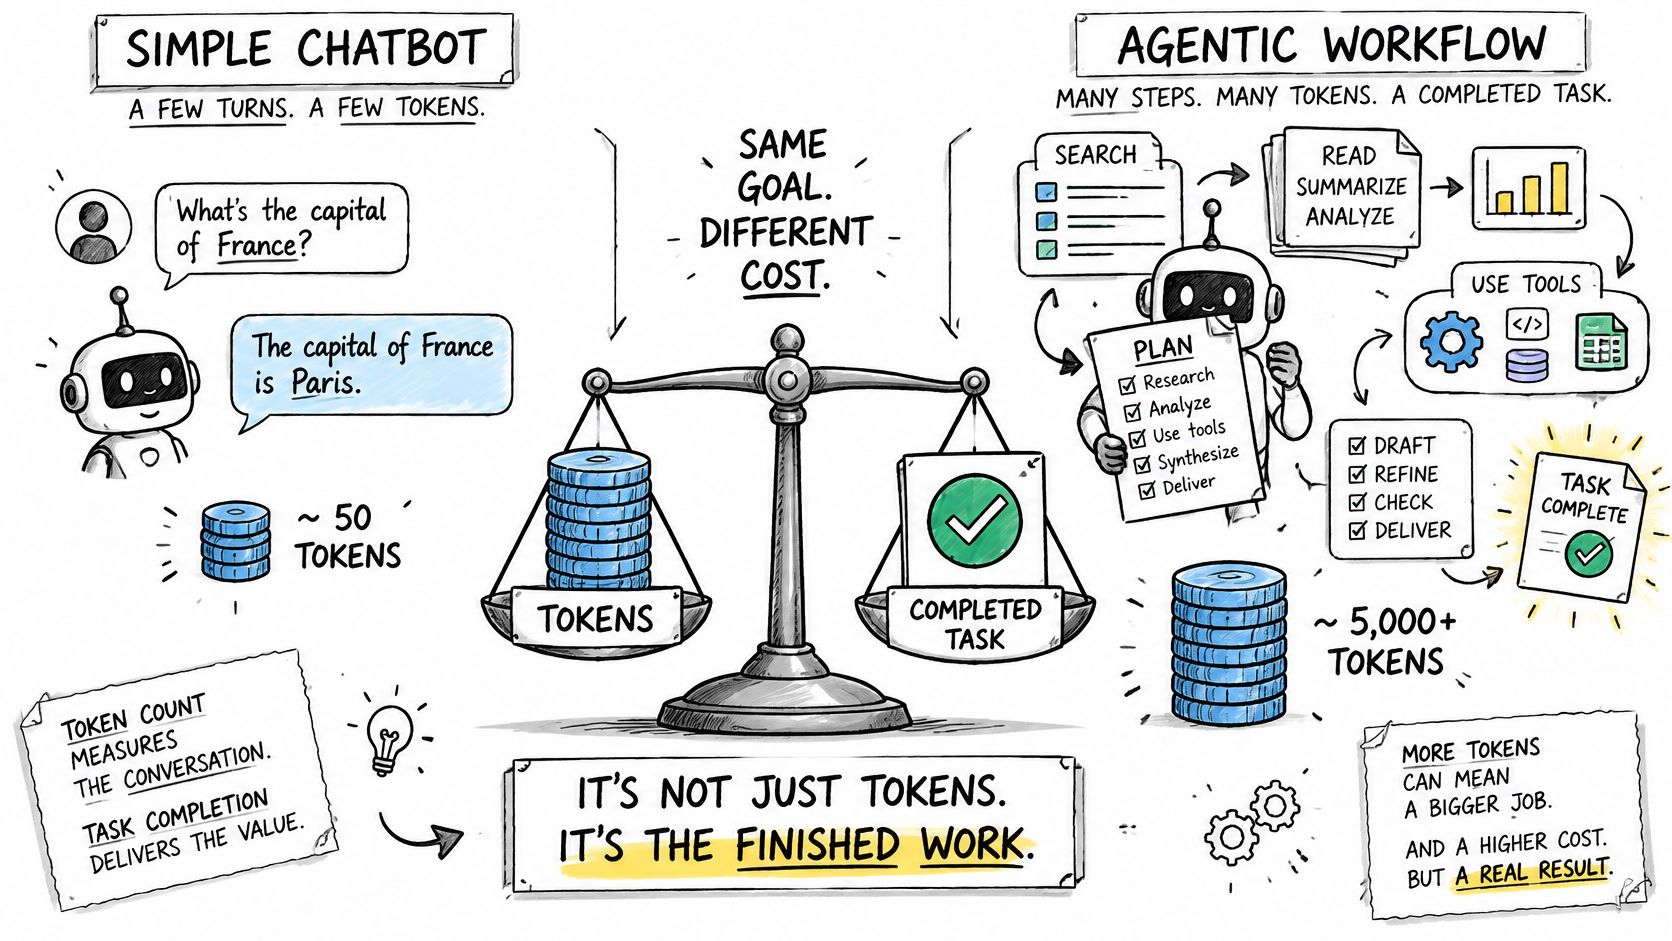
Análise de custo de workflow agêntico da Oometa descreve workflows agênticos consumindo 5–30 vezes mais tokens do que uma interação de chatbot convencional e estima aproximadamente $0.001 para uma chamada de chatbot simples versus $0.10–$1.00 para uma tarefa de agente de várias etapas. Trate isso como contexto, não como sua previsão: planejamento, recuperação, ferramentas, reflexão e novas tentativas diferem por implementação.
Coloque o trabalho malsucedido no numerador
Custo por resultado bem-sucedido = gasto total relacionado à tarefa ÷ tarefas concluídas com sucesso.
Em um lote hipotético, 1,000 tentativas a $0.10 cada custam $100. Se 800 tiverem sucesso, o custo por tarefa resolvida é $0.125, não $0.10. As tentativas malsucedidas ainda pertencem ao cálculo de custo.
Uma segunda comparação hipotética mostra por que os preços de tabela enganam:
| Modelo hipotético | Custo por tentativa | Taxa de sucesso | Custo por sucesso |
|---|---|---|---|
| Modelo de preço mais baixo | $0.05 | 30% | Cerca de $0.167 |
| Modelo de preço mais alto | $0.10 | 90% | Cerca de $0.111 |
Estes são exemplos aritméticos, não desempenho de modelo medido. Eles assumem tentativas comparáveis e uma taxa de sucesso inalterada; sua avaliação deve estabelecer ambos.
O vídeo oferece outra maneira de considerar os custos do workflow.
Acompanhe comprimento da saída, novas tentativas, fallbacks impulsionados pela latência e cobranças por solicitações malsucedidas em relação a um identificador de tarefa compartilhado. Inclua custos de ferramentas ou infraestrutura quando forem materiais, e distinga uma resposta de API de um sucesso de negócio.
Uma resposta de suporte que exige que um funcionário a reescreva não é equivalente a um ticket resolvido. Use o resultado que seu cliente precisa: um caso resolvido, um clipe aceito ou uma tarefa de codificação que passa em seus testes de aceitação.
Por Que os Preços dos Modelos Continuam Caindo
O modelo mais barato com desempenho equivalente ao nível GPT-3.5 no MMLU caiu de aproximadamente $20 por milhão de tokens em novembro de 2022 para $0.07 em outubro de 2024, aproximadamente 286 vezes mais barato, de acordo com o resumo da Orb dos dados reportados por Stanford. O Relatório do Índice de IA de 2025 da Stanford descreve o declínio do custo de inferência, com capacidade equivalente, nesse período como mais de 280 vezes.
Essa comparação mantém o limite de benchmark constante. Ela não compara apenas um modelo caro e capaz com um modelo mais fraco e barato, embora corresponder a um benchmark ainda não garanta um comportamento equivalente em sua aplicação.
Orçamento para oferta variável, não uma taxa permanente
Arquiteturas menores, quantização, software de inferência aprimorado, hardware especializado e a concorrência entre provedores contribuem para custos mais baixos. Cada um afeta uma parte diferente da economia: tamanho do modelo, precisão numérica, eficiência de serviço, utilização de hardware ou margem do fornecedor.
Para os compradores, a implicação prática é separar uma suposição de preço de uma suposição de qualidade. Uma taxa mais baixa é útil apenas se o candidato ainda atender aos seus critérios de aceitação.
- Mantenha um registro de preços datado: Salve o identificador do modelo, as taxas de entrada e saída, a unidade de cobrança e a data em que você as consultou.
- Use cenários de orçamento: Modele a demanda esperada juntamente com uma carga de trabalho mais pesada, com saídas mais longas e tarefas mais complexas.
- Agende revisões: Revise as taxas trimestralmente e investigue desvios significativos na fatura antes da próxima revisão agendada.
Um índice de preços de modelos pode ajudar a identificar candidatos que valem a pena retestar. Ele não deve substituir o registro de preços anexado aos seus próprios logs de solicitação.
Nosso preço listado é atualizado a cada 5 minutos. Ele usa o preço de tabela do provedor multiplicado pela parcela do preço de tabela cobrada durante a hora de negociação mais cara do marketplace nas últimas 24 horas, e nunca é inferior à oferta mais barata.
Verifique os termos contratuais de mudança de preço separadamente do seu cronograma de revisão. Um lembrete de calendário não torna uma taxa variável fixa, e os declínios históricos não são uma garantia de que todas as rotas se tornarão mais baratas.
Escolhendo Entre Créditos, Assinaturas e Cobrança por Uso
Um estudo do arXiv sobre precificação de produtos de IA descobriu que assinaturas com cotas de uso eram o maior padrão de precificação nativo de IA entre 52 produtos; 25 ofereciam um plano gratuito, teste ou créditos iniciais, enquanto 13 usavam precificação de entrada pay-as-you-go. Esse padrão não estabelece um vencedor universal. Ele mostra por que a cobrança de consumo puro não é a única estrutura sensata.
A decisão é sobre quem assume o risco de uso variável. Uma assinatura move parte do risco de demanda para o fornecedor, enquanto estruturas pré-pagas e medidas tornam o consumo mais visível para o comprador.
Use suas restrições operacionais para escolher
| Pergunta | O que a resposta sugere |
|---|---|
| O uso mensal é estável? | Uma assinatura com uma cota utilizável pode simplificar o orçamento |
| Você usará vários provedores ou modalidades? | Um saldo pré-pago compartilhado pode reduzir o financiamento fragmentado |
| Você consegue prever o consumo de forma confiável? | A medição é mais fácil de gerenciar quando as estimativas de carga de trabalho são confiáveis |
| O setor financeiro exige um limite rígido? | Priorize limites aplicáveis em vez de rótulos de cobrança |
Uso estável com um único provedor aponta para uma assinatura, desde que a franquia se ajuste à sua carga de trabalho real. Não conte a cota não utilizada como valor e verifique se os excedentes exigem aprovação ou acontecem automaticamente.
Demanda irregular em vários modelos aponta para créditos ou uso medido. Os termos de expiração e de acúmulo são importantes porque comprar capacidade que você nunca usa pode anular um desconto aparente.
Separe o financiamento da cobrança
Uma carteira pré-paga descreve quando você financia o uso, não necessariamente como cada solicitação é precificada. Da mesma forma, o pay-as-you-go pode operar por meio de um saldo pré-pago, em vez de uma fatura pós-paga.
Não temos taxa mensal nem mínimo. Os clientes mantêm um saldo e pagam conforme usam. Nossa opção de pagamento upto, oferecida primeiro, faz com que a carteira assine uma cotação como um teto; após a resposta, apenas o custo real é cobrado, arredondado para o próximo milionésimo de dólar.
Escolha a restrição da qual você não pode abrir mão antes de escolher o plano.
Se essa restrição for um orçamento fixo, inspecione os controles de gastos. Se for acesso previsível para uma equipe estável, inspecione a cota e as regras de excedente. Se for flexibilidade entre texto e mídia, verifique se o mesmo saldo suporta os fluxos de trabalho que você pretende executar.
Checklist do Provedor Além do Preço Listado
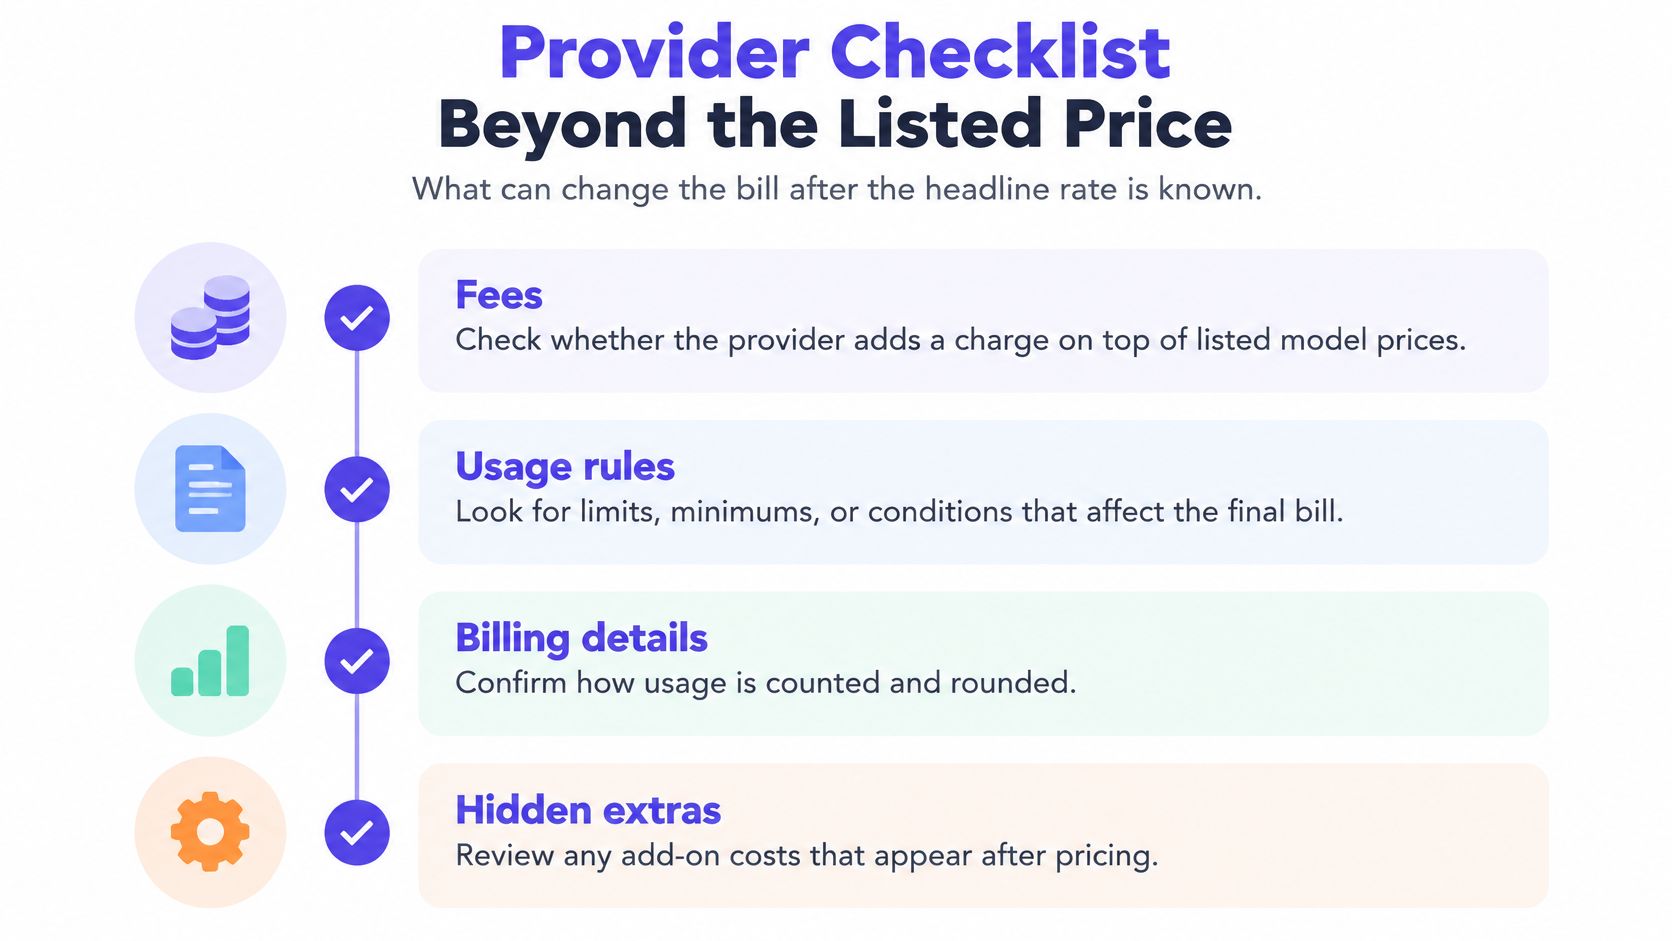
Uma tabela de preços não informa tudo o que é necessário para conciliar uma fatura de produção. Teste o comportamento de cobrança, não apenas a aritmética exibida em um playground.
Use este checklist para identificar os termos que precisam de uma resposta concreta.
Verifique o caminho de cobrança
- As taxas são explícitas. Não adicionamos nenhuma taxa além dos preços de modelo listados. Mantenha as taxas de financiamento separadas das taxas de solicitação ao comparar o gasto total. Uma resposta ruim é uma cotação que exclui uma sobretaxa de plataforma não especificada.
- A base de cobrança é rastreável. Quando o provedor informa o que cobrou por uma chamada, faturamos exatamente esse valor. Caso contrário, a chamada custa seus tokens ao preço listado. Uma resposta ruim é um total de fatura que não pode ser vinculado ao uso em nível de solicitação ou a cobranças relatadas.
- Solicitações malsucedidas têm tratamento definido. Nossas solicitações e gerações falhas não custam nada. Uma geração concluída que você não goste, no entanto, não deve ser automaticamente classificada como uma falha técnica. Uma resposta ruim deixa a distinção indefinida.
Verifique o caminho de controle
- As chaves fornecem isolamento. Nossas API keys são delimitadas e revogáveis, e limites de gasto por chave se aplicam. Uma chamada de ferramenta MCP é cobrada, limitada e recusada como a solicitação de API equivalente. Uma resposta ruim exige desabilitar todos os serviços para parar uma única integração comprometida.
- O comportamento de fallback é compreensível. Movemos as solicitações para outro vendedor saudável quando um provedor se torna lento ou indisponível. Teste a cobrança e o tempo resultantes em seus logs. Um provedor que não consegue explicar se uma rota alternativa altera a cobrança deixa você com um preço desconhecido.
Para cargas de trabalho mistas, inspecione como uma API unificada de texto, imagem e vídeo expõe o status e os resultados da tarefa. Uma solicitação de mídia assíncrona precisa de um identificador de tarefa durável para que o envio, a conclusão e a cobrança possam ser reconciliados mesmo quando ocorrem em momentos diferentes.
Execute essas verificações contra tráfego representativo em formato de produção, incluindo timeouts, cancelamentos e trabalhos falhos. Uma conta de demonstração com prompts curtos e respostas bem-sucedidas não revelará se sua contabilidade sobrevive às condições que sua aplicação deve lidar.
Confirme Seu Custo por Tarefa Antes de Se Comprometer
Use uma avaliação controlada em vez de migrar com base apenas em uma tabela de preços. O objetivo é descobrir qual opção oferece resultados aceitáveis a um custo operacional aceitável, sem alterar a carga de trabalho.
Execute uma comparação controlada
- Selecione tarefas representativas. Inclua solicitações rotineiras, casos difíceis, contexto longo e entradas que anteriormente causaram problemas. Mantenha material sensível do cliente fora de uma avaliação, a menos que seu uso seja autorizado.
- Capture o registro de execução. Faça o log de tokens de entrada e saída, identificadores de tarefa, retentativas, chamadas de ferramenta, cobranças e julgamentos de sucesso. Registre o tempo para um resultado utilizável, não apenas o tempo para a primeira resposta.
- Calcule a linha de base atual. Divida todos os gastos relevantes pelos resultados aceitos. Mantenha as classes de tarefa separadas para que solicitações fáceis não ocultem uma economia ruim em trabalhos difíceis.
- Teste modelos alternativos. Preserve prompts, inputs, permissões de ferramenta e testes de aceitação. Com nosso acesso comum à API, a troca de modelos usa um identificador de modelo diferente, e cada solicitação é roteada para o vendedor saudável mais barato.
- Aplique um orçamento de solicitação. Escolha limites apropriados para cada classe de tarefa e verifique como o aplicativo lida com recusas ou trabalho incompleto. Um limite deve produzir uma experiência de usuário controlada, não um erro inexplicável.
- Compare os resultados operacionais em conjunto. Avalie o custo por sucesso, latência e taxa de falha. Inspecione as saídas reais onde a pontuação automatizada pode perder erros factuais ou trabalho incompleto.
- Faça um piloto antes de se comprometer. Envie uma pequena parcela controlada de tráfego real para o candidato. Reconcilie as cobranças faturadas com seus logs durante o piloto e mantenha um caminho de reversão até que a qualidade e a contabilidade sejam confiáveis.
Torne a decisão repetível
Anote os critérios de aceitação antes de revisar nomes e preços de modelos. Caso contrário, é fácil desculpar uma saída mais fraca porque um candidato parece mais barato.
Mantenha o conjunto de avaliação versionado e adicione novos casos de falha conforme o aplicativo muda. Agende a próxima revisão trimestralmente, com um novo teste antecipado quando uma mudança material no modelo, preço ou produto tornar a comparação existente não confiável.
A opção vencedora não é o modelo mais barato isoladamente. É a configuração que completa sua carga de trabalho dentro de suas restrições de qualidade, latência e orçamento.
UberLLM oferece uma API key para modelos de texto e mídia, um saldo pré-pago compartilhado e roteamento para o vendedor saudável mais barato para cada modelo solicitado. Visite UberLLM para comparar os preços atuais, depois teste tarefas representativas e meça o custo dos resultados aceitos antes de mover o tráfego de produção.