Text-zu-Sprache-Modelle: Fähigkeiten und Auswahlleitfaden
Entdecken Sie Text-zu-Sprache-Modelle nach Eingabe, Ausgabe, Stimmklonung, Qualitätsmetriken und Zustimmungsregeln, mit Tabellen und einer Auswahl-Checkliste für 2026.
Neuronale und KI-generierte Stimmen machten 67.90% des Umsatzes im Text-to-Speech-Markt in 2024 aus, laut Branchentrend-Bericht von Sonix. Das misst Umsatz, nicht Zuverlässigkeit. Für einen Entwickler, der Text-to-Speech-Modelle auswählt, ist die schwierigere Frage, ob eine Stimme die Namen, Codes, Anweisungen und emotionalen Dialoge wiedergeben kann, die eine Anwendung sendet.
Eine schöne Demo beantwortet diese Frage nicht. Behandle die Modellauswahl als einen Input-und-Output-Vertrag, gefolgt von einer Evaluierung mit Produktionstext. Architektur, Stimmähnlichkeit und durchschnittliche Natürlichkeit sind wichtig, aber nichts davon sollte einen Fehler aufwiegen, der verändert, was der Zuhörer versteht.
Inhaltsverzeichnis
- Funktionen, Eingaben und Ausgaben auf einen Blick
- Architekturfamilien und ihre Bedeutung
- Stimmklonung, Skalierung und Sprachabdeckung
- Qualitätsmetriken, die über MOS hinausgehen
- Erstellen eines Testsets für schwierigen Text
- Modelle an Ihren Anwendungsfall anpassen
- Einwilligung, Offenlegung und sichere Stimmnutzung
- Gehostete APIs oder selbst gehostete offene Modelle
- Vorauswahl, Test und Abnahme
Fähigkeiten, Eingaben und Ausgaben auf einen Blick
| Fähigkeit | Typische Eingabe | Typische Ausgabe | Verwenden Sie es, wenn |
|---|---|---|---|
| Standard-TTS | Klartext | Audiodatei oder stream | Sie eine Erzählung aus festem oder vom Benutzer bereitgestelltem Text benötigen |
| Streaming-TTS | Textabschnitte, während sie generiert werden | Audioabschnitte in Wiedergabereihenfolge | Audio muss starten, bevor der vollständige Text bereit ist |
| Markup- oder stilgesteuerte TTS | Text mit SSML- oder style tags | Audio mit festgelegten Pausen, Betonung oder Emotion | Aussprache und Tempo kontrolliert werden müssen |
| Stimmklonung | Text plus Referenz-Audio mit dokumentierter Zustimmung | Audio in der Stimme des Referenzsprechers | Eine Marken- oder Benutzerstimme reproduziert werden muss |
| Mehrsprachige TTS | Text in mehreren Sprachen | Audio in jeder Sprache, mit einer oder vielen Stimmen | Ein Produkt Benutzer in vielen Sprachen bedient |
Standard-TTS ist der einfachste Vertrag: Text übermitteln und Sprache empfangen. Verwenden Sie es für vorbereitete Erzählungen, Benachrichtigungen und Passagen, deren Wortlaut bereits vollständig ist. Eine herunterladbare Datei eignet sich zum Bearbeiten und Caching; eine gestreamte Antwort kann das Warten auf die gesamte Audiodatei vermeiden.
Streaming-TTS erfordert eine genauere Prüfung. Einige Dienste streamen Audio, nachdem sie eine vollständige Texteingabe erhalten haben, während andere auch inkrementellen Text akzeptieren. Wenn ein Assistent seine Antwort schrittweise generiert, bestätigen Sie, dass die Schnittstelle Letzteres unterstützt, anstatt anzunehmen, dass streaming beide Richtungen bedeutet.
Markup-gesteuerte Synthese fügt Lieferanweisungen hinzu. SSML, Aussprachekontrollen und proprietäre style tags sind nicht austauschbar, testen Sie daher die genaue Syntax, die Ihr ausgewähltes Modell akzeptiert. Nicht unterstützte Anweisungen könnten ignoriert, abgelehnt oder laut ausgesprochen werden.
Klonen fügt eine Referenzsprecher-Eingabe hinzu, während mehrsprachige Synthese die Sprachabdeckung erweitert. Keines schließt das andere automatisch ein: Eine mehrsprachige voreingestellte Stimme ist nicht unbedingt klonbar, und eine geklonte Stimme ist nicht unbedingt in jeder unterstützten Sprache zuverlässig.
Wählen Sie den Audio-Vertrag vor der Stimme
WAV ist ein Container; PCM beschreibt eine Audio-Repräsentation. Unkomprimiertes PCM, oft in WAV verpackt, ist praktisch für Bearbeitung und Verarbeitung. Telefonie-Pipelines benötigen die encoding, channel configuration und sample rate, die ihre nachgeschalteten Systeme erwarten, nicht nur eine Datei mit einer bekannten Erweiterung.
MP3 und Opus sind komprimierte Lieferoptionen für Browser und Anwendungen, abhängig von der client support. Wählen Sie ein Format, das Ihr Player ohne eine zusätzliche Konvertierungsstufe dekodieren kann. Andernfalls beschreibt Ihre gemessene Syntheseleistung nicht die Verzögerung, die Benutzer erleben.
Sample rate gibt an, wie häufig Audio abgetastet wird. Sie beeinflusst den dargestellten Frequenzbereich und, bei unkomprimiertem Audio mit festen anderen Einstellungen, die Dateigröße. Das Erhöhen der output sample rate repariert keine unklare Aussprache und stellt keine Details wieder her, die das Modell nie generiert hat.
Vor der Integration, notieren Sie den Vertrag:
- Eingabebeschränkungen: Akzeptierte Textlänge, unterstütztes markup und inkrementelles Eingabeverhalten.
- Stimmenverfügbarkeit: Erforderliche Sprachen, Dialekte, voreingestellte Stimmen und custom-voice access.
- Ausgabeanforderungen: Encoding, sample rate, channels und streaming behavior.
- Fehlerverhalten: Wie die Anwendung abgelehnte Texte, unterbrochene streams und nicht verfügbare Stimmen handhabt.
Lesen Sie die Tabelle von links nach rechts: Gleichen Sie die Eingabe, die Sie haben, mit der Ausgabe ab, die Sie benötigen, und prüfen Sie dann, ob der Anwendungsfall passt. Eine Stimme, die hervorragend klingt, aber das falsche Interaktionsmuster erfordert, gehört nicht auf die Auswahlliste.
Architekturfamilien und was sie bedeuten
| Familie | Wie sie Sprache erzeugt | Hauptkompromiss |
|---|---|---|
| Konkatenativ | Fügt vorab aufgenommene Spracheinheiten zusammen | Natürlich innerhalb des aufgenommenen Bereichs, schwach außerhalb davon |
| Statistisch-parametrisch | Sagt akustische Merkmale voraus, dann rendert ein vocoder Audio | Flexibel, aber oft gedämpft |
| Neuronale Wellenform | Erzeugt Audio-Samples mit einem neural network | Hohe Natürlichkeit, rechenintensiv ohne Optimierung |
| Token-basiert neuronal | Sagt diskrete audio codes aus Text voraus | Skaliert gut mit Daten, erfordert sorgfältige Kontrolle von Stil und Sprecher |
Die groben Pipeline-Unterscheidungen sind unten dargestellt.
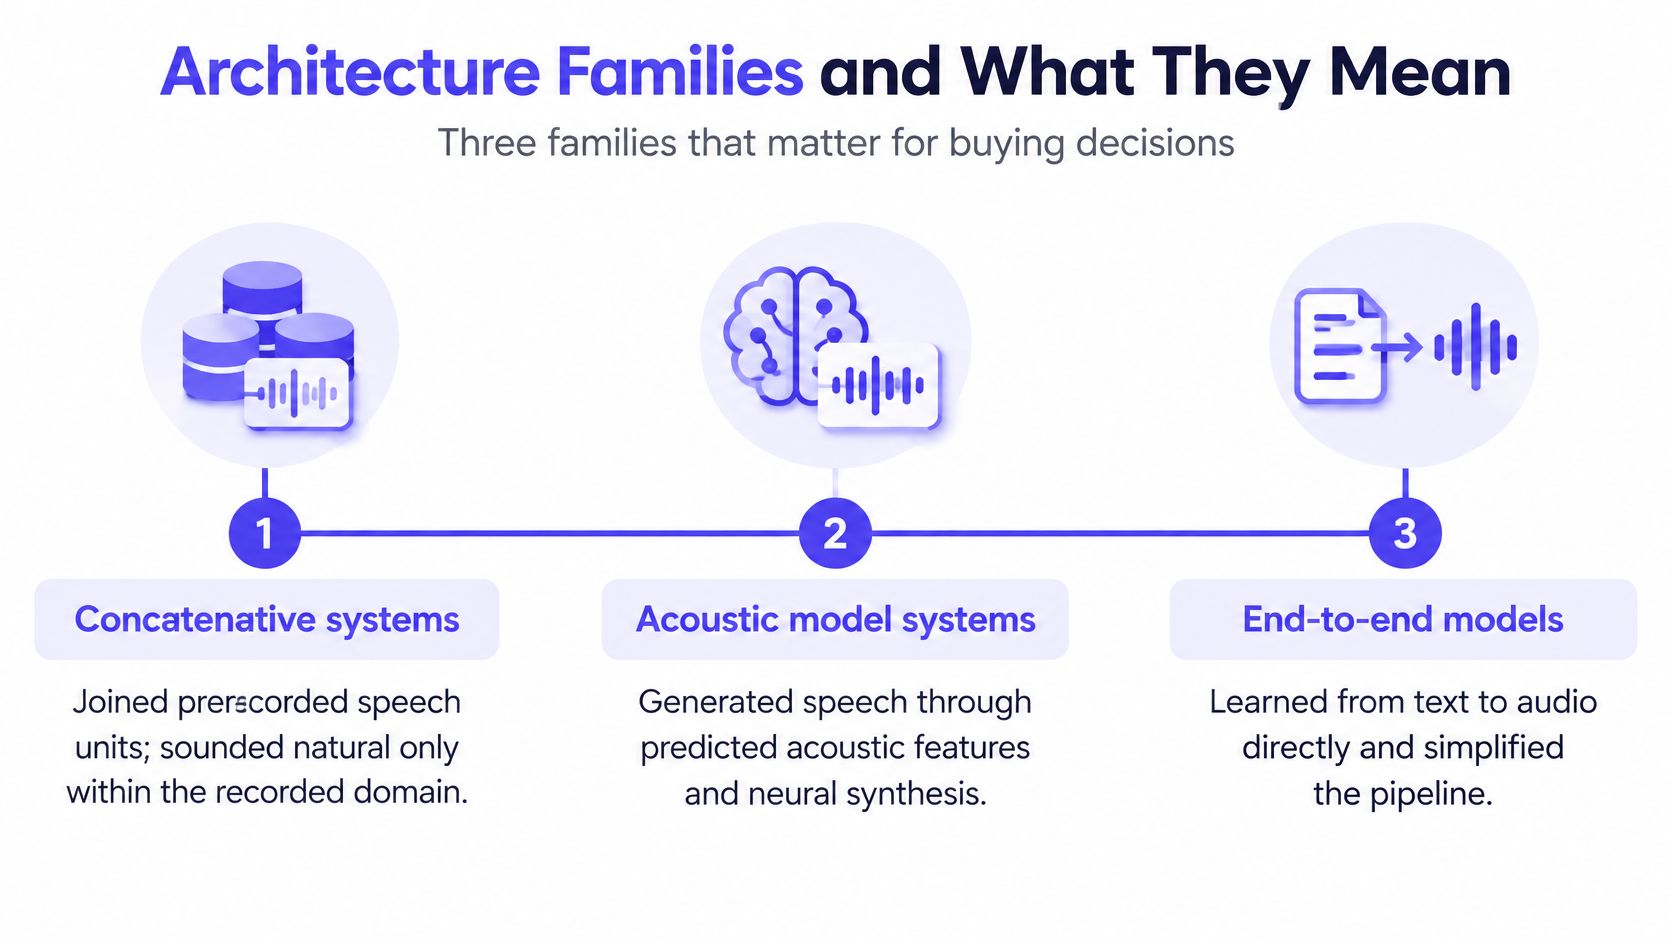
Konkatenative Systeme setzen aufgenommene Einheiten zusammen, daher ist ihre Flexibilität durch die verfügbaren Aufnahmen und die Übergänge zwischen ihnen begrenzt. Statistisch-parametrische Systeme sagen stattdessen akustische Eigenschaften voraus und rendern dann Sprache durch einen vocoder, wobei sie die direkte Wiederverwendung von Aufnahmen gegen eine besser steuerbare Synthese-Pipeline eintauschen.
Ein Meilenstein wurde mit WaveNet im Jahr 2016 erreicht: Das WaveNet paper berichtete über eine Reduzierung von mehr als 50% der Qualitätslücke zwischen den stärksten bestehenden TTS-Systemen und menschlicher Sprache in seinen Bewertungen für US-Englisch und Mandarin-Chinesisch. Diese Erkenntnis etablierte die Bedeutung der neuronalen Wellenformgenerierung, nicht eine universelle Leistungsgarantie für jedes spätere neural model.
Token-basierte neural systems sagen diskrete Audio-Repräsentationen voraus, die ein decoder in Klang umwandelt. Für Kaufentscheidungen unterscheiden Sie diese Repräsentation von der service interface: Ein End-to-End-Produkt kann immer noch mehrere interne Verarbeitungsstufen enthalten.
Model Cards als Pipeline-Beschreibungen lesen
Achten Sie auf spectrogram, vocoder, codec, audio tokens und Details zur Sprecherkonditionierung. Eine spectrogram-Stufe, gefolgt von einem vocoder, deutet auf eine acoustic-model pipeline hin; diskrete audio codes deuten auf token-basierte Generierung hin. Trainingsbeschreibungen helfen, das Design zu erklären, ersetzen aber nicht das output testing.
Für eingeschränkte Geräte vergleichen Sie den tatsächlichen memory, runtime und die hardware compatibility, anstatt anzunehmen, dass älter kleiner oder neuer cloud-only bedeutet. Bei hosted deployment prüfen Sie die gelieferte latency und controls, anstatt sie aus dem architecture label abzuleiten.
Die Grenze ist auch für angrenzende Aufgaben wichtig. Ein singing voice synthesis guide behandelt ein anderes Steuerungsproblem: Gesprochene Prosodie ist kein Ersatz für explizites musikalisches Timing und pitch.
Praktische Regel: Nutzen Sie die Architektur, um wahrscheinliche Einschränkungen und nützliche Diagnosefragen zu verstehen, nicht um einen Gewinner zu küren, bevor Sie zugehört haben.
Stimmklonung, Skalierung und Sprachabdeckung
Stimmklonung trennt die Sprecheridentität von den gesprochenen Wörtern. Bewerten Sie diese Dimensionen unabhängig voneinander: Eine Ausgabe kann dem Referenzsprecher ähneln, während der Satz mit unpassender Emotion wiedergegeben wird.
Die wichtigsten Klonungswege unterscheiden sich darin, wie sie diese Identität herstellen.
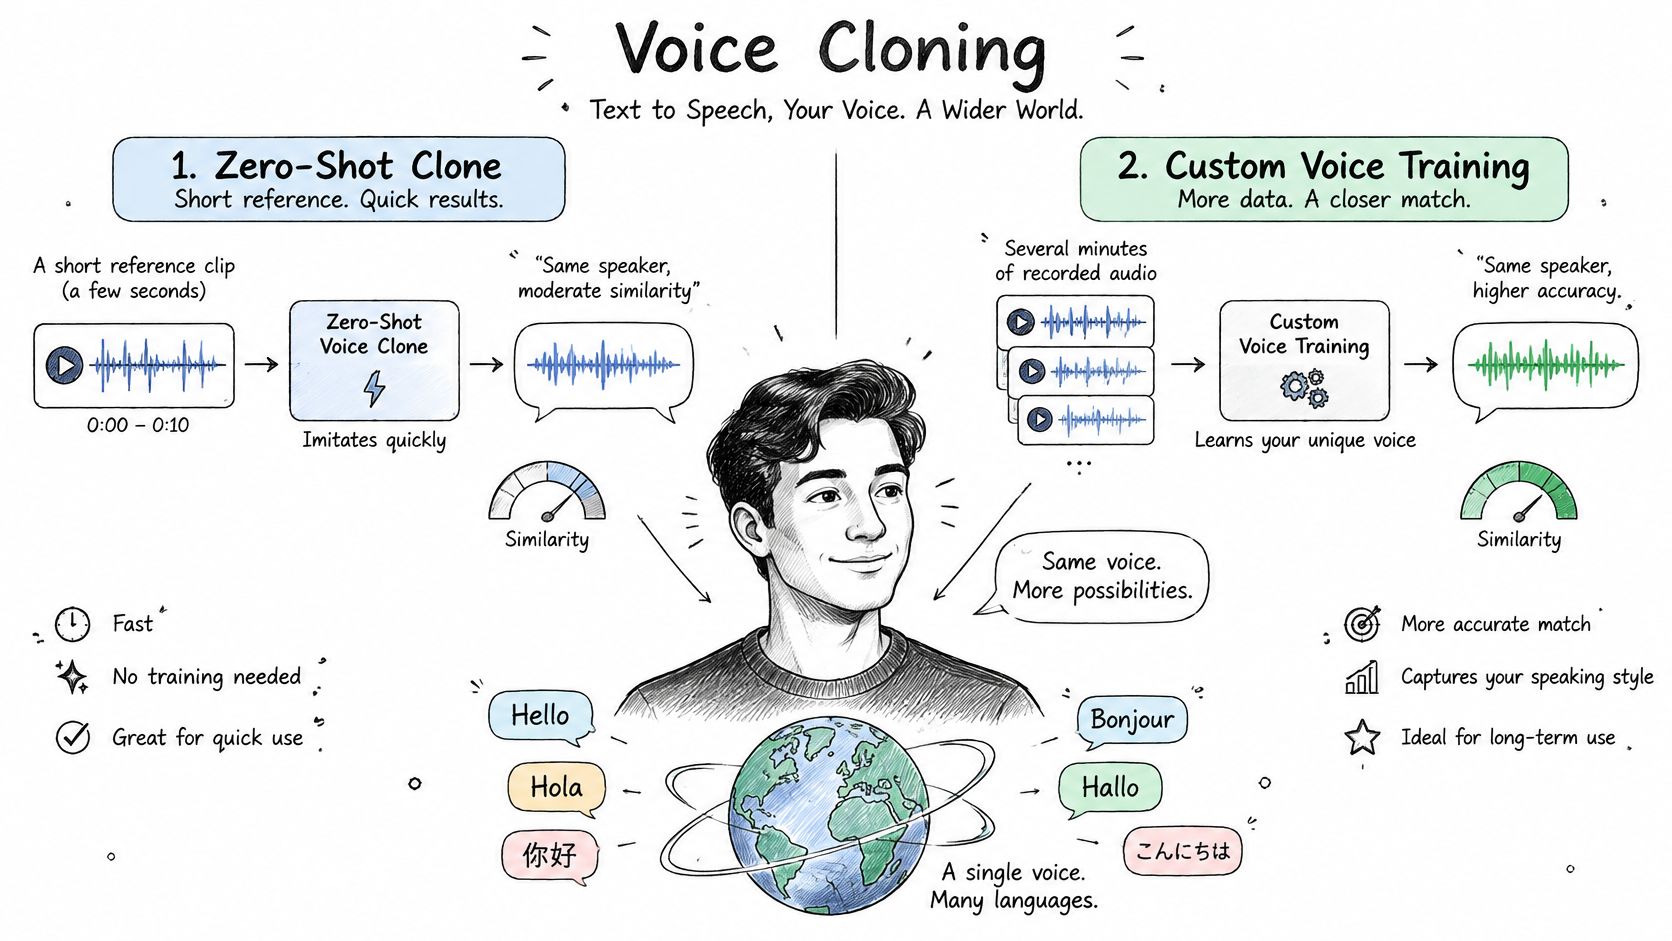
Zero-Shot-Klonung bedingt die Synthese auf Referenz-Audio ohne einen separaten sprecherspezifischen Trainingsjob. Benutzerdefiniertes Stimmtraining passt ein Modell mithilfe eines vorbereiteten Sprecherdatensatzes an. Ersteres reduziert den Einrichtungsaufwand; letzteres fügt Anforderungen an Aufnahme, Vorbereitung und Training hinzu, ohne die Ähnlichkeit automatisch zu machen.
Die Referenzqualität verdient einen eigenen Test. Hintergrundgeräusche, konkurrierende Sprecher, inkonsistente Mikrofonplatzierung und stark unterschiedliche Vortragsstile können es erschweren zu bestimmen, was das System bewahren sollte. Vergleichen Sie saubere Referenzen, bevor Sie ein schwaches Ergebnis vollständig dem Synthesemodell zuschreiben.
Ähnlichkeit von Performance trennen
Betrachten Sie einen hypothetischen Vergleich zwischen einer kurzen, neutralen Referenz und einer längeren Referenz, die mehrere emotionale Vorträge enthält. Generieren Sie aus jeder den gleichen optimistischen Marketing-Satz. Fragen Sie Zuhörer separat, ob der Sprecher erkennbar klingt und ob der optimistische Vortrag angemessen klingt.
Gehen Sie nicht davon aus, dass die längere Referenz gewinnen muss. Sie enthält mehr Material, führt aber auch mehr Variationen ein; die nützliche Frage ist, ob das Modell die Identität bewahrt, während es der angeforderten Performance folgt.
Für eine audiovisuelle Einführung in das Thema bietet das folgende Video ein weiteres Betrachtungsformat.
Skalierung liefert Kontext, keine Abnahme. In seiner 2024 Berichterstattung berichtete TechCrunch, dass BASE-large 100,000 Stunden gemeinfreie Sprache für das Training verwendete und 980 Millionen Parameter enthielt. Diese Gesamtzahlen legen nicht fest, wie ein bestimmter Akzent, Sprecher oder eine Sprache performen wird.
Bei der Prüfung einer mehrsprachigen TTS-Modellliste, wandeln Sie die beworbene Fähigkeit in konkrete Abnahmekriterien um:
- Sprachabdeckung: Bewerten Sie jede erforderliche Sprache und jeden Dialekt mit fließend sprechenden Zuhörern.
- Identitätsstabilität: Vergleichen Sie den Sprecher über Fragen, Aussagen und ausdrucksstarken Dialog hinweg.
- Fallback-Bereitschaft: Identifizieren Sie eine genehmigte voreingestellte Stimme für nicht verfügbare oder ungeeignete Klone.
- Referenzherkunft: Bewahren Sie den Aufnahme-Identifikator und die zugehörige Genehmigungsaufzeichnung auf.
Eine erkennbare Stimme ist nur dann nützlich, wenn ihre Wiedergabe über die tatsächlichen Nachrichten des Produkts hinweg verständlich und angemessen bleibt.
Qualitätsmetriken, die über MOS hinausgehen
Ein Benchmark kann reproduzierbar sein, ohne repräsentativ zu sein. Das LJSpeech-Datenset enthält 13,100 Clips mit einer Gesamtdauer von etwa 24 Stunden, aufgenommen von einer einzelnen englischsprachigen Sprecherin. Das ist nützlich für kontrollierte Vergleiche, aber ein Erfolg in diesem Rahmen begründet keine breitere Leistung über verschiedene Sprecher, Akzente oder Konversationsstile hinweg.
Der Mean Opinion Score, oder MOS, misst die von Zuhörern bewertete wahrgenommene Qualität. Halten Sie die Sätze und Hörbedingungen über alle Modelle hinweg konsistent, verbergen Sie die Modellidentitäten und definieren Sie die Bewertungsfrage klar. Ein Panel, das nach der Angenehmheit gefragt wird, bewertet nicht unbedingt, ob ein Produktcode korrekt gesprochen wurde.
| Metrik | Was sie misst | Wie man sie misst | Hauptgrenze |
|---|---|---|---|
| MOS | Wahrgenommene Qualität auf einer Hörskala von schlecht bis exzellent | Ein Hörpanel bewertet dieselben Sätze von jedem Modell | Isoliert keine Aussprache- oder Rhythmusfehler ohne gezielte Fragen |
| Intelligibilität | Ob Zuhörer die Wörter erkennen können | Transkribieren Sie die Ausgabe mit einem Spracherkenner und vergleichen Sie sie mit dem beabsichtigten Text | Fehler des Erkenners können Synthesefehler verdecken |
| Zeit bis zum ersten Audio | Verzögerung, bevor nutzbares Audio ankommt oder abgespielt wird | Zeitstempel für Anforderungsübermittlung, ersten Audioempfang und Wiedergabe separat | Sagt nichts über die Sprachqualität aus |
| Echtzeitfaktor | Synthesezeit geteilt durch Audiodauer | Generierungszeit messen und durch Ausgabedauer teilen | Ändert sich mit Hardware, Last und Messgrenzen |
| Reproduzierbarkeit | Konsistenz über wiederholte Läufe und Versionen hinweg | Offengelegte Einstellungen und Seeds fixieren, dann erneut ausführen und vergleichen | Einige Dienste legen Seeds oder Versions-Pins nicht offen |
Definieren Sie, was Ihre Stoppuhr umfasst
Beim streaming unterscheiden Sie zwischen erstmals empfangenem Audio und erstmals hörbarer Wiedergabe. Netzwerkübertragung, Dekodierung und Player-Pufferung gehören zur Benutzererfahrung, auch wenn sie außerhalb der Modellinferenz stattfinden. Zeichnen Sie beides auf, wenn Sie Verzögerungen diagnostizieren.
Vergleichen Sie beim Intelligibilitätstesting die erkannte Sprache mit der beabsichtigten gesprochenen Form, nicht blind mit rohen Eingabezeichen. Ein akzeptables gesprochenes Datum stimmt nicht Zeichen für Zeichen mit seiner schriftlichen Notation überein. Überprüfen Sie Fehler, die Namen, Zahlen und Symbole betreffen, manuell, bevor Sie den Erkennungsdienst als Ground Truth behandeln.
Ein Qualitätsmittelwert ist eine Beschreibung eines Tests. Er ist kein Akzeptanzkriterium, bis Sie definieren, welche Fehler das Produkt tolerieren kann.
Kombinieren Sie automatisierte Prüfungen mit dem Hören. Tonhöhenmessungen allein beschreiben nicht Rhythmus, Betonung oder Intensität, und Wellenformunterschiede bedeuten nicht unbedingt, dass Zuhörer eine bedeutsame Änderung hören.
Berichten Sie MOS, Intelligibilität, Zeit bis zum ersten Audio und Echtzeitfaktor zusammen. Fügen Sie die Modellversion, die Laufzeitumgebung, die Anforderungseinstellungen und die Messgrenzen hinzu, damit ein anderer Ingenieur das Ergebnis interpretieren kann.
Ein Testset für schwierigen Text erstellen
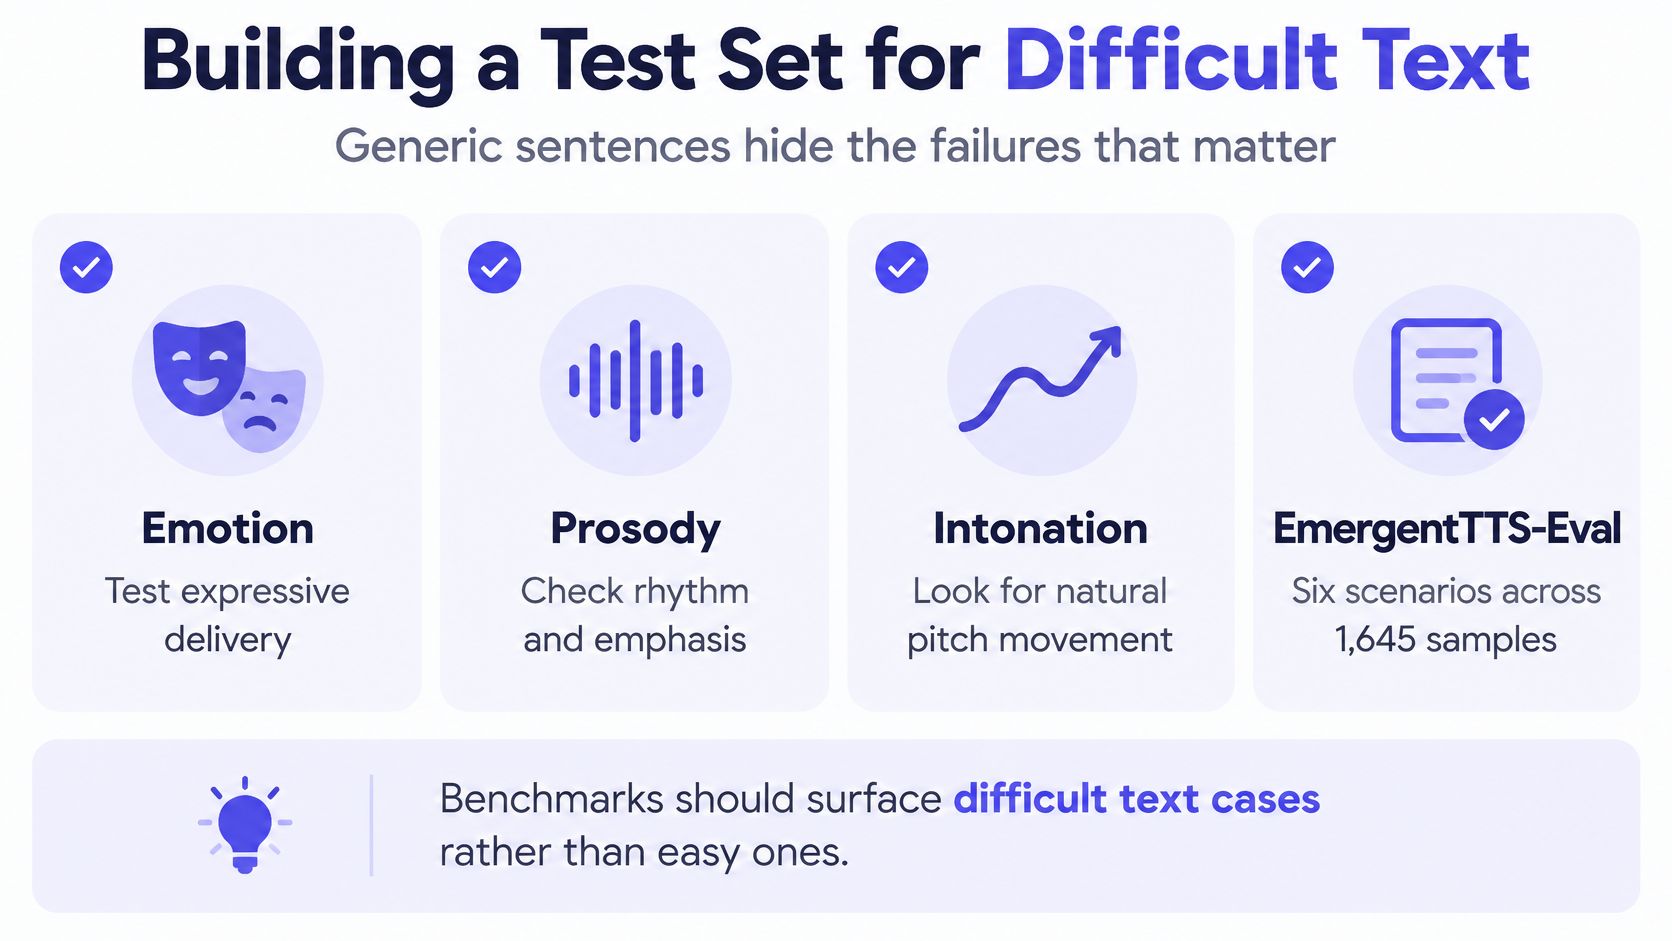
Generische Sätze sind schwache Abnahmetests, weil sie den Text weglassen, der interpretiert werden muss. EmergentTTS-Eval bewertet sechs Szenarien über 1,645 Beispiele hinweg, die Emotion, Prosodie, Intonation und Aussprache abdecken; die Autor:innen berichten von einer starken Korrelation zwischen modellbasierter Bewertung und menschlichen Präferenzen.
Nutze diesen breiteren Ansatz, ohne einen externen Benchmark als Testsuite deines Produkts zu behandeln. Deine Anwendung hat ihr eigenes Vokabular, ihre eigene Formatierung und ihre eigenen Konsequenzen bei Fehlern.
Die Bewertungskategorien unten helfen, Fehler aufzudecken, die einfache Lesepassagen nicht zeigen.
Text aufnehmen, der bei falscher Lesart die Bedeutung ändert
- Namen und Orte: Produktnamen, Marken, Personennamen, Adressen und Postleitzahlen.
- Kompakte Bezeichner: Akronyme, Kontoangaben, Produktcodes und mehrdeutige Abkürzungen.
- Strukturierte Notation: Datumsangaben, Uhrzeiten, URLs, Codefragmente und mathematische Formeln.
- Sprachwechsel: Fremdwörter und gemischtsprachige Passagen.
- Gesprächsabsicht: Fragen, Beruhigung, Dringlichkeit, Widerspruch und emotional aufgeladene Dialoge.
- Nicht-sprachliche Signale: Lachen, Seufzen und andere unterstützte Sprechanweisungen.
Erfasse für jeden Eintrag die beabsichtigte Lesart. Ein Code muss vielleicht Zeichen für Zeichen buchstabiert werden, während ein Akronym vielleicht als Wort ausgesprochen werden muss. Ohne diese Anmerkung können sich Zuhörer:innen über die Korrektheit uneinig sein, selbst wenn sie dieselbe Ausgabe hören.
Einen wiederholbaren Vergleich durchführen
- Repräsentativen Text sammeln. Extrahiere Produktionsbeispiele und anonymisiere sie, tagge sie anschließend nach Kategorie. Nimm ungewöhnliche Eingaben auf, bei denen ein Fehler ernste Folgen hätte.
- Vergleichbare Ausgaben erzeugen. Halte Format, Stimmenrolle und Sprechanweisungen nach Möglichkeit gleichwertig. Speichere die exakte Anfrage und die Modellkennung.
- Konsistente Zuhörer:innen einsetzen. Bitte dasselbe Panel, Verständlichkeit, Aussprache und prosodische Angemessenheit getrennt zu bewerten. Mische die Modellreihenfolge.
- Leistung pro Eintrag erfassen. Erfasse die Zeit bis zum ersten Audio und den Echtzeitfaktor zusammen mit dem zugehörigen Text, statt nur einen Batch-Durchschnitt zu speichern.
- Nach Änderungen wiederholen. Behalte eine freigegebene Baseline bei und untersuche Regressionen, wenn sich ein Anbieter, eine Stimmenkonfiguration oder eine Vorverarbeitungsregel ändert.
Angenommen, ein Support-Prompt enthält den Nachnamen einer Kundin oder eines Kunden und ein Termindatum. Ein wunderschön vorgetragener Satz, bei dem eines von beidem falsch ist, sollte gegen eine weniger ausdrucksstarke, aber korrekte Alternative verlieren.
Melde Fehlerraten nach Kategorie und Schweregrad. Ein Gesamtwert kann genau die Fehlerklasse verdecken, die einen Einsatz blockieren sollte.
Modelle auf deinen Anwendungsfall abstimmen
| Anwendungsfall | Kriterien, die am meisten zählen | Was du zuerst testen solltest |
|---|---|---|
| Telefon-Prompts für den Kundensupport | Zeit bis zum ersten Audio, Aussprache von Namen und Produktcodes | Ein realistischer Prompt mit einem Namen und einem Code über den Telefon-Wiedergabepfad |
| Hörbuchnarration im Langformat | Prosodie über Absätze hinweg, Stabilität über lange Passagen | Konsistenz über eine längere Passage mit Dialog und Szenenwechseln |
| Barrierefreiheit und Screenreader | Verständlichkeit, zuverlässige Steuerung der Sprechgeschwindigkeit | Klarheit bei der schnellsten Geschwindigkeit, die Nutzer wahrscheinlich wählen würden |
| Video-Dubbing und Medien | Emotionale Bandbreite, Timing im Abgleich mit Referenzclips | Übereinstimmung mit Länge und Emotion des Referenzclips |
| Bildung und Training | Aussprache von Fachbegriffen, Formeln und Fremdwörtern | Formeln, Akronyme und fremde Namen aus dem Kursmaterial |
Die stärkste Eigenschaft eines Modells zählt nur, wenn sie die Aufgabe unterstützt. Der folgende Vergleich veranschaulicht die unterschiedlichen Prioritäten.
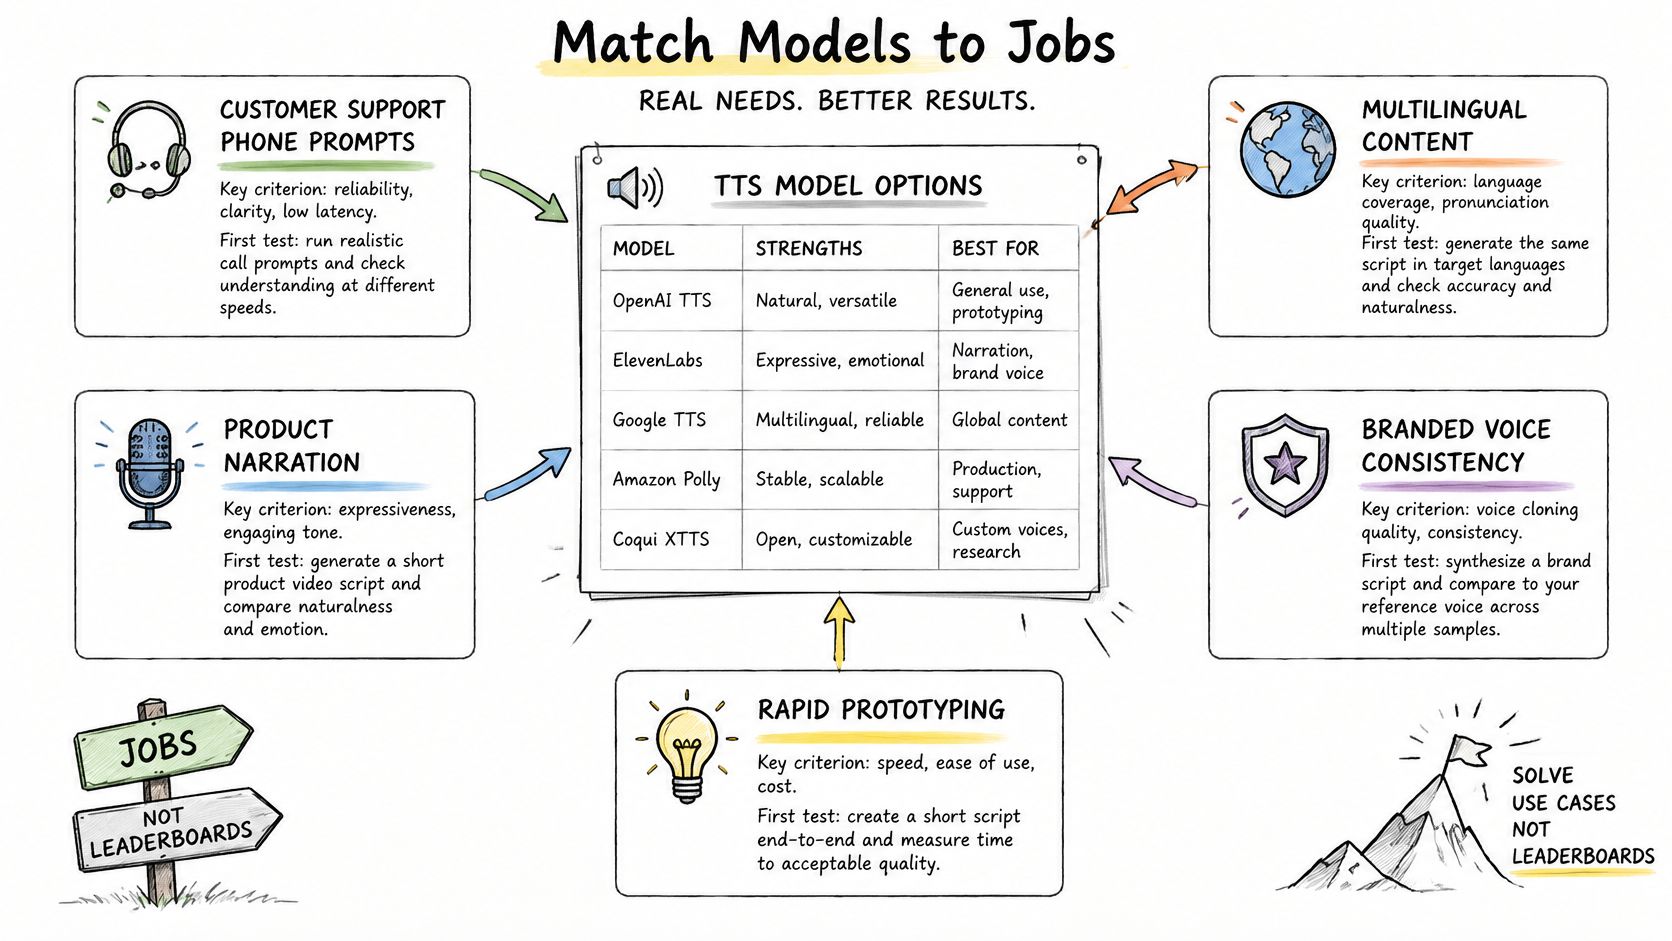
Teste für den Kundensupport den tatsächlichen Telefonpfad, statt nur Downloads in Studioqualität zu prüfen. Höre bei Hörbüchern über Absatzgrenzen, Sprecherwechsel und wiederaufgenommene Generierung hinweg, denn isolierte Sätze prüfen die Kontinuität nicht.
Die Bewertung der Barrierefreiheit sollte die Menschen einbeziehen, die die Ausgabe nutzen werden, und ihre bevorzugten Wiedergabesteuerungen. Dubbing braucht eine Referenzdarbietung und Timing-Vorgaben; Bildung braucht eine fachliche Prüfung der beabsichtigten gesprochenen Notation.
Harte Ausschlusskriterien vor Präferenzen anwenden
Wenn Latenz die Interaktion bestimmt, verlange eine geeignete Streaming-Schnittstelle, bevor du Stimmen in eine Rangfolge bringst. Eine verzögerte Antwort kann das Interaktionsdesign scheitern lassen, unabhängig von ihrer letztendlichen Qualität.
Wenn eine bestimmte Sprecheridentität zwingend erforderlich ist, hole die Erlaubnis ein, bevor du Bewertungsklone erstellst. Mach die Autorisierung nicht erst in der Produktion zum Thema, nachdem das Team eine Stimme liebgewonnen hat.
Wenn Codes und Datumsangaben die Botschaft tragen, priorisiere ihre korrekte Vorleseweise vor angenehmem Klang. Behandle kritische Aussprachefehler als Blocker, statt zuzulassen, dass starke Stilbewertungen sie ausgleichen.
Auswahlprinzip: Bringe akzeptable Modelle in eine Rangfolge, nachdem du harte Anforderungen angewendet hast. Verrechne einen disqualifizierenden Fehler nicht mit einer ansonsten attraktiven Bewertung.
Schreibe diese Ausschlusskriterien auf, bevor du Ergebnisse prüfst. Zum Beispiel braucht ein Kurs-Sprecher vielleicht zuverlässiges Fachvokabular, aber kein Streaming für Konversationen, während ein Sprachassistent vielleicht inkrementelle Texteingabe, aber kein Klonen braucht. Diese Unterscheidung verengt den Vergleich, ohne dich auf eine allgemeingültige Bestenliste zu verlassen.
Einwilligung, Offenlegung und sichere Stimmennutzung
Voice-Cloning ist eine Governance-Entscheidung, nicht nur eine Synthese-Einstellung. Die Responsible-TTS-Leitlinie beschreibt die Einstufung KI-generierter Robocall-Stimmen durch die FCC als künstliche Stimmen im Rahmen des Telephone Consumer Protection Act; dadurch sind erfasste Anrufe ohne die erforderliche vorherige Einwilligung rechtswidrig. Interpretieren Sie das nicht als pauschales Verbot synthetischer Sprachausgabe oder als Erlaubnis für jede Nutzung, die kein Robocall ist.
Gewöhnliche synthetische Sprachausgabe und identitätsbewahrendes Klonen erfordern eine unterschiedliche betriebliche Prüfung. Die Auswahl einer lizenzierten voreingestellten Stimme begründet nicht das Recht, eine identifizierbare Person nachzuahmen. Für individuelle Stimmen sollte eine dokumentierte Sprecherfreigabe eine Voraussetzung für den Einsatz sein.
Kontrollen in den Anfragepfad einbauen
- Sprecherfreigabe erfassen: Halten Sie den autorisierten Zweck, die zulässigen Kanäle, den Nutzungsumfang sowie Ablauf- oder Überprüfungsbedingungen zusammen mit dem Stimmeneintrag fest.
- Unbefugte Nachahmung ablehnen: Untersagen Sie das Klonen identifizierbarer Personen ohne schriftliche Genehmigung und bieten Sie eine Möglichkeit, umstrittene Stimmen zu sperren.
- Offenlegungsregeln anwenden: Kennzeichnen Sie synthetische Sprache, wenn geltendes Recht, Plattformrichtlinien oder der Kontext es erfordern.
- Prüfbarkeit erhalten: Protokollieren Sie die Modellkennung, die Stimmenkennung, den Anfragezeitpunkt und die Autorisierungsreferenz, ohne sensiblen Text unnötig zu duplizieren.
- Sichere Alternativen bereithalten: Genehmigen Sie Fallback-Stimmen, die nicht dazu gedacht sind, identifizierbare Personen nachzuahmen.
- Modell-Metadaten aufbewahren: Speichern Sie offengelegte Trainingsdatenquellen, Lizenzen, Nutzungsbeschränkungen und relevante Evaluierungsdokumentation.
Ein Freigabedatensatz braucht außerdem einen Widerrufsprozess. Legen Sie fest, wer eine Stimme deaktivieren kann, wie mit zwischengespeichertem Audio umgegangen wird und was mit geplanten Inhalten passiert, wenn sich die Autorisierung ändert.
Bewerten, wem das System dient
Testen Sie die Leistung bei Akzent, Dialekt und Sprache getrennt. Ein globaler Durchschnitt kann eine schlechte Erfahrung für eine bestimmte Sprechergruppe verdecken; bewahren Sie daher Ergebnisse auf Gruppenebene auf, wo Erhebung und Berichterstattung angemessen sind.
Governance muss auch dem Routing folgen. Wenn Anfragen verschiedene Anbieter erreichen können, gehen Sie nicht davon aus, dass eine Stimmenautorisierung oder eine Verarbeitungsvereinbarung für jedes Ziel gilt. Beschränken Sie das Routing auf genehmigte Kombinationen aus Modell, Stimme und Verarbeitungsbedingungen.
Dies ist allgemeine operative Orientierung, keine Rechtsberatung. Prüfen Sie vor der Freigabe die Gesetze und vertraglichen Anforderungen, die für die sprechende Person, das Publikum und den Bereitstellungsort gelten.
Gehostete APIs oder selbst gehostete offene Modelle
Die Bereitstellung bestimmt, was du kontrollierst und was du betreiben musst. Eine gehostete API verlagert das Modell-Serving auf einen externen Betreiber. Selbst-Hosting gibt deinem Team die Verantwortung für Runtime, Kapazität, Updates und Zugriffskontrollen.
Offene Gewichte bedeuten nicht automatisch uneingeschränkte kommerzielle Nutzung, Offline-Eignung oder geringe Hardwareanforderungen. Prüfe die Lizenz- und Runtime-Anforderungen, bevor du in die Integration investierst. Ebenso garantiert ein gehosteter Endpoint nicht automatisch feste Versionen oder eine bestimmte Datenresidenz-Regelung.
| Entscheidungskriterium | Gehostete API | Selbst gehostetes offenes Modell |
|---|---|---|
| Kosten bei erwartetem Volumen | Nutzungsgebühren plus Integrations- und Bereitstellungskosten | Compute, Storage, Leerkapazität und Engineering-Aufwand |
| Latenz bei Spitzenlast | Umfasst Netzwerkpfad und Warteschlangen auf der Dienstseite | Hängt von bereitgestellter Hardware und deiner Planung ab |
| Datenresidenz | Erfordert die Prüfung der Verarbeitungsstandorte und Bedingungen | Kann innerhalb der Infrastruktur bleiben, die du kontrollierst |
| Versionsverwaltung | Unterliegt den Pinning- und Update-Optionen des Dienstes | Dein Team kontrolliert Artefakte und den Rollout-Zeitpunkt |
Vergleiche die gesamten Betriebskosten
Gehostetes Deployment kann zu variablem Bedarf und zu Teams passen, die keine Inferenz-Hardware betreiben möchten. Bestätige die Abrechnungseinheit, die Nebenläufigkeitslimits und den Umgang mit Wiederholungen, bevor du die Kosten schätzt. Ein auf Zeichen basierender Preis allein beschreibt nicht die vollständige Rechnung der Anwendung.
Selbst-Hosting kann zu Offline-Betrieb oder Anforderungen passen, die das Senden von Text und Referenzaufnahmen außerhalb kontrollierter Infrastruktur verbieten. Es erfordert weiterhin Kapazitätsplanung, Monitoring, Sicherheitsupdates und einen reproduzierbaren Release-Prozess. Ein Modell, das auf einer Workstation läuft, ist nicht unbedingt für gleichzeitigen Produktionsverkehr bereit.
Betrachte das Qwen TTS Modelllisting als Ausgangspunkt für einen Kandidaten, nicht als Nachweis seiner Eignung für eine bestimmte Hosting-Konfiguration. Bestätige die tatsächliche Runtime, Lizenz und Schnittstelle für das Deployment, das du bewertest.
Teste den Serving-Pfad, nicht nur die Gewichte
Verwende denselben anonymisierten Korpus für gehostete und selbst gehostete Kandidaten. Halte das Wiedergabeformat und den Testclient konsistent und miss dann unter den Nebenläufigkeits- und Anfragemustern, die die Anwendung erwartet.
Halte fest, ob der Test Start, Laden, Warteschlangen und Konvertierung umfasst. Andernfalls sind ein warmer lokaler Benchmark und eine vollständige entfernte Anfrage nicht vergleichbar.
Wenn dein Testset personenbezogene Informationen enthält, prüfe die Datenverarbeitungsbedingungen, bevor du sie überträgst. Entferne unnötige Identifikatoren, auch wenn das Ziel genehmigt ist, und beschränke den Zugriff auf Referenzaufnahmen unabhängig vom normalen Anwendungstext.
Vorauswahl, Testen und Freigabe
Eine Vorauswahl sollte Anforderungen ausdrücken, nicht Markenvertrautheit. Behalten Sie Kandidaten, die den Eingabevertrag, die erforderlichen Sprachen, die Betriebsbedingungen und die Bedingungen für die Sprachautorisierung erfüllen. Schließen Sie Modelle aus, die eine harte Anforderung nicht erfüllen können, bevor Sie Zeit mit dem Anhören verbringen.
Verwenden Sie ein Freigabeverfahren, das eine überprüfbare Entscheidungsdokumentation hinterlässt:
- Kompatible Kandidaten auswählen. Dokumentieren Sie, warum jedes Modell zu den erforderlichen Eingaben und Ausgaben passt. Trennen Sie obligatorische Funktionen von Präferenzen, damit Prüfer wissen, was verhandelbar ist.
- Die Suite für schwierige Texte ausführen und überprüfen. Bewahren Sie Rohausgaben, Hörerurteile und Zeitaufzeichnungen auf. Untersuchen Sie kritische Fehler, anstatt einen attraktiven Gesamtscore zu akzeptieren.
- Rechte und Verarbeitungsbedingungen genehmigen. Überprüfen Sie die Modelllizenz, die Referenz-Audio-Autorisierung und die beabsichtigte Verwendung jeder benutzerdefinierten Stimme. Weisen Sie unerledigten Bedingungen einen Eigentümer zu.
- Die genehmigte Konfiguration einfrieren. Fixieren Sie Versionen, wo unterstützt, speichern Sie Vorverarbeitungs- und Bereitstellungseinstellungen und fordern Sie Regressionstests an, wenn sich die Bereitstellungskonfiguration ändert.
Integrationskomfort von der Akzeptanz trennen
UberLLM bietet Zugriff auf Claude, GPT, Gemini, DeepSeek sowie Bild-, Video- und Musikmodelle über einen OpenAI- und Anthropic-kompatiblen endpoint. Ein gemeinsamer API key und ein vorausbezahltes Guthaben konsolidieren den Zugriff, und das Ändern des Modellidentifikators unterstützt Kandidatenvergleiche ohne eine separate Anbieterintegration für jedes Modell; modellspezifische Sprachparameter müssen jedoch noch überprüft werden.
Qwen3 0.6B TTS wird zu $0.035 pro 1K Zeichen angeboten, gegenüber einem Listenpreis von $0.0875 pro 1K Zeichen. Bestätigen Sie die aktuellen Preise auf der Anbieterliste, bevor Sie budgetieren, und vergleichen Sie die Kosten nur unter Kandidaten, die die Akzeptanzkriterien erfüllen.
Eine namentliche Freigabeentscheidung verlangen
Geben Sie der Abnahme-Dokumentation einen Eigentümer und bewahren Sie die genehmigten Audiobeispiele auf. Erfassen Sie Ausnahmen explizit, einschließlich aller Textkategorien, die eine Vorverarbeitung, eine Fallback-Stimme oder eine menschliche Überprüfung erfordern.
Eine Freigabeentscheidung sollte verständlich bleiben, nachdem die Personen, die die Evaluierung durchgeführt haben, zu einem anderen Projekt gewechselt sind. Die letzte Überprüfung ist einfach: Besteht das gewählte Modell den schwierigen Texttest, und deckt die Einverständniserklärung jede geklonte Stimme ab?
UberLLM bietet eine vereinheitlichte API zum Vergleichen und Integrieren von Sprache neben anderen Modelltypen. Besuchen Sie UberLLM], um Sprachkandidaten zu prüfen, und führen Sie dann Ihre anonymisierten Namen, Codes und emotionalen Dialoge durch die Modelle, die Ihre Eingabeanforderungen erfüllen, bevor Sie eine Produktionskonfiguration wählen.