Model Text to Speech: Kemampuan dan Panduan Pemilihan
Jelajahi model text to speech berdasarkan input, output, kloning suara, metrik kualitas, dan aturan persetujuan, dengan tabel dan daftar periksa pemilihan untuk 2026.
Suara neural dan suara yang dihasilkan AI menyumbang 67.90% dari pendapatan pasar text-to-speech pada 2024, menurut laporan tren industri Sonix. Itu mengukur pendapatan, bukan keandalan. Bagi developer yang memilih model text-to-speech, pertanyaan yang lebih sulit adalah apakah sebuah suara dapat menyampaikan nama, kode, instruksi, dan dialog emosional yang dikirim aplikasi.
Demo yang menyenangkan tidak menjawab pertanyaan itu. Perlakukan pemilihan model sebagai kontrak input dan output, lalu lakukan evaluasi teks produksi. Arsitektur, kemiripan suara, dan kenaturalan rata-rata penting, tetapi tidak satu pun boleh mengesampingkan kegagalan yang mengubah apa yang dipahami pendengar.
Daftar Isi
- Kemampuan, Input, dan Output Sekilas
- Keluarga Arsitektur dan Artinya
- Kloning Suara, Skala, dan Cakupan Bahasa
- Metrik Kualitas yang Melampaui MOS
- Membangun Set Uji untuk Teks Sulit
- Mencocokkan Model dengan Kasus Penggunaan Anda
- Persetujuan, Pengungkapan, dan Penggunaan Suara yang Aman
- API yang Dihosting atau Model Terbuka yang Dihosting Sendiri
- Daftar Pendek, Uji, dan Setujui
Kemampuan, Input, dan Output Sekilas
| Kemampuan | Input umum | Output umum | Gunakan saat |
|---|---|---|---|
| TTS Standar | Teks biasa | File atau stream audio | Anda memerlukan narasi dari teks tetap atau yang disediakan pengguna |
| TTS Streaming | Potongan teks saat dihasilkan | Potongan audio dalam urutan pemutaran | Audio harus dimulai sebelum teks lengkap siap |
| TTS yang dikontrol markup atau gaya | Teks dengan SSML atau tag gaya | Audio dengan jeda, penekanan, atau emosi yang diatur | Pelafalan dan kecepatan harus dikontrol |
| Kloning suara | Teks ditambah audio referensi dengan persetujuan yang didokumentasikan | Audio dalam suara pembicara referensi | Suara merek atau pengguna harus direproduksi |
| TTS Multibahasa | Teks dalam beberapa bahasa | Audio dalam setiap bahasa, dengan satu atau banyak suara | Satu produk melayani pengguna dalam banyak bahasa |
TTS Standar adalah kontrak paling sederhana: kirim teks dan terima ucapan. Gunakan untuk narasi yang disiapkan, notifikasi, dan bagian-bagian yang susunan katanya sudah lengkap. File yang dapat diunduh cocok untuk pengeditan dan caching; respons yang di-stream dapat menghindari menunggu seluruh file audio.
Streaming TTS memerlukan pemeriksaan lebih dekat. Beberapa layanan melakukan streaming audio setelah menerima input teks lengkap, sementara yang lain juga menerima teks inkremental. Jika asisten menghasilkan balasannya secara progresif, pastikan bahwa antarmuka mendukung yang terakhir daripada mengasumsikan bahwa streaming berarti kedua arah.
Sintesis yang dikontrol markup menambahkan instruksi pengiriman. SSML, kontrol pelafalan, dan tag gaya proprietary tidak dapat dipertukarkan, jadi uji sintaksis persis yang diterima model pilihan Anda. Instruksi yang tidak didukung mungkin diabaikan, ditolak, atau diucapkan dengan keras.
Kloning menambahkan input pembicara referensi, sementara sintesis multibahasa menambahkan cakupan bahasa. Keduanya tidak secara otomatis mencakup yang lain: suara preset multibahasa belum tentu dapat dikloning, dan suara yang dikloning belum tentu dapat diandalkan di setiap bahasa yang didukung.
Pilih Kontrak Audio Sebelum Suara
WAV adalah container; PCM menjelaskan representasi audio. PCM yang tidak terkompresi, sering dikemas dalam WAV, nyaman untuk pengeditan dan pemrosesan. Pipeline telepon memerlukan encoding, konfigurasi saluran, dan sample rate yang diharapkan oleh sistem hilir mereka, bukan hanya file dengan ekstensi yang dikenal.
MP3 dan Opus adalah opsi pengiriman terkompresi untuk browser dan aplikasi, tergantung pada dukungan klien. Pilih format yang dapat didekode oleh pemutar Anda tanpa tahap konversi tambahan. Jika tidak, kinerja sintesis yang Anda ukur tidak akan menggambarkan penundaan yang dialami pengguna.
Sample rate menentukan seberapa sering audio diambil sampelnya. Ini memengaruhi rentang frekuensi yang direpresentasikan dan, untuk audio yang tidak terkompresi dengan pengaturan lain yang tetap, ukuran file. Menaikkan sample rate output tidak memperbaiki pelafalan yang tidak jelas atau mengembalikan detail yang tidak pernah dihasilkan oleh model.
Sebelum integrasi, tuliskan kontraknya:
- Batasan input: Panjang teks yang diterima, markup yang didukung, dan perilaku input inkremental.
- Ketersediaan suara: Bahasa yang diperlukan, dialek, suara preset, dan akses suara kustom.
- Persyaratan output: Encoding, sample rate, channels, dan perilaku streaming.
- Perilaku kegagalan: Bagaimana aplikasi menangani teks yang ditolak, stream yang terputus, dan suara yang tidak tersedia.
Baca tabel dari kiri ke kanan: cocokkan input yang Anda miliki dengan output yang Anda butuhkan, lalu periksa apakah kasus penggunaan tersebut sesuai. Suara yang terdengar sangat baik tetapi memerlukan pola interaksi yang salah tidak termasuk dalam daftar pilihan.
Keluarga Arsitektur dan Apa Artinya
| Keluarga | Cara menghasilkan suara | Kompromi utama |
|---|---|---|
| Konkatenatif | Menggabungkan unit suara yang sudah direkam | Alami dalam domain rekaman, lemah di luarnya |
| Parametrik statistik | Memprediksi fitur akustik, lalu vocoder merender audio | Fleksibel, tapi sering kali teredam |
| Bentuk gelombang saraf | Menghasilkan sampel audio dengan jaringan saraf | Kealamian tinggi, berat secara komputasi tanpa optimasi |
| Saraf berbasis token | Memprediksi kode audio diskrit dari teks | Skala baik dengan data, memerlukan kontrol gaya dan pembicara yang cermat |
Perbedaan pipeline secara umum diilustrasikan di bawah ini.
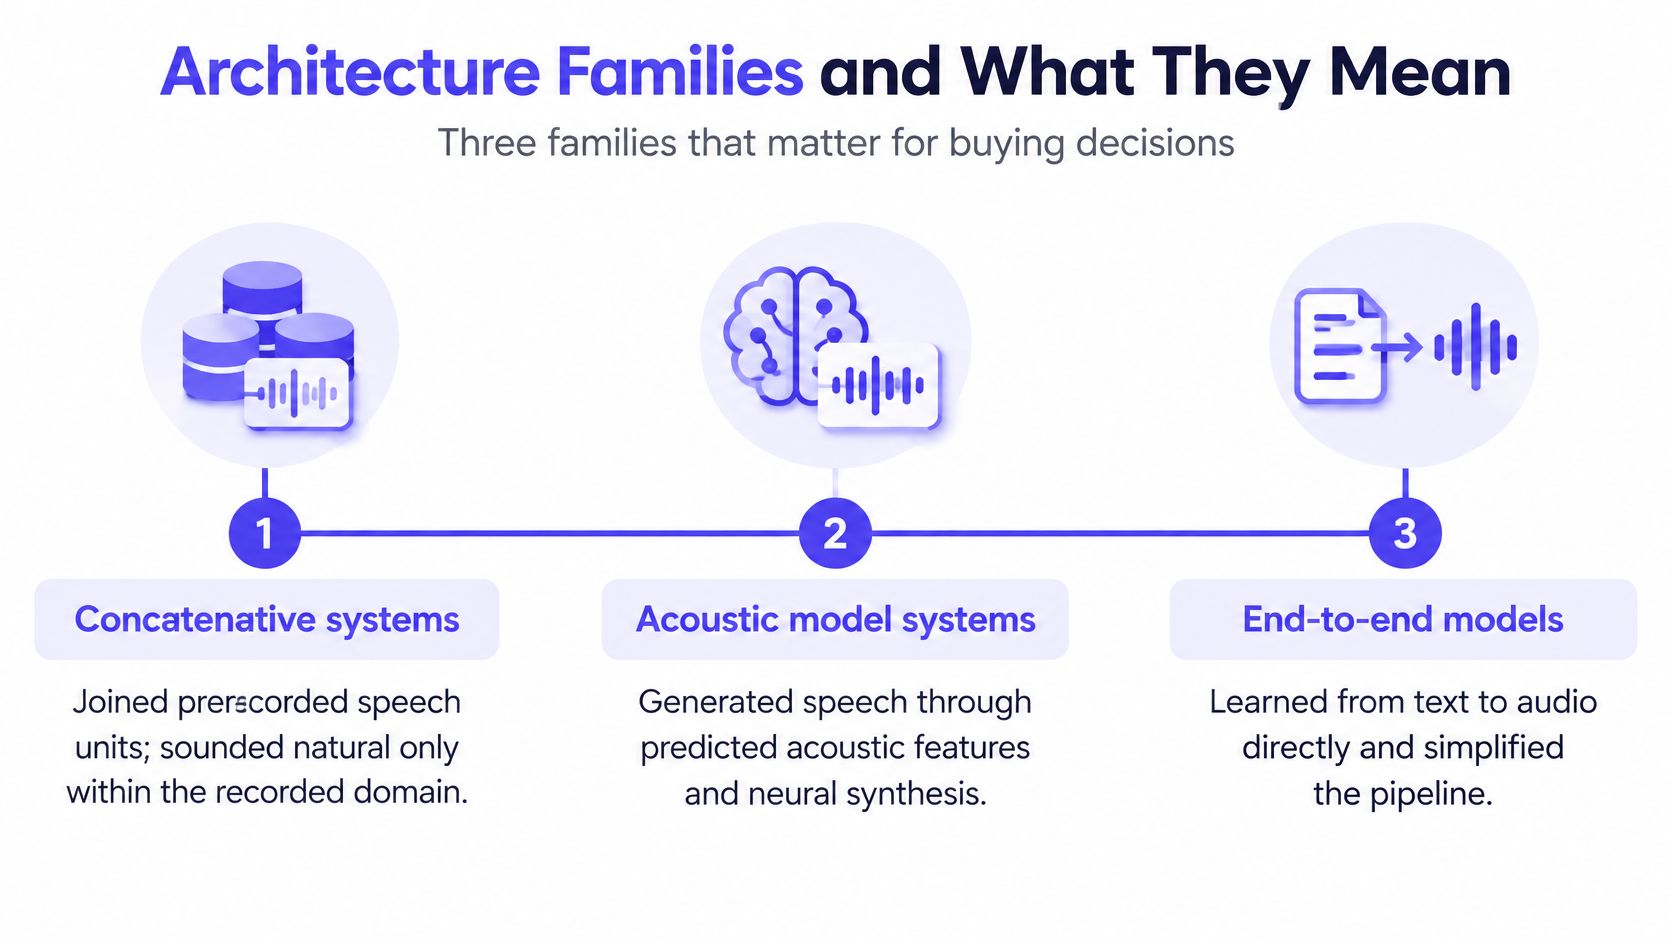
Sistem konkatenatif merangkai unit-unit yang direkam, sehingga fleksibilitasnya dibatasi oleh rekaman yang tersedia dan sambungan di antaranya. Sistem parametrik statistik justru memprediksi properti akustik, lalu merender ucapan melalui vocoder, menukar penggunaan langsung rekaman dengan pipeline sintesis yang lebih terkontrol.
Tonggak penting tiba dengan WaveNet pada 2016: makalah WaveNet melaporkan pengurangan lebih dari 50% dalam kesenjangan kualitas antara sistem TTS terkuat yang ada dan ucapan manusia dalam evaluasi bahasa Inggris AS dan Mandarin Tiongkoknya. Temuan itu menetapkan pentingnya generasi bentuk gelombang saraf, bukan jaminan kinerja universal untuk setiap model saraf selanjutnya.
Sistem saraf berbasis token memprediksi representasi audio diskrit yang diubah oleh dekoder menjadi suara. Untuk keputusan pembelian, bedakan representasi ini dari antarmuka layanan: produk end-to-end masih dapat berisi beberapa tahap pemrosesan internal.
Baca Kartu Model sebagai Deskripsi Pipeline
Cari detail spektrogram, vocoder, codec, token audio, dan pengkondisian pembicara. Tahap spektrogram yang diikuti oleh vocoder menunjukkan pipeline model akustik; kode audio diskrit menunjukkan generasi berbasis token. Deskripsi pelatihan membantu menjelaskan desain, tetapi tidak menggantikan pengujian keluaran.
Untuk perangkat terbatas, bandingkan memori aktual, waktu proses, dan kompatibilitas perangkat keras daripada berasumsi bahwa yang lama berarti lebih kecil atau yang baru berarti hanya cloud. Dalam deployment yang di-host, periksa latensi dan kontrol yang diberikan daripada menyimpulkannya dari label arsitektur.
Batas juga penting untuk tugas-tugas yang berdekatan. Panduan sintesis suara nyanyian membahas masalah kontrol yang berbeda: prosodi ucapan bukanlah pengganti untuk waktu dan nada musik yang eksplisit.
Aturan praktis: Gunakan arsitektur untuk memahami kemungkinan batasan dan pertanyaan diagnostik yang berguna, bukan untuk menyatakan pemenang sebelum mendengarkan.
Kloning Suara, Skala, dan Cakupan Bahasa
Kloning suara memisahkan identitas pembicara dari kata-kata yang diucapkan. Evaluasi dimensi-dimensi tersebut secara independen: sebuah keluaran dapat menyerupai pembicara referensi sambil menyampaikan kalimat dengan emosi yang tidak sesuai.
Rute kloning utama berbeda dalam cara mereka menetapkan identitas tersebut.
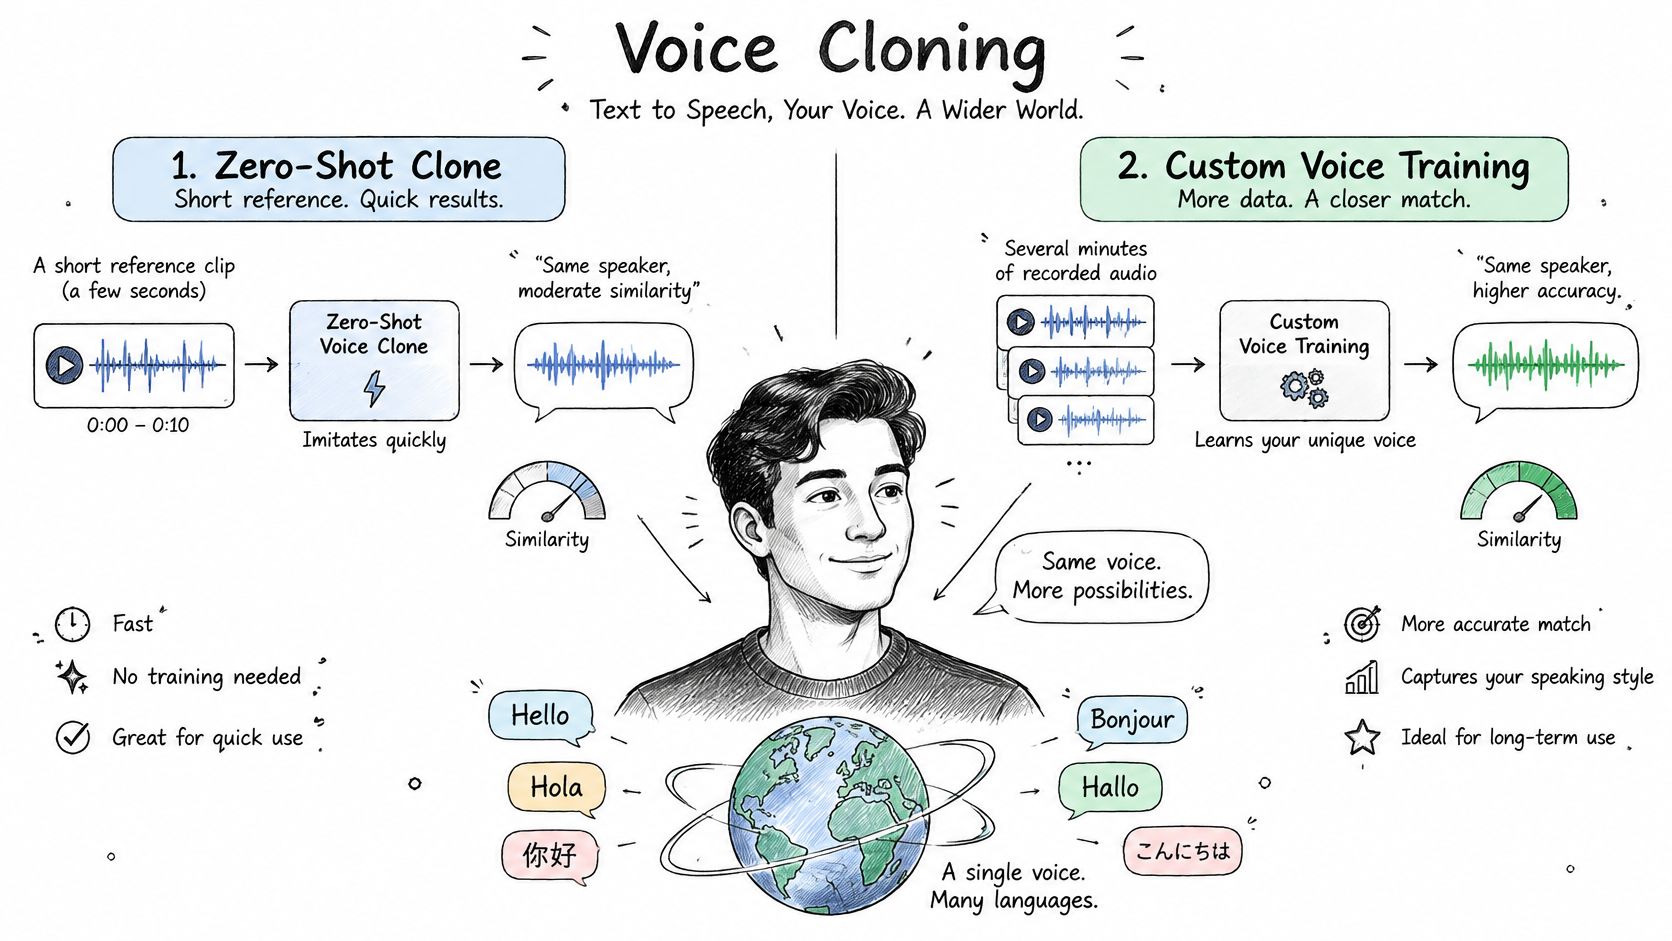
Kloning zero-shot mengkondisikan sintesis pada audio referensi tanpa pekerjaan pelatihan khusus pembicara yang terpisah. Pelatihan suara kustom mengadaptasi model menggunakan dataset pembicara yang disiapkan. Yang pertama mengurangi pekerjaan penyiapan; yang terakhir menambahkan persyaratan perekaman, persiapan, dan pelatihan, tanpa membuat kemiripan otomatis.
Kualitas referensi layak untuk diuji sendiri. Kebisingan latar belakang, pembicara yang bersaing, penempatan mikrofon yang tidak konsisten, dan gaya penyampaian yang sangat berbeda dapat mempersulit penentuan apa yang harus dipertahankan oleh sistem. Bandingkan referensi yang bersih sebelum mengaitkan hasil yang lemah sepenuhnya pada model sintesis.
Pisahkan Kemiripan dari Performa
Pertimbangkan perbandingan hipotetis antara referensi singkat yang netral dan referensi yang lebih panjang yang berisi beberapa penyampaian emosional. Hasilkan baris pemasaran yang ceria yang sama dari masing-masing. Tanyakan kepada pendengar secara terpisah apakah pembicara terdengar dapat dikenali dan apakah penyampaian yang ceria terdengar sesuai.
Jangan berasumsi bahwa referensi yang lebih panjang harus menang. Ini berisi lebih banyak materi, tetapi juga memperkenalkan lebih banyak variasi; pertanyaan yang berguna adalah apakah model mempertahankan identitas sambil mengikuti performa yang diminta.
Untuk pengantar audiovisual tentang topik ini, video berikut menyediakan format tontonan lain.
Skala memberikan konteks, bukan persetujuan akhir. Dalam liputan 2024-nya, TechCrunch melaporkan bahwa BASE-large menggunakan 100,000 jam pidato domain publik untuk pelatihan dan berisi 980 juta parameter. Total tersebut tidak menetapkan bagaimana aksen, pembicara, atau bahasa tertentu akan berkinerja.
Saat memeriksa daftar model TTS multibahasa, ubah kemampuan yang diiklankan menjadi pemeriksaan penerimaan yang konkret:
- Cakupan bahasa: Evaluasi setiap bahasa dan dialek yang diperlukan dengan pendengar yang fasih.
- Stabilitas identitas: Bandingkan pembicara di seluruh pertanyaan, pernyataan, dan dialog ekspresif.
- Kesiapan fallback: Identifikasi suara preset yang disetujui untuk klon yang tidak tersedia atau tidak sesuai.
- Asal referensi: Pertahankan pengidentifikasi rekaman dan catatan izin terkait.
Suara yang dapat dikenali hanya berguna jika penyampaiannya tetap dapat dimengerti dan sesuai di seluruh pesan aktual produk.
Metrik Kualitas yang Melampaui MOS
Sebuah benchmark bisa direproduksi tanpa harus representatif. Dataset LJSpeech berisi 13,100 klip dengan total sekitar 24 jam, direkam oleh seorang narator wanita berbahasa Inggris. Ini berguna untuk perbandingan terkontrol, tetapi keberhasilan dalam lingkup tersebut tidak menetapkan kinerja yang lebih luas di berbagai pembicara, aksen, atau gaya percakapan.
Mean Opinion Score, atau MOS, mengukur kualitas yang dirasakan pendengar. Jaga agar kalimat dan kondisi mendengarkan konsisten di seluruh model, sembunyikan identitas model, dan definisikan pertanyaan penilaian dengan jelas. Sebuah panel yang ditanya tentang kenyamanan belum tentu mengevaluasi apakah kode produk diucapkan dengan benar.
| Metrik | Apa yang diukur | Cara mengukurnya | Batasan utama |
|---|---|---|---|
| MOS | Kualitas yang dirasakan pada skala pendengaran buruk-hingga-sangat baik | Panel pendengar menilai kalimat yang sama dari setiap model | Tidak mengisolasi kesalahan pengucapan atau ritme tanpa pertanyaan yang ditargetkan |
| Intelligibility | Apakah pendengar dapat mengenali kata-kata | Transkripsikan output dengan speech recognizer dan bandingkan dengan teks yang dimaksud | Kesalahan recognizer dapat mengaburkan kesalahan synthesis |
| Time to first audio | Penundaan sebelum audio yang dapat digunakan tiba atau diputar | Catat waktu pengiriman permintaan, penerimaan audio pertama, dan pemutaran secara terpisah | Tidak mengatakan apa pun tentang kualitas ucapan |
| Real-time factor | Waktu synthesis dibagi durasi audio | Waktu generation dan bagi dengan durasi output | Berubah dengan hardware, load, dan batasan pengukuran |
| Reproducibility | Konsistensi di seluruh pengulangan dan versi | Perbaiki pengaturan dan seed yang terekspos, lalu jalankan ulang dan bandingkan | Beberapa layanan tidak mengekspos seed atau version pins |
Definisikan Apa yang Termasuk dalam Stopwatch Anda
Untuk streaming, bedakan audio pertama yang diterima dari pemutaran audio pertama yang terdengar. Transfer jaringan, decoding, dan buffering player termasuk dalam pengalaman pengguna, bahkan jika terjadi di luar model inference. Catat keduanya saat mendiagnosis penundaan.
Untuk pengujian intelligibility, bandingkan ucapan yang dikenali dengan bentuk lisan yang dimaksud, bukan secara membabi buta dengan karakter input mentah. Tanggal yang diucapkan dengan benar tidak akan cocok dengan notasi tertulisnya karakter per karakter. Tinjau secara manual kesalahan yang melibatkan nama, angka, dan simbol sebelum memperlakukan recognizer sebagai ground truth.
Rata-rata kualitas adalah deskripsi dari sebuah tes. Ini bukan kriteria penerimaan sampai Anda mendefinisikan kesalahan apa yang dapat ditoleransi oleh produk.
Pasangkan pemeriksaan otomatis dengan mendengarkan. Pengukuran pitch saja tidak menggambarkan ritme, tekanan, atau intensitas, dan perbedaan waveform tidak selalu berarti pendengar mendengar perubahan yang berarti.
Laporkan MOS, intelligibility, time to first audio, dan real-time factor secara bersamaan. Sertakan versi model, runtime environment, request settings, dan batasan pengukuran agar engineer lain dapat menginterpretasikan hasilnya.
Membangun Set Pengujian untuk Teks Sulit
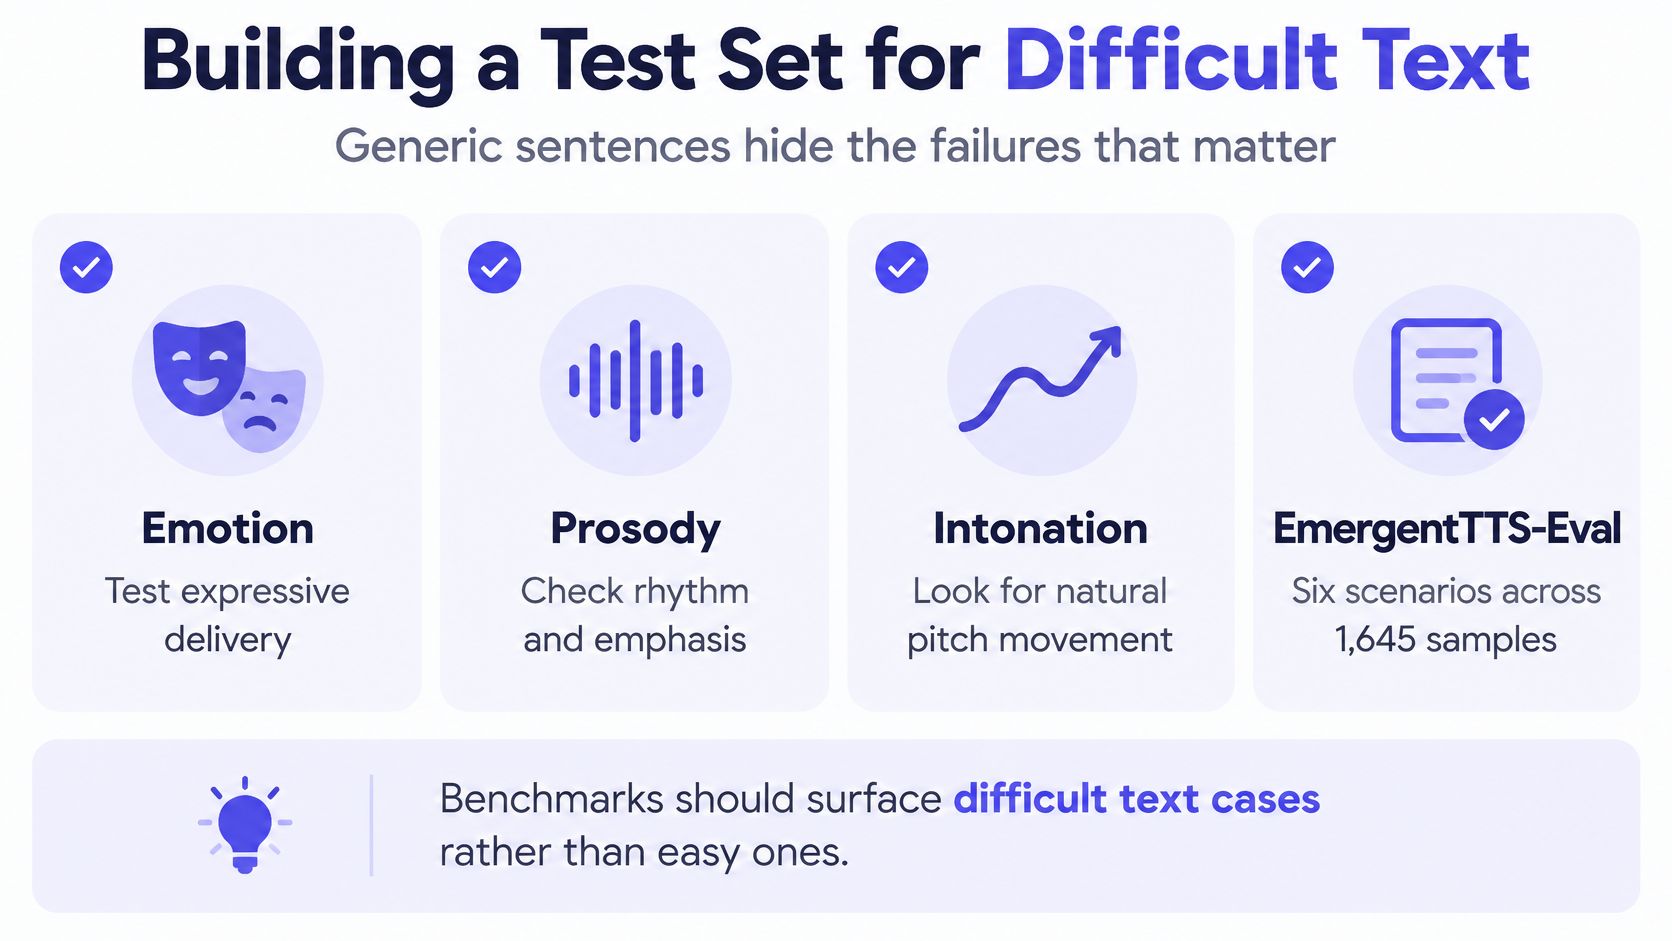
Kalimat generik membuat tes penerimaan lemah karena menghilangkan teks yang membutuhkan interpretasi. EmergentTTS-Eval](https://papers.neurips.cc/paper_files/paper/2025/hash/04970a25af46918606ba2cf0a3d7905d-Abstract-Datasets_and_Benchmarks_Track.html) mengevaluasi enam skenario di seluruh 1,645 sampel, mencakup emosi, prosodi, intonasi, dan pelafalan; para penulisnya melaporkan korelasi kuat antara penilaian berbasis model dan preferensi manusia.
Gunakan pendekatan yang lebih luas itu tanpa memperlakukan benchmark eksternal sebagai rangkaian pengujian produk Anda. Aplikasi Anda punya kosakata, pemformatan, dan konsekuensi kesalahan sendiri.
Kategori evaluasi di bawah ini membantu mengungkap kegagalan yang tidak akan muncul dari bacaan yang mudah.
Sertakan Teks yang Mengubah Makna jika Salah Dibaca
- Nama dan lokasi: Nama produk, merek, nama orang, alamat, dan kode pos.
- Pengenal ringkas: Akronim, referensi akun, kode produk, dan singkatan yang ambigu.
- Notasi terstruktur: Tanggal, waktu, URL, fragmen kode, dan rumus matematika.
- Perubahan bahasa: Kata asing dan bagian campuran bahasa.
- Maksud percakapan: Pertanyaan, penenangan, urgensi, ketidaksetujuan, dan dialog yang sarat emosi.
- Isyarat non-ucapan: Tawa, desahan, dan instruksi performa lain yang didukung.
Untuk setiap item, catat pembacaan yang dimaksud. Kode mungkin perlu dieja karakter demi karakter, sementara akronim mungkin perlu dilafalkan sebagai kata. Tanpa anotasi itu, pendengar bisa berbeda pendapat soal kebenaran meskipun mendengar output yang sama.
Jalankan Perbandingan yang Dapat Diulang
- Kumpulkan teks representatif. Ekstrak dan anonimkan contoh produksi, lalu tandai berdasarkan kategori. Sertakan input tidak umum yang kegagalannya akan berdampak serius.
- Hasilkan output yang dapat dibandingkan. Jaga format, peran suara, dan instruksi penyampaian tetap setara bila memungkinkan. Simpan permintaan persis dan pengenal model.
- Gunakan pendengar yang konsisten. Minta panel yang sama menilai keterpahaman, pelafalan, dan kesesuaian prosodi secara terpisah. Acak urutan model.
- Catat performa per item. Rekam waktu audio pertama dan real-time factor bersama teks terkait, bukan hanya menyimpan rata-rata batch.
- Ulangi setelah perubahan. Pertahankan baseline yang sudah disetujui dan selidiki regresi saat penyedia, konfigurasi suara, atau aturan prapemrosesan berubah.
Misalkan prompt dukungan berisi nama belakang pelanggan dan tanggal janji temu. Kalimat yang disampaikan dengan indah tetapi salah pada salah satunya harus kalah dari alternatif yang kurang ekspresif tetapi akurat.
Laporkan tingkat kegagalan berdasarkan kategori dan tingkat keparahan. Skor agregat bisa menyembunyikan justru kelas kesalahan yang seharusnya menghalangi deployment.
Mencocokkan Model dengan Kasus Penggunaan Anda
| Kasus penggunaan | Kriteria yang paling penting | Apa yang harus diuji pertama |
|---|---|---|
| Prompt telepon dukungan pelanggan | Waktu hingga audio pertama, pengucapan nama dan kode produk | Prompt realistis yang berisi nama dan kode melalui jalur pemutaran telepon |
| Narasi buku audio bentuk panjang | Prosodi antar paragraf, stabilitas pada bagian panjang | Konsistensi pada bagian yang diperpanjang dengan dialog dan perubahan adegan |
| Aksesibilitas dan pembaca layar | Keterbacaan, kontrol kecepatan bicara yang andal | Kejelasan pada kecepatan tercepat yang kemungkinan dipilih pengguna |
| Dubbing video dan media | Rentang emosi, sinkronisasi dengan klip referensi | Penyelarasan dengan panjang dan emosi klip referensi |
| Edukasi dan pelatihan | Pengucapan istilah teknis, rumus, dan kata asing | Rumus, akronim, dan nama asing dari materi kursus |
Fitur terkuat sebuah model hanya penting jika mendukung pekerjaan tersebut. Perbandingan berikut mengilustrasikan prioritas yang berbeda.
 ](
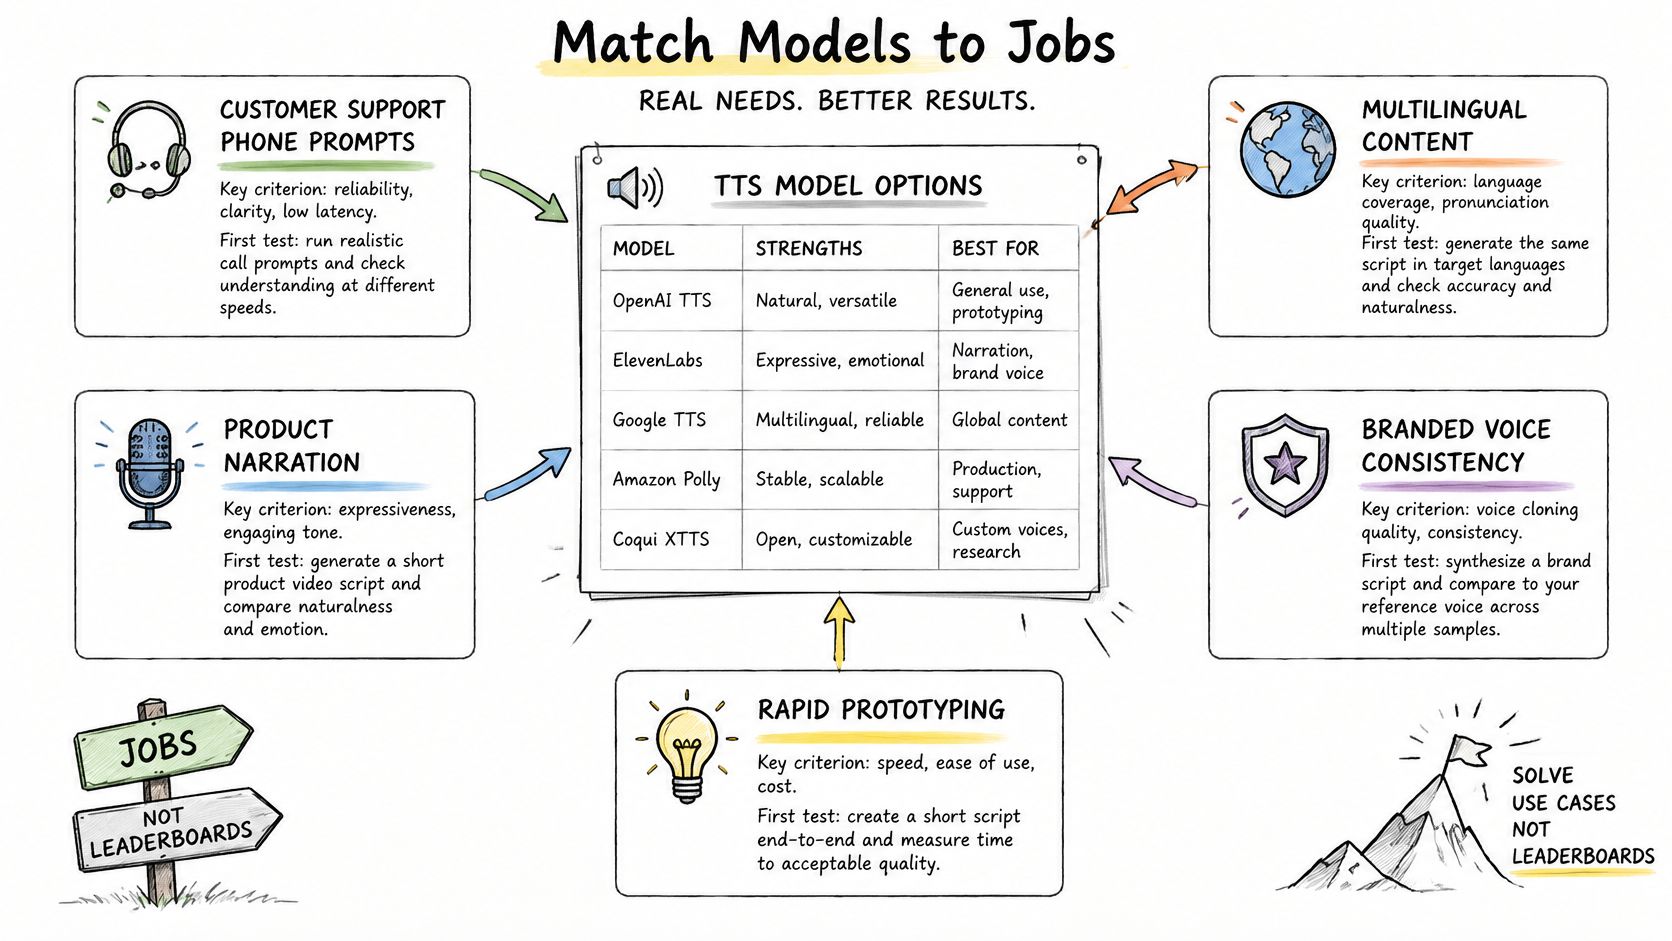
Untuk dukungan pelanggan, uji jalur telepon yang sebenarnya daripada hanya meninjau unduhan berkualitas studio. Untuk buku audio, dengarkan melintasi batas paragraf, perubahan pembicara, dan generasi yang dilanjutkan, karena kalimat yang terisolasi tidak melatih kontinuitas.
Evaluasi aksesibilitas harus mencakup orang-orang yang akan menggunakan output dan kontrol pemutaran pilihan mereka. Dubbing membutuhkan kinerja referensi dan batasan waktu; edukasi membutuhkan tinjauan materi pelajaran dari notasi lisan yang dimaksudkan.
Terapkan Batasan Keras Sebelum Preferensi
Jika latensi mendefinisikan interaksi, perlukan antarmuka streaming yang sesuai sebelum memberi peringkat suara. Respons yang tertunda dapat menggagalkan desain interaksi terlepas dari kualitas akhirnya.
Jika identitas pembicara tertentu wajib, tetapkan izin sebelum membuat klon evaluasi. Jangan jadikan otorisasi sebagai masalah produksi saja setelah tim terikat pada suatu suara.
Jika kode dan tanggal membawa pesan, prioritaskan pembacaan yang benar daripada kesenangan. Perlakukan kesalahan pengucapan kritis sebagai penghalang daripada membiarkan skor gaya yang kuat mengkompensasinya.
Prinsip seleksi: Beri peringkat model yang dapat diterima setelah menerapkan persyaratan keras. Jangan merata-ratakan kegagalan yang mendiskualifikasi ke dalam skor yang menarik.
Tulis batasan-batasan tersebut sebelum meninjau hasilnya. Misalnya, narator kursus mungkin memerlukan kosakata teknis yang andal tetapi tidak streaming percakapan, sementara asisten suara mungkin memerlukan input teks inkremental tetapi tidak ada kloning. Perbedaan itu mempersempit perbandingan tanpa bergantung pada papan peringkat universal.
Persetujuan, Pengungkapan, dan Penggunaan Suara yang Aman
Kloning suara adalah keputusan tata kelola, bukan sekadar pengaturan sintesis. Panduan TTS yang bertanggung jawab menjelaskan klasifikasi FCC atas suara robocall yang dihasilkan AI sebagai suara artifisial di bawah Telephone Consumer Protection Act, yang membuat panggilan yang tercakup tanpa persetujuan sebelumnya yang disyaratkan menjadi melanggar hukum. Jangan menafsirkan itu sebagai larangan menyeluruh atas narasi sintetis atau sebagai izin untuk setiap penggunaan non-robocall.
Narasi sintetis biasa dan kloning yang mempertahankan identitas memerlukan pengawasan operasional yang berbeda. Memilih suara preset berlisensi tidak menetapkan hak untuk meniru orang yang dapat diidentifikasi. Untuk suara kustom, izin pembicara yang terdokumentasi harus menjadi persyaratan deployment.
Bangun Kontrol ke Dalam Jalur Permintaan
- Catat izin pembicara: Simpan tujuan yang diizinkan, kanal yang diizinkan, cakupan penggunaan, dan kondisi kedaluwarsa atau peninjauan bersama catatan suara.
- Tolak imitasi yang tidak sah: Larang kloning orang yang dapat diidentifikasi tanpa izin tertulis dan sediakan cara untuk menangguhkan suara yang disengketakan.
- Terapkan aturan pengungkapan: Beri label pada ucapan sintetis saat hukum yang berlaku, kebijakan platform, atau konteksnya mengharuskan.
- Jaga auditabilitas: Catat pengenal model, pengenal suara, waktu permintaan, dan referensi otorisasi tanpa menduplikasi teks sensitif secara tidak perlu.
- Pelihara alternatif yang aman: Setujui suara fallback yang tidak dimaksudkan untuk meniru individu yang dapat diidentifikasi.
- Pertahankan metadata model: Simpan sumber data pelatihan yang diungkapkan, lisensi, pembatasan penggunaan, dan dokumentasi evaluasi yang relevan.
Catatan izin juga memerlukan proses pencabutan. Tentukan siapa yang dapat menonaktifkan suara, bagaimana audio yang di-cache ditangani, dan apa yang terjadi pada konten terjadwal saat otorisasi berubah.
Evaluasi Siapa yang Dilayani Sistem
Uji performa aksen, dialek, dan bahasa secara terpisah. Rata-rata global dapat menyembunyikan pengalaman buruk bagi kelompok pembicara tertentu, jadi pertahankan hasil tingkat kelompok di mana pengumpulan dan pelaporan sesuai.
Tata kelola juga harus mengikuti routing. Jika permintaan dapat mencapai penyedia berbeda, jangan menganggap otorisasi suara atau perjanjian pemrosesan berlaku untuk setiap tujuan. Batasi routing ke kombinasi model, suara, dan ketentuan pemrosesan yang disetujui.
Ini adalah panduan operasional umum, bukan nasihat hukum. Periksa hukum dan persyaratan kontraktual yang berlaku untuk pembicara, audiens, dan lokasi deployment sebelum rilis.
API yang Dihosting atau Model Terbuka yang Dihosting Sendiri
Penerapan menentukan apa yang Anda kendalikan dan apa yang harus Anda operasikan. API yang dihosting memindahkan penyediaan model ke operator eksternal. Penghostingan sendiri memberikan tim Anda tanggung jawab untuk runtime, capacity, updates, dan access controls.
Bobot terbuka tidak secara otomatis berarti penggunaan komersial tanpa batas, kesesuaian offline, atau persyaratan perangkat keras yang rendah. Periksa lisensi dan persyaratan runtime sebelum berinvestasi dalam integrasi. Demikian pula, endpoint yang dihosting tidak secara otomatis menyediakan versi tetap atau pengaturan data-residency tertentu.
| Kriteria keputusan | API yang Dihosting | Model terbuka yang dihosting sendiri |
|---|---|---|
| Biaya pada volume yang diharapkan | Biaya penggunaan ditambah biaya integrasi dan pengiriman | Compute, storage, idle capacity, dan upaya rekayasa |
| Latensi di bawah beban puncak | Termasuk jalur jaringan dan antrean sisi layanan | Tergantung pada perangkat keras yang disediakan dan penjadwalan Anda |
| Residensi data | Membutuhkan peninjauan lokasi pemrosesan dan ketentuan | Dapat tetap berada dalam infrastruktur yang Anda kendalikan |
| Manajemen versi | Tunduk pada opsi pinning dan update layanan | Tim Anda mengontrol artefak dan waktu peluncuran |
Bandingkan Seluruh Biaya Operasional
Penerapan yang dihosting dapat sesuai untuk permintaan yang bervariasi dan tim yang tidak ingin mengoperasikan inference hardware. Konfirmasikan billing unit, concurrency limits, dan cara penanganan retries sebelum memperkirakan biaya. Harga berbasis karakter saja tidak menggambarkan seluruh tagihan aplikasi.
Penghostingan sendiri dapat sesuai untuk operasi offline atau persyaratan yang melarang pengiriman teks dan reference recordings di luar infrastruktur yang terkontrol. Ini masih membutuhkan capacity planning, monitoring, security updates, dan reproducible release process. Model yang berjalan di workstation belum tentu siap untuk concurrent production traffic.
Perlakukan daftar model Qwen TTS] sebagai titik penemuan untuk kandidat, bukan bukti kesesuaiannya untuk pengaturan hosting tertentu. Konfirmasikan runtime, lisensi, dan interface yang sebenarnya untuk penerapan mana pun yang Anda evaluasi.
Uji Jalur Penyediaan, Bukan Hanya Bobotnya
Gunakan corpus anonim yang sama pada kandidat yang dihosting dan dihosting sendiri. Jaga playback format dan test client tetap konsisten, lalu ukur di bawah concurrency dan request patterns yang diharapkan aplikasi.
Catat apakah pengujian mencakup startup, loading, queuing, dan conversion. Jika tidak, warm local benchmark dan complete remote request tidak dapat dibandingkan.
Jika set pengujian Anda berisi informasi pribadi, tinjau data-handling terms sebelum mengirimkannya. Hapus unnecessary identifiers bahkan ketika tujuan disetujui, dan batasi akses ke reference recordings secara independen dari ordinary application text.
Pilih, Uji, dan Setujui
Daftar pendek harus menyatakan persyaratan, bukan familiaritas merek. Pertahankan kandidat yang memenuhi kontrak input, bahasa yang diperlukan, batasan operasional, dan kondisi otorisasi suara. Kecualikan model yang tidak dapat memenuhi persyaratan keras sebelum menghabiskan waktu untuk mendengarkannya.
Gunakan prosedur rilis yang meninggalkan catatan keputusan yang dapat diperiksa:
- Pilih kandidat yang kompatibel. Dokumentasikan mengapa setiap model sesuai dengan input dan output yang diperlukan. Pisahkan fitur wajib dari preferensi agar peninjau tahu apa yang bisa ditukar.
- Jalankan dan tinjau rangkaian teks sulit. Simpan output mentah, penilaian pendengar, dan catatan waktu. Selidiki kesalahan kritis alih-alih menerima skor agregat yang menarik.
- Setujui hak dan ketentuan pemrosesan. Verifikasi lisensi model, otorisasi audio referensi, dan tujuan penggunaan setiap suara kustom. Tetapkan pemilik untuk kondisi yang belum terselesaikan.
- Bekukan konfigurasi yang disetujui. Kunci versi di mana didukung, simpan pengaturan pra-pemrosesan dan pengiriman, dan perlukan pengujian regresi ketika konfigurasi penyajian berubah.
Pisahkan Kemudahan Integrasi dari Penerimaan
UberLLM menyediakan akses ke model Claude, GPT, Gemini, DeepSeek, serta model gambar, video, dan musik melalui endpoint yang kompatibel dengan OpenAI dan Anthropic. Kunci API umum dan saldo prabayar mengonsolidasikan akses, dan mengubah pengidentifikasi model mendukung perbandingan kandidat tanpa integrasi penyedia terpisah untuk setiap model; parameter ucapan spesifik model masih perlu diperiksa.
Qwen3 0.6B TTS terdaftar dengan harga $0.035 per 1K karakter, dibandingkan dengan harga daftar $0.0875 per 1K karakter. Konfirmasikan harga saat ini pada daftar penyedia sebelum membuat anggaran, dan bandingkan biaya hanya di antara kandidat yang memenuhi kriteria penerimaan.
Perlukan Keputusan Rilis Bernama
Berikan pemilik pada catatan persetujuan dan simpan contoh audio yang disetujui. Catat pengecualian secara eksplisit, termasuk kategori teks apa pun yang memerlukan pra-pemrosesan, suara cadangan, atau tinjauan manusia.
Keputusan rilis harus tetap dapat dipahami setelah orang-orang yang menjalankan evaluasi pindah ke proyek lain. Pemeriksaan terakhir sederhana: Apakah model yang dipilih lulus uji teks sulit, dan apakah catatan persetujuan mencakup setiap suara yang dikloning?
UberLLM menawarkan API terpadu untuk membandingkan dan mengintegrasikan ucapan bersama jenis model lainnya. Kunjungi UberLLM untuk memeriksa kandidat ucapan, lalu jalankan nama, kode, dan dialog emosional Anda yang dianonimkan melalui model yang memenuhi persyaratan input Anda sebelum memilih konfigurasi produksi.