Modelli Text-to-Speech: Capacità e Guida alla Selezione
Esplora i modelli Text-to-Speech in base a input, output, clonazione vocale, metriche di qualità e regole di consenso, con tabelle e una checklist di selezione per 2026.
Le voci neurali e generate dall'IA hanno rappresentato 67.90% dei ricavi del mercato della sintesi vocale nel 2024, secondo il rapporto sulle tendenze del settore di Sonix. Questo misura i ricavi, non l'affidabilità. Per uno sviluppatore che sceglie modelli di sintesi vocale, la domanda più difficile è se una voce riesce a rendere i nomi, i codici, le istruzioni e il dialogo emotivo che un'applicazione invia.
Una demo piacevole non risponde a questa domanda. Considera la selezione del modello come un contratto di input e output, seguita da una valutazione sui testi di produzione. Architettura, somiglianza della voce e naturalezza media contano, ma nessuna dovrebbe avere la precedenza su un errore che cambia ciò che l'ascoltatore capisce.
Indice
- Funzionalità, Input e Output a Colpo d'Occhio
- Famiglie di Architetture e il Loro Significato
- Clonazione Vocale, Scala e Copertura Linguistica
- Metriche di Qualità Che Vanno Oltre il MOS
- Costruire un Set di Test per Testi Difficili
- Abbinare i Modelli al Tuo Caso d'Uso
- Consenso, Divulgazione e Uso Sicuro della Voce
- API Ospitate o Modelli Aperti Self-Hosted
- Seleziona, Testa e Approva
Capacità, input e output in breve
| Capacità | Input tipico | Output tipico | Usalo quando |
|---|---|---|---|
| TTS standard | Testo semplice | File audio o stream | Ti serve una narrazione da testo fisso o fornito dall'utente |
| TTS in streaming | Blocchi di testo man mano che vengono generati | Blocchi audio nell'ordine di riproduzione | L'audio deve partire prima che il testo completo sia pronto |
| TTS con markup o controllo di stile | Testo con SSML o tag di stile | Audio con pause, enfasi o emozione impostate | Pronuncia e ritmo devono essere controllati |
| Clonazione vocale | Testo più audio di riferimento con consenso documentato | Audio con la voce dello speaker di riferimento | Una voce del brand o dell'utente deve essere riprodotta |
| TTS multilingue | Testo in più lingue | Audio in ogni lingua, con una o più voci | Un prodotto serve utenti in più lingue |
TTS standard è il contratto più semplice: invii testo e ricevi parlato. Usalo per narrazioni preparate, notifiche e passaggi il cui testo è già completo. Un file scaricabile è adatto alla modifica e alla cache; una risposta in streaming può evitare di aspettare l'intero file audio.
TTS in streaming richiede un'analisi più attenta. Alcuni servizi trasmettono audio in streaming dopo aver ricevuto un input testuale completo, mentre altri accettano anche testo incrementale. Se un assistente genera la risposta in modo progressivo, verifica che l'interfaccia supporti quest'ultima modalità invece di dare per scontato che streaming significhi entrambe le direzioni.
La sintesi controllata da markup aggiunge istruzioni di resa. SSML, controlli di pronuncia e tag di stile proprietari non sono intercambiabili, quindi testa la sintassi esatta accettata dal modello che hai scelto. Le istruzioni non supportate potrebbero essere ignorate, rifiutate o lette ad alta voce.
La clonazione aggiunge un input di speaker di riferimento, mentre la sintesi multilingue aggiunge copertura linguistica. Nessuna delle due include automaticamente l'altra: una voce preset multilingue non è necessariamente clonabile, e una voce clonata non è necessariamente affidabile in ogni lingua supportata.
Scegli il contratto audio prima della voce
WAV è un contenitore; PCM descrive una rappresentazione audio. Il PCM non compresso, spesso confezionato in WAV, è comodo per la modifica e l'elaborazione. Le pipeline di telefonia hanno bisogno della codifica, della configurazione dei canali e della frequenza di campionamento che i loro sistemi a valle si aspettano, non solo di un file con un'estensione nota.
MP3 e Opus sono opzioni di consegna compresse per browser e applicazioni, soggette al supporto del client. Scegli un formato che il tuo player riesca a decodificare senza un passaggio di conversione aggiuntivo. Altrimenti, le prestazioni di sintesi che misuri non descriveranno il ritardo che gli utenti percepiscono.
La frequenza di campionamento indica con quale frequenza viene campionato l'audio. Influisce sull'intervallo di frequenze rappresentato e, per l'audio non compresso con le altre impostazioni fisse, sulla dimensione del file. Aumentare la frequenza di campionamento in output non corregge una pronuncia poco chiara né ripristina dettagli che il modello non ha mai generato.
Prima dell'integrazione, metti per iscritto il contratto:
- Vincoli di input: lunghezza del testo accettata, markup supportato e comportamento con input incrementale.
- Disponibilità delle voci: lingue richieste, dialetti, voci preset e accesso alle voci personalizzate.
- Requisiti di output: codifica, frequenza di campionamento, canali e comportamento in streaming.
- Comportamento in caso di errore: come l'applicazione gestisce testo rifiutato, stream interrotti e voci non disponibili.
Leggi la tabella da sinistra a destra: abbina l'input che hai all'output che ti serve, poi controlla se il caso d'uso è adatto. Una voce che suona benissimo ma richiede il pattern di interazione sbagliato resta fuori dalla shortlist.
Famiglie di Architetture e Cosa Significano
| Famiglia | Come genera il parlato | Compromesso principale |
|---|---|---|
| Concatenativa | Unisce unità di parlato preregistrate | Naturale all'interno del dominio registrato, debole al di fuori |
| Parametrica statistica | Prevede caratteristiche acustiche, poi un vocoder rende l'audio | Flessibile, ma spesso ovattata |
| A forma d'onda neurale | Genera campioni audio con una rete neurale | Elevata naturalezza, computazionalmente pesante senza ottimizzazione |
| Neurale basata su token | Prevede codici audio discreti dal testo | Scala bene con i dati, richiede un attento controllo di stile e parlante |
Le ampie distinzioni di pipeline sono illustrate di seguito.
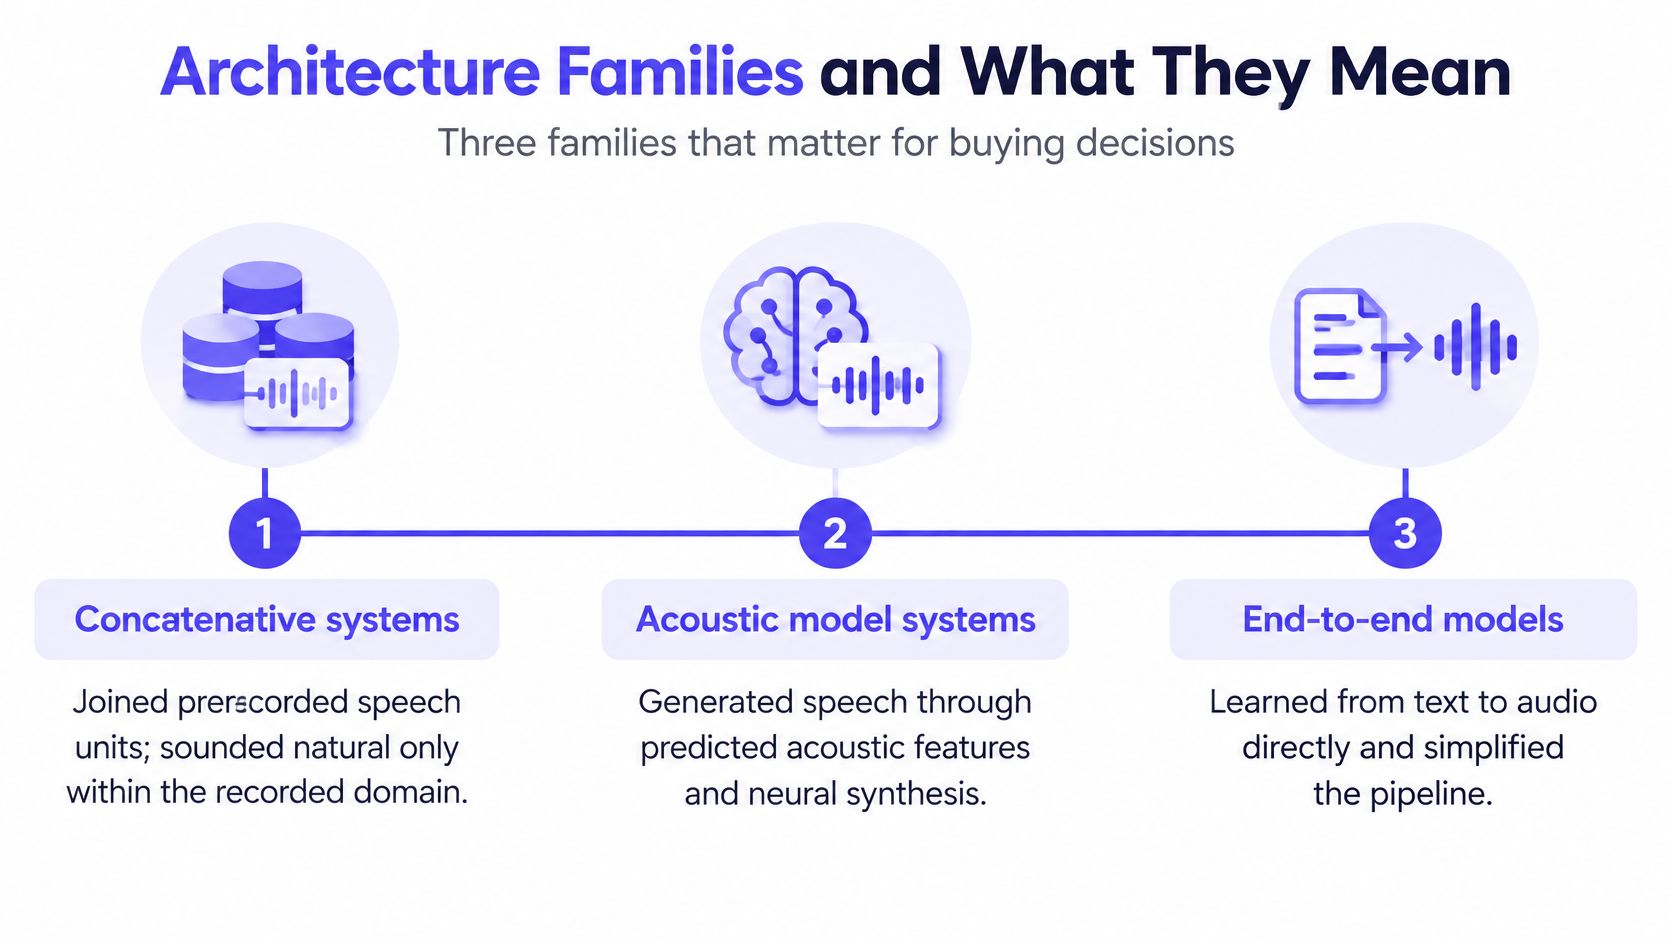
I sistemi concatenativi assemblano unità registrate, quindi la loro flessibilità è limitata dalle registrazioni disponibili e dalle giunzioni tra di esse. I sistemi parametrici statistici invece prevedono proprietà acustiche, quindi rendono il parlato tramite un vocoder, scambiando il riutilizzo diretto delle registrazioni con una pipeline di sintesi più controllabile.
Una pietra miliare è arrivata con WaveNet nel 2016: il paper di WaveNet ha riportato una riduzione di più di 50% nel divario di qualità tra i più forti sistemi TTS esistenti e il parlato umano nelle sue valutazioni in inglese americano e cinese mandarino. Questa scoperta ha stabilito l'importanza della generazione di forme d'onda neurali, non una garanzia universale di prestazioni per ogni modello neurale successivo.
I sistemi neurali basati su token prevedono rappresentazioni audio discrete che un decoder trasforma in suono. Per le decisioni di acquisto, distingui questa rappresentazione dall'interfaccia del servizio: un prodotto end-to-end può comunque contenere diverse fasi di elaborazione interne.
Leggi le Schede Modello come Descrizioni di Pipeline
Cerca dettagli su spectrogram, vocoder, codec, audio tokens e condizionamento del parlante. Uno stadio di spectrogram seguito da un vocoder suggerisce una pipeline a modello acustico; i codici audio discreti suggeriscono una generazione basata su token. Le descrizioni di training aiutano a spiegare il design, ma non sostituiscono il testing dell'output.
Per dispositivi con risorse limitate, confronta memoria effettiva, runtime e compatibilità hardware piuttosto che supporre che "più vecchio" significhi "più piccolo" o "più nuovo" significhi "solo cloud". Nelle implementazioni ospitate, ispeziona la latenza e i controlli forniti piuttosto che inferirli dall'etichetta dell'architettura.
Il confine è importante anche per compiti adiacenti. Una guida alla sintesi vocale cantata affronta un problema di controllo diverso: la prosodia parlata non è un sostituto per il timing e il pitch musicale espliciti.
Regola pratica: Usa l'architettura per comprendere i probabili vincoli e le utili domande diagnostiche, non per dichiarare un vincitore prima di ascoltare.
Clonazione Vocale, Scala e Copertura Linguistica
La clonazione vocale separa l'identità del parlante dalle parole pronunciate. Valuta queste dimensioni in modo indipendente: un output può assomigliare al parlante di riferimento pur pronunciando la frase con un'emozione inadeguata.
Le principali vie di clonazione differiscono nel modo in cui stabiliscono tale identità.
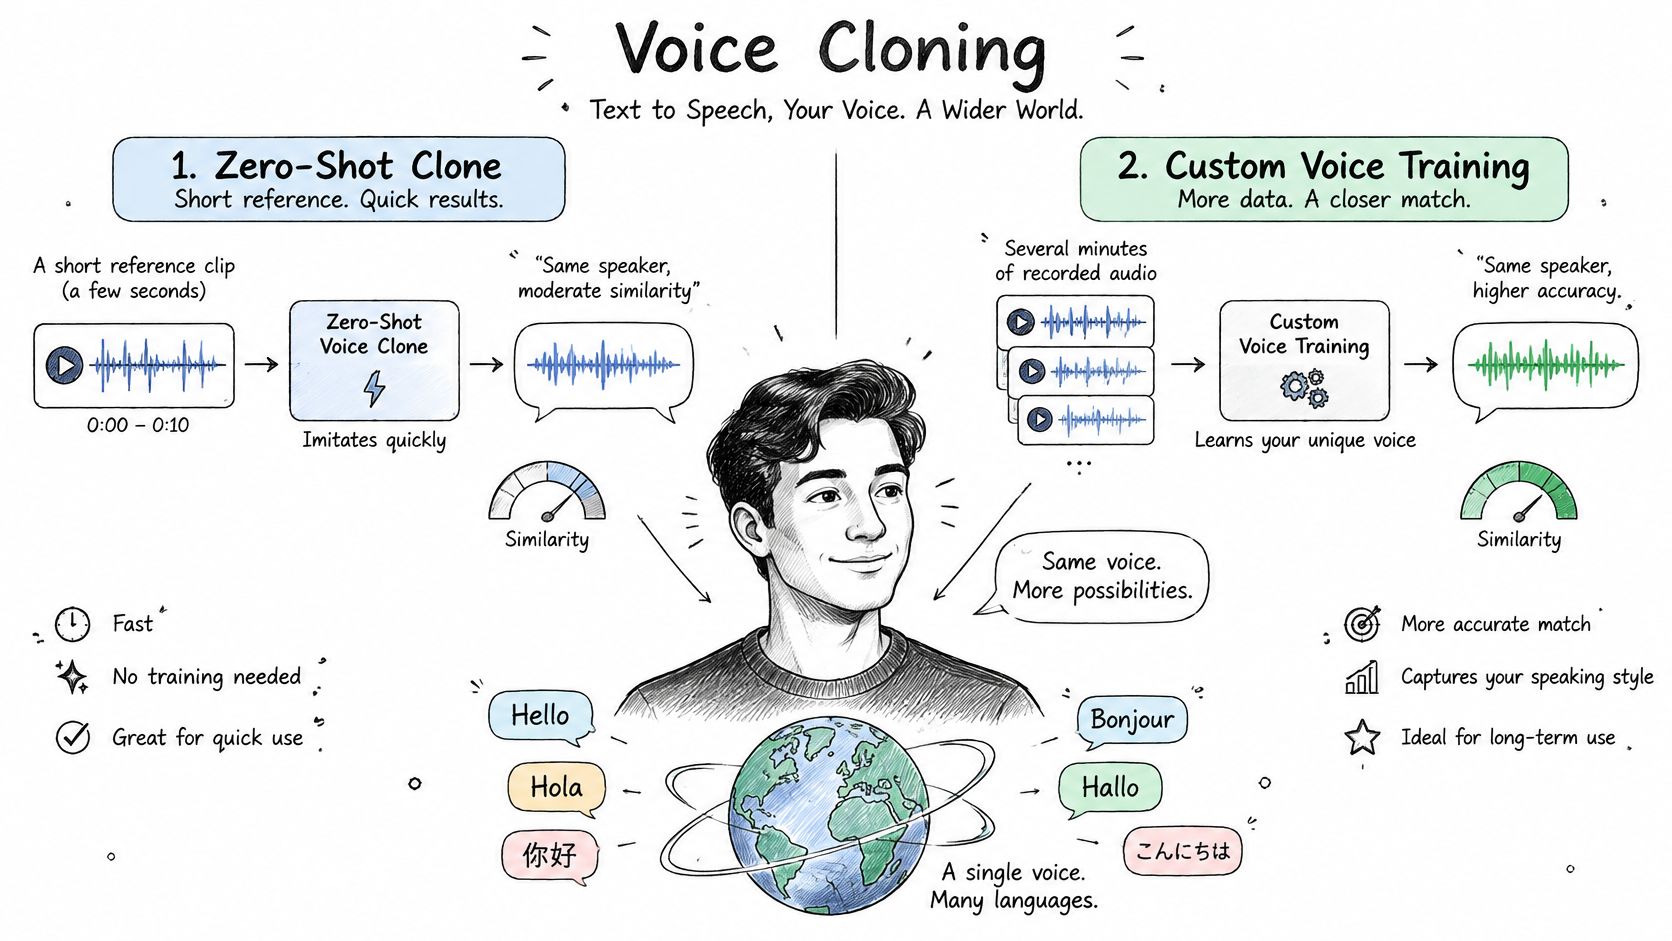
La clonazione zero-shot condiziona la sintesi sull'audio di riferimento senza un lavoro di addestramento separato specifico per il parlante. L'addestramento vocale personalizzato adatta un modello utilizzando un dataset di parlanti preparato. Il primo riduce il lavoro di configurazione; il secondo aggiunge requisiti di registrazione, preparazione e addestramento, senza rendere automatica la somiglianza.
La qualità del riferimento merita un test a sé stante. Rumore di fondo, parlanti concorrenti, posizionamento incoerente del microfono e stili di pronuncia nettamente diversi possono rendere più difficile determinare cosa il sistema dovrebbe preservare. Confronta riferimenti puliti prima di attribuire un risultato debole interamente al modello di sintesi.
Separare la Somiglianza dalla Performance
Considera un confronto ipotetico tra un riferimento breve e neutro e un riferimento più lungo contenente diverse pronunce emotive. Genera la stessa frase di marketing allegra da ciascuno. Chiedi agli ascoltatori separatamente se il parlante suona riconoscibile e se la pronuncia allegra suona appropriata.
Non dare per scontato che il riferimento più lungo debba vincere. Contiene più materiale, ma introduce anche più variazioni; la domanda utile è se il modello preserva l'identità seguendo la performance richiesta.
Per un'introduzione audiovisiva all'argomento, il seguente video offre un altro formato di visualizzazione.
La scala fornisce contesto, non approvazione. Nella sua copertura 2024, TechCrunch ha riportato che BASE-large ha utilizzato 100,000 ore di parlato di dominio pubblico per l'addestramento e conteneva 980 milioni di parametri. Questi totali non stabiliscono come si comporterà un particolare accento, parlante o lingua.
Quando esamini un elenco di modelli TTS multilingue, trasforma la capacità pubblicizzata in controlli di accettazione concreti:
- Copertura linguistica: Valuta ogni lingua e dialetto richiesto con ascoltatori fluenti.
- Stabilità dell'identità: Confronta il parlante attraverso domande, affermazioni e dialoghi espressivi.
- Prontezza al fallback: Identifica una voce preimpostata approvata per cloni non disponibili o inadatti.
- Provenienza del riferimento: Conserva l'identificatore della registrazione e il suo record di autorizzazione associato.
Una voce riconoscibile è utile solo quando la sua pronuncia rimane comprensibile e appropriata attraverso i messaggi effettivi del prodotto.
Metriche di Qualità Che Vanno Oltre il MOS
Un benchmark può essere riproducibile senza essere rappresentativo. Il dataset LJSpeech contiene 13,100 clip per un totale di circa 24 ore, registrate da un'unica narratrice di lingua inglese. Questo è utile per confronti controllati, ma il successo all'interno di questo ambito non stabilisce prestazioni più ampie tra oratori, accenti o stili conversazionali.
Il Mean Opinion Score, o MOS, misura la qualità percepita valutata dagli ascoltatori. Mantieni le frasi e le condizioni di ascolto coerenti tra i modelli, nascondi le identità dei modelli e definisci chiaramente la domanda di valutazione. Un panel a cui viene chiesta la gradevolezza non sta necessariamente valutando se un codice prodotto è stato pronunciato correttamente.
| Metrica | Cosa misura | Come misurarla | Limite principale |
|---|---|---|---|
| MOS | Qualità percepita su una scala di ascolto da scadente a eccellente | Un panel di ascolto valuta le stesse frasi di ogni modello | Non isola errori di pronuncia o ritmo senza domande mirate |
| Intelligibilità | Se gli ascoltatori riescono a riconoscere le parole | Trascrivere l'output con un riconoscitore vocale e confrontarlo con il testo previsto | Gli errori del riconoscitore possono oscurare gli errori di sintesi |
| Tempo al primo audio | Ritardo prima che l'audio utilizzabile arrivi o venga riprodotto | Registrare separatamente l'invio della richiesta, la ricezione del primo audio e la riproduzione | Non dice nulla sulla qualità del parlato |
| Fattore in tempo reale | Tempo di sintesi diviso per la durata dell'audio | Cronometrare la generazione e dividere per la durata dell'output | Varia con hardware, carico e limiti di misurazione |
| Riproducibilità | Coerenza tra esecuzioni e versioni ripetute | Fissare le impostazioni esposte e i seed, quindi rieseguire e confrontare | Alcuni servizi non espongono seed o blocchi di versione |
Definisci Cosa Include il Tuo Cronometro
Per lo streaming, distingui il primo audio ricevuto dalla prima riproduzione udibile. Il trasferimento di rete, la decodifica e il buffering del lettore appartengono all'esperienza utente, anche se si verificano al di fuori dell'inferenza del modello. Registra entrambi quando diagnostichi un ritardo.
Per i test di intelligibilità, confronta il parlato riconosciuto con la forma parlata prevista, non ciecamente con i caratteri di input grezzi. Una data pronunciata accettabile non corrisponderà alla sua notazione scritta carattere per carattere. Rivedi manualmente gli errori che coinvolgono nomi, numeri e simboli prima di trattare il riconoscitore come verità di base.
Una media di qualità è la descrizione di un test. Non è un criterio di accettazione finché non definisci quali errori il prodotto può tollerare.
Abbina i controlli automatizzati all'ascolto. Le misurazioni del Pitch da sole non descrivono ritmo, stress o intensità, e le differenze nella forma d'onda non significano necessariamente che gli ascoltatori percepiscano un cambiamento significativo.
Riporta insieme MOS, intelligibilità, tempo al primo audio e fattore in tempo reale. Includi la versione del modello, l'ambiente di runtime, le impostazioni della richiesta e i limiti di misurazione in modo che un altro ingegnere possa interpretare il risultato.
Costruire un Set di Test per Testo Difficile
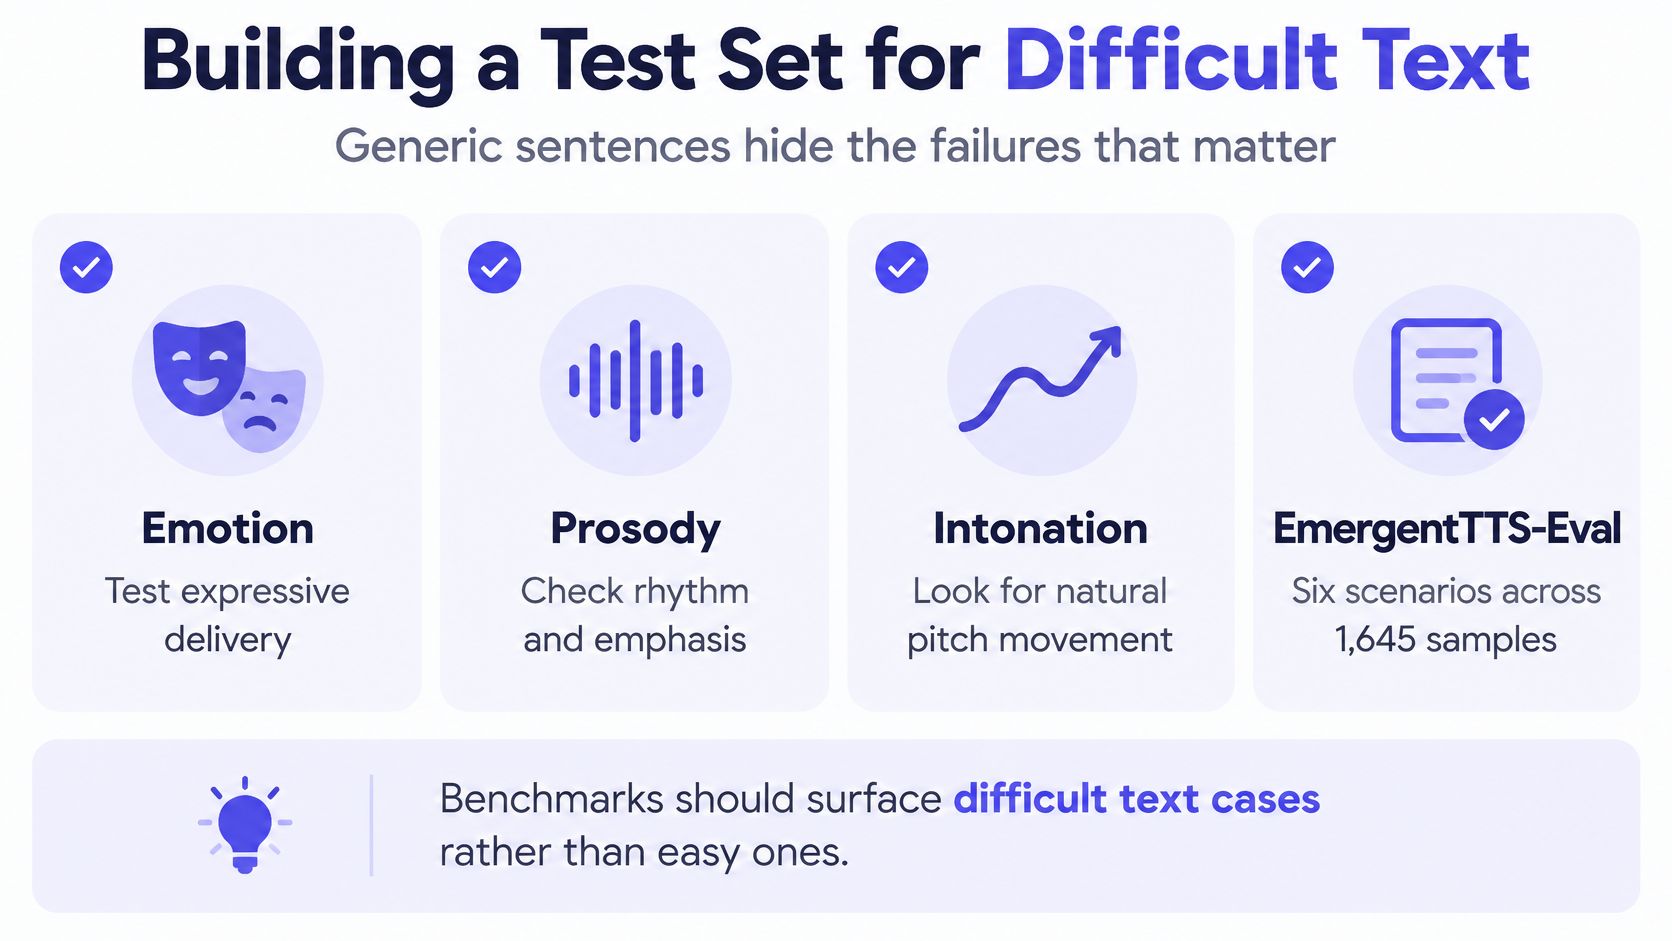
Le frasi generiche rendono i test di accettazione deboli perché omettono il testo che richiede interpretazione. EmergentTTS-Eval valuta sei scenari su 1,645 campioni, coprendo emozione, prosodia, intonazione e pronuncia; i suoi autori riportano una forte correlazione tra la valutazione basata su modelli e le preferenze umane.
Usa questo approccio più ampio senza trattare un benchmark esterno come la suite di test del tuo prodotto. La tua applicazione ha il suo vocabolario, la sua formattazione e le sue conseguenze per gli errori.
Le categorie di valutazione seguenti aiutano a esporre i fallimenti che i passaggi di facile lettura non rivelerebbero.
Includi Testo Che Cambia Significato Se Letto Male
- Nomi e luoghi: Nomi di prodotti, marchi, nomi personali, indirizzi e codici postali.
- Identificatori compatti: Acronimi, riferimenti account, codici prodotto e abbreviazioni ambigue.
- Notazione strutturata: Date, orari, URL, frammenti di codice e formule matematiche.
- Cambiamenti di lingua: Parole straniere e passaggi in lingua mista.
- Intento conversazionale: Domande, rassicurazione, urgenza, disaccordo e dialoghi carichi emotivamente.
- Segnali non vocali: Risate, sospiri e altre istruzioni di performance supportate.
Per ogni elemento, registra la lettura prevista. Un codice potrebbe richiedere la pronuncia carattere per carattere, mentre un acronimo potrebbe aver bisogno di essere pronunciato come una parola. Senza questa annotazione, gli ascoltatori possono non essere d'accordo sulla correttezza anche quando sentono lo stesso output.
Esegui un Confronto Ripetibile
- Raccogli testo rappresentativo. Estrai e anonimizza esempi di produzione, quindi etichettali per categoria. Includi input insoliti il cui fallimento avrebbe gravi conseguenze.
- Genera output comparabili. Mantieni formato, ruolo vocale e istruzioni di consegna equivalenti ove possibile. Salva la richiesta esatta e l'identificatore del modello.
- Usa ascoltatori coerenti. Chiedi allo stesso panel di valutare separatamente intelligibilità, pronuncia e appropriatezza prosodica. Mescola l'ordine dei modelli.
- Cattura le prestazioni per elemento. Registra il tempo del primo audio e il fattore in tempo reale insieme al testo associato, invece di mantenere solo una media del batch.
- Ripeti dopo le modifiche. Preserva una baseline approvata e indaga le regressioni quando un provider, una configurazione vocale o una regola di pre-elaborazione cambia.
Diciamo che un prompt di supporto contiene il cognome di un cliente e una data di appuntamento. Una frase splendidamente pronunciata che sbaglia uno dei due dovrebbe perdere contro un'alternativa meno espressiva ma accurata.
Riporta i tassi di fallimento per categoria e gravità. Un punteggio aggregato può nascondere proprio la classe di errore che dovrebbe bloccare il deployment.
Abbinare i Modelli al Tuo Caso d'Uso
| Caso d'uso | Criteri più importanti | Cosa testare per primo |
|---|---|---|
| Messaggi telefonici per il supporto clienti | Tempo al primo audio, pronuncia di nomi e codici prodotto | Un messaggio realistico contenente un nome e un codice attraverso il percorso di riproduzione telefonica |
| Narrazione di audiolibri di lunga durata | Prosodia tra i paragrafi, stabilità su passaggi lunghi | Coerenza su un passaggio esteso con dialoghi e cambi di scena |
| Accessibilità e lettori di schermo | Intelligibilità, controllo affidabile della velocità di parlato | Chiarezza alla velocità più alta che gli utenti probabilmente sceglieranno |
| Doppiaggio video e media | Gamma emotiva, sincronizzazione con clip di riferimento | Allineamento con la lunghezza e l'emozione della clip di riferimento |
| Istruzione e formazione | Pronuncia di termini tecnici, formule e parole straniere | Formule, acronimi e nomi stranieri dal materiale del corso |
La caratteristica più forte di un modello conta solo se supporta il lavoro. Il seguente confronto illustra le diverse priorità.
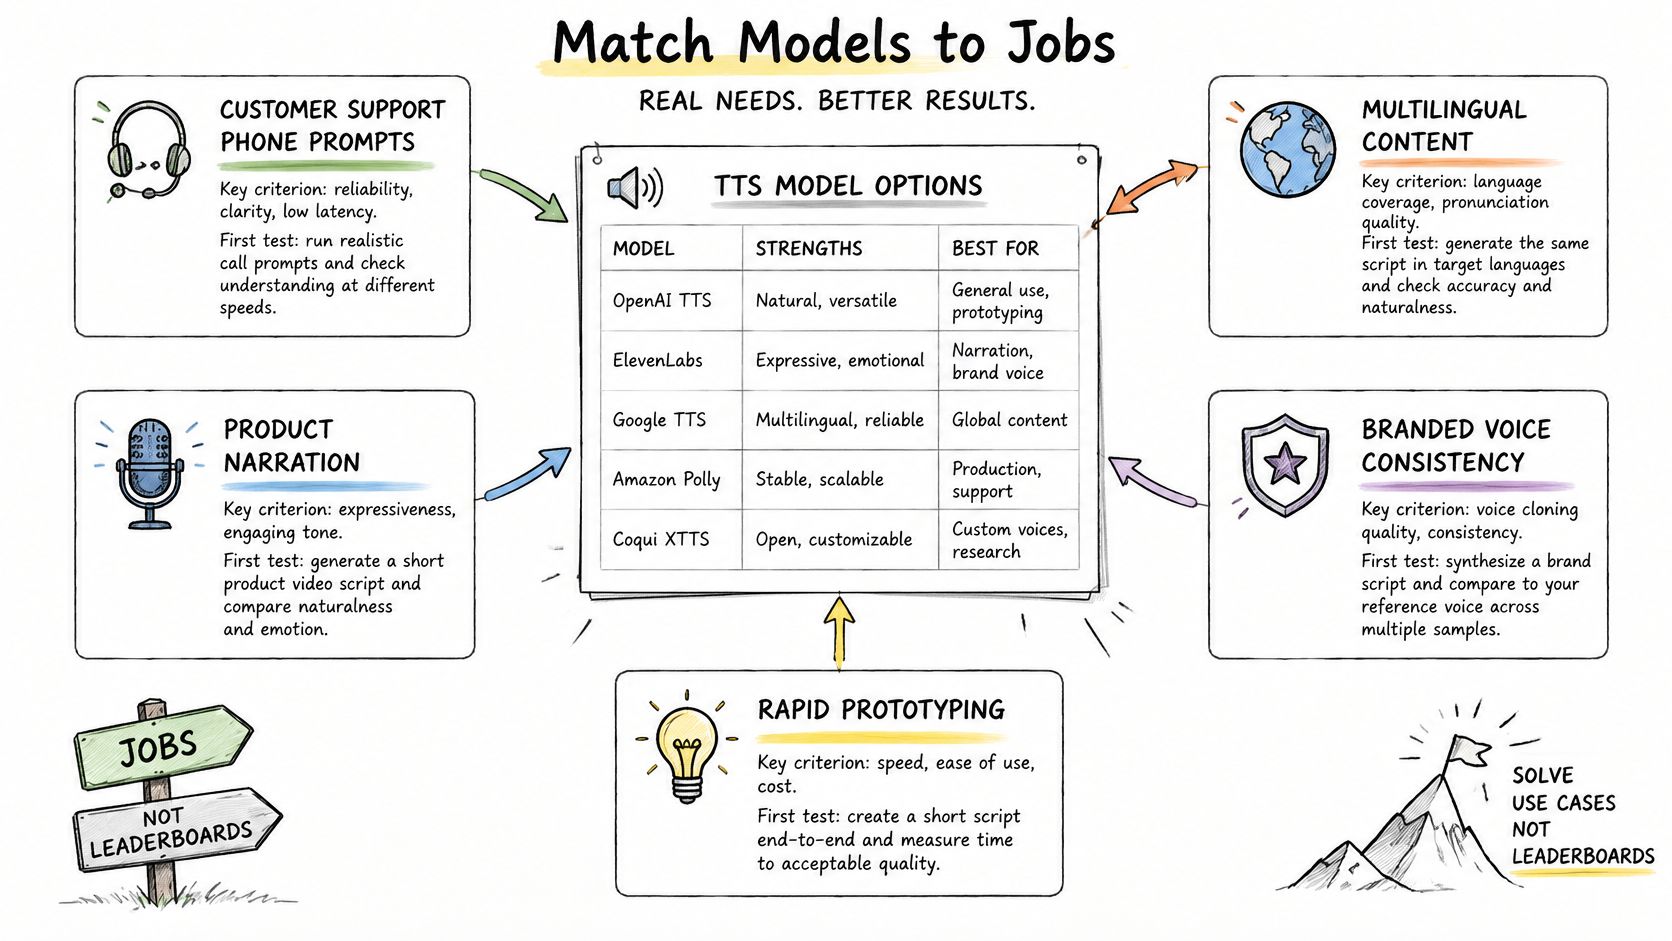
Per il supporto clienti, testa il percorso telefonico effettivo anziché limitarti a revisionare download di qualità studio. Per gli audiolibri, ascolta attraverso i confini dei paragrafi, i cambi di oratore e la generazione ripresa, perché le frasi isolate non esercitano la continuità.
La valutazione dell'accessibilità dovrebbe includere le persone che useranno l'output e i loro controlli di riproduzione preferiti. Il doppiaggio richiede una performance di riferimento e vincoli di tempo; l'istruzione richiede una revisione specialistica della notazione parlata prevista.
Applica Criteri Eliminatori Prima delle Preferenze
Se la latenza definisce l'interazione, richiedi un'interfaccia di streaming adatta prima di classificare le voci. Una risposta ritardata può compromettere il design dell'interazione indipendentemente dalla sua qualità finale.
Se un'identità di oratore specifica è obbligatoria, stabilisci il permesso prima di creare cloni per la valutazione. Non rendere l'autorizzazione una preoccupazione solo di produzione dopo che il team si è affezionato a una voce.
Se codici e date veicolano il messaggio, dai priorità alla loro lettura corretta rispetto alla gradevolezza. Tratta gli errori di pronuncia critici come blocchi anziché lasciare che punteggi di stile elevati li compensino.
Principio di selezione: Classifica i modelli accettabili dopo aver applicato i requisiti stringenti. Non mediare un fallimento squalificante in un punteggio altrimenti attraente.
Scrivi questi criteri eliminatori prima di rivedere i risultati. Ad esempio, un narratore di corsi potrebbe aver bisogno di un vocabolario tecnico affidabile ma non di streaming conversazionale, mentre un assistente vocale potrebbe aver bisogno di input di testo incrementale ma non di clonazione. Questa distinzione restringe il confronto senza fare affidamento su una classifica universale.
Consenso, divulgazione e uso sicuro della voce
Il clonaggio vocale è una decisione di governance, non solo un'impostazione di sintesi. La guida TTS responsabile descrive la classificazione della FCC delle voci robocall generate dall'IA come voci artificiali ai sensi del Telephone Consumer Protection Act, rendendo illegali le chiamate soggette senza il previo consenso richiesto. Non interpretarlo come un divieto generale della narrazione sintetica né come un permesso per ogni uso non-robocall.
La narrazione sintetica ordinaria e il clonaggio che preserva l'identità richiedono controlli operativi diversi. Selezionare una voce preimpostata con licenza non stabilisce il diritto di imitare una persona identificabile. Per le voci personalizzate, il permesso documentato del parlante dovrebbe essere un requisito di deployment.
Integra i controlli nel percorso della richiesta
- Registra il permesso del parlante: Conserva lo scopo autorizzato, i canali consentiti, l'ambito d'uso e le condizioni di scadenza o revisione insieme al record della voce.
- Rifiuta l'imitazione non autorizzata: Vieta il clonaggio di persone identificabili senza permesso scritto e prevedi un modo per sospendere le voci contestate.
- Applica le regole di divulgazione: Etichetta il parlato sintetico quando lo richiedono la legge applicabile, la policy della piattaforma o il contesto.
- Preserva l'auditabilità: Registra l'identificatore del modello, l'identificatore della voce, l'ora della richiesta e il riferimento all'autorizzazione senza duplicare inutilmente testo sensibile.
- Mantieni alternative sicure: Approva voci di fallback che non intendono imitare individui identificabili.
- Conserva i metadati del modello: Archivia le fonti dei dati di addestramento divulgate, le licenze, le restrizioni d'uso e la documentazione di valutazione pertinente.
Un record di permesso necessita anche di un processo di revoca. Decidi chi può disabilitare una voce, come vengono gestiti gli audio in cache e cosa succede ai contenuti programmati quando l'autorizzazione cambia.
Valuta a chi serve il sistema
Testa separatamente le prestazioni relative ad accento, dialetto e lingua. Una media globale può nascondere un'esperienza scadente per un particolare gruppo di parlanti, quindi conserva i risultati a livello di gruppo dove la raccolta e la reportistica sono appropriate.
Anche la governance deve seguire il routing. Se le richieste possono raggiungere provider diversi, non dare per scontato che un'autorizzazione vocale o un accordo di trattamento si applichi a ogni destinazione. Limita il routing a combinazioni approvate di modello, voce e termini di trattamento.
Questa è una guida operativa generale, non un parere legale. Verifica le leggi e i requisiti contrattuali applicabili al parlante, al pubblico e alla sede di deployment prima del rilascio.
API Ospitate o Modelli Aperti Auto-Ospitati
Il deployment determina cosa controlli e cosa devi gestire. Un'API ospitata sposta l'erogazione del modello a un operatore esterno. L'auto-hosting affida al tuo team la responsabilità per il runtime, la capacità, gli aggiornamenti e i controlli di accesso.
I pesi aperti non significano automaticamente uso commerciale illimitato, idoneità offline o bassi requisiti hardware. Esamina la licenza e i requisiti di runtime prima di investire nell'integrazione. Allo stesso modo, un endpoint ospitato non fornisce automaticamente versioni fisse o una particolare disposizione sulla residenza dei dati.
| Criterio di decisione | API ospitata | Modello aperto auto-ospitato |
|---|---|---|
| Costo al volume previsto | Costi di utilizzo più costi di integrazione e consegna | Calcolo, archiviazione, capacità inattiva e sforzo ingegneristico |
| Latenza sotto carico di punta | Include il percorso di rete e la coda lato servizio | Dipende dall'hardware fornito e dalla tua pianificazione |
| Residenza dei dati | Richiede la revisione delle posizioni e dei termini di elaborazione | Può rimanere all'interno dell'infrastruttura che controlli |
| Gestione delle versioni | Soggetto alle opzioni di blocco e aggiornamento del servizio | Il tuo team controlla gli artefatti e i tempi di rollout |
Confronta il Costo Operativo Totale
Il deployment ospitato può essere adatto a una domanda variabile e a team che non desiderano gestire hardware di inferenza. Conferma l'unità di fatturazione, i limiti di concorrenza e come vengono gestiti i tentativi prima di stimare il costo. Un prezzo basato solo sui caratteri non descrive l'intera fattura dell'applicazione.
L'auto-hosting può essere adatto per operazioni offline o requisiti che proibiscono l'invio di testo e registrazioni di riferimento al di fuori dell'infrastruttura controllata. Richiede comunque pianificazione della capacità, monitoraggio, aggiornamenti di sicurezza e un processo di rilascio riproducibile. Un modello che gira su una workstation non è necessariamente pronto per il traffico di produzione concorrente.
Considera l'elenco del modello Qwen TTS come un punto di scoperta per un candidato, non come prova della sua idoneità per una particolare configurazione di hosting. Conferma il runtime effettivo, la licenza e l'interfaccia per qualsiasi deployment tu stia valutando.
Testa il Percorso di Servizio, Non Solo i Pesi
Utilizza lo stesso corpus anonimizzato su candidati ospitati e auto-ospitati. Mantieni coerenti il formato di riproduzione e il client di test, quindi misura sotto i modelli di concorrenza e richiesta che l'applicazione si aspetta.
Registra se il test include avvio, caricamento, accodamento e conversione. Altrimenti, un benchmark locale "a caldo" e una richiesta remota completa non sono comparabili.
Se il tuo set di test contiene informazioni personali, rivedi i termini di gestione dei dati prima di trasmetterlo. Rimuovi gli identificatori non necessari anche quando la destinazione è approvata e limita l'accesso alle registrazioni di riferimento indipendentemente dal testo ordinario dell'applicazione.
Preselezione, test e approvazione finale
Una preselezione dovrebbe esprimere requisiti, non familiarità con il marchio. Mantieni i candidati che soddisfano il contratto di input, le lingue richieste, i vincoli operativi e le condizioni di autorizzazione della voce. Escludi i modelli che non possono soddisfare un requisito obbligatorio prima di dedicare loro tempo all'ascolto.
Usa una procedura di rilascio che lasci un registro delle decisioni ispezionabile:
- Seleziona i candidati compatibili. Documenta perché ogni modello è adatto agli input e agli output richiesti. Separa le funzionalità obbligatorie dalle preferenze, così i revisori sanno cosa si può sacrificare.
- Esegui e revisiona la suite di testi difficili. Conserva gli output grezzi, i giudizi degli ascoltatori e i registri dei tempi. Indaga gli errori critici invece di accettare un punteggio aggregato attraente.
- Approva i diritti e i termini di elaborazione. Verifica la licenza del modello, l'autorizzazione dell'audio di riferimento e l'uso previsto di ogni voce personalizzata. Assegna un responsabile alle condizioni irrisolte.
- Congela la configurazione approvata. Fissa le versioni dove supportato, salva le impostazioni di pre-elaborazione e consegna, e richiedi test di regressione quando cambia la configurazione di erogazione.
Mantieni separata la comodità dell'integrazione dall'accettazione
UberLLM fornisce accesso a Claude, GPT, Gemini, DeepSeek e ai modelli per immagini, video e musica tramite un endpoint compatibile con OpenAI e Anthropic. Un'API key comune e un saldo prepagato consolidano l'accesso, e cambiare l'identificatore del modello supporta il confronto tra candidati senza un'integrazione separata per ogni provider; i parametri vocali specifici del modello devono comunque essere verificati.
Qwen3 0.6B TTS è elencato a $0.035 per 1K caratteri, rispetto a un prezzo di listino di $0.0875 per 1K caratteri. Conferma i prezzi attuali nella scheda del provider prima di definire il budget, e confronta i costi solo tra i candidati che soddisfano i criteri di accettazione.
Richiedi una decisione di rilascio con un responsabile
Assegna un responsabile al registro di approvazione e conserva gli esempi audio approvati. Registra esplicitamente le eccezioni, incluse le categorie di testo che richiedono pre-elaborazione, una voce di fallback o una revisione umana.
Una decisione di rilascio dovrebbe restare comprensibile dopo che le persone che hanno eseguito la valutazione passano a un altro progetto. Il controllo finale è semplice: Il modello scelto supera il test sui testi difficili e il registro dei consensi copre ogni voce clonata?
UberLLM offre un'API unificata per confrontare e integrare la voce insieme ad altri tipi di modello. Visita UberLLM per esaminare i candidati vocali, poi esegui i tuoi nomi, codici e dialoghi emotivi anonimizzati attraverso i modelli che soddisfano i tuoi requisiti di input prima di scegliere una configurazione di produzione.