音声合成モデル: 機能と選定ガイド
入力、出力、音声クローン、品質指標、同意規則といった観点から、音声合成モデルについて掘り下げていきます。表や2026向けの選定チェックリストも掲載しています。
Sonixの業界動向レポートによると、ニューラル音声とAI生成音声は、**テキスト読み上げ市場収益の67.90%(2024)**を占めました。それは収益を測るもので、信頼性を測るものではありません。
テキスト読み上げモデルを選ぶ開発者にとって、より難しい問いは、その音声がアプリケーションから送られる名前、コード、指示、感情的な対話を届けられるかどうかです。聞こえのいいデモでは、その問いには答えられません。モデル選定は入出力の契約として捉え、その後に本番テキストでの評価を行うべきです。アーキテクチャ、声の類似性、平均的な自然さは重要ですが、どれも、聞き手の理解を変えてしまう失敗を帳消しにするほど重視すべきではありません。
目次
- 機能、入力、出力の概要
- アーキテクチャファミリーとその意味
- 音声クローン、スケール、言語対応
- MOSを超える品質指標
- 難しいテキストのためのテストセットを構築する
- ユースケースにモデルを合わせる
- 同意、開示、安全な音声利用
- ホスト型APIまたはセルフホスト型オープンモデル
- 候補を絞り込み、テストし、承認する
機能、入力、出力の概要
| 機能 | 典型的な入力 | 典型的な出力 | 使用場面 |
|---|---|---|---|
| 標準TTS | プレーンテキスト | 音声ファイルまたはストリーム | 固定またはユーザー提供のテキストからナレーションが必要な場合 |
| ストリーミングTTS | 生成されたテキストチャンク | 再生順の音声チャンク | 全文が準備できる前に音声を開始する必要がある場合 |
| マークアップまたはスタイル制御TTS | SSMLまたはスタイルタグ付きテキスト | 設定されたポーズ、強調、感情を含む音声 | 発音とペースを制御する必要がある場合 |
| 音声クローニング | テキストと、文書化された同意を得た参照音声 | 参照話者の声による音声 | ブランドまたはユーザーの声を再現する必要がある場合 |
| 多言語TTS | 複数の言語のテキスト | 各言語の音声(1つまたは複数の声で) | 1つの製品が多くの言語のユーザーに対応する場合 |
標準TTSは最もシンプルな契約です。テキストを送信し、音声を受け取ります。準備されたナレーション、通知、および文言がすでに完成している文章に使用します。ダウンロード可能なファイルは編集やキャッシュに適しており、ストリーミング応答は音声ファイル全体を待つ必要がありません。
ストリーミングTTSはより詳細な確認が必要です。一部のサービスは完全なテキスト入力を受け取った後に音声をストリーミングしますが、増分テキストも受け入れるサービスもあります。アシスタントが応答を段階的に生成する場合、ストリーミングが両方向を意味すると仮定するのではなく、インターフェースが後者をサポートしていることを確認してください。
マークアップ制御合成は配信指示を追加します。SSML、発音制御、および独自のスタイルタグは互換性がないため、選択したモデルが受け入れる正確な構文をテストしてください。サポートされていない指示は無視されるか、拒否されるか、または読み上げられる可能性があります。
クローニングは参照話者の入力を追加し、多言語合成は言語カバレッジを追加します。どちらも自動的にもう一方を含むわけではありません。多言語のプリセット音声が必ずしもクローン可能であるとは限らず、クローンされた音声がすべてのサポート言語で必ずしも信頼できるとは限りません。
音声を選ぶ前にオーディオ契約を選択する
WAVはコンテナであり、PCMは音声表現を記述します。 非圧縮PCMは、WAVにパッケージされることが多く、編集や処理に便利です。電話パイプラインは、馴染みのある拡張子のファイルだけでなく、ダウンストリームシステムが期待するエンコーディング、チャンネル構成、サンプルレートを必要とします。
MP3とOpusは、クライアントのサポート状況に応じて、ブラウザやアプリケーション向けの圧縮配信オプションです。追加の変換段階なしでプレイヤーがデコードできる形式を選択してください。そうしないと、測定された合成パフォーマンスはユーザーが経験する遅延を説明しません。
サンプルレートは、音声がどれくらいの頻度でサンプリングされるかを指定します。これは、表現される周波数範囲に影響を与え、他の設定が固定された非圧縮音声の場合、ファイルサイズにも影響します。出力サンプルレートを上げても、不明瞭な発音が修正されたり、モデルが生成しなかった詳細が復元されたりすることはありません。
統合する前に、契約を書き留めてください。
- 入力制約: 許容されるテキスト長、サポートされるマークアップ、および増分入力の動作。
- 音声の利用可能性: 必要な言語、方言、プリセット音声、およびカスタム音声へのアクセス。
- 出力要件: エンコーディング、サンプルレート、チャンネル、およびストリーミングの動作。
- 障害時の動作: アプリケーションが拒否されたテキスト、中断されたストリーム、および利用できない音声をどのように処理するか。
表を左から右に読んでください。持っている入力を必要な出力に合わせ、そのユースケースが適合するかどうかを確認してください。優れた音質だが、間違った対話パターンを必要とする音声は、候補リストから外すべきです。
アーキテクチャの種類とその意味
| 種類 | 音声生成方法 | 主なトレードオフ |
|---|---|---|
| 連結型 | 録音済みの音声単位を結合する | 録音された領域内では自然だが、それ以外では弱い |
| 統計的パラメトリック型 | 音響特徴を予測し、ボコーダーで音声をレンダリングする | 柔軟だが、しばしばこもった音になる |
| ニューラル波形生成型 | ニューラルネットワークでオーディオサンプルを生成する | 高い自然さ、最適化なしでは計算負荷が高い |
| トークンベースニューラル型 | テキストから離散的なオーディオコードを予測する | データとともにうまくスケールするが、スタイルと話者の慎重な制御が必要 |
広範なパイプラインの区別を以下に示します。
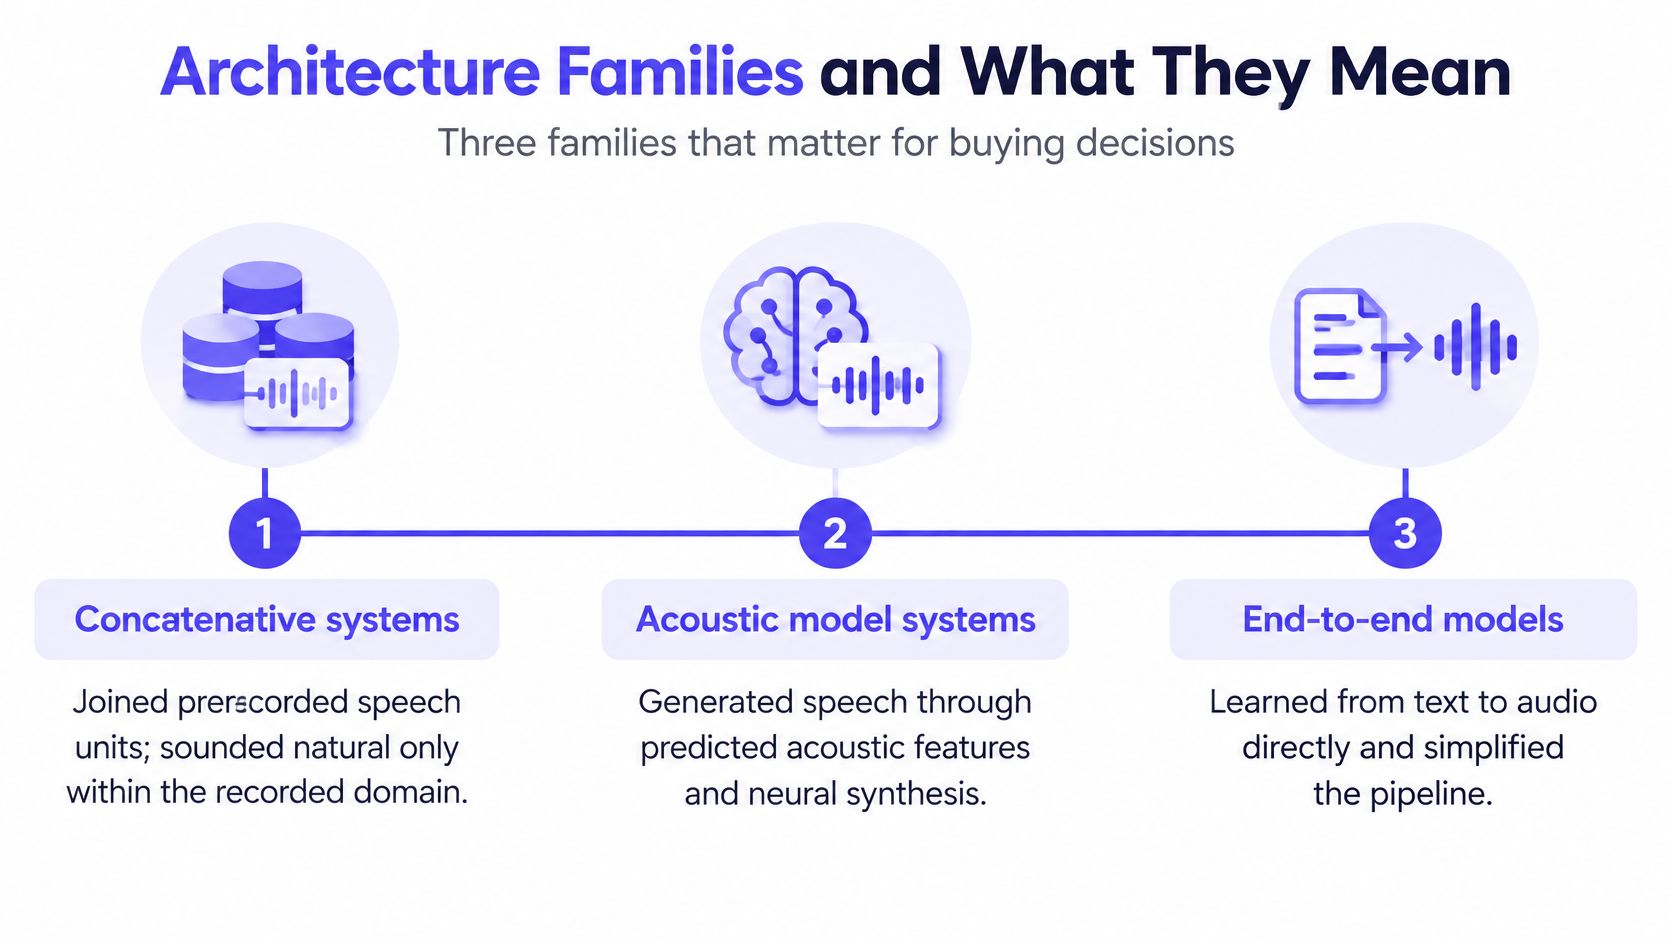
連結型システムは録音された単位を組み立てるため、その柔軟性は利用可能な録音とそれらの間の結合によって制限されます。一方、統計的パラメトリックシステムは音響特性を予測し、ボコーダーを介して音声をレンダリングすることで、録音の直接的な再利用を、より制御可能な合成パイプラインと交換します。
2016年のWaveNetで画期的な進歩がありました。WaveNet論文]は、その米国英語と中国語(北京語)の評価において、既存の最も強力なTTSシステムと人間の音声との間の品質ギャップが50%以上縮小したと報告しました。この発見は、ニューラル波形生成の重要性を確立しましたが、その後のすべてのニューラルモデルに対する普遍的な性能保証ではありません。
トークンベースニューラルシステムは、デコーダーが音に変換する離散的なオーディオ表現を予測します。購入の意思決定においては、この表現をサービスインターフェースと区別してください。エンドツーエンドの製品であっても、内部に複数の処理段階を含むことがあります。
モデルカードをパイプライン記述として読む
spectrogram、vocoder、codec、audio tokens、および話者条件付けの詳細を探してください。スペクトログラム段階の後にボコーダーが続く場合は音響モデルパイプラインを示唆し、離散的なオーディオコードはトークンベースの生成を示唆します。トレーニングの記述は設計を説明するのに役立ちますが、出力テストの代わりにはなりません。
制約のあるデバイスの場合、古いものが小さい、新しいものがクラウド専用であると仮定するのではなく、実際のメモリ、ランタイム、ハードウェアの互換性を比較してください。ホスト型デプロイメントでは、アーキテクチャのラベルから推測するのではなく、提供されるレイテンシと制御を検査してください。
この境界は隣接するタスクにも関係します。歌声合成ガイド]は異なる制御問題に対処しています。話されたプロソディは、明示的な音楽のタイミングやピッチの代わりにはなりません。
実践的なルール: アーキテクチャは、可能性のある制約や役立つ診断上の疑問を理解するために使用し、聞く前に勝者を宣言するためではありません。
音声クローニング、規模、および対応言語
音声クローニングは、話者のアイデンティティと発話内容を分離します。 これらの側面は個別に評価してください。出力は参照話者に似ていても、不適切な感情で文を話す可能性があります。
主なクローニング方法では、アイデンティティの確立方法が異なります。
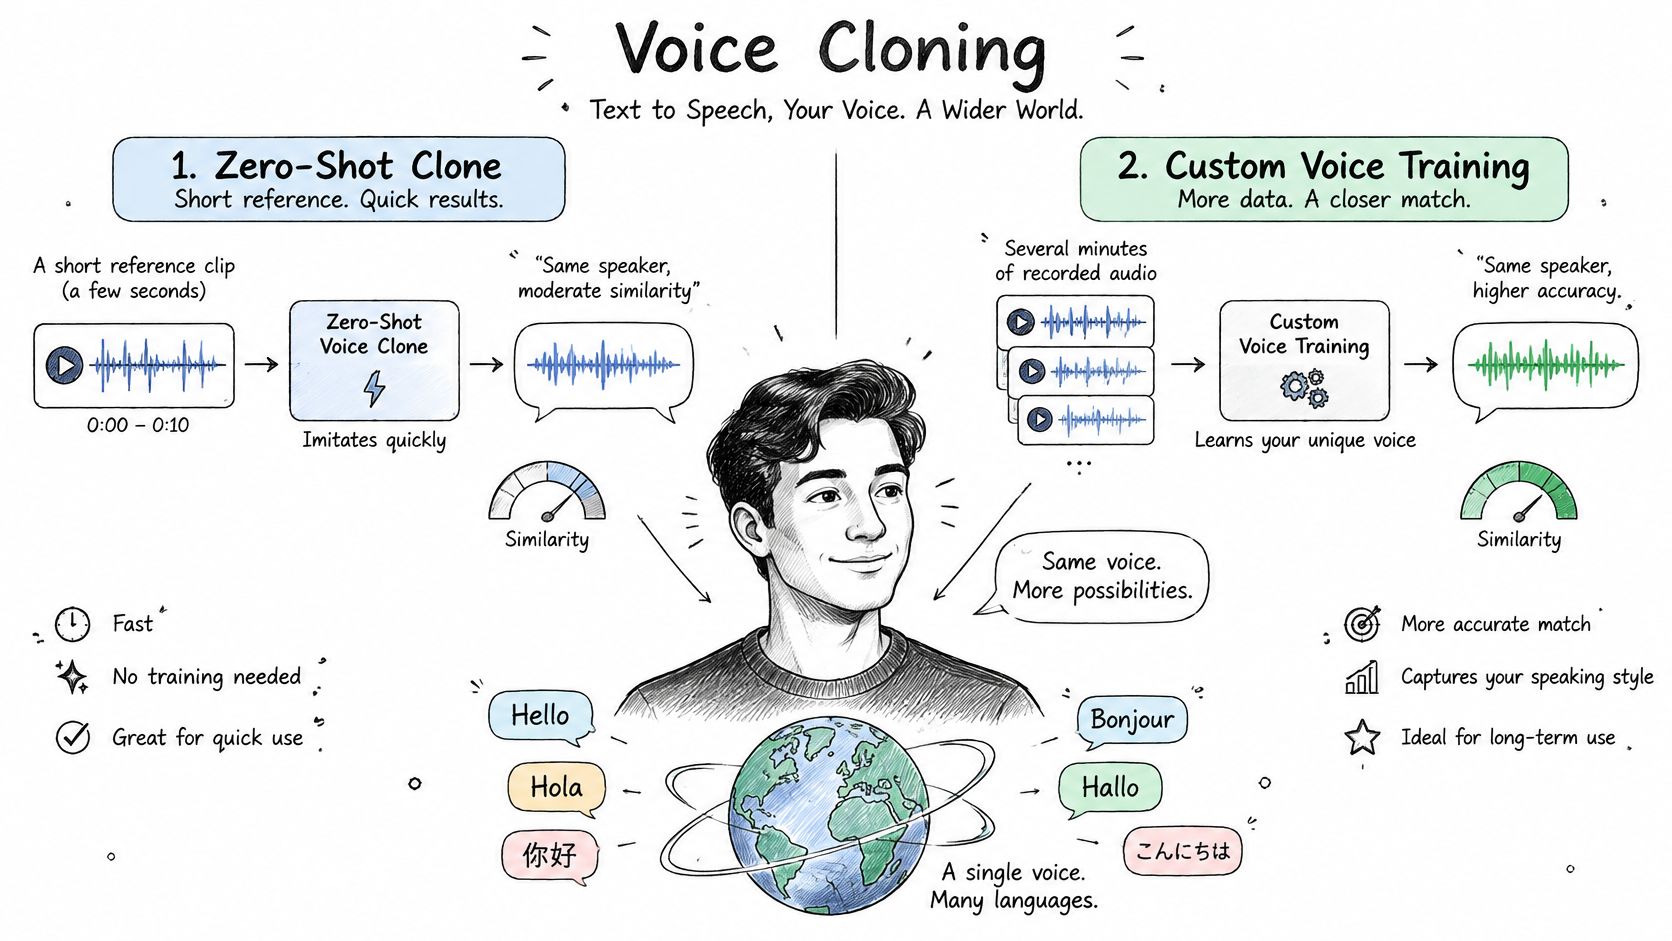
ゼロショットクローニングは、個別の話者固有のトレーニングジョブなしで、参照オーディオに基づいて合成を行います。カスタム音声トレーニングは、準備された話者データセットを使用してモデルを適応させます。前者はセットアップ作業を削減しますが、後者は、類似性が自動的に得られるわけではなく、録音、準備、およびトレーニングの要件を追加します。
参照品質は、別途テストが必要です。背景ノイズ、他の話者の声、一貫性のないマイク配置、大きく異なる発話スタイルは、システムが何を保持すべきかを判断しにくくする可能性があります。不十分な結果を合成モデルのみに帰する前に、クリーンな参照音声と比較してください。
類似性とパフォーマンスを分離する
短く中立的な参照と、いくつかの感情的な発話を含むより長い参照との架空の比較を考えてみましょう。それぞれから同じ陽気なマーケティングフレーズを生成します。話者が認識可能であるか、そして陽気な発話が適切に聞こえるかを、リスナーに個別に尋ねてください。
より長い参照が必ずしも優れているとは限りません。それはより多くの情報を含んでいますが、より多くのバリエーションも生み出します。重要な問いは、モデルが要求されたパフォーマンスに沿いながらアイデンティティを保持するかどうかです。
このトピックを動画で紹介するために、以下のビデオは別の視聴形式を提供します。
規模は文脈を示すものであり、最終的な保証ではありません。2024の報道で、TechCrunchは、BASE-largeがトレーニングに100,000時間のパブリックドメイン音声を使用し、980百万のparametersを含んでいたと報じました。これらの合計は、特定のアクセント、話者、または言語がどのように機能するかを保証するものではありません。
多言語TTSモデルのリストを検討する際には、宣伝されている機能を具体的な受け入れ確認項目に変えてください。
- 言語対応: 流暢なリスナーとともに、必要な各言語と方言を評価してください。
- アイデンティティの安定性: 質問、平叙文、感情表現豊かな対話を通じて話者を比較してください。
- フォールバックの準備: 利用できない、または不適切なクローンに対して、承認されたプリセット音声を特定してください。
- 参照元の記録: 録音識別子とそれに関連する許諾記録を保持してください。
認識可能な音声は、製品の実際のメッセージ全体で、その発話が理解しやすく、かつ適切である場合にのみ有用です。
MOSだけではない品質指標
ベンチマークは再現可能であっても、代表的であるとは限りません。LJSpeechデータセットには、一人の英語を話す女性ナレーターによって録音された、合計約24時間の13,100クリップが含まれています。これは制御された比較には役立ちますが、その範囲内での成功は、話者、アクセント、会話スタイル全体にわたるより広範なパフォーマンスを確立するものではありません。
**平均意見スコア(MOS)は、リスナーが評価する知覚品質を測定します。**モデル間で文章と聴取条件を一貫させ、モデルの識別情報を隠し、評価の質問を明確に定義してください。心地よさについて尋ねられたパネルは、製品コードが正しく話されたかどうかを必ずしも評価しているわけではありません。
| 指標 | 測定内容 | 測定方法 | 主な限界 |
|---|---|---|---|
| MOS | 「悪い」から「素晴らしい」までの聴取スケールでの知覚品質 | 聴取パネルが各モデルの同じ文章を評価する | 的を絞った質問なしでは、発音やリズムのエラーを特定できない |
| 明瞭度 | リスナーが単語を認識できるか | 音声認識器で出力を文字起こしし、意図したテキストと比較する | 認識器のエラーが合成エラーを不明瞭にする可能性がある |
| 最初のオーディオまでの時間 | 利用可能なオーディオが到着または再生されるまでの遅延 | リクエスト送信、最初のオーディオ受信、再生を個別にタイムスタンプする | 音声品質については何も語らない |
| リアルタイムファクター | 合成時間をオーディオの持続時間で割ったもの | 生成時間を測定し、出力の持続時間で割る | ハードウェア、負荷、測定境界によって変化する |
| 再現性 | 繰り返しの実行とバージョン間での一貫性 | 公開されている設定とシードを固定し、再実行して比較する | 一部のサービスはシードやバージョンピンを公開していない |
ストップウォッチの測定範囲を明確にする
streamingの場合、最初の受信オーディオと最初の可聴再生を区別してください。ネットワーク転送、デコード、プレイヤーのバッファリングは、これらがモデル推論の外部で発生する場合でも、ユーザーエクスペリエンスに属します。遅延を診断する際には、両方を記録してください。
明瞭度テストでは、認識された音声を意図された発話形式と比較し、生の入力文字と盲目的に比較しないでください。許容される発話された日付は、書かれた表記と文字通り一致するわけではありません。認識器を真実として扱う前に、名前、数字、記号に関するエラーを手動でレビューしてください。
品質平均はテストの説明です。製品が許容できるエラーを定義するまでは、それは受け入れ基準ではありません。
自動チェックとリスニングを組み合わせてください。ピッチ測定だけでは、リズム、強調、強度を説明できません。また、波形の違いが必ずしもリスナーが意味のある変化を聞き取るとは限りません。
MOS、明瞭度、最初のオーディオまでの時間、リアルタイムファクターをまとめて報告してください。他のエンジニアが結果を解釈できるように、モデルバージョン、ランタイム環境、リクエスト設定、測定境界を含めてください。
難しいテキストのテストセットを作る
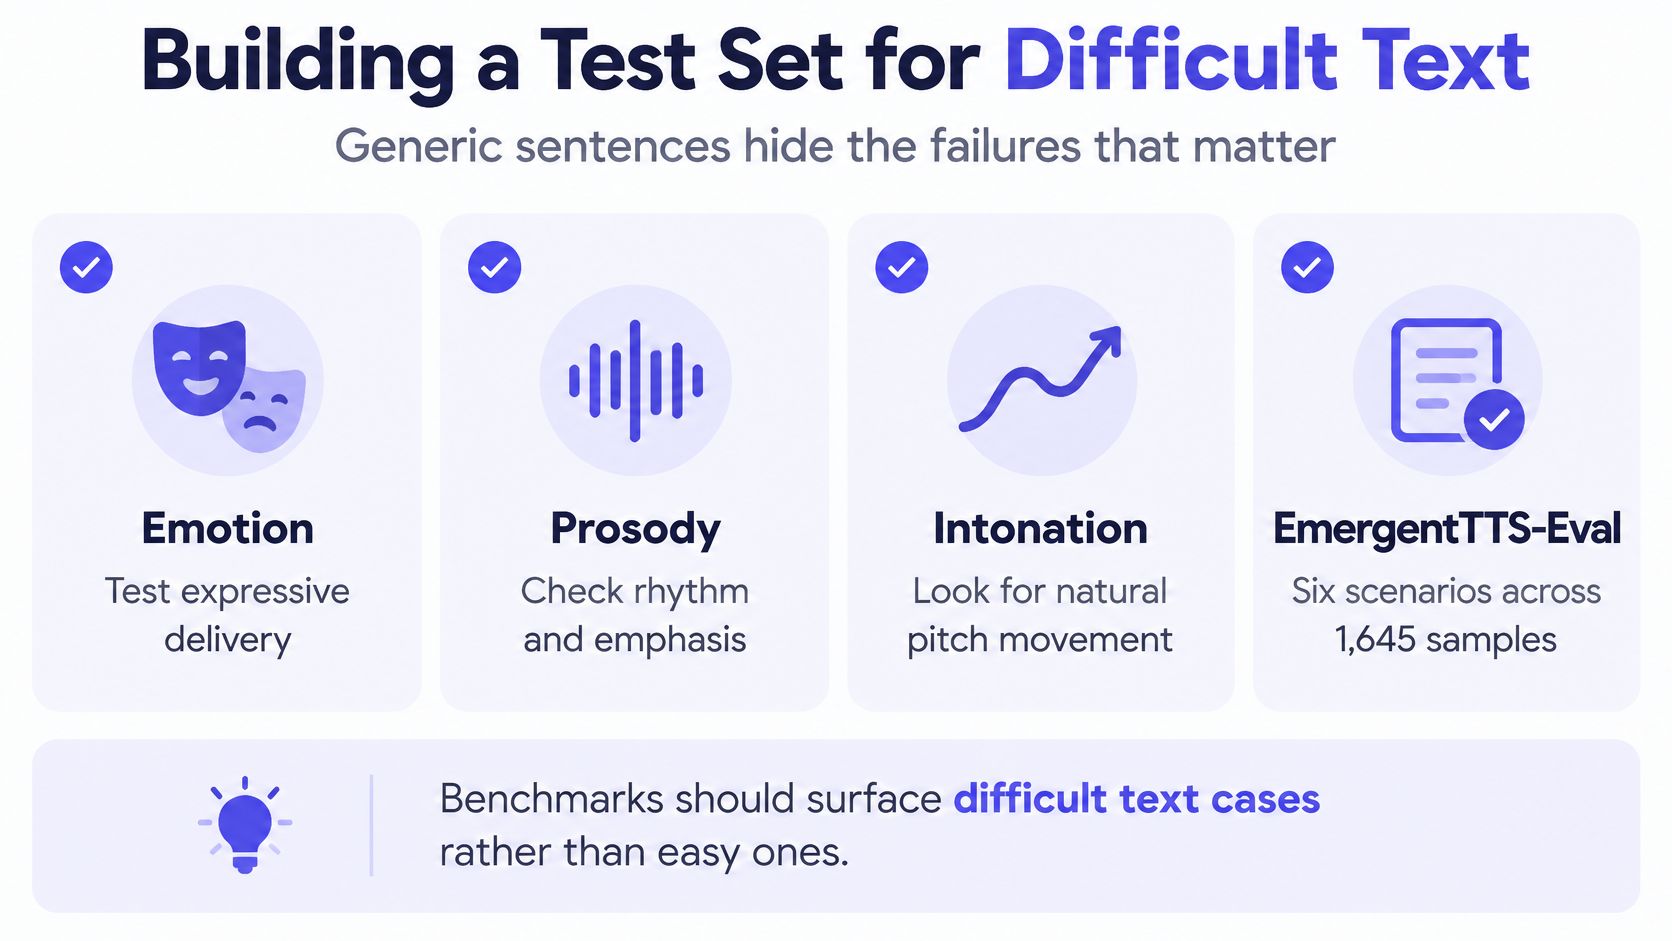
一般的な文は、解釈が必要なテキストを省いてしまうため、受け入れテストとしては弱いです。EmergentTTS-Eval は 1,645 件のサンプルにわたる 6 つのシナリオを評価し、感情、韻律、イントネーション、発音を対象にしています;その著者らは、モデルベースの判定と人間の選好との間に強い相関があると報告しています。
そのより広いアプローチは取り入れつつ、外部ベンチマークを製品のテストスイートとして扱わないでください。あなたのアプリケーションには独自の語彙、書式、そして間違いによる影響があります。
以下の評価カテゴリは、やさしい読み上げ原稿では見えない失敗を明らかにするのに役立ちます。
読み間違えると意味が変わるテキストを含める
- 人名と地名: 製品名、ブランド、人名、住所、郵便番号。
- 短い識別子: 頭字語、アカウント参照、製品コード、あいまいな略語。
- 構造化された表記: 日付、時刻、URL、コード断片、数式。
- 言語の切り替わり: 外来語や複数言語が混ざった文章。
- 会話の意図: 質問、安心させる表現、緊急性、不同意、感情が込められた対話。
- 非音声キュー: 笑い、ため息、その他対応している演出指示。
各項目について、意図した読み方を記録します。コードは 1 文字ずつ綴る必要があるかもしれませんし、頭字語は 1 語として発音する必要があるかもしれません。その注記がないと、同じ出力を聞いても、聞き手によって正しさの判断が分かれることがあります。
再現可能な比較を実行する
- 代表的なテキストを集める。 本番環境の例を抽出して匿名化し、カテゴリ別にタグ付けします。失敗すると重大な影響がある珍しい入力も含めます。
- 比較可能な出力を生成する。 可能な範囲で、フォーマット、音声の役割、話し方の指示を同等に保ちます。正確なリクエストとモデル識別子を保存します。
- 一貫した聞き手を使う。 同じパネルに、明瞭性、発音、韻律の適切さを個別に評価してもらいます。モデルの順序はシャッフルします。
- 項目ごとにパフォーマンスを記録する。 バッチ平均だけを残すのではなく、関連するテキストと一緒に、最初の音声が出るまでの時間とリアルタイム係数を記録します。
- 変更後に再実行する。 承認済みのベースラインを維持し、プロバイダー、音声設定、前処理ルールが変わったときにリグレッションを調査します。
たとえば、サポート用のプロンプトに顧客の姓と予約日が含まれているとします。どちらかを間違えてしまう、美しく読み上げられた文は、表現力は低くても正確な代替案に負けるべきです。
カテゴリと重大度別の失敗率を報告します。集計スコアは、デプロイを止めるべきまさにその種類のエラーを隠してしまうことがあります。
ユースケースに合ったモデルを選ぶ
| ユースケース | 最も重要な基準 | まず何をテストすべきか |
|---|---|---|
| カスタマーサポートの電話プロンプト | 最初の音声までの時間、名前や製品コードの発音 | 電話再生経路を通じた、名前とコードを含む現実的なプロンプト |
| 長尺オーディオブックのナレーション | 段落間のプロソディ、長尺での安定性 | 会話や場面転換を含む長尺での一貫性 |
| アクセシビリティとスクリーンリーダー | 明瞭さ、信頼性の高い読み上げ速度制御 | ユーザーが選択する可能性のある最速での明瞭さ |
| 動画の吹き替えとメディア | 感情表現の幅、参照クリップとのタイミング | 参照クリップの長さと感情との一致 |
| 教育とトレーニング | 技術用語、数式、外国語の発音 | 教材からの数式、頭字語、外国語名 |
モデルの最も強力な機能も、それがその仕事に役立つ場合にのみ意味があります。以下の比較は、異なる優先順位を示しています。
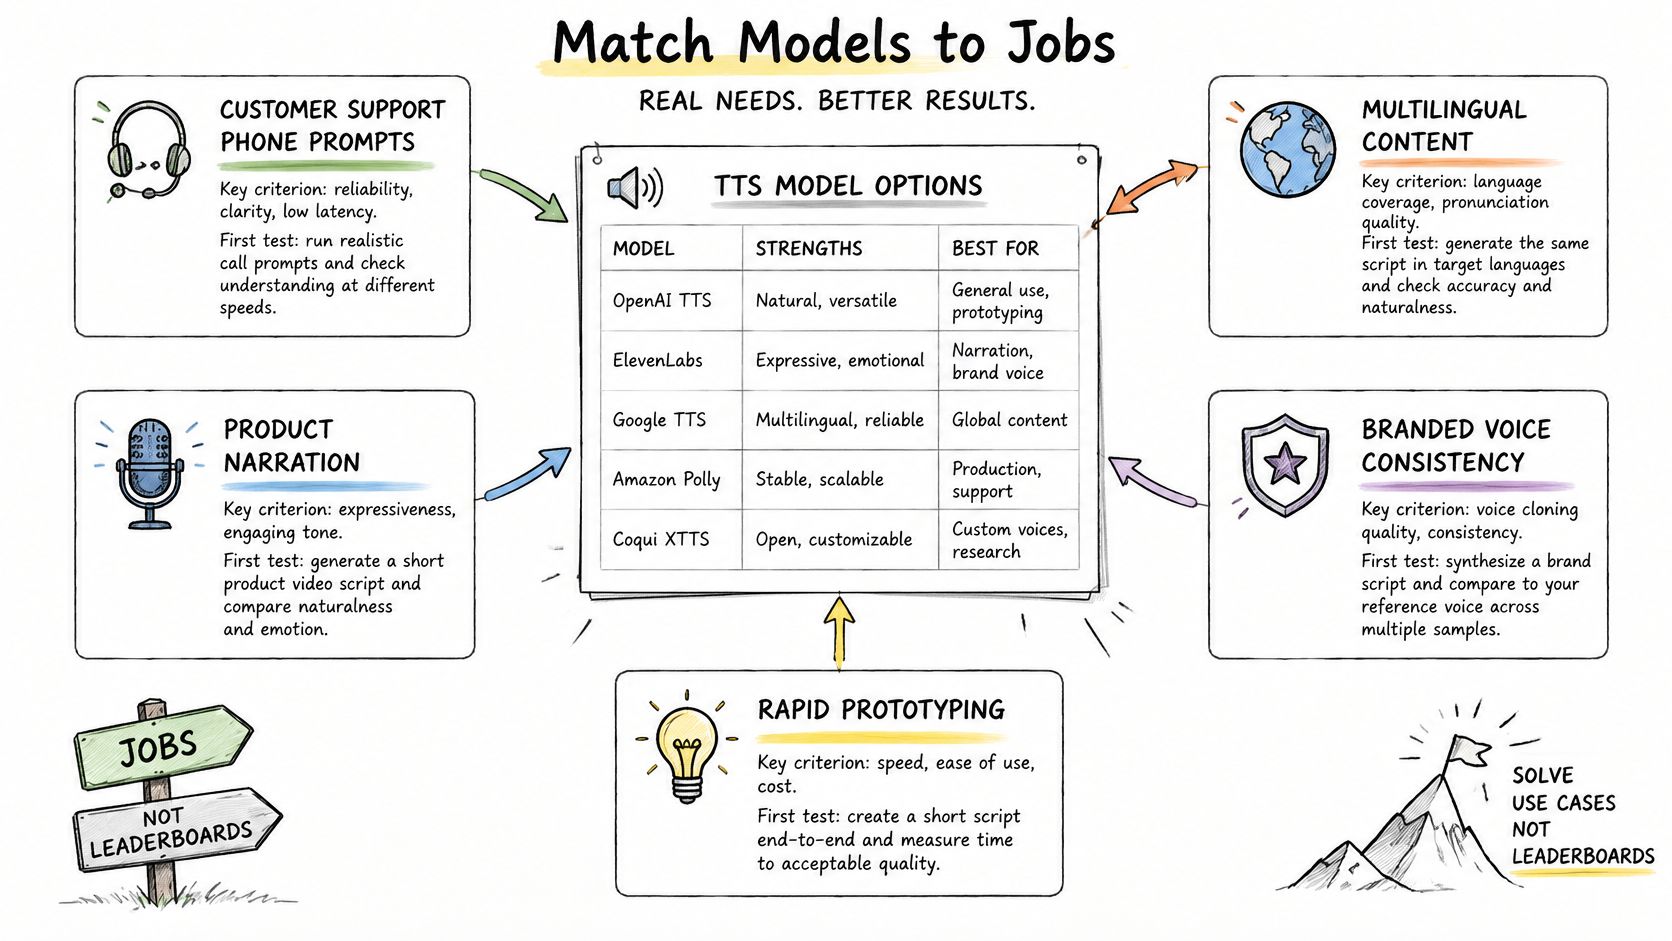
カスタマーサポートの場合、スタジオ品質のダウンロードだけを確認するのではなく、実際の電話経路でテストしてください。オーディオブックの場合、個々の文では連続性が検証されないため、段落の区切り、話者の変更、再開された生成にわたって聞いてください。
アクセシビリティ評価には、出力を使用する人々や彼らが好む再生コントロールを含めるべきです。吹き替えには参照となるパフォーマンスとタイミングの制約が必要です。教育には、意図された音声表記の専門家によるレビューが必要です。
好みよりも厳格な条件を適用する
レイテンシーがインタラクションを左右する場合、音声をランク付けする前に適切なストリーミングインターフェースを必須とします。 応答が遅れると、最終的な品質に関わらず、インタラクションデザインが失敗する可能性があります。
特定の話者IDが必須である場合、評価用のクローンを作成する前に許可を得てください。 チームが特定の音声に愛着を持った後で、承認を本番環境だけの問題にしないでください。
コードや日付がメッセージを伝える場合、快適さよりもそれらの正しい読み上げを優先してください。 致命的な発音エラーは、強力なスタイルスコアで補うのではなく、ブロッカーとして扱ってください。
選択の原則: 厳格な要件を適用した後で、許容できるモデルをランク付けします。失格となるような失敗を、他の魅力的なスコアに平均化しないでください。
結果を確認する前に、これらの条件を書き出してください。例えば、コースのナレーターは信頼性の高い技術用語の読み上げが必要でも、会話型ストリーミングは不要かもしれません。一方、音声アシスタントは段階的なテキスト入力が必要でも、クローン作成は不要かもしれません。この区別により、普遍的なリーダーボードに頼ることなく比較を絞り込むことができます。
同意、開示、安全な音声利用
音声クローニングは、単なる合成設定ではなく、ガバナンス上の判断です。責任あるTTSガイダンスは、FCCが電話消費者保護法の下でAI生成のロボコール音声を人工音声として分類しており、必要な事前同意なしに対象となる通話を行うことを違法にしていると説明しています。これを、合成ナレーションの一律禁止や、ロボコール以外のあらゆる利用に対する許可と解釈しないでください。
通常の合成ナレーションとアイデンティティを保持するクローニングには、異なる運用上の精査が必要です。 ライセンス済みのプリセット音声を選んでも、特定可能な人物を模倣する権利が確立されるわけではありません。カスタム音声では、文書化された話者の許可をデプロイ要件にすべきです。
リクエストパスに制御を組み込む
- 話者の許可を記録する: 許可された目的、許可されたチャネル、利用範囲、および有効期限または見直し条件を、音声記録と一緒に保管します。
- 未承認の模倣を拒否する: 書面による許可なく特定可能な人物をクローニングすることを禁止し、異議申し立てのある音声を一時停止する方法を提供します。
- 開示ルールを適用する: 適用法、プラットフォームポリシー、または文脈上必要な場合は、合成音声にラベルを付けます。
- 監査可能性を保つ: モデル識別子、音声識別子、リクエスト時刻、承認参照をログに記録し、機密テキストを不必要に複製しないようにします。
- 安全な代替手段を維持する: 特定可能な個人を模倣する意図のないフォールバック音声を承認します。
- モデルメタデータを保持する: 開示されたトレーニングデータのソース、ライセンス、利用制限、および関連する評価ドキュメントを保管します。
許可記録には取り消しプロセスも必要です。誰が音声を無効化できるか、キャッシュされた音声をどう扱うか、承認が変わったときにスケジュール済みコンテンツがどうなるかを決めます。
システムが誰にサービスを提供するかを評価する
アクセント、方言、言語のパフォーマンスを個別にテストします。全体平均は、特定の話者グループにとっての悪い体験を隠す可能性があるため、収集と報告が適切な場合はグループレベルの結果を保持します。
ガバナンスはルーティングにも追随する必要があります。リクエストが異なるプロバイダーに到達する可能性がある場合、音声の承認や処理契約がすべての宛先に適用されると想定しないでください。ルーティングを、モデル、音声、処理条件の承認済みの組み合わせに制限します。
これは一般的な運用ガイダンスであり、法的助言ではありません。リリース前に、話者、オーディエンス、デプロイ場所に適用される法律と契約要件を確認してください。
ホスト型APIまたはセルフホスト型オープンモデル
デプロイメントによって、何を制御し、何を運用する必要があるかが決まります。 ホスト型APIはモデルの提供を外部のオペレーターに委ねます。セルフホスティングは、ランタイム、キャパシティ、更新、アクセス制御の責任をチームに与えます。
オープンウェイトだからといって、自動的に商用利用が無制限であること、オフラインでの利用に適していること、またはハードウェア要件が低いことを意味するわけではありません。統合に投資する前に、ライセンスとランタイム要件を確認してください。同様に、ホスト型endpointだからといって、固定バージョンや特定のデータレジデンシーの取り決めが自動的に提供されるわけではありません。
| 決定基準 | ホスト型API | セルフホスト型オープンモデル |
|---|---|---|
| 想定されるボリュームでのコスト | 利用料金に加えて統合および配信コスト | Compute、storage、アイドルキャパシティ、およびエンジニアリングの労力 |
| ピーク負荷時のLatency | ネットワークパスとサービス側のキューイングを含む | プロビジョニングされたハードウェアとスケジューリングに依存 |
| データレジデンシー | 処理場所と規約の確認が必要 | 制御するインフラストラクチャ内に留めることが可能 |
| バージョン管理 | サービスの固定および更新オプションに左右される | チームがアーティファクトとロールアウトのタイミングを制御 |
総運用コストを比較する
ホスト型デプロイメントは、変動する需要や、推論ハードウェアを運用したくないチームに適しています。コストを見積もる前に、課金単位、concurrency limits、およびretriesの処理方法を確認してください。文字ベースの料金だけでは、アプリケーションの総費用を完全に表すことはできません。
セルフホスティングは、offline operationや、制御されたインフラストラクチャ外へのテキストおよび参照録音の送信を禁止する要件に適しています。それでも、capacity planning、monitoring、security updates、およびreproducible release processが必要です。ワークステーションで動作するモデルが、必ずしもconcurrent production trafficに対応できるとは限りません。
Qwen TTSモデルのリストを候補の発見点として扱い、特定のホスティング構成への適合性の証明として扱わないでください。評価するデプロイメントについて、実際のランタイム、ライセンス、およびinterfaceを確認してください。
ウェイトだけでなく、提供パスをテストする
ホスト型およびセルフホスト型の候補に対して、同じ匿名化されたcorpusを使用してください。再生フォーマットとtest clientを一貫させ、アプリケーションが想定するconcurrencyとrequest patternsで測定してください。
テストにstartup、loading、queuing、およびconversionが含まれているかどうかを記録してください。そうしないと、ウォームなローカルベンチマークと完全なremote requestは比較できません。
テストセットに個人情報が含まれている場合は、送信する前にdata-handling termsを確認してください。送信先が承認されている場合でも不要なidentifiersを削除し、通常のapplication textとは別にreference recordingsへのアクセスを制限してください。
候補選定、テスト、承認
候補リストはブランドの知名度ではなく、要件を反映すべきです。入力契約、必須言語、運用上の制約、音声認証条件を満たす候補を保持してください。厳格な要件を満たせないモデルは、時間をかけて検討する前に除外してください。
検証可能な決定記録を残すリリース手順を使用してください:
- 互換性のある候補を選定する。 各モデルが必須の入力と出力に適合する理由を文書化してください。必須機能と好みを区別し、レビュー担当者が何をトレードオフできるかを知るようにしてください。
- 難解なテキストスイートを実行し、レビューする。 生の出力、リスナーの判断、タイミング記録を保持してください。魅力的な集計スコアを受け入れるのではなく、重大なエラーを調査してください。
- 権利と処理条件を承認する。 モデルライセンス、参照音声の認証、および各カスタム音声の意図された使用法を確認してください。未解決の条件には所有者を割り当ててください。
- 承認された構成を固定する。 サポートされている場合はバージョンを固定し、前処理と配信設定を保存し、提供構成が変更された場合は回帰テストを要求してください。
統合の利便性と受け入れ基準を区別する
UberLLMは、OpenAIおよびAnthropic互換のendpointを通じて、Claude、GPT、Gemini、DeepSeek、および画像、動画、音楽モデルへのアクセスを提供します。共通のAPI keyとプリペイド残高によりアクセスが一元化され、モデル識別子を変更することで、各モデルのプロバイダー統合を個別に行うことなく候補の比較が可能です。ただし、モデル固有の音声パラメーターは依然として確認が必要です。
Qwen3 0.6B TTSは、定価**$0.0875 per 1K charactersに対し、$0.035 per 1K characters**で掲載されています。予算を組む前にプロバイダーの掲載情報で現在の価格を確認し、受け入れ基準を満たす候補間でのみコストを比較してください。
記名によるリリース決定を要求する
承認記録に所有者を割り当て、承認された音声サンプルを保存してください。前処理、フォールバック音声、または人間によるレビューが必要なテキストカテゴリを含め、例外を明示的に記録してください。
評価を実行した担当者が別のプロジェクトに異動した後も、リリース決定は理解できる状態を保つべきです。最終確認はシンプルです:選択されたモデルは難解なテキストテストに合格し、同意記録はすべてのクローン音声をカバーしていますか?
UberLLMは、他のモデルタイプと並行して音声を比較・統合するための統一APIを提供します。音声候補を検査するにはUberLLM]にアクセスし、本番構成を選択する前に、入力要件を満たすモデルで匿名化された名前、コード、感情的な対話を実行してください。