Mô hình Chuyển văn bản thành giọng nói: Khả năng và Hướng dẫn lựa chọn
Khám phá các mô hình chuyển văn bản thành giọng nói theo đầu vào, đầu ra, nhân bản giọng nói, các chỉ số chất lượng và quy tắc đồng ý, cùng với các bảng và danh sách kiểm tra lựa chọn cho 2026.
Giọng nói AI và giọng nói nơ-ron chiếm 67.90% doanh thu thị trường chuyển văn bản thành giọng nói vào năm 2024, theo báo cáo xu hướng ngành của Sonix. Điều đó đo lường doanh thu, không phải độ tin cậy. Đối với một nhà phát triển khi chọn các mô hình chuyển văn bản thành giọng nói, câu hỏi khó hơn là liệu một giọng nói có thể truyền tải được tên, mã, hướng dẫn và đoạn hội thoại cảm xúc mà một ứng dụng gửi đi hay không.
Một bản demo dễ chịu không trả lời được câu hỏi đó. Hãy coi việc lựa chọn mô hình như một hợp đồng đầu vào và đầu ra, sau đó là đánh giá văn bản sản xuất. Kiến trúc, độ tương đồng giọng nói và độ tự nhiên trung bình đều quan trọng, nhưng không yếu tố nào được phép bỏ qua một lỗi làm thay đổi những gì người nghe hiểu.
Mục lục
- Khả năng, Đầu vào và Đầu ra trong nháy mắt
- Các họ kiến trúc và ý nghĩa của chúng
- Nhân bản giọng nói, Quy mô và Phạm vi ngôn ngữ
- Các chỉ số chất lượng vượt xa MOS
- Xây dựng bộ kiểm thử cho văn bản khó
- Ghép nối mô hình với trường hợp sử dụng của bạn
- Sự đồng ý, Tiết lộ và Sử dụng giọng nói an toàn
- API được lưu trữ hoặc Mô hình mở tự lưu trữ
- Lập danh sách rút gọn, Kiểm tra và Phê duyệt
Tổng quan nhanh về khả năng, đầu vào và đầu ra
| Khả năng | Đầu vào thường gặp | Đầu ra thường gặp | Dùng khi |
|---|---|---|---|
| TTS tiêu chuẩn | Văn bản thuần | Tệp âm thanh hoặc luồng | Bạn cần đọc lời từ văn bản cố định hoặc do người dùng cung cấp |
| TTS streaming | Các đoạn văn bản khi chúng được tạo ra | Các đoạn âm thanh theo thứ tự phát | Âm thanh phải bắt đầu trước khi toàn bộ văn bản sẵn sàng |
| TTS điều khiển bằng markup hoặc style | Văn bản có SSML hoặc thẻ style | Âm thanh có khoảng dừng, nhấn mạnh hoặc cảm xúc được đặt | Cần kiểm soát cách phát âm và nhịp độ |
| Nhân bản giọng nói | Văn bản cùng âm thanh tham chiếu có sự đồng ý được ghi nhận | Âm thanh bằng giọng của người nói tham chiếu | Cần tái tạo giọng của thương hiệu hoặc người dùng |
| TTS đa ngôn ngữ | Văn bản bằng nhiều ngôn ngữ | Âm thanh ở từng ngôn ngữ, với một hoặc nhiều giọng | Một sản phẩm phục vụ người dùng ở nhiều ngôn ngữ |
TTS tiêu chuẩn là hợp đồng đơn giản nhất: gửi văn bản và nhận giọng nói. Dùng nó cho lời đọc đã chuẩn bị, thông báo và các đoạn mà câu chữ đã hoàn chỉnh. Tệp có thể tải xuống phù hợp để chỉnh sửa và lưu đệm; phản hồi streaming có thể tránh phải chờ toàn bộ tệp âm thanh.
TTS streaming cần xem xét kỹ hơn. Một số dịch vụ phát luồng âm thanh sau khi nhận đầu vào văn bản hoàn chỉnh, trong khi những dịch vụ khác cũng chấp nhận văn bản tăng dần. Nếu một trợ lý tạo câu trả lời dần dần, hãy xác nhận rằng giao diện hỗ trợ trường hợp sau thay vì cho rằng streaming có nghĩa là cả hai chiều.
Tổng hợp điều khiển bằng markup thêm hướng dẫn cách thể hiện. SSML, điều khiển phát âm và thẻ style độc quyền không thể thay thế cho nhau, nên hãy kiểm tra cú pháp chính xác mà model bạn chọn chấp nhận. Hướng dẫn không được hỗ trợ có thể bị bỏ qua, bị từ chối hoặc bị đọc thành tiếng.
Nhân bản thêm đầu vào người nói tham chiếu, còn tổng hợp đa ngôn ngữ thêm phạm vi ngôn ngữ. Cái này không tự động bao gồm cái kia: giọng đặt sẵn đa ngôn ngữ không nhất thiết có thể nhân bản, và giọng đã nhân bản không nhất thiết đáng tin cậy ở mọi ngôn ngữ được hỗ trợ.
Chọn hợp đồng âm thanh trước khi chọn giọng
WAV là một container; PCM mô tả một cách biểu diễn âm thanh. PCM không nén, thường được đóng gói trong WAV, thuận tiện cho việc chỉnh sửa và xử lý. Các pipeline điện thoại cần mã hóa, cấu hình kênh và tốc độ lấy mẫu mà hệ thống hạ nguồn của họ mong đợi, chứ không chỉ một tệp có phần mở rộng quen thuộc.
MP3 và Opus là các tùy chọn phân phối nén cho trình duyệt và ứng dụng, tùy thuộc vào hỗ trợ của client. Chọn định dạng mà trình phát của bạn có thể giải mã mà không cần thêm bước chuyển đổi. Nếu không, hiệu năng tổng hợp bạn đo được sẽ không mô tả độ trễ mà người dùng trải nghiệm.
Tốc độ lấy mẫu quy định tần suất lấy mẫu âm thanh. Nó ảnh hưởng đến dải tần được biểu diễn và, với âm thanh không nén khi các cài đặt khác cố định, kích thước tệp. Tăng tốc độ lấy mẫu đầu ra không sửa được cách phát âm không rõ hay khôi phục chi tiết mà model chưa từng tạo ra.
Trước khi tích hợp, hãy ghi rõ hợp đồng:
- Ràng buộc đầu vào: Độ dài văn bản được chấp nhận, markup được hỗ trợ và hành vi đầu vào tăng dần.
- Tính sẵn có của giọng: Ngôn ngữ, phương ngữ, giọng đặt sẵn và quyền truy cập giọng tùy chỉnh cần thiết.
- Yêu cầu đầu ra: Mã hóa, tốc độ lấy mẫu, kênh và hành vi streaming.
- Hành vi khi lỗi: Cách ứng dụng xử lý văn bản bị từ chối, luồng bị gián đoạn và giọng không khả dụng.
Đọc bảng từ trái sang phải: ghép đầu vào bạn có với đầu ra bạn cần, rồi kiểm tra xem trường hợp sử dụng có phù hợp không. Một giọng nghe rất hay nhưng đòi hỏi mẫu tương tác sai thì nên nằm ngoài danh sách rút gọn.
Các Họ Kiến Trúc và Ý Nghĩa của Chúng
| Họ | Cách tạo ra giọng nói | Đánh đổi chính |
|---|---|---|
| Ghép nối | Ghép các đơn vị giọng nói đã ghi âm sẵn | Tự nhiên trong phạm vi đã ghi âm, yếu kém bên ngoài phạm vi đó |
| Tham số thống kê | Dự đoán các đặc trưng âm thanh, sau đó bộ mã hóa giọng nói (vocoder) tạo ra âm thanh | Linh hoạt, nhưng thường bị bóp nghẹt |
| Dạng sóng thần kinh | Tạo ra các mẫu âm thanh bằng mạng thần kinh | Độ tự nhiên cao, nặng về tính toán nếu không được tối ưu hóa |
| Thần kinh dựa trên token | Dự đoán các mã âm thanh rời rạc từ văn bản | Mở rộng tốt với dữ liệu, cần kiểm soát cẩn thận về phong cách và người nói |
Sự khác biệt về quy trình tổng thể được minh họa dưới đây.
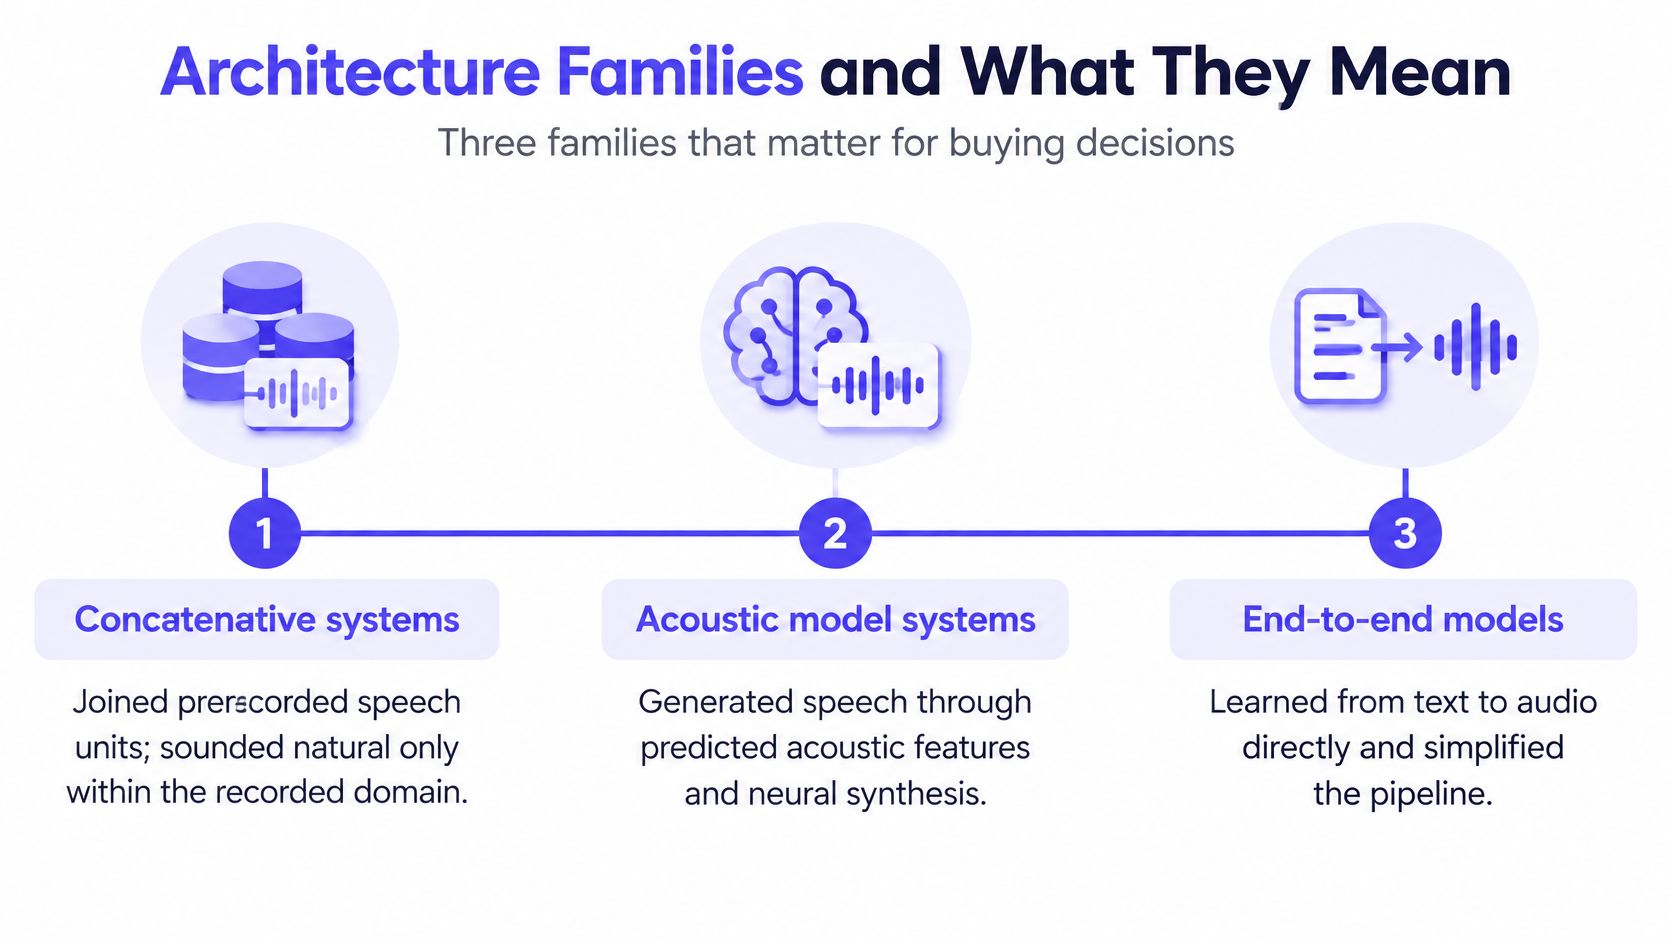
Hệ thống ghép nối tập hợp các đơn vị đã ghi âm, vì vậy tính linh hoạt của chúng bị giới hạn bởi các bản ghi có sẵn và các điểm nối giữa chúng. Thay vào đó, hệ thống tham số thống kê dự đoán các thuộc tính âm thanh, sau đó tạo ra giọng nói thông qua bộ mã hóa giọng nói (vocoder), đánh đổi việc tái sử dụng trực tiếp các bản ghi để có một quy trình tổng hợp dễ kiểm soát hơn.
Một cột mốc quan trọng đã đến với WaveNet vào năm 2016: bài báo WaveNet đã báo cáo giảm hơn 50% khoảng cách chất lượng giữa các hệ thống TTS hiện có mạnh nhất và giọng nói con người trong các đánh giá tiếng Anh Mỹ và tiếng Quan Thoại của nó. Phát hiện đó đã thiết lập tầm quan trọng của việc tạo dạng sóng thần kinh, chứ không phải là một đảm bảo hiệu suất phổ quát cho mọi mô hình thần kinh sau này.
Hệ thống thần kinh dựa trên token dự đoán các biểu diễn âm thanh rời rạc mà bộ giải mã biến thành âm thanh. Đối với các quyết định mua hàng, hãy phân biệt biểu diễn này với giao diện dịch vụ: một sản phẩm đầu cuối vẫn có thể chứa nhiều giai đoạn xử lý nội bộ.
Đọc Thẻ Mô hình như Mô tả Quy trình
Hãy tìm kiếm các chi tiết về spectrogram, vocoder, codec, audio tokens và điều kiện hóa người nói. Một giai đoạn spectrogram theo sau bởi một vocoder gợi ý một quy trình mô hình âm thanh; các mã âm thanh rời rạc gợi ý việc tạo ra dựa trên token. Các mô tả đào tạo giúp giải thích thiết kế, nhưng chúng không thay thế việc kiểm tra đầu ra.
Đối với các thiết bị bị hạn chế, hãy so sánh bộ nhớ thực tế, thời gian chạy và khả năng tương thích phần cứng thay vì giả định rằng cũ hơn có nghĩa là nhỏ hơn hoặc mới hơn có nghĩa là chỉ trên đám mây. Trong triển khai được lưu trữ, hãy kiểm tra độ trễ và các điều khiển được cung cấp thay vì suy luận chúng từ nhãn kiến trúc.
Ranh giới cũng quan trọng đối với các tác vụ liền kề. Hướng dẫn tổng hợp giọng hát giải quyết một vấn đề kiểm soát khác: ngữ điệu lời nói không thể thay thế cho thời gian và cao độ âm nhạc rõ ràng.
Quy tắc thực tế: Sử dụng kiến trúc để hiểu các hạn chế có thể xảy ra và các câu hỏi chẩn đoán hữu ích, chứ không phải để tuyên bố người chiến thắng trước khi lắng nghe.
Nhân bản giọng nói, Quy mô và Phạm vi ngôn ngữ
Nhân bản giọng nói tách biệt danh tính người nói khỏi những từ được nói. Đánh giá các khía cạnh này một cách độc lập: một đầu ra có thể giống người nói tham chiếu nhưng lại truyền tải câu nói với cảm xúc không phù hợp.
Các phương pháp nhân bản chính khác nhau ở cách chúng thiết lập danh tính đó.
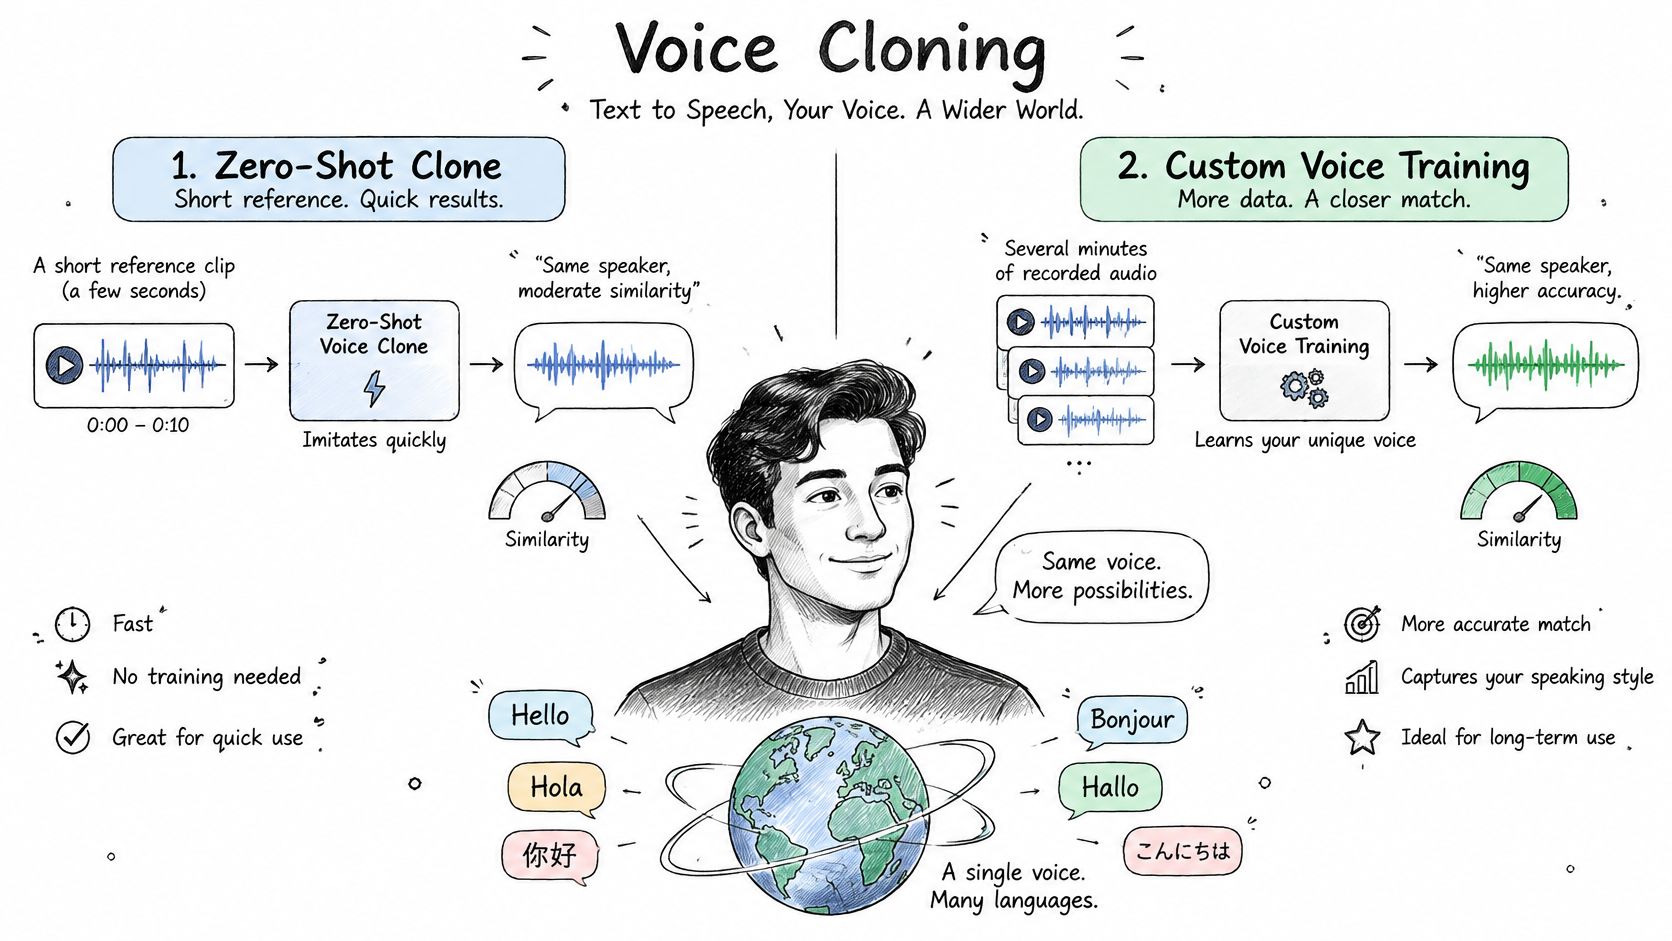
Nhân bản zero-shot điều kiện tổng hợp dựa trên âm thanh tham chiếu mà không cần một công việc đào tạo riêng biệt dành riêng cho người nói. Đào tạo giọng nói tùy chỉnh điều chỉnh một mô hình bằng cách sử dụng một tập dữ liệu người nói đã được chuẩn bị. Phương pháp trước giúp giảm công việc thiết lập; phương pháp sau bổ sung các yêu cầu về ghi âm, chuẩn bị và đào tạo, mà không tự động hóa sự tương đồng.
Chất lượng tham chiếu xứng đáng có một bài kiểm tra riêng. Tiếng ồn nền, những người nói cạnh tranh, vị trí micro không nhất quán và phong cách truyền tải khác biệt rõ rệt có thể khiến việc xác định những gì hệ thống nên giữ lại trở nên khó khăn hơn. Hãy so sánh các tham chiếu sạch trước khi đổ lỗi hoàn toàn cho mô hình tổng hợp về một kết quả yếu kém.
Tách biệt sự tương đồng khỏi hiệu suất
Hãy xem xét một so sánh giả định giữa một tham chiếu ngắn, trung tính và một tham chiếu dài hơn chứa nhiều cách truyền tải cảm xúc khác nhau. Tạo cùng một câu quảng cáo vui tươi từ mỗi tham chiếu. Hỏi người nghe một cách riêng biệt xem người nói có dễ nhận biết không và cách truyền tải vui tươi đó có phù hợp không.
Đừng cho rằng tham chiếu dài hơn nhất định sẽ thắng. Nó chứa nhiều tài liệu hơn, nhưng cũng đưa vào nhiều biến thể hơn; câu hỏi hữu ích là liệu mô hình có giữ được danh tính trong khi tuân theo hiệu suất được yêu cầu hay không.
Để có một phần giới thiệu bằng hình ảnh và âm thanh về chủ đề này, video sau đây cung cấp một định dạng xem khác.
Quy mô cung cấp ngữ cảnh, không phải sự chấp thuận cuối cùng. Trong bài đưa tin 2024 của mình, TechCrunch đã báo cáo rằng BASE-large đã sử dụng 100,000 giờ nói chuyện thuộc phạm vi công cộng để đào tạo và chứa 980 triệu tham số. Những tổng số đó không xác định được cách một giọng, người nói hoặc ngôn ngữ cụ thể sẽ hoạt động.
Khi xem xét một danh sách mô hình TTS đa ngôn ngữ, hãy biến khả năng được quảng cáo thành các kiểm tra chấp nhận cụ thể:
- Phạm vi ngôn ngữ: Đánh giá từng ngôn ngữ và phương ngữ yêu cầu với người nghe thành thạo.
- Tính ổn định của danh tính: So sánh người nói qua các câu hỏi, câu khẳng định và hội thoại biểu cảm.
- Sự sẵn sàng dự phòng: Xác định một giọng nói cài đặt sẵn được phê duyệt cho các bản sao không khả dụng hoặc không phù hợp.
- Nguồn gốc tham chiếu: Giữ lại mã định danh bản ghi và hồ sơ quyền liên quan của nó.
Một giọng nói dễ nhận biết chỉ hữu ích khi cách truyền tải của nó vẫn dễ hiểu và phù hợp trên các thông điệp thực tế của sản phẩm.
Các Chỉ Số Chất Lượng Vượt Ra Ngoài MOS
Một benchmark có thể tái tạo được nhưng không nhất thiết phải đại diện. Bộ dữ liệu LJSpeech chứa 13,100 đoạn âm thanh tổng cộng khoảng 24 giờ, được ghi âm bởi một người kể chuyện nữ nói tiếng Anh duy nhất. Điều đó hữu ích cho các so sánh có kiểm soát, nhưng thành công trong phạm vi đó không thể khẳng định hiệu suất rộng hơn trên nhiều người nói, giọng điệu hoặc phong cách trò chuyện khác nhau.
Điểm ý kiến trung bình, hay MOS, đo lường chất lượng cảm nhận được đánh giá bởi người nghe. Giữ các câu và điều kiện nghe nhất quán giữa các mô hình, giấu danh tính mô hình và xác định rõ ràng câu hỏi đánh giá. Một hội đồng được hỏi về sự dễ chịu không nhất thiết phải đánh giá xem mã sản phẩm có được nói đúng hay không.
| Chỉ số | Nó đo lường gì | Cách đo lường | Hạn chế chính |
|---|---|---|---|
| MOS | Chất lượng cảm nhận trên thang điểm nghe từ kém đến xuất sắc | Một hội đồng nghe đánh giá cùng các câu từ mỗi mô hình | Không tách biệt lỗi phát âm hoặc nhịp điệu nếu không có câu hỏi cụ thể |
| Intelligibility | Liệu người nghe có thể nhận ra các từ hay không | Chuyển đổi đầu ra bằng bộ nhận dạng giọng nói và so sánh với văn bản dự định | Lỗi của bộ nhận dạng có thể che khuất lỗi tổng hợp |
| Time to first audio | Độ trễ trước khi âm thanh khả dụng đến hoặc phát | Ghi lại thời gian gửi yêu cầu, nhận âm thanh đầu tiên và phát lại riêng biệt | Không nói lên điều gì về chất lượng giọng nói |
| Real-time factor | Thời gian tổng hợp chia cho thời lượng âm thanh | Đo thời gian tạo và chia cho thời lượng đầu ra | Thay đổi theo phần cứng, tải và giới hạn đo lường |
| Reproducibility | Tính nhất quán qua các lần chạy và phiên bản lặp lại | Cố định các cài đặt và seeds đã công bố, sau đó chạy lại và so sánh | Một số dịch vụ không công bố seeds hoặc phiên bản cố định |
Xác Định Những Gì Đồng Hồ Bấm Giờ Của Bạn Bao Gồm
Đối với streaming, hãy phân biệt âm thanh nhận được đầu tiên với âm thanh phát ra đầu tiên. Truyền tải mạng, giải mã và bộ đệm trình phát thuộc về trải nghiệm người dùng, ngay cả khi chúng xảy ra bên ngoài suy luận của mô hình. Ghi lại cả hai khi chẩn đoán độ trễ.
Để kiểm tra intelligibility, hãy so sánh giọng nói được nhận dạng với dạng nói dự định, không phải so sánh mù quáng với các ký tự đầu vào thô. Một ngày nói được chấp nhận sẽ không khớp từng ký tự với ký hiệu viết của nó. Xem xét thủ công các lỗi liên quan đến tên, số và ký hiệu trước khi coi bộ nhận dạng là sự thật tuyệt đối.
Một chất lượng trung bình là mô tả của một bài kiểm tra. Nó không phải là tiêu chí chấp nhận cho đến khi bạn xác định những lỗi mà sản phẩm có thể chấp nhận.
Kết hợp kiểm tra tự động với việc nghe. Các phép đo cao độ đơn thuần không mô tả nhịp điệu, trọng âm hoặc cường độ, và sự khác biệt về dạng sóng không nhất thiết có nghĩa là người nghe nhận thấy một thay đổi có ý nghĩa.
Báo cáo MOS, intelligibility, time to first audio và real-time factor cùng nhau. Bao gồm phiên bản mô hình, môi trường runtime, cài đặt yêu cầu và giới hạn đo lường để một kỹ sư khác có thể diễn giải kết quả.
Xây dựng Bộ Kiểm thử cho Văn bản Khó
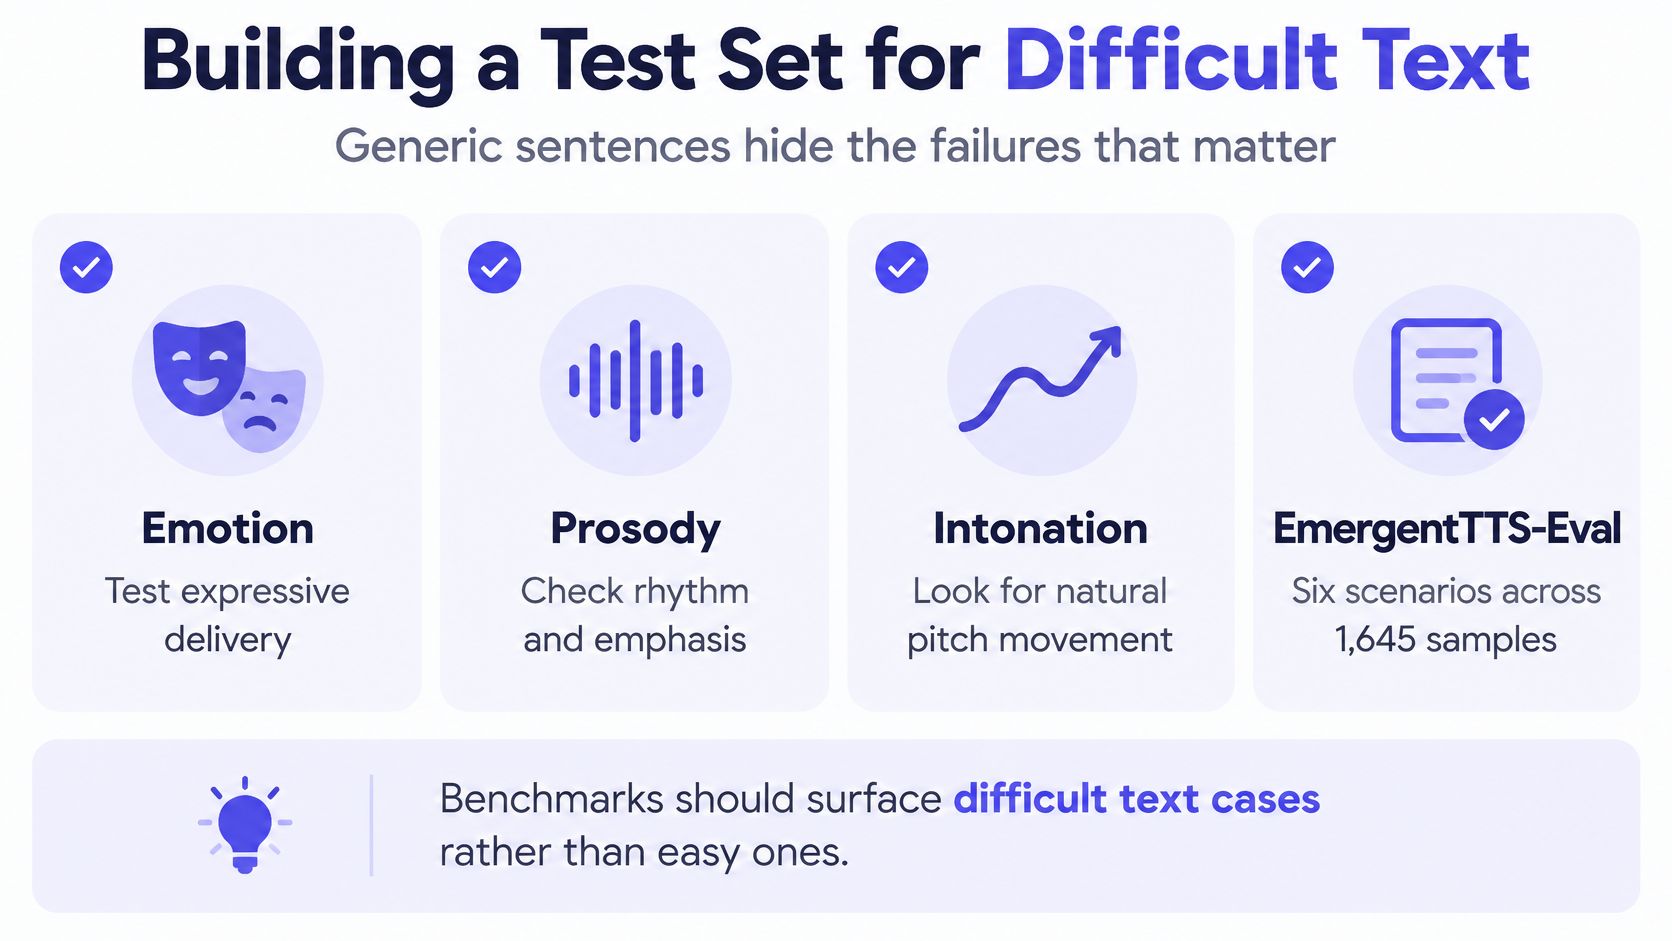
Các câu chung chung tạo ra các bài kiểm thử chấp nhận yếu vì chúng bỏ qua phần văn bản cần được diễn giải. EmergentTTS-Eval đánh giá sáu kịch bản trên 1,645 mẫu, bao gồm cảm xúc, ngữ điệu, trọng âm và cách phát âm; các tác giả của nó báo cáo mối tương quan mạnh mẽ giữa việc đánh giá dựa trên mô hình và sở thích của con người.
Hãy sử dụng cách tiếp cận rộng hơn đó mà không coi một tiêu chuẩn bên ngoài là bộ kiểm thử của sản phẩm bạn. Ứng dụng của bạn có từ vựng, định dạng và hậu quả riêng cho những lỗi sai.
Các danh mục đánh giá dưới đây giúp phơi bày những lỗi mà các đoạn văn dễ đọc sẽ không làm được.
Bao gồm Văn bản Thay đổi Ý nghĩa khi Đọc Sai
- Tên và địa điểm: Tên sản phẩm, thương hiệu, tên cá nhân, địa chỉ và mã bưu chính.
- Mã định danh nhỏ gọn: Từ viết tắt, tham chiếu tài khoản, mã sản phẩm và các từ viết tắt mơ hồ.
- Ký hiệu có cấu trúc: Ngày, giờ, URL, đoạn mã và công thức toán học.
- Thay đổi ngôn ngữ: Từ nước ngoài và các đoạn văn pha trộn ngôn ngữ.
- Ý định hội thoại: Câu hỏi, sự trấn an, sự khẩn cấp, sự bất đồng và hội thoại chứa cảm xúc.
- Tín hiệu phi ngôn ngữ: Tiếng cười, tiếng thở dài và các hướng dẫn biểu diễn được hỗ trợ khác.
Đối với mỗi mục, hãy ghi lại cách đọc dự kiến. Một đoạn mã có thể yêu cầu đánh vần từng ký tự, trong khi một từ viết tắt có thể cần phát âm như một từ. Nếu không có chú thích đó, người nghe có thể không đồng ý về độ chính xác ngay cả khi họ nghe cùng một đầu ra.
Chạy một So sánh có thể Lặp lại
- Thu thập văn bản đại diện. Trích xuất và ẩn danh các ví dụ từ sản xuất, sau đó gắn thẻ chúng theo danh mục. Bao gồm các đầu vào không phổ biến mà lỗi của chúng sẽ gây ra hậu quả nghiêm trọng.
- Tạo ra các đầu ra có thể so sánh được. Giữ định dạng, vai trò giọng nói và hướng dẫn phân phối tương đương nếu có thể. Lưu yêu cầu chính xác và mã định danh mô hình.
- Sử dụng người nghe nhất quán. Yêu cầu cùng một nhóm đánh giá riêng biệt về khả năng dễ hiểu, cách phát âm và sự phù hợp về ngữ điệu. Xáo trộn thứ tự mô hình.
- Ghi lại hiệu suất cho từng mục. Ghi lại thời gian âm thanh đầu tiên và yếu tố thời gian thực cùng với văn bản liên quan, thay vì chỉ giữ một mức trung bình theo lô.
- Lặp lại sau khi có thay đổi. Giữ một đường cơ sở đã được phê duyệt và điều tra các hồi quy khi nhà cung cấp, cấu hình giọng nói hoặc quy tắc tiền xử lý thay đổi.
Giả sử một lời nhắc hỗ trợ chứa họ của khách hàng và ngày hẹn. Một câu được truyền tải đẹp mắt nhưng sai một trong hai thông tin đó nên thua một lựa chọn thay thế ít biểu cảm hơn nhưng chính xác.
Báo cáo tỷ lệ lỗi theo danh mục và mức độ nghiêm trọng. Một điểm số tổng hợp có thể che giấu chính loại lỗi đáng lẽ phải chặn việc triển khai.
Ghép nối mô hình với trường hợp sử dụng của bạn
| Trường hợp sử dụng | Tiêu chí quan trọng nhất | Nên kiểm tra gì trước tiên |
|---|---|---|
| Lời nhắc điện thoại hỗ trợ khách hàng | Thời gian phát âm thanh đầu tiên, cách phát âm tên và mã sản phẩm | Một lời nhắc thực tế chứa tên và mã qua đường dẫn phát lại điện thoại |
| Tường thuật sách nói dài | Ngữ điệu giữa các đoạn văn, độ ổn định qua các đoạn dài | Tính nhất quán qua một đoạn văn dài với đối thoại và thay đổi cảnh |
| Khả năng tiếp cận và trình đọc màn hình | Dễ hiểu, kiểm soát tốc độ nói đáng tin cậy | Độ rõ ràng ở tốc độ nhanh nhất mà người dùng có thể chọn |
| Lồng tiếng video và truyền thông | Phạm vi cảm xúc, thời gian so với các clip tham chiếu | Sự phù hợp với độ dài và cảm xúc của clip tham chiếu |
| Giáo dục và đào tạo | Cách phát âm thuật ngữ kỹ thuật, công thức và từ nước ngoài | Công thức, từ viết tắt và tên nước ngoài từ tài liệu khóa học |
Tính năng mạnh nhất của một mô hình chỉ có ý nghĩa nếu nó hỗ trợ công việc. Bảng so sánh sau đây minh họa các ưu tiên khác nhau.
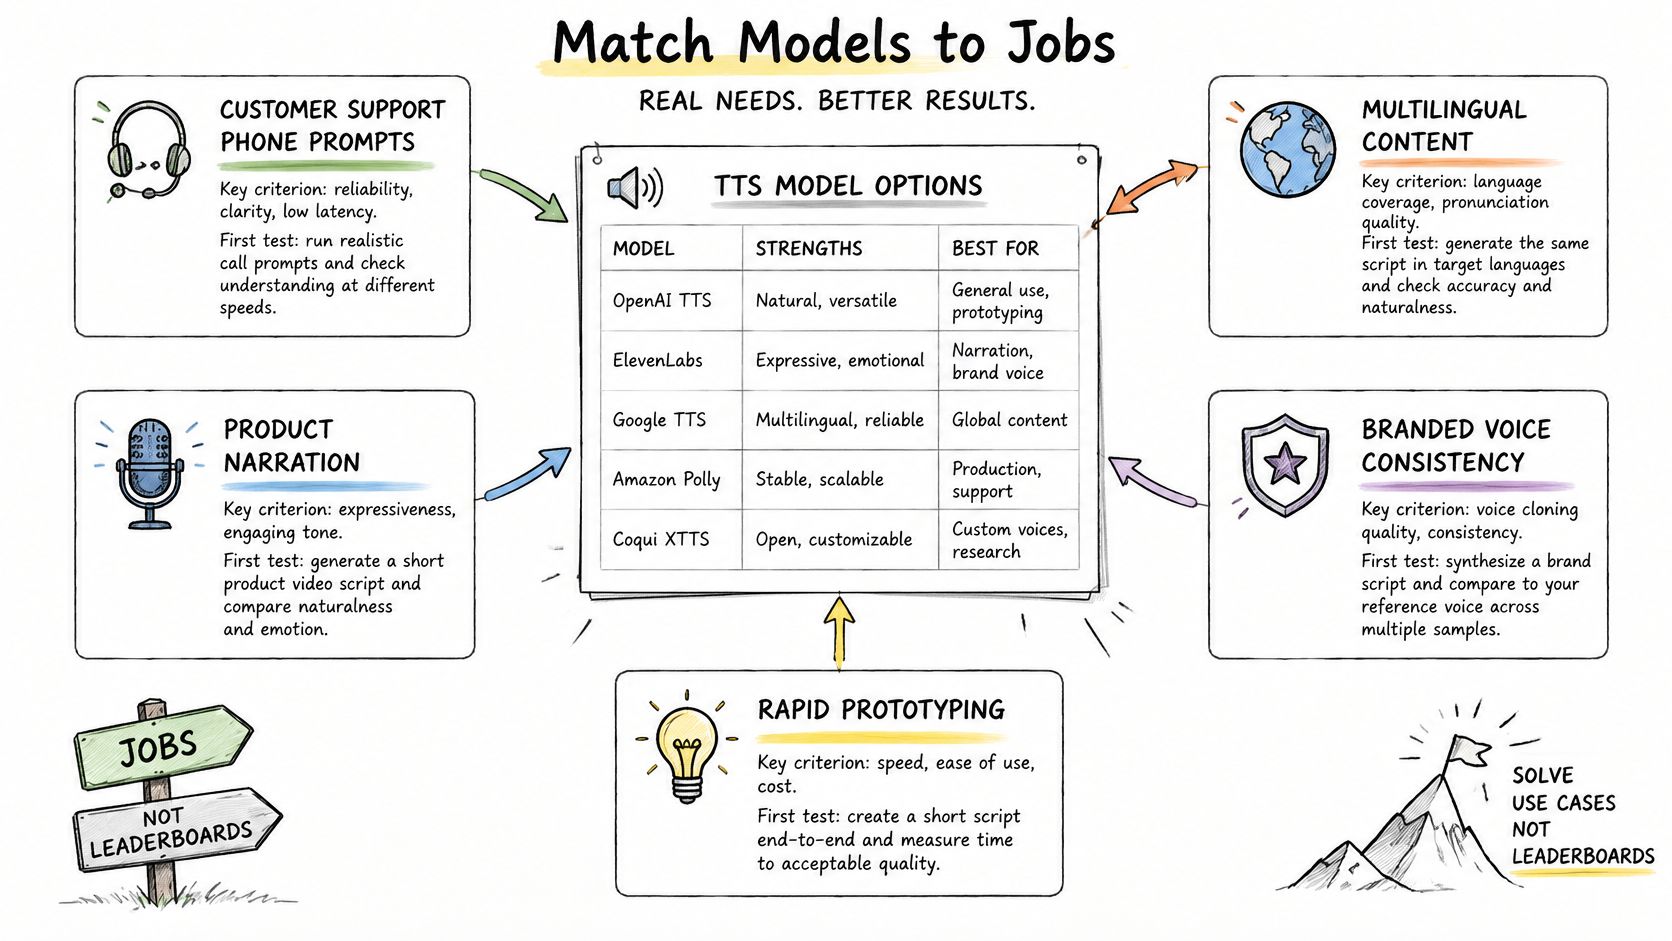
Đối với hỗ trợ khách hàng, hãy kiểm tra đường dẫn điện thoại thực tế thay vì chỉ xem xét các bản tải xuống chất lượng phòng thu. Đối với sách nói, hãy lắng nghe qua các ranh giới đoạn văn, thay đổi người nói và quá trình tạo lại, vì các câu riêng lẻ không thể hiện tính liên tục.
Đánh giá khả năng tiếp cận nên bao gồm những người sẽ sử dụng đầu ra và các điều khiển phát lại ưa thích của họ. Lồng tiếng cần một hiệu suất tham chiếu và các ràng buộc về thời gian; giáo dục cần đánh giá chuyên môn về ký hiệu nói dự kiến.
Áp dụng các ngưỡng cứng trước khi xem xét sở thích
Nếu độ trễ xác định tương tác, hãy yêu cầu một giao diện streaming phù hợp trước khi xếp hạng giọng nói. Một phản hồi bị trì hoãn có thể làm hỏng thiết kế tương tác bất kể chất lượng cuối cùng của nó.
Nếu một danh tính người nói cụ thể là bắt buộc, hãy thiết lập quyền trước khi tạo các bản sao để đánh giá. Đừng biến việc cấp phép thành mối lo ngại chỉ trong giai đoạn sản xuất sau khi nhóm đã gắn bó với một giọng nói.
Nếu mã và ngày tháng truyền tải thông điệp, hãy ưu tiên việc đọc đúng chúng hơn là sự dễ chịu. Coi các lỗi phát âm nghiêm trọng là yếu tố chặn thay vì để điểm phong cách cao bù đắp cho chúng.
Nguyên tắc lựa chọn: Xếp hạng các mô hình chấp nhận được sau khi áp dụng các yêu cầu bắt buộc. Đừng tính trung bình một lỗi không đủ điều kiện vào một điểm số hấp dẫn khác.
Hãy viết ra các ngưỡng đó trước khi xem xét kết quả. Ví dụ, một người kể chuyện khóa học có thể cần từ vựng kỹ thuật đáng tin cậy nhưng không cần streaming hội thoại, trong khi một trợ lý giọng nói có thể cần nhập văn bản tăng dần nhưng không cần nhân bản. Sự khác biệt đó thu hẹp phạm vi so sánh mà không cần dựa vào bảng xếp hạng chung.
Sự đồng ý, Tiết lộ và Sử dụng giọng nói an toàn
Nhân bản giọng nói là một quyết định quản trị, không chỉ là một cài đặt tổng hợp. Các hướng dẫn TTS có trách nhiệm mô tả việc FCC phân loại giọng nói robocall do AI tạo ra là giọng nói nhân tạo theo Đạo luật Bảo vệ Người tiêu dùng Điện thoại, khiến các cuộc gọi thuộc phạm vi điều chỉnh mà không có sự đồng ý trước theo yêu cầu là bất hợp pháp. Đừng hiểu điều đó là lệnh cấm hoàn toàn đối với lời kể tổng hợp hoặc là sự cho phép cho mọi mục đích sử dụng không phải robocall.
Lời kể tổng hợp thông thường và nhân bản giữ nguyên danh tính đòi hỏi sự xem xét vận hành khác nhau. Việc chọn một giọng nói cài đặt sẵn được cấp phép không thiết lập quyền bắt chước một người có thể nhận dạng được. Đối với giọng nói tùy chỉnh, sự cho phép của người nói được ghi lại nên là một yêu cầu triển khai.
Xây dựng các biện pháp kiểm soát vào đường dẫn yêu cầu
- Ghi lại sự cho phép của người nói: Lưu giữ mục đích được ủy quyền, các kênh được phép, phạm vi sử dụng và điều kiện hết hạn hoặc xem xét cùng với bản ghi giọng nói.
- Từ chối bắt chước trái phép: Cấm nhân bản những người có thể nhận dạng được mà không có sự cho phép bằng văn bản và cung cấp cách để tạm ngừng các giọng nói đang tranh chấp.
- Áp dụng các quy tắc tiết lộ: Gắn nhãn lời nói tổng hợp khi luật pháp hiện hành, chính sách nền tảng hoặc ngữ cảnh yêu cầu.
- Bảo toàn khả năng kiểm toán: Ghi lại mã định danh mô hình, mã định danh giọng nói, thời gian yêu cầu và tham chiếu ủy quyền mà không sao chép không cần thiết văn bản nhạy cảm.
- Duy trì các lựa chọn thay thế an toàn: Phê duyệt các giọng nói dự phòng không nhằm mục đích bắt chước các cá nhân có thể nhận dạng được.
- Lưu giữ siêu dữ liệu mô hình: Lưu trữ các nguồn dữ liệu huấn luyện đã tiết lộ, giấy phép, hạn chế sử dụng và tài liệu đánh giá liên quan.
Một bản ghi quyền cũng cần một quy trình thu hồi. Quyết định ai có thể vô hiệu hóa một giọng nói, cách xử lý âm thanh được lưu vào bộ nhớ cache và điều gì xảy ra với nội dung đã lên lịch khi quyền ủy quyền thay đổi.
Đánh giá đối tượng mà hệ thống phục vụ
Kiểm tra hiệu suất về giọng điệu, phương ngữ và ngôn ngữ một cách riêng biệt. Một mức trung bình toàn cầu có thể che giấu trải nghiệm kém cho một nhóm người nói cụ thể, vì vậy hãy giữ lại kết quả cấp nhóm khi việc thu thập và báo cáo là phù hợp.
Quản trị cũng phải tuân theo định tuyến. Nếu các yêu cầu có thể đến các nhà cung cấp khác nhau, đừng cho rằng một thỏa thuận ủy quyền giọng nói hoặc xử lý áp dụng cho mọi điểm đến. Hạn chế định tuyến đến các kết hợp mô hình, giọng nói và điều khoản xử lý đã được phê duyệt.
Đây là hướng dẫn vận hành chung, không phải lời khuyên pháp lý. Kiểm tra các luật và yêu cầu hợp đồng áp dụng cho người nói, khán giả và địa điểm triển khai trước khi phát hành.
API được host hay mô hình mở tự host
Cách triển khai quyết định bạn kiểm soát gì và phải vận hành gì. API được host chuyển việc phục vụ mô hình sang một đơn vị vận hành bên ngoài. Tự host khiến nhóm của bạn chịu trách nhiệm về runtime, công suất, cập nhật và kiểm soát truy cập.
Trọng số mở không tự động có nghĩa là được dùng thương mại không hạn chế, phù hợp chạy ngoại tuyến hay yêu cầu phần cứng thấp. Hãy kiểm tra giấy phép và yêu cầu runtime trước khi đầu tư vào tích hợp. Tương tự, một endpoint được host không tự động cung cấp phiên bản cố định hay một cách bố trí lưu trú dữ liệu cụ thể.
| Tiêu chí quyết định | API được host | Mô hình mở tự host |
|---|---|---|
| Chi phí ở mức sử dụng dự kiến | Phí sử dụng cộng chi phí tích hợp và phân phối | Compute, lưu trữ, công suất nhàn rỗi và công sức kỹ thuật |
| Độ trễ khi tải đỉnh | Bao gồm đường truyền mạng và hàng đợi phía dịch vụ | Phụ thuộc vào phần cứng được cấp phát và cách lập lịch của bạn |
| Lưu trú dữ liệu | Cần xem xét vị trí xử lý và các điều khoản | Có thể nằm trong hạ tầng bạn kiểm soát |
| Quản lý phiên bản | Phụ thuộc vào tùy chọn ghim phiên bản và cập nhật của dịch vụ | Nhóm của bạn kiểm soát các artifact và thời điểm rollout |
So sánh toàn bộ chi phí vận hành
Triển khai được host có thể phù hợp với nhu cầu thay đổi và các nhóm không muốn vận hành phần cứng suy luận. Hãy xác nhận đơn vị tính phí, giới hạn đồng thời và cách xử lý thử lại trước khi ước tính chi phí. Chỉ một mức giá theo ký tự không mô tả được toàn bộ hóa đơn ứng dụng.
Tự host có thể phù hợp với vận hành ngoại tuyến hoặc các yêu cầu cấm gửi văn bản và bản ghi tham chiếu ra ngoài hạ tầng được kiểm soát. Việc này vẫn cần lập kế hoạch công suất, giám sát, cập nhật bảo mật và một quy trình phát hành có thể tái lập. Một mô hình chạy được trên máy trạm không nhất thiết đã sẵn sàng cho lưu lượng sản xuất đồng thời.
Hãy coi danh sách mô hình Qwen TTS là điểm khám phá cho một ứng viên, không phải bằng chứng về mức độ phù hợp của nó với một cách triển khai cụ thể. Hãy xác nhận runtime, giấy phép và giao diện thực tế cho bất kỳ cách triển khai nào bạn đánh giá.
Kiểm thử đường phục vụ, không chỉ trọng số
Dùng cùng một corpus đã ẩn danh cho các ứng viên được host và tự host. Giữ định dạng phát lại và client kiểm thử nhất quán, rồi đo dưới các mẫu đồng thời và yêu cầu mà ứng dụng mong đợi.
Ghi lại xem bài kiểm thử có bao gồm khởi động, tải, xếp hàng và chuyển đổi hay không. Nếu không, một benchmark cục bộ đã warm và một yêu cầu từ xa hoàn chỉnh không thể so sánh được.
Nếu tập kiểm thử của bạn chứa thông tin cá nhân, hãy xem lại các điều khoản xử lý dữ liệu trước khi truyền nó. Xóa các định danh không cần thiết ngay cả khi đích đến đã được phê duyệt, và hạn chế quyền truy cập vào bản ghi tham chiếu một cách độc lập với văn bản ứng dụng thông thường.
Danh sách rút gọn, kiểm thử và phê duyệt
Danh sách rút gọn nên thể hiện yêu cầu, không phải độ quen thuộc thương hiệu. Giữ lại các ứng viên đáp ứng hợp đồng đầu vào, ngôn ngữ bắt buộc, ràng buộc vận hành và điều kiện ủy quyền giọng nói. Loại trừ những model không thể đáp ứng một yêu cầu cứng trước khi dành thời gian nghe chúng.
Áp dụng quy trình phát hành để lại hồ sơ quyết định có thể kiểm tra:
- Chọn các ứng viên tương thích. Ghi lại lý do từng model phù hợp với đầu vào và đầu ra yêu cầu. Tách các tính năng bắt buộc khỏi các tùy chọn để người đánh giá biết có thể đánh đổi những gì.
- Chạy và đánh giá bộ văn bản khó. Giữ lại đầu ra thô, đánh giá của người nghe và bản ghi thời gian. Điều tra các lỗi nghiêm trọng thay vì chấp nhận một điểm tổng hợp hấp dẫn.
- Phê duyệt quyền và điều khoản xử lý. Xác minh giấy phép của model, ủy quyền âm thanh tham chiếu và mục đích sử dụng của từng giọng nói tùy chỉnh. Chỉ định người phụ trách cho các điều kiện chưa được giải quyết.
- Đóng băng cấu hình đã được phê duyệt. Ghim phiên bản ở nơi được hỗ trợ, lưu cài đặt tiền xử lý và phân phối, và yêu cầu kiểm thử hồi quy khi cấu hình phục vụ thay đổi.
Tách sự tiện lợi khi tích hợp khỏi việc nghiệm thu
UberLLM cung cấp quyền truy cập vào Claude, GPT, Gemini, DeepSeek, cùng các model hình ảnh, video và âm nhạc thông qua endpoint tương thích OpenAI và Anthropic. Một API key chung và số dư trả trước hợp nhất quyền truy cập, và việc thay đổi model identifier hỗ trợ so sánh ứng viên mà không cần tích hợp nhà cung cấp riêng cho từng model; các tham số giọng nói riêng của từng model vẫn cần được kiểm tra.
Qwen3 0.6B TTS được niêm yết ở mức $0.035 mỗi 1K ký tự, so với giá niêm yết $0.0875 mỗi 1K ký tự. Xác nhận giá hiện tại trên trang niêm yết của nhà cung cấp trước khi lập ngân sách, và chỉ so sánh chi phí giữa các ứng viên đáp ứng tiêu chí nghiệm thu.
Yêu cầu quyết định phát hành có người chịu trách nhiệm được nêu tên
Giao hồ sơ phê duyệt cho một người phụ trách và lưu giữ các mẫu âm thanh đã được phê duyệt. Ghi lại các ngoại lệ một cách rõ ràng, bao gồm mọi danh mục văn bản cần tiền xử lý, giọng nói dự phòng hoặc đánh giá của con người.
Quyết định phát hành vẫn phải dễ hiểu sau khi những người chạy đánh giá chuyển sang dự án khác. Bước kiểm tra cuối cùng rất đơn giản: Model được chọn có vượt qua bài kiểm tra văn bản khó không, và hồ sơ đồng thuận có bao quát mọi giọng nói đã được nhân bản không?
UberLLM cung cấp một API hợp nhất để so sánh và tích hợp giọng nói cùng với các loại model khác. Truy cập UberLLM để xem xét các ứng viên giọng nói, sau đó chạy tên, mã và hội thoại cảm xúc đã ẩn danh của bạn qua các model đáp ứng yêu cầu đầu vào trước khi chọn cấu hình production.