Tekst-naar-spraakmodellen: Mogelijkheden en Selectiegids
Ontdek tekst-naar-spraakmodellen op basis van invoer, uitvoer, stemklonen, kwaliteitsstatistieken en toestemmingsregels, met tabellen en een selectiechecklist voor 2026.
Neurale en AI-gegenereerde stemmen waren goed voor 67.90% van de omzet van de tekst-naar-spraakmarkt in 2024, volgens het branchetrendsrapport van Sonix. Dat meet omzet, geen betrouwbaarheid. Voor een ontwikkelaar die tekst-naar-spraakmodellen kiest, is de moeilijkere vraag of een stem de namen, codes, instructies en emotionele dialoog kan overbrengen die een applicatie verstuurt.
Een prettige demo beantwoordt die vraag niet. Behandel modelselectie als een input-en-outputcontract, gevolgd door een evaluatie van productietekst. Architectuur, stemgelijkenis en gemiddelde natuurlijkheid zijn belangrijk, maar geen daarvan mag een fout overschrijven die verandert wat de luisteraar begrijpt.
Inhoudsopgave
- Mogelijkheden, Invoer en Uitvoer in één Oogopslag
- Architectuurfamilies en Wat Ze Betekenen
- Stemklonen, Schaal en Taaldekking
- Kwaliteitsstatistieken Die Verder Gaan Dan MOS
- Een Testset Bouwen voor Moeilijke Tekst
- Modellen Afstemmen op Uw Gebruiksscenario
- Toestemming, Openbaarmaking en Veilig Stemgebruik
- Gehoste API's of Zelf Gehoste Open Modellen
- Shortlist, Test en Goedkeuren
Mogelijkheden, Invoer en Uitvoer in één oogopslag
| Mogelijkheid | Typische invoer | Typische uitvoer | Gebruik het wanneer |
|---|---|---|---|
| Standaard TTS | Platte tekst | Audiobestand of stream | Je gesproken tekst nodig hebt van vaste of door de gebruiker aangeleverde tekst |
| Streaming TTS | Tekstfragmenten zoals ze worden gegenereerd | Audiofragmenten in afspeelvolgorde | Audio moet starten voordat de volledige tekst klaar is |
| Markup- of stijlgestuurde TTS | Tekst met SSML of stijltags | Audio met ingestelde pauzes, nadruk of emotie | Uitspraak en tempo moeten worden gecontroleerd |
| Stemklonen | Tekst plus referentieaudio met gedocumenteerde toestemming | Audio in de stem van de referentiespreker | Een merk- of gebruikersstem moet worden gereproduceerd |
| Meertalige TTS | Tekst in meerdere talen | Audio in elke taal, met één of meerdere stemmen | Eén product bedient gebruikers in vele talen |
Standaard TTS is het eenvoudigste contract: dien tekst in en ontvang spraak. Gebruik het voor voorbereide gesproken tekst, meldingen en passages waarvan de formulering al compleet is. Een downloadbaar bestand is geschikt voor bewerking en caching; een gestreamde respons kan wachten op het hele audiobestand voorkomen.
Streaming TTS vereist nader onderzoek. Sommige diensten streamen audio na ontvangst van een complete tekstinvoer, terwijl andere ook incrementele tekst accepteren. Als een assistent zijn antwoord geleidelijk genereert, bevestig dan dat de interface het laatste ondersteunt in plaats van aan te nemen dat streaming beide richtingen betekent.
Markup-gestuurde synthese voegt leveringsinstructies toe. SSML, uitspraakcontroles en eigen stijltags zijn niet uitwisselbaar, dus test de exacte syntaxis die uw geselecteerde model accepteert. Niet-ondersteunde instructies kunnen worden genegeerd, afgewezen of hardop worden uitgesproken.
Klonen voegt een referentiesprekerinvoer toe, terwijl meertalige synthese taaldekking toevoegt. Geen van beide omvat automatisch de ander: een meertalige vooraf ingestelde stem is niet noodzakelijkerwijs kloonbaar, en een gekloonde stem is niet noodzakelijkerwijs betrouwbaar in elke ondersteunde taal.
Kies het Audiocontract Vóór de Stem
WAV is een container; PCM beschrijft een audioweergave. Ongecomprimeerde PCM, vaak verpakt in WAV, is handig voor bewerking en verwerking. Telefonie-pipelines hebben de codering, kanaalconfiguratie en sample rate nodig die hun downstream-systemen verwachten, niet alleen een bestand met een bekende extensie.
MP3 en Opus zijn gecomprimeerde leveringsopties voor browsers en applicaties, afhankelijk van clientondersteuning. Selecteer een formaat dat uw speler kan decoderen zonder een extra conversiestap. Anders zal uw gemeten syntheseprestatie de vertraging die gebruikers ervaren niet beschrijven.
Sample rate specificeert hoe vaak audio wordt bemonsterd. Het beïnvloedt het weergegeven frequentiebereik en, voor ongecomprimeerde audio met andere vaste instellingen, de bestandsgrootte. Het verhogen van de output sample rate herstelt geen onduidelijke uitspraak of herstelt geen details die het model nooit heeft gegenereerd.
Schrijf vóór de integratie het contract op:
- Invoerbeperkingen: Geaccepteerde tekstlengte, ondersteunde markup en incrementeel invoergedrag.
- Beschikbaarheid van stemmen: Vereiste talen, dialecten, vooraf ingestelde stemmen en toegang tot aangepaste stemmen.
- Uitvoervereisten: Codering, sample rate, kanalen en streaminggedrag.
- Foutgedrag: Hoe de applicatie omgaat met afgewezen tekst, onderbroken streams en niet-beschikbare stemmen.
Lees de tabel van links naar rechts: match de invoer die u heeft met de uitvoer die u nodig heeft, en controleer vervolgens of de use case past. Een stem die uitstekend klinkt maar het verkeerde interactiepatroon vereist, hoort niet op de shortlist.
Architectuurfamilies en wat ze betekenen
| Familie | Hoe het spraak genereert | Belangrijkste afweging |
|---|---|---|
| Concatenatief | Voegt vooraf opgenomen spraakeenheden samen | Natuurlijk binnen het opgenomen domein, zwak daarbuiten |
| Statistisch parametrisch | Voorspelt akoestische kenmerken, waarna een vocoder audio rendert | Flexibel, maar vaak gedempt |
| Neurale golfvorm | Genereert audiosamples met een neuraal netwerk | Hoge natuurlijkheid, computationeel zwaar zonder optimalisatie |
| Token-gebaseerd neuraal | Voorspelt discrete audiocodes uit tekst | Schaalt goed met data, vereist zorgvuldige controle over stijl en spreker |
De brede pijplijnonderscheidingen worden hieronder geïllustreerd.
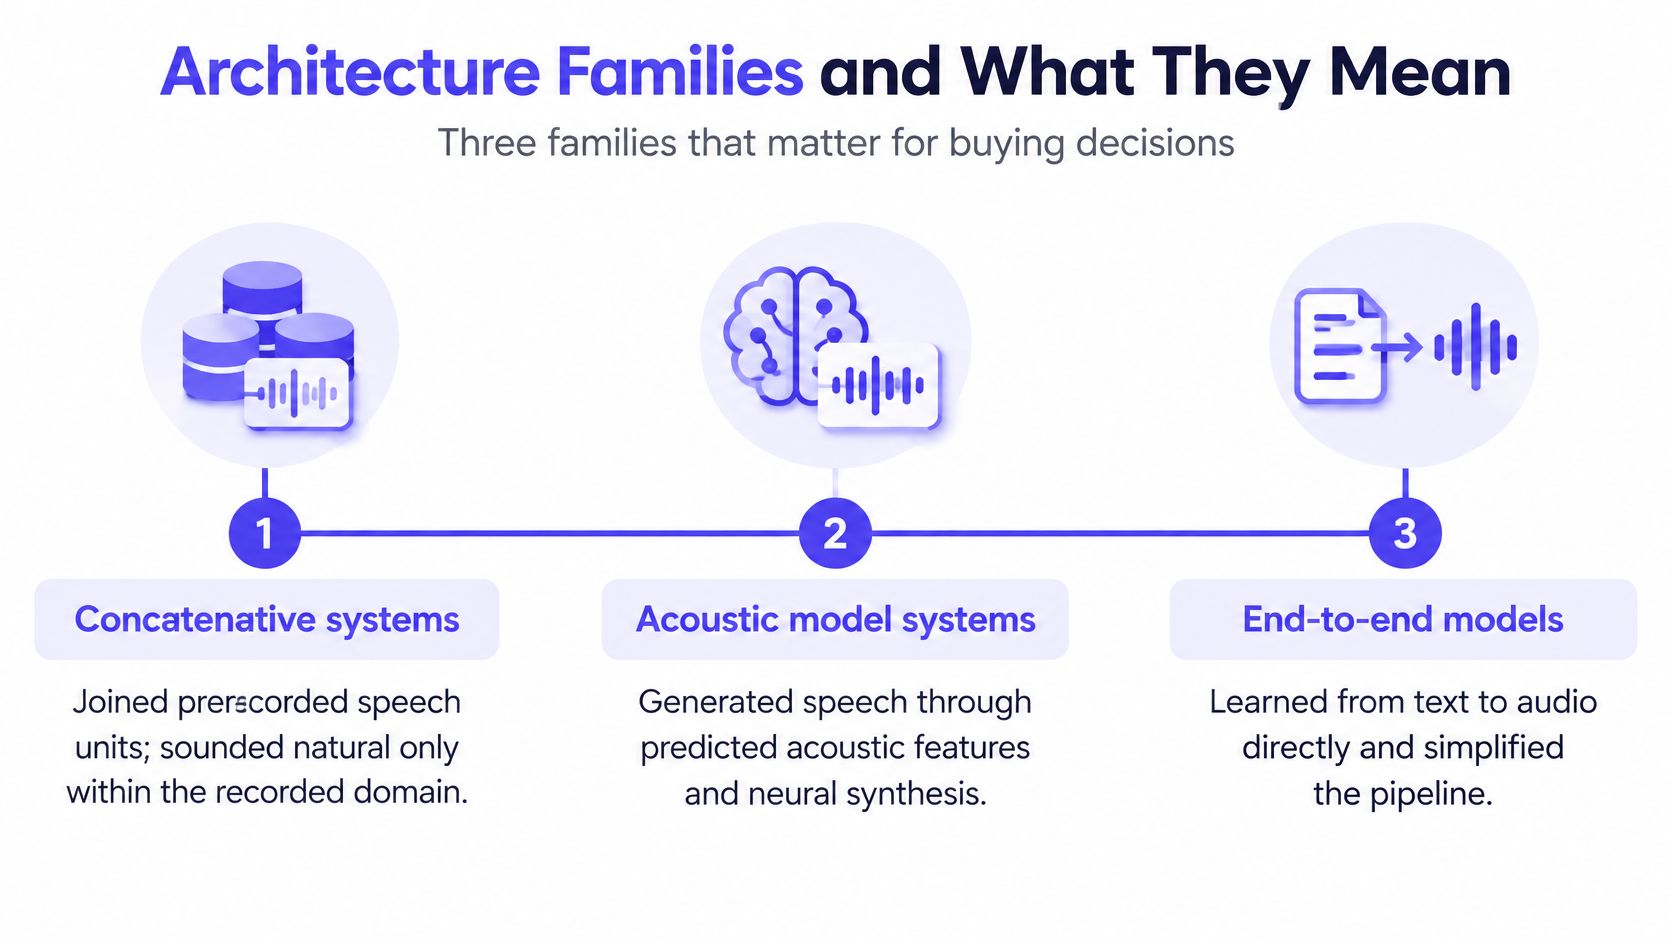
Concatenatieve systemen assembleren opgenomen eenheden, dus hun flexibiliteit wordt begrensd door de beschikbare opnamen en de verbindingen daartussen. Statistische parametrische systemen voorspellen in plaats daarvan akoestische eigenschappen en renderen vervolgens spraak via een vocoder, waarbij direct hergebruik van opnamen wordt ingeruild voor een beter beheersbare synthesepijplijn.
Een mijlpaal werd bereikt met WaveNet in 2016: het WaveNet-paper rapporteerde een vermindering van meer dan 50% in het kwaliteitsverschil tussen de sterkste bestaande TTS-systemen en menselijke spraak in zijn Amerikaanse Engelse en Mandarijn Chinese evaluaties. Die bevinding bevestigde het belang van neurale golfvormgeneratie, niet een universele prestatiegarantie voor elk later neuraal model.
Token-gebaseerde neurale systemen voorspellen discrete audioweergaven die een decoder omzet in geluid. Voor aankoopbeslissingen, onderscheid deze weergave van de service-interface: een end-to-end product kan nog steeds verschillende interne verwerkingsstadia bevatten.
Lees Modelkaarten als Pijplijnbeschrijvingen
Zoek naar spectrogram, vocoder, codec, audio tokens en details over sprekerconditionering. Een spectrogramfase gevolgd door een vocoder suggereert een akoestisch-modelpijplijn; discrete audiocodes suggereren token-gebaseerde generatie. Trainingsbeschrijvingen helpen het ontwerp te verklaren, maar ze vervangen geen outputtests.
Voor beperkte apparaten, vergelijk het daadwerkelijke geheugen, de runtime en hardwarecompatibiliteit in plaats van aan te nemen dat ouder kleiner betekent of nieuwer alleen cloud. Bij gehoste implementatie, inspecteer de geleverde latency en controles in plaats van deze af te leiden uit het architectuurlabel.
De grens is ook van belang voor aangrenzende taken. Een gids voor zangstem-synthese behandelt een ander controleprobleem: gesproken prosodie is geen vervanging voor expliciete muzikale timing en toonhoogte.
Praktische regel: Gebruik architectuur om waarschijnlijke beperkingen en nuttige diagnostische vragen te begrijpen, niet om een winnaar uit te roepen voordat je luistert.
Stemklonen, Schaal en Taaldekking
Stemklonen scheidt de identiteit van de spreker van de gesproken woorden. Evalueer die dimensies onafhankelijk: een output kan lijken op de referentiespreker terwijl de zin wordt uitgesproken met ongeschikte emotie.
De belangrijkste kloonmethoden verschillen in hoe ze die identiteit vaststellen.
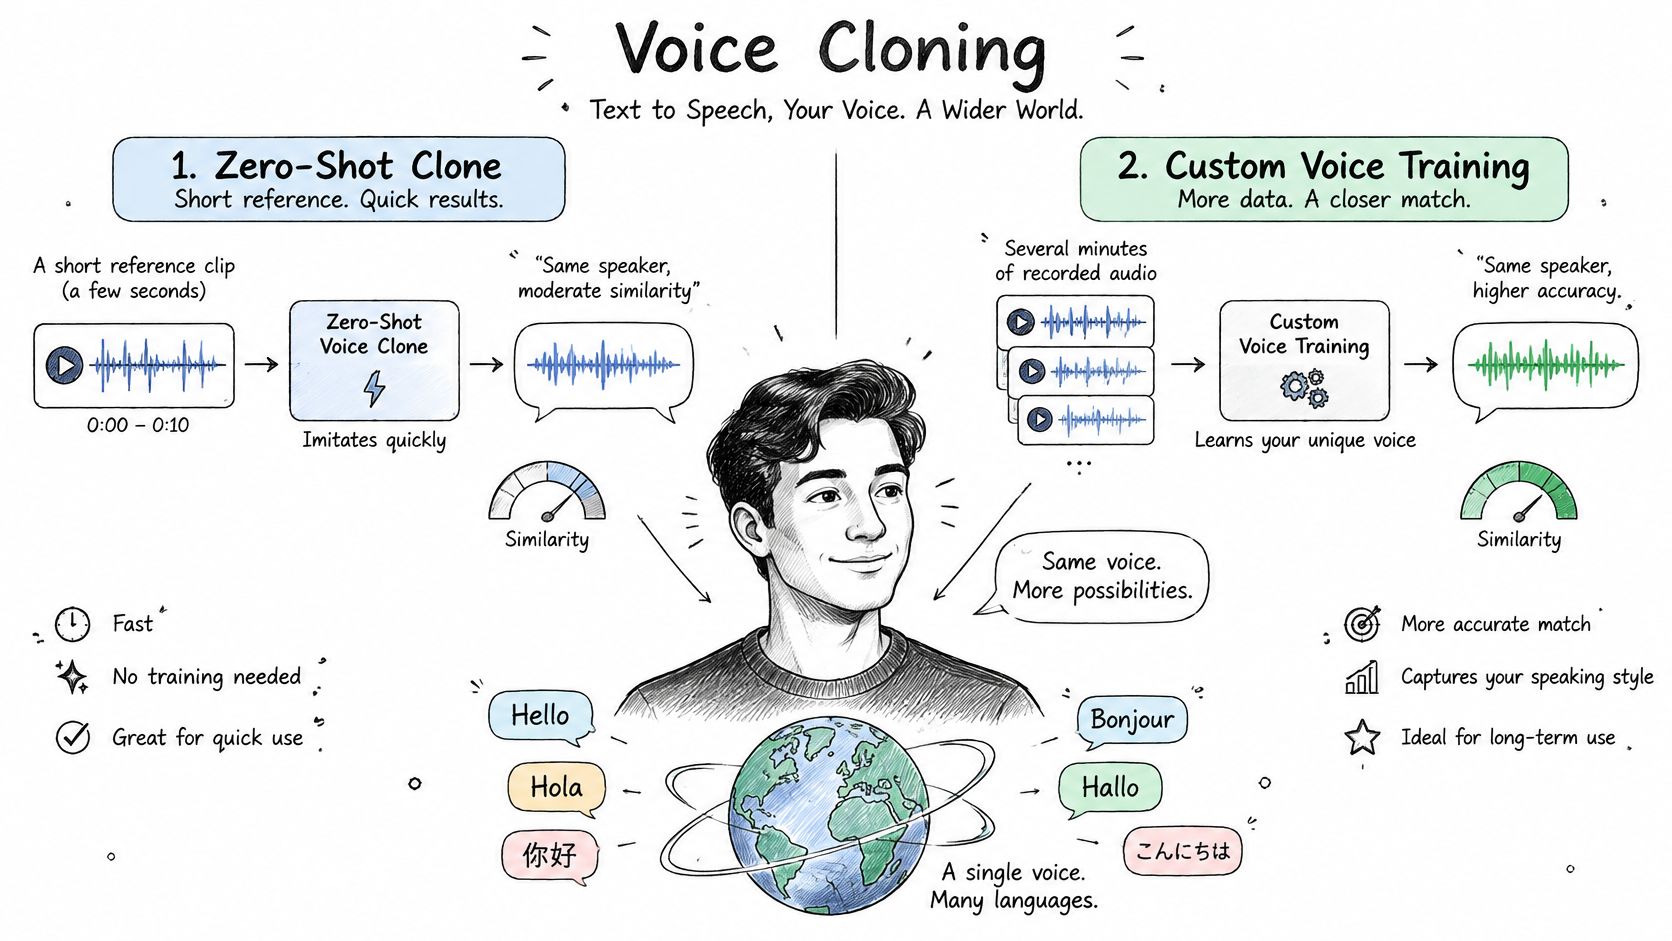
Zero-shot klonen conditioneert de synthese op referentieaudio zonder een aparte sprekerspecifieke trainingstaak. Aangepaste stemtraining past een model aan met behulp van een voorbereide sprekersdataset. De eerste vermindert het instelwerk; de laatste voegt opname-, voorbereidings- en trainingsvereisten toe, zonder dat gelijkenis automatisch wordt.
Referentiekwaliteit verdient een eigen test. Achtergrondgeluid, concurrerende sprekers, inconsistente microfoonplaatsing en scherp verschillende spreekstijlen kunnen het moeilijker maken om te bepalen wat het systeem moet behouden. Vergelijk schone referenties voordat u een zwak resultaat volledig toeschrijft aan het synthesesmodel.
Scheid Gelijkenis van Prestatie
Overweeg een hypothetische vergelijking tussen een korte, neutrale referentie en een langere referentie die verschillende emotionele uitingen bevat. Genereer dezelfde vrolijke marketingzin uit elk. Vraag luisteraars afzonderlijk of de spreker herkenbaar klinkt en of de vrolijke levering passend klinkt.
Ga er niet van uit dat de langere referentie moet winnen. Het bevat meer materiaal, maar introduceert ook meer variatie; de nuttige vraag is of het model de identiteit behoudt terwijl het de gevraagde prestatie volgt.
Voor een audiovisuele introductie tot het onderwerp, biedt de volgende video een ander kijkformaat.
Schaal biedt context, geen goedkeuring. In zijn 2024 verslaggeving, TechCrunch meldde dat BASE-large 100,000 uur aan spraak uit het publieke domein gebruikte voor training en 980 miljoen parameters bevatte. Die totalen bepalen niet hoe een bepaald accent, spreker of taal zal presteren.
Bij het onderzoeken van een lijst met meertalige TTS-modellen, zet de geadverteerde functionaliteit om in concrete acceptatiecontroles:
- Taaldekking: Evalueer elke vereiste taal en elk dialect met vloeiende luisteraars.
- Identiteitsstabiliteit: Vergelijk de spreker over vragen, beweringen en expressieve dialoog.
- Fallback-gereedheid: Identificeer een goedgekeurde vooraf ingestelde stem voor niet-beschikbare of ongeschikte klonen.
- Referentieherkomst: Bewaar de opname-identificatie en het bijbehorende toestemmingsrecord.
Een herkenbare stem is alleen nuttig wanneer de levering ervan begrijpelijk en passend blijft voor de daadwerkelijke berichten van het product.
Kwaliteitsstatistieken die verder gaan dan MOS
Een benchmark kan reproduceerbaar zijn zonder representatief te zijn. De LJSpeech dataset bevat 13,100 fragmenten van in totaal ongeveer 24 uur, opgenomen door één Engelstalige vrouwelijke spreker. Dat is nuttig voor gecontroleerde vergelijkingen, maar succes binnen die reikwijdte zegt niets over bredere prestaties bij verschillende sprekers, accenten of gespreksstijlen.
Mean Opinion Score, of MOS, meet de door luisteraars beoordeelde waargenomen kwaliteit. Houd de zinnen en luisteromstandigheden consistent voor alle modellen, verberg de modelidentiteiten en definieer de beoordelingsvraag duidelijk. Een panel dat wordt gevraagd naar aangenaamheid, evalueert niet noodzakelijkerwijs of een productcode correct is uitgesproken.
| Metriek | Wat het meet | Hoe het te meten | Belangrijkste beperking |
|---|---|---|---|
| MOS | Waargenomen kwaliteit op een luistersschaal van slecht tot uitstekend | Een luisterpanel beoordeelt dezelfde zinnen van elk model | Isoleert geen uitspraak- of ritmefouten zonder gerichte vragen |
| Intelligibility | Of luisteraars de woorden kunnen herkennen | Transcribeer output met een speech recognizer en vergelijk met de bedoelde tekst | Recognizer errors kunnen synthesis errors verhullen |
| Time to first audio | Vertraging voordat bruikbare audio arriveert of afspeelt | Timestamp request submission, first audio receipt en playback afzonderlijk | Zegt niets over spraakkwaliteit |
| Real-time factor | Synthesis time gedeeld door audio duration | Time generation en deel door output duration | Verandert met hardware, load en measurement boundaries |
| Reproducibility | Consistentie bij herhaalde runs en versies | Fix exposed settings en seeds, voer dan opnieuw uit en vergelijk | Sommige services expose geen seeds of version pins |
Definieer wat uw stopwatch omvat
Voor streaming, onderscheid first received audio van first audible playback. Netwerkoverdracht, decoding en player buffering behoren tot de gebruikerservaring, zelfs als ze buiten model inference plaatsvinden. Registreer beide bij het diagnosticeren van vertraging.
Voor intelligibility testing, vergelijk herkende spraak met de bedoelde gesproken vorm, niet blindelings met ruwe invoertekens. Een acceptabele gesproken datum komt niet teken voor teken overeen met de geschreven notatie. Controleer handmatig fouten met namen, nummers en symbolen voordat u de recognizer als ground truth beschouwt.
Een kwaliteitsgemiddelde is een beschrijving van een test. Het is geen acceptatiecriterium totdat u definieert welke fouten het product kan tolereren.
Combineer geautomatiseerde controles met luisteren. Alleen toonhoogtemetingen beschrijven geen ritme, klemtoon of intensiteit, en golfvormverschillen betekenen niet noodzakelijkerwijs dat luisteraars een betekenisvolle verandering horen.
Rapporteer MOS, intelligibility, time to first audio en real-time factor samen. Vermeld de modelversie, runtime environment, request settings en measurement boundaries, zodat een andere engineer het resultaat kan interpreteren.
Een testset bouwen voor moeilijke tekst
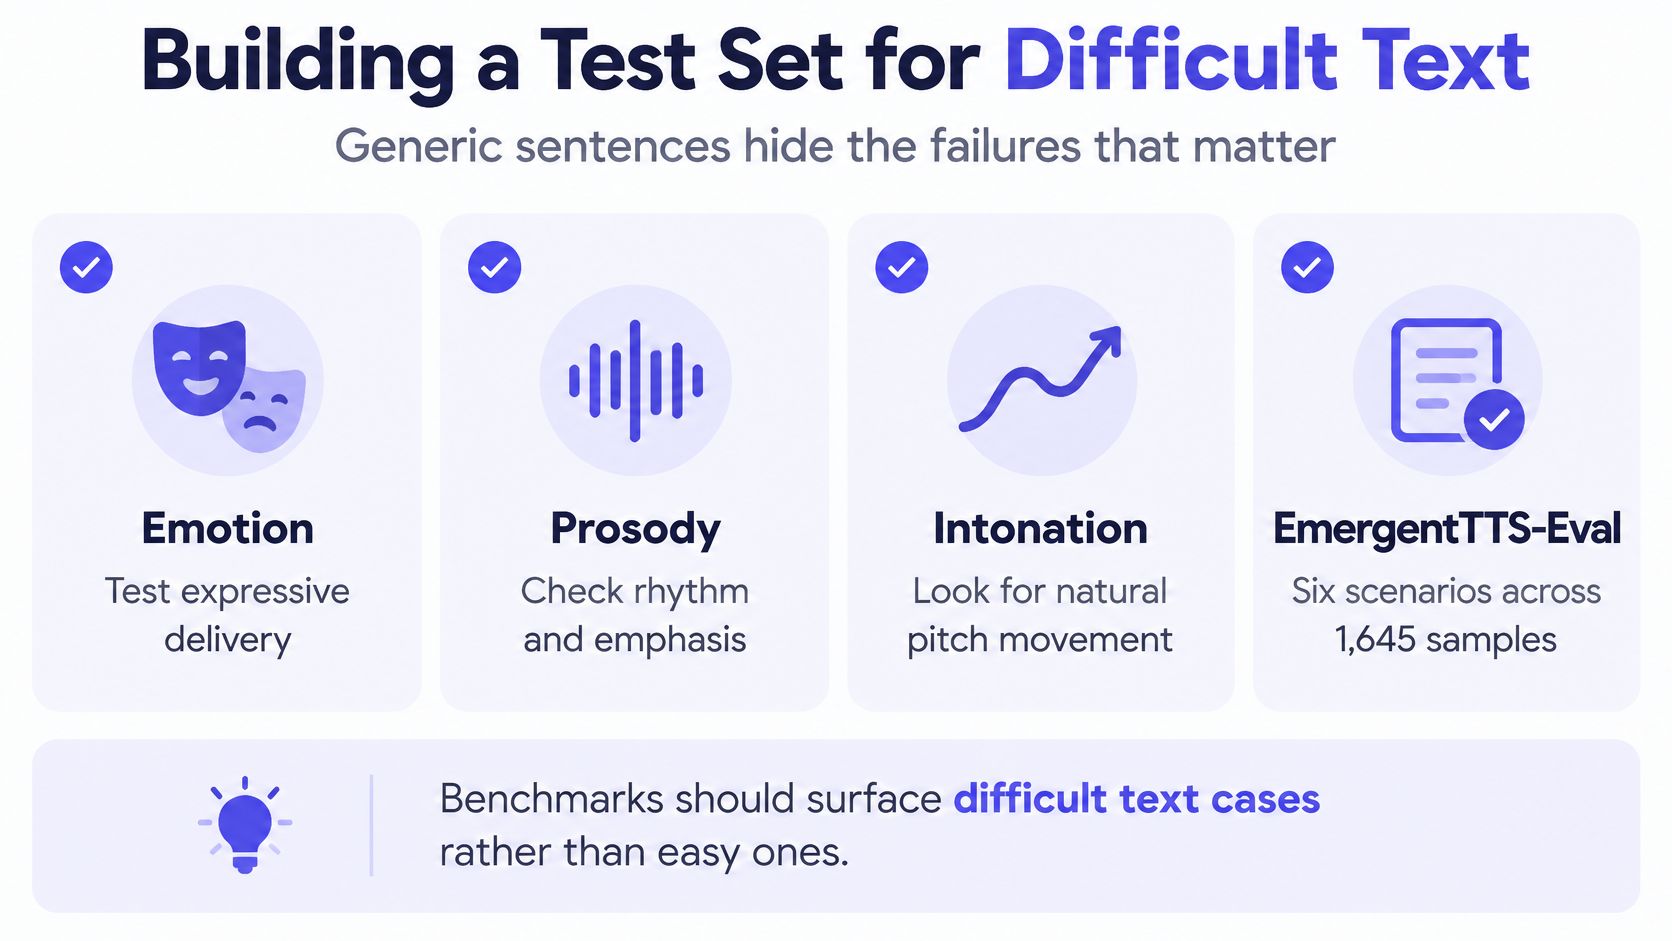
Generieke zinnen maken zwakke acceptatietests omdat ze de tekst weglaten die interpretatie vereist. EmergentTTS-Eval evalueert zes scenario's over 1,645 voorbeelden, die emotie, prosodie, intonatie en uitspraak bestrijken; de auteurs rapporteren een sterke correlatie tussen modelgebaseerde beoordeling en menselijke voorkeuren.
Gebruik die bredere aanpak zonder een externe benchmark te beschouwen als de testsuite van uw product. Uw applicatie heeft zijn eigen vocabulaire, opmaak en gevolgen voor fouten.
De onderstaande evaluatiecategorieën helpen fouten bloot te leggen die gemakkelijke leespassages niet zullen aantonen.
Neem tekst op die van betekenis verandert wanneer deze verkeerd wordt gelezen
- Namen en locaties: Productnamen, merken, persoonsnamen, adressen en postcodes.
- Compacte identificatoren: Acroniemen, accountreferenties, productcodes en ambigue afkortingen.
- Gestructureerde notatie: Datums, tijden, URLs, codefragmenten en wiskundige formules.
- Taalwisselingen: Vreemde woorden en passages in gemengde talen.
- Gespreksintentie: Vragen, geruststelling, urgentie, onenigheid en emotioneel geladen dialoog.
- Niet-spraak cues: Gelach, zuchten en andere ondersteunde uitvoeringsinstructies.
Noteer voor elk item de beoogde lezing. Een code vereist mogelijk letter-voor-letter spelling, terwijl een acroniem mogelijk uitspraak als een woord nodig heeft. Zonder die annotatie kunnen luisteraars het oneens zijn over de correctheid, zelfs wanneer ze dezelfde uitvoer horen.
Voer een herhaalbare vergelijking uit
- Verzamel representatieve tekst. Extraheer en anonimiseer productievoorbeelden en tag ze vervolgens per categorie. Voeg ongebruikelijke inputs toe waarvan het falen ernstige gevolgen zou hebben.
- Genereer vergelijkbare outputs. Houd formaat, stemrol en leveringsinstructies waar mogelijk equivalent. Sla de exacte aanvraag en model-ID op.
- Gebruik consistente luisteraars. Vraag hetzelfde panel om verstaanbaarheid, uitspraak en prosodische geschiktheid afzonderlijk te beoordelen. Schud de modelvolgorde.
- Leg prestaties per item vast. Registreer de timing van de eerste audio en de real-time factor naast de bijbehorende tekst, in plaats van alleen een batchgemiddelde te bewaren.
- Herhaal na wijzigingen. Bewaar een goedgekeurde basislijn en onderzoek regressies wanneer een provider, stemconfiguratie of voorverwerkingsregel verandert.
Stel dat een ondersteuningsprompt de achternaam van een klant en een afspraakdatum bevat. Een prachtig geleverde zin die een van beide fout heeft, zou moeten verliezen van een minder expressief maar nauwkeurig alternatief.
Rapporteer faalpercentages per categorie en ernst. Een geaggregeerde score kan precies de foutklasse verbergen die de implementatie zou moeten blokkeren.
Modellen afstemmen op uw gebruiksscenario
| Gebruiksscenario | Belangrijkste criteria | Wat u eerst moet testen |
|---|---|---|
| Telefoonprompts voor klantenservice | Tijd tot eerste audio, uitspraak van namen en productcodes | Een realistische prompt met een naam en code via het telefoonafspeelpad |
| Lange audioboekvertelling | Prosodie over paragrafen heen, stabiliteit over lange passages | Consistentie over een langere passage met dialoog en scèneveranderingen |
| Toegankelijkheid en schermlezers | Verstaanbaarheid, betrouwbare spraaksnelheidsregeling | Duidelijkheid bij de snelste snelheid die gebruikers waarschijnlijk zullen kiezen |
| Videodubbing en media | Emotioneel bereik, timing ten opzichte van referentieclips | Afstemming op de lengte en emotie van de referentieclip |
| Onderwijs en training | Uitspraak van technische termen, formules en vreemde woorden | Formules, acroniemen en buitenlandse namen uit het cursusmateriaal |
De sterkste eigenschap van een model is alleen relevant als het de taak ondersteunt. De volgende vergelijking illustreert de verschillende prioriteiten.
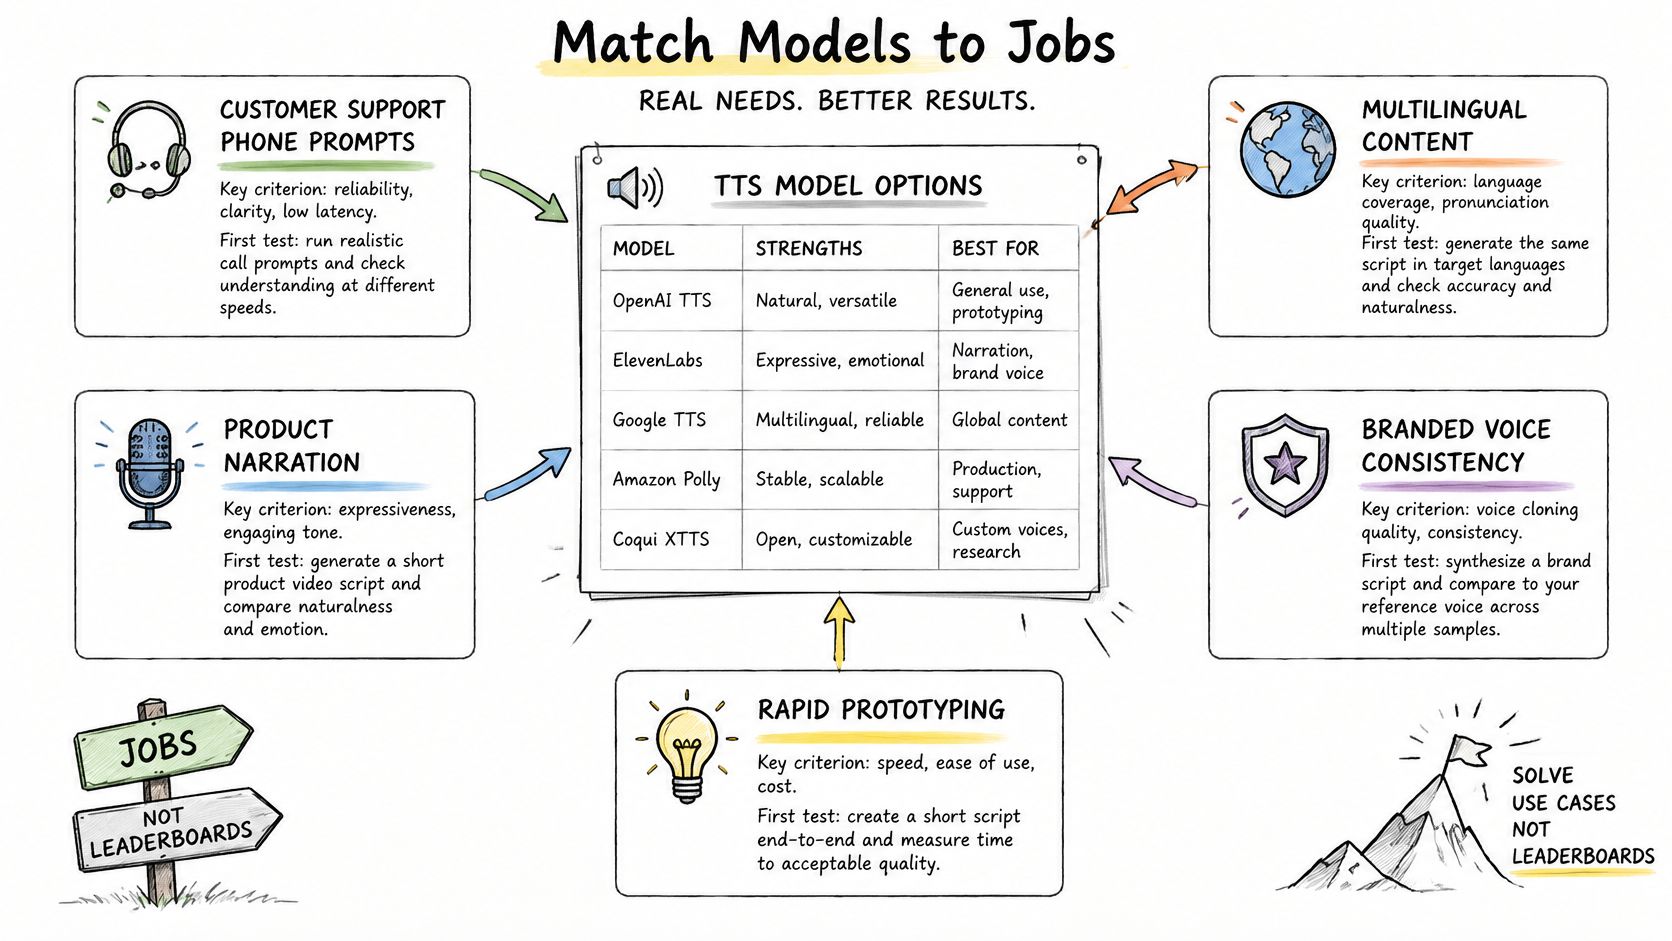
Voor klantenservice test u het daadwerkelijke telefoonpad in plaats van alleen downloads van studiokwaliteit te beoordelen. Voor audioboeken luistert u over paragraafgrenzen, sprekerswisselingen en hervatte generatie heen, omdat geïsoleerde zinnen de continuïteit niet testen.
Toegankelijkheidsbeoordeling moet de mensen omvatten die de uitvoer zullen gebruiken en hun voorkeursafspeelbediening. Dubbing vereist een referentieprestatie en timingbeperkingen; onderwijs vereist een inhoudelijke beoordeling van de beoogde gesproken notatie.
Pas harde drempels toe vóór voorkeuren
Als latentie de interactie definieert, vereis dan een geschikte streaming-interface voordat u stemmen rangschikt. Een vertraagde reactie kan het interactieontwerp doen mislukken, ongeacht de uiteindelijke kwaliteit.
Als een specifieke sprekersidentiteit verplicht is, verkrijg dan toestemming voordat u evaluatieklonen maakt. Maak autorisatie geen zorg die alleen voor productie geldt nadat het team gehecht is geraakt aan een stem.
Als codes en datums de boodschap overbrengen, geef dan prioriteit aan hun correcte uitspraak boven aangenaamheid. Behandel kritieke uitspraakfouten als blokkades in plaats van sterke stijlscores deze te laten compenseren.
Selectieprincipe: Rangschik acceptabele modellen na het toepassen van strikte eisen. Middel een diskwalificerende mislukking niet uit in een anderszins aantrekkelijke score.
Schrijf die drempels op voordat u de resultaten beoordeelt. Een cursusverteller heeft bijvoorbeeld betrouwbare technische woordenschat nodig, maar geen conversationele streaming, terwijl een stemassistent incrementele tekstinvoer nodig heeft, maar geen klonen. Dat onderscheid versmalt de vergelijking zonder te vertrouwen op een universeel klassement.
Toestemming, Openbaarmaking en Veilig Stemgebruik
Stemklonen is een bestuursbeslissing, niet slechts een synthese-instelling. De richtlijnen voor verantwoordelijke TTS beschrijven de classificatie van door AI gegenereerde robocall-stemmen door de FCC als kunstmatige stemmen onder de Telephone Consumer Protection Act, waardoor gedekte oproepen zonder de vereiste voorafgaande toestemming onwettig zijn. Interpreteer dit niet als een algemeen verbod op synthetische narratie of als toestemming voor elk niet-robocall gebruik.
Gewone synthetische narratie en identiteitsbehoudende klonen vereisen verschillende operationele controle. Het selecteren van een gelicentieerde vooraf ingestelde stem geeft geen recht om een identificeerbaar persoon na te bootsen. Voor aangepaste stemmen moet gedocumenteerde toestemming van de spreker een implementatievereiste zijn.
Bouw controles in het aanvraagpad
- Leg toestemming van de spreker vast: Bewaar het geautoriseerde doel, toegestane kanalen, gebruiksgebied en verval- of beoordelingsvoorwaarden bij de stemopname.
- Wijs ongeoorloofde imitatie af: Verbied het klonen van identificeerbare personen zonder schriftelijke toestemming en bied een manier om betwiste stemmen op te schorten.
- Pas openbaarmakingsregels toe: Label synthetische spraak wanneer toepasselijke wetgeving, platformbeleid of de context dit vereist.
- Behoud controleerbaarheid: Log de model-ID, stem-ID, aanvraagtijd en autorisatiereferentie zonder onnodig gevoelige tekst te dupliceren.
- Handhaaf veilige alternatieven: Keur terugvalstemmen goed die niet bedoeld zijn om identificeerbare personen na te bootsen.
- Bewaar modelmetadata: Sla openbaar gemaakte trainingsgegevensbronnen, licenties, gebruiksbeperkingen en relevante evaluatiedocumentatie op.
Een toestemmingsrecord heeft ook een intrekkingsproces nodig. Bepaal wie een stem kan uitschakelen, hoe met gecachte audio wordt omgegaan en wat er gebeurt met geplande inhoud wanneer de autorisatie verandert.
Evalueer wie het systeem bedient
Test accent-, dialect- en taalprestaties afzonderlijk. Een wereldwijd gemiddelde kan een slechte ervaring voor een specifieke sprekersgroep verbergen, dus bewaar resultaten op groepsniveau waar verzameling en rapportage passend zijn.
Bestuur moet ook de routering volgen. Als aanvragen verschillende providers kunnen bereiken, ga er dan niet van uit dat een stemautorisatie of verwerkingsovereenkomst van toepassing is op elke bestemming. Beperk routering tot goedgekeurde combinaties van model, stem en verwerkingsvoorwaarden.
Dit is algemene operationele richtlijnen, geen juridisch advies. Controleer de wetten en contractuele vereisten die van toepassing zijn op de spreker, het publiek en de implementatielocatie vóór de release.
Gehoste API's of Zelf-gehoste Open Modellen
De implementatie bepaalt wat je beheert en wat je moet uitvoeren. Een gehoste API verplaatst het aanbieden van modellen naar een externe operator. Zelf-hosten geeft je team de verantwoordelijkheid voor de runtime, capaciteit, updates en toegangscontroles.
Open weights betekenen niet automatisch onbeperkt commercieel gebruik, offline geschiktheid of lage hardwarevereisten. Controleer de licentie- en runtimevereisten voordat je investeert in integratie. Evenzo biedt een gehoste endpoint niet automatisch vaste versies of een specifieke data-residency regeling.
| Beslissingscriterium | Gehoste API | Zelf-gehost open model |
|---|---|---|
| Kosten bij verwacht volume | Gebruikskosten plus integratie- en leveringskosten | Compute, storage, ongebruikte capaciteit en engineering-inspanning |
| Latentie onder piekbelasting | Inclusief netwerkpad en queuing aan de servicekant | Afhankelijk van de geleverde hardware en je planning |
| Data residency | Vereist beoordeling van verwerkingslocaties en voorwaarden | Kan binnen de infrastructuur blijven die je beheert |
| Versiebeheer | Onderhevig aan de pinning- en update-opties van de service | Je team beheert artefacten en uitroltiming |
Vergelijk de Totale Operationele Kosten
Gehoste implementatie kan geschikt zijn voor variabele vraag en teams die geen inference hardware willen bedienen. Bevestig de factureringseenheid, concurrency limits en hoe retries worden afgehandeld voordat je de kosten schat. Een prijs op basis van tekens alleen beschrijft niet de volledige applicatiefactuur.
Zelf-hosten kan geschikt zijn voor offline gebruik of vereisten die het verzenden van tekst en referentieopnames buiten gecontroleerde infrastructuur verbieden. Het vereist nog steeds capaciteitsplanning, monitoring, beveiligingsupdates en een reproduceerbaar releaseproces. Een model dat op een werkstation draait, is niet noodzakelijkerwijs klaar voor gelijktijdig productieverkeer.
Behandel de Qwen TTS modelvermelding als een startpunt voor een kandidaat, niet als bewijs van geschiktheid voor een specifieke hostingregeling. Bevestig de daadwerkelijke runtime, licentie en interface voor welke implementatie je ook evalueert.
Test het Serving Pad, Niet Alleen de Weights
Gebruik hetzelfde geanonimiseerde corpus op gehoste en zelf-gehoste kandidaten. Houd het afspeelformaat en de test client consistent, en meet vervolgens onder de concurrency en verzoekpatronen die de applicatie verwacht.
Noteer of de test opstarten, laden, queuing en conversie omvat. Anders zijn een warme lokale benchmark en een volledig extern verzoek niet vergelijkbaar.
Als je testset persoonlijke informatie bevat, controleer dan de voorwaarden voor gegevensverwerking voordat je deze verzendt. Verwijder onnodige identifiers, zelfs wanneer de bestemming is goedgekeurd, en beperk de toegang tot referentieopnames onafhankelijk van gewone applicatietekst.
Shortlist, testen en goedkeuren
Een shortlist moet eisen uitdrukken, niet merkbekendheid. Houd kandidaten die voldoen aan het inputcontract, de vereiste talen, operationele beperkingen en voorwaarden voor stemautorisatie. Sluit modellen die niet aan een harde eis kunnen voldoen uit voordat je luistertijd aan ze besteedt.
Gebruik een releaseprocedure die een controleerbaar beslissingsverslag oplevert:
- Selecteer compatibele kandidaten. Documenteer waarom elk model past bij de vereiste inputs en outputs. Scheid verplichte functies van voorkeuren, zodat reviewers weten wat kan worden ingeruild.
- Draai en beoordeel de suite met moeilijke teksten. Bewaar ruwe outputs, luisteraarsbeoordelingen en timingregistraties. Onderzoek kritieke fouten in plaats van een aantrekkelijke geaggregeerde score te accepteren.
- Keur rechten en verwerkingsvoorwaarden goed. Controleer de modellicentie, autorisatie voor referentieaudio en het beoogde gebruik van elke aangepaste stem. Wijs een eigenaar toe aan onopgeloste voorwaarden.
- Bevries de goedgekeurde configuratie. Zet versies vast waar dat wordt ondersteund, sla preprocessing- en leveringsinstellingen op en vereis regressietests wanneer de servingconfiguratie verandert.
Houd integratiegemak gescheiden van acceptatie
UberLLM biedt toegang tot Claude, GPT, Gemini, DeepSeek en beeld-, video- en muziekmodellen via een OpenAI- en Anthropic-compatibel endpoint. Een gedeelde API key en prepaid saldo bundelen de toegang, en het wijzigen van de model-id maakt vergelijkingen tussen kandidaten mogelijk zonder voor elk model een aparte providerintegratie; modelspecifieke spraakparameters moeten nog steeds worden gecontroleerd.
Qwen3 0.6B TTS staat vermeld voor $0.035 per 1K tekens, tegen een lijstprijs van $0.0875 per 1K tekens. Bevestig de actuele prijs op de vermelding van de provider voordat je budgetteert, en vergelijk kosten alleen tussen kandidaten die aan de acceptatiecriteria voldoen.
Vereis een releasebeslissing op naam
Geef het goedkeuringsrecord een eigenaar en bewaar de goedgekeurde audiovoorbeelden. Leg uitzonderingen expliciet vast, inclusief tekstcategorieën die preprocessing, een fallbackstem of menselijke beoordeling vereisen.
Een releasebeslissing moet begrijpelijk blijven nadat de mensen die de evaluatie hebben uitgevoerd naar een ander project gaan. De laatste controle is eenvoudig: Haalt het gekozen model de test met moeilijke teksten, en dekt het toestemmingsrecord elke gekloonde stem?
UberLLM biedt een uniforme API om spraak naast andere modeltypen te vergelijken en te integreren. Bezoek UberLLM om spraakkandidaten te bekijken, en laat daarna je geanonimiseerde namen, codes en emotionele dialoog door de modellen lopen die aan je inputvereisten voldoen, voordat je een productieconfiguratie kiest.