Danh sách các mô hình AI 2026: 10 Tùy chọn theo Trường hợp sử dụng
Duyệt qua danh sách thực tế này về các mô hình AI theo phương thức, khả năng và trường hợp sử dụng, với 10 danh mục được so sánh về giá cả, quyền truy cập và khối lượng công việc phù hợp nhất.
Giả sử nhóm của bạn dành một tuần để đọc các trang mô hình, so sánh giá token và xây dựng một bản thử nghiệm. Sau đó, ai đó tải lên một tài liệu đại diện và phát hiện ra rằng ứng viên rẻ nhất không thể chứa tài liệu, hướng dẫn và phản hồi mong đợi vào cửa sổ ngữ cảnh của nó. Việc tích hợp hoạt động. Lựa chọn mô hình thì không.
Một danh mục mô hình không giống như một lựa chọn mô hình. Một số danh mục giúp bạn khám phá các trọng số có thể tải xuống. Những danh mục khác so sánh hiệu suất đo lường, bán dịch vụ suy luận được lưu trữ, kết nối mô hình với mua sắm đám mây hoặc đóng gói mô hình để thực thi cục bộ. Coi chúng là có thể thay thế cho nhau sẽ lãng phí thời gian và có thể che giấu ràng buộc quyết định liệu ứng dụng của bạn có hoạt động hay không.
Một danh sách mô hình AI hữu ích nên cho bạn biết nên bắt đầu từ đâu cho một công việc cụ thể:
- Khám phá và tùy chỉnh mô hình: Sử dụng một thư mục với thẻ mô hình, tệp và thông tin cấp phép.
- So sánh các ứng viên sản xuất: Sử dụng các phép đo độc lập, sau đó kiểm tra khối lượng công việc của riêng bạn.
- Gọi các mô hình được lưu trữ: Sử dụng một danh mục API với các định danh mô hình rõ ràng và chi tiết triển khai.
- Chạy ngoại tuyến: Sử dụng một danh mục thời gian chạy cục bộ và xác minh các yêu cầu phần cứng.
Đối với các ứng dụng văn bản, độ dài ngữ cảnh và hỗ trợ công cụ có thể loại bỏ ngay lập tức các ứng viên. Đối với các ứng dụng hình ảnh, video và âm thanh, các đầu vào được hỗ trợ, kiểm soát đầu ra và xử lý tác vụ không đồng bộ xứng đáng được quan tâm như nhau. Các tùy chọn dưới đây phục vụ các mục đích khác nhau, vì vậy điểm khởi đầu đúng đắn ít phụ thuộc vào danh mục nào trông lớn nhất mà phụ thuộc nhiều hơn vào những gì bạn cần làm tiếp theo.
Mục lục
- 1. Danh mục mô hình AI UberLLM
- 2. OpenRouter
- 3. Hugging Face Hub
- 4. Artificial Analysis
- 5. Replicate Explore
- 6. Microsoft Foundry Models
- 7. Danh mục mô hình Amazon Bedrock
- 8. Google Cloud Model Garden
- 9. Ollama Library
- 10. Danh sách mô hình API Google Gemini
- Các Danh mục Mô hình 10 Khác nhau như thế nào về Quyền truy cập, Khả năng hiển thị giá và Giới hạn
- Biến danh sách rút gọn thành một tích hợp hoạt động
1. Danh mục mô hình AI của UberLLM
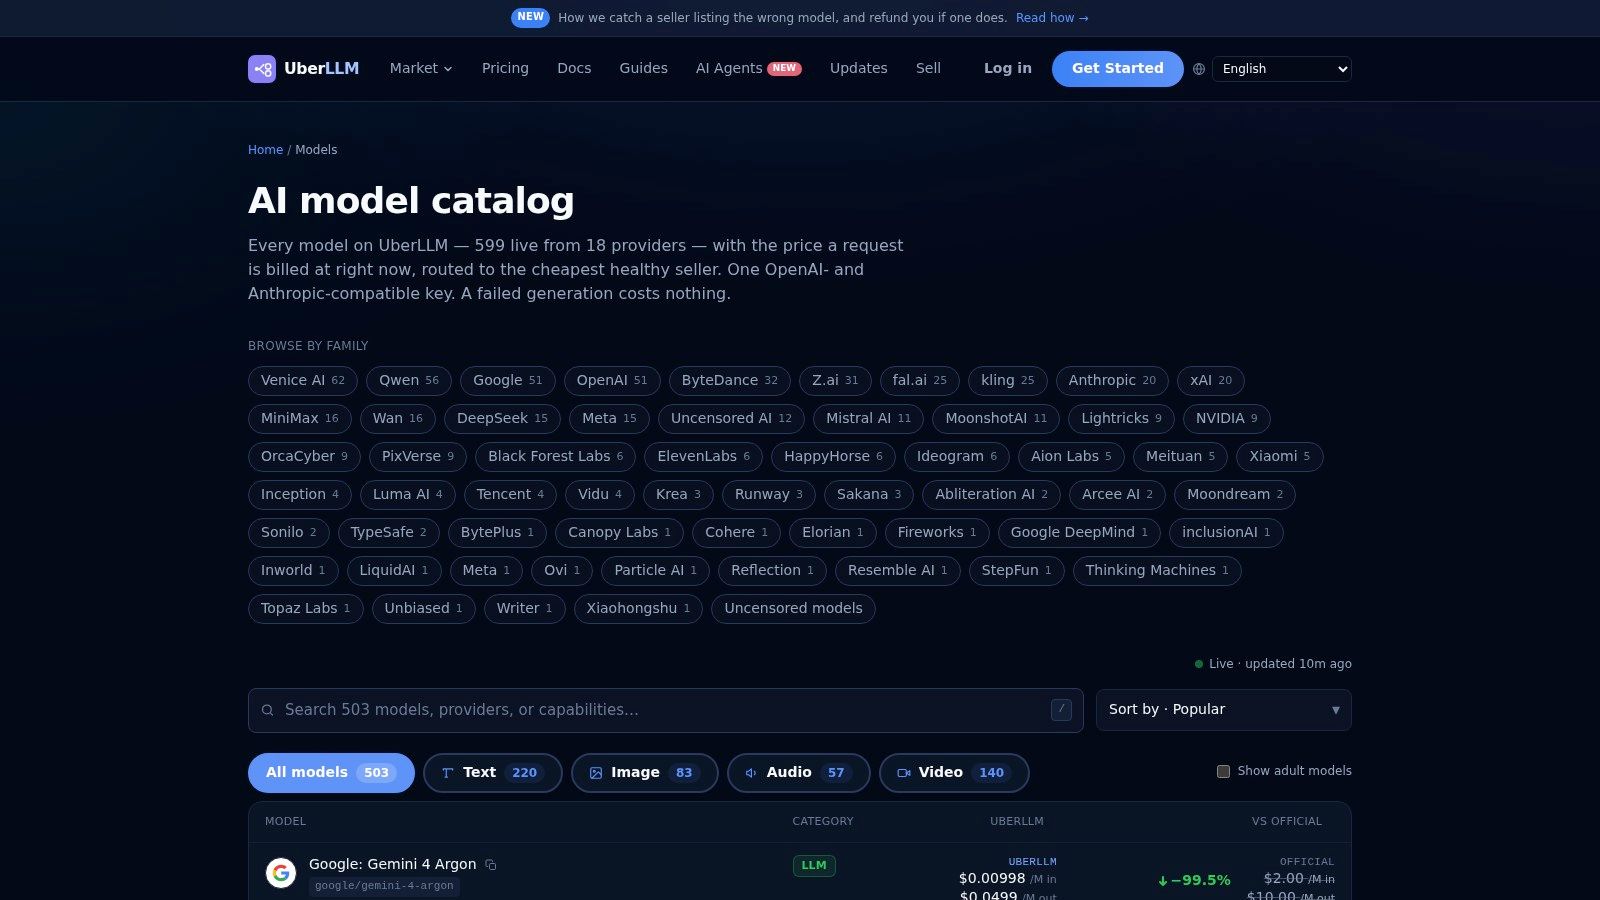
Tốt nhất để so sánh các tùy chọn được lưu trữ trước khi tích hợp API của một thị trường. Danh mục mô hình AI của UberLLM mang 457 mô hình vào một trang so sánh với giá trực tiếp, tên nhà cung cấp, độ dài ngữ cảnh và loại mô hình. Nó hữu ích khi danh sách rút gọn của bạn bao gồm cả văn bản và phương tiện thay vì chỉ một họ mô hình duy nhất.
Tại UberLLM, chúng tôi kết nối quá trình khám phá đó với một endpoint tương thích với OpenAI và Anthropic. Các nhà phát triển chọn một mã định danh mô hình, trong khi định tuyến thị trường chọn một nhà cung cấp có sẵn cho mô hình được yêu cầu. Sự khác biệt đó rất quan trọng: bạn đang chọn cả khả năng của mô hình và đường dẫn truy cập được lưu trữ.
Những điều cần kiểm tra trước khi lựa chọn
Đối với xử lý tài liệu, hãy so sánh độ dài ngữ cảnh và số lượng token đầu ra tối đa một cách riêng biệt. Một mô hình chấp nhận tài liệu nguồn của bạn vẫn có thể có giới hạn đầu ra ngăn nó tạo ra kết quả hoàn chỉnh. Siêu dữ liệu mô hình của chúng tôi hiển thị cả hai trường, và danh mục đánh dấu các mô hình hỗ trợ công cụ.
- Điểm mạnh: Giá trực tiếp và tên nhà cung cấp giúp việc rút gọn danh sách giữa các nhà cung cấp ít bị phân mảnh hơn.
- Quy trình làm việc hữu ích: Lọc theo phương thức, kiểm tra giới hạn, sau đó so sánh các đầu ra đại diện trong playground.
- Hạn chế: Một danh sách không thể xác định liệu lược đồ trích xuất, tác vụ mã hóa hay bản tóm tắt hình ảnh của bạn có thành công hay không.
Đừng coi giá thấp nhất được hiển thị là câu trả lời cuối cùng. Đối với văn bản, hãy ước tính sự kết hợp giữa đầu vào và đầu ra mà ứng dụng của bạn tạo ra; đối với phương tiện, hãy kiểm tra cấu hình tạo được yêu cầu trước khi so sánh chi phí.
Quy tắc thực tế: Chỉ chọn một mô hình sau khi giới hạn, chất lượng đầu ra và hành vi lỗi của nó đáp ứng được khối lượng công việc. Một yêu cầu rẻ tiền nhưng tạo ra kết quả không thể sử dụng thì không phải là một khoản tiết kiệm hữu ích.
Giá cả và tính khả dụng có thể thay đổi, vì vậy hãy ghi lại mã định danh và cấu hình đã sử dụng trong quá trình thử nghiệm thay vì để danh sách rút gọn của bạn chỉ là một tập hợp các tên mô hình.
2. OpenRouter
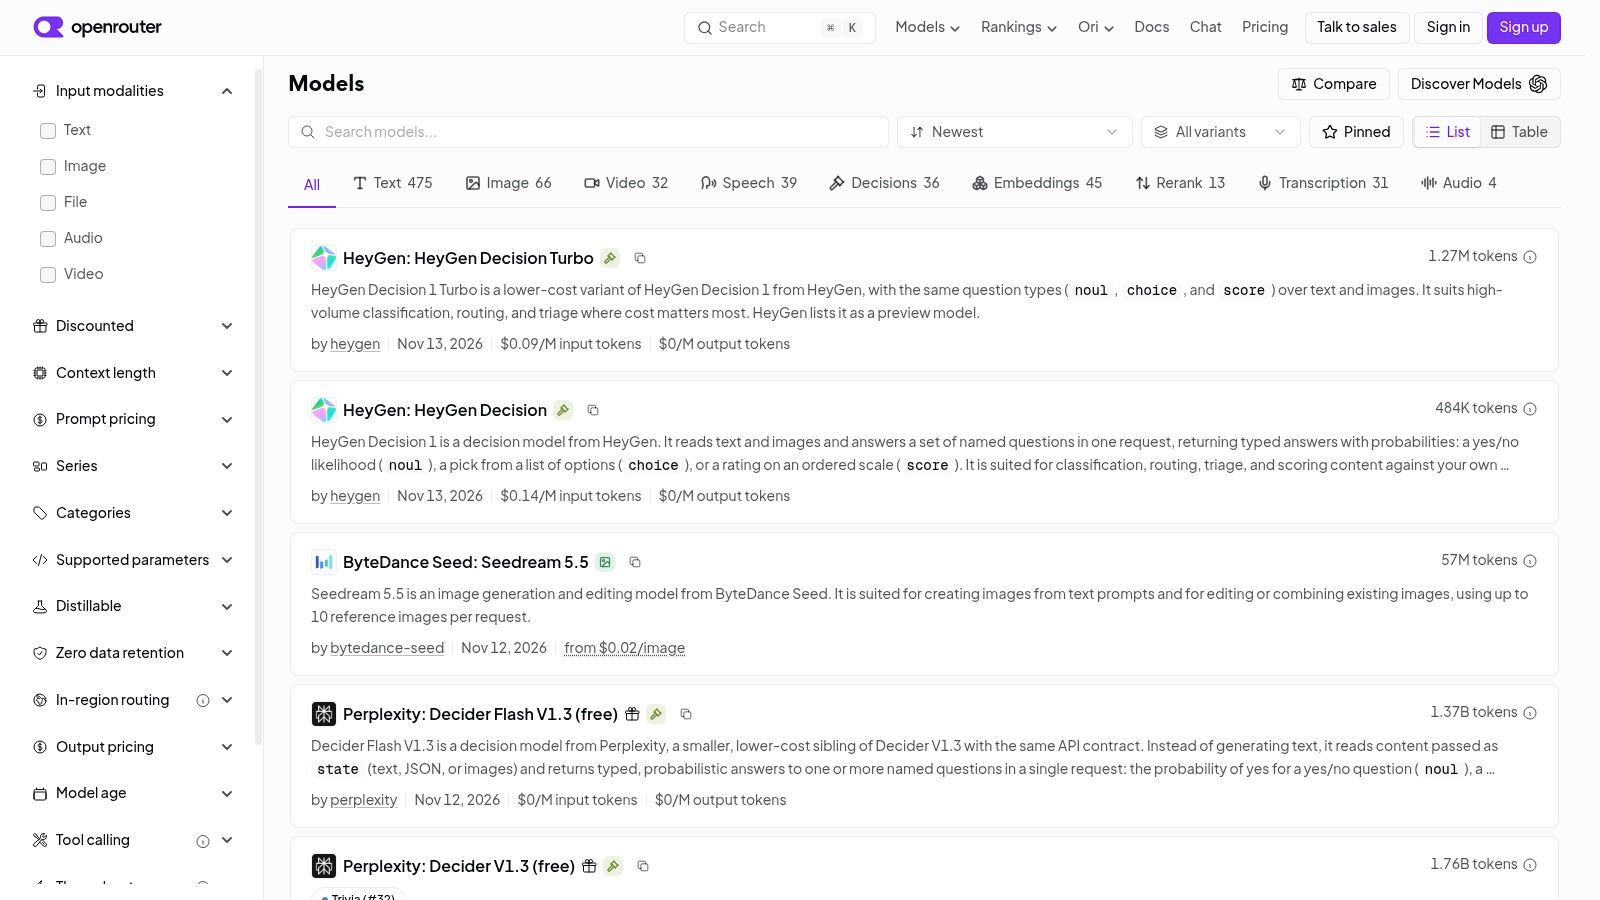
Nếu nhiệm vụ trước mắt của bạn là thử các mô hình được lưu trữ mà không cần xây dựng các tích hợp nhà cung cấp riêng biệt, danh mục mô hình của OpenRouter là một điểm khởi đầu thiết thực. Nó kết hợp các thông số kỹ thuật mô hình có thể tìm kiếm với quyền truy cập thông qua một API chung.
Các trường so sánh hữu ích bao gồm giá cả, độ dài ngữ cảnh, phương thức và khả năng. Chúng giúp phân biệt các mô hình chỉ chấp nhận văn bản với các ứng viên hỗ trợ các đầu vào hoặc hành vi bổ sung mà ứng dụng của bạn yêu cầu. Hãy kiểm tra trang mô hình riêng lẻ thay vì cho rằng mọi mô hình được hiển thị qua cùng một giao diện đều chấp nhận cùng một yêu cầu.
Nơi nó phù hợp
OpenRouter phù hợp với nhà phát triển đang so sánh các ứng viên được lưu trữ trong một ứng dụng hiện có. Bạn có thể giữ cho khung đánh giá xung quanh ổn định trong khi thay đổi mô hình đã chọn, mặc dù các tham số được hỗ trợ và hành vi đầu ra vẫn cần được xác thực.
- Điểm mạnh: Chuyển từ khám phá sang thử nghiệm API mà không cần sắp xếp từng tích hợp nhà cung cấp riêng biệt.
- Điểm không phù hợp: Coi danh mục là một kho lưu trữ nơi có thể tải xuống trọng số của mọi mô hình được liệt kê.
- Cần xác minh: Tính khả dụng hiện tại, giá cả cụ thể của mô hình, giới hạn ngữ cảnh và các khả năng cần thiết.
Đối với một tác nhân mã hóa, hãy kiểm tra các đối số gọi công cụ và khả năng phục hồi sau khi thực thi công cụ không thành công, chứ không chỉ chất lượng của một câu trả lời mã độc lập. Một API chung không làm cho hành vi của tác nhân có thể hoán đổi cho nhau.
So sánh các lựa chọn thay thế OpenRouter rất hữu ích khi đánh giá các dịch vụ truy cập khác nhau. Hãy giữ quyết định đó tách biệt với việc lựa chọn mô hình: mô hình và dịch vụ lưu trữ nó mang lại những đánh đổi vận hành khác nhau.
3. Hugging Face Hub
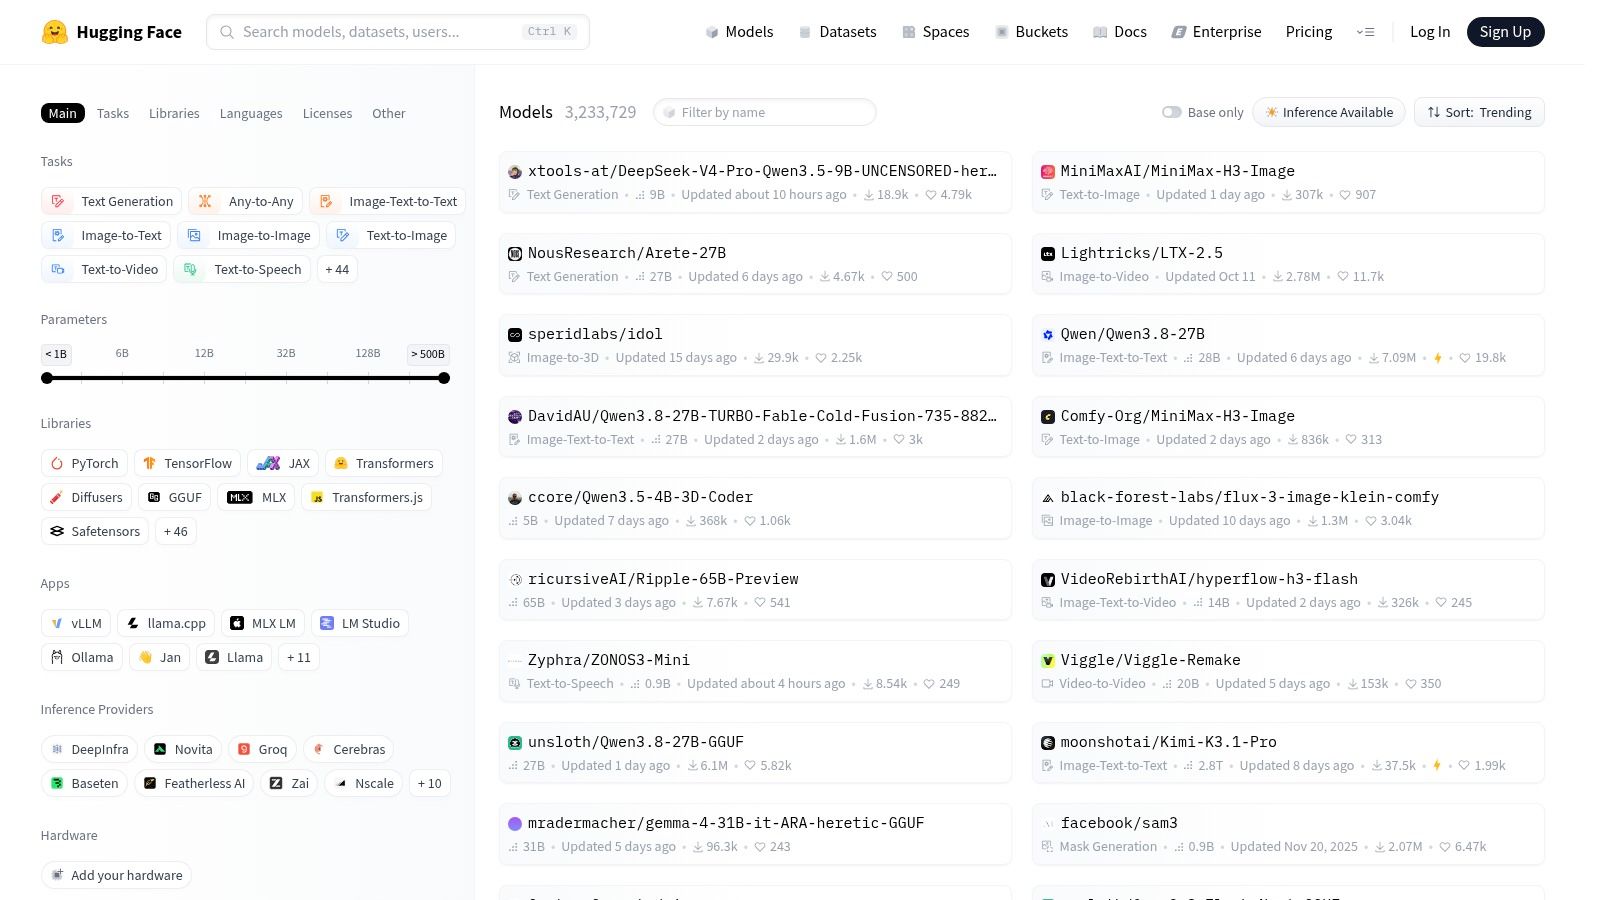
Hãy bắt đầu với Hugging Face khi bạn cần trọng số (weights), không chỉ một endpoint. Hugging Face Hub đặc biệt hữu ích để tìm các mô hình mà bạn có thể tùy chỉnh, kiểm tra hoặc tự triển khai.
Các trang mô hình của nó có thể kết hợp thẻ mô hình (model cards), tệp có thể tải xuống, ví dụ triển khai và chi tiết giấy phép. Điều đó làm cho nó trở thành một loại tài nguyên khác so với một menu API được lưu trữ: bạn đang nghiên cứu tạo phẩm và các yêu cầu của nó, chứ không chỉ đơn thuần quyết định gửi mã định danh nào trong một yêu cầu.
Đọc kỹ hơn tên mô hình
Kiểm tra tác vụ, kiến trúc, framework suy luận được hỗ trợ và giấy phép trước khi tải xuống. Sau đó, kiểm tra xem các ví dụ có khớp với mục đích sử dụng của bạn không, đặc biệt đối với các mô hình đã được tinh chỉnh (fine-tuned) với các prompt templates chuyên biệt.
- Điểm mạnh: Khám phá rộng rãi trên các tác vụ văn bản, thị giác, hình ảnh và âm thanh.
- Đánh đổi: Chất lượng tài liệu và đánh giá phụ thuộc vào nhà xuất bản.
- Hạn chế triển khai: Một mô hình có thể tải xuống không tự động có sẵn dưới dạng một API được quản lý.
Ví dụ, một nhóm xử lý tài liệu có thể tìm thấy một mô hình ngôn ngữ-thị giác đầy hứa hẹn nhưng vẫn cần phải lắp ráp tiền xử lý (preprocessing), suy luận (inference) và xác thực đầu ra. Kho lưu trữ giúp xác định những gì có sẵn; nó không loại bỏ công việc triển khai.
Trọng số mở (open weights) cũng không có nghĩa là sử dụng không giới hạn. Hãy đọc giấy phép thực tế và các điều kiện liên quan thay vì suy luận quyền hạn từ nút tải xuống.
Sử dụng Hugging Face cho nghiên cứu và tùy chỉnh khi việc truy cập vào các tệp cơ bản là quan trọng. Nếu bạn chỉ cần so sánh các phản hồi được lưu trữ chiều nay, một danh mục API có thể giúp bạn thực hiện một thử nghiệm có ý nghĩa nhanh hơn.
4. Phân tích nhân tạo
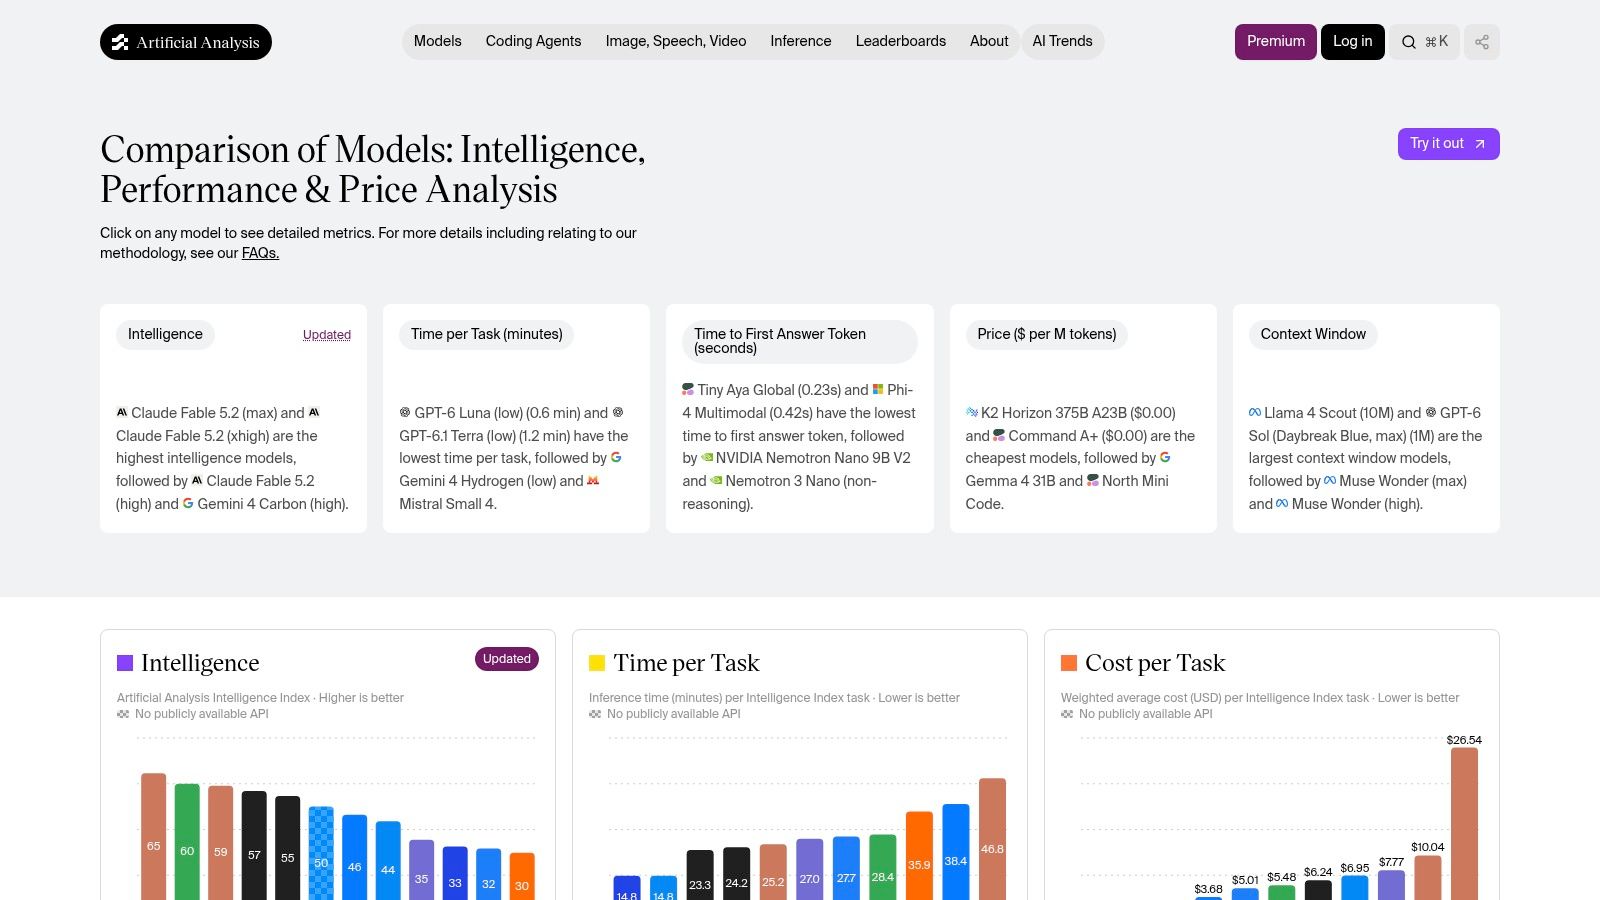
Câu hỏi khó không phải là mô hình nào có giá token quảng cáo thấp nhất. Mà là ứng viên nào đáp ứng yêu cầu chất lượng của bạn với tổng chi phí và thời gian hoàn thành chấp nhận được.
Phân tích nhân tạo so sánh các mô hình bằng cách sử dụng các thước đo bao gồm trí thông minh, giá cả, thời gian cho mỗi tác vụ, độ trễ đến token trả lời đầu tiên và kích thước cửa sổ ngữ cảnh. Phương pháp tính chi phí trên mỗi tác vụ của nó hữu ích hơn cho việc lập danh sách rút gọn so với việc đọc giá token một cách riêng lẻ vì nó liên kết các khoản phí với khối lượng công việc.
So sánh các chỉ số mà người dùng của bạn trải nghiệm
Đối với một trợ lý tương tác, thời gian đến token đầu tiên rất quan trọng, nhưng nó không thay thế thời gian hoàn thành từ đầu đến cuối. Đối với một công việc trích xuất nền, việc hoàn thành được xác thực và tổng chi phí có thể quan trọng hơn tốc độ văn bản xuất hiện lần đầu.
- Dùng để: Xác định sự đánh đổi giữa khả năng, chi phí và tốc độ trước khi thử nghiệm ứng dụng.
- Không dùng để: Giả định rằng một mô hình dẫn đầu trong điểm chuẩn sẽ thắng với các lời nhắc hoặc ngôn ngữ của bạn.
- Lưu ý về truy cập: Một số bộ dữ liệu hoặc tính năng có thể yêu cầu tài khoản hoặc quyền truy cập trả phí.
So sánh chi phí trên mỗi tác vụ thành công, không chỉ chi phí trên mỗi yêu cầu. Bao gồm cả các lần thử lại và kết quả bị từ chối trong đánh giá của riêng bạn.
chỉ số giá LLM cung cấp một tham chiếu giá khác khi lập danh sách rút gọn. Giữ các giả định về khối lượng công việc hiển thị khi so sánh bất kỳ chỉ số nào.
Phân tích nhân tạo không phải là nơi để tải xuống mọi mô hình hoặc triển khai ứng dụng của bạn. Nhiệm vụ của nó là cải thiện danh sách rút gọn, để lại công cụ kiểm tra của riêng bạn để xác định xem các ứng viên đó có đáp ứng yêu cầu sản xuất hay không.
5. Replicate Explore
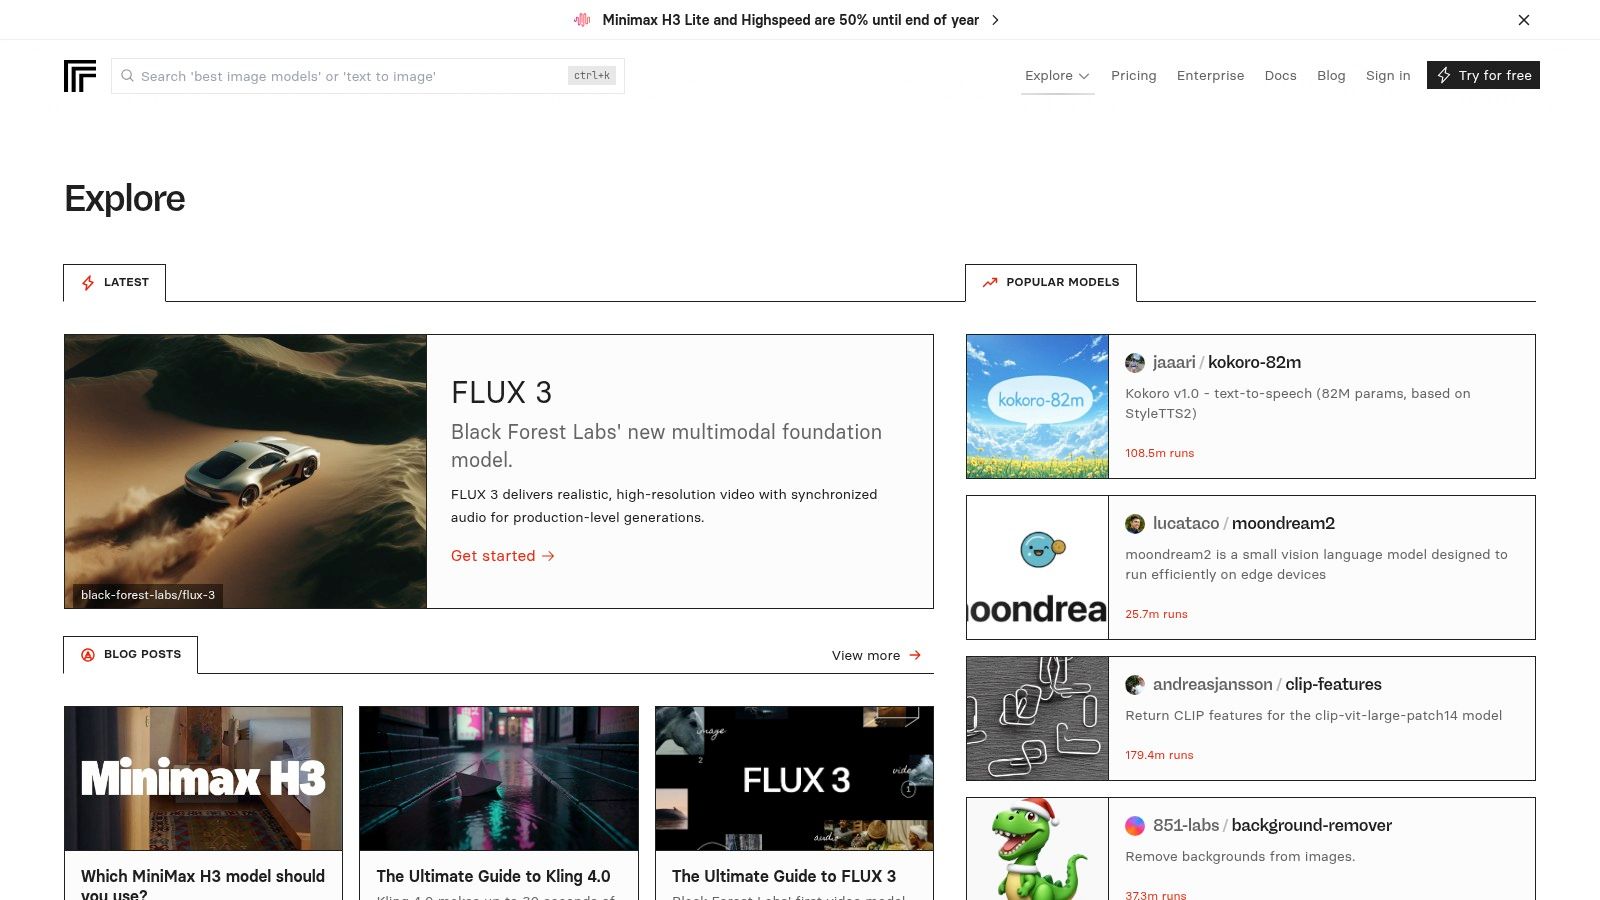
Kiểm tra một mô hình video đòi hỏi nhiều hơn là chỉ đọc bảng xếp hạng mô hình ngôn ngữ. Bạn cần kiểm tra các đầu vào được chấp nhận, ví dụ đầu ra, các điều khiển tạo và cách ứng dụng truy xuất kết quả đã hoàn thành.
Replicate Explore hữu ích cho việc khám phá thực tế này, đặc biệt là trong tạo ảnh, video và âm thanh. Các trang mô hình có thể cung cấp ví dụ, định nghĩa đầu vào, hướng dẫn sử dụng và giá cả cùng với một đường dẫn thực thi được lưu trữ.
Kiểm tra với tài liệu nguồn của riêng bạn
Đối với chuyển đổi ảnh sang video, hãy sử dụng một hình ảnh đại diện cho ứng dụng của bạn, không chỉ các ví dụ đã được trau chuốt của mô hình. Kiểm tra tính nhất quán của chủ thể, chuyển động, bố cục và liệu đầu ra có tuân thủ yêu cầu hay không. Đối với giọng nói, hãy kiểm tra tên riêng, dấu câu và các ngôn ngữ mà người dùng của bạn gửi.
- Điểm mạnh: Bạn có thể thử nghiệm mà không cần thiết lập local inference trước.
- Linh hoạt: Các triển khai tùy chỉnh có thể sử dụng Cog, công cụ đóng gói của Replicate.
- Hạn chế: Các mô hình do cộng đồng xuất bản có thể khác nhau về bảo trì, tài liệu và hỗ trợ.
Hãy kiểm tra xem một danh sách có phải là chính thức và được duy trì tích cực hay không trước khi xây dựng dựa trên nó. Cũng hãy đọc kỹ đơn vị thanh toán, vì giá mô hình có thể phụ thuộc vào thời gian chạy hoặc đầu ra được tạo ra chứ không phải là tính toán token theo kiểu văn bản.
Replicate là một lựa chọn mạnh mẽ khi bạn cần xem liệu một mô hình tạo sinh có thể tạo ra phương tiện truyền thông chấp nhận được hay không. Nó ít hữu ích hơn như một bảng xếp hạng chuẩn hóa duy nhất trên các phương thức không liên quan: một mô hình giọng nói và một mô hình video cần các tiêu chí chấp nhận khác nhau.
6. Microsoft Foundry Models
Đối với một ứng dụng dựa trên Azure, khả năng triển khai có thể quan trọng ngang với năng lực của mô hình. Một ứng viên tiềm năng sẽ không hữu ích nếu phương pháp triển khai có sẵn của nó không phù hợp với kiến trúc hoặc khu vực hoạt động của bạn.
Microsoft Foundry Models kết nối việc khám phá mô hình với môi trường đám mây của Microsoft. Danh mục này bao gồm các sản phẩm của Microsoft, đối tác và cộng đồng, cùng với thông tin liên quan đến tác vụ, khả năng, cấp phép và các lựa chọn triển khai.
Chọn đường dẫn triển khai cùng với mô hình
Các mô hình đủ điều kiện có thể có các tùy chọn API-based, batch, provisioned hoặc managed-compute khác nhau. Đừng cho rằng việc tìm thấy một mô hình trong danh mục có nghĩa là mọi phương pháp lưu trữ và thanh toán đều có sẵn cho nó.
- Phù hợp tốt: Các nhóm cần lựa chọn mô hình phù hợp với các quyết định triển khai Azure.
- Chi tiết hữu ích: Thông tin triển khai dành riêng cho mô hình và kết quả benchmark đã chọn.
- Hạn chế: Tính khả dụng, phương pháp triển khai và giá cả có thể khác nhau tùy theo mô hình và khu vực.
Một nhóm phân tích tài liệu nên tìm hiểu cả khả năng hỗ trợ đầu vào của mô hình và cấu hình endpoint mà nó sẽ triển khai. Việc thử nghiệm một demonstration endpoint là không đủ nếu sản xuất sẽ sử dụng một sắp xếp phục vụ khác biệt đáng kể.
Do đó, danh mục này là một tài nguyên kiến trúc cũng như một công cụ khám phá. Hãy sử dụng nó khi tích hợp Azure là một yêu cầu thực tế, chứ không phải vì một mô hình mong muốn tình cờ xuất hiện ở đó.
Để khám phá không phụ thuộc nhà cung cấp, một công cụ so sánh đa nhà cung cấp thường là điểm khởi đầu rõ ràng hơn. Hãy quay lại Foundry khi bạn đã sẵn sàng thiết lập đường dẫn triển khai đám mây thực tế.
7. Danh mục mô hình Amazon Bedrock
Kiểm tra tính khả dụng theo khu vực trước khi xây dựng nguyên mẫu. Đó là thói quen hữu ích nhất khi sử dụng danh mục mô hình Amazon Bedrock cho một ứng dụng AWS.
Danh mục này xác định các mô hình nền tảng được hỗ trợ và khả năng của chúng. Các nhóm có thể kiểm tra tính khả dụng theo khu vực và thử nghiệm các mô hình đủ điều kiện trong môi trường thử nghiệm (playground) của bảng điều khiển Bedrock trước khi tích hợp chúng vào một ứng dụng dựa trên AWS.
Việc mua sắm và truy cập là một phần của lựa chọn
Bedrock đặc biệt phù hợp khi ứng dụng đã hoạt động trong cơ sở hạ tầng AWS. Tuy nhiên, việc thiết lập tài khoản và quyền truy cập theo khu vực có thể ảnh hưởng đến việc liệu mô hình bạn muốn có thể sử dụng được trong môi trường dự định hay không.
- Những gì hiệu quả: Chuyển từ việc khám phá mô hình được hỗ trợ sang triển khai AWS.
- Những gì cần xác nhận: Quyền truy cập tài khoản, khu vực dự định, đầu vào được hỗ trợ và yêu cầu gọi (invocation).
- Những gì nó không phải: Một danh mục trung lập của mọi mô hình AI có thể tải xuống hoặc có sẵn trên thị trường.
Đối với một trợ lý hỗ trợ, hãy kiểm tra các đoạn truy xuất và hướng dẫn tương tự mà bạn dự định gửi từ môi trường sản xuất. Thành công trong môi trường thử nghiệm (playground) xác nhận rằng một yêu cầu có thể hoạt động; nó không xác nhận rằng pipeline truy xuất, xử lý lỗi và trình phân tích đầu ra của bạn là chính xác.
Điểm mạnh của Bedrock là kết nối của nó với ngăn xếp ứng dụng AWS. Định hướng tương tự đó là một hạn chế đối với các nhóm chỉ muốn khảo sát rộng rãi các tùy chọn mô hình mà không cam kết tích hợp dành riêng cho đám mây.
Hãy ghi lại chính xác mô hình và cấu hình truy cập đã sử dụng trong quá trình đánh giá. Một tên họ mô hình dễ nhận biết không đủ để tái tạo một quyết định triển khai.
8. Google Cloud Model Garden
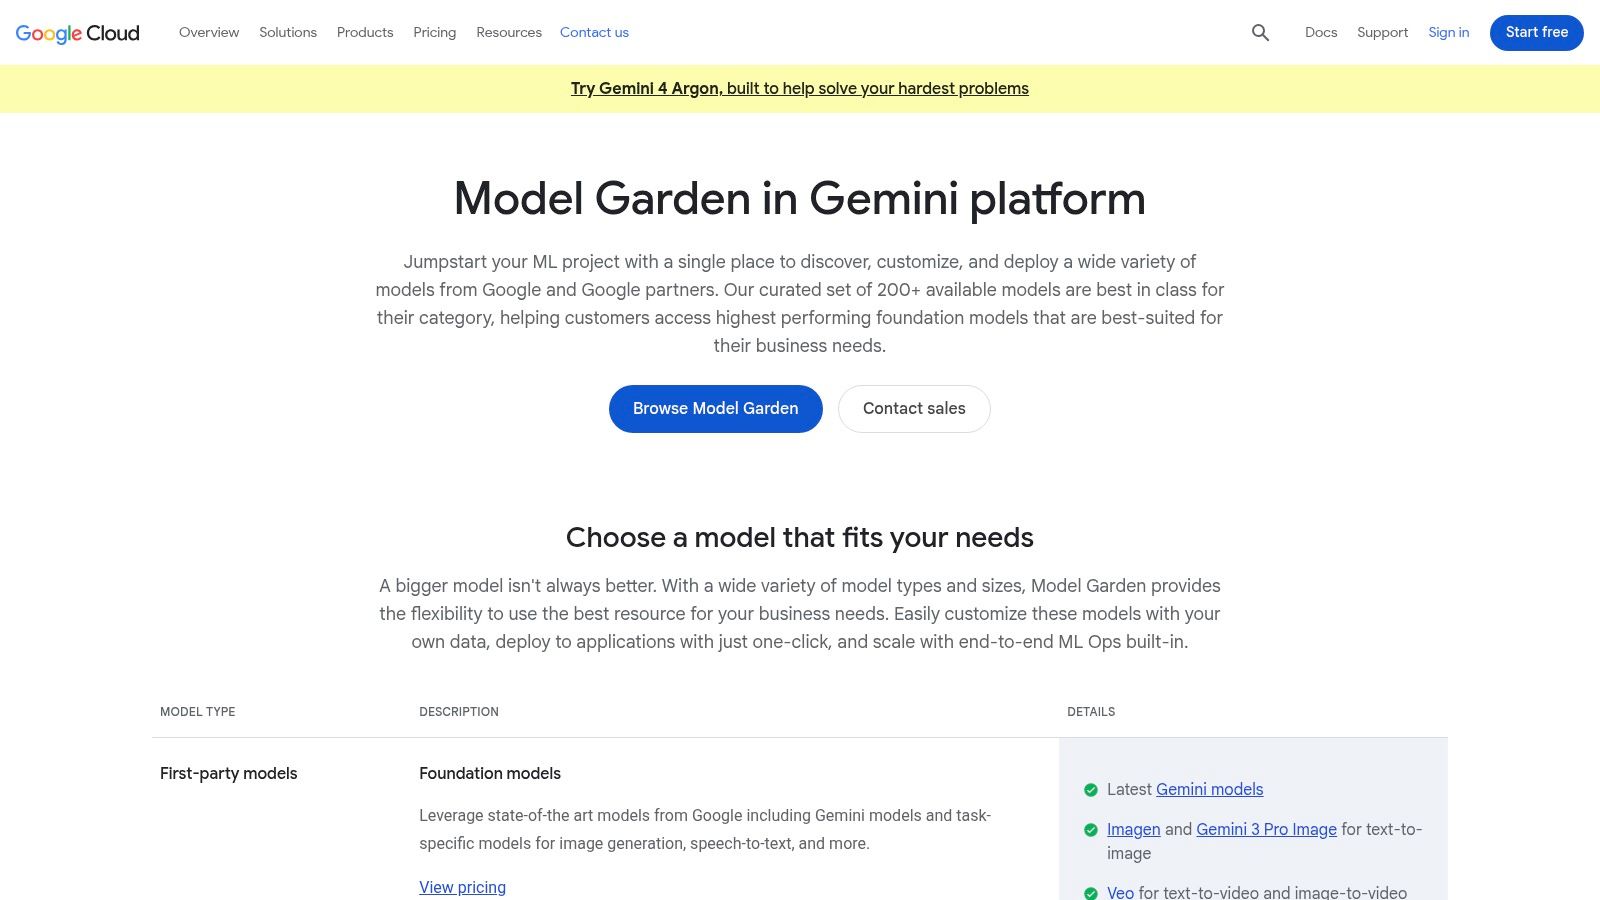
Một nhóm phát triển trên Google Cloud nên đánh giá mô hình và cách thức phục vụ của nó cùng nhau. Việc tìm kiếm dòng mô hình phù hợp chỉ là bước khởi đầu; cấu hình triển khai sẽ quyết định cách nó phù hợp với ứng dụng.
Google Cloud Model Garden cung cấp khả năng khám phá các mô hình của Google, bên thứ ba và các mô hình mã nguồn mở trong môi trường AI của Google Cloud. Nó hữu ích nhất khi bước tiếp theo là phát triển dựa trên đám mây thay vì tải xuống một mô hình cho một môi trường chạy cục bộ không liên quan.
Tách biệt việc khám phá khỏi các giả định triển khai
Kiểm tra từng dịch vụ riêng lẻ trước khi ước tính chi phí hoặc nỗ lực triển khai. Khả năng sẵn có và giá cả phụ thuộc vào mô hình, khu vực và cấu hình dịch vụ, vì vậy một mục trong danh mục không đủ để xác định sự phù hợp cho sản xuất.
- Sử dụng tốt nhất: Khám phá các mô hình cho một ứng dụng Google Cloud.
- Lợi thế: Các dịch vụ của Google và các dịch vụ bên ngoài được chọn xuất hiện trong cùng một quy trình khám phá hướng đám mây.
- Hạn chế: Nó kém tiện lợi hơn cho một cuộc khảo sát trung lập về nhà cung cấp hoặc thử nghiệm ngoại tuyến.
Đối với một dịch vụ phân tích hình ảnh, hãy xác nhận định dạng đầu vào được chấp nhận và sau đó kiểm tra chính xác quá trình tiền xử lý mà ứng dụng của bạn thực hiện. Thay đổi kích thước, cắt xén và chuyển đổi tài liệu thuộc về quá trình đánh giá, chứ không chỉ trong quá trình triển khai cuối cùng.
Đừng nhầm lẫn Model Garden với danh sách mô hình Gemini API hẹp hơn. Cái trước giúp khám phá mô hình đám mây rộng hơn; cái sau cung cấp chi tiết của bên thứ nhất cho một hệ sinh thái API cụ thể.
Sử dụng Model Garden khi nhóm của bạn biết rằng Google Cloud là một phần của kế hoạch triển khai. Nếu không, hãy bắt đầu với các yêu cầu về mô hình và tránh để một bảng điều khiển đám mây hiện có xác định danh sách rút gọn quá sớm.
9. Thư viện Ollama
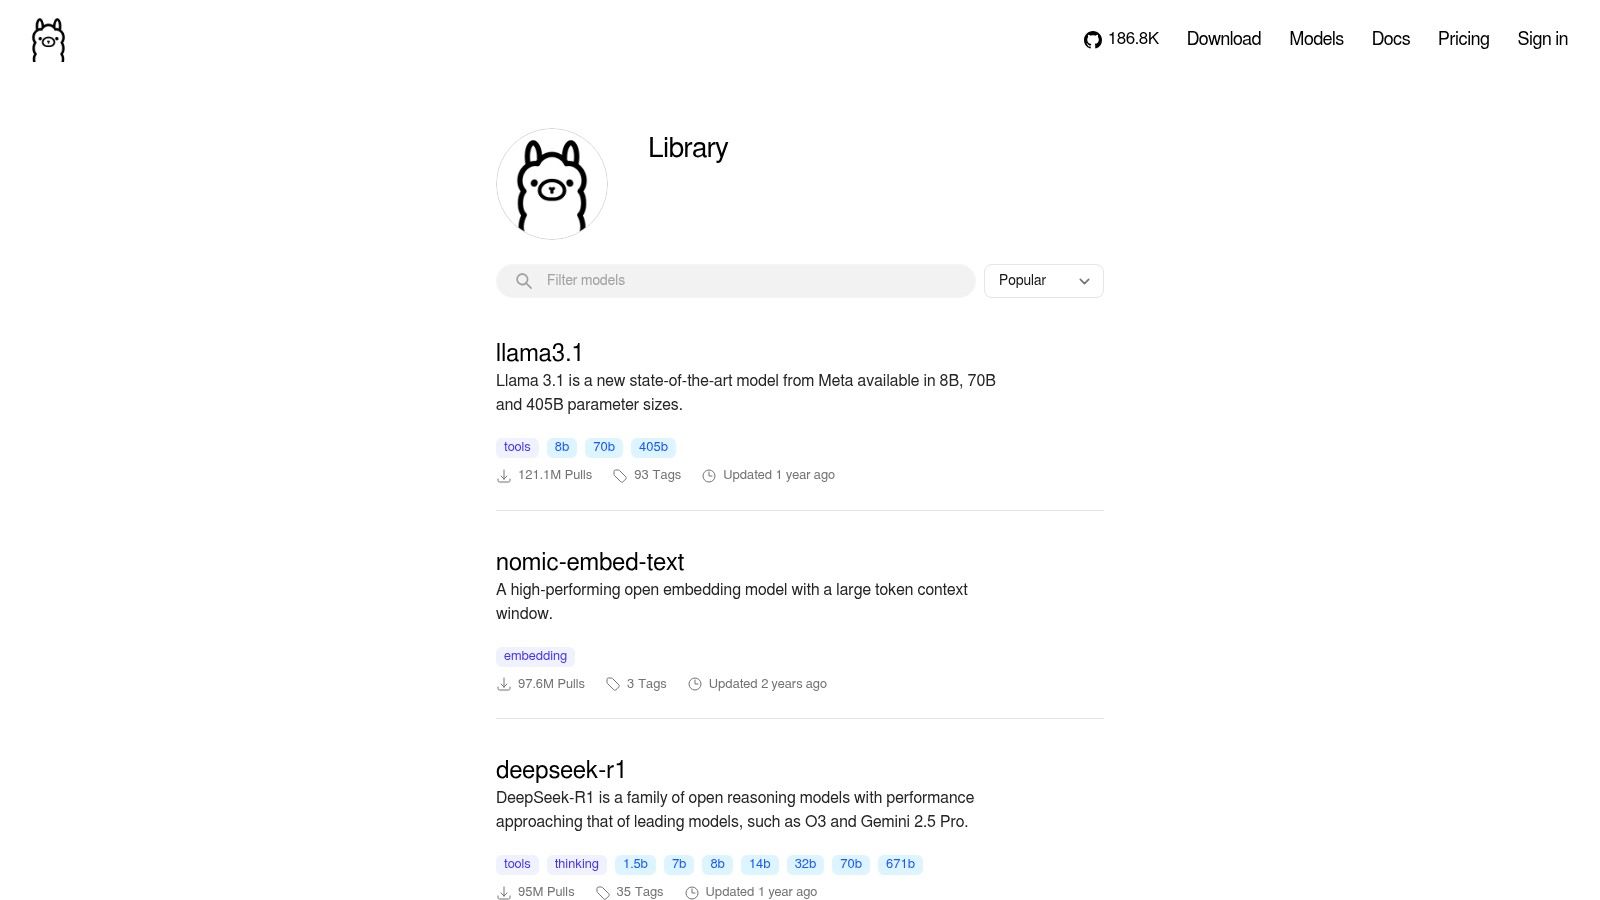
Nếu yêu cầu là chạy một mô hình trên máy của riêng bạn, hãy bắt đầu với một danh mục tập trung vào thời gian chạy thay vì một thị trường API được lưu trữ. Thư viện Ollama Library giúp người dùng tìm các mô hình, kích thước, biến thể và khả năng được hỗ trợ cho quy trình làm việc cục bộ của Ollama.
Kích thước mô hình là một bộ lọc ban đầu hữu ích, nhưng nó không phải là một ước tính phần cứng hoàn chỉnh. Việc sử dụng ngữ cảnh, chi phí thời gian chạy và các ứng dụng khác cạnh tranh bộ nhớ cũng ảnh hưởng đến việc cấu hình có chạy thoải mái hay không.
Kiểm tra máy thực tế
Chọn một ứng cử viên phù hợp với phần cứng của bạn, sau đó thử nghiệm nó với độ dài đầu vào đại diện. Một mô hình xử lý một lời nhắc trò chuyện ngắn có thể trở nên không thực tế khi bạn thêm các tài liệu đã truy xuất hoặc một cuộc trò chuyện dài.
Stanford's AI Index efficiency discussion báo cáo rằng Phi-3-mini, với 3.8 tỷ tham số, đã đạt đến ngưỡng MMLU được nêu tương tự mà trước đây yêu cầu 540 tỷ tham số của PaLM. So sánh đó hỗ trợ một bài học thực tế: số lượng tham số một mình không phải là một xếp hạng chất lượng.
- Điểm mạnh: Thử nghiệm dễ dàng với các mô hình có thể chạy cục bộ.
- Khác biệt về chi phí: Thực thi cục bộ tránh các khoản phí sử dụng API được lưu trữ, nhưng phần cứng và hoạt động vẫn tốn tiền.
- Hạn chế: Máy của bạn và các định dạng được hỗ trợ giới hạn danh sách rút gọn.
Thực thi cục bộ không tự động là một hệ thống ngoại tuyến hoàn chỉnh. Kiểm tra xem việc truy xuất, ghi nhật ký, công cụ và các thành phần ứng dụng khác có ở lại cục bộ hay không.
Ollama là một điểm khởi đầu hữu ích cho các nguyên mẫu ngoại tuyến và các thử nghiệm bị hạn chế về phần cứng. Nó không loại bỏ nhu cầu xác thực chất lượng, việc sử dụng bộ nhớ hoặc độ trễ từ đầu đến cuối.
10. Danh sách mô hình Google Gemini API
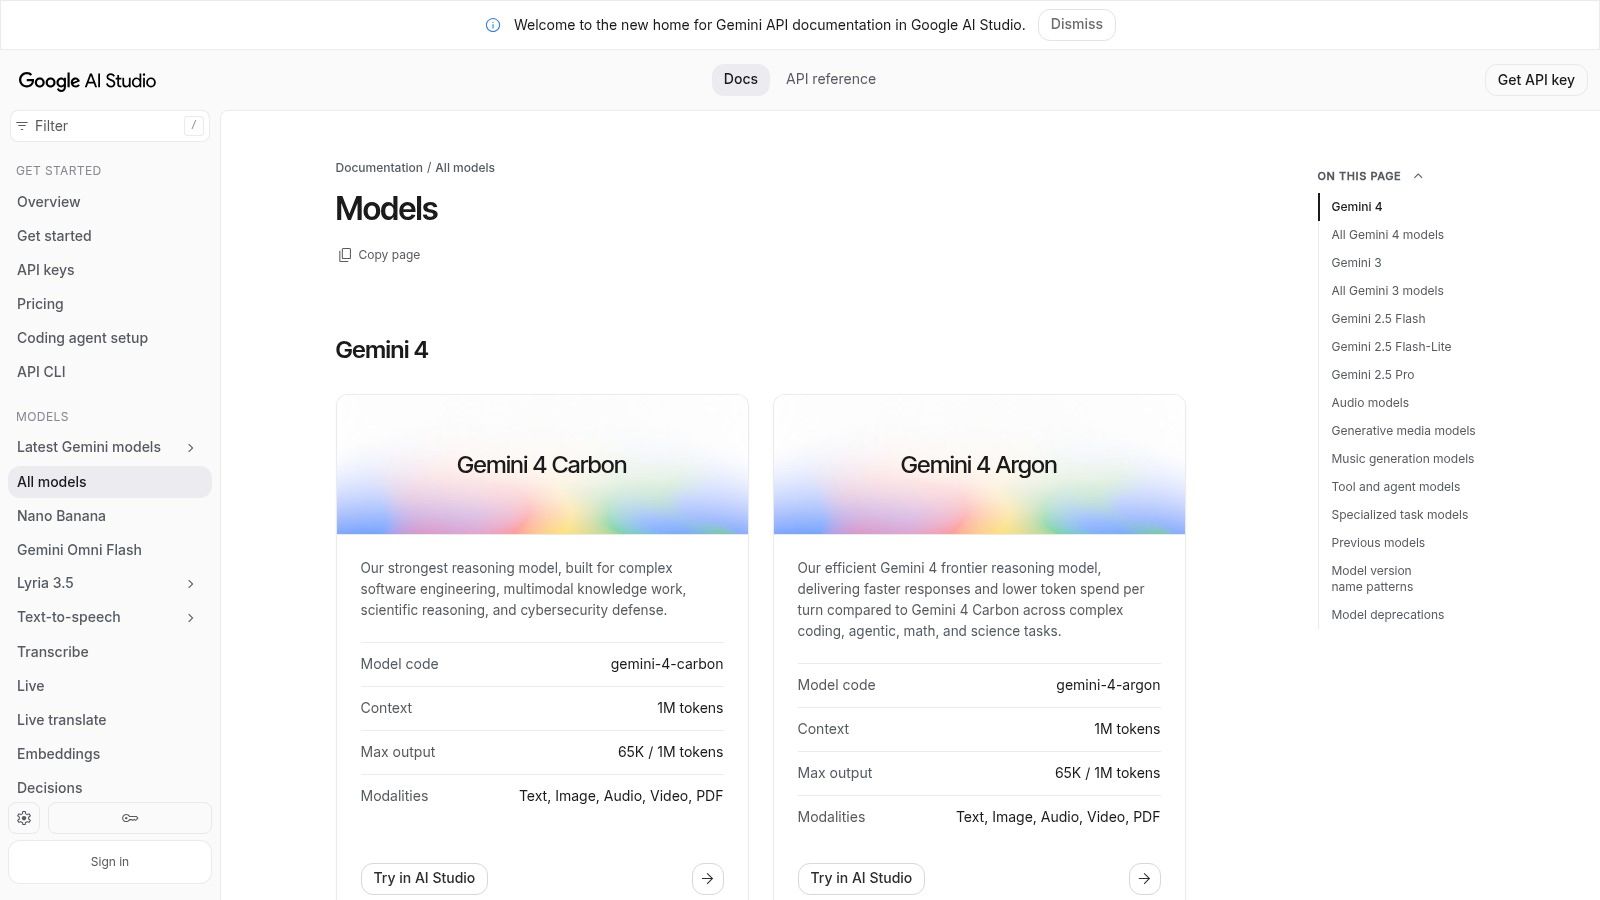
Đôi khi, con đường đúng đắn là con đường hẹp nhất. Nếu bạn đã chọn Gemini API, hãy sử dụng danh sách mô hình Gemini API chính thức để xác nhận định danh mô hình, mô tả và các khả năng được hỗ trợ.
Đây là tài liệu triển khai từ bên thứ nhất, không phải dịch vụ so sánh giữa các nhà cung cấp. Nó kết nối việc khám phá mô hình với tài liệu API và Google AI Studio, giúp ích khi bạn cần biến một nhóm mô hình đã chọn thành một yêu cầu hoạt động.
Xác minh định danh chính xác
Đừng xây dựng dựa trên tên nhóm mô hình được sao chép từ một bài viết so sánh. Xác nhận định danh cụ thể và kiểm tra các đầu vào, đầu ra được hỗ trợ cũng như điều kiện truy cập của nó trước khi tích hợp.
- Điểm mạnh: Thông tin mô hình trực tiếp dành cho các nhà phát triển sử dụng Gemini API.
- Giới hạn phạm vi: Nó sẽ không giúp bạn so sánh mọi nhà cung cấp cạnh tranh.
- Lưu ý thương mại: Kiểm tra giá hiện tại, cấp độ truy cập và điều kiện đủ điều kiện của mô hình đã chọn.
Đối với một ứng dụng liên quan đến âm thanh, hãy xác minh xem mô hình cụ thể đó có hỗ trợ quy trình làm việc âm thanh cần thiết hay không thay vì giả định rằng mọi mô hình Gemini đều cung cấp chức năng giống hệt nhau. Áp dụng sự cẩn trọng tương tự cho các đầu vào đa phương thức và việc sử dụng công cụ.
Cũng hãy duy trì các kiểm tra vòng đời trong quy trình bảo trì của bạn. Hướng dẫn ngừng hoạt động của Veo và Gemini API có liên quan khi xem xét các phụ thuộc endpoint và công việc di chuyển.
Danh sách chính thức được sử dụng tốt nhất làm tài liệu tham khảo triển khai sau khi đã chọn lọc. Nó cung cấp các chi tiết cần thiết để tạo một yêu cầu hợp lệ, trong khi đánh giá của riêng bạn sẽ xác định liệu kết quả trả về có đáp ứng yêu cầu của sản phẩm hay không.
Cách 10 Danh mục Mô hình Khác nhau về Quyền truy cập, Khả năng hiển thị giá và Giới hạn
| Mục | Phù hợp nhất cho | Mô hình truy cập | Khả năng hiển thị giá | Hạn chế chính |
|---|---|---|---|---|
| Danh mục mô hình AI của UberLLM (Được khuyến nghị) | So sánh các mô hình giữa các nhà cung cấp | Unified API và marketplace | Giá trực tiếp được niêm yết | Các danh mục không dự đoán hiệu suất cụ thể theo khối lượng công việc |
| OpenRouter | So sánh và truy cập các mô hình giữa các nhà cung cấp | Hosted API với một key | Giá mô hình được hiển thị; xác minh tỷ giá hiện tại | Hosted API, không phải trọng số mô hình có thể tải xuống |
| Hugging Face Hub | Nghiên cứu, tùy chỉnh và self-hosting | Tải xuống mô hình; việc hosting khác nhau | Giá không được niêm yết nhất quán | Chất lượng mô hình và documentation khác nhau |
| Artificial Analysis | So sánh benchmarks, cost và speed | Tài nguyên nghiên cứu và so sánh; data API | Giá API được hiển thị; một số quyền truy cập có thể phải trả phí | Benchmarks có thể không phản ánh workload của bạn |
| Replicate Explore | Kiểm tra và chạy các mô hình tạo sinh được hosted | Hosted model APIs và custom deployments | Giá cụ thể theo mô hình; có thể thay đổi tùy theo mức usage | Chất lượng và support mô hình cộng đồng khác nhau |
| Microsoft Foundry Models | Chọn mô hình cho các ứng dụng Azure | Các tùy chọn triển khai Azure | Thay đổi theo mô hình và region | Phù hợp nhất cho người dùng Azure |
| Danh mục mô hình Amazon Bedrock | Tìm mô hình cho các ứng dụng AWS | Các dịch vụ Bedrock trong AWS | Thay đổi theo mô hình và region | Quyền truy cập phụ thuộc vào AWS và region |
| Google Cloud Model Garden | Tìm mô hình để triển khai trên Google Cloud | Các dịch vụ AI của Google Cloud | Thay đổi theo mô hình và configuration | Hướng tới Google Cloud |
| Ollama Library | Chạy mô hình cục bộ | Local inference với Ollama | Không có giá hosted; sử dụng hardware của bạn | Yêu cầu setup và hardware phù hợp |
| Danh sách mô hình API Google Gemini | Xây dựng với các mô hình của Google | Gemini API và Google AI Studio | Trang giá riêng; các tiers khác nhau | Chỉ bao gồm các mô hình của Google |
Biến danh sách rút gọn thành tích hợp hoạt động
Ngừng tìm kiếm khi bạn đã có hai hoặc ba mô hình khả thi cho mỗi phương thức. Nhiều ứng viên hơn không giúp ích gì nếu nhóm của bạn chưa xác định kết quả chấp nhận được trông như thế nào. Ghi lại độ dài ngữ cảnh yêu cầu, giới hạn đầu ra, hỗ trợ công cụ, định dạng đầu vào và các ràng buộc triển khai trước khi chạy so sánh.
Sau đó, gửi cùng một lời nhắc hoặc tác vụ tạo qua từng ứng viên. Đối với trích xuất văn bản, hãy xác thực schema trả về và so sánh các giá trị được trích xuất với các câu trả lời mong đợi. Đối với mã hóa, chạy thử nghiệm với các thay đổi được tạo; đối với phương tiện, xem xét đầu ra dựa trên một bản tóm tắt nhất quán thay vì chọn bất kỳ mẫu nào trông ấn tượng nhất.
Đánh giá toàn bộ đường dẫn ứng dụng
Bao gồm công việc xung quanh inference. Chuyển đổi tài liệu, truy xuất, thực thi công cụ, thăm dò, thử lại và xác thực đầu ra đều có thể quyết định liệu một mô hình có khả năng khác có thể sử dụng được hay không.
- Chất lượng: Ghi lại các kết quả được chấp nhận, không chỉ các yêu cầu đã hoàn thành.
- Độ trễ: Đo cả phản hồi ban đầu và hoàn thành từ đầu đến cuối khi có liên quan.
- Chi phí: Bao gồm các lần thử lại, các thế hệ bị từ chối và các cuộc gọi theo dõi cần thiết.
- Độ tin cậy: Thực hiện kiểm tra các trường hợp hết thời gian chờ, đầu ra không đúng định dạng và các endpoint không khả dụng.
Thảo luận của Brookings về đánh giá mô hình AI giải thích tại sao điểm chuẩn có thể bỏ qua các mối quan tâm thực tế như độ trễ, yêu cầu tính toán, chi phí và an toàn. Đánh giá của bạn nên làm rõ những mối quan tâm đó thay vì coi bảng xếp hạng công khai là một bài kiểm tra chấp nhận sản xuất.
Đối với các nhóm muốn một endpoint duy nhất cho các quy trình làm việc về văn bản, hình ảnh, video và âm thanh, hãy bắt đầu tích hợp UberLLM bằng cách đặt base URL trong cấu hình SDK OpenAI hoặc Anthropic hiện có của bạn thành API endpoint tương thích. Sử dụng UberLLM key và giữ lại giao diện SDK hiện có cùng mã xung quanh, sau đó chuyển đổi ứng viên bằng cách thay đổi model identifier. Xác thực các tham số được hỗ trợ của từng ứng viên và sử dụng quy trình làm việc tác vụ không đồng bộ (asynchronous task workflow) phù hợp cho phương tiện thay vì giả định mọi phương thức đều hoạt động như một phản hồi trò chuyện streaming.
Giữ cho quyết định có thể tái tạo
Lưu trữ model identifier, phiên bản lời nhắc, cài đặt tạo, đầu vào đánh giá và kết quả chấp nhận cùng nhau. Bản ghi đó cho phép một kỹ sư khác lặp lại thử nghiệm và giúp việc đánh giá các thay đổi mô hình sau này dễ dàng hơn. Tránh dựa vào ảnh chụp màn hình không có phiên bản hoặc ấn tượng ghi nhớ về chất lượng đầu ra.
Chọn một mô hình mặc định và xác định khi nào ứng dụng nên leo thang hoặc thất bại an toàn. Một phương án dự phòng chỉ hữu ích nếu nó đáp ứng các yêu cầu thiết yếu tương tự, bao gồm các ràng buộc về quyền riêng tư và hỗ trợ công cụ. Danh sách mô hình AI tốt nhất là danh sách giúp bạn đưa ra quyết định tích hợp có thể bảo vệ được, sau đó nhường chỗ cho các thử nghiệm có thể lặp lại.
UberLLM kết nối các nhà phát triển với các mô hình văn bản, hình ảnh, video, âm nhạc và giọng nói của bên thứ ba thông qua một API thống nhất và số dư trả trước. Truy cập UberLLM để so sánh giới hạn mô hình và giá trực tiếp, kiểm tra danh sách rút gọn của bạn trong playground và tích hợp các ứng viên đáp ứng yêu cầu ứng dụng của bạn.