Daftar Model AI 2026: 10 Pilihan Berdasarkan Kasus Penggunaan
Jelajahi daftar praktis model AI ini berdasarkan modalitas, kapabilitas, dan kasus penggunaan, dengan 10 katalog dibandingkan mengenai harga, akses, dan beban kerja yang paling sesuai.
Bayangkan tim Anda menghabiskan seminggu membaca halaman model, membandingkan harga token, dan menyiapkan prototipe. Kemudian seseorang mengunggah dokumen representatif dan menemukan bahwa kandidat termurah tidak dapat memuat dokumen, instruksi, dan respons yang diharapkan ke dalam jendela konteksnya. Integrasinya berfungsi. Pilihan modelnya tidak.
Katalog model tidak sama dengan pilihan model. Beberapa katalog membantu Anda menemukan bobot yang dapat diunduh. Yang lain membandingkan kinerja terukur, menjual inferensi yang di-host, menghubungkan model ke pengadaan cloud, atau mengemas model untuk eksekusi lokal. Memperlakukan mereka sebagai hal yang dapat dipertukarkan membuang-buang waktu dan dapat menyembunyikan batasan yang menentukan apakah aplikasi Anda berfungsi.
Sebuah daftar model AI yang berguna harus memberi tahu Anda di mana harus memulai untuk pekerjaan tertentu:
- Temukan dan sesuaikan model: Gunakan direktori dengan kartu model, file, dan informasi lisensi.
- Bandingkan kandidat produksi: Gunakan pengukuran independen, lalu uji beban kerja Anda sendiri.
- Panggil model yang di-host: Gunakan katalog API dengan pengidentifikasi model eksplisit dan detail deployment.
- Jalankan secara offline: Gunakan katalog runtime lokal dan verifikasi persyaratan perangkat keras.
Untuk aplikasi teks, panjang konteks dan dukungan alat mungkin langsung menghilangkan kandidat. Untuk aplikasi gambar, video, dan audio, input yang didukung, kontrol output, dan penanganan tugas asinkron layak mendapatkan perhatian yang sama. Opsi di bawah ini melayani tujuan yang berbeda, jadi titik awal yang tepat kurang bergantung pada katalog mana yang terlihat terbesar dan lebih pada apa yang perlu Anda lakukan selanjutnya.
Daftar Isi
- 1. Katalog model AI UberLLM
- 2. OpenRouter
- 3. Hugging Face Hub
- 4. Artificial Analysis
- 5. Replicate Explore
- 6. Microsoft Foundry Models
- 7. Katalog model Amazon Bedrock
- 8. Google Cloud Model Garden
- 9. Ollama Library
- 10. Daftar model Google Gemini API
- Bagaimana 10 Katalog Model Berbeda berdasarkan Akses, Visibilitas Harga, dan Batasan
- Mengubah Daftar Pilihan Menjadi Integrasi yang Berfungsi
1. Katalog model AI UberLLM
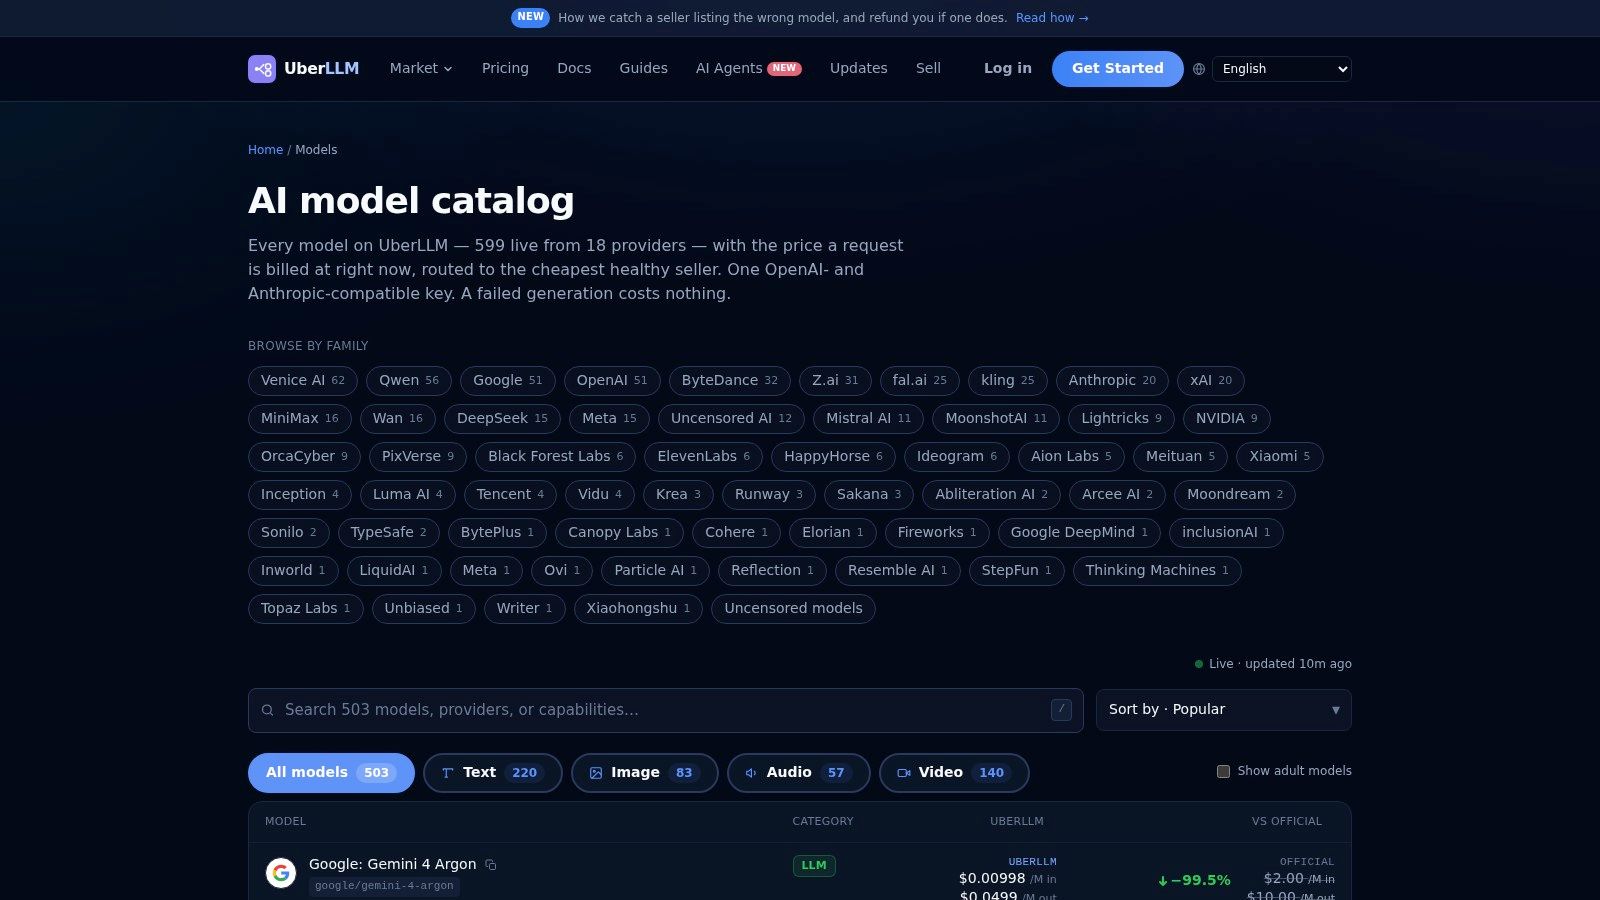
Terbaik untuk membandingkan opsi yang di-host sebelum mengintegrasikan marketplace API. Katalog model AI UberLLM menghadirkan 457 model ke halaman perbandingan dengan harga langsung, nama penyedia, panjang konteks, dan jenis model. Ini berguna ketika daftar pilihan Anda mencakup teks dan media, bukan hanya satu keluarga model.
Di UberLLM, kami menghubungkan proses penemuan tersebut ke endpoint yang kompatibel dengan OpenAI dan Anthropic. Developer memilih pengidentifikasi model, sementara perutean marketplace memilih penjual yang tersedia untuk model yang diminta. Perbedaan itu penting: Anda memilih kemampuan model dan jalur akses yang di-host.
Apa yang perlu diperiksa sebelum memilih
Untuk pemrosesan dokumen, bandingkan panjang konteks dan token output maksimum secara terpisah. Model yang menerima materi sumber Anda mungkin masih memiliki batas output yang mencegahnya menghasilkan hasil yang lengkap. Metadata model kami menampilkan kedua bidang tersebut, dan katalog menandai model yang mendukung tools.
- Kekuatan: Harga langsung dan nama penyedia membuat pemilihan awal lintas penyedia menjadi tidak terlalu terfragmentasi.
- Alur kerja yang berguna: Filter berdasarkan modalitas, periksa batas, lalu bandingkan output representatif di playground.
- Keterbatasan: Daftar tidak dapat menentukan apakah skema ekstraksi, tugas coding, atau ringkasan visual Anda akan berhasil.
Jangan anggap harga terendah yang ditampilkan sebagai jawaban akhir. Untuk teks, perkirakan campuran input dan output yang dihasilkan aplikasi Anda; untuk media, periksa konfigurasi generasi yang diminta sebelum membandingkan biaya.
Aturan praktis: Pilih model hanya setelah batasnya, kualitas output, dan perilaku kegagalannya memenuhi beban kerja. Permintaan murah yang menghasilkan hasil tidak berguna bukanlah penghematan yang bermanfaat.
Harga dan ketersediaan dapat berubah, jadi catat pengidentifikasi dan konfigurasi yang digunakan dalam pengujian daripada membiarkan daftar pilihan Anda sebagai kumpulan nama model.
2. OpenRouter
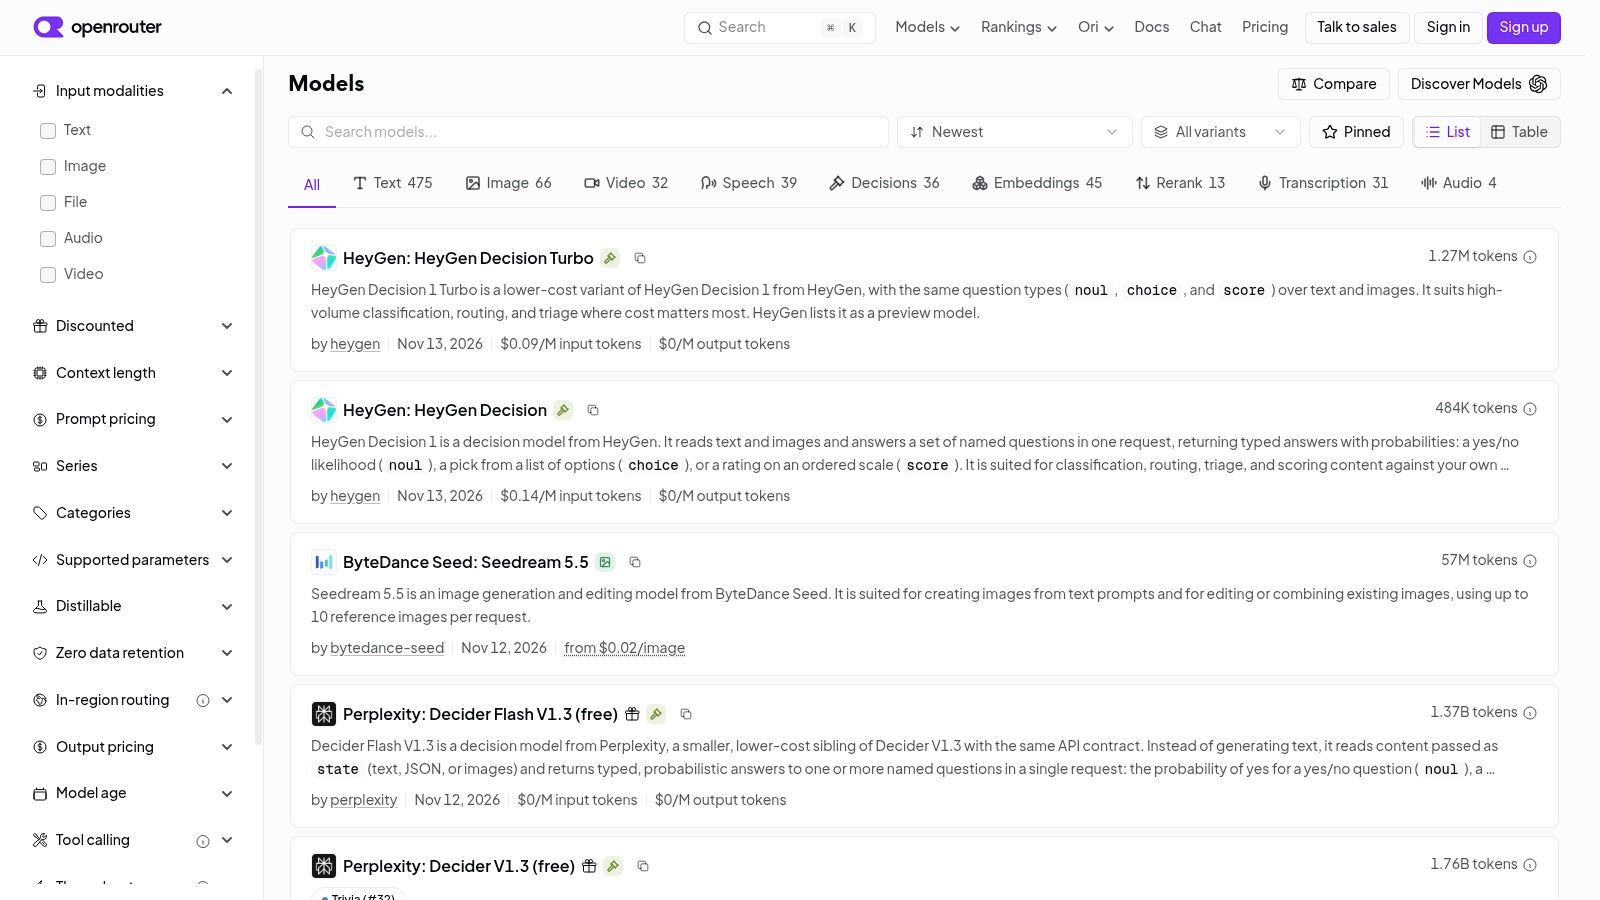
Jika tugas utama Anda adalah mencoba model yang di-host tanpa membangun integrasi penyedia terpisah, katalog model OpenRouter adalah titik awal yang praktis. Ini menggabungkan spesifikasi model yang dapat dicari dengan akses melalui API umum.
Bidang perbandingan yang berguna meliputi harga, panjang konteks, modalitas, dan kapabilitas. Ini membantu membedakan model yang hanya menerima teks dari kandidat yang mendukung input atau perilaku tambahan yang dibutuhkan aplikasi Anda. Periksa halaman model individual daripada berasumsi bahwa setiap model yang diekspos melalui antarmuka yang sama menerima permintaan yang sama.
Di mana ia cocok
OpenRouter cocok untuk pengembang yang membandingkan kandidat yang di-host di dalam aplikasi yang sudah ada. Anda dapat menjaga kerangka evaluasi di sekitarnya tetap stabil saat mengubah model yang dipilih, meskipun parameter yang didukung dan perilaku output masih memerlukan validasi.
- Yang berfungsi: Beralih dari penemuan ke eksperimen API tanpa mengatur setiap integrasi penyedia secara terpisah.
- Yang tidak berfungsi: Memperlakukan katalog sebagai repositori tempat bobot setiap model yang terdaftar dapat diunduh.
- Yang perlu diverifikasi: Ketersediaan saat ini, harga spesifik model, batas konteks, dan kapabilitas yang dibutuhkan.
Untuk agen pengkodean, uji argumen panggilan alat dan pemulihan setelah eksekusi alat yang gagal, bukan hanya kualitas jawaban kode yang berdiri sendiri. API umum tidak membuat perilaku agen dapat dipertukarkan.
perbandingan alternatif OpenRouter berguna saat mengevaluasi layanan akses yang berbeda. Pisahkan keputusan itu dari pemilihan model: model dan layanan yang menghostingnya memperkenalkan pertimbangan operasional yang berbeda.
3. Hugging Face Hub
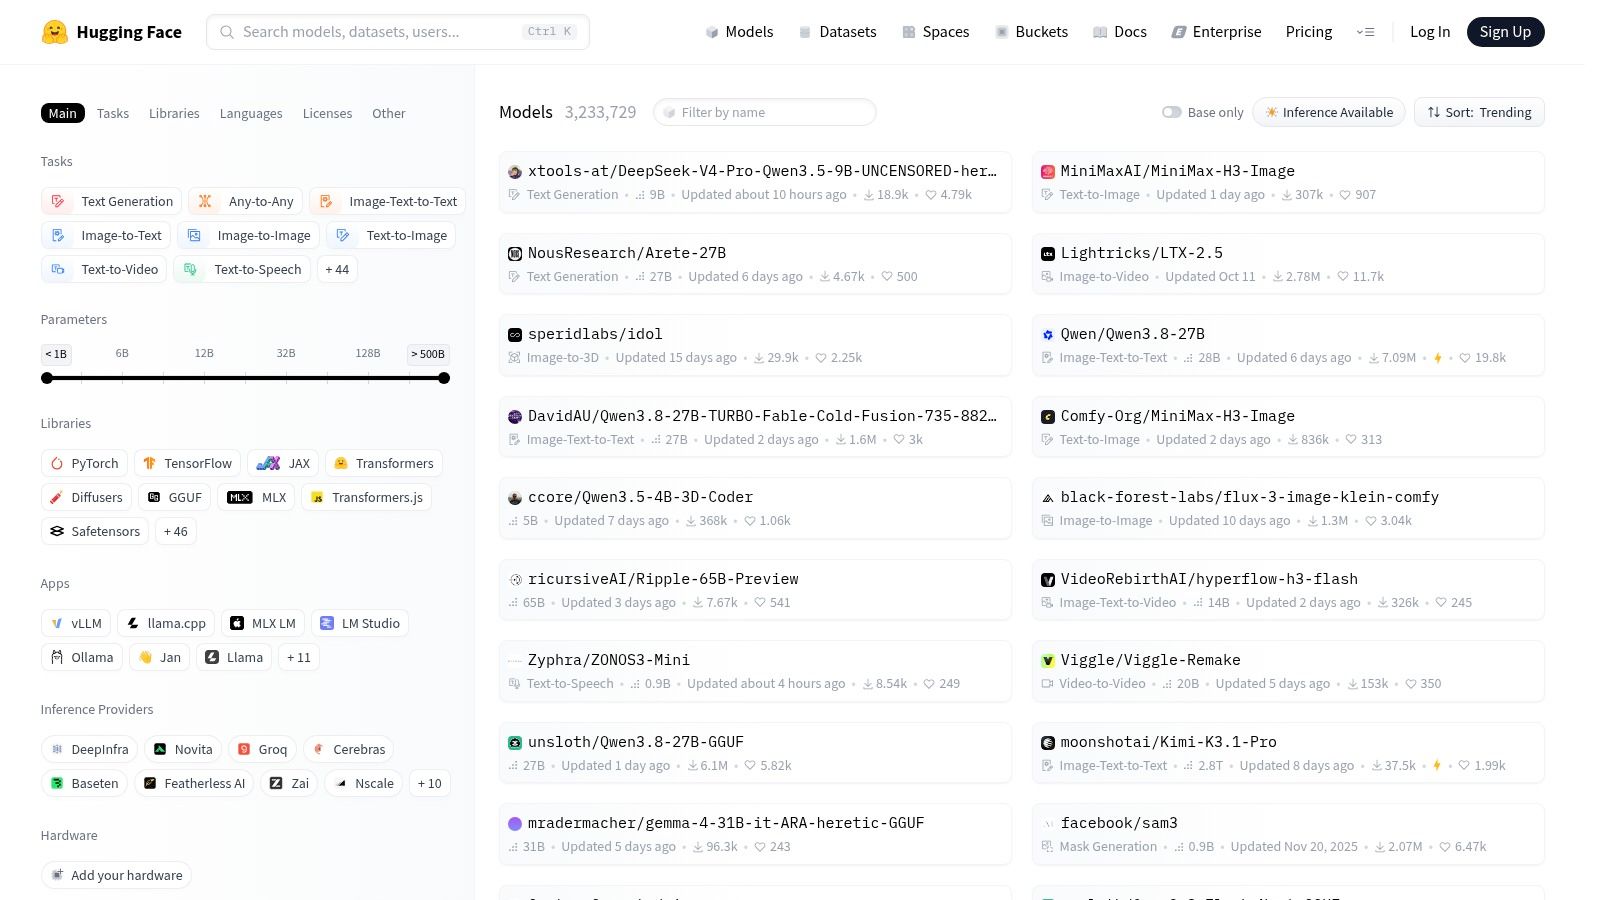
Mulailah dengan Hugging Face saat Anda membutuhkan weights, bukan hanya endpoint. Hugging Face Hub sangat berguna untuk menemukan model yang mungkin ingin Anda sesuaikan, periksa, atau deploy sendiri.
Halaman modelnya dapat menggabungkan model cards, berkas yang dapat diunduh, contoh implementasi, dan detail lisensi. Hal ini menjadikannya jenis sumber daya yang berbeda dari menu API yang di-host: Anda sedang menyelidiki artefak dan persyaratannya, bukan hanya memutuskan pengenal mana yang akan dikirim dalam sebuah permintaan.
Baca lebih dari sekadar nama model
Periksa tugas, arsitektur, inference framework yang didukung, dan lisensi sebelum mengunduh. Kemudian periksa apakah contoh-contohnya sesuai dengan penggunaan yang Anda inginkan, terutama untuk model yang di-fine-tune dengan prompt templates khusus.
- Kekuatan: Penemuan luas di seluruh tugas teks, visi, gambar, dan audio.
- Kompromi: Kualitas dokumentasi dan evaluasi bergantung pada penerbit.
- Batasan deployment: Model yang dapat diunduh tidak secara otomatis tersedia sebagai API terkelola.
Misalnya, tim pemrosesan dokumen mungkin menemukan model visi-bahasa yang menjanjikan tetapi masih perlu merakit preprocessing, inference, dan validasi output. Repositori membantu menetapkan apa yang tersedia; itu tidak menghilangkan pekerjaan deployment.
Open weights juga tidak berarti penggunaan tanpa batas. Baca lisensi sebenarnya dan ketentuan terkait daripada menyimpulkan izin dari tombol unduh.
Gunakan Hugging Face untuk penelitian dan penyesuaian saat akses ke berkas dasar penting. Jika Anda hanya perlu membandingkan respons yang di-host sore ini, katalog API mungkin akan membawa Anda ke pengujian yang berarti lebih cepat.
4. Artificial Analysis
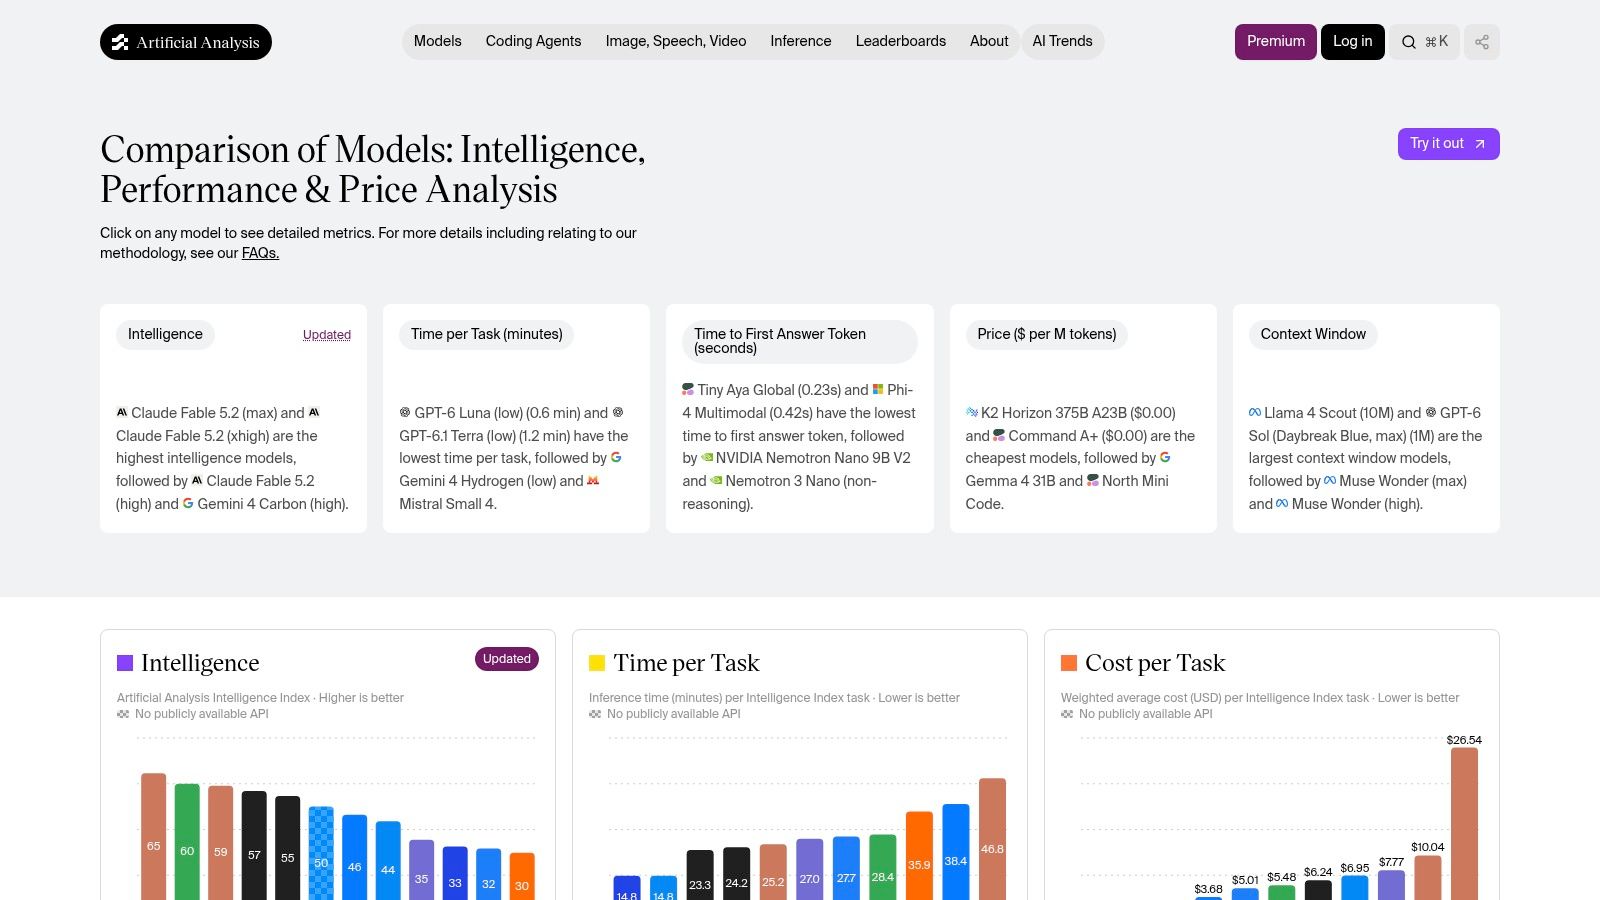
Pertanyaan sulitnya bukanlah model mana yang memiliki harga token terendah yang diiklankan. Melainkan kandidat mana yang memenuhi persyaratan kualitas Anda dengan total biaya dan waktu penyelesaian yang dapat diterima.
Artificial Analysis](https://artificialanalysis.ai/models) membandingkan model menggunakan ukuran termasuk kecerdasan, harga, waktu per tugas, latensi ke token jawaban pertama, dan ukuran context-window. Pendekatan biaya per tugasnya lebih berguna untuk membuat daftar pendek daripada membaca harga token secara terpisah karena menghubungkan biaya dengan beban kerja.
Bandingkan metrik yang dialami pengguna Anda
Untuk asisten interaktif, waktu ke token pertama itu penting, tetapi tidak menggantikan waktu penyelesaian end-to-end. Untuk pekerjaan ekstraksi latar belakang, penyelesaian yang tervalidasi dan total pengeluaran mungkin lebih penting daripada kecepatan teks pertama kali muncul.
- Gunakan untuk: Mengidentifikasi trade-off kemampuan, biaya, dan kecepatan sebelum pengujian aplikasi.
- Jangan gunakan untuk: Mengasumsikan pemimpin benchmark akan menang pada prompt atau bahasa Anda.
- Peringatan akses: Beberapa dataset atau fitur mungkin memerlukan akun atau akses berbayar.
Bandingkan biaya per tugas yang berhasil, bukan hanya biaya per permintaan. Sertakan percobaan ulang dan output yang ditolak dalam evaluasi Anda sendiri.
Indeks harga LLM menyediakan referensi harga lain saat menyusun daftar pendek. Pertahankan asumsi beban kerja terlihat saat membandingkan indeks apa pun.
Artificial Analysis bukanlah tempat untuk mengunduh setiap model atau menerapkan aplikasi Anda. Tugasnya adalah untuk meningkatkan daftar pendek, menyerahkan harness Anda sendiri untuk menentukan apakah kandidat tersebut memenuhi persyaratan produksi.
5. Replicate Explore
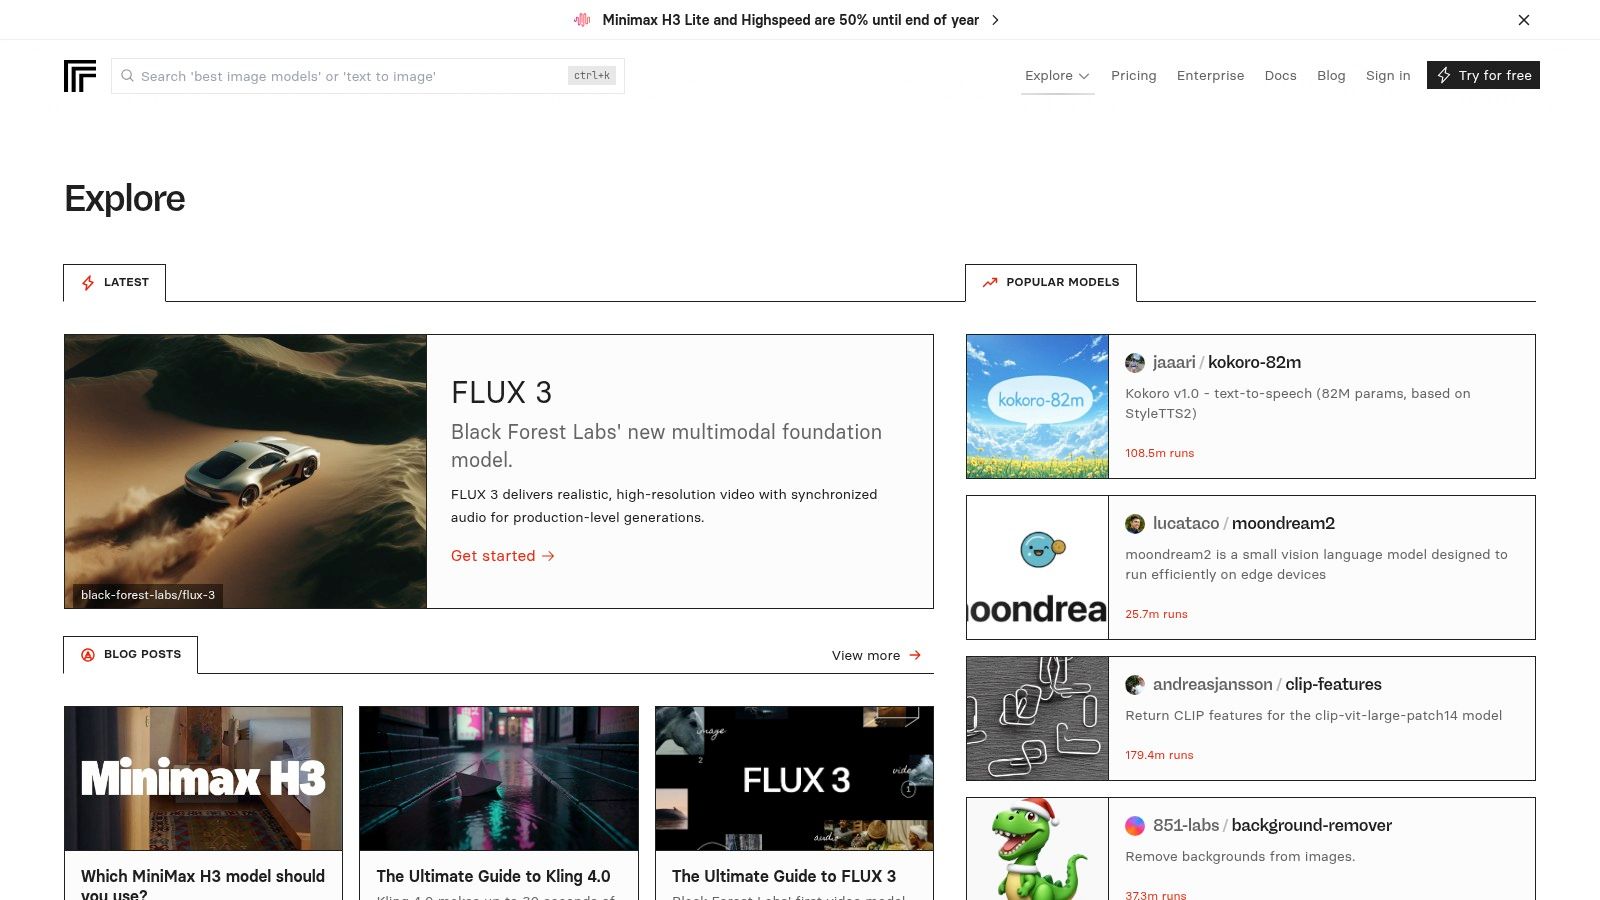
Menguji model video membutuhkan lebih dari sekadar membaca papan peringkat model bahasa. Anda perlu memeriksa input yang diterima, contoh output, kontrol generasi, dan bagaimana aplikasi mengambil hasil yang telah selesai.
Replicate Explore berguna untuk penemuan langsung ini, terutama untuk generasi gambar, video, dan audio. Halaman model dapat menyediakan contoh, definisi input, instruksi penggunaan, dan harga di samping jalur eksekusi yang di-hosting.
Uji dengan Materi Sumber Anda Sendiri
Untuk gambar-ke-video, gunakan gambar yang mewakili aplikasi Anda, bukan hanya contoh model yang sudah dipoles. Periksa konsistensi subjek, gerakan, komposisi, dan apakah output sesuai dengan instruksi. Untuk ucapan, uji nama, tanda baca, dan bahasa yang dikirimkan pengguna Anda.
- Kekuatan: Anda dapat bereksperimen tanpa perlu menyiapkan inferensi lokal terlebih dahulu.
- Fleksibilitas: Deployment kustom dapat menggunakan Cog, alat pengemasan Replicate.
- Keterbatasan: Model yang diterbitkan komunitas dapat berbeda dalam pemeliharaan, dokumentasi, dan dukungan.
Periksa apakah daftar tersebut resmi dan aktif dipelihara sebelum membangun di sekitarnya. Baca juga unit penagihan dengan cermat, karena harga model mungkin bergantung pada waktu proses (runtime) atau output yang dihasilkan, bukan perhitungan token gaya teks.
Replicate adalah pilihan yang kuat ketika Anda perlu melihat apakah model generatif dapat menghasilkan media yang dapat diterima. Kurang berguna sebagai peringkat tunggal yang dinormalisasi di seluruh modalitas yang tidak terkait: model ucapan dan model video membutuhkan kriteria penerimaan yang berbeda.
6. Microsoft Foundry Models
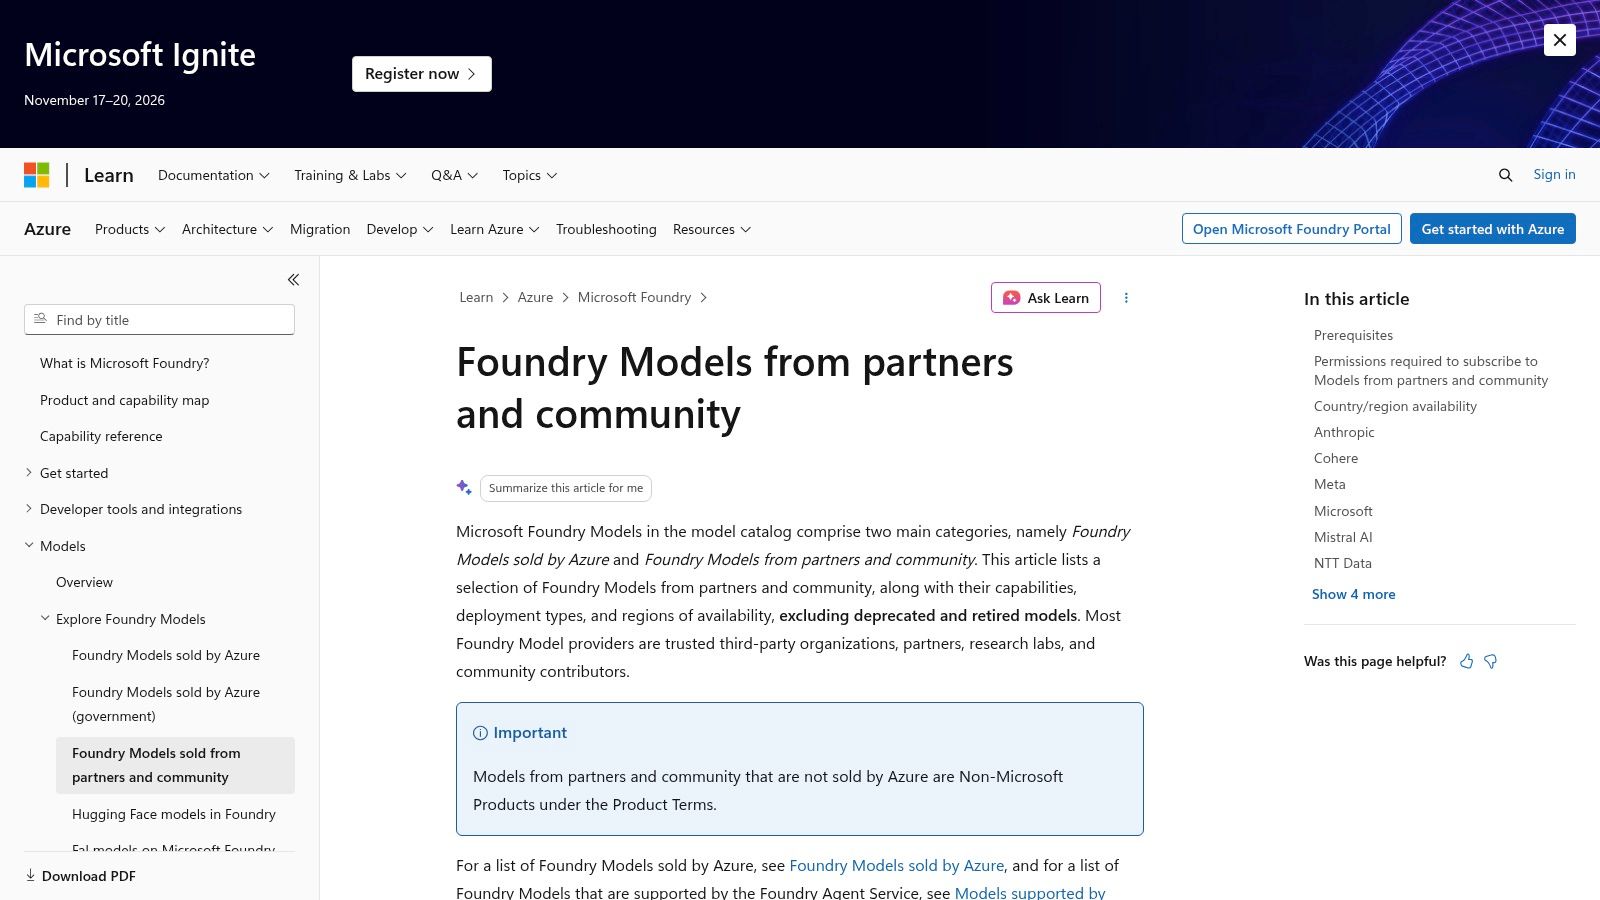
Untuk aplikasi berbasis Azure, kelayakan deployment bisa sama pentingnya dengan kapabilitas model. Kandidat yang menjanjikan tidak akan berguna jika metode deployment yang tersedia tidak sesuai dengan arsitektur atau wilayah operasional Anda.
Microsoft Foundry Models menghubungkan penemuan model dengan lingkungan cloud Microsoft. Katalog ini mencakup penawaran dari Microsoft, mitra, dan komunitas, dengan informasi yang relevan untuk tugas, kapabilitas, lisensi, dan pilihan deployment.
Pilih jalur deployment bersamaan dengan model
Model yang memenuhi syarat dapat memiliki opsi API-based, batch, provisioned, atau managed-compute yang berbeda. Jangan berasumsi bahwa menemukan model di katalog berarti setiap pendekatan hosting dan penagihan tersedia untuknya.
- Cocok untuk: Tim yang membutuhkan pemilihan model agar selaras dengan keputusan deployment Azure.
- Detail berguna: Informasi deployment spesifik model dan hasil benchmark terpilih.
- Batasan: Ketersediaan, metode deployment, dan harga dapat berbeda berdasarkan model dan wilayah.
Tim analisis dokumen harus menyelidiki dukungan input model dan konfigurasi endpoint yang akan di-deploy. Menguji demonstration endpoint tidak cukup jika produksi akan menggunakan pengaturan serving yang secara material berbeda.
Oleh karena itu, katalog ini adalah sumber daya arsitektur sekaligus alat penemuan. Gunakan ini ketika integrasi Azure adalah persyaratan yang sebenarnya, bukan karena model yang diinginkan kebetulan muncul di sana.
Untuk eksplorasi yang netral penyedia, alat perbandingan lintas-penyedia biasanya merupakan titik awal yang lebih bersih. Kembali ke Foundry saat Anda siap untuk menetapkan jalur deployment cloud yang praktis.
7. Katalog Model Amazon Bedrock
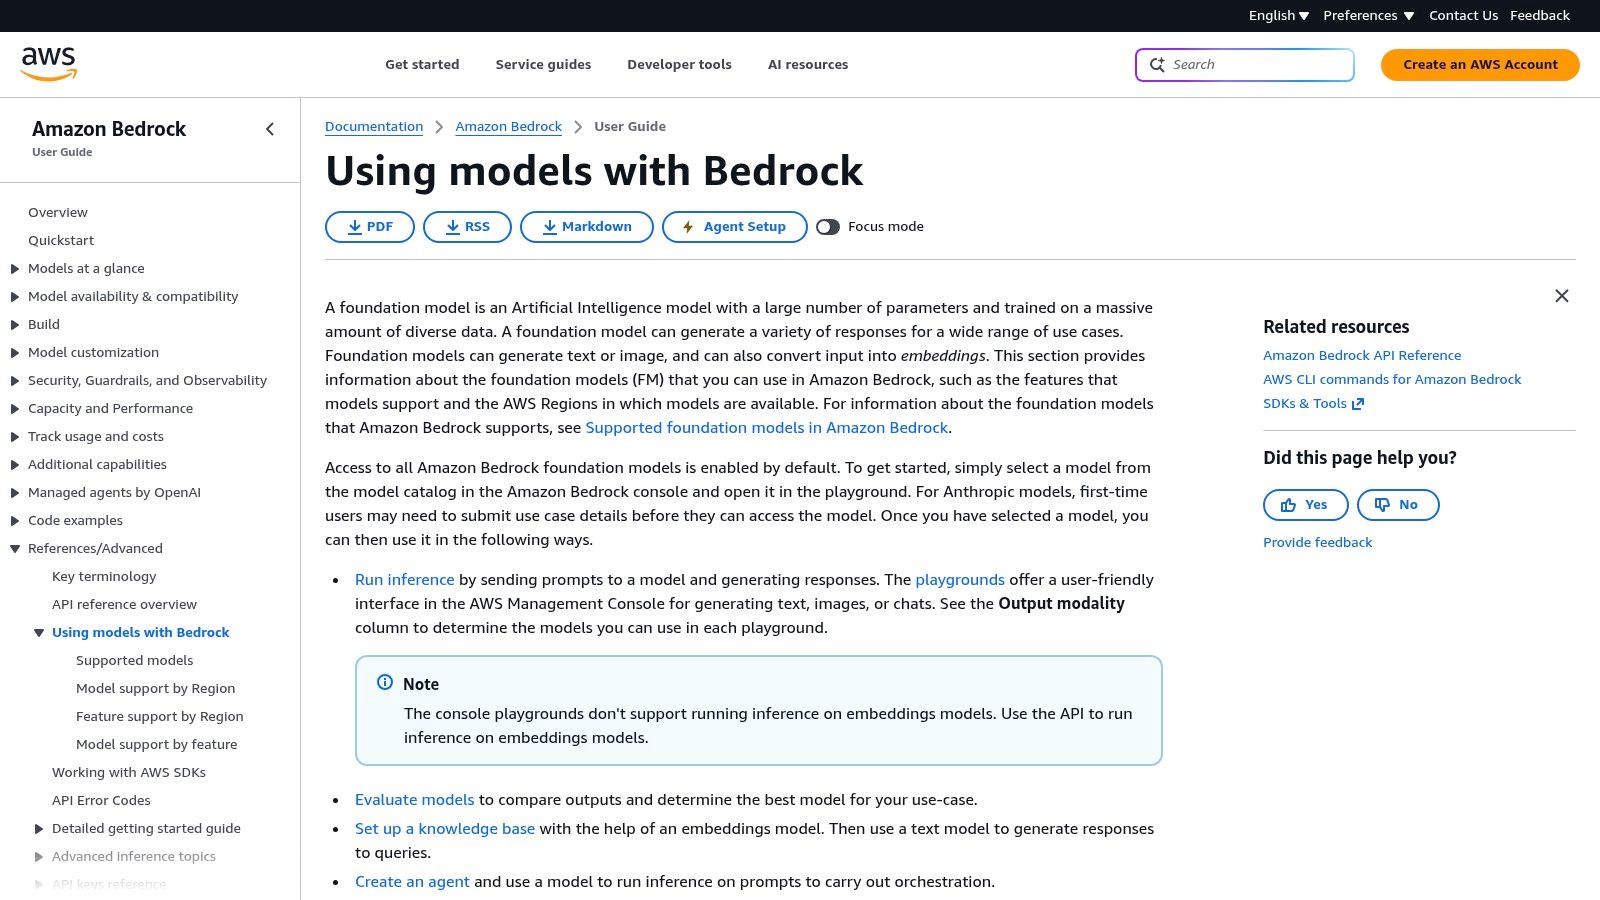
Periksa ketersediaan regional sebelum membangun prototipe. Itu adalah kebiasaan paling berguna saat menggunakan Katalog Model Amazon Bedrock untuk aplikasi AWS.
Katalog ini mengidentifikasi model dasar yang didukung dan kemampuannya. Tim dapat memeriksa ketersediaan regional dan menguji model yang memenuhi syarat di playground konsol Bedrock sebelum mengintegrasikannya ke dalam aplikasi berbasis AWS.
Pengadaan dan akses adalah bagian dari pilihan
Bedrock sangat relevan ketika aplikasi sudah beroperasi di dalam infrastruktur AWS. Namun, pengaturan akun dan akses regional dapat memengaruhi apakah model yang Anda inginkan dapat digunakan di lingkungan yang dituju.
- Yang berhasil: Beralih dari penemuan model yang didukung menuju deployment AWS.
- Yang perlu dikonfirmasi: Akses akun, wilayah yang dituju, input yang didukung, dan persyaratan pemanggilan.
- Yang bukan: Inventaris netral dari setiap model AI yang dapat diunduh atau tersedia secara komersial.
Untuk asisten dukungan, uji bagian pengambilan dan instruksi yang sama yang Anda rencanakan untuk dikirim dari produksi. Keberhasilan di playground menunjukkan bahwa sebuah permintaan dapat berfungsi; itu tidak menunjukkan bahwa retrieval pipeline, error handling, dan output parser Anda sudah benar.
Kekuatan Bedrock adalah koneksinya ke tumpukan aplikasi AWS. Orientasi yang sama menjadi batasan bagi tim yang hanya menginginkan survei luas opsi model tanpa berkomitmen pada integrasi khusus cloud.
Simpan catatan model dan konfigurasi akses yang tepat yang digunakan dalam evaluasi. Nama keluarga model yang dapat dikenali tidak cukup untuk mereproduksi keputusan deployment.
8. Google Cloud Model Garden
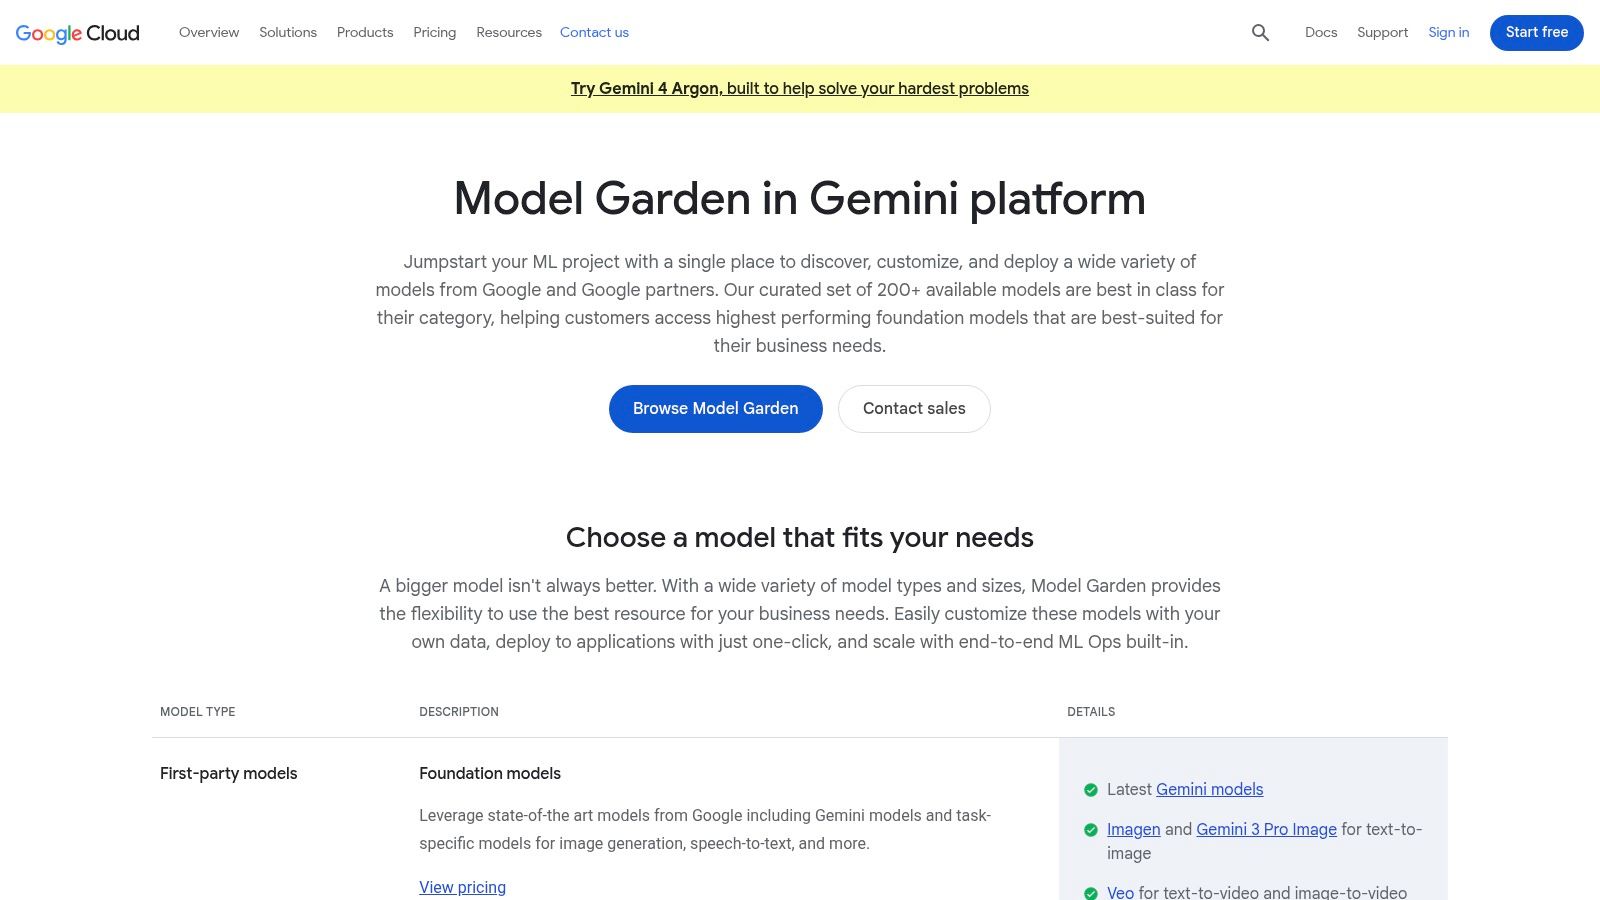
Tim yang membangun di Google Cloud harus mengevaluasi model dan pengaturan penyajiannya secara bersamaan. Menemukan keluarga model yang tepat hanyalah permulaan; konfigurasi deployment menentukan bagaimana model tersebut sesuai dengan aplikasi.
Google Cloud Model Garden menyediakan penemuan model dari Google, pihak ketiga, dan penawaran model terbuka dalam lingkungan AI Google Cloud. Ini paling berguna ketika langkah selanjutnya adalah pengembangan berbasis cloud, bukan mengunduh model untuk runtime lokal yang tidak terkait.
Pisahkan penemuan dari asumsi deployment
Periksa setiap penawaran secara individual sebelum memperkirakan biaya atau upaya implementasi. Ketersediaan dan harga bergantung pada model, wilayah, dan konfigurasi layanan, jadi entri katalog saja tidak cukup untuk menentukan kesesuaian produksi.
- Penggunaan terbaik: Menjelajahi model untuk aplikasi Google Cloud.
- Keuntungan: Penawaran dari Google dan pihak eksternal terpilih muncul dalam alur kerja penemuan yang berorientasi cloud yang sama.
- Keterbatasan: Kurang nyaman untuk survei yang netral penyedia atau eksperimen offline.
Untuk layanan analisis gambar, konfirmasikan format input yang diterima lalu uji pra-pemrosesan persis yang dilakukan aplikasi Anda. Resizing, cropping, dan konversi dokumen termasuk dalam evaluasi, bukan hanya dalam deployment akhir.
Jangan bingung Model Garden dengan daftar model Gemini API yang lebih sempit. Yang pertama membantu penemuan model cloud yang lebih luas; yang terakhir menyediakan detail pihak pertama untuk ekosistem API tertentu.
Gunakan Model Garden setelah tim Anda tahu bahwa Google Cloud adalah bagian dari rencana deployment. Jika tidak, mulailah dengan persyaratan model dan hindari membiarkan konsol cloud yang ada menentukan daftar pilihan terlalu dini.
9. Pustaka Ollama
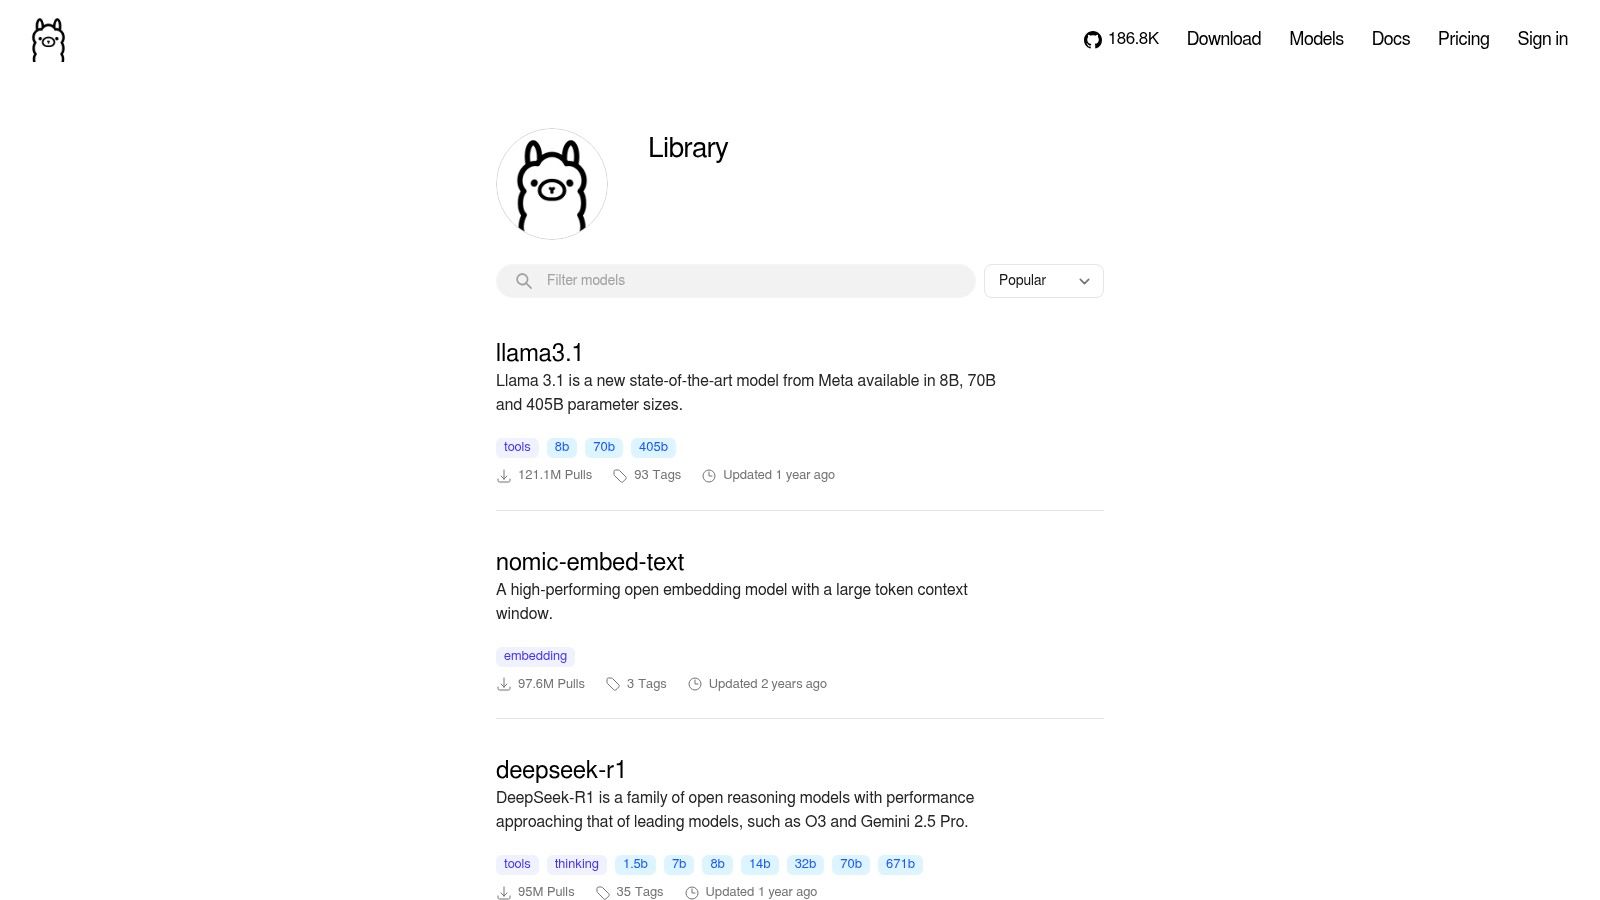
Jika persyaratannya adalah menjalankan model di mesin Anda sendiri, mulailah dengan katalog yang berorientasi runtime daripada marketplace API yang di-hosting. Pustaka Ollama](https://ollama.com/library) membantu pengguna menemukan model, ukuran, varian, dan kapabilitas yang didukung untuk alur kerja lokal Ollama.
Ukuran model adalah filter awal yang berguna, tetapi bukan perkiraan hardware yang lengkap. Penggunaan konteks, overhead runtime, dan aplikasi lain yang bersaing untuk memori juga memengaruhi apakah konfigurasi berjalan dengan nyaman.
Uji Mesin Sebenarnya
Pilih kandidat yang sesuai dengan hardware Anda, lalu ujilah dengan panjang input yang representatif. Model yang menangani prompt chat pendek mungkin menjadi tidak praktis saat Anda menambahkan dokumen yang diambil atau percakapan panjang.
Diskusi efisiensi AI Index Stanford](https://hai.stanford.edu/news/ai-index-2025-state-of-ai-in-10-charts) melaporkan bahwa Phi-3-mini, dengan 3.8 miliar parameter, mencapai ambang MMLU yang sama yang sebelumnya membutuhkan 540 miliar parameter PaLM. Perbandingan itu mendukung pelajaran praktis: jumlah parameter saja bukan peringkat kualitas.
- Kekuatan: Eksperimen yang mudah diakses dengan model yang dapat dijalankan secara lokal.
- Perbedaan Biaya: Eksekusi lokal menghindari biaya penggunaan API yang di-hosting, tetapi hardware dan operasi tetap membutuhkan biaya.
- Keterbatasan: Mesin Anda dan format yang didukung membatasi daftar pilihan.
Eksekusi lokal tidak secara otomatis menjadi sistem offline yang lengkap. Periksa apakah retrieval, logging, tools, dan komponen aplikasi lainnya juga tetap lokal.
Ollama adalah titik awal yang berguna untuk prototipe offline dan eksperimen yang dibatasi hardware. Ini tidak menghilangkan kebutuhan untuk memvalidasi kualitas, penggunaan memori, atau latensi end-to-end.
10. Daftar model API Google Gemini
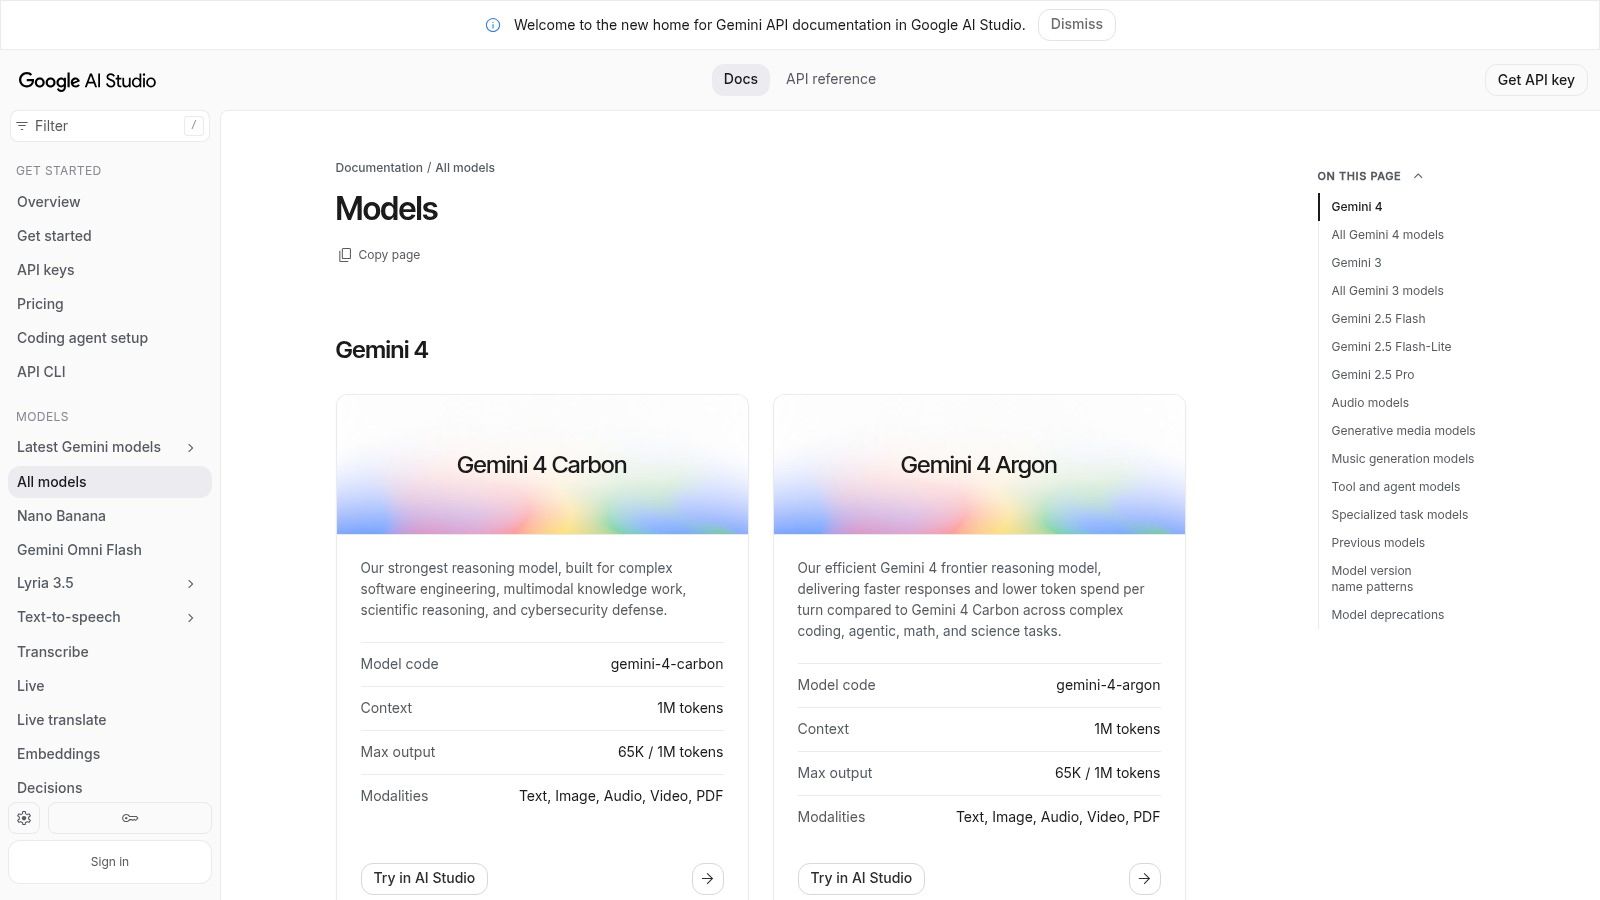
Terkadang, jalur yang benar adalah yang paling sempit. Jika Anda sudah memilih Gemini API, gunakan daftar model Gemini API resmi untuk mengonfirmasi pengidentifikasi model, deskripsi, dan kapabilitas yang didukung.
Ini adalah dokumentasi implementasi pihak pertama, bukan layanan perbandingan antar penyedia. Ini menghubungkan penemuan model dengan dokumentasi API dan Google AI Studio, menjadikannya berguna saat Anda perlu mengubah keluarga model yang dipilih menjadi permintaan yang berfungsi.
Verifikasi pengidentifikasi yang tepat
Jangan membangun berdasarkan nama keluarga model yang disalin dari artikel perbandingan. Konfirmasi pengidentifikasi spesifik dan periksa input, output, serta kondisi akses yang didukungnya sebelum mengintegrasikan.
- Kekuatan: Informasi model langsung untuk pengembang yang menggunakan Gemini API.
- Batasan cakupan: Ini tidak akan membantu Anda membandingkan setiap penyedia pesaing.
- Peringatan komersial: Periksa harga saat ini, tingkat akses, dan kondisi kelayakan model yang dipilih.
Untuk aplikasi terkait audio, verifikasi apakah model tertentu mendukung alur kerja audio yang diperlukan daripada berasumsi bahwa setiap model Gemini mengekspos fungsionalitas yang identik. Terapkan kehati-hatian yang sama pada input multimodal dan penggunaan alat.
Sertakan juga pemeriksaan siklus hidup dalam proses pemeliharaan Anda. Panduan penghentian Veo dan Gemini API](https://uberllm.dev/veo-3-1-gemini-api-shutdown) relevan saat meninjau dependensi endpoint dan pekerjaan migrasi.
Daftar resmi paling baik digunakan sebagai referensi implementasi setelah melakukan penyaringan awal. Ini menyediakan detail yang diperlukan untuk membuat permintaan yang valid, sementara evaluasi Anda sendiri menentukan apakah hasil yang dikembalikan memenuhi persyaratan produk.
Bagaimana 10 Katalog Model Berbeda berdasarkan Akses, Visibilitas Harga, dan Batasan
| Item | Terbaik Untuk | Model Akses | Visibilitas Harga | Batasan Utama |
|---|---|---|---|---|
| Katalog model AI UberLLM (Direkomendasikan) | Membandingkan model dari berbagai penyedia | API terpadu dan marketplace | Harga langsung terdaftar | Katalog tidak memprediksi kinerja spesifik beban kerja |
| OpenRouter | Membandingkan dan mengakses model dari berbagai penyedia | API yang di-host dengan satu kunci | Harga model ditampilkan; verifikasi tarif saat ini | API yang di-host, bukan bobot model yang dapat diunduh |
| Hugging Face Hub | Penelitian, kustomisasi, dan hosting mandiri | Unduhan model; hosting bervariasi | Harga tidak tercantum secara konsisten | Kualitas dan dokumentasi model bervariasi |
| Artificial Analysis | Membandingkan benchmark, biaya, dan kecepatan | Sumber daya penelitian dan perbandingan; API data | Harga API ditampilkan; beberapa akses mungkin berbayar | Benchmark mungkin tidak mencerminkan beban kerja Anda |
| Replicate Explore | Menguji dan menjalankan model generatif yang di-host | API model yang di-host dan deployment kustom | Harga spesifik model; dapat bervariasi berdasarkan penggunaan | Kualitas dan dukungan model komunitas bervariasi |
| Microsoft Foundry Models | Memilih model untuk aplikasi Azure | Opsi deployment Azure | Bervariasi berdasarkan model dan wilayah | Paling cocok untuk pengguna Azure |
| Katalog model Amazon Bedrock | Menemukan model untuk aplikasi AWS | Layanan Bedrock di dalam AWS | Bervariasi berdasarkan model dan wilayah | Akses tergantung AWS dan wilayah |
| Google Cloud Model Garden | Menemukan model untuk deployment Google Cloud | Layanan AI Google Cloud | Bervariasi berdasarkan model dan konfigurasi | Berorientasi pada Google Cloud |
| Ollama Library | Menjalankan model secara lokal | Inferensi lokal dengan Ollama | Tidak ada harga hosting; menggunakan perangkat keras Anda | Membutuhkan pengaturan dan perangkat keras yang sesuai |
| Daftar model API Google Gemini | Membangun dengan model Google | API Gemini dan Google AI Studio | Halaman harga terpisah; tingkatan bervariasi | Hanya mencakup model Google |
Mengubah Daftar Pilihan Menjadi Integrasi yang Berfungsi
Berhentilah mencari setelah Anda memiliki dua atau tiga model yang masuk akal per modalitas. Lebih banyak kandidat tidak akan membantu jika tim Anda belum mendefinisikan seperti apa hasil yang dapat diterima. Catat panjang konteks yang diperlukan, batas keluaran, dukungan alat, format masukan, dan batasan penerapan sebelum menjalankan perbandingan.
Kemudian kirimkan prompt atau tugas generasi yang sama melalui setiap kandidat. Untuk ekstraksi teks, validasi skema yang dikembalikan dan bandingkan nilai yang diekstraksi dengan jawaban yang diharapkan. Untuk pengkodean, jalankan pengujian terhadap perubahan yang dihasilkan; untuk media, tinjau keluaran berdasarkan ringkasan yang konsisten daripada memilih sampel mana pun yang terlihat paling mengesankan.
Evaluasi jalur aplikasi secara lengkap
Sertakan pekerjaan di sekitar inferensi. Konversi dokumen, pengambilan, eksekusi alat, polling, percobaan ulang, dan validasi keluaran semuanya dapat menentukan apakah model yang sebenarnya mampu dapat digunakan.
- Kualitas: Catat hasil yang diterima, bukan hanya permintaan yang selesai.
- Latensi: Ukur respons awal dan penyelesaian ujung-ke-ujung jika relevan.
- Biaya: Sertakan percobaan ulang, generasi yang ditolak, dan panggilan tindak lanjut yang diperlukan.
- Keandalan: Latih batas waktu, keluaran yang salah format, dan endpoint yang tidak tersedia.
Diskusi Brookings tentang evaluasi model AI menjelaskan mengapa skor benchmark dapat mengabaikan masalah praktis seperti latensi, persyaratan komputasi, biaya, dan keamanan. Evaluasi Anda harus membuat masalah tersebut eksplisit alih-alih memperlakukan papan peringkat publik sebagai uji penerimaan produksi.
Untuk tim yang menginginkan satu endpoint di seluruh alur kerja teks, gambar, video, dan audio, mulailah integrasi UberLLM dengan mengatur base URL di konfigurasi SDK OpenAI atau Anthropic Anda yang sudah ada ke API endpoint yang kompatibel. Gunakan UberLLM key dan pertahankan antarmuka SDK yang ada serta kode di sekitarnya, lalu ganti kandidat dengan mengubah pengidentifikasi model. Validasi parameter yang didukung setiap kandidat, dan gunakan alur kerja tugas asinkron yang sesuai untuk media daripada berasumsi setiap modalitas berperilaku seperti respons chat streaming.
Jaga agar keputusan dapat direproduksi
Simpan pengidentifikasi model, versi prompt, pengaturan generasi, masukan evaluasi, dan hasil penerimaan secara bersamaan. Catatan tersebut memungkinkan insinyur lain mengulangi pengujian dan membuat perubahan model di kemudian hari lebih mudah dinilai. Hindari mengandalkan tangkapan layar tanpa versi atau kesan kualitas keluaran yang diingat.
Pilih model default dan definisikan kapan aplikasi harus melakukan eskalasi atau gagal dengan aman. Fallback hanya berguna jika memenuhi persyaratan esensial yang sama, termasuk batasan privasi dan dukungan alat. Daftar model AI terbaik adalah yang membantu Anda mencapai keputusan integrasi yang dapat dipertahankan, lalu membuka jalan bagi pengujian yang dapat diulang.
UberLLM menghubungkan developer ke model teks, gambar, video, musik, dan ucapan pihak ketiga melalui API terpadu dan saldo prabayar. Kunjungi UberLLM untuk membandingkan batas model dan harga langsung, menguji daftar pilihan Anda di playground, dan mengintegrasikan kandidat yang memenuhi persyaratan aplikasi Anda.