Unduh Teks ke Suara: Hasilkan dan Simpan Audio dalam 2026
Panduan unduh teks ke suara: hasilkan audio dari teks, simpan sebagai MP3 atau WAV, periksa file, dan konfirmasi Anda memiliki hak untuk menggunakannya.
Anda sudah punya naskah siap, tenggat waktu hari ini, dan alat yang memutar suara dengan sempurna di browser Anda. Lalu Anda mengunduhnya, dan file tersebut tidak bisa dibuka, terpotong di tengah jalan, atau tidak bisa secara hukum digunakan dalam video yang Anda buat. Celah itulah tempat sebagian besar masalah unduhan teks ke suara berada. Perlakukan unduhan tersebut sebagai aset audio yang sudah jadi, bukan trik browser, dan Anda akan menemukan masalah-masalah itu selagi masih murah untuk diperbaiki.
Daftar Isi
- Pilih Cara yang Tepat untuk Mendapatkan File Audio Anda
- Memilih MP3, WAV atau Format Lain
- Cara Membuat dan Mengunduh File Audio Pertama Anda
- Memperbaiki Unduhan yang Tidak Bisa Diputar atau Suaranya Salah
- Apakah Anda Bisa Menerbitkan Audio yang Diunduh
- Jalankan Unduhan Uji Coba Sebelum Anda Berkomitmen
Pilih Cara yang Tepat untuk Mendapatkan File Audio Anda
Mulailah dengan satu pertanyaan. Apakah Anda memerlukan file tersimpan yang dapat Anda simpan, edit, dan pindahkan, atau Anda hanya perlu teks diucapkan di layar saat ini? Itu adalah pekerjaan yang berbeda, dan alat yang bagus untuk satu pekerjaan seringkali tidak cocok sama sekali untuk yang lain.
Alat web adalah yang tercepat untuk satu narasi karena tidak ada yang perlu diinstal. Aplikasi desktop sangat berguna ketika Anda mengonversi dokumen setiap minggu dan menginginkan suara, struktur folder, dan pengaturan yang sama setiap kali. API membalikkan cara kerja. Kode Anda mengirim teks, menerima audio bytes dalam response, dan menyimpan file di mana pun aplikasi Anda membutuhkannya. Itu adalah bentuk yang tepat untuk audio per pengguna, dan bentuk yang salah untuk satu intro podcast.
Cara Mendapatkan File Text-to-Speech
| Metode | Output umum | Bekerja offline | Terbaik untuk |
|---|---|---|---|
| Alat web TTS online dengan tombol unduh | MP3 atau WAV | Tidak | Narasi sekali pakai dan voiceover cepat |
| Aplikasi TTS desktop | MP3 atau WAV | Ya, setelah suara diinstal | Batch dokumen yang dikonversi secara teratur |
| Panggilan API Text-to-speech | Audio bytes dalam response, format diatur dalam request | Tidak | Aplikasi yang membuat audio untuk setiap pengguna |
| Model open-source yang dijalankan secara lokal | WAV atau format yang ditulis kode Anda | Ya | Teks sensitif dan alur kerja offline |
| Pembaca layar sistem operasi | Biasanya tidak ada file tersimpan | Ya | Mendengarkan daripada menghasilkan file |
Model open-source lokal cocok untuk draf rahasia, materi klien, dan pekerjaan tanpa koneksi yang andal. Ada konsekuensi yang nyata. Anda akan membutuhkan ruang disk untuk model dan file suara, mesin yang dapat merender dengan kecepatan yang dapat digunakan, dan waktu untuk mengaturnya serta menjaganya tetap terbaru. Privasi juga tidak otomatis hanya karena sintesisnya lokal. Periksa apakah aplikasi masih mengirim analytics, crash reports, atau file referensi suara ke mana pun.
Pembaca layar berada dalam kategori yang berbeda. Mereka dibuat untuk mendengarkan dan navigasi, jadi sebagian besar mengucapkan teks tanpa menyimpan file portabel. Jika hasil akhir Anda adalah MP3 yang dapat diputar orang lain nanti, pembaca layar tidak menyelesaikan masalah Anda.
Aturan praktis: Jika Anda akan menghasilkan suara yang sama lebih dari beberapa kali seminggu, pilih akses batch atau API daripada menempelkan ke formulir web berulang kali.
Sebelum Anda berkomitmen pada suatu jalur, bandingkan suara dan perilaku model dalam panduan model text-to-speech ini, lalu uji skrip Anda yang sebenarnya. Suara yang terdengar halus pada kalimat demo pendek masih bisa tersandung pada nama produk, harga, dan akronim Anda.
Memilih MP3, WAV atau Format Lain
Format menentukan tiga hal sekaligus: ukuran file, fleksibilitas pengeditan, dan kompatibilitas. Pilih sekali per proyek, sebelum Anda merender, karena mengonversi setelahnya akan membuang ruang atau mengurangi kualitas.
MP3 dan AAC bersifat lossy. Mereka membuang detail audio agar ukurannya kecil, dan setiap re-encode membuang sedikit lebih banyak. Itu tidak masalah untuk file jadi yang akan diputar di pemutar. Itu pilihan yang buruk untuk master yang akan Anda potong, ratakan, campur dengan musik, dan ekspor lagi. WAV mempertahankan sinyal penuh, itulah sebabnya editor lebih menyukainya, dan mengapa narasi panjang menjadi cepat berat. FLAC juga lossless dan lebih kecil dari WAV, tetapi Anda masih akan menemukan pemutar, formulir unggah, dan perangkat lama yang menolaknya.
Format Audio dan Komprominya
| Format | Ukuran per menit | Terbaik untuk | Perhatikan |
|---|---|---|---|
| MP3 | Sekitar 1 MB pada 128 kbps | Berbagi, podcast, pemutaran web | Lossy, jadi re-encoding mengurangi kualitas |
| WAV | Sekitar 2.6 MB mono pada 22.05 kHz, sekitar 10.6 MB untuk stereo kualitas CD | Pengeditan, pengarsipan, salinan master | File besar, narasi stereo sepuluh menit bisa mencapai sekitar 100 MB |
| M4A atau AAC | Sekitar 1 MB pada 128 kbps | Perangkat Apple dan aplikasi seluler | Beberapa alat pengeditan kurang mudah menerimanya |
| FLAC | Kira-kira setengah dari WAV, bervariasi dengan konten | Arsip lossless | Tidak setiap pemutar mendukungnya |
Ukuran lebih penting dari yang orang duga. Sulih suara singkat tidak masalah dalam format apa pun. Kursus pelatihan yang panjang, kumpulan bab buku audio, atau pustaka prompt yang dihasilkan mengubah perbedaan per menit itu menjadi biaya penyimpanan, waktu unggah, dan pencadangan.
Kompatibilitas sama pentingnya bagi pendengar. Simpan konten lisan dalam format yang didukung secara luas, beri label format dengan jelas, dan pastikan file dapat diputar tanpa aplikasi yang membuatnya. Unduhan yang tidak dapat dibuka audiens Anda di ponsel tidak dapat diakses, berapa pun kualitas suaranya.
Pilihan ini adalah kemewahan baru-baru ini. Ucapan yang dapat diunduh hanya menjadi praktis setelah synthesizer perangkat lunak dapat menghasilkan ucapan yang cukup dimengerti dalam waktu hampir nyata, sebuah poin yang sejarah teknologi text-to-speech blog ANSI tempatkan pada akhir tahun 1980-an. Sebelum itu, Anda tidak memilih codec. Anda memilih perangkat keras.
Saya akan menyederhanakannya. Unduh WAV sebagai salinan master Anda, lalu ekspor MP3 untuk distribusi. Anda mengedit dari file yang tidak kehilangan apa pun, dan pendengar Anda mendapatkan file yang dapat diputar di mana saja.
Cara Membuat dan Mengunduh File Audio Pertama Anda
Teks bersih masuk, file terverifikasi keluar. Sebagian besar unduhan yang buruk ditentukan sebelum Anda menekan tombol buat, oleh teks yang tidak dibersihkan dan pengaturan yang tidak diatur dengan sengaja.
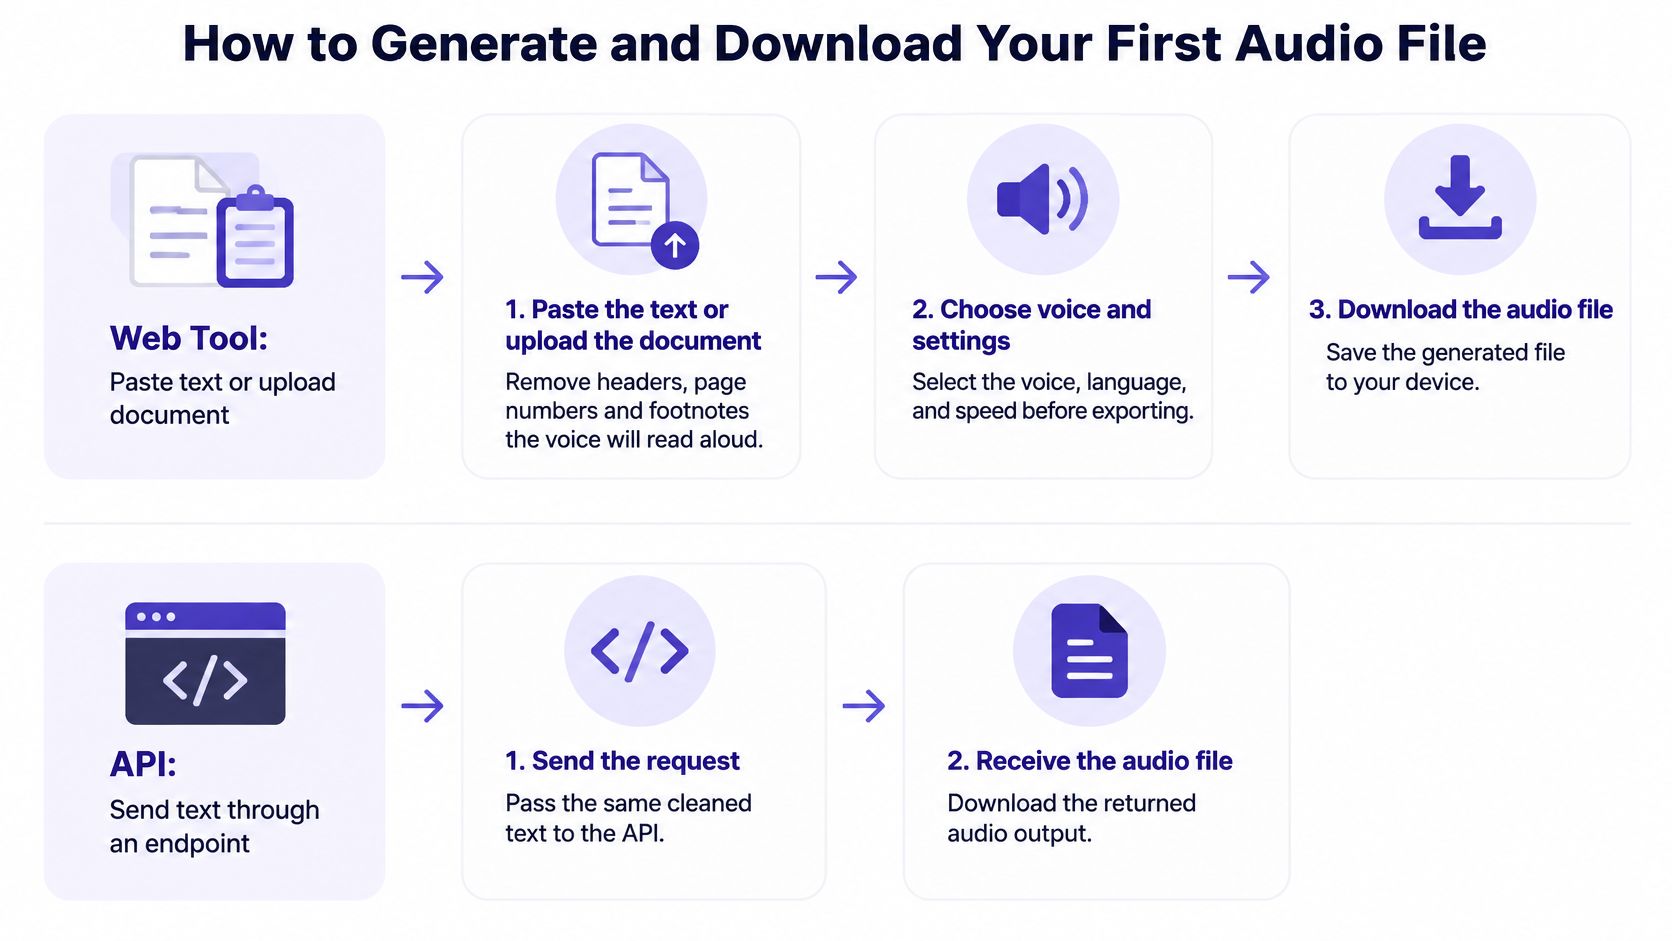
Menggunakan Alat Web
- Tempel teks atau unggah dokumen. Hapus header, nomor halaman, catatan kaki, sisa tabel, dan URL yang tidak ingin Anda bacakan. Suara akan membaca apa yang ada di sana, termasuk footer.
- Pilih bahasa, suara, dan lokal secara eksplisit. Lokal mengontrol bagaimana tanggal, mata uang, dan angka terdengar. Jangan biarkan alat menebak dari pengaturan browser Anda.
- Biarkan kecepatan pada pengaturan default untuk percobaan pertama Anda. Kecepatan yang lebih tinggi sering kali mengaburkan konsonan dan menelan kata-kata pendek. Sesuaikan hanya setelah Anda mendengar dasar yang bersih.
- Buat sampel singkat terlebih dahulu, sekitar 30 detik. Dengarkan sampai selesai. Ini menangkap suara yang salah, aksen yang salah, atau nama yang salah sebelum Anda membayar untuk merender seluruh skrip.
- Pilih format output untuk pekerjaan tersebut. Pilih WAV jika Anda akan mengedit, MP3 jika file sudah selesai dan akan didengarkan oleh pendengar.
- Unduh dan ganti namanya segera. Gunakan proyek, suara, dan tanggal dalam nama file. Folder yang penuh dengan file bernama output.mp3 tidak dapat dilacak dalam seminggu.
Menggunakan API
Rute API mengikuti logika yang sama dalam kode. Dapatkan key dari penyedia Anda, lalu kirim POST request dengan model, input text, voice, dan format respons yang Anda inginkan. Tulis byte yang dikembalikan ke file dengan ekstensi yang cocok dengan format tersebut. Meminta satu format dan menyimpan dengan ekstensi lain adalah cara Anda membuat file yang tidak akan dibuka oleh pemutar mana pun.
Dua detail praktis menghemat masalah di kemudian hari. Pertama, stream respons ke disk untuk render yang panjang alih-alih menahan semuanya di memory. Kedua, simpan pengaturan request di samping file, termasuk model dan voice identifier, locale, sample rate, dan tanggal. Ketika klien meminta satu paragraf direkam ulang sebulan kemudian, catatan itulah cara Anda mencocokkan yang asli.
Saat akses, rencanakan kredensial. Pay-per-request berfungsi untuk chat melalui POST /v1/chat/completions dan POST /v1/messages, sementara gambar, video, musik, dan speech masih memerlukan key. Jadi, bangun penyimpanan dan rotasi key ke dalam workflow speech Anda sejak awal, bukan sebagai tambalan.
File pertama yang baik tidak memiliki kata pertama atau terakhir yang terpotong, jeda yang jelas di akhir kalimat, dan durasi yang mendekati apa yang Anda harapkan untuk jumlah kata.
Periksa durasi sebelum hal lain. Jika sampel Anda seharusnya berjalan sekitar 30 detik dan file menunjukkan empat detik, ada yang salah, dan tidak ada jumlah pendengaran yang akan memperbaikinya. Buat ulang sampel, bukan seluruh dokumen, sampai versi singkatnya benar.
Memperbaiki Unduhan yang Tidak Bisa Diputar atau Suaranya Salah
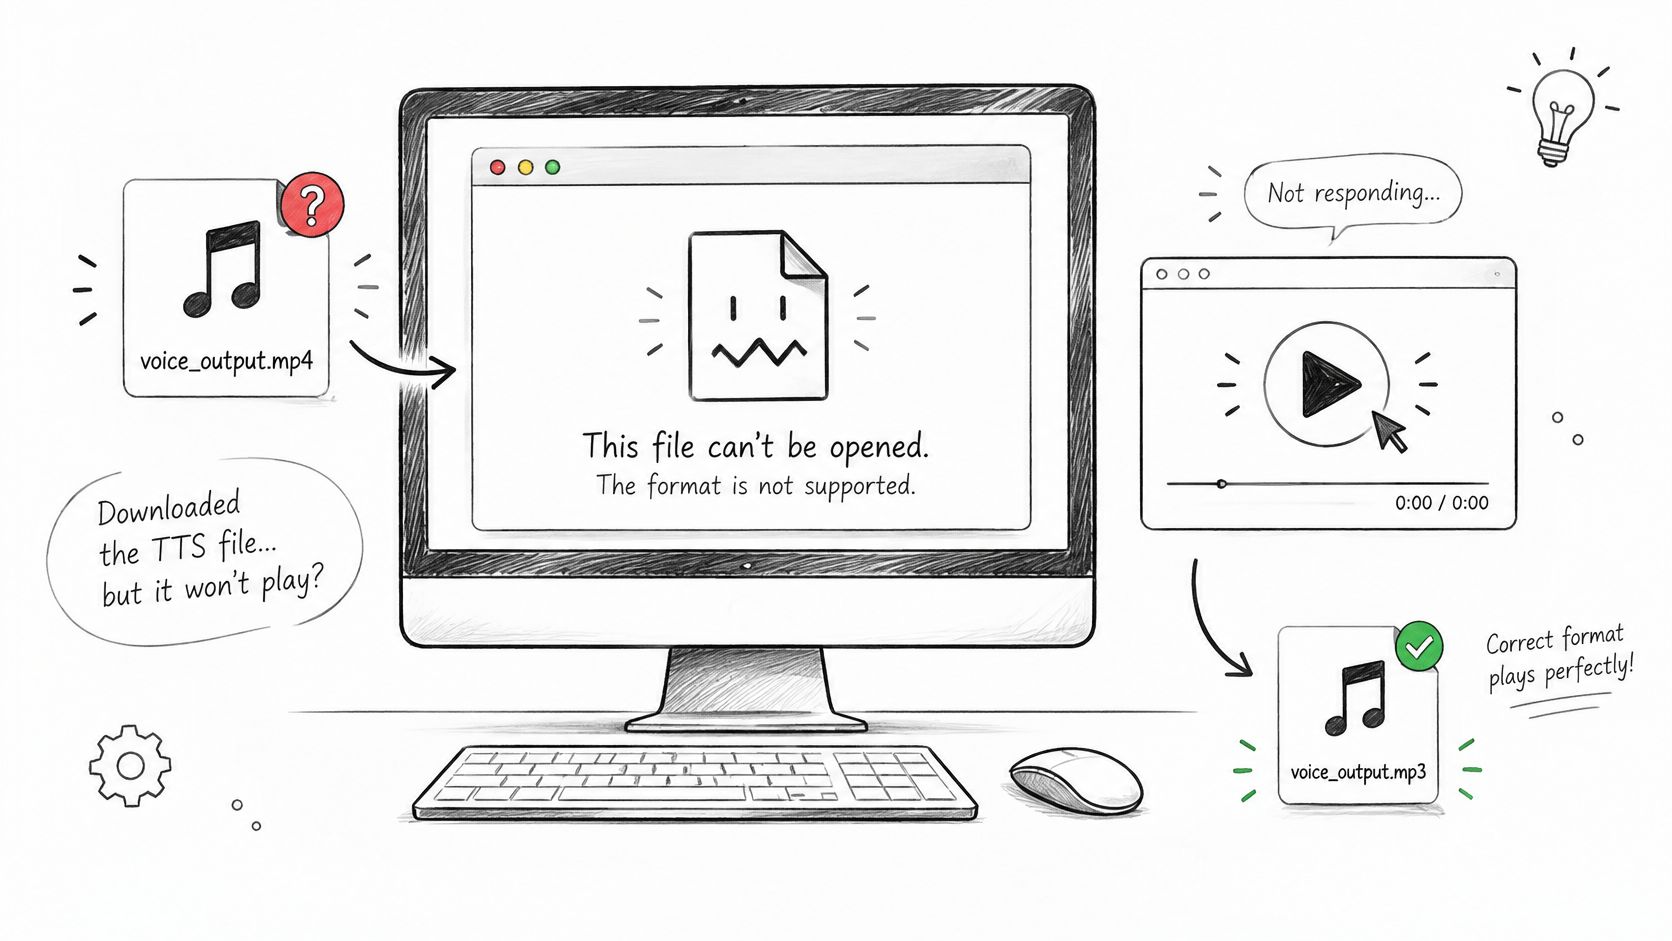
Kegagalan yang paling umum adalah hal yang sepele. File terunduh, terlihat normal, dan tidak bisa dibuka karena audio mentah atau yang dienkode secara berbeda disimpan dengan ekstensi yang tidak sesuai dengan isinya. Pemutar mempercayai ekstensi tersebut, lalu gagal pada byte di dalamnya.
Masalah Unduhan, Penyebab, dan Perbaikannya
| Gejala | Kemungkinan penyebab | Perbaikan |
|---|---|---|
| File tidak bisa dibuka | Audio mentah disimpan dengan ekstensi yang salah | Simpan dengan ekstensi yang sesuai dengan format yang diminta |
| Audio berhenti sebelum selesai | Respons streaming terpotong | Bandingkan durasi dengan panjang yang diharapkan dan unduh lagi |
| Hening atau statis | Sample rate atau encoding tidak didukung oleh pemutar | Buat ulang dalam MP3 atau WAV dengan sample rate standar |
| Kata-kata terlewat atau tergabung | Teks panjang terpotong di tengah kalimat | Pisahkan input pada batas kalimat dan buat ulang |
| Angka atau akronim dibaca salah | Teks tidak dinormalisasi sebelum sintesis | Tuliskan tanggal, mata uang, dan akronim sebelum membuat |
| Aksen atau bahasa salah | Locale tidak diatur | Atur bahasa dan locale secara eksplisit dalam permintaan |
Kerjakan tabel ini berdasarkan urutan upaya. Mengganti nama file ke ekstensi yang benar dan mengatur locale hanya butuh beberapa menit. Streaming yang terpotong memerlukan unduhan baru dan pemeriksaan jumlah byte atau durasi. Kata-kata yang terlewat dan pembacaan angka yang salah memerlukan perbaikan teks dan pembuatan ulang audio, karena tidak ada pengaturan pemutar yang akan mengembalikan kata-kata yang tidak pernah disintesis dengan benar.
Tiga pemeriksaan ini dapat mengatasi sebagian besar masalah sebelum publikasi. Pastikan file dapat didekode dan memiliki durasi bukan nol yang kira-kira sesuai dengan harapan Anda. Putar di dua perangkat, idealnya laptop dan ponsel. Kemudian transkripsikan dengan alat speech-to-text apa pun dan bandingkan kata-katanya dengan teks sumber Anda, perhatikan angka dan nama dengan cermat.
Pendekatan berlapis itu sesuai dengan praktik evaluasi formal. Sebuah makalah benchmark tentang evaluasi ucapan sintetis menyatukan sampel uji sebagai 16-kHz WAV sebelum penilaian dan menggunakan pemeriksaan terpisah untuk integritas file, kejelasan, dan kualitas persepsi. Anda tidak memerlukan ketelitian penuh itu untuk satu sulih suara, tetapi tirulah prinsipnya. Respons unduhan yang berhasil tidak membuktikan bahwa Anda memiliki ucapan yang dapat digunakan, jadi periksa audionya sendiri, bukan kode statusnya.
Pisahkan juga ambang batas Anda. Sebuah file dapat diunduh dengan andal, terdengar menyenangkan, dan masih salah membaca harga. Catat transportasi, kejelasan, dan kealamian sebagai hasil yang berbeda, dan Anda akan tahu perbaikan mana yang harus diterapkan daripada membuat ulang secara acak.
Apakah Anda Boleh Memublikasikan Audio yang Diunduh
Berikut adalah asumsi yang harus dihilangkan: sebuah file di hard drive Anda tidak secara otomatis menjadi milik Anda untuk dipublikasikan, dijual, atau didistribusikan ulang. Kemampuan untuk mengekspor audio dan memiliki hak untuk menggunakannya adalah dua hal yang berbeda, dan panduan unduh yang berhenti pada tombol simpan membuat Anda menanggung risiko tersebut.
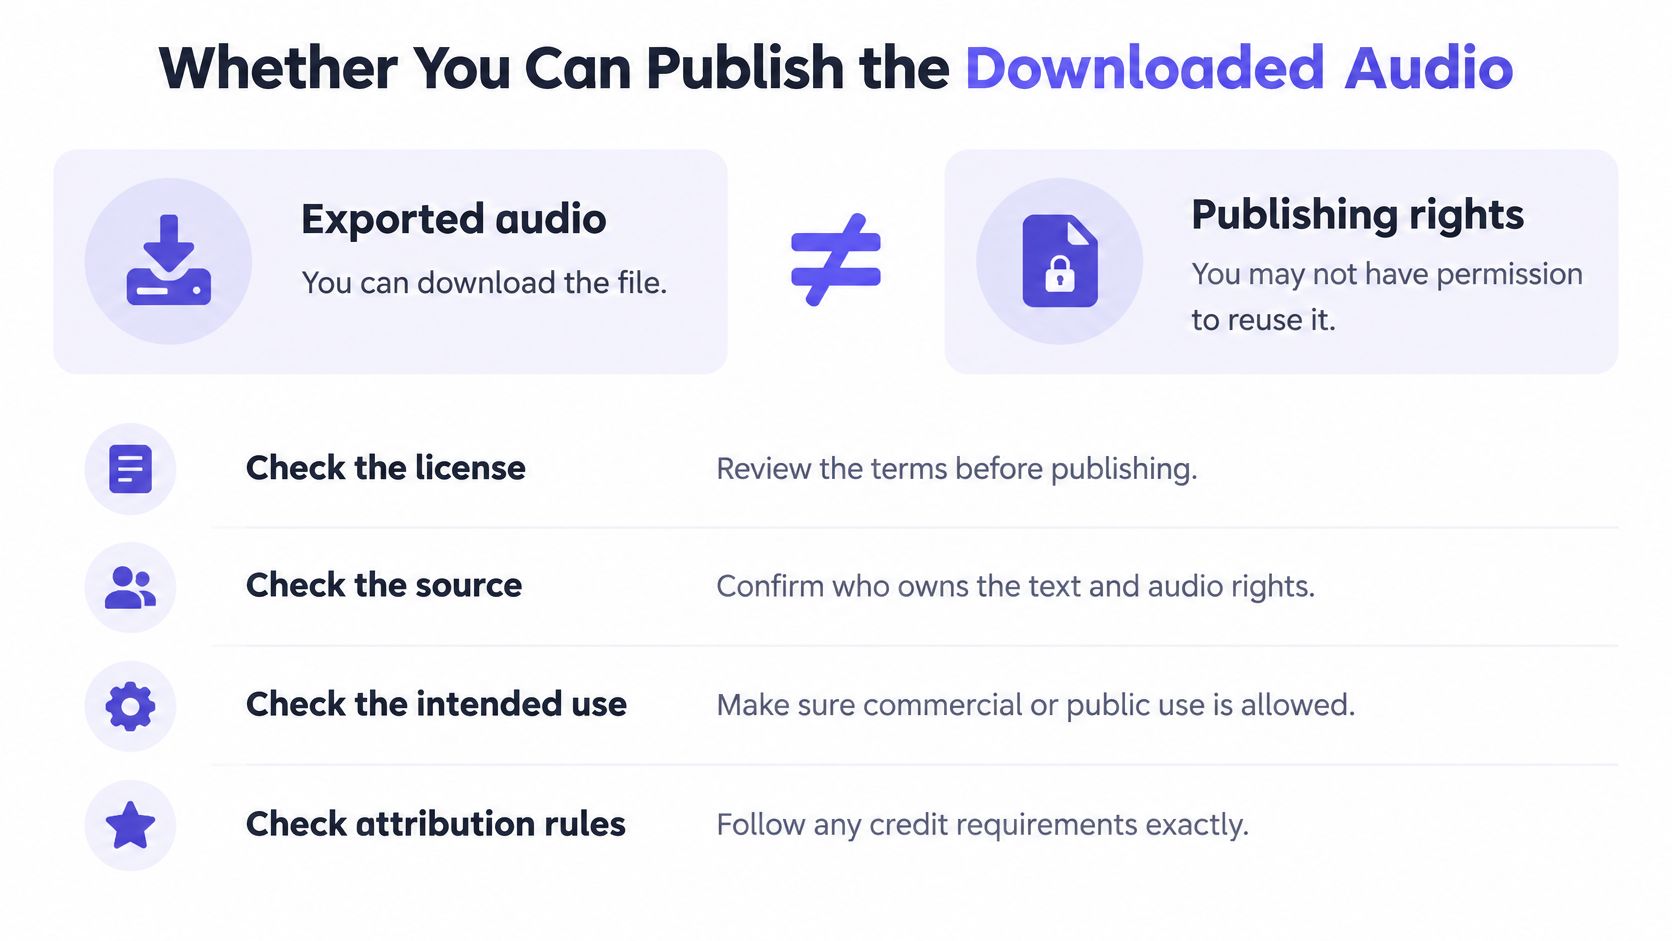
Periksa hal-hal berikut sebelum file dipublikasikan:
- Tingkat dan ketentuan Anda: Konfirmasikan apakah penggunaan komersial diizinkan pada paket Anda, bukan hanya penggunaan pribadi. Tingkat gratis sering kali membatasi penggunaan yang dimonetisasi.
- Jenis suara: Suara bawaan (prebuilt voice) dan suara kloning (cloned voice) memiliki kewajiban yang berbeda. Kloning memerlukan persetujuan dari orang yang ditirunya.
- Hak input Anda: Anda memerlukan hak atas teks yang Anda konversi, tidak hanya atas audio yang dihasilkan.
- Pengungkapan: Putuskan apakah pasar atau platform Anda mengharuskan Anda untuk melabeli ucapan sintetis, dan tambahkan label tersebut sebelum memublikasikan.
Tanggung jawab itu ada pada Anda. Catatan transparansi text-to-speech Microsoft menempatkan tanggung jawab pada pengguna untuk mengamankan hak atas teks input, bakat suara, kemiripan, dan materi sumber lainnya, sementara output suara bawaan berbayar (paid prebuilt-voice) umumnya dapat digunakan secara komersial berdasarkan ketentuan yang berlaku. Bacalah ketentuan penyedia Anda sendiri dengan pemahaman tersebut daripada berasumsi bahwa semuanya sama.
Unduhan open-source menambahkan lapisan kedua. Code dan model weights dapat memiliki lisensi terpisah, dan salah satunya dapat membatasi penggunaan komersial, redistribusi, atau penawaran model sebagai layanan yang di-host. Periksa keduanya, ditambah lisensi pada data suara apa pun yang Anda fine-tune dari.
Simpan bukti selagi mudah. Simpan ketentuan paket atau lisensi yang berlaku pada tanggal unduh, nama dan versi suara, pengaturan permintaan Anda, dan tanggalnya sendiri. Catatan ini paling penting ketika file berpindah ke pengecer, platform iklan, atau saluran klien, karena ketentuan asli tidak ikut serta di dalam MP3. Jika narasi Anda akan berada di dalam video, selesaikan pertanyaan asal-usul yang sama untuk aset jadi menggunakan panduan untuk mendapatkan video ini sebelum Anda mengunggah ke mana pun.
Jalankan Unduhan Uji Coba Sebelum Anda Berkomitmen
Anda dapat menentukan format, suara, dan hak dalam satu sore dengan satu sampel yang menantang. Jangan gunakan teks demo yang mudah. Gunakan teks yang bisa gagal.
1. Tempel sekitar 1,000 karakter yang mencakup angka, nama pribadi, tanggal, dan akronim.
2. Hasilkan dalam WAV dan MP3 dengan suara dan pengaturan yang sama, lalu bandingkan kedua file.
3. Putar masing-masing di ponsel dan laptop dan periksa durasinya terhadap ekspektasi Anda.
4. Transkripsikan satu file dan bandingkan kata-katanya dengan sumber Anda, catat setiap angka yang salah dibaca.
5. Simpan uji coba di samping bukti lisensi Anda, beri label dengan nama suara, format, dan tanggal.
Harga pekerjaan penuh dari sampel tersebut sebelum Anda melakukan penskalaan. Dengan tarif contoh yang telah dihitung di mana Qwen3 0.6B TTS berharga $0.035 per 1K karakter, dibandingkan dengan harga daftar $0.0875 per 1K karakter, uji coba 1,000 karakter Anda berharga $0.035, atau 3.5 sen. Kalikan dengan panjang skrip Anda yang sebenarnya dan Anda memiliki anggaran, bukan tebakan. Bandingkan suara kandidat dengan cara yang sama, termasuk model seperti [ElevenLabs TTS v4``](https://uberllm.dev/models/elevenlabs/elevenlabs-tts-v4), menggunakan teks uji yang identik.
Jika sampel gagal, perbaiki penyebab spesifiknya dan jalankan kembali sampel tersebut. Uji coba yang gagal hampir selalu menunjukkan satu pengaturan, satu angka yang tidak dinormalisasi, atau satu ekstensi yang salah. Setelah kedua format lolos dan pemeriksaan hak Anda berlaku, render teks lengkapnya dan simpan file uji coba sebagai referensi Anda untuk setiap render di masa mendatang.
Siap untuk menghasilkan file terverifikasi pertama Anda alih-alih merender ulang file yang rusak yang sama? UberLLM memberi Anda model teks, gambar, video, musik, dan ucapan melalui satu API, sehingga Anda dapat menguji suara, mengunduh audio dalam format yang dibutuhkan proyek Anda, dan menjaga alur kerja Anda di satu tempat. Mulai unduhan uji coba pertama Anda hari ini di [UberLLM](https://uberllm.dev).