Téléchargement de synthèse vocale : Générer et enregistrer l'audio en 2026
Guide de téléchargement de synthèse vocale : générez de l'audio à partir de texte, enregistrez-le au format MP3 ou WAV, vérifiez le fichier et confirmez que vous avez les droits d'utilisation.
Vous avez un script prêt, une échéance aujourd'hui, et un outil qui joue la voix parfaitement dans votre navigateur. Puis vous le téléchargez, et le fichier ne s'ouvre pas, se coupe prématurément, ou ne peut pas être légalement intégré à la vidéo pour laquelle vous l'avez créé. C'est là que se situent la plupart des problèmes de téléchargement de synthèse vocale. Considérez le téléchargement comme un actif audio fini, et non comme une astuce de navigateur, et vous détecterez ces problèmes tant qu'ils sont encore peu coûteux à résoudre.
Table des matières
- Choisir la bonne méthode pour obtenir votre fichier audio
- Choisir le format MP3, WAV ou un autre format
- Comment générer et télécharger votre premier fichier audio
- Résoudre les problèmes de téléchargement qui ne se lancent pas ou sonnent mal
- Si vous pouvez publier l'audio téléchargé
- Effectuer un téléchargement test avant de vous engager
Choisissez la bonne façon d'obtenir votre fichier audio
Commencez par une question. Avez-vous besoin d'un fichier enregistré que vous pouvez conserver, modifier et déplacer, ou avez-vous seulement besoin que du texte soit lu à voix haute sur un écran, tout de suite ? Ce sont des tâches différentes, et l'outil qui fait bien l'une ne fait souvent pas du tout l'autre.
Un outil web est le plus rapide pour une narration unique car il n'y a rien à installer. Une application de bureau est rentable lorsque vous convertissez des documents chaque semaine et que vous souhaitez la même voix, la même structure de dossiers et les mêmes paramètres à chaque fois. Une API inverse le travail. Votre code envoie du texte, reçoit des octets audio en réponse, et stocke le fichier là où votre application en a besoin. C'est la bonne forme pour l'audio par utilisateur, et la mauvaise pour une seule introduction de podcast.
Façons d'obtenir un fichier de synthèse vocale
| Méthode | Sortie typique | Fonctionne hors ligne | Idéal pour |
|---|---|---|---|
| Outil web de synthèse vocale en ligne avec bouton de téléchargement | MP3 ou WAV | Non | Narration unique et voix off rapides |
| Application de synthèse vocale de bureau | MP3 ou WAV | Oui, une fois les voix installées | Lots de documents convertis régulièrement |
| Appel d'API de synthèse vocale | Octets audio en réponse, format défini dans la requête | Non | Applications qui créent de l'audio pour chaque utilisateur |
| Modèle open-source exécuté localement | WAV ou le format que votre code écrit | Oui | Texte sensible et flux de travail hors ligne |
| Lecteur d'écran du système d'exploitation | Généralement pas de fichier enregistré | Oui | Écoute plutôt que production d'un fichier |
Les modèles open-source locaux conviennent aux brouillons confidentiels, aux documents clients et au travail sans connexion fiable. Le compromis est réel. Vous aurez besoin d'espace disque pour les modèles et les fichiers vocaux, d'une machine capable de rendre à une vitesse utilisable, et de temps pour l'installer et le maintenir à jour. La confidentialité n'est pas non plus automatique simplement parce que la synthèse est locale. Vérifiez si l'application envoie toujours des analyses, des rapports d'erreur ou des fichiers de référence vocale quelque part.
Les lecteurs d'écran se situent dans une catégorie différente. Ils sont conçus pour l'écoute et la navigation, de sorte que la plupart lisent le texte à voix haute sans enregistrer de fichier portable. Si votre livrable est un MP3 que quelqu'un d'autre peut écouter plus tard, un lecteur d'écran ne résout pas votre problème.
Règle générale : Si vous générez la même voix plus de quelques fois par semaine, choisissez l'accès par lot ou par API au lieu de coller encore et encore dans un formulaire web.
Avant de vous engager sur une voie, comparez les voix et le comportement des modèles dans ce guide des modèles de synthèse vocale, puis testez votre script réel. Une voix qui semble soignée sur une courte phrase de démonstration peut toujours trébucher sur vos noms de produits, prix et acronymes.
Choisir MP3, WAV ou un autre format
Le format détermine trois choses à la fois : la taille du fichier, la flexibilité d'édition et la compatibilité. Choisissez-le une fois par projet, avant de rendre, car le convertir après coup gaspille de l'espace ou dégrade la qualité.
MP3 et AAC sont des formats avec perte. Ils éliminent des détails audio pour rester petits, et chaque nouvel encodage en élimine un peu plus. C'est bien pour un fichier final destiné à un lecteur. C'est un mauvais choix pour une copie maîtresse que vous allez couper, niveler, mixer avec de la musique et exporter à nouveau. Le WAV conserve le signal complet, c'est pourquoi les éditeurs le préfèrent, et pourquoi une longue narration devient vite lourde. Le FLAC est également sans perte et plus petit que le WAV, mais vous rencontrerez toujours des lecteurs, des formulaires de téléchargement et des appareils plus anciens qui le refusent.
Formats audio et leurs compromis
| Format | Taille par minute | Idéal pour | Attention à |
|---|---|---|---|
| MP3 | Environ 1 Mo à 128 kbps | Partage, podcasts, lecture web | Avec perte, donc le ré-encodage dégrade la qualité |
| WAV | Environ 2.6 Mo mono à 22.05 kHz, environ 10.6 Mo pour un stéréo qualité CD | Édition, archivage, copies maîtresses | Fichiers volumineux, une narration stéréo de dix minutes peut atteindre environ 100 Mo |
| M4A ou AAC | Environ 1 Mo à 128 kbps | Appareils Apple et applications mobiles | Certains outils d'édition l'acceptent moins facilement |
| FLAC | Environ la moitié du WAV, varie selon le contenu | Archive sans perte | Tous les lecteurs ne le prennent pas en charge |
La taille compte plus tôt qu'on ne le pense. Une courte voix off est triviale dans n'importe quel format. Un long cours de formation, un ensemble de chapitres d'un livre audio ou une bibliothèque de prompts générés transforme cet écart par minute en coût de stockage, de temps de téléchargement et de sauvegarde.
La compatibilité est tout aussi importante pour les auditeurs. Enregistrez le contenu parlé dans un format largement pris en charge, étiquetez clairement le format et assurez-vous que le fichier se lit sans l'application qui l'a créé. Un téléchargement que votre public ne peut pas ouvrir sur un téléphone n'est pas accessible, quelle que soit la qualité de la voix.
Ce choix est un luxe récent. La parole téléchargeable n'est devenue pratique qu'une fois que les synthétiseurs logiciels ont pu produire un discours raisonnablement intelligible en temps quasi réel, un point que l'histoire de la technologie de synthèse vocale du blog ANSI situe à la fin des années 1980. Avant cela, vous ne choisissiez pas de codecs. Vous choisissiez du matériel.
Je ferais simple. Téléchargez le WAV comme copie maîtresse, puis exportez le MP3 pour la distribution. Vous éditez à partir du fichier qui n'a rien perdu, et vos auditeurs obtiennent le fichier qui se lit partout.
Comment générer et télécharger votre premier fichier audio
Texte propre en entrée, fichier vérifié en sortie. La plupart des mauvais téléchargements sont décidés avant que vous n'appuyiez sur générer, à cause d'un texte que personne n'a nettoyé et de paramètres que personne n'a définis intentionnellement.
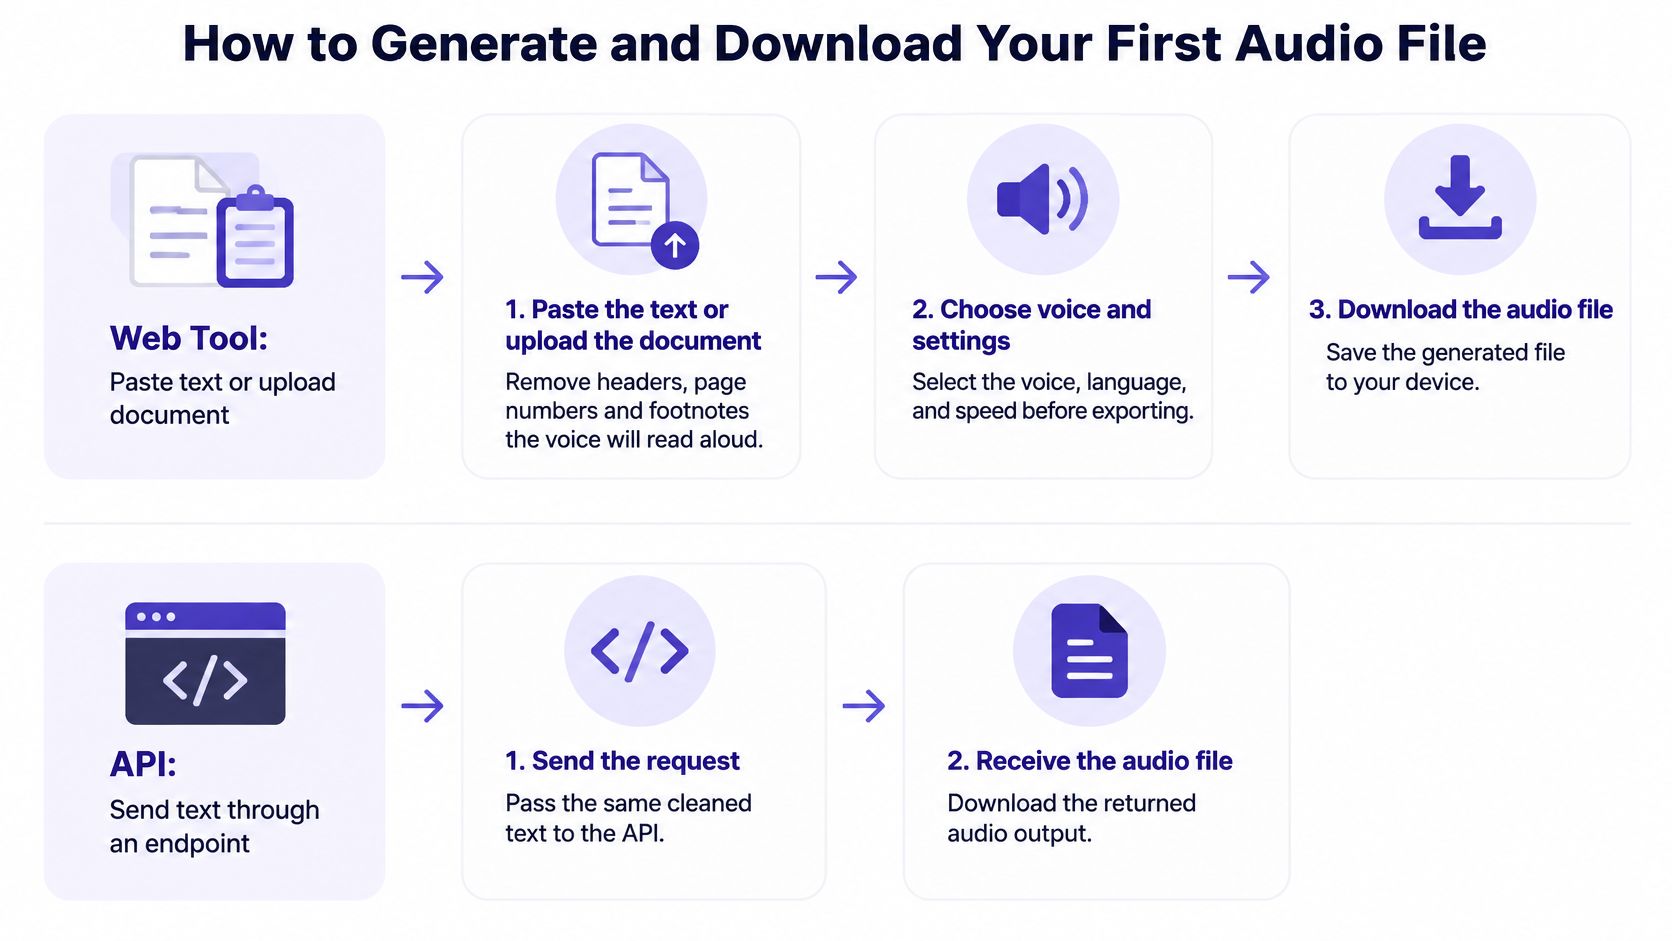
Utiliser un outil web
- Collez le texte ou téléchargez le document. Supprimez les en-têtes, les numéros de page, les notes de bas de page, les débris de tableau et les URL que vous ne voulez pas faire lire à voix haute. La voix lira ce qui est là, y compris le pied de page.
- Choisissez explicitement la langue, la voix et la locale. La locale contrôle la prononciation des dates, des devises et des nombres. Ne laissez pas l'outil deviner à partir des paramètres de votre navigateur.
- Laissez la vitesse par défaut pour votre première tentative. Des débits plus rapides estompent souvent les consonnes et avalent les mots courts. N'ajustez qu'après avoir entendu une base propre.
- Générez d'abord un court échantillon, d'environ 30 secondes. Écoutez-le entièrement. Cela permet de détecter la mauvaise voix, le mauvais accent ou un nom mal prononcé avant de payer pour rendre le script complet.
- Choisissez le format de sortie adapté à la tâche. Choisissez WAV si vous allez éditer, MP3 si le fichier est terminé et destiné aux auditeurs.
- Téléchargez-le et renommez-le immédiatement. Utilisez le projet, la voix et la date dans le nom du fichier. Un dossier rempli de fichiers appelés output.mp3 est introuvable en une semaine.
Utiliser une API
La route API suit la même logique dans le code. Obtenez une clé de votre fournisseur, puis envoyez une requête POST avec le modèle, le texte d'entrée, la voix et le format de réponse que vous souhaitez. Écrivez les octets retournés dans un fichier avec l'extension qui correspond à ce format. Demander un format et enregistrer avec une autre extension est la façon de créer un fichier qu'aucun lecteur n'ouvrira.
Deux détails pratiques vous éviteront des problèmes plus tard. Premièrement, diffusez la réponse sur le disque pour les rendus longs au lieu de tout conserver en mémoire. Deuxièmement, stockez les paramètres de la requête à côté du fichier, y compris l'identifiant du modèle et de la voix, la locale, le taux d'échantillonnage et la date. Lorsqu'un client demande la ré-enregistrement d'un paragraphe un mois plus tard, cet enregistrement est la façon de faire correspondre l'original.
Concernant l'accès, prévoyez les identifiants. Le paiement à la requête fonctionne pour le chat via POST /v1/chat/completions et POST /v1/messages, tandis que les images, la vidéo, la musique et la parole nécessitent toujours une clé. Intégrez donc le stockage et la rotation des clés à votre flux de travail vocal dès le début, et non comme un correctif.
Un bon premier fichier n'a pas de mots coupés au début ou à la fin, des pauses claires à la fin des phrases et une durée proche de ce que vous attendriez pour le nombre de mots.
Vérifiez la durée avant toute autre chose. Si votre échantillon devrait durer environ 30 secondes et que le fichier indique quatre secondes, quelque chose a échoué, et aucune écoute ne le réparera. Régénérez l'échantillon, pas le document entier, jusqu'à ce que la version courte soit correcte.
Corriger les téléchargements qui ne se lisent pas ou dont le son est mauvais
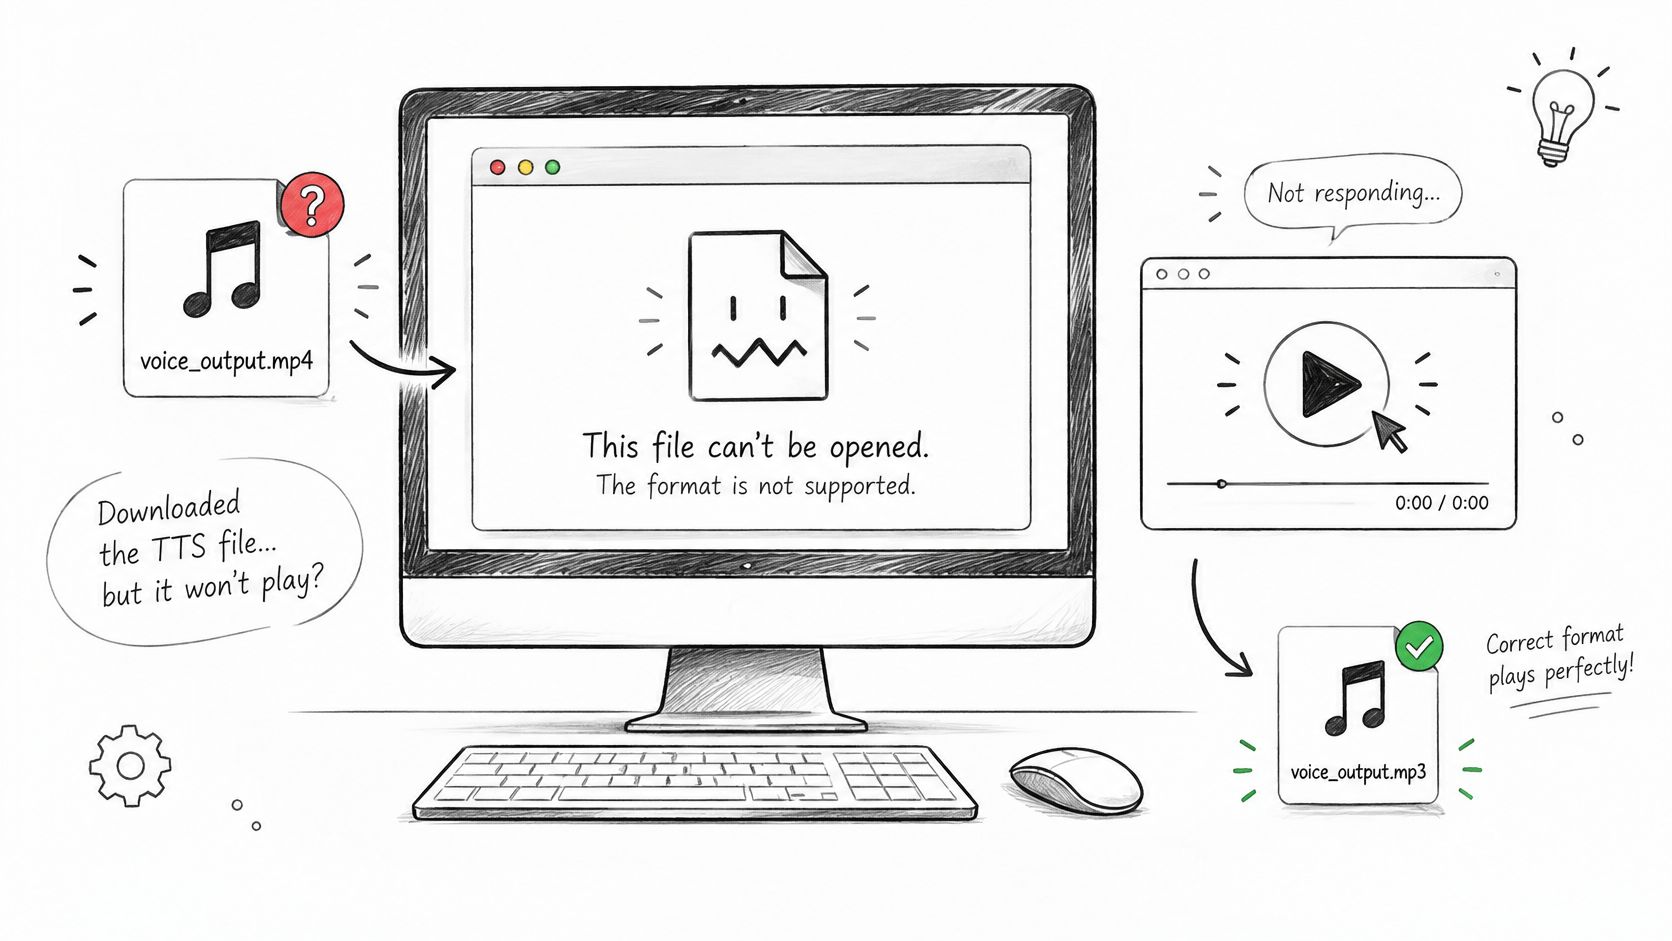
La panne la plus courante est ennuyeuse. Le fichier se télécharge, semble normal, et ne s'ouvre pas parce qu'un audio brut ou encodé différemment a été enregistré avec une extension qui ne correspond pas à son contenu. Les lecteurs font confiance à l'extension, puis échouent sur les octets à l'intérieur.
Problèmes de téléchargement, causes et solutions
| Symptôme | Cause probable | Solution |
|---|---|---|
| Le fichier ne s'ouvre pas | Audio brut enregistré avec la mauvaise extension | Enregistrer avec l'extension qui correspond au format demandé |
| L'audio s'arrête avant la fin | La réponse en streaming a été tronquée | Comparer la durée avec la longueur attendue et télécharger à nouveau |
| Silence ou bruit statique | Fréquence d'échantillonnage ou encodage non pris en charge par le lecteur | Regénérer en MP3 ou WAV à une fréquence d'échantillonnage standard |
| Mots sautés ou fusionnés | Texte long coupé au milieu d'une phrase | Diviser l'entrée aux limites des phrases et regénérer |
| Nombres ou acronymes lus de manière incorrecte | Texte non normalisé avant la synthèse | Écrire les dates, les devises et les acronymes en toutes lettres avant de générer |
| Mauvais accent ou langue | Locale non définie | Définir explicitement la langue et la locale dans la requête |
Parcourez le tableau par ordre d'effort. Renommer un fichier avec la bonne extension et définir une locale prend quelques minutes. Un flux tronqué nécessite un nouveau téléchargement et une vérification du nombre d'octets ou de la durée. Les mots sautés et la mauvaise lecture des nombres nécessitent de corriger le texte et de regénérer l'audio, car aucun réglage du lecteur ne pourra récupérer des mots qui n'ont jamais été synthétisés correctement.
Trois vérifications permettent de détecter la plupart des problèmes avant la publication. Confirmez que le fichier se décode et a une durée non nulle qui correspond approximativement à vos attentes. Lisez-le sur deux appareils, idéalement un ordinateur portable et un téléphone. Ensuite, transcrivez-le avec n'importe quel outil de reconnaissance vocale et comparez les mots avec votre texte source, en surveillant attentivement les nombres et les noms.
Cette approche stratifiée correspond aux pratiques d'évaluation formelles. Un article de référence sur l'évaluation de la parole synthétisée a unifié les échantillons de test en WAV 16 kHz avant la notation et a utilisé des vérifications distinctes pour l'intégrité du fichier, l'intelligibilité et la qualité perceptuelle. Vous n'avez pas besoin de toute cette rigueur pour une seule voix off, mais copiez le principe. Une réponse de téléchargement réussie ne prouve pas que vous avez une parole utilisable, alors vérifiez l'audio lui-même, pas le code de statut.
Gardez vos seuils séparés également. Un fichier peut se télécharger de manière fiable, avoir un son agréable, et pourtant lire un prix de manière incorrecte. Enregistrez le transport, l'intelligibilité et le naturel comme des résultats différents, et vous saurez quelle correction appliquer au lieu de régénérer au hasard.
Pouvez-vous publier l'audio téléchargé ?
Voici une idée reçue à oublier : un fichier sur votre disque dur ne vous appartient pas automatiquement pour le publier, le vendre ou le redistribuer. Pouvoir exporter de l'audio et avoir le droit de l'utiliser sont deux choses différentes, et les guides de téléchargement qui s'arrêtent au bouton d'enregistrement vous laissent porter ce risque.
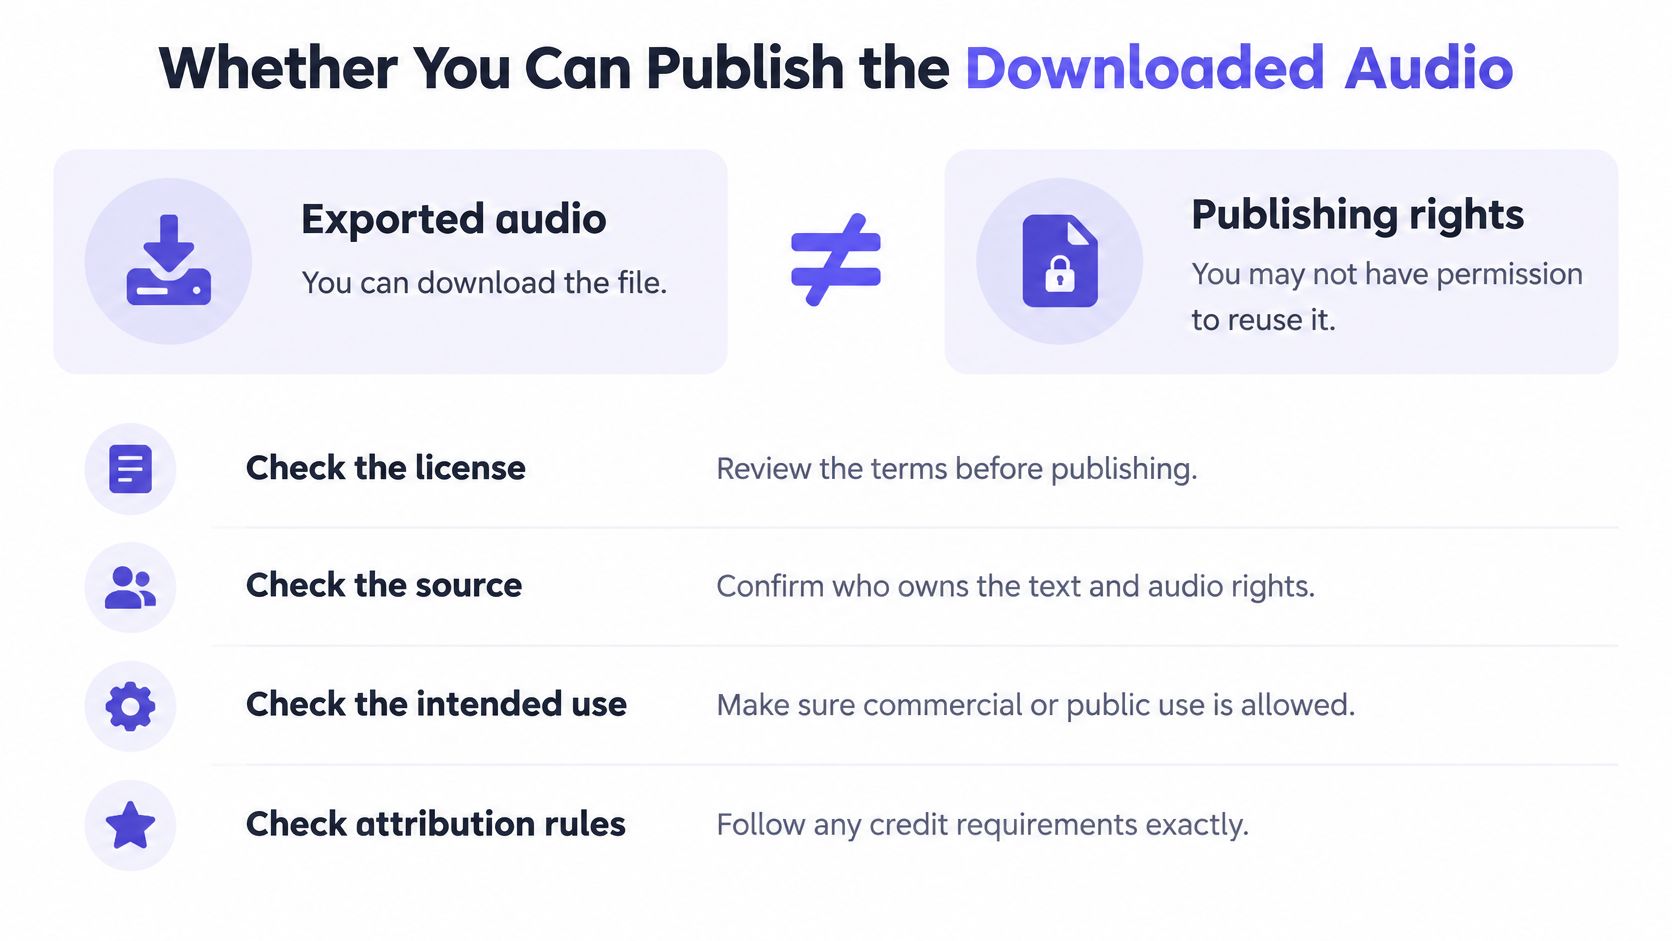
Vérifiez ces éléments avant de publier le fichier :
- Votre niveau d'abonnement et vos conditions : Confirmez si l'utilisation commerciale est autorisée sur votre forfait, et pas seulement l'utilisation personnelle. Les forfaits gratuits restreignent souvent l'utilisation monétisée.
- Le type de voix : Une voix préexistante et une voix clonée entraînent des obligations différentes. Un clone nécessite le consentement de la personne qu'il imite.
- Vos droits sur l'entrée : Vous avez besoin des droits sur le texte que vous convertissez, pas seulement sur l'audio qui en résulte.
- Divulgation : Décidez si votre marché ou votre plateforme vous oblige à étiqueter la parole synthétique, et ajoutez cette étiquette avant de publier.
Cette responsabilité vous incombe. La note de transparence text-to-speech de Microsoft place la responsabilité sur les utilisateurs de sécuriser les droits sur le texte d'entrée, le talent vocal, la ressemblance et tout autre matériel source, tandis que la sortie vocale préexistante payante peut généralement être utilisable commercialement selon les conditions applicables. Lisez les conditions de votre propre fournisseur sous cet angle plutôt que de supposer qu'elles correspondent.
Les téléchargements open-source ajoutent une deuxième couche. Le code et les poids du modèle peuvent avoir des licences distinctes, et l'un ou l'autre peut restreindre l'utilisation commerciale, la redistribution ou l'offre du modèle en tant que service hébergé. Vérifiez les deux, plus la licence de toute donnée vocale à partir de laquelle vous avez effectué un fine-tuning.
Conservez les preuves tant que c'est facile. Enregistrez le forfait ou les conditions de licence en vigueur à la date du téléchargement, le nom et la version de la voix, vos paramètres de requête, et la date elle-même. Cet enregistrement est le plus important lorsque le fichier est transféré à un détaillant, une plateforme publicitaire ou la chaîne d'un client, car les conditions originales ne voyagent pas à l'intérieur d'un MP3. Si votre narration sera intégrée à une vidéo, réglez les mêmes questions de provenance pour l'actif final en utilisant ce guide pour obtenir des vidéos avant de télécharger quoi que ce soit.
Effectuez un téléchargement de test avant de vous engager
Vous pouvez définir le format, la voix et les droits en un après-midi avec un seul échantillon exigeant. N'utilisez pas de texte de démonstration facile. Utilisez un texte qui peut échouer.
1. Collez environ 1,000 caractères qui incluent des chiffres, un nom propre, une date et un acronyme.
2. Générez-le en WAV et MP3 avec la même voix et les mêmes paramètres, puis comparez les deux fichiers.
3. Écoutez chaque fichier sur un téléphone et un ordinateur portable et vérifiez la durée par rapport à vos attentes.
4. Transcrivez un fichier et comparez les mots avec votre source, en notant chaque chiffre mal lu.
5. Classez le test à côté de votre preuve de licence, étiqueté avec le nom de la voix, le format et la date.
Estimez le coût total du travail à partir de cet échantillon avant de passer à l'échelle. À titre d'exemple de tarif où Qwen3 0.6B TTS coûte $0.035 pour 1K caractères, contre un prix catalogue de $0.0875 pour 1K caractères, votre test de 1,000 caractères coûte $0.035, soit 3.5 cents. Multipliez par la longueur réelle de votre script et vous aurez un budget, pas une estimation. Comparez les voix candidates de la même manière, y compris un modèle tel que [ElevenLabs TTS v4``](https://uberllm.dev/models/elevenlabs/elevenlabs-tts-v4), en utilisant un texte de test identique.
Si l'échantillon échoue, corrigez la cause spécifique et relancez l'échantillon. Un test échoué indique presque toujours un paramètre, un nombre non normalisé ou une mauvaise extension. Une fois que les deux formats sont validés et que votre vérification des droits est confirmée, rendez le texte complet et conservez le fichier de test comme référence pour chaque rendu futur.
Prêt à générer votre premier fichier vérifié au lieu de re-rendre le même fichier défectueux ? UberLLM vous offre des modèles de texte, d'image, de vidéo, de musique et de parole via une seule API, afin que vous puissiez tester des voix, télécharger de l'audio dans le format dont votre projet a besoin, et conserver votre flux de travail en un seul endroit. Commencez votre premier téléchargement de test dès aujourd'hui sur [UberLLM](https://uberllm.dev).