Tekst-naar-spraak download: Genereer en sla audio op in 2026
Handleiding voor tekst-naar-spraak download: genereer audio uit tekst, sla het op als MP3 of WAV, controleer het bestand en bevestig dat je de rechten hebt om het te gebruiken.
Je hebt een script klaar, een deadline vandaag, en een tool die de stem perfect afspeelt in je browser. Dan download je het, en het bestand opent niet, stopt te vroeg, of mag wettelijk niet gebruikt worden in de video waarvoor je het gemaakt hebt. Die kloof is waar de meeste text to speech downloadproblemen zich bevinden. Behandel de download als een afgewerkt audio asset, niet als een browsertruc, en je zult die problemen ontdekken terwijl ze nog goedkoop zijn om op te lossen.
Inhoudsopgave
- Kies de Juiste Manier om Je Audiobestand te Krijgen
- MP3, WAV of een Ander Formaat Kiezen
- Hoe Je Je Eerste Audiobestand Genereert en Downloadt
- Problemen Oplossen met Downloads Die Niet Afspelen of Verkeerd Klinken
- Of Je de Gedownloade Audio Kunt Publiceren
- Voer een Testdownload Uit Voordat Je Je Vastlegt
Kies de Juiste Manier om Je Audiobestand te Krijgen
Begin met één vraag. Heb je een opgeslagen bestand nodig dat je kunt bewaren, bewerken en verplaatsen, of heb je alleen tekst nodig die nu hardop wordt voorgelezen op een scherm? Dat zijn verschillende taken, en de tool die de ene goed doet, doet de andere vaak helemaal niet.
Een webtool is het snelst voor een enkele narratie omdat er niets te installeren is. Een desktop-app verdient zichzelf terug wanneer je wekelijks documenten converteert en elke keer dezelfde stem, mapstructuur en instellingen wilt. Een API draait het werk om. Je code stuurt tekst, ontvangt audio bytes in de response, en slaat het bestand op waar je app het nodig heeft. Dat is de juiste vorm voor audio per gebruiker, en het is de verkeerde vorm voor één podcastintro.
Manieren om een Tekst-naar-Spraak Bestand te Krijgen
| Methode | Typische uitvoer | Werkt offline | Het beste voor |
|---|---|---|---|
| Online TTS webtool met downloadknop | MP3 of WAV | Nee | Eenmalige narratie en snelle voice-overs |
| Desktop TTS-applicatie | MP3 of WAV | Ja, zodra stemmen zijn geïnstalleerd | Batches documenten die regelmatig worden geconverteerd |
| Text-to-speech API call | Audio bytes in de response, formaat ingesteld in de request | Nee | Apps die audio creëren voor elke gebruiker |
| Lokaal draaiend open-source model | WAV of het formaat dat je code schrijft | Ja | Gevoelige tekst en offline workflows |
| Schermlezer van het besturingssysteem | Meestal geen opgeslagen bestand | Ja | Luisteren in plaats van een bestand produceren |
Lokale open-source modellen zijn geschikt voor vertrouwelijke concepten, klantenmateriaal en werk zonder betrouwbare verbinding. De afweging is reëel. Je hebt schijfruimte nodig voor modellen en stembestanden, een machine die op een bruikbare snelheid kan renderen, en tijd om het in te stellen en up-to-date te houden. Privacy is ook niet automatisch alleen omdat de synthese lokaal is. Controleer of de app nog steeds analytics, crash reports of stemreferentiebestanden ergens naartoe stuurt.
Schermlezers vallen in een andere categorie. Ze zijn gebouwd voor luisteren en navigatie, dus de meeste spreken tekst hardop uit zonder een draagbaar bestand op te slaan. Als je oplevering een MP3 is die iemand anders later kan afspelen, lost een schermlezer je probleem niet op.
Vuistregel: Als je meer dan een paar keer per week dezelfde stem genereert, kies dan voor batch- of API-toegang in plaats van steeds opnieuw in een webformulier te plakken.
Voordat je een route kiest, vergelijk stemmen en modelgedrag in deze gids voor tekst-naar-spraak modellen, en test vervolgens je eigen script. Een stem die gepolijst klinkt in een korte demosin, kan nog steeds struikelen over je productnamen, prijzen en acroniemen.
Kiezen voor MP3, WAV of een ander formaat
Formaat bepaalt drie dingen tegelijk: bestandsgrootte, bewerkingsflexibiliteit en compatibiliteit. Kies het één keer per project, voordat je rendert, want achteraf converteren verspilt ofwel ruimte of gooit kwaliteit weg.
MP3 en AAC zijn lossy. Ze gooien audiodetails weg om klein te blijven, en elke hercodering gooit nog een beetje meer weg. Dat is prima voor een afgewerkt bestand dat naar een speler gaat. Het is een slechte keuze voor een master die je gaat inkorten, nivelleren, mixen onder muziek en opnieuw exporteren. WAV behoudt het volledige signaal, daarom geven editors er de voorkeur aan, en daarom wordt een lange voice-over snel zwaar. FLAC is ook lossless en kleiner dan WAV, maar je zult nog steeds spelers, uploadformulieren en oudere apparaten tegenkomen die het weigeren.
Audioformaten en hun afwegingen
| Formaat | Grootte per minuut | Het beste voor | Let op |
|---|---|---|---|
| MP3 | Ongeveer 1 MB bij 128 kbps | Delen, podcasts, webweergave | Lossy, dus hercodering verliest kwaliteit |
| WAV | Ongeveer 2.6 MB mono bij 22.05 kHz, ongeveer 10.6 MB voor CD-kwaliteit stereo | Bewerken, archiveren, masterkopieën | Grote bestanden, een stereo voice-over van tien minuten kan ongeveer 100 MB bereiken |
| M4A of AAC | Ongeveer 1 MB bij 128 kbps | Apple-apparaten en mobiele apps | Sommige bewerkingstools accepteren het minder gemakkelijk |
| FLAC | Ongeveer de helft van WAV, varieert met inhoud | Lossless archief | Niet elke speler ondersteunt het |
Grootte doet er eerder toe dan mensen verwachten. Een korte voice-over is triviaal in elk formaat. Een lange training, een set hoofdstukken van een luisterboek, of een bibliotheek met gegenereerde prompts verandert dat verschil per minuut in opslag, uploadtijd en back-upkosten.
Compatibiliteit is net zo belangrijk voor luisteraars. Sla gesproken inhoud op in een breed ondersteund formaat, label het formaat duidelijk en zorg ervoor dat het bestand afspeelt zonder de app die het heeft gemaakt. Een download die je publiek niet op een telefoon kan openen, is niet toegankelijk, ongeacht de stemkwaliteit.
Deze keuze is een recente luxe. Downloadbare spraak werd pas praktisch toen softwaresynthesizers redelijk verstaanbare spraak in bijna realtime konden produceren, een punt dat de ANSI blog geschiedenis van tekst-naar-spraak technologie plaatst in de late jaren 1980. Daarvoor koos je geen codecs. Je koos hardware.
Ik zou het simpel houden. Download WAV als je masterkopie en exporteer vervolgens MP3 voor distributie. Je bewerkt vanuit het bestand dat niets heeft verloren, en je luisteraars krijgen het bestand dat overal afspeelt.
Hoe je je eerste audiobestand genereert en downloadt
Schone tekst erin, geverifieerd bestand eruit. De meeste mislukte downloads worden al bepaald voordat je op genereren drukt, door tekst die niemand heeft opgeschoond en instellingen die niemand bewust heeft ingesteld.
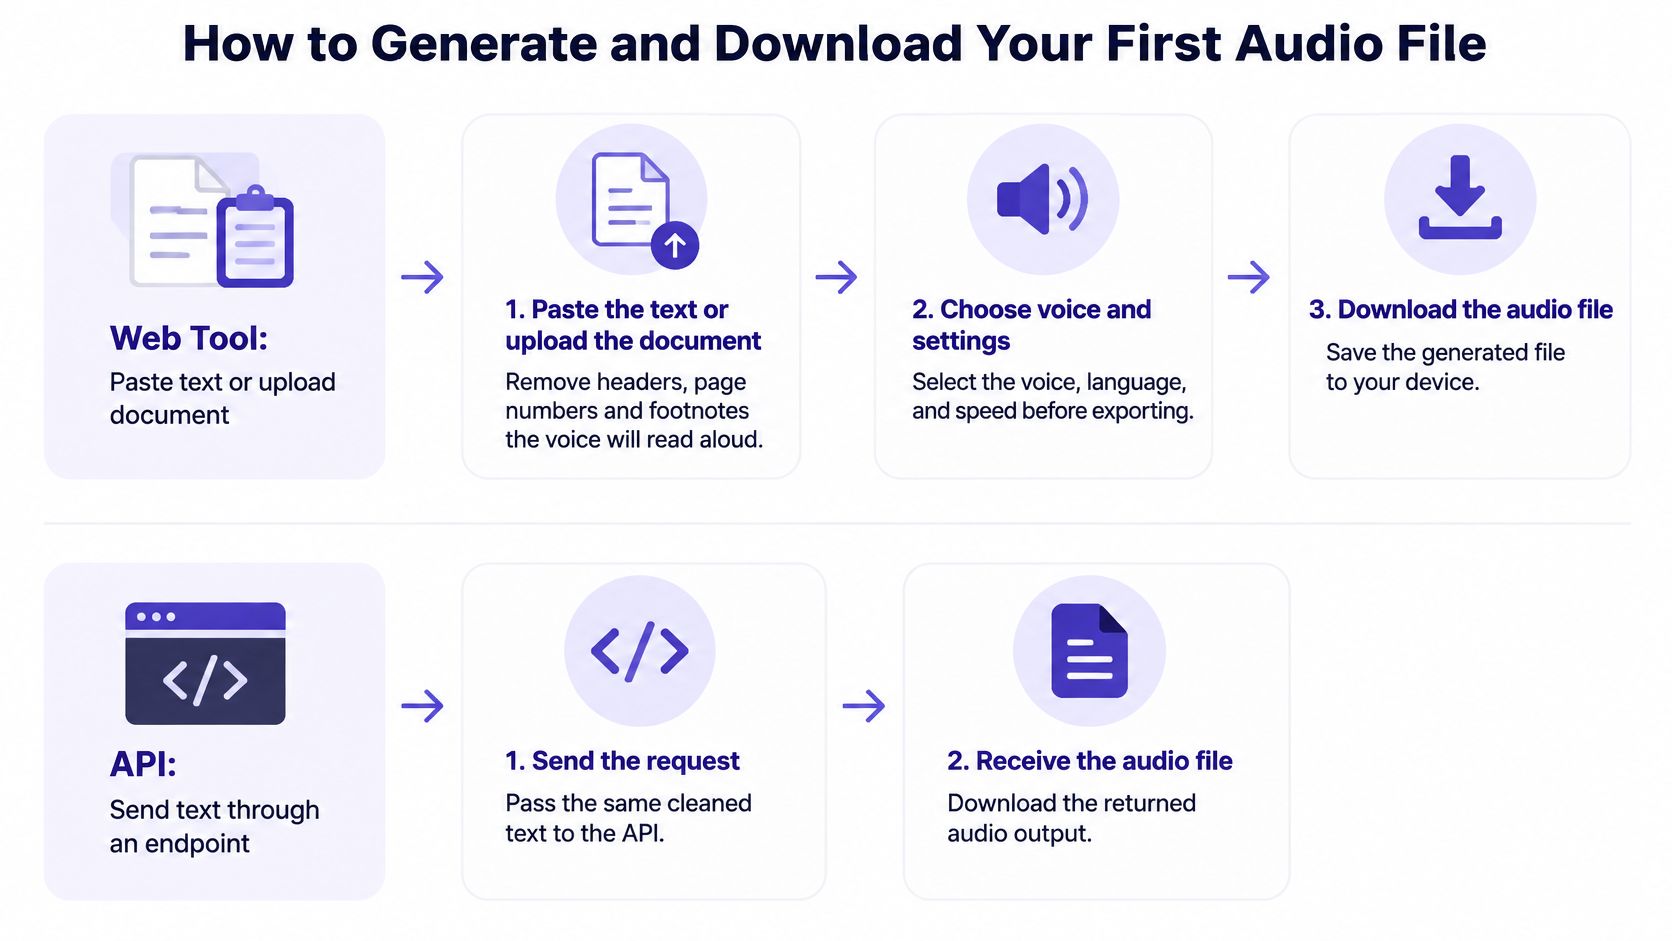
Een webtool gebruiken
- Plak de tekst of upload het document. Verwijder kopteksten, paginanummers, voetnoten, tabelresten en URL's die je niet hardop wilt laten voorlezen. De stem leest voor wat er staat, inclusief de voettekst.
- Kies expliciet de taal, stem en locale. Locale bepaalt hoe datums, valuta en getallen klinken. Laat de tool niet raden op basis van je browserinstellingen.
- Laat de snelheid bij de eerste poging op de standaardinstelling staan. Snellere snelheden vervagen vaak medeklinkers en slikken korte woorden in. Pas dit pas aan nadat je een schone basislijn hebt gehoord.
- Genereer eerst een korte sample, van ongeveer 30 seconden. Luister helemaal. Dit voorkomt de verkeerde stem, het verkeerde accent of een verminkte naam voordat je betaalt om het volledige script te renderen.
- Kies het uitvoerformaat voor de taak. Kies WAV als je gaat bewerken, MP3 als het bestand klaar is en naar luisteraars gaat.
- Download het en hernoem het onmiddellijk. Gebruik project, stem en datum in de bestandsnaam. Een map vol bestanden genaamd output.mp3 is binnen een week onvindbaar.
Een API gebruiken
De API-route volgt dezelfde logica in code. Haal een key op bij je provider en stuur vervolgens een POST request met het model, de invoertekst, de stem en het gewenste responsformaat. Schrijf de geretourneerde bytes naar een bestand met de extensie die overeenkomt met dat formaat. Een formaat aanvragen en opslaan met een andere extensie is hoe je een bestand maakt dat geen enkele speler zal openen.
Twee praktische details besparen later problemen. Ten eerste, stream de response naar schijf voor lange renders in plaats van alles in het geheugen te houden. Ten tweede, sla de request-instellingen op naast het bestand, inclusief model- en stem-ID, locale, sample rate en de datum. Wanneer een klant een maand later vraagt om één paragraaf opnieuw op te nemen, is die registratie hoe je de originele matcht.
Plan voor credentials bij toegang. Pay-per-request werkt voor chat via POST /v1/chat/completions en POST /v1/messages, terwijl afbeeldingen, video, muziek en spraak nog steeds een key vereisen. Bouw dus key-opslag en -rotatie vanaf het begin in je spraakworkflow in, niet als een patch.
Een goed eerste bestand heeft geen afgekapt eerste of laatste woord, duidelijke pauzes aan het einde van zinnen en een duur die dicht bij wat je zou verwachten voor het aantal woorden ligt.
Controleer de duur vóór al het andere. Als je sample ongeveer 30 seconden zou moeten duren en het bestand vier seconden aangeeft, is er iets misgegaan, en geen enkele hoeveelheid luisteren zal dat oplossen. Genereer de sample opnieuw, niet het hele document, totdat de korte versie correct is.
Problemen oplossen met downloads die niet afspelen of verkeerd klinken
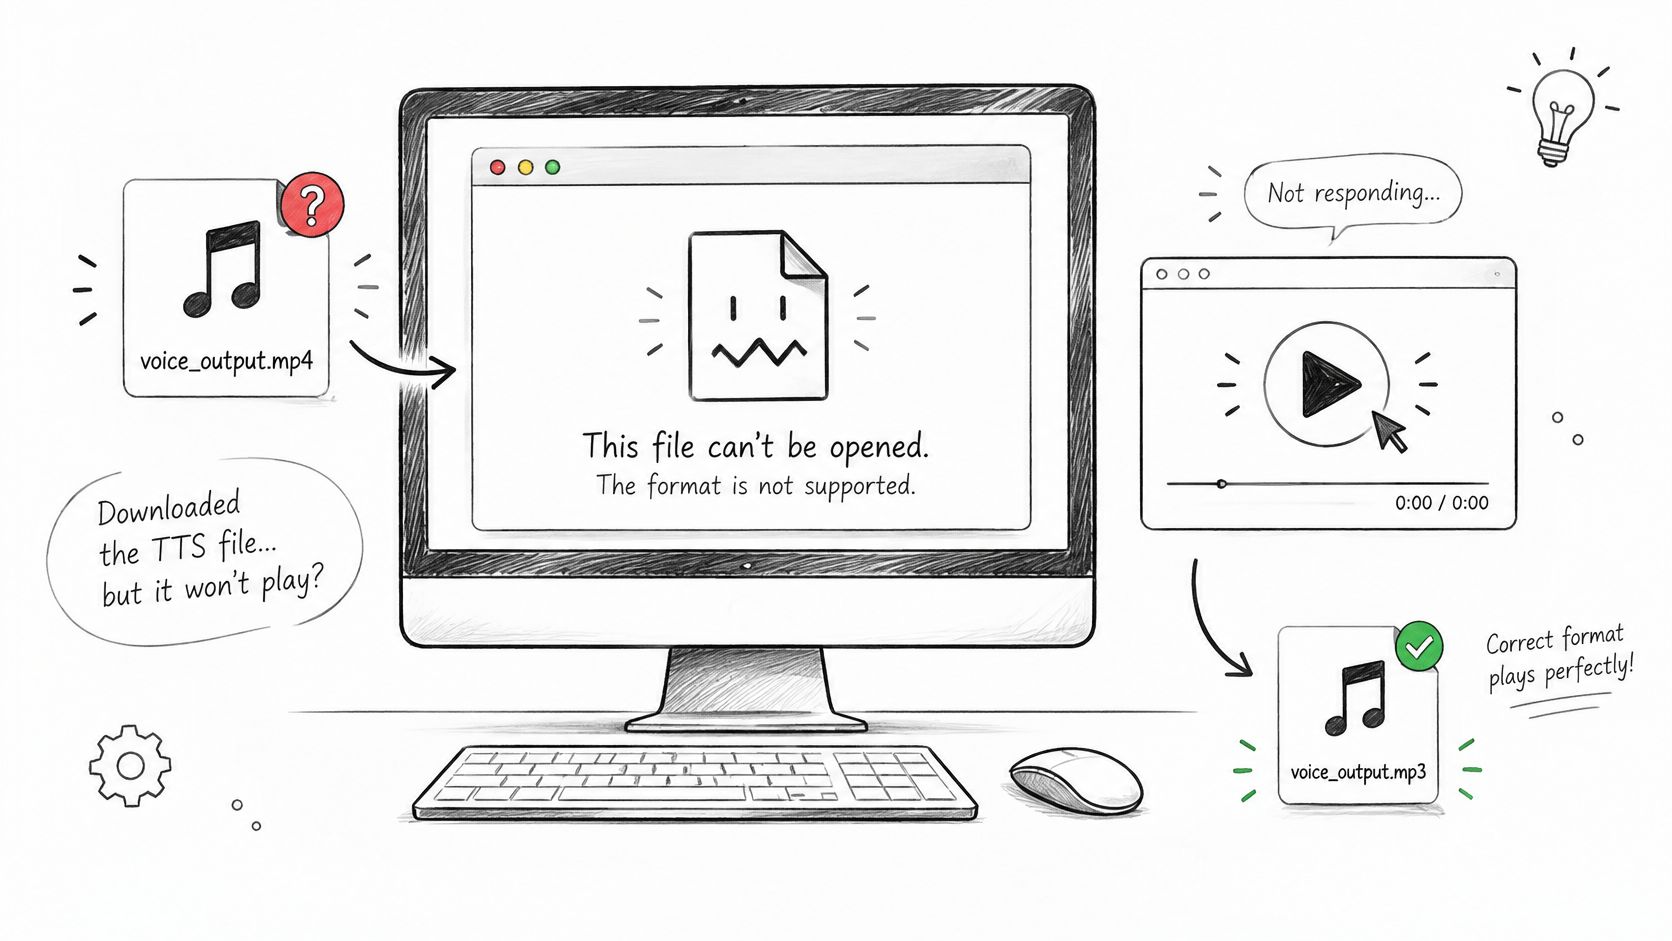
De meest voorkomende fout is eenvoudig. Het bestand downloadt, ziet er normaal uit en opent niet omdat ruwe of anders gecodeerde audio werd opgeslagen met een extensie die niet overeenkomt met de inhoud ervan. Spelers vertrouwen de extensie, maar kunnen de inhoud niet verwerken.
Problemen met downloads, oorzaken en oplossingen
| Symptoom | Waarschijnlijke oorzaak | Oplossing |
|---|---|---|
| Bestand opent niet | Ruwe audio opgeslagen met de verkeerde extensie | Opslaan met de extensie die overeenkomt met het aangevraagde formaat |
| Audio stopt voor het einde | Gestreamde respons was afgekapt | Vergelijk de duur met de verwachte lengte en download opnieuw |
| Stilte of ruis | Samplefrequentie of codering niet ondersteund door de speler | Opnieuw genereren in MP3 of WAV met een standaard samplefrequentie |
| Woorden overgeslagen of samengevoegd | Lange tekst midden in een zin gesplitst | Splits invoer op zinsgrenzen en genereer opnieuw |
| Getallen of acroniemen verkeerd gelezen | Tekst niet genormaliseerd vóór synthese | Schrijf datums, valuta en acroniemen voluit vóór het genereren |
| Verkeerd accent of verkeerde taal | Locale niet ingesteld | Stel de taal en locale expliciet in de aanvraag in |
Doorloop de tabel in volgorde van inspanning. Een bestand hernoemen naar de juiste extensie en een locale instellen kost minuten. Een afgekapt stream vereist een nieuwe download en een controle van het aantal bytes of de duur. Overgeslagen woorden en verkeerd gelezen getallen vereisen dat de tekst wordt gecorrigeerd en de audio opnieuw wordt gegenereerd, omdat geen enkele spelerinstelling woorden kan herstellen die nooit correct zijn gesynthetiseerd.
Drie controles vangen de meeste problemen op vóór publicatie. Controleer of het bestand decodeert en een duur heeft die niet nul is en die ruwweg overeenkomt met uw verwachting. Speel het af op twee apparaten, idealiter een laptop en een telefoon. Transcribeer het vervolgens met een willekeurige spraak-naar-tekst tool en vergelijk de woorden met uw brontekst, waarbij u goed let op getallen en namen.
Die gelaagde aanpak komt overeen met formele evaluatiepraktijken. Een benchmark paper over de evaluatie van gesynthetiseerde spraak verenigde testmonsters als 16-kHz WAV vóór de scoring en gebruikte afzonderlijke controles voor bestandsintegriteit, verstaanbaarheid en perceptuele kwaliteit. U heeft die volledige nauwkeurigheid niet nodig voor één voice-over, maar kopieer het principe. Een succesvolle downloadrespons bewijst niet dat u bruikbare spraak heeft, dus controleer de audio zelf, niet de statuscode.
Houd uw drempels ook gescheiden. Een bestand kan betrouwbaar downloaden, aangenaam klinken en toch een prijs verkeerd lezen. Registreer transport, verstaanbaarheid en natuurlijkheid als verschillende resultaten, en u weet welke oplossing u moet toepassen in plaats van willekeurig opnieuw te genereren.
Of je de gedownloade audio mag publiceren
Hier is de aanname die je moet laten vallen: een bestand op je harde schijf is niet automatisch van jou om te publiceren, verkopen of herdistribueren. Audio kunnen exporteren en het recht hebben om het te gebruiken zijn twee verschillende dingen, en downloadgidsen die stoppen bij de opslagknop laten jou met dat risico zitten.
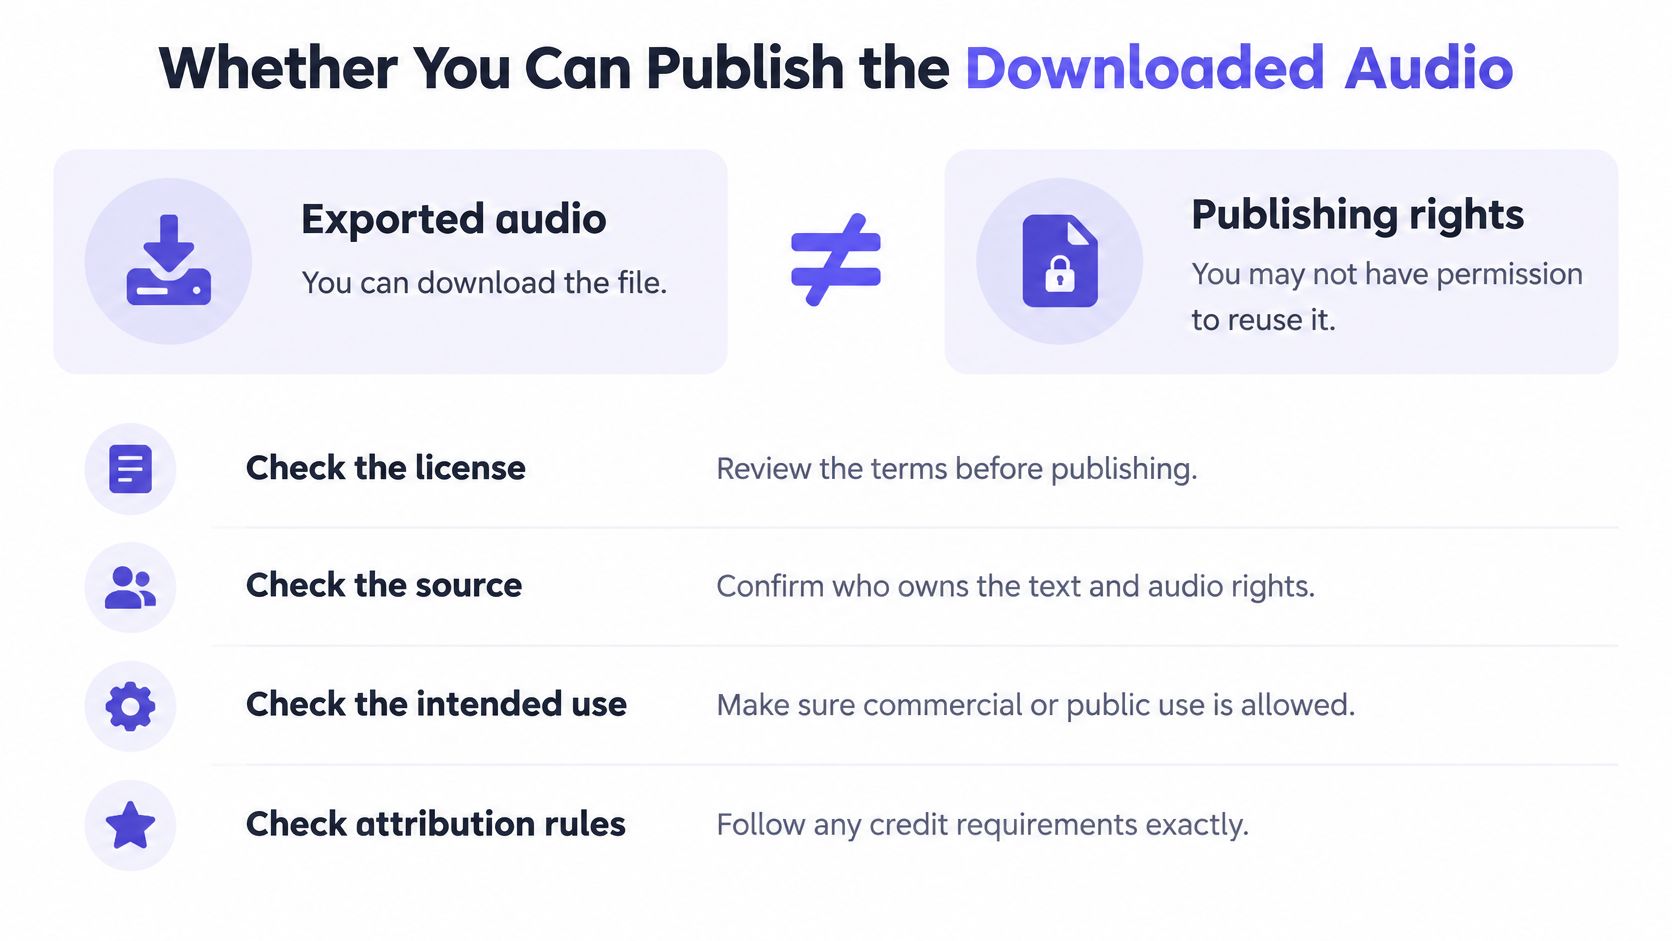
Controleer dit voordat het bestand ergens openbaar wordt:
- Je abonnement en voorwaarden: Bevestig of commercieel gebruik is toegestaan op je abonnement, niet alleen persoonlijk gebruik. Gratis abonnementen beperken vaak gebruik voor commerciële doeleinden.
- Het stemtype: Een standaardstem en een gekloonde stem brengen verschillende verplichtingen met zich mee. Een kloon heeft toestemming nodig van de persoon die het imiteert.
- Je invoerrechten: Je hebt rechten nodig op de tekst die je converteert, niet alleen op de audio die eruit komt.
- Openbaarmaking: Bepaal of je markt of platform vereist dat je synthetische spraak labelt, en voeg dat label toe voordat je publiceert.
Die verantwoordelijkheid ligt bij jou. Microsoft's text-to-speech transparantienota legt de verantwoordelijkheid bij gebruikers om rechten te verkrijgen voor invoertekst, stemtalent, gelijkenis en ander bronmateriaal, terwijl betaalde output van standaardstemmen over het algemeen commercieel bruikbaar kan zijn onder de toepasselijke voorwaarden. Lees de voorwaarden van je eigen provider in dat licht, in plaats van aan te nemen dat ze overeenkomen.
Open-source downloads voegen een tweede laag toe. Code en modelgewichten kunnen afzonderlijke licenties hebben, en elk van beide kan commercieel gebruik, herdistributie of het aanbieden van het model als een hosted service beperken. Controleer beide, plus de licentie op eventuele stemdata waarvan je hebt gefinetuned.
Bewaar bewijs zolang het gemakkelijk is. Sla het abonnement of de licentievoorwaarden die van kracht waren op de download datum, de stemnaam en -versie, je aanvraaginstellingen en de datum zelf op. Dit dossier is het belangrijkst wanneer het bestand naar een retailer, een advertentieplatform of het kanaal van een klant gaat, omdat de oorspronkelijke voorwaarden niet meereizen in een MP3. Als je narratie in video komt te zitten, beantwoord dan dezelfde herkomstvragen voor het voltooide asset met behulp van deze gids voor het verkrijgen van video's voordat je ergens uploadt.
Voer een testdownload uit voordat u zich vastlegt
U kunt het formaat, de stem en de rechten in één middag vastleggen met één enkel, representatief voorbeeld. Gebruik geen gemakkelijke demotekst. Gebruik tekst die kan mislukken.
1. Plak ongeveer 1,000 tekens die cijfers, een persoonsnaam, een datum en een acroniem bevatten.
2. Genereer het in WAV en MP3 met dezelfde stem en instellingen, vergelijk vervolgens beide bestanden.
3. Speel elk af op een telefoon en een laptop en controleer de duur tegenover uw verwachting.
4. Transcribeer één bestand en vergelijk de woorden met uw bron, waarbij u elk verkeerd gelezen nummer noteert.
5. Archiveer de test naast uw licentiebewijs, gelabeld met stemnaam, formaat en datum.
Prijs de volledige opdracht op basis van dat voorbeeld voordat u opschaalt. Met een voorbeeldtarief waarbij Qwen3 0.6B TTS $0.035 kost per 1K tekens, tegen een catalogusprijs van $0.0875 per 1K tekens, kost uw test van 1,000 tekens $0.035, of 3.5 cent. Vermenigvuldig met de lengte van uw echte script en u heeft een budget, geen schatting. Vergelijk kandidaatstemmen op dezelfde manier, inclusief een model zoals [ElevenLabs TTS v4``](https://uberllm.dev/models/elevenlabs/elevenlabs-tts-v4), met gebruik van identieke testtekst.
Als het voorbeeld mislukt, los dan de specifieke oorzaak op en voer het voorbeeld opnieuw uit. Een mislukte test wijst bijna altijd op één instelling, één niet-genormaliseerd nummer of één verkeerde extensie. Zodra beide formaten slagen en uw rechtencontrole standhoudt, render de volledige tekst en bewaar het testbestand als uw referentie voor elke toekomstige render.
Klaar om uw eerste geverifieerde bestand te genereren in plaats van steeds hetzelfde kapotte bestand opnieuw te renderen? UberLLM biedt u tekst-, beeld-, video-, muziek- en spraakmodellen via één API, zodat u stemmen kunt testen, audio kunt downloaden in het formaat dat uw project nodig heeft, en uw workflow op één plek kunt houden. Begin vandaag nog met uw eerste testdownload op [UberLLM](https://uberllm.dev).