テキスト読み上げダウンロード: 2026で音声を生成して保存
テキスト読み上げダウンロードガイド: テキストから音声を生成し、MP3またはWAV形式で保存し、ファイルを確認し、使用する権利があることを確認してください。
スクリプトは準備万端、締め切りは今日、そしてブラウザでは完璧に音声を再生してくれるツールがある。しかし、ダウンロードしてみると、ファイルが開かなかったり、途中で途切れたり、作成した動画に法的に使用できなかったりする。そのギャップこそが、テキスト読み上げのダウンロード問題のほとんどが発生する場所です。ダウンロードをブラウザの単なる機能ではなく、完成したオーディオアセットとして扱うことで、まだ修正が安価なうちにそれらの問題を発見できるでしょう。
目次
- オーディオファイルを取得する最適な方法を選ぶ
- MP3,、WAV、またはその他の形式を選ぶ
- 最初のオーディオファイルを生成してダウンロードする方法
- 再生できない、または音がおかしいダウンロードを修正する
- ダウンロードしたオーディオを公開できるか
- コミットする前にテストダウンロードを実行する
オーディオファイルを入手する最適な方法を選ぶ
まず、一つの質問から始めましょう。保存、編集、移動が可能なファイルが必要ですか、それとも今すぐ画面上でテキストを読み上げるだけで十分ですか?これらは異なる目的であり、一方をうまくこなすツールが、もう一方を全くこなせないこともよくあります。
単一のナレーションであれば、インストール不要なウェブツールが最も速いです。毎週ドキュメントを変換し、毎回同じ音声、フォルダー構造、設定を望む場合は、デスクトップアプリがその価値を発揮します。APIは作業のやり方を根本的に変えます。あなたのコードがテキストを送信し、レスポンスでオーディオバイトを受け取り、アプリが必要とする場所にファイルを保存します。これはユーザーごとのオーディオには適した形ですが、一つのポッドキャストのイントロには適していません。
テキスト読み上げファイルを入手する方法
| 方法 | 一般的な出力 | オフラインで動作 | 最適な用途 |
|---|---|---|---|
| ダウンロードボタン付きオンラインTTSウェブツール | MP3またはWAV | いいえ | 単発のナレーションやクイックなボイスオーバー |
| デスクトップTTSアプリケーション | MP3またはWAV | はい、音声がインストールされていれば | 定期的に変換されるドキュメントのバッチ処理 |
| テキスト読み上げAPIコール | レスポンス内のオーディオバイト、リクエストでフォーマットを設定 | いいえ | ユーザーごとにオーディオを作成するアプリ |
| ローカルで実行するオープンソースモデル | WAVまたはコードが書き込むフォーマット | はい | 機密性の高いテキストやオフラインワークフロー |
| オペレーティングシステムスクリーンリーダー | 通常、保存ファイルなし | はい | ファイルを生成するのではなく、聞くこと |
ローカルのオープンソースモデルは、機密性の高い下書き、クライアント資料、信頼できる接続がない環境での作業に適しています。トレードオフは現実的です。モデルや音声ファイルのためのディスク容量、実用的な速度でレンダリングできるマシン、そしてセットアップと更新に時間が必要です。合成がローカルで行われるからといって、プライバシーが自動的に保護されるわけではありません。アプリが分析データ、クラッシュレポート、または音声参照ファイルをどこかに送信していないか確認してください。
スクリーンリーダーは別のカテゴリーに属します。これらは聞くこととナビゲーションのために作られているため、ほとんどがポータブルファイルを保存せずにテキストを読み上げます。もしあなたの成果物が、後で他の人が再生できるMP3である場合、スクリーンリーダーはあなたの問題を解決しません。
経験則: 週に数回以上同じ音声を生成する場合、ウェブフォームに何度も貼り付けるのではなく、バッチ処理またはAPIアクセスを選びましょう。
ルートを決定する前に、このテキスト読み上げモデルのガイド]で音声とモデルの動作を比較し、実際のスクリプトでテストしてください。短いデモ文では洗練されて聞こえる音声でも、製品名、価格、頭字語でつまずくことがあります。
MP3,、WAV、または別の形式を選ぶ
形式は、ファイルサイズ、編集の柔軟性、互換性という3つのことを一度に決定します。レンダリングする前に、プロジェクトごとに一度選択してください。後で変換すると、容量を無駄にするか、品質を損なうかのどちらかになるからです。
MP3とAACは非可逆圧縮です。これらはファイルサイズを小さく保つためにオーディオの詳細を破棄し、再エンコードするたびにさらに少しずつ破棄されます。プレーヤーに送る完成したファイルには問題ありません。しかし、トリミング、レベル調整、音楽とのミックス、そして再エクスポートを行うマスターファイルとしては不適切な選択です。WAVは完全な信号を保持するため、編集者が好み、長いナレーションがすぐに重くなる理由でもあります。FLACも可逆圧縮でWAVより小さいですが、それでも対応しないプレーヤー、アップロードフォーム、古いデバイスに遭遇するでしょう。
オーディオ形式とそのトレードオフ
| 形式 | 1分あたりのサイズ | 最適な用途 | 注意点 |
|---|---|---|---|
| MP3 | 128 kbpsで約1 MB | 共有、ポッドキャスト、ウェブ再生 | 非可逆圧縮のため、再エンコードすると品質が低下します |
| WAV | 22.05 kHzモノラルで約2.6 MB、CD品質ステレオで約10.6 MB | 編集、アーカイブ、マスターコピー | ファイルサイズが大きい、10分間のステレオナレーションは約100 MBに達することがあります |
| M4AまたはAAC | 128 kbpsで約1 MB | Appleデバイスとモバイルアプリ | 一部の編集ツールではあまり簡単に受け入れられません |
| FLAC | WAVの約半分、コンテンツによって異なります | 可逆圧縮アーカイブ | すべてのプレーヤーがサポートしているわけではありません |
サイズは人々が予想するよりも早く重要になります。短いナレーションであれば、どの形式でも大した問題ではありません。しかし、長いトレーニングコース、オーディオブックの章セット、または生成されたプロンプトのライブラリでは、その1分あたりの差がストレージ、アップロード時間、バックアップコストへと変わります。
互換性はリスナーにとっても同様に重要です。音声コンテンツは広くサポートされている形式で保存し、形式を明確に表示し、作成したアプリがなくてもファイルが再生できることを確認してください。音声品質がどんなに良くても、視聴者がスマートフォンで開けないダウンロードはアクセス可能とは言えません。
この選択は最近の贅沢です。ダウンロード可能な音声が実用的になったのは、ソフトウェアシンセサイザーがほぼリアルタイムで合理的に理解できる音声を生成できるようになったときだけです。ANSIブログのテキスト読み上げ技術の歴史]が1980年代後半に位置付けている点です。それ以前は、コーデックを選んでいたのではなく、ハードウェアを選んでいました。
私はシンプルにすることをお勧めします。マスターコピーとしてWAVをダウンロードし、配布用にMP3をエクスポートしてください。 あなたは何も失われていないファイルから編集し、リスナーはどこでも再生できるファイルを受け取ることができます。
最初のオーディオファイルを生成してダウンロードする方法
きれいなテキストを入力し、検証済みのファイルを出力する。ほとんどの不良ダウンロードは、生成ボタンを押す前に、誰もクリーンアップしなかったテキストや、意図的に設定しなかった設定によって決まってしまう。
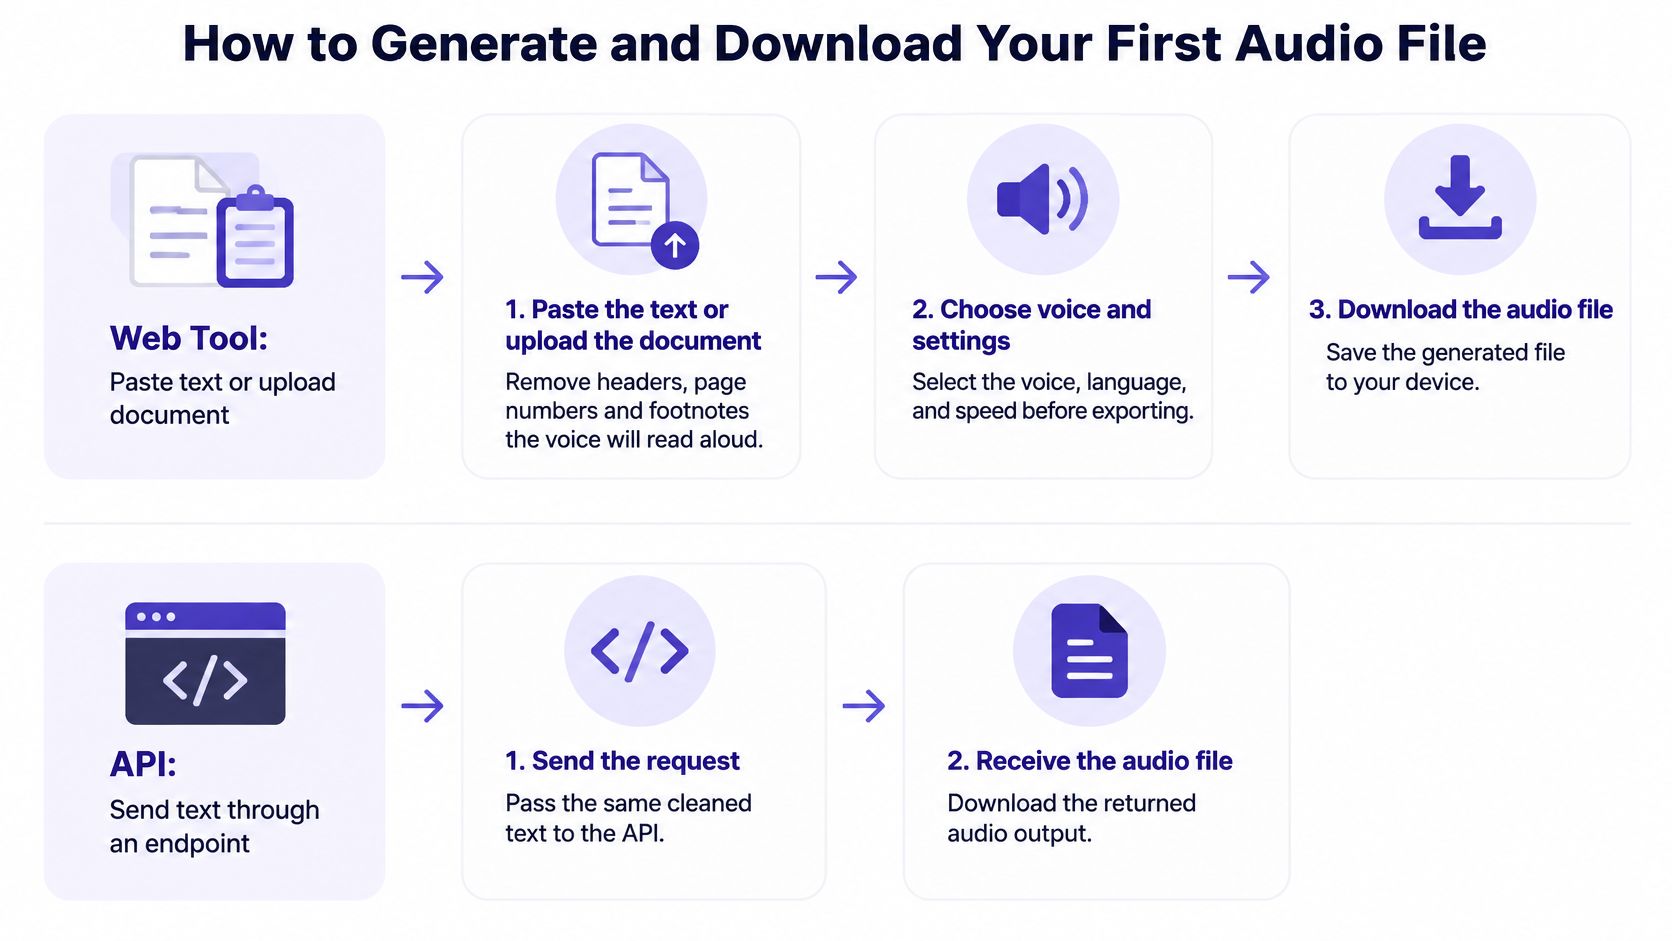
ウェブツールを使用する
- テキストを貼り付けるか、ドキュメントをアップロードする。 読み上げたくないヘッダー、ページ番号、脚注、表の残骸、URLを削除する。音声は、フッターを含め、そこにあるものを読み上げる。
- 言語、音声、ロケールを明示的に選択する。 ロケールは、日付、通貨、数字の読み上げ方を制御する。ツールの推測に任せず、ブラウザ設定から選択しないこと。
- 最初の試行では速度をデフォルトのままにする。 速い速度は、子音を不明瞭にし、短い単語を飲み込んでしまうことが多い。きれいなベースラインを聞いてから調整する。
- まず、約30秒の短いサンプルを生成する。 最後まで聞く。これにより、全スクリプトのレンダリングに料金を支払う前に、間違った声、間違ったアクセント、または破損した名前を検出できる。
- 作業に適した出力形式を選択する。 編集する場合はWAVを、ファイルが完成してリスナーに配信する場合はMP3を選択する。
- ダウンロードしてすぐに名前を変更する。 ファイル名にプロジェクト名、音声、日付を含める。output.mp3という名前のファイルでいっぱいのフォルダは、1週間以内に追跡不能になる。
APIを使用する
APIルートもコード内で同じロジックに従う。プロバイダーからkeyを取得し、model、input text、voice、および希望するresponse formatを含むPOST requestを送信する。返されたbytesを、そのformatに一致するextensionを持つファイルに書き込む。あるformatを要求し、別のextensionで保存すると、どのplayerも開けないファイルが作成される。
2つの実用的な詳細が後々の手間を省く。まず、長いレンダリングの場合、すべてをmemoryに保持するのではなく、responseをdiskにstreamingする。次に、modelとvoice identifier、locale、sample rate、日付を含むrequest settingsをファイルと一緒に保存する。クライアントが1か月後に1つのparagraphの再録音を要求した場合、その記録がオリジナルと一致させる方法となる。
アクセス時には、credentialsを計画する。POST /v1/chat/completionsおよびPOST /v1/messagesを介したchatではpay-per-requestが機能するが、images、video、music、speechには依然としてkeyが必要となる。そのため、keyのstorageとrotationを、後からのpatchとしてではなく、最初からspeech workflowに組み込む。
良い最初のファイルは、最初や最後の単語が途切れておらず、文末に明確なポーズがあり、単語数から予想されるdurationに近い。
何よりもまずdurationを確認する。サンプルが約30秒であるべきなのに、ファイルが4秒しか表示しない場合、何かが失敗しており、いくら聞いても修正できない。短いバージョンが正しくなるまで、ドキュメント全体ではなく、サンプルを再生成する。
再生できない、または音がおかしいダウンロードを修正する
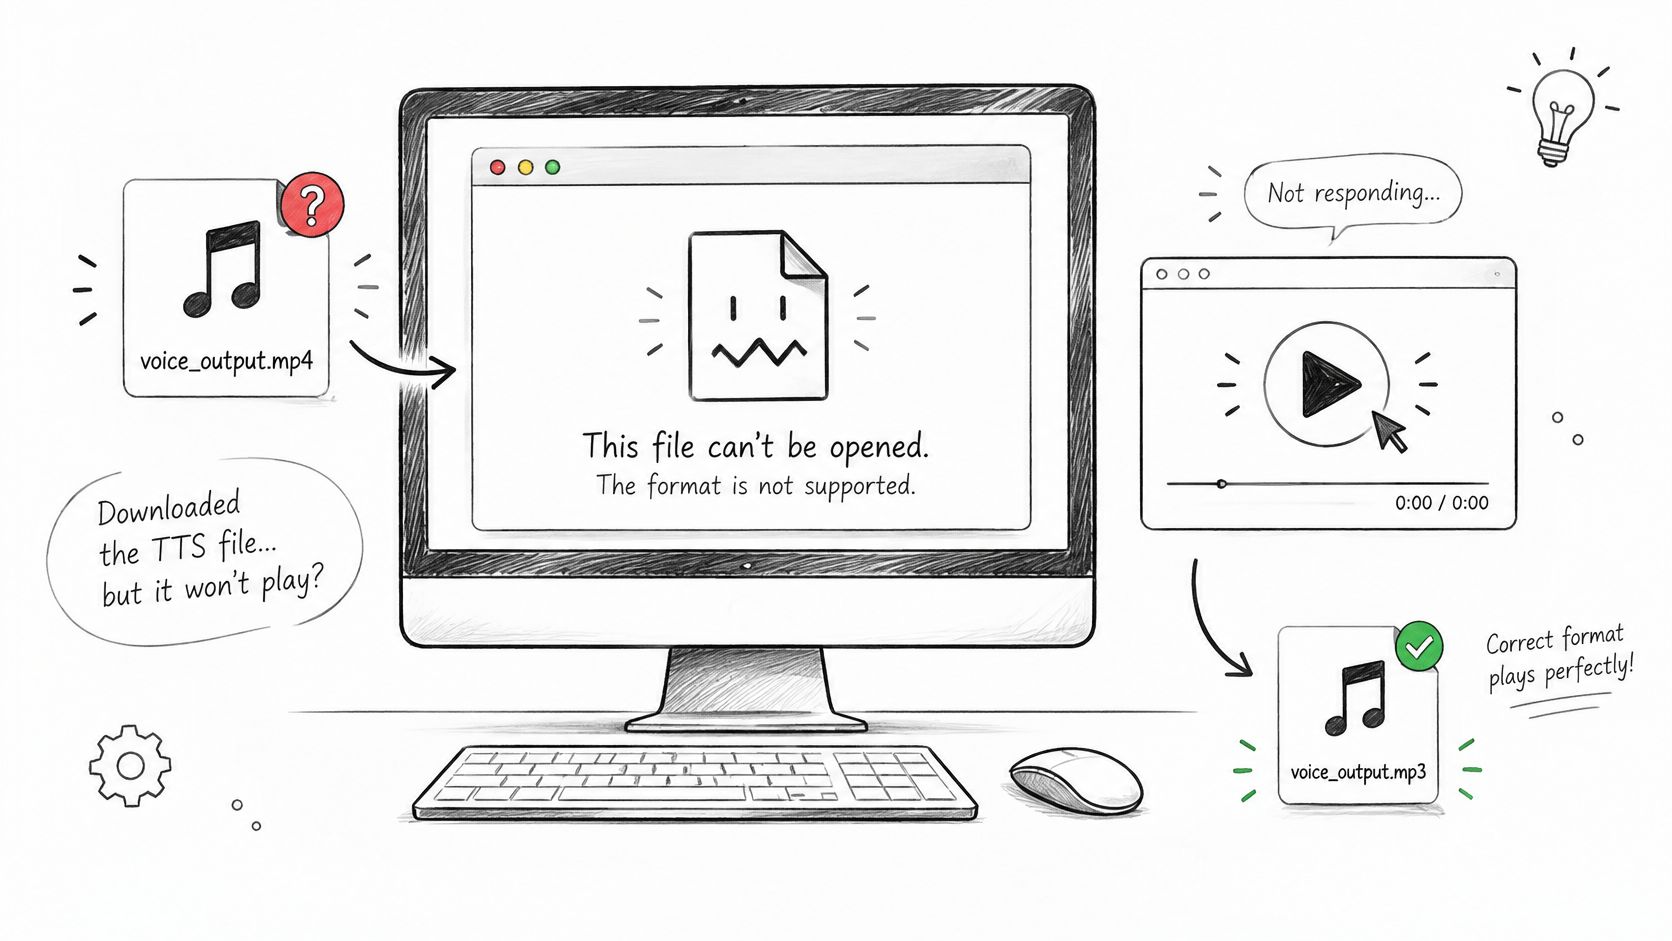
いちばんよくある失敗は地味です。ファイルはダウンロードできて見た目も普通なのに開かない。理由は、raw または別のエンコードの音声が、中身と合わない拡張子で保存されているからです。プレーヤーは拡張子を信用して、中のバイトデータでつまずきます。
ダウンロードの問題、原因、修正方法
| 症状 | 考えられる原因 | 修正方法 |
|---|---|---|
| ファイルが開かない | raw 音声が間違った拡張子で保存されている | 要求した形式に合う拡張子で保存する |
| 音声が最後まで再生されない | ストリーミング応答が途中で切れた | 再生時間を想定の長さと比較して、もう一度ダウンロードする |
| 無音またはノイズ | サンプルレートまたはエンコードがプレーヤーでサポートされていない | 標準のサンプルレートで MP3 または WAV として再生成する |
| 単語が抜ける、または結合される | 長いテキストが文の途中で分割された | 文の境界で入力を分割し、再生成する |
| 数字や頭字語が誤って読まれる | 合成前にテキストが正規化されていない | 生成前に日付、通貨、頭字語を文字で書き出す |
| アクセントまたは言語が違う | ロケールが設定されていない | リクエストで言語とロケールを明示的に設定する |
表は手間の少ない順に試してください。ファイル名を正しい拡張子に変更するのと、ロケールを設定するのは数分で終わります。途中で切れたストリームは、新しくダウンロードし、バイト数または再生時間を確認する必要があります。単語の抜けや数字の読み間違いは、テキストを直して音声を再生成する必要があります。正しく合成されなかった単語は、プレーヤーの設定では戻せないからです。
公開前にほとんどの問題を捕まえられるチェックは3つあります。ファイルがデコードでき、ゼロではない再生時間があり、それがおおよそ想定と合っていることを確認してください。2台のデバイス、できればノートPCとスマートフォンで再生してください。次に、任意の音声テキスト化ツールで文字起こしし、単語を元のテキストと比較します。数字と名前は特に注意して見てください。
このように層を分けたアプローチは、正式な評価の実践と一致します。ある合成音声評価に関するベンチマーク論文は、スコアリングの前にテストサンプルを 16-kHz WAV に統一し、ファイルの整合性、明瞭性、知覚品質を別々にチェックしていました。1本のナレーションにそこまでの厳密さは不要ですが、原則は真似してください。ダウンロード応答が成功したからといって、使える音声が得られた証明にはなりません。ステータスコードではなく、音声そのものを確認してください。
しきい値も分けておきましょう。ファイルは安定してダウンロードでき、聞き心地がよくても、価格を読み間違えることがあります。転送、明瞭性、自然さを別々の結果として記録すれば、ランダムに再生成するのではなく、どの修正を適用すべきかがわかります。
ダウンロードしたオーディオを公開できるか
まず、この思い込みを捨てましょう。ハードドライブにあるファイルが、自動的に公開、販売、または再配布できるあなたのものになるわけではありません。オーディオをエクスポートできることと、それを使用する権利があることは、まったく別のことです。保存ボタンで終わるダウンロードガイドは、あなたにそのリスクを負わせることになります。
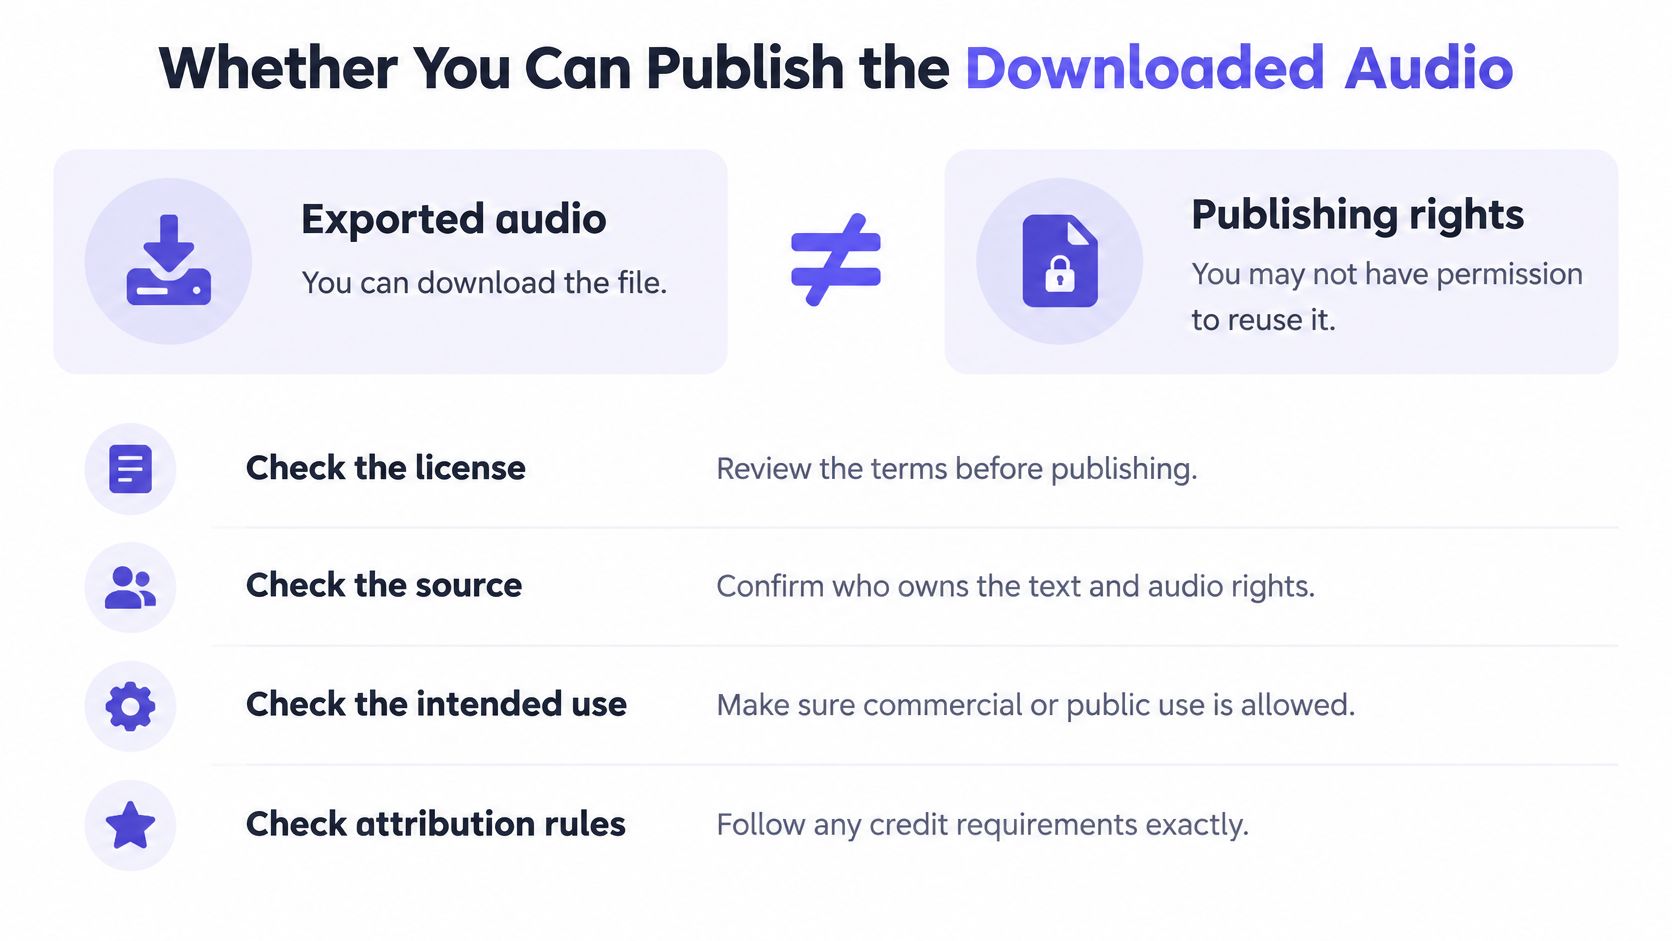
ファイルを公開する前に、これらを確認してください。
- あなたのティアと規約: あなたのプランで個人的な使用だけでなく、商用利用が許可されているか確認してください。無料ティアでは、収益化を伴う使用が制限されていることがよくあります。
- 音声の種類: 既成の音声とクローン音声では、異なる義務が生じます。クローン音声は、模倣する人物からの同意が必要です。
- 入力の権利: 出力されるオーディオだけでなく、変換するテキストに対しても権利が必要です。
- 開示: あなたの市場やプラットフォームが合成音声にラベル付けを要求するかどうかを判断し、公開前にそのラベルを追加してください。
その責任はあなたにあります。Microsoftのテキスト読み上げの透明性に関する注記は、入力テキスト、音声タレント、肖像、その他のソース素材に対する権利を確保する責任をユーザーに課しています。一方、有料の既成音声出力は、適用される規約の下で一般的に商用利用可能です。あなたのプロバイダーの規約が一致すると仮定するのではなく、その観点からご自身のプロバイダーの規約を読んでください。
オープンソースのダウンロードには、もう一つの層が加わります。コードとモデルの重みは、それぞれ異なるライセンスを持つ場合があります。そして、どちらか一方が商用利用、再配布、またはモデルをホスト型サービスとして提供することを制限する可能性があります。両方を確認し、さらにファインチューニングに使用した音声データのライセンスも確認してください。
簡単なうちに証拠を残しておきましょう。ダウンロード日時点のプランまたはライセンス規約、音声の名前とバージョン、リクエスト設定、そして日付自体を保存してください。この記録は、ファイルが小売業者、広告プラットフォーム、またはクライアントのチャンネルに移動する際に最も重要になります。なぜなら、元の規約はMP3ファイル内に含まれないからです。ナレーションが動画内に組み込まれる場合は、どこかにアップロードする前に、この動画の入手ガイドを使用して、完成したアセットについても同様の出所に関する疑問を解決してください。
コミットする前にテストダウンロードを実行する
困難なサンプルを1つ使用するだけで、形式、音声、権利を半日で確定できます。簡単なデモテキストは使用しないでください。失敗する可能性のあるテキストを使用してください。
- 数字、人名、日付、頭字語を含む1,000文字程度のテキストを貼り付けます。
- 同じ音声と設定でWAVとMP3形式で生成し、両方のファイルを比較します。
- それぞれをスマートフォンとノートパソコンで再生し、期待する再生時間と比較して確認します。
- いずれかのファイルを文字起こしし、ソースと比較して単語を確認し、読み間違えられた数字をすべて記録します。
- 音声名、形式、日付を付けて、テスト結果をライセンス証拠の隣に保管します。
スケールする前に、そのサンプルから全体の費用を見積もってください。Qwen3 0.6B TTSが1K文字あたり$0.035かかるという計算例のレートで、リスト価格の1K文字あたり$0.0875と比較すると、1,000文字のテストは**$0.035、または3.5セント**かかります。実際のスクリプトの長さを掛ければ、推測ではなく予算が得られます。ElevenLabs TTS v4のようなモデルを含め、同じテストテキストを使用して候補となる音声を同様に比較してください。
サンプルが失敗した場合は、特定の問題を修正し、サンプルを再実行してください。失敗したテストは、ほとんどの場合、1つの設定、1つの正規化されていない数字、または1つの間違った拡張子を指し示します。両方の形式が合格し、権利確認が保持されたら、全文をレンダリングし、テストファイルを今後のすべてのレンダリングの参照として保管してください。
同じ壊れたファイルを再レンダリングする代わりに、最初の検証済みファイルを生成する準備はできていますか?UberLLMは、1つのAPIを通じてテキスト、画像、ビデオ、音楽、音声モデルを提供します。そのため、音声をテストし、プロジェクトに必要な形式でオーディオをダウンロードし、ワークフローを1か所にまとめることができます。今すぐUberLLMで最初のテストダウンロードを開始してください。