Download Sintesi Vocale: Genera e Salva Audio in 2026
Guida al download della sintesi vocale: generare audio da testo, salvarlo come MP3 o WAV, controllare il file e confermare di avere i diritti per usarlo.
Hai uno script pronto, una scadenza oggi e uno strumento che riproduce la voce perfettamente nel tuo browser. Poi lo scarichi, e il file non si apre, si interrompe prima del previsto o non può essere legalmente usato nel video per cui l'hai creato. È proprio in quel divario che si annidano la maggior parte dei problemi di download del text to speech. Considera il download come una risorsa audio finita, non un trucco del browser, e individuerai quei problemi mentre risolverli è ancora economico.
Indice
- Scegli il modo giusto per ottenere il tuo file audio
- Scegliere MP3, WAV o un altro formato
- Come generare e scaricare il tuo primo file audio
- Risolvere i download che non si riproducono o suonano male
- Se puoi pubblicare l'audio scaricato
- Esegui un download di prova prima di impegnarti
Scegli il Modo Giusto per Ottenere il Tuo File Audio
Inizia con una domanda. Hai bisogno di un file salvato che puoi conservare, modificare e spostare, o hai solo bisogno che il testo venga letto ad alta voce su uno schermo in questo momento? Sono lavori diversi, e lo strumento che fa bene l'uno spesso non fa affatto l'altro.
Uno strumento web è il più veloce per una singola narrazione perché non c'è nulla da installare. Un'applicazione desktop si ripaga quando converti documenti ogni settimana e desideri la stessa voce, struttura di cartelle e impostazioni ogni volta. Un'API capovolge il lavoro. Il tuo codice invia testo, riceve audio bytes nella risposta, e memorizza il file ovunque la tua app ne abbia bisogno. Questa è la forma giusta per l'audio per utente, ed è la forma sbagliata per un'introduzione di podcast.
Modi per Ottenere un File Text-to-Speech
| Metodo | Output tipico | Funziona offline | Ideale per |
|---|---|---|---|
| Strumento web TTS online con pulsante di download | MP3 o WAV | No | Narrazione una tantum e voiceover rapidi |
| Applicazione TTS desktop | MP3 o WAV | Sì, una volta installate le voci | Lotti di documenti convertiti regolarmente |
| Chiamata API text-to-speech | Audio bytes nella risposta, formato impostato nella request | No | App che creano audio per ogni utente |
| Modello open-source eseguito localmente | WAV o il formato che il tuo code scrive | Sì | Testo sensibile e flussi di lavoro offline |
| Screen reader del sistema operativo | Di solito nessun file salvato | Sì | Ascolto piuttosto che produzione di un file |
I modelli open-source locali sono adatti per bozze riservate, materiale del cliente e lavoro senza una connessione affidabile. Il compromesso è reale. Avrai bisogno di spazio su disco per i modelli e i file vocali, una macchina in grado di renderizzare a una velocità utilizzabile e tempo per configurarla e mantenerla aggiornata. La privacy non è automatica solo perché la sintesi è locale. Controlla se l'app invia ancora analytics, crash reports o file di riferimento vocali da qualche parte.
Gli screen reader rientrano in una categoria diversa. Sono costruiti per l'ascolto e la navigazione, quindi la maggior parte legge il testo ad alta voce senza salvare un file portatile. Se il tuo prodotto finale è un MP3 che qualcun altro può riprodurre in seguito, uno screen reader non risolve il tuo problema.
Regola pratica: Se genererai la stessa voce più di qualche volta a settimana, scegli l'accesso batch o API invece di incollare in un modulo web più e più volte.
Prima di impegnarti in una strada, confronta le voci e il comportamento del modello in questa guida ai modelli text-to-speech, quindi testa il tuo script effettivo. Una voce che suona raffinata in una breve frase demo può comunque inciampare sui nomi dei tuoi prodotti, prezzi e acronimi.
Scegliere MP3, WAV o un altro formato
Il formato decide tre cose contemporaneamente: dimensione del file, flessibilità di editing e compatibilità. Sceglilo una volta per progetto, prima di renderizzare, perché convertirlo in seguito spreca spazio o sacrifica la qualità.
MP3 e AAC sono lossy. Scartano i dettagli audio per rimanere piccoli, e ogni ricodifica ne scarta un po' di più. Va bene per un file finito destinato a un lettore. È una scelta sbagliata per un master che taglierai, livellerai, mixerai con la musica ed esporterai di nuovo. WAV mantiene il segnale completo, ecco perché gli editor lo preferiscono, e perché una lunga narrazione diventa pesante velocemente. FLAC è anch'esso lossless e più piccolo di WAV, ma incontrerai comunque lettori, moduli di caricamento e dispositivi più vecchi che lo rifiutano.
Formati audio e i loro compromessi
| Formato | Dimensione per minuto | Ideale per | Attenzione a |
|---|---|---|---|
| MP3 | Circa 1 MB a 128 kbps | Condivisione, podcast, riproduzione web | Lossy, quindi la ricodifica perde qualità |
| WAV | Circa 2.6 MB mono a 22.05 kHz, circa 10.6 MB per stereo qualità CD | Editing, archiviazione, copie master | File grandi, una narrazione stereo di dieci minuti può raggiungere circa 100 MB |
| M4A o AAC | Circa 1 MB a 128 kbps | Dispositivi Apple e app mobili | Alcuni strumenti di editing lo accettano meno facilmente |
| FLAC | Circa la metà di WAV, varia con il contenuto | Archivio lossless | Non tutti i lettori lo supportano |
La dimensione conta prima di quanto ci si aspetti. Un breve voiceover è banale in qualsiasi formato. Un lungo corso di formazione, un set di capitoli di audiolibri o una libreria di prompt generati trasforma quel divario per minuto in spazio di archiviazione, tempo di caricamento e costo di backup.
La compatibilità è altrettanto importante per gli ascoltatori. Salva i contenuti parlati in un formato ampiamente supportato, etichetta chiaramente il formato e assicurati che il file venga riprodotto senza l'app che lo ha creato. Un download che il tuo pubblico non può aprire su un telefono non è accessibile, qualunque sia la qualità della voce.
Questa scelta è un lusso recente. Il parlato scaricabile è diventato pratico solo quando i sintetizzatori software sono stati in grado di produrre un parlato ragionevolmente intelligibile quasi in tempo reale, un punto che la storia della tecnologia text-to-speech del blog ANSI colloca alla fine degli anni 1980. Prima di allora, non stavi scegliendo codec. Stavi scegliendo hardware.
Io la terrei semplice. Scarica WAV come copia master, quindi esporta MP3 per la distribuzione. Modifichi dal file che non ha perso nulla, e i tuoi ascoltatori ottengono il file che si riproduce ovunque.
Come Generare e Scaricare il Tuo Primo File Audio
Testo pulito in ingresso, file verificato in uscita. La maggior parte dei download scadenti sono decisi prima ancora di premere genera, a causa di testo non pulito e impostazioni non configurate intenzionalmente.
Utilizzo di uno Strumento Web
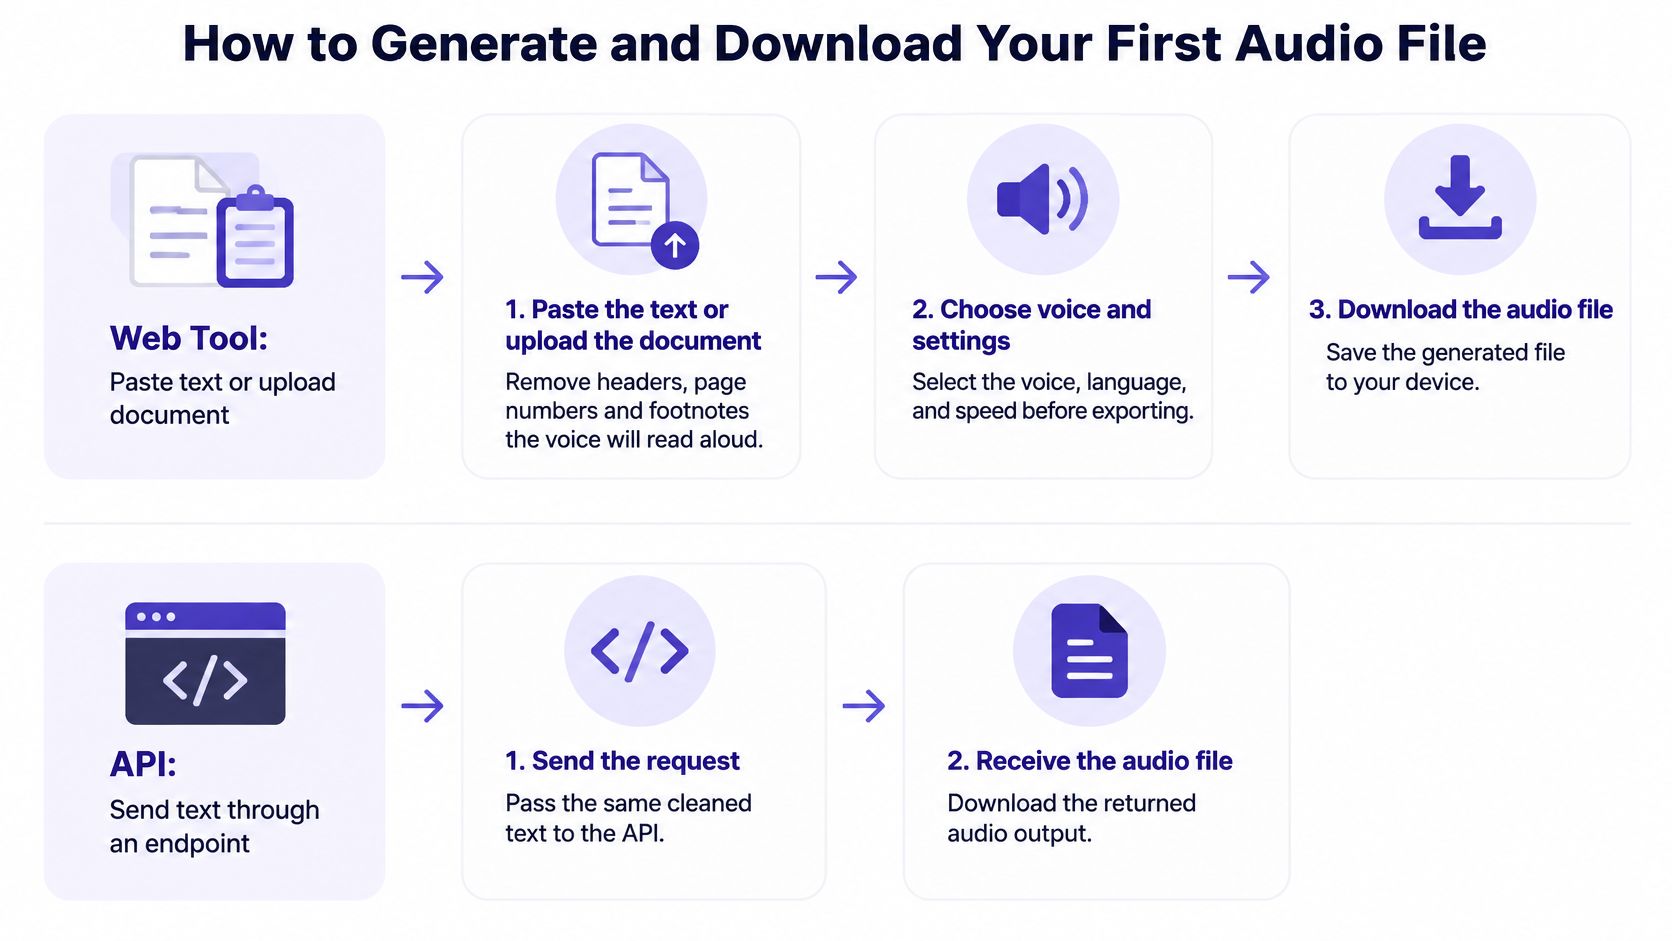
- Incolla il testo o carica il documento. Rimuovi intestazioni, numeri di pagina, note a piè di pagina, frammenti di tabelle e URL che non vuoi vengano letti ad alta voce. La voce leggerà ciò che è presente, incluso il piè di pagina.
- Scegli esplicitamente lingua, voce e locale. Il locale controlla come suonano date, valute e numeri. Non lasciare che lo strumento indovini dalle impostazioni del tuo browser.
- Lascia la velocità predefinita per il tuo primo tentativo. Velocità più elevate spesso sfocano le consonanti e ingoiano parole brevi. Regola solo dopo aver ascoltato una base pulita.
- Genera prima un breve campione, di circa 30 secondi. Ascoltalo per intero. Questo ti permette di individuare la voce sbagliata, l'accento errato o un nome storpiato prima di pagare per renderizzare l'intero script.
- Scegli il formato di output per il lavoro. Scegli WAV se intendi modificare, MP3 se il file è finito e destinato agli ascoltatori.
- Scaricalo e rinominalo immediatamente. Usa progetto, voce e data nel nome del file. Una cartella piena di file chiamati output.mp3 diventa irrintracciabile entro una settimana.
Utilizzo di un'API
Il percorso API segue la stessa logica nel codice. Ottieni una key dal tuo provider, quindi invia una POST request con il model, l'input text, la voice e il response format che desideri. Scrivi i byte restituiti in un file con l'extension che corrisponde a quel format. Richiedere un format e salvare con un'altra extension è il modo in cui crei un file che nessun player aprirà.
Due dettagli pratici ti risparmiano problemi in seguito. Primo, esegui lo streaming della response su disk per renderizzazioni lunghe invece di tenere tutto in memory. Secondo, memorizza le request settings accanto al file, inclusi model e voice identifier, locale, sample rate e la date. Quando un cliente chiede di registrare nuovamente un paragrafo un mese dopo, quel record è il modo in cui abbini l'originale.
Per l'accesso, pianifica le credentials. Il pay-per-request funziona per la chat tramite POST /v1/chat/completions e POST /v1/messages, mentre images, video, music e speech richiedono ancora una key. Quindi, integra lo storage e la rotation delle key nel tuo workflow di speech fin dall'inizio, non come una patch.
Un buon primo file non ha parole iniziali o finali tagliate, pause chiare alla fine delle frasi e una durata vicina a quella che ti aspetteresti per il conteggio delle parole.
Controlla la duration prima di ogni altra cosa. Se il tuo sample dovrebbe durare circa 30 secondi e il file mostra quattro secondi, qualcosa è andato storto, e nessun ascolto lo risolverà. Rigenera il sample, non l'intero document, finché la versione breve non sarà corretta.
Risolvere i download che non si riproducono o suonano male
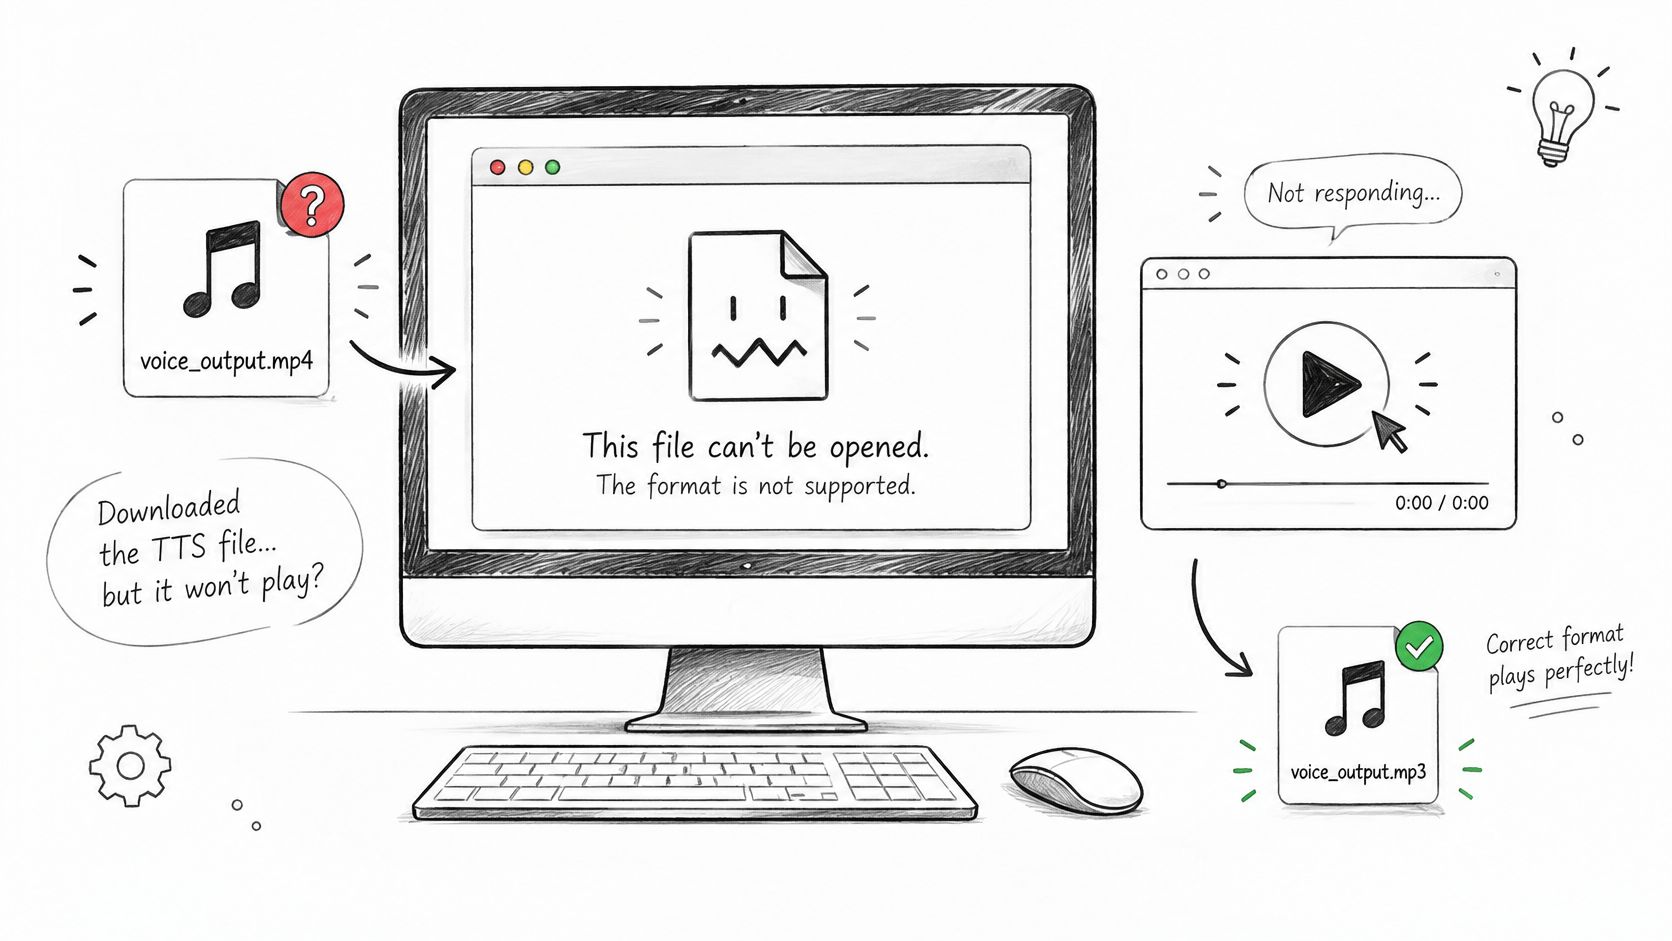
Il problema più comune è banale. Il file si scarica, sembra normale, ma non si apre perché l'audio grezzo o codificato in modo diverso è stato salvato con un'estensione che non corrisponde al suo contenuto. I lettori si fidano dell'estensione, poi falliscono sui byte all'interno.
Problemi di download, cause e soluzioni
| Sintomo | Causa probabile | Soluzione |
|---|---|---|
| Il file non si apre | Audio grezzo salvato con l'estensione sbagliata | Salva con l'estensione che corrisponde al formato richiesto |
| L'audio si interrompe prima della fine | La risposta in streaming è stata troncata | Confronta la durata con la lunghezza prevista e scarica di nuovo |
| Silenzio o rumore statico | Frequenza di campionamento o codifica non supportata dal lettore | Rigenera in MP3 o WAV con una frequenza di campionamento standard |
| Parole saltate o unite | Testo lungo diviso a metà frase | Dividi l'input ai confini delle frasi e rigenera |
| Numeri o acronimi letti male | Testo non normalizzato prima della sintesi | Scrivi per esteso date, valute e acronimi prima di generare |
| Accento o lingua sbagliati | Locale non impostato | Imposta esplicitamente la lingua e il locale nella richiesta |
Procedi nella tabella in ordine di sforzo. Rinominare un file con l'estensione corretta e impostare un locale richiede pochi minuti. Un flusso troncato necessita di un nuovo download e di un controllo del conteggio dei byte o della durata. Le parole saltate e la lettura errata dei numeri richiedono la correzione del testo e la rigenerazione dell'audio, perché nessuna impostazione del lettore potrà recuperare parole che non sono mai state sintetizzate correttamente.
Tre controlli risolvono la maggior parte dei problemi prima della pubblicazione. Conferma che il file decodifica e ha una durata diversa da zero che corrisponde approssimativamente alle tue aspettative. Riproducilo su due dispositivi, idealmente un laptop e un telefono. Quindi trascrivilo con qualsiasi strumento di riconoscimento vocale e confronta le parole con il tuo testo sorgente, prestando molta attenzione a numeri e nomi.
Questo approccio stratificato corrisponde alle pratiche di valutazione formale. Un documento di benchmark sulla valutazione del parlato sintetizzato ha unificato i campioni di test come 16-kHz WAV prima del punteggio e ha utilizzato controlli separati per l'integrità del file, l'intelligibilità e la qualità percettiva. Non hai bisogno di tutto questo rigore per un singolo voiceover, ma copia il principio. Una risposta di download riuscita non prova che tu abbia un parlato utilizzabile, quindi controlla l'audio stesso, non il codice di stato.
Mantieni separati anche i tuoi limiti. Un file può essere scaricato in modo affidabile, suonare piacevole e comunque leggere un prezzo in modo errato. Registra il trasporto, l'intelligibilità e la naturalezza come risultati diversi, e saprai quale correzione applicare invece di rigenerare a caso.
Se puoi pubblicare l'audio scaricato
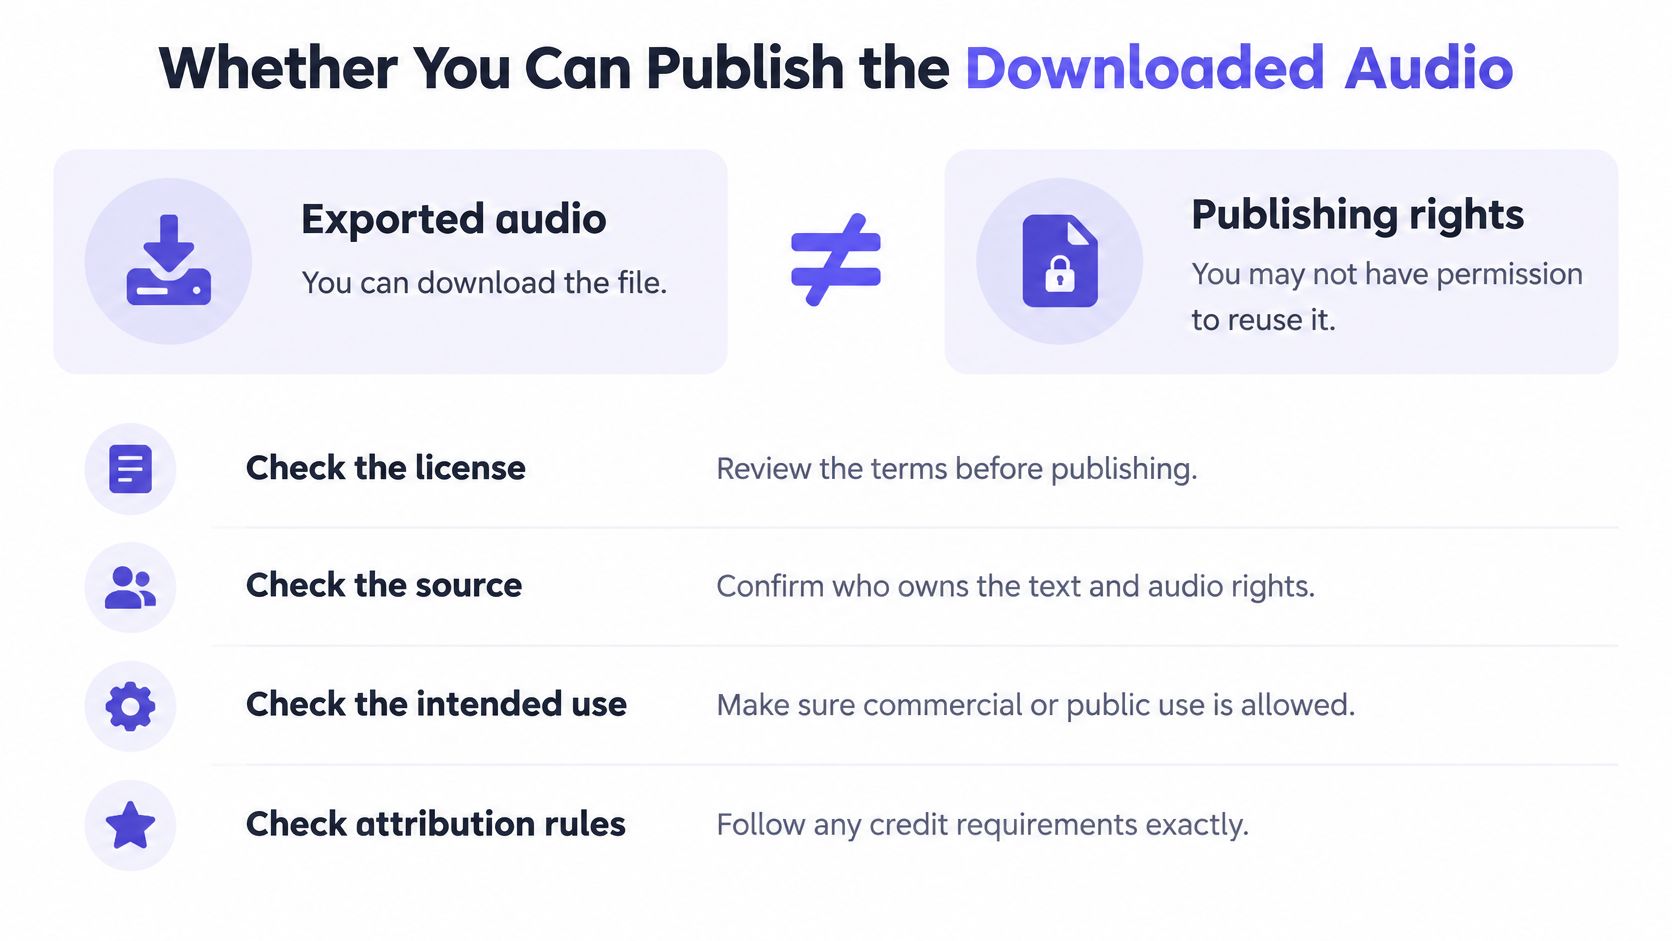
Ecco l'assunto da abbandonare: un file sul tuo disco rigido non è automaticamente tuo da pubblicare, vendere o ridistribuire. Poter esportare l'audio e avere il diritto di usarlo sono due cose diverse, e le guide al download che si fermano al pulsante di salvataggio ti lasciano addosso quel rischio.
Controlla questi punti prima che il file venga reso pubblico:
- Il tuo piano e i termini: Conferma se l'uso commerciale è consentito dal tuo piano, non solo l'uso personale. I piani gratuiti spesso limitano l'uso monetizzato.
- Il tipo di voce: Una voce predefinita e una voce clonata comportano obblighi diversi. Un clone necessita del consenso della persona che imita.
- I tuoi diritti sull'input: Hai bisogno dei diritti sul testo che stai convertendo, non solo sull'audio che ne risulta.
- Divulgazione: Decidi se il tuo mercato o la tua piattaforma ti richiede di etichettare il parlato sintetico e aggiungi tale etichetta prima della pubblicazione.
La responsabilità è tua. La nota sulla trasparenza del text-to-speech di Microsoft pone la responsabilità sugli utenti di assicurarsi i diritti sul testo di input, sul talento vocale, sull'immagine e su altro materiale sorgente, mentre l'output di voci predefinite a pagamento può generalmente essere utilizzabile commercialmente secondo i termini applicabili. Leggi i termini del tuo fornitore in quest'ottica, piuttosto che dare per scontato che corrispondano.
I download open-source aggiungono un secondo livello. Il codice e i pesi del modello possono avere licenze separate, ed entrambi possono limitare l'uso commerciale, la ridistribuzione o l'offerta del modello come servizio ospitato. Controlla entrambi, più la licenza su qualsiasi dato vocale da cui hai effettuato il fine-tuning.
Conserva le prove finché è facile. Salva il piano o i termini di licenza in vigore alla data del download, il nome e la versione della voce, le impostazioni della tua richiesta e la data stessa. Questo registro è più importante quando il file si sposta verso un rivenditore, una piattaforma pubblicitaria o il canale di un cliente, perché i termini originali non viaggiano all'interno di un MP3. Se la tua narrazione sarà inserita in un video, risolvi le stesse questioni di provenienza per l'asset finale utilizzando questa guida per ottenere video prima di caricarlo ovunque.
Esegui un download di prova prima di impegnarti
Puoi definire formato, voce e diritti in un pomeriggio con un singolo campione impegnativo. Non usare testo demo facile. Usa testo che può fallire.
- Incolla circa 1,000 caratteri che includano numeri, un nome proprio, una data e un acronimo.
- Generalo in WAV e MP3 con la stessa voce e impostazioni, poi confronta entrambi i file.
- Riproduci ciascuno su un telefono e un laptop e controlla la durata rispetto alle tue aspettative.
- Trascrivi un file e confronta le parole con la tua fonte, annotando ogni numero letto male.
- Archivia il test accanto alla prova della tua licenza, etichettato con nome della voce, formato e data.
Prezza il lavoro completo da quel campione prima di scalare. Con un tasso di esempio calcolato dove Qwen3 0.6B TTS costa $0.035 per 1K caratteri, rispetto a un prezzo di listino di $0.0875 per 1K caratteri, il tuo test di 1,000 caratteri costa $0.035, o 3.5 centesimi. Moltiplica per la lunghezza reale del tuo script e avrai un budget, non una stima. Confronta le voci candidate allo stesso modo, includendo un modello come ElevenLabs TTS v4, usando un testo di prova identico.
Se il campione fallisce, correggi la causa specifica e riesegui il campione. Un test fallito quasi sempre indica un'impostazione, un numero non normalizzato o un'estensione errata. Una volta che entrambi i formati superano il test e il controllo dei tuoi diritti è valido, renderizza il testo completo e conserva il file di test come riferimento per ogni rendering futuro.
Pronto a generare il tuo primo file verificato invece di renderizzare di nuovo quello stesso rotto? UberLLM ti offre modelli di testo, immagine, video, musica e voce tramite un'unica API, così puoi testare le voci, scaricare l'audio nel formato di cui il tuo progetto ha bisogno e mantenere il tuo flusso di lavoro in un unico posto. Inizia il tuo primo download di prova oggi su UberLLM.