Text-zu-Sprache-Download: Audio in 2026 generieren und speichern
Anleitung zum Text-zu-Sprache-Download: Audio aus Text generieren, als MP3 oder WAV speichern, die Datei überprüfen und bestätigen Sie, dass Sie die Nutzungsrechte dafür haben.
Du hast ein Skript bereit, heute eine Frist und ein Tool, das die Stimme perfekt in deinem Browser abspielt. Dann lädst du es herunter, und die Datei lässt sich nicht öffnen, bricht frühzeitig ab oder kann rechtlich nicht in dem Video verwendet werden, für das du es erstellt hast. Genau diese Lücke ist der Ursprung der meisten Probleme beim Herunterladen von Text-zu-Sprache-Dateien. Behandle den Download als fertiges Audio-Asset, nicht als einen Browser-Trick, und du wirst diese Probleme erkennen, solange sie noch günstig zu beheben sind.
Inhaltsverzeichnis
- Den richtigen Weg wählen, um Ihre Audiodatei zu erhalten
- MP3, WAV oder ein anderes Format wählen
- So generieren und laden Sie Ihre erste Audiodatei herunter
- Downloads reparieren, die nicht abgespielt werden oder falsch klingen
- Ob Sie die heruntergeladene Audiodatei veröffentlichen können
- Führen Sie einen Test-Download durch, bevor Sie sich festlegen
Wählen Sie den passenden Weg, um Ihre Audiodatei zu erhalten
Beginnen Sie mit einer Frage. Benötigen Sie eine gespeicherte Datei, die Sie behalten, bearbeiten und verschieben können, oder benötigen Sie nur Text, der jetzt auf einem Bildschirm vorgelesen wird? Das sind unterschiedliche Aufgaben, und das Tool, das die eine gut erledigt, kann die andere oft überhaupt nicht.
Ein Web-Tool ist am schnellsten für eine einzelne Erzählung, da nichts installiert werden muss. Eine Desktop-App rechnet sich, wenn Sie jede Woche Dokumente konvertieren und jedes Mal dieselbe Stimme, Ordnerstruktur und Einstellungen wünschen. Eine API dreht die Arbeit um. Ihr Code sendet Text, empfängt Audio-Bytes in der Antwort und speichert die Datei dort, wo Ihre App sie benötigt. Das ist die richtige Form für Audio pro Benutzer und die falsche Form für ein einzelnes Podcast-Intro.
Wege, um eine Text-zu-Sprache-Datei zu erhalten
| Methode | Typische Ausgabe | Funktioniert offline | Am besten geeignet für |
|---|---|---|---|
| Online TTS-Webtool mit Download-Button | MP3 oder WAV | Nein | Einmalige Erzählungen und schnelle Voiceovers |
| Desktop-TTS-Anwendung | MP3 oder WAV | Ja, sobald Stimmen installiert sind | Regelmäßig konvertierte Dokumentenstapel |
| Text-to-Speech-API-Aufruf | Audio-Bytes in der Antwort, Format in der Anfrage festgelegt | Nein | Apps, die Audio für jeden Benutzer erstellen |
| Lokal ausgeführtes Open-Source-Modell | WAV oder das Format, das Ihr Code schreibt | Ja | Sensible Texte und Offline-Workflows |
| Bildschirmleseprogramm des Betriebssystems | Normalerweise keine gespeicherte Datei | Ja | Zum Anhören statt zum Erstellen einer Datei |
Lokale Open-Source-Modelle eignen sich für vertrauliche Entwürfe, Kundenmaterial und Arbeiten ohne zuverlässige Verbindung. Der Kompromiss ist real. Sie benötigen Speicherplatz für Modelle und Stimmdateien, eine Maschine, die mit einer brauchbaren Geschwindigkeit rendern kann, und Zeit, um sie einzurichten und auf dem neuesten Stand zu halten. Datenschutz ist auch nicht automatisch gegeben, nur weil die Synthese lokal erfolgt. Überprüfen Sie, ob die App immer noch Analysedaten, Absturzberichte oder Stimmreferenzdateien irgendwohin sendet.
Bildschirmleseprogramme gehören zu einer anderen Kategorie. Sie sind für das Anhören und die Navigation konzipiert, daher sprechen die meisten Text laut vor, ohne eine portable Datei zu speichern. Wenn Ihr Ergebnis eine MP3 ist, die jemand anderes später abspielen kann, löst ein Bildschirmleseprogramm Ihr Problem nicht.
Faustregel: Wenn Sie dieselbe Stimme mehr als ein paar Mal pro Woche generieren, wählen Sie den Stapel- oder API-Zugriff, anstatt immer wieder in ein Webformular einzufügen.
Bevor Sie sich für einen Weg entscheiden, vergleichen Sie Stimmen und Modellverhalten in diesem Leitfaden zu Text-to-Speech-Modellen, und testen Sie dann Ihr tatsächliches Skript. Eine Stimme, die in einem kurzen Demo-Satz poliert klingt, kann immer noch über Ihre Produktnamen, Preise und Akronyme stolpern.
MP3, WAV oder ein anderes Format wählen
Das Format entscheidet über drei Dinge gleichzeitig: Dateigröße, Bearbeitungsflexibilität und Kompatibilität. Wählen Sie es einmal pro Projekt, bevor Sie rendern, denn eine spätere Konvertierung verschwendet entweder Speicherplatz oder beeinträchtigt die Qualität.
MP3 und AAC sind verlustbehaftet. Sie verwerfen Audiodetails, um klein zu bleiben, und jede erneute Kodierung verwirft ein bisschen mehr. Das ist in Ordnung für eine fertige Datei, die an einen Player geht. Es ist eine schlechte Wahl für eine Masterdatei, die Sie trimmen, pegeln, unter Musik mischen und erneut exportieren werden. WAV behält das volle Signal, weshalb Editoren es bevorzugen und warum eine lange Erzählung schnell groß wird. FLAC ist ebenfalls verlustfrei und kleiner als WAV, aber Sie werden immer noch auf Player, Upload-Formulare und ältere Geräte stoßen, die es ablehnen.
Audioformate und ihre Kompromisse
| Format | Größe pro Minute | Am besten für | Vorsicht bei |
|---|---|---|---|
| MP3 | Etwa 1 MB bei 128 kbps | Teilen, Podcasts, Web-Wiedergabe | Verlustbehaftet, erneute Kodierung führt zu Qualitätsverlust |
| WAV | Etwa 2.6 MB Mono bei 22.05 kHz, etwa 10.6 MB für CD-Qualität Stereo | Bearbeitung, Archivierung, Masterkopien | Große Dateien, eine zehnminütige Stereo-Erzählung kann etwa 100 MB erreichen |
| M4A oder AAC | Etwa 1 MB bei 128 kbps | Apple-Geräte und mobile Apps | Manche Bearbeitungstools akzeptieren es weniger bereitwillig |
| FLAC | Etwa die Hälfte von WAV, variiert mit dem Inhalt | Verlustfreies Archiv | Nicht jeder Player unterstützt es |
Die Größe spielt früher eine Rolle, als man erwartet. Ein kurzes Voiceover ist in jedem Format trivial. Ein langer Trainingskurs, ein Satz von Hörbuchkapiteln oder eine Bibliothek generierter Prompts verwandelt diese Lücke pro Minute in Speicherplatz, Upload-Zeit und Sicherungskosten.
Kompatibilität ist für Zuhörer genauso wichtig. Speichern Sie gesprochene Inhalte in einem weit verbreiteten Format, kennzeichnen Sie das Format klar und stellen Sie sicher, dass die Datei ohne die App, die sie erstellt hat, abgespielt werden kann. Ein Download, den Ihr Publikum auf einem Telefon nicht öffnen kann, ist nicht zugänglich, unabhängig von der Sprachqualität.
Diese Wahl ist ein neuer Luxus. Herunterladbare Sprache wurde erst praktisch, als Softwaresynthesizer in nahezu Echtzeit einigermaßen verständliche Sprache erzeugen konnten, ein Punkt, den der ANSI Blog zur Geschichte der Text-to-Speech-Technologie in die späten 1980er Jahre datiert. Davor haben Sie keine Codecs gewählt. Sie haben Hardware gewählt.
Ich würde es einfach halten. Laden Sie WAV als Ihre Masterkopie herunter und exportieren Sie dann MP3 für die Verteilung. Sie bearbeiten die Datei, die nichts verloren hat, und Ihre Zuhörer erhalten die Datei, die überall abgespielt wird.
So generieren und laden Sie Ihre erste Audiodatei herunter
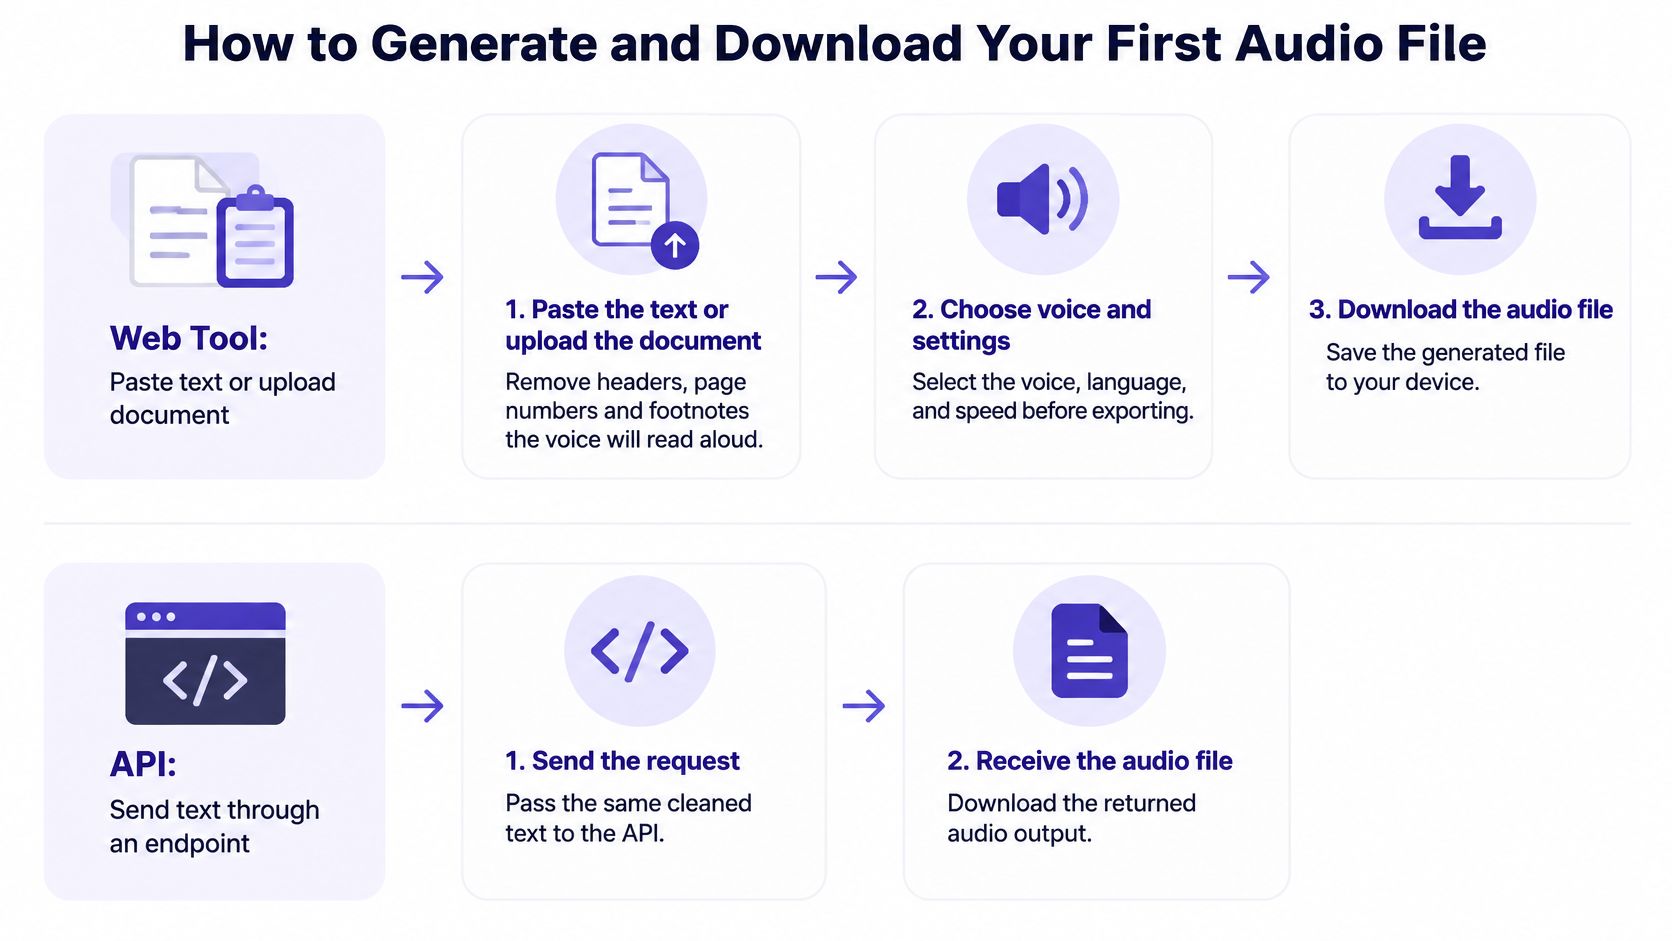
Sauberer Text rein, verifizierte Datei raus. Die meisten fehlerhaften Downloads entstehen, bevor Sie auf „Generieren“ klicken, durch ungepflegten Text und unbeabsichtigte Einstellungen.
Verwendung eines Web-Tools
- Fügen Sie den Text ein oder laden Sie das Dokument hoch. Entfernen Sie Kopfzeilen, Seitenzahlen, Fußnoten, Tabellenreste und URLs, die nicht vorgelesen werden sollen. Die Stimme liest alles vor, was vorhanden ist, einschließlich der Fußzeile.
- Wählen Sie Sprache, Stimme und Gebietsschema (locale) explizit aus. Das Gebietsschema (locale) steuert, wie sich Daten, Währungen und Zahlen anhören. Lassen Sie das Tool nicht anhand Ihrer Browsereinstellungen raten.
- Lassen Sie die Geschwindigkeit für den ersten Durchlauf auf der Standardeinstellung. Schnellere Raten verwischen oft Konsonanten und verschlucken kurze Wörter. Passen Sie sie erst an, nachdem Sie eine saubere Ausgangsversion gehört haben.
- Generieren Sie zuerst eine kurze Hörprobe, etwa 30 Sekunden lang. Hören Sie sie vollständig an. So erkennen Sie die falsche Stimme, den falschen Akzent oder einen falsch ausgesprochenen Namen, bevor Sie für die vollständige Wiedergabe des Skripts bezahlen.
- Wählen Sie das Ausgabeformat für die Aufgabe. Wählen Sie WAV, wenn Sie bearbeiten möchten, MP3, wenn die Datei fertig ist und an Zuhörer geht.
- Laden Sie sie herunter und benennen Sie sie sofort um. Verwenden Sie Projekt, Stimme und Datum im Dateinamen. Ein Ordner voller Dateien namens output.mp3 ist innerhalb einer Woche nicht mehr nachvollziehbar.
Verwendung einer API
Der API-Weg folgt der gleichen Logik im Code. Holen Sie sich einen key von Ihrem Anbieter und senden Sie dann einen POST request mit dem model, dem input text, der voice und dem gewünschten response format. Schreiben Sie die zurückgegebenen bytes in eine Datei mit der Erweiterung, die diesem format entspricht. Ein format anzufordern und mit einer anderen Erweiterung zu speichern, ist der Weg, wie Sie eine Datei erstellen, die kein Player öffnen wird.
Zwei praktische Details ersparen später Ärger. Erstens, streamen Sie die response für lange renders auf die Festplatte, anstatt alles im memory zu halten. Zweitens, speichern Sie die request settings neben der Datei, einschließlich model und voice identifier, locale, sample rate und dem Datum. Wenn ein Kunde einen Monat später einen Absatz neu aufgenommen haben möchte, ist diese Aufzeichnung der Weg, wie Sie das Original abgleichen.
Planen Sie beim Zugriff credentials ein. Pay-per-request funktioniert für chat über POST /v1/chat/completions und POST /v1/messages, während images, video, music und speech weiterhin einen key erfordern. Bauen Sie also key storage und rotation von Anfang an in Ihren speech workflow ein, nicht als patch.
Eine gute erste Datei hat keine abgeschnittenen ersten oder letzten Wörter, klare Pausen am Satzende und eine Dauer, die dem entspricht, was Sie für die Wortanzahl erwarten würden.
Überprüfen Sie die Dauer vor allem anderen. Wenn Ihre Hörprobe etwa 30 Sekunden dauern sollte und die Datei vier Sekunden anzeigt, ist etwas fehlgeschlagen, und kein noch so langes Anhören wird es beheben. Generieren Sie die Hörprobe neu, nicht das gesamte Dokument, bis die kurze Version korrekt ist.
Downloads reparieren, die sich nicht abspielen lassen oder falsch klingen
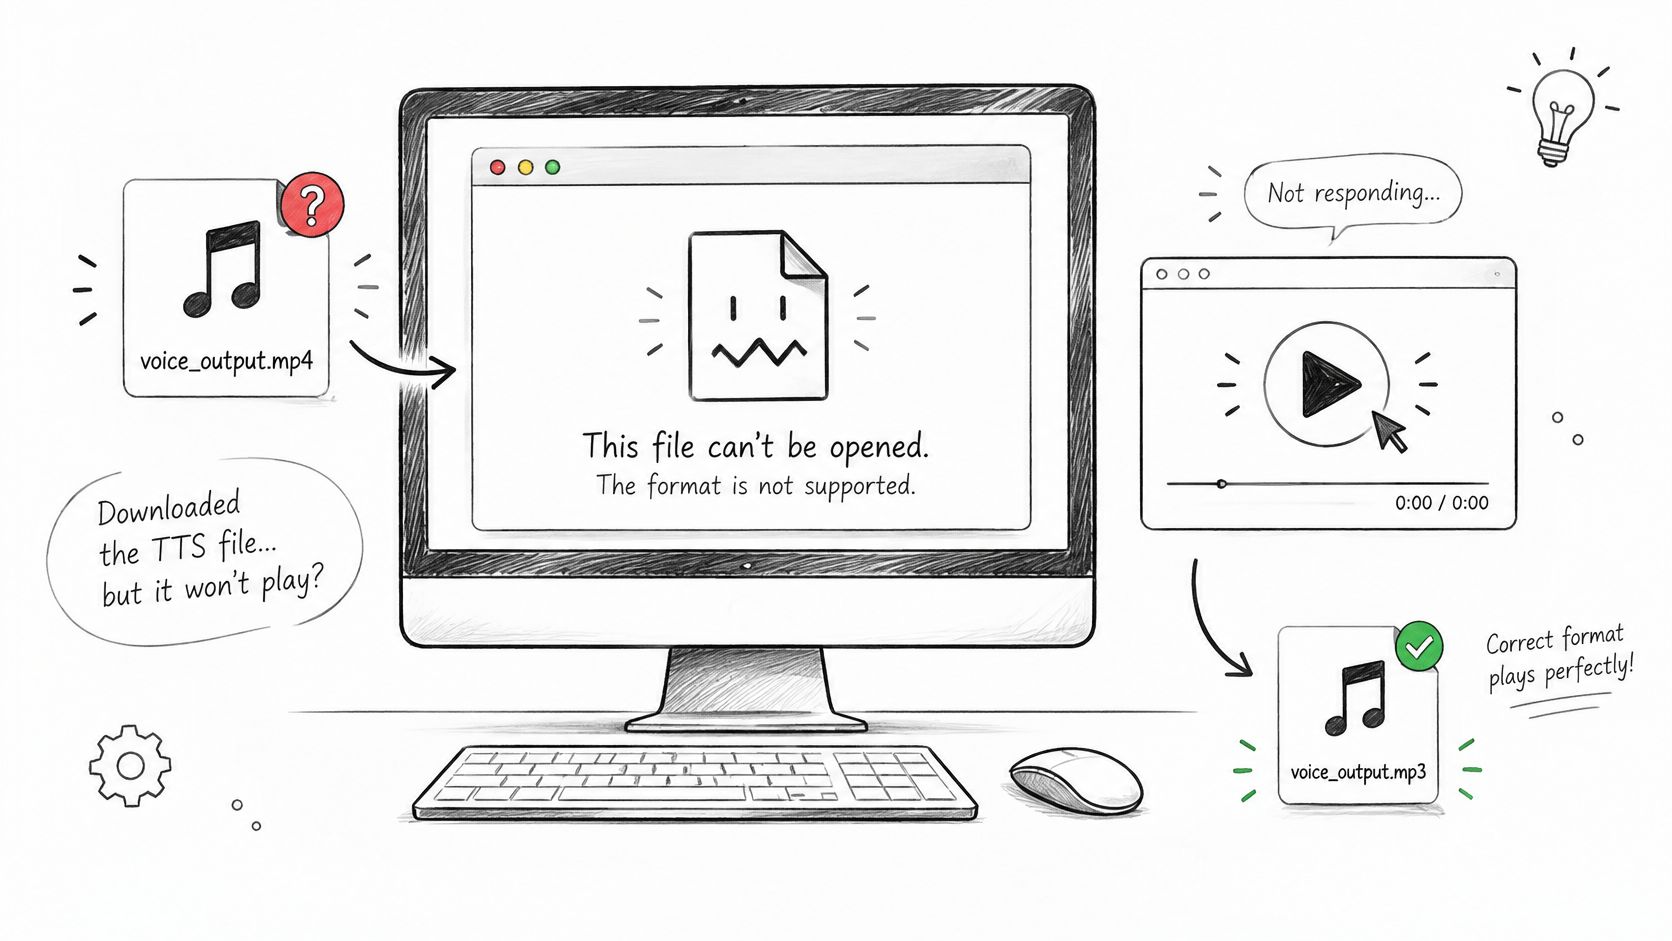
Der häufigste Fehler ist banal. Die Datei lädt herunter, sieht normal aus und lässt sich nicht öffnen, weil rohes oder anders kodiertes Audio mit einer Dateiendung gespeichert wurde, die nicht zum Inhalt passt. Player verlassen sich auf die Endung und scheitern dann an den Bytes im Inneren.
Download-Probleme, Ursachen und Lösungen
| Symptom | Wahrscheinliche Ursache | Lösung |
|---|---|---|
| Datei lässt sich nicht öffnen | Rohes Audio mit der falschen Endung gespeichert | Mit der Endung speichern, die zum angeforderten Format passt |
| Audio stoppt vor dem Ende | Gestreamte Antwort wurde abgeschnitten | Dauer mit der erwarteten Länge vergleichen und erneut herunterladen |
| Stille oder Rauschen | Abtastrate oder Kodierung wird vom Player nicht unterstützt | In MP3 oder WAV mit einer Standard-Abtastrate neu generieren |
| Wörter werden übersprungen oder zusammengezogen | Langer Text mitten im Satz geteilt | Eingabe an Satzgrenzen aufteilen und neu generieren |
| Zahlen oder Akronyme werden falsch vorgelesen | Text vor der Synthese nicht normalisiert | Datumsangaben, Währung und Akronyme vor dem Generieren ausschreiben |
| Falscher Akzent oder falsche Sprache | Locale nicht gesetzt | Sprache und Locale explizit in der Anfrage festlegen |
Arbeite die Tabelle nach Aufwand durch. Eine Datei auf die richtige Endung umzubenennen und eine Locale festzulegen, dauert Minuten. Ein abgeschnittener Stream braucht einen neuen Download und eine Prüfung der Byteanzahl oder Dauer. Übersprungene Wörter und falsch vorgelesene Zahlen erfordern, dass der Text korrigiert und das Audio neu generiert wird, denn keine Player-Einstellung holt Wörter zurück, die nie richtig synthetisiert wurden.
Drei Prüfungen fangen die meisten Probleme vor der Veröffentlichung ab. Bestätige, dass sich die Datei dekodieren lässt und eine Dauer größer als null hat, die ungefähr deiner Erwartung entspricht. Spiele sie auf zwei Geräten ab, idealerweise auf einem Laptop und einem Smartphone. Transkribiere sie dann mit einem beliebigen Speech-to-Text-Tool und vergleiche die Wörter mit deinem Ausgangstext; achte dabei besonders auf Zahlen und Namen.
Dieser mehrstufige Ansatz entspricht der Praxis formaler Evaluierungen. Ein Benchmark-Paper zur Bewertung synthetisierter Sprache vereinheitlichte Testproben als 16-kHz-WAV vor der Bewertung und nutzte getrennte Prüfungen für Dateiintegrität, Verständlichkeit und Wahrnehmungsqualität. Für ein einzelnes Voiceover brauchst du nicht diese volle Gründlichkeit, aber übernimm das Prinzip. Eine erfolgreiche Download-Antwort beweist nicht, dass du brauchbare Sprache hast; prüfe also das Audio selbst, nicht den Statuscode.
Halte auch deine Schwellenwerte getrennt. Eine Datei kann zuverlässig heruntergeladen werden, angenehm klingen und trotzdem einen Preis falsch vorlesen. Protokolliere Transport, Verständlichkeit und Natürlichkeit als unterschiedliche Ergebnisse, und du weißt, welche Korrektur du anwenden musst, statt zufällig neu zu generieren.
Ob Sie das heruntergeladene Audio veröffentlichen dürfen
Verabschieden Sie sich von dieser Annahme: Eine Datei auf Ihrer Festplatte gehört Ihnen nicht automatisch, um sie zu veröffentlichen, zu verkaufen oder weiterzuverbreiten. Audio exportieren zu können und das Recht zu haben, es zu nutzen, sind zwei verschiedene Dinge, und Download-Anleitungen, die beim Speichern-Button aufhören, überlassen Ihnen dieses Risiko.
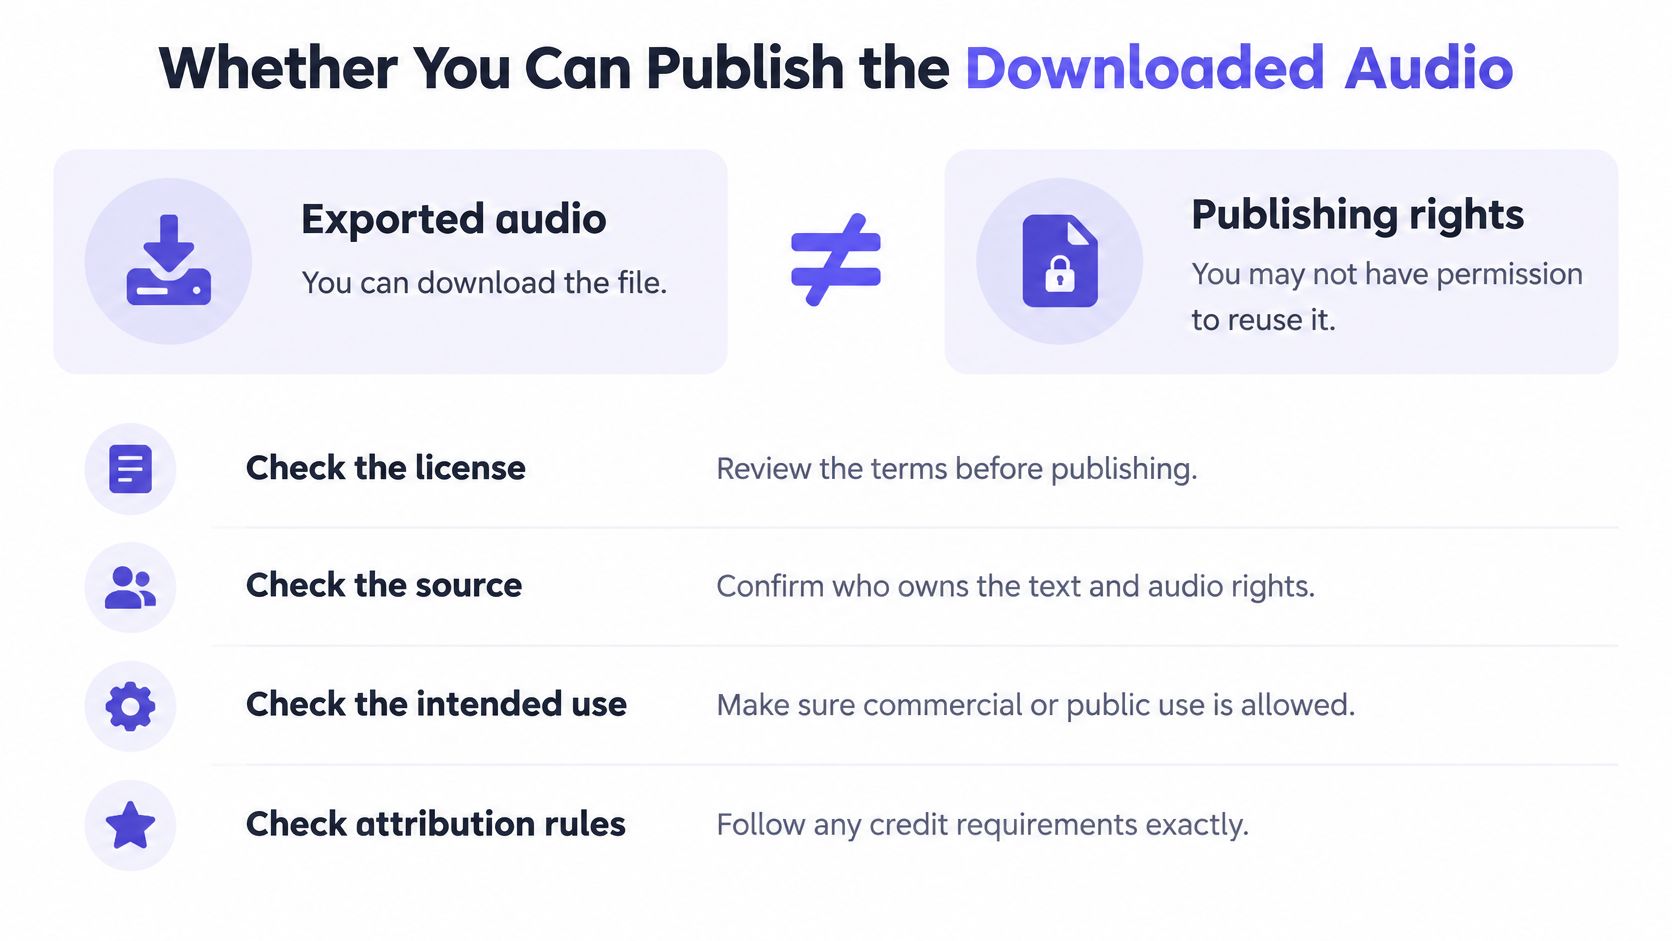
Prüfen Sie Folgendes, bevor die Datei öffentlich zugänglich gemacht wird:
- Ihr Tarif und Ihre Bedingungen: Bestätigen Sie, ob kommerzielle Nutzung in Ihrem Tarif erlaubt ist, nicht nur die persönliche Nutzung. Kostenlose Tarife schränken die monetarisierte Nutzung oft ein.
- Der Stimmentyp: Eine vorgefertigte Stimme und eine geklonte Stimme bringen unterschiedliche Verpflichtungen mit sich. Ein Klon benötigt die Zustimmung der Person, die er imitiert.
- Ihre Eingaberechte: Sie benötigen Rechte an dem Text, den Sie konvertieren, nicht nur an dem Audio, das dabei entsteht.
- Offenlegung: Entscheiden Sie, ob Ihr Markt oder Ihre Plattform verlangt, dass Sie synthetische Sprache kennzeichnen, und fügen Sie diese Kennzeichnung vor der Veröffentlichung hinzu.
Diese Verantwortung liegt bei Ihnen. Microsofts Transparenzhinweis für Text-to-Speech legt die Verantwortung auf die Nutzer, Rechte an Eingabetext, Sprecher, Abbild und anderem Quellmaterial zu sichern, während die Ausgabe von bezahlten vorgefertigten Stimmen im Allgemeinen unter den geltenden Bedingungen kommerziell nutzbar sein kann. Lesen Sie die Bedingungen Ihres eigenen Anbieters in diesem Licht, anstatt anzunehmen, dass sie übereinstimmen.
Open-Source-Downloads fügen eine zweite Ebene hinzu. Code und Modellgewichte können separate Lizenzen haben, und jede davon kann die kommerzielle Nutzung, Weiterverbreitung oder das Anbieten des Modells als gehosteten Dienst einschränken. Prüfen Sie beides, plus die Lizenz für alle Stimmendaten, von denen Sie feinabgestimmt haben.
Bewahren Sie Beweise auf, solange es einfach ist. Speichern Sie den Plan oder die Lizenzbedingungen, die am Download-Datum galten, den Stimmnamen und die Version, Ihre Anforderungseinstellungen und das Datum selbst. Diese Aufzeichnung ist am wichtigsten, wenn die Datei an einen Einzelhändler, eine Werbeplattform oder einen Kanal eines Kunden weitergegeben wird, da die ursprünglichen Bedingungen nicht in einer MP3 mitreisen. Wenn Ihre Erzählung in einem Video enthalten sein wird, klären Sie die gleichen Herkunftsfragen für das fertige Asset mithilfe dieses Leitfadens zum Erstellen von Videos, bevor Sie es irgendwo hochladen.
Machen Sie einen Test-Download, bevor Sie sich festlegen
Sie können Format, Stimme und Rechte an einem Nachmittag mit einer einzigen aussagekräftigen Probe klären. Verwenden Sie keinen einfachen Demo-Text. Verwenden Sie Text, der fehlschlagen kann.
- Fügen Sie etwa 1,000 Zeichen ein, die Zahlen, einen Personennamen, ein Datum und ein Akronym enthalten.
- Generieren Sie es in WAV und MP3 mit derselben Stimme und denselben Einstellungen, vergleichen Sie dann beide Dateien.
- Spielen Sie jede Datei auf einem Telefon und einem Laptop ab und überprüfen Sie die Dauer im Vergleich zu Ihrer Erwartung.
- Transkribieren Sie eine Datei und vergleichen Sie die Wörter mit Ihrer Quelle, wobei Sie jede falsch gelesene Zahl notieren.
- Archivieren Sie den Test neben Ihrem Lizenznachweis, beschriftet mit Stimmenname, Format und Datum.
Kalkulieren Sie den gesamten Auftrag anhand dieser Probe, bevor Sie skalieren. Bei einem Beispieltarif, bei dem Qwen3 0.6B TTS $0.035 pro 1K Zeichen kostet, gegenüber einem Listenpreis von $0.0875 pro 1K Zeichen, kostet Ihr 1,000 Zeichen-Test $0.035, oder 3.5 Cent. Multiplizieren Sie mit Ihrer tatsächlichen Skriptlänge und Sie haben ein Budget, keine Schätzung. Vergleichen Sie Kandidatenstimmen auf dieselbe Weise, einschließlich eines Modells wie ElevenLabs TTS v4, unter Verwendung identischen Testtextes.
Wenn die Probe fehlschlägt, beheben Sie die spezifische Ursache und wiederholen Sie die Probe. Ein fehlgeschlagener Test weist fast immer auf eine Einstellung, eine nicht normalisierte Zahl oder eine falsche Erweiterung hin. Sobald beide Formate bestehen und Ihre Rechteprüfung gültig ist, rendern Sie den vollständigen Text und bewahren Sie die Testdatei als Referenz für jedes zukünftige Rendering auf.
Bereit, Ihre erste verifizierte Datei zu generieren, anstatt dieselbe fehlerhafte immer wieder neu zu rendern? UberLLM bietet Ihnen Text-, Bild-, Video-, Musik- und Sprachmodelle über eine API, damit Sie Stimmen testen, Audio im Format Ihres Projekts herunterladen und Ihren Workflow an einem einzigen Ort behalten können. Starten Sie Ihren ersten Test-Download noch heute unter UberLLM.