Liste der KI-Modelle 2026: 10 Optionen nach Anwendungsfall
Durchsuchen Sie diese praktische Liste von KI-Modellen nach Modalität, Fähigkeit und Anwendungsfall, wobei 10 Kataloge hinsichtlich Preisen, Zugang und am besten geeigneten Workloads verglichen werden.
Nehmen wir an, Ihr Team verbringt eine Woche damit, Modellseiten zu lesen, Token-Preise zu vergleichen und einen Prototyp aufzusetzen. Dann lädt jemand ein repräsentatives Dokument hoch und entdeckt, dass der günstigste Kandidat das Dokument, die Anweisungen und die erwartete Antwort nicht in seinem Kontextfenster unterbringen kann. Die Integration funktioniert. Die Modellwahl nicht.
Ein Modellkatalog ist nicht dasselbe wie eine Modellwahl. Einige Kataloge helfen Ihnen, herunterladbare Gewichte zu entdecken. Andere vergleichen die gemessene Leistung, verkaufen gehostete Inference, verbinden Modelle mit der Cloud-Beschaffung oder verpacken Modelle für die lokale Ausführung. Sie als austauschbar zu behandeln, verschwendet Zeit und kann die Einschränkung verbergen, die bestimmt, ob Ihre Anwendung funktioniert.
Eine nützliche Liste von KI-Modellen sollte Ihnen sagen, wo Sie für eine bestimmte Aufgabe anfangen sollen:
- Modelle entdecken und anpassen: Verwenden Sie ein Verzeichnis mit Modellkarten, Dateien und Lizenzinformationen.
- Produktionskandidaten vergleichen: Verwenden Sie unabhängige Messungen und testen Sie dann Ihre eigene Arbeitslast.
- Gehostete Modelle aufrufen: Verwenden Sie einen API-Katalog mit expliziten Modell-Identifikatoren und Bereitstellungsdetails.
- Offline ausführen: Verwenden Sie einen lokalen Laufzeitkatalog und überprüfen Sie die Hardwareanforderungen.
Für Textanwendungen können Kontextlänge und Tool-Unterstützung Kandidaten sofort eliminieren. Für Bild-, Video- und Audioanwendungen verdienen unterstützte Eingaben, Ausgabesteuerungen und asynchrone Aufgabenbearbeitung die gleiche Aufmerksamkeit. Die unten stehenden Optionen dienen unterschiedlichen Zwecken, daher hängt der richtige Ausgangspunkt weniger davon ab, welcher Katalog am größten aussieht, und mehr davon, was Sie als Nächstes tun müssen.
Inhaltsverzeichnis
- 1. UberLLM KI-Modellkatalog
- 2. OpenRouter
- 3. Hugging Face Hub
- 4. Artificial Analysis
- 5. Replicate Explore
- 6. Microsoft Foundry Models
- 7. Amazon Bedrock Modellkatalog
- 8. Google Cloud Model Garden
- 9. Ollama Library
- 10. Google Gemini API Modellliste
- Wie sich die 10 Modellkataloge nach Zugang, Preistransparenz und Limits unterscheiden
- Eine Auswahlliste in eine funktionierende Integration verwandeln
1. UberLLM KI-Modellkatalog
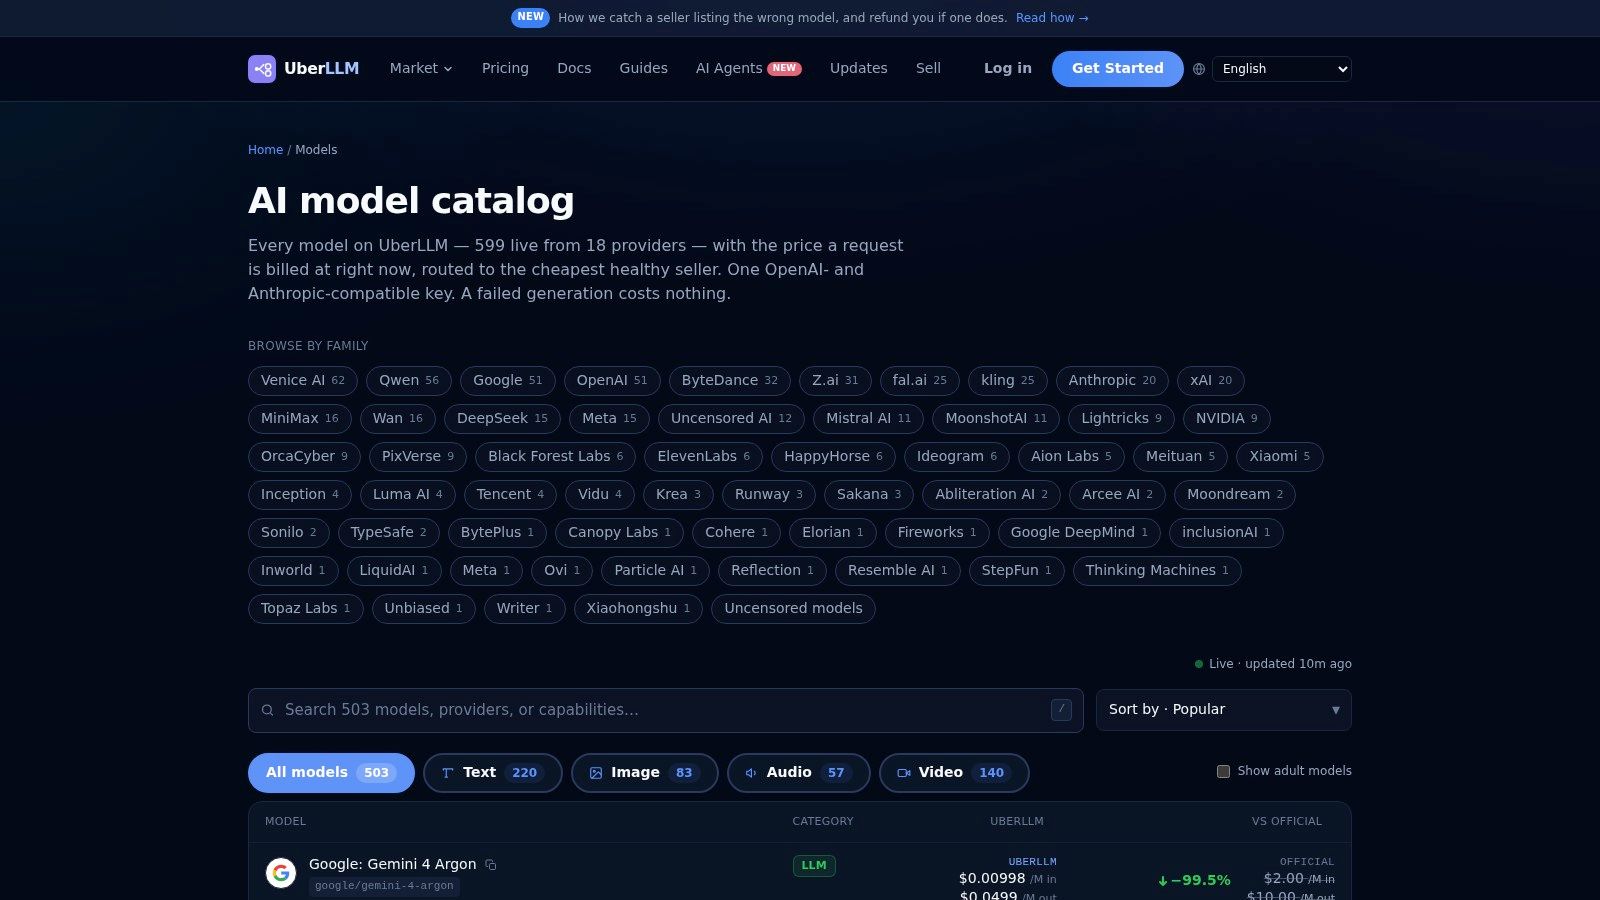
Ideal, um gehostete Optionen zu vergleichen, bevor Sie eine marketplace API integrieren. Der UberLLM KI-Modellkatalog führt 457 Modelle auf einer Vergleichsseite mit Live-Preisen, Anbieternamen, context lengths und Modelltypen zusammen. Er ist nützlich, wenn Ihre engere Auswahl Text und Medien umfasst, anstatt sich auf eine einzige Modellfamilie zu beschränken.
Bei UberLLM verbinden wir diesen Entdeckungsprozess mit einem OpenAI- und Anthropic-kompatiblen endpoint. Entwickler wählen einen Modell-identifier, während das marketplace routing einen verfügbaren Anbieter für das angefragte Modell auswählt. Diese Unterscheidung ist wichtig: Sie wählen sowohl die Fähigkeiten eines Modells als auch einen gehosteten Zugangspfad.
Was Sie vor der Auswahl prüfen sollten
Für die Dokumentenverarbeitung vergleichen Sie context length und maximum output tokens separat. Ein Modell, das Ihr Quellmaterial akzeptiert, kann dennoch ein output limit haben, das die Generierung des vollständigen Ergebnisses verhindert. Unsere Modell-metadata legen beide Felder offen, und der Katalog kennzeichnet Modelle, die tools unterstützen.
- Stärke: Live-Preise und Anbieternamen machen die anbieterübergreifende shortlist weniger fragmentiert.
- Nützlicher workflow: Nach Modalität filtern, limits prüfen, dann repräsentative outputs im playground vergleichen.
- Einschränkung: Eine Auflistung kann nicht feststellen, ob Ihr extraction schema, Ihre coding task oder Ihr visual brief erfolgreich sein wird.
Betrachten Sie den niedrigsten angezeigten Preis nicht als endgültige Antwort. Schätzen Sie für Text den input- und output-Mix, den Ihre Anwendung erzeugt; prüfen Sie für Medien die angeforderte generation configuration, bevor Sie Kosten vergleichen.
Praktische Regel: Wählen Sie ein Modell erst, wenn dessen limits, output quality und failure behavior die workload erfüllen. Eine günstige Anfrage, die ein unbrauchbares Ergebnis liefert, ist keine nützliche Ersparnis.
Preise und Verfügbarkeit können sich ändern, daher sollten Sie den identifier und die im Test verwendete configuration festhalten, anstatt Ihre shortlist als Sammlung von Modellnamen zu belassen.
2. OpenRouter
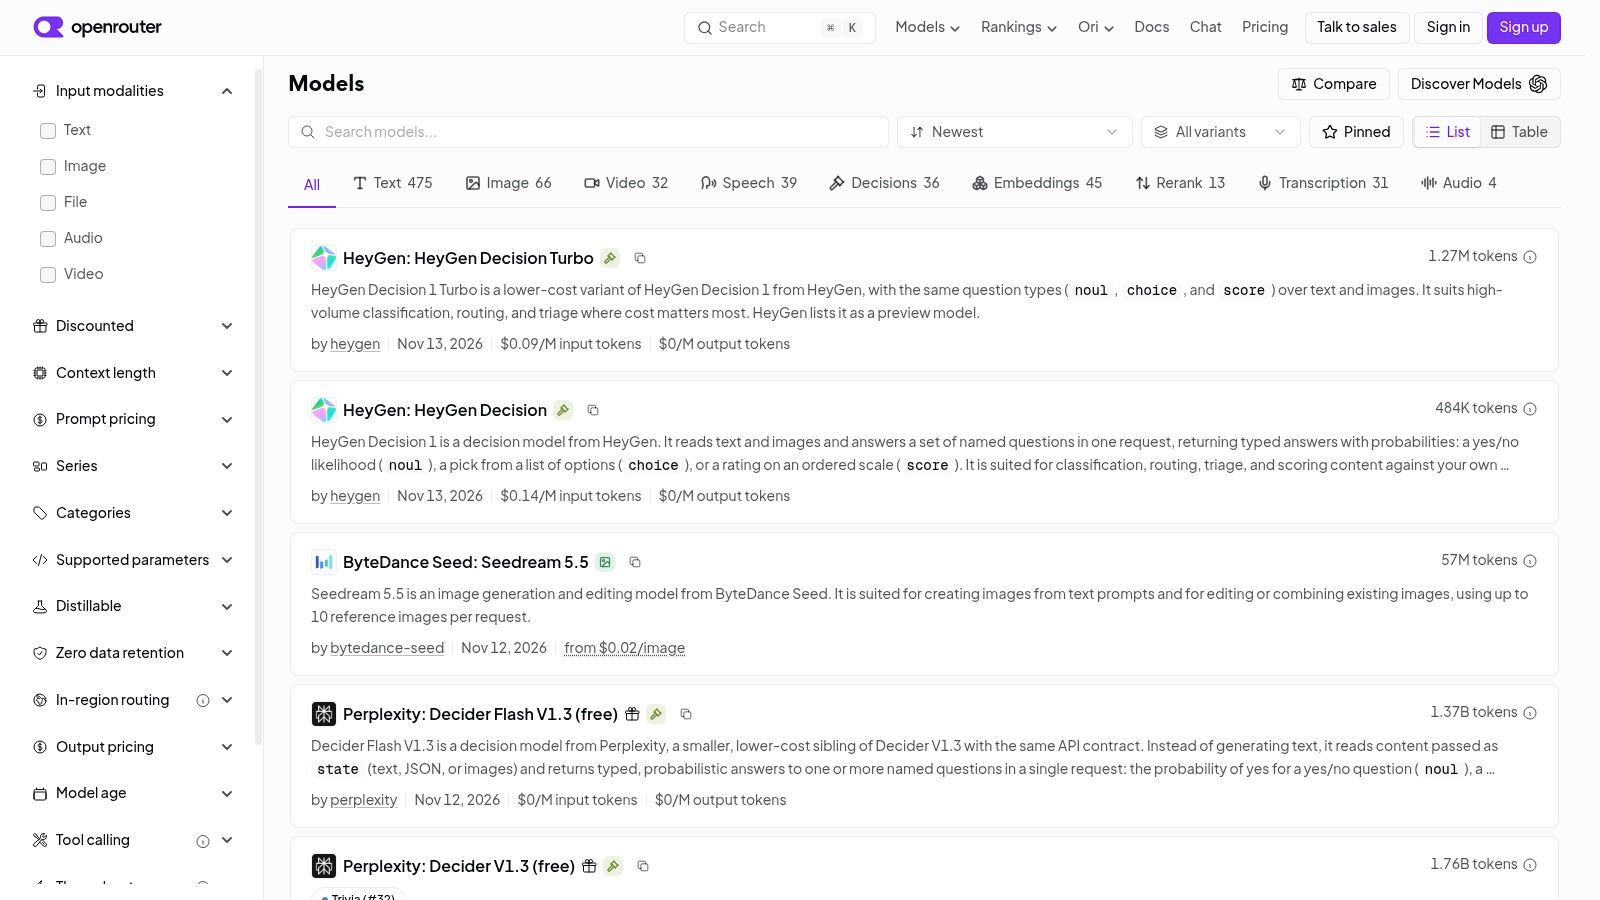
Wenn Ihre unmittelbare Aufgabe darin besteht, gehostete Modelle auszuprobieren, ohne separate Anbieterintegrationen zu erstellen, ist der Modellkatalog von OpenRouter ein praktischer Ausgangspunkt. Er kombiniert durchsuchbare Modellspezifikationen mit Zugriff über eine gemeinsame API.
Die nützlichen Vergleichsfelder umfassen Preise, Kontextlänge, Modalitäten und Fähigkeiten. Diese helfen, Modelle, die lediglich Text akzeptieren, von Kandidaten zu unterscheiden, die die zusätzlichen Eingaben oder Verhaltensweisen unterstützen, die Ihre Anwendung benötigt. Überprüfen Sie die individuelle Modellseite, anstatt davon auszugehen, dass jedes Modell, das über dieselbe Schnittstelle zugänglich ist, dieselbe Anfrage akzeptiert.
Wo es passt
OpenRouter eignet sich für Entwickler, die gehostete Kandidaten innerhalb einer bestehenden Anwendung vergleichen. Sie können das umgebende Evaluierungs-Framework stabil halten, während Sie das ausgewählte Modell ändern, obwohl unterstützte Parameter und Ausgabeverhalten weiterhin validiert werden müssen.
- Was funktioniert: Der Übergang von der Entdeckung zur API-Experimentation, ohne jede Anbieterintegration separat einzurichten.
- Was nicht funktioniert: Den Katalog als Repository zu behandeln, in dem die Gewichte jedes gelisteten Modells heruntergeladen werden können.
- Was zu überprüfen ist: Aktuelle Verfügbarkeit, modellspezifische Preise, Kontextlimits und erforderliche Fähigkeiten.
Testen Sie für einen Coding-Agenten die Tool-Call-Argumente und die Wiederherstellung nach einer fehlgeschlagenen Tool-Ausführung, nicht nur die Qualität einer eigenständigen Code-Antwort. Eine gemeinsame API macht das Agentenverhalten nicht austauschbar.
Der Vergleich von OpenRouter-Alternativen ist nützlich, wenn verschiedene Zugriffs-Services evaluiert werden. Halten Sie diese Entscheidung von der Modellauswahl getrennt: Das Modell und der Service, der es hostet, führen zu unterschiedlichen operativen Kompromissen.
3. Hugging Face Hub
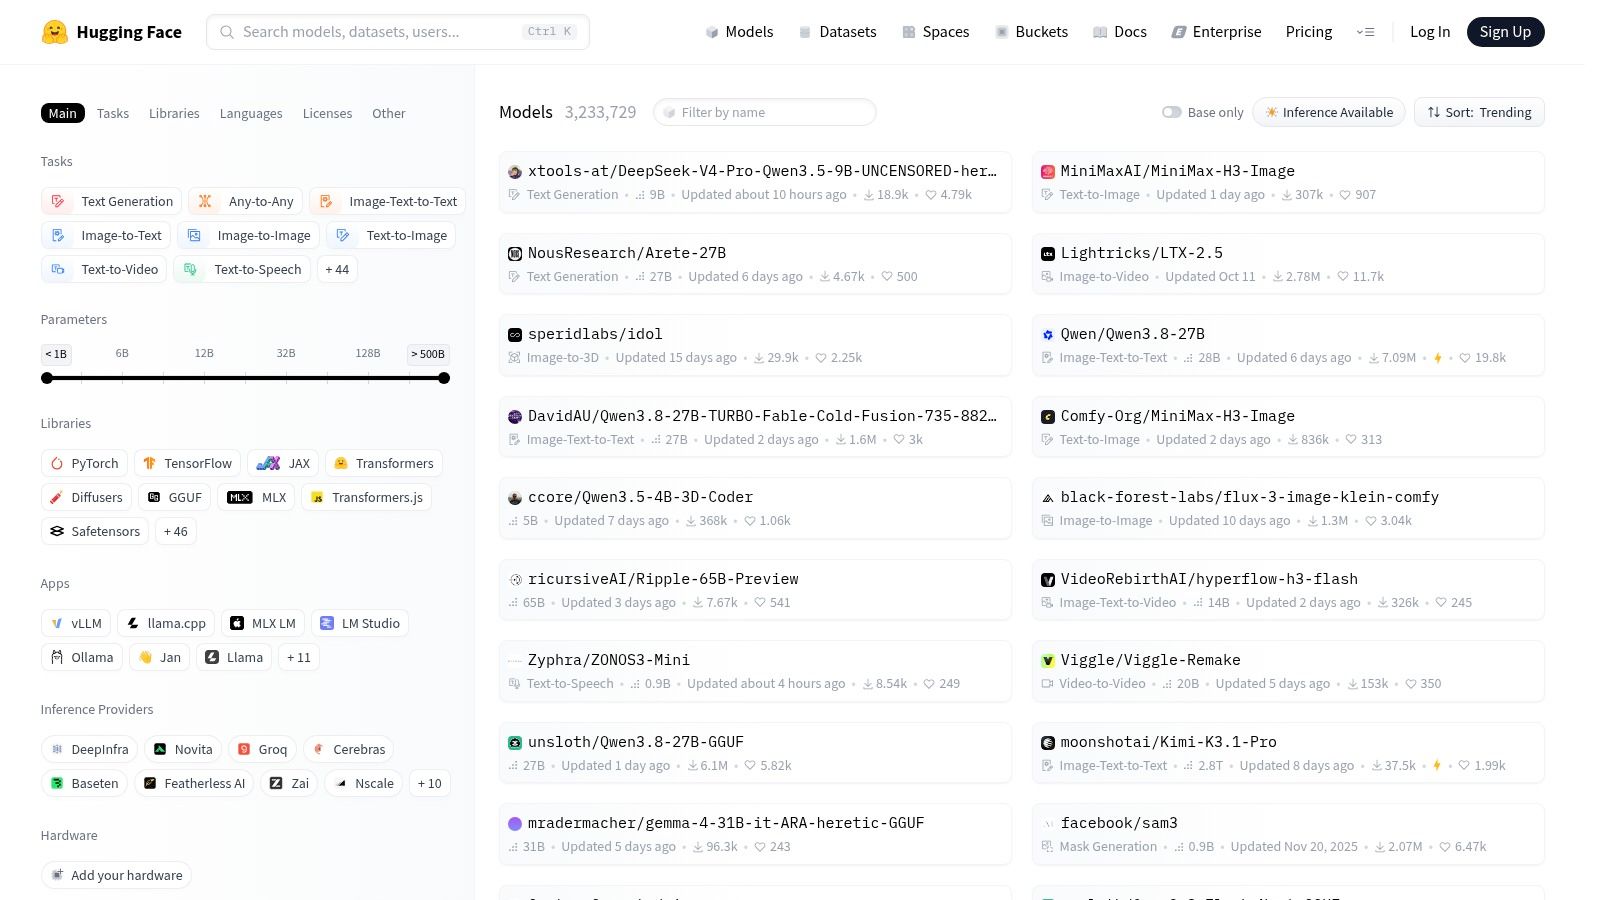
Beginnen Sie mit Hugging Face, wenn Sie Gewichte benötigen, nicht nur einen Endpoint. Der Hugging Face Hub ist besonders nützlich, um Modelle zu finden, die Sie selbst anpassen, überprüfen oder bereitstellen möchten.
Die Modellseiten können Modellkarten, herunterladbare Dateien, Implementierungsbeispiele und Lizenzdetails kombinieren. Das macht es zu einer anderen Art von Ressource als ein gehostetes API-Menü: Sie untersuchen das Artefakt und seine Anforderungen, anstatt nur zu entscheiden, welche Kennung Sie in einer Anfrage senden sollen.
Mehr als nur der Modellname
Überprüfen Sie vor dem Download die Aufgabe, die Architektur, das unterstützte Inferenz-Framework und die Lizenz. Prüfen Sie dann, ob die Beispiele Ihrer beabsichtigten Verwendung entsprechen, insbesondere bei feinabgestimmten Modellen mit spezialisierten Prompt-Templates.
- Stärke: Breite Entdeckung über Text-, visuelle, Bild- und Audioaufgaben hinweg.
- Kompromiss: Die Qualität der Dokumentation und Evaluierung hängt vom Herausgeber ab.
- Bereitstellungsbeschränkung: Ein herunterladbares Modell ist nicht automatisch als verwaltete API verfügbar.
Zum Beispiel könnte ein Dokumentenverarbeitungsteam ein vielversprechendes Vision-Language-Modell finden, müsste aber dennoch Vorverarbeitung, Inferenz und Ausgabevalidierung zusammenstellen. Das Repository hilft dabei, festzustellen, was verfügbar ist; es nimmt die Bereitstellungsarbeit nicht ab.
Offene Gewichte bedeuten auch keine uneingeschränkte Nutzung. Lesen Sie die tatsächliche Lizenz und die zugehörigen Bedingungen, anstatt Berechtigungen vom Download-Button abzuleiten.
Nutzen Sie Hugging Face für Forschung und Anpassung, wenn der Zugriff auf die zugrunde liegenden Dateien wichtig ist. Wenn Sie heute Nachmittag nur gehostete Antworten vergleichen müssen, bringt Sie ein API-Katalog möglicherweise schneller zu einem aussagekräftigen Test.
4. Künstliche Analyse
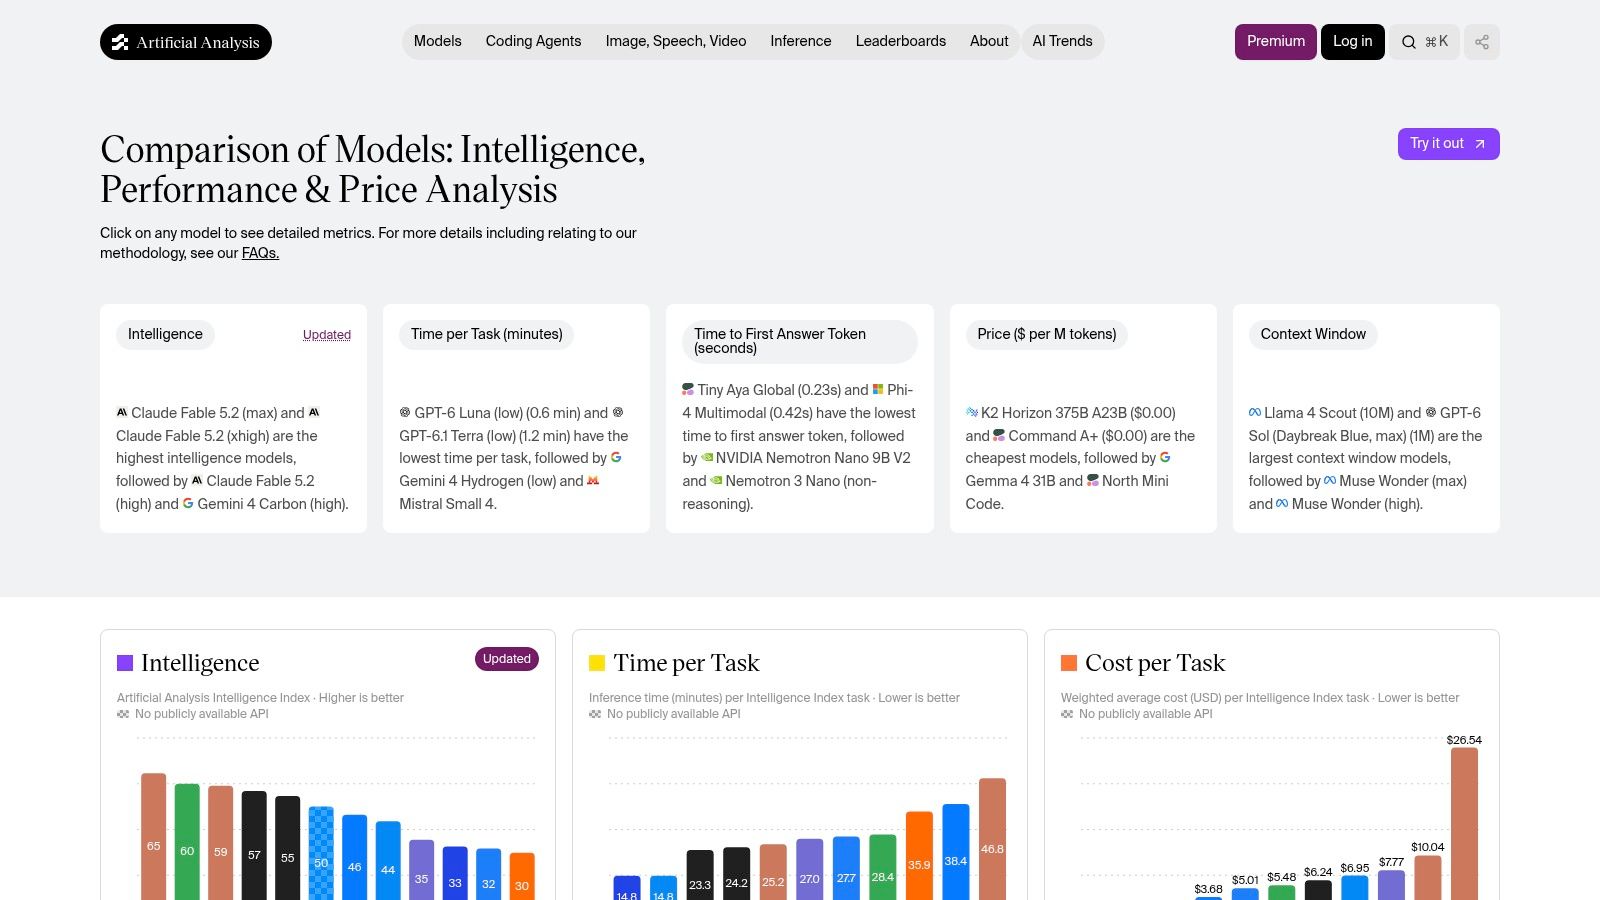
Die schwierige Frage ist nicht, welches Modell den niedrigsten beworbenen token-Preis hat. Es ist, welcher Kandidat Ihre Qualitätsanforderung zu akzeptablen Gesamtkosten und Fertigstellungszeit erfüllt.
Künstliche Analyse vergleicht Modelle anhand von Messgrößen wie Intelligenz, Preis, Zeit pro Aufgabe, Latenz bis zum ersten Antwort-token und context-window-Größe. Sein Kosten-pro-Aufgabe-Ansatz ist für die Vorauswahl nützlicher als das isolierte Lesen von token-Preisen, da er die Kosten mit einer Arbeitslast verbindet.
Vergleichen Sie die Metrik, die Ihre Benutzer erleben
Für einen interaktiven Assistenten ist die Zeit bis zum ersten token wichtig, ersetzt aber nicht die end-to-end-Fertigstellungszeit. Für einen Hintergrund-Extraktionsjob können eine validierte Fertigstellung und die Gesamtkosten wichtiger sein als die Geschwindigkeit, mit der Text zuerst erscheint.
- Verwenden Sie es für: Die Identifizierung von Kompromissen bei Fähigkeiten, Kosten und Geschwindigkeit vor dem Anwendungstesting.
- Verwenden Sie es nicht für: Die Annahme, dass ein Benchmark-Führer bei Ihren prompts oder Ihrer Sprache gewinnen wird.
- Zugangshinweis: Einige Datensätze oder Funktionen erfordern möglicherweise ein Konto oder kostenpflichtigen Zugang.
Vergleichen Sie die Kosten pro erfolgreicher Aufgabe, nicht nur die Kosten pro Anfrage. Beziehen Sie Wiederholungsversuche und abgelehnte Ausgaben in Ihre eigene Bewertung ein.
Der LLM-Preisindex bietet eine weitere Preisreferenz bei der Zusammenstellung einer Vorauswahl. Halten Sie die Annahmen zur Arbeitslast sichtbar, wenn Sie einen Index vergleichen.
Künstliche Analyse ist nicht der Ort, um jedes Modell herunterzuladen oder Ihre Anwendung bereitzustellen. Ihre Aufgabe ist es, die Vorauswahl zu verbessern und es Ihrem eigenen Testsystem zu überlassen, zu bestimmen, ob diese Kandidaten die Produktionsanforderungen erfüllen.
5. Replicate Explore
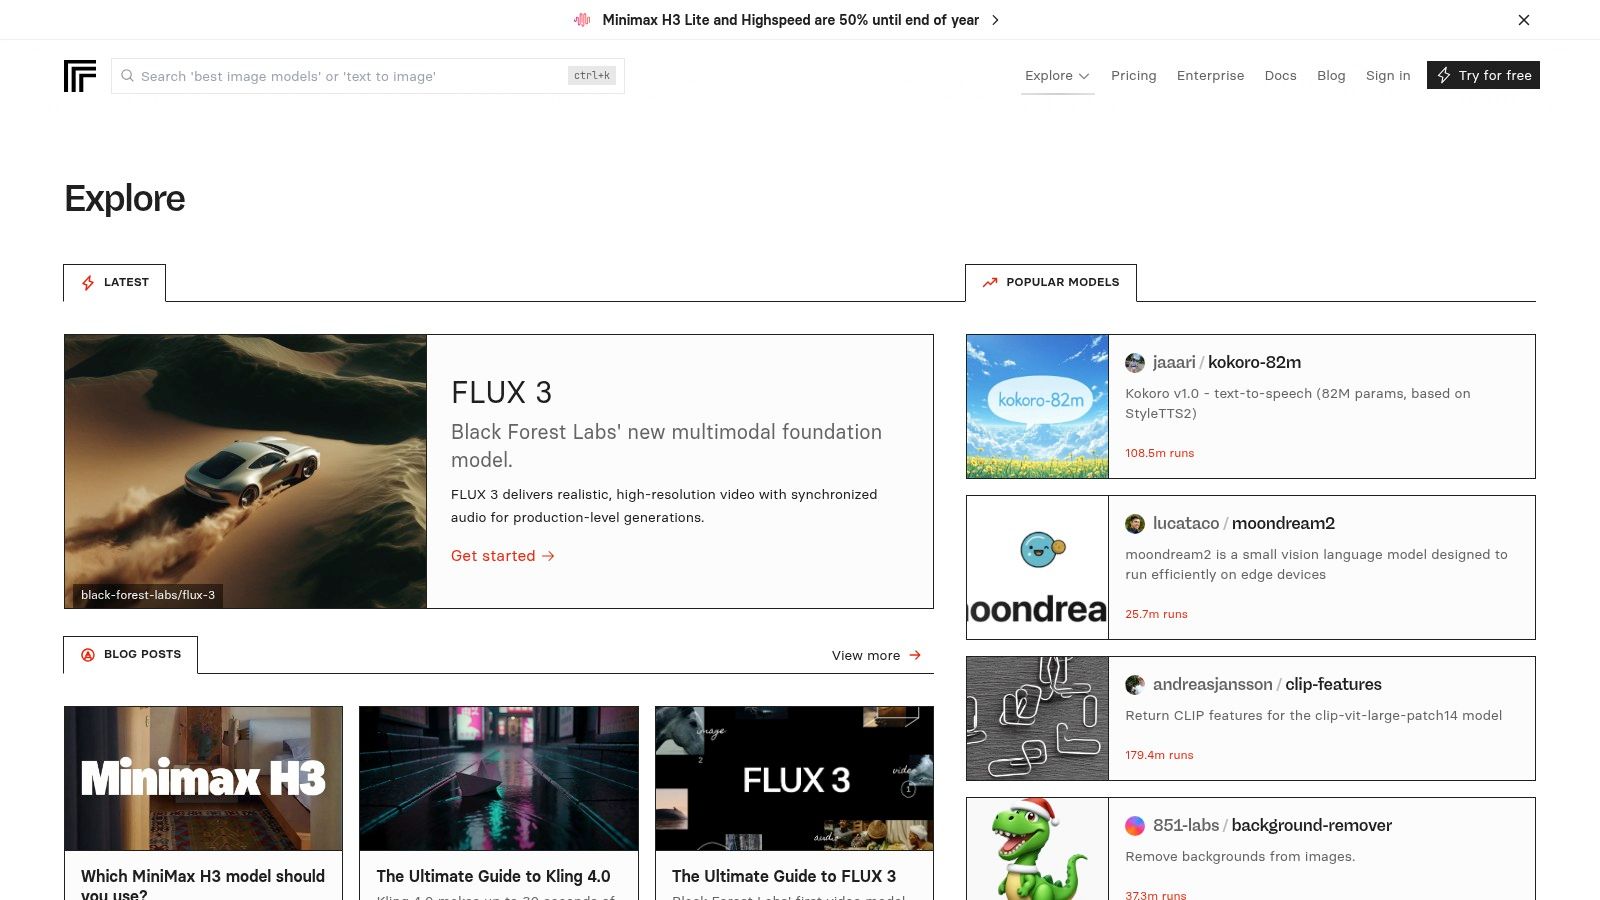
Das Testen eines Videomodells erfordert mehr als nur das Lesen einer Bestenliste für Sprachmodelle. Sie müssen akzeptierte Eingaben, Ausgabebeispiele, Generierungssteuerungen und die Art und Weise, wie die Anwendung ein fertiges Ergebnis abruft, überprüfen.
Replicate Explore ist nützlich für diese praktische Erkundung, insbesondere bei der Bild-, Video- und Audiogenerierung. Modellseiten können Beispiele, Eingabedefinitionen, Nutzungsanweisungen und Preise zusammen mit einem gehosteten Ausführungspfad bereitstellen.
Mit eigenem Quellmaterial testen
Verwenden Sie für Bild-zu-Video ein Bild, das für Ihre Anwendung repräsentativ ist, nicht nur die ausgefeilten Beispiele des Modells. Überprüfen Sie die Konsistenz des Motivs, die Bewegung, die Komposition und ob die Ausgabe die Vorgaben respektiert. Testen Sie für Sprache Namen, Satzzeichen und die Sprachen, die Ihre Benutzer eingeben.
- Stärke: Sie können experimentieren, ohne zuerst eine lokale inference einzurichten.
- Flexibilität: Benutzerdefinierte deployments können Cog, das Verpackungstool von Replicate, verwenden.
- Einschränkung: Von der Community veröffentlichte Modelle können sich in Wartung, Dokumentation und Support unterscheiden.
Prüfen Sie, ob ein Eintrag offiziell und aktiv gepflegt wird, bevor Sie darauf aufbauen. Lesen Sie auch die Abrechnungseinheit sorgfältig durch, da die Modellpreise von der Laufzeit oder der generierten Ausgabe abhängen können und nicht von einer token-Berechnung im Textstil.
Replicate ist eine gute Wahl, wenn Sie sehen müssen, ob ein generatives Modell akzeptable Medien produzieren kann. Es ist weniger nützlich als eine einzige normalisierte Rangliste über nicht verwandte Modalitäten hinweg: Ein Sprachmodell und ein Videomodell benötigen unterschiedliche Akzeptanzkriterien.
6. Microsoft Foundry Modelle
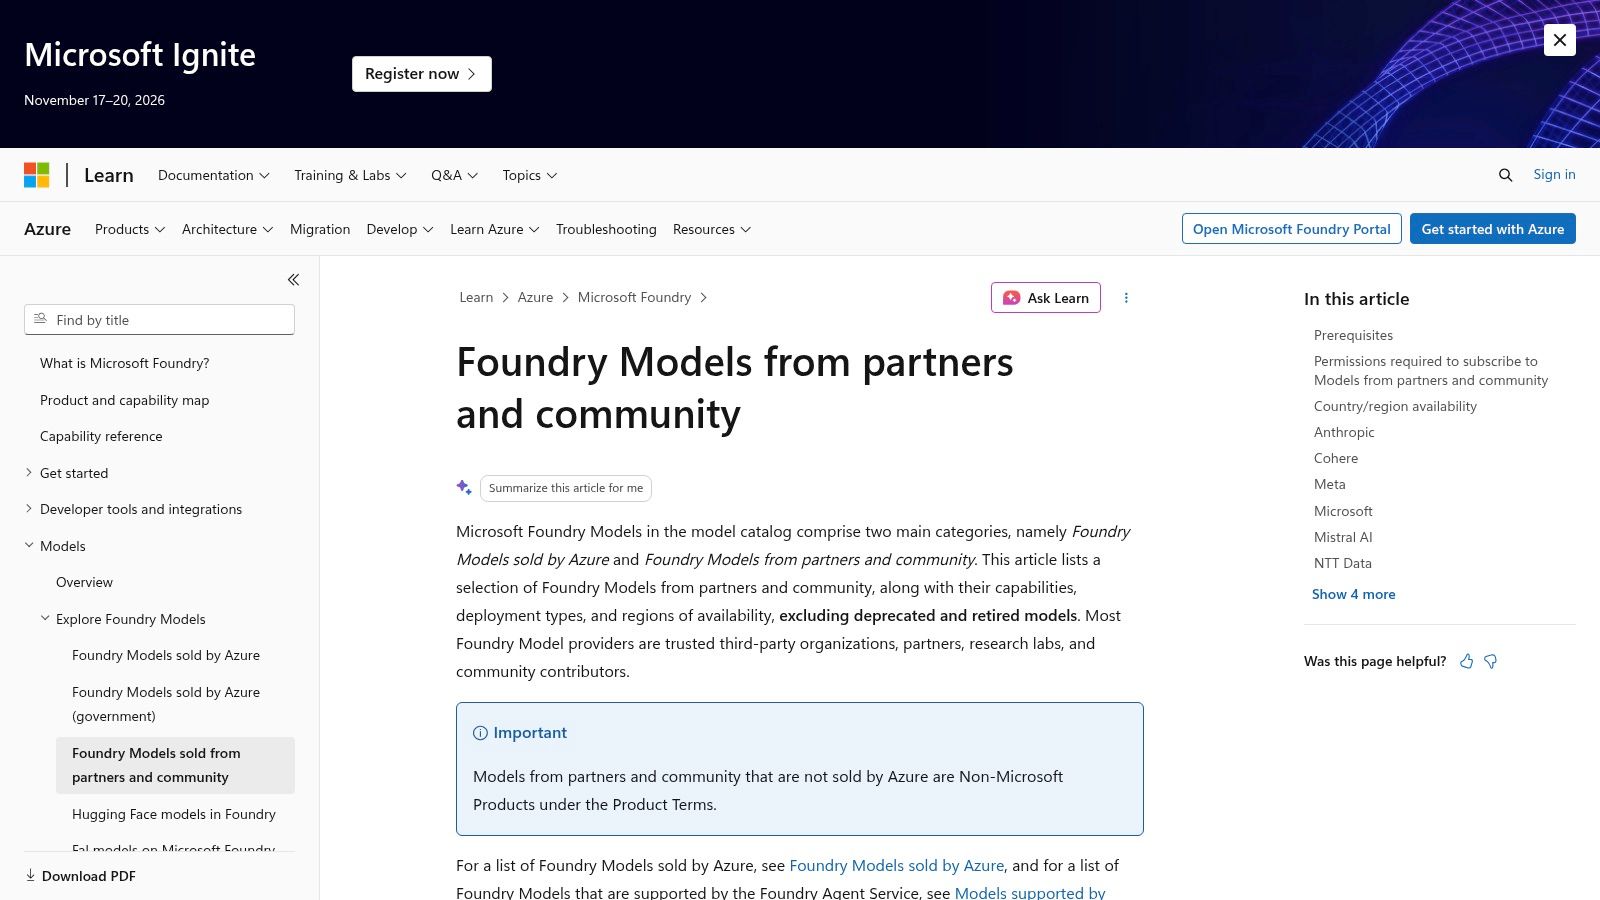
Für eine Azure-basierte Anwendung kann die Bereitstellungsberechtigung genauso wichtig sein wie die Modellfähigkeit. Ein vielversprechender Kandidat ist nutzlos, wenn seine verfügbare Bereitstellungsmethode nicht zu Ihrer Architektur oder Betriebsregion passt.
Microsoft Foundry Modelle verbindet die Modellentdeckung mit der Cloud-Umgebung von Microsoft. Der Katalog umfasst Angebote von Microsoft, Partnern und der Community mit Informationen zu Aufgaben, Fähigkeiten, Lizenzierung und Bereitstellungsoptionen.
Wählen Sie den Bereitstellungspfad zusammen mit dem Modell
Berechtigte Modelle können verschiedene API-basierte, Batch-, bereitgestellte oder Managed-Compute-Optionen haben. Gehen Sie nicht davon aus, dass das Auffinden eines Modells im Katalog bedeutet, dass jeder Hosting- und Abrechnungsansatz dafür verfügbar ist.
- Gute Passung: Teams, die die Modellauswahl an Azure-Bereitstellungsentscheidungen anpassen müssen.
- Nützliche Details: Modellspezifische Bereitstellungsinformationen und ausgewählte Benchmark-Ergebnisse.
- Einschränkung: Verfügbarkeit, Bereitstellungsmethoden und Preise können je nach Modell und Region variieren.
Ein Dokumentenanalyse-Team sollte sowohl die Eingabeunterstützung des Modells als auch die endpoint-Konfiguration untersuchen, die es bereitstellen wird. Das Testen eines Demonstrations-endpoint ist nicht ausreichend, wenn die Produktion eine wesentlich andere Bereitstellungsanordnung verwenden wird.
Der Katalog ist daher sowohl eine Architekturressource als auch ein Entdeckungstool. Nutzen Sie ihn, wenn die Azure-Integration eine tatsächliche Anforderung ist, nicht weil ein gewünschtes Modell zufällig dort erscheint.
Für eine anbieterneutrale Erkundung ist ein anbieterübergreifendes Vergleichstool in der Regel ein saubererer Ausgangspunkt. Kehren Sie zu Foundry zurück, wenn Sie bereit sind, den praktischen Cloud-Bereitstellungspfad festzulegen.
7. Amazon Bedrock Modellkatalog
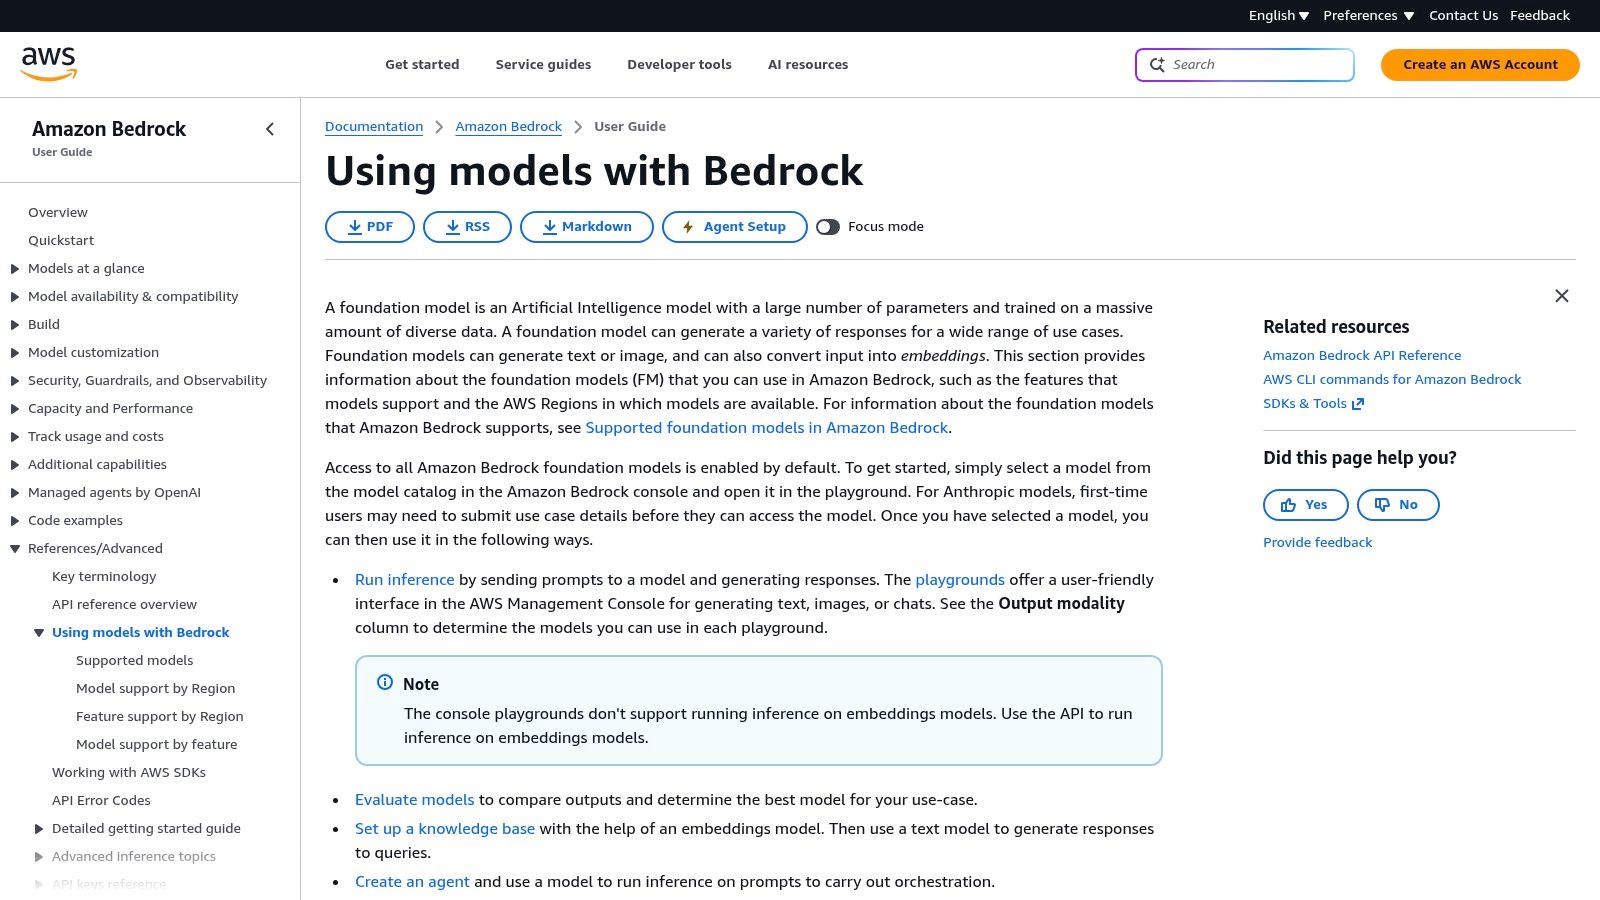
Überprüfen Sie die regionale Verfügbarkeit, bevor Sie den Prototyp erstellen. Das ist die nützlichste Gewohnheit, wenn Sie den Amazon Bedrock Modellkatalog für eine AWS-Anwendung verwenden.
Der Katalog identifiziert unterstützte Basismodelle und deren Funktionen. Teams können die regionale Verfügbarkeit überprüfen und geeignete Modelle im Bedrock-Konsolen-Playground testen, bevor sie diese in eine AWS-basierte Anwendung integrieren.
Beschaffung und Zugriff sind Teil der Wahl
Bedrock ist besonders relevant, wenn die Anwendung bereits innerhalb der AWS-Infrastruktur betrieben wird. Allerdings können die Kontoeinrichtung und der regionale Zugriff beeinflussen, ob das gewünschte Modell in der vorgesehenen Umgebung nutzbar ist.
- Was funktioniert: Der Übergang von der Entdeckung unterstützter Modelle zu einer AWS-Bereitstellung.
- Was zu bestätigen ist: Kontozugriff, beabsichtigte Region, unterstützte Eingaben und Aufrufanforderungen.
- Was es nicht ist: Ein neutrales Verzeichnis jedes herunterladbaren oder kommerziell verfügbaren KI-Modells.
Testen Sie für einen Support-Assistenten dieselben Abrufpassagen und Anweisungen, die Sie aus der Produktion senden möchten. Der Erfolg im Playground beweist, dass eine Anfrage funktionieren kann; er beweist nicht, dass Ihre Abrufpipeline, Fehlerbehandlung und Ihr Ausgabeparser korrekt sind.
Die Stärke von Bedrock ist seine Verbindung zum AWS-Anwendungsstack. Diese gleiche Ausrichtung ist eine Einschränkung für Teams, die nur eine breite Übersicht über Modelloptionen wünschen, ohne sich auf eine Cloud-spezifische Integration festzulegen.
Führen Sie Aufzeichnungen über das genaue Modell und die Zugriffskonfiguration, die bei der Evaluierung verwendet wurden. Ein erkennbarer Modellfamilienname reicht nicht aus, um eine Bereitstellungsentscheidung zu reproduzieren.
8. Google Cloud Model Garden
Ein Team, das auf Google Cloud aufbaut, sollte das Modell und seine Bereitstellungskonfiguration zusammen bewerten. Die Suche nach der richtigen Modellfamilie ist nur der Anfang; die Bereitstellungskonfiguration bestimmt, wie es zur Anwendung passt.
Google Cloud Model Garden bietet eine Übersicht über Modelle von Google, Drittanbietern und Open-Source-Modelle innerhalb der KI-Umgebung von Google Cloud. Es ist am nützlichsten, wenn der nächste Schritt eine cloudbasierte Entwicklung ist und nicht das Herunterladen eines Modells für eine unabhängige lokale Laufzeit.
Trennung der Modellsuche von den Bereitstellungsannahmen
Prüfen Sie das einzelne Angebot, bevor Sie Kosten oder Implementierungsaufwand schätzen. Verfügbarkeit und Preise hängen vom Modell, der Region und der Servicekonfiguration ab, daher begründet ein Katalogeintrag allein nicht die Produktionstauglichkeit.
- Optimaler Einsatz: Modelle für eine Google Cloud-Anwendung erkunden.
- Vorteil: Angebote von Google und ausgewählten externen Anbietern erscheinen im selben cloud-orientierten Entdeckungs-Workflow.
- Einschränkung: Es ist weniger praktisch für eine anbieterneutrale Übersicht oder Offline-Experimente.
Für einen Bildanalyse-Service bestätigen Sie das akzeptierte Eingabeformat und testen Sie dann die genaue Vorverarbeitung, die Ihre Anwendung durchführt. Größenänderung, Zuschneiden und Dokumentenkonvertierung gehören zur Evaluierung, nicht nur zur späteren Bereitstellung.
Verwechseln Sie Model Garden nicht mit der enger gefassten Gemini API-Modellliste. Ersteres hilft bei der breiteren Entdeckung von Cloud-Modellen; Letzteres liefert Erstanbieter-Details für ein spezifisches API-Ökosystem.
Nutzen Sie Model Garden, sobald Ihr Team weiß, dass Google Cloud Teil des Bereitstellungsplans ist. Andernfalls beginnen Sie mit den Modellanforderungen und vermeiden Sie es, dass eine bestehende Cloud-Konsole die engere Auswahl vorzeitig festlegt.
9. Ollama Library
Wenn die Anforderung darin besteht, ein Modell auf Ihrer eigenen Maschine auszuführen, beginnen Sie mit einem laufzeitbasierten Katalog anstatt mit einem gehosteten API-Marktplatz. Die Ollama Library hilft Benutzern, unterstützte Modelle, Größen, Varianten und Funktionen für Ollamas lokalen Arbeitsablauf zu finden.
Die Modellgröße ist ein nützlicher erster Filter, aber keine vollständige Hardware-Schätzung. Kontextnutzung, Laufzeit-Overhead und andere Anwendungen, die um Speicher konkurrieren, beeinflussen ebenfalls, ob die Konfiguration komfortabel läuft.
Testen Sie die tatsächliche Maschine
Wählen Sie einen Kandidaten, der zu Ihrer Hardware passt, und testen Sie ihn dann mit repräsentativen Eingabelängen. Ein Modell, das eine kurze Chat-Eingabeaufforderung verarbeitet, kann unpraktisch werden, wenn Sie abgerufene Dokumente oder eine lange Konversation hinzufügen.
Effizienzdiskussion des Stanford AI Index berichtet, dass Phi-3-mini mit 3.8 Milliarden Parametern denselben angegebenen MMLU-Schwellenwert erreichte, für den zuvor PaLMs 540 Milliarden Parameter erforderlich waren. Dieser Vergleich untermauert eine praktische Lektion: Die reine Parameteranzahl ist kein Qualitätsranking.
- Stärke: Zugängliche Experimente mit lokal ausführbaren Modellen.
- Kostenunterschied: Die lokale Ausführung vermeidet Gebühren für die Nutzung gehosteter API, aber Hardware und Betrieb kosten immer noch Geld.
- Einschränkung: Ihre Maschine und unterstützte Formate schränken die Auswahl ein.
Die lokale Ausführung ist nicht automatisch ein vollständiges Offline-System. Prüfen Sie, ob Abruf, Protokollierung, Tools und andere Anwendungskomponenten ebenfalls lokal bleiben.
Ollama ist ein nützlicher Ausgangspunkt für Offline-Prototypen und hardwarebeschränkte Experimente. Es eliminiert nicht die Notwendigkeit, Qualität, Speichernutzung oder End-to-End-Latenz zu validieren.
10. Google Gemini API Modellliste
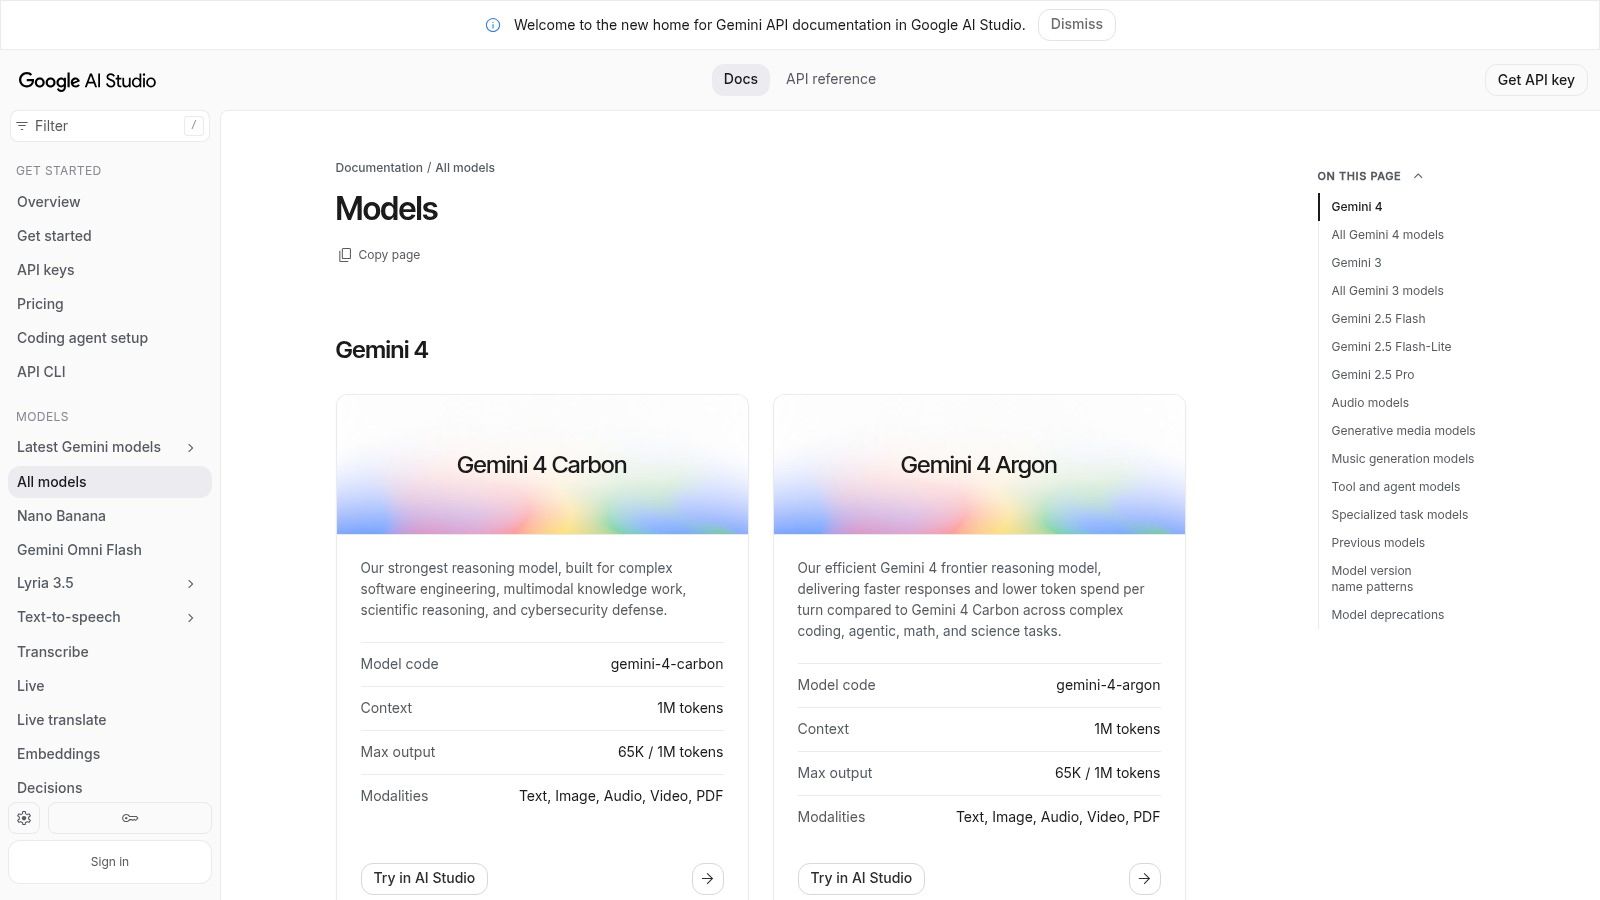
Manchmal ist der richtige Weg der direkteste. Wenn Sie sich bereits für die Gemini API entschieden haben, nutzen Sie die offizielle Gemini API Modellliste, um Modell-Identifikatoren, Beschreibungen und unterstützte Funktionen zu bestätigen.
Dies ist eine Erstanbieter-Implementierungsdokumentation, kein anbieterübergreifender Vergleichsdienst. Sie verbindet die Modellfindung mit der API Dokumentation und Google AI Studio, was nützlich ist, wenn Sie eine ausgewählte Modellfamilie in eine funktionierende Anfrage umwandeln müssen.
Den genauen Identifikator überprüfen
Bauen Sie nicht auf einem Modellfamiliennamen auf, der aus einem Vergleichsartikel kopiert wurde. Bestätigen Sie den spezifischen Identifikator und prüfen Sie dessen unterstützte Inputs, Outputs und Zugriffsbedingungen, bevor Sie ihn integrieren.
- Stärke: Direkte Modellinformationen für Entwickler, die die Gemini API nutzen.
- Einschränkung des Umfangs: Es wird Ihnen nicht helfen, jeden konkurrierenden Anbieter zu vergleichen.
- Kommerzieller Hinweis: Überprüfen Sie die aktuellen Preise, die Zugriffsebene und die Berechtigungsbedingungen des ausgewählten Modells.
Für eine audiobezogene Anwendung überprüfen Sie, ob das jeweilige Modell den erforderlichen Audio-Workflow unterstützt, anstatt davon auszugehen, dass jedes Gemini Modell identische Funktionalität bietet. Wenden Sie die gleiche Sorgfalt bei multimodalen Inputs und der Tool-Nutzung an.
Behalten Sie auch Lifecycle-Checks in Ihrem Wartungsprozess bei. Der Veo und Gemini API Shutdown Guide ist relevant, wenn Sie Endpoint-Abhängigkeiten und Migrationsarbeiten überprüfen.
Die offizielle Liste wird am besten als Implementierungsreferenz nach der Vorauswahl verwendet. Sie liefert die Details, die für eine gültige Anfrage erforderlich sind, während Ihre eigene Bewertung bestimmt, ob die zurückgegebenen Ergebnisse die Anforderungen des Produkts erfüllen.
Wie sich die 10 Modellkataloge nach Zugang, Preistransparenz und Einschränkungen unterscheiden
| Eintrag | Am besten geeignet für | Zugangsmodell | Preistransparenz | Hauptbeschränkung |
|---|---|---|---|---|
| UberLLM AI Modellkatalog (Empfohlen) | Vergleich von Modellen verschiedener Anbieter | Vereinheitlichte API und Marktplatz | Live-Preise aufgeführt | Kataloge sagen keine workload-spezifische Leistung voraus |
| OpenRouter | Vergleich und Zugang zu Modellen verschiedener Anbieter | Gehostete API mit einem Schlüssel | Modellpreise angezeigt; aktuelle Raten überprüfen | Gehostete API, keine herunterladbaren Modellgewichte |
| Hugging Face Hub | Forschung, Anpassung und Self-Hosting | Modell-Downloads; Hosting variiert | Preise nicht durchgängig aufgeführt | Modellqualität und Dokumentation variieren |
| Artificial Analysis | Vergleich von Benchmarks, Kosten und Geschwindigkeit | Forschungs- und Vergleichsressource; Daten-API | API-Preise angezeigt; einige Zugänge können kostenpflichtig sein | Benchmarks spiegeln möglicherweise nicht Ihre Workload wider |
| Replicate Explore | Testen und Ausführen von gehosteten generativen Modellen | Gehostete Modell-APIs und benutzerdefinierte Bereitstellungen | Modellspezifische Preise; kann je nach Nutzung variieren | Qualität und Support von Community-Modellen variieren |
| Microsoft Foundry Models | Auswahl von Modellen für Azure-Anwendungen | Azure-Bereitstellungsoptionen | Variiert je nach Modell und Region | Am besten geeignet für Azure-Benutzer |
| Amazon Bedrock Modellkatalog | Finden von Modellen für AWS-Anwendungen | Bedrock-Dienste innerhalb von AWS | Variiert je nach Modell und Region | AWS- und regionsabhängiger Zugang |
| Google Cloud Model Garden | Finden von Modellen für die Google Cloud-Bereitstellung | Google Cloud AI-Dienste | Variiert je nach Modell und Konfiguration | Auf Google Cloud ausgerichtet |
| Ollama Library | Lokales Ausführen von Modellen | Lokale Inferenz mit Ollama | Kein gehosteter Preis; nutzt Ihre Hardware | Erfordert Einrichtung und geeignete Hardware |
| Google Gemini API Modellliste | Entwicklung mit Google-Modellen | Gemini API und Google AI Studio | Separate Preisseite; Stufen variieren | Umfasst nur Google-Modelle |
Eine Auswahlliste in eine funktionierende Integration verwandeln
Hören Sie auf zu suchen, sobald Sie zwei oder drei plausible Modelle pro Modalität haben. Mehr Kandidaten helfen nicht, wenn Ihr Team nicht definiert hat, wie ein akzeptables Ergebnis aussieht. Notieren Sie die erforderliche Kontextlänge, Ausgabebeschränkungen, Tool-Unterstützung, Eingabeformate und Bereitstellungsbeschränkungen, bevor Sie Vergleiche durchführen.
Senden Sie dann die gleichen Prompts oder Generierungsaufgaben an jeden Kandidaten. Für die Textextraktion validieren Sie das zurückgegebene Schema und vergleichen die extrahierten Werte mit den erwarteten Antworten. Für die Codierung führen Sie Tests für die generierten Änderungen durch; für Medien überprüfen Sie die Ausgaben anhand eines konsistenten Briefings, anstatt das beeindruckendste Beispiel auszuwählen.
Den vollständigen Anwendungspfad bewerten
Beziehen Sie die Arbeit rund um die Inferenz ein. Dokumentenkonvertierung, Abruf, Tool-Ausführung, Polling, Wiederholungsversuche und Ausgabevalidierung können alle darüber entscheiden, ob ein ansonsten fähiges Modell nutzbar ist.
- Qualität: Erfassen Sie akzeptierte Ergebnisse, nicht nur abgeschlossene Anfragen.
- Latenz: Messen Sie sowohl die anfängliche Antwort als auch die End-to-End-Fertigstellung, wo relevant.
- Kosten: Berücksichtigen Sie Wiederholungsversuche, abgelehnte Generierungen und notwendige Folgeanrufe.
- Zuverlässigkeit: Testen Sie Timeouts, fehlerhafte Ausgaben und nicht verfügbare Endpoints.
Die Diskussion von Brookings zur Bewertung von KI-Modellen erklärt, warum Benchmark-Ergebnisse praktische Bedenken wie Latenz, Rechenanforderungen, Kosten und Sicherheit außer Acht lassen können. Ihre Bewertung sollte diese Bedenken explizit machen, anstatt eine öffentliche Bestenliste als Produktionsabnahmetest zu behandeln.
Für Teams, die einen einzigen Endpoint für Text-, Bild-, Video- und Audio-Workflows wünschen, starten Sie die UberLLM-Integration, indem Sie die base URL in Ihrer bestehenden OpenAI- oder Anthropic SDK-Konfiguration auf den kompatiblen API endpoint setzen. Verwenden Sie einen UberLLM key und behalten Sie die bestehende SDK-Schnittstelle und den umgebenden Code bei, wechseln Sie dann die Kandidaten, indem Sie den Modell-Identifikator ändern. Validieren Sie die unterstützten Parameter jedes Kandidaten und verwenden Sie den entsprechenden asynchronen Aufgaben-Workflow für Medien, anstatt davon auszugehen, dass jede Modalität wie eine streaming Chat-Antwort funktioniert.
Die Entscheidung reproduzierbar halten
Speichern Sie den Modell-Identifikator, die Prompt-Version, die Generierungseinstellungen, die Evaluierungseingaben und die Akzeptanzergebnisse zusammen. Diese Aufzeichnung ermöglicht es einem anderen Ingenieur, den Test zu wiederholen, und erleichtert die spätere Bewertung von Modelländerungen. Vermeiden Sie es, sich auf einen unversionierten Screenshot oder einen erinnerten Eindruck der Ausgabequalität zu verlassen.
Wählen Sie ein Standardmodell und definieren Sie, wann die Anwendung eskalieren oder sicher fehlschlagen soll. Ein Fallback ist nur nützlich, wenn es die gleichen wesentlichen Anforderungen erfüllt, einschließlich Datenschutzbeschränkungen und Tool-Unterstützung. Die beste Liste von KI-Modellen ist diejenige, die Ihnen hilft, eine vertretbare Integrationsentscheidung zu treffen, und dann wiederholbaren Tests weicht.
UberLLM verbindet Entwickler über eine einheitliche API und ein Prepaid-Guthaben mit Text-, Bild-, Video-, Musik- und Sprachmodellen von Drittanbietern. Besuchen Sie UberLLM, um Modellgrenzen und Live-Preise zu vergleichen, Ihre Auswahlliste im Playground zu testen und die Kandidaten zu integrieren, die die Anforderungen Ihrer Anwendung erfüllen.