Webhook vs. API: Push, Polling und wann man welche einsetzt
Webhook vs. API im Vergleich hinsichtlich Richtung, Traffic, Zuverlässigkeit und Kosten, sowie wann man welche einsetzt und wie man sie für asynchrone KI-Medienaufträge kombiniert.
Der beliebte Ratschlag zu Webhook vs. API ist unvollständig: Verwenden Sie Webhooks für Echtzeit-Updates und APIs für alles andere. Das überspringt den schwierigsten Teil. Ein Webhook-Receiver ist ein asynchroner Nachrichten-Consumer, und die Wahl der Push-Zustellung bedeutet, die Verantwortung für Duplikate, verpasste Benachrichtigungen, Authentifizierung und Wiederherstellung zu übernehmen. Der nützliche Vergleich ist nicht Push versus Pull. Es ist Traffic Economics versus Operational Control, mit einem Wiederherstellungspfad für den Kanal, der ausfällt.
Inhaltsverzeichnis
- Webhook vs. API auf einen Blick
- Wie jedes Muster Daten bewegt
- Zu berücksichtigende Kompromisse bei der Zuverlässigkeit
- Wann Polling die sicherere Wahl ist
- Wie man den hybriden Workflow für Medienaufträge aufbaut
- Wählen Sie nach Arbeitslast und Einschränkung
Webhook vs. API auf einen Blick
| Kriterium | API (Anfrage-Antwort oder Polling) | Webhook (Push-Benachrichtigung) |
|---|---|---|
| Richtung | Client sendet Anfrage, Server antwortet | Provider sendet HTTP request an Client-URL |
| Wer initiiert | Client | Provider, wenn ein Ereignis eintritt |
| Zeitpunkt | Wenn der Client fragt | Wenn das Ereignis eintritt |
| Am besten geeignet für | Aktueller Zustand, Historie, Nachlieferungen, Abgleich | Benachrichtigung von Apps, wenn sich der Zustand ändert oder ein job abgeschlossen ist |
| Client benötigt | Nur ausgehenden HTTP access | Öffentlichen HTTPS endpoint, signature verification, Speicher |
| Zustellung | Direkte Antwort auf jede request, wenn der Transport erfolgreich ist | Normalerweise at-least-once delivery mit begrenzten Wiederholungsversuchen, möglichen Duplikaten und Neuanordnung |
| Fehlerbehebung | Client versucht es erneut und prüft nochmals | Provider versucht es erneut; consumer dedupliziert und gleicht über die API ab |
| Kostenmuster | Traffic wächst mit der Polling-Frequenz | Traffic wächst mit dem Ereignisvolumen |
Ein Webhook ist ein Ereignisübermittlungsmechanismus, der auf HTTP APIs aufbaut, und kein Ersatz dafür. Die meisten Produktionsintegrationen benötigen beides: einen Anforderungspfad für Befehle und autoritative Lesevorgänge sowie einen Benachrichtigungspfad für Änderungen.
Angenommen, Ihre Anwendung übermittelt einen Video-Generierungsauftrag. Mit einer API sendet Ihr Backend eine GET request unter Verwendung des gespeicherten task identifier und empfängt den aktuellen Status des Auftrags. Ihre Anwendung entscheidet, wann sie fragt, wie lange sie wartet und was zu tun ist, wenn die request fehlschlägt.
Mit einem Webhook sendet der Provider ein job-complete event an einen von Ihnen registrierten endpoint. Ihr Backend akzeptiert diese Benachrichtigung und plant die nächste Aktion, z. B. das Abrufen des fertigen Assets. Die ursprüngliche Browser-Session muss nicht verbunden bleiben.
Befehl von der Benachrichtigung trennen
Arbeiten einzureichen und zu erfahren, dass sie abgeschlossen sind, sind unterschiedliche Operationen. Eine API kann eine task sofort akzeptieren, ohne die Verbindung offen zu halten, bis die zugrunde liegende Berechnung abgeschlossen ist. Ein Webhook liefert dann ein separates Abschluss-Signal.
Diese Unterscheidung verhindert einen häufigen Designfehler: jede asynchrone Operation als eine HTTP request zu behandeln, die offen bleiben muss. Sie verhindert auch den entgegengesetzten Fehler, nämlich zu versuchen, Ereignisbenachrichtigungen als vollständige Aufzeichnung des aktuellen Zustands zu verwenden.
Erste Entscheidung: Muss Ihre Anwendung reagieren, wenn sich etwas ändert, oder benötigt sie die Antwort nur, wenn jemand fragt?
Wenn ein Benutzer einen job-history screen öffnet, rufen Sie die aktuellen Datensätze ab. Wenn ein abgeschlossener Auftrag die Asset-Lieferung auslösen soll, während niemand diesen screen beobachtet, verwenden Sie einen ereignisgesteuerten Pfad. Keines der Muster eliminiert die Notwendigkeit, Netzwerkfehler zu behandeln, aber jedes versetzt den Aufrufer in eine andere Position, um sich zu erholen.
Wie jedes Muster Daten bewegt
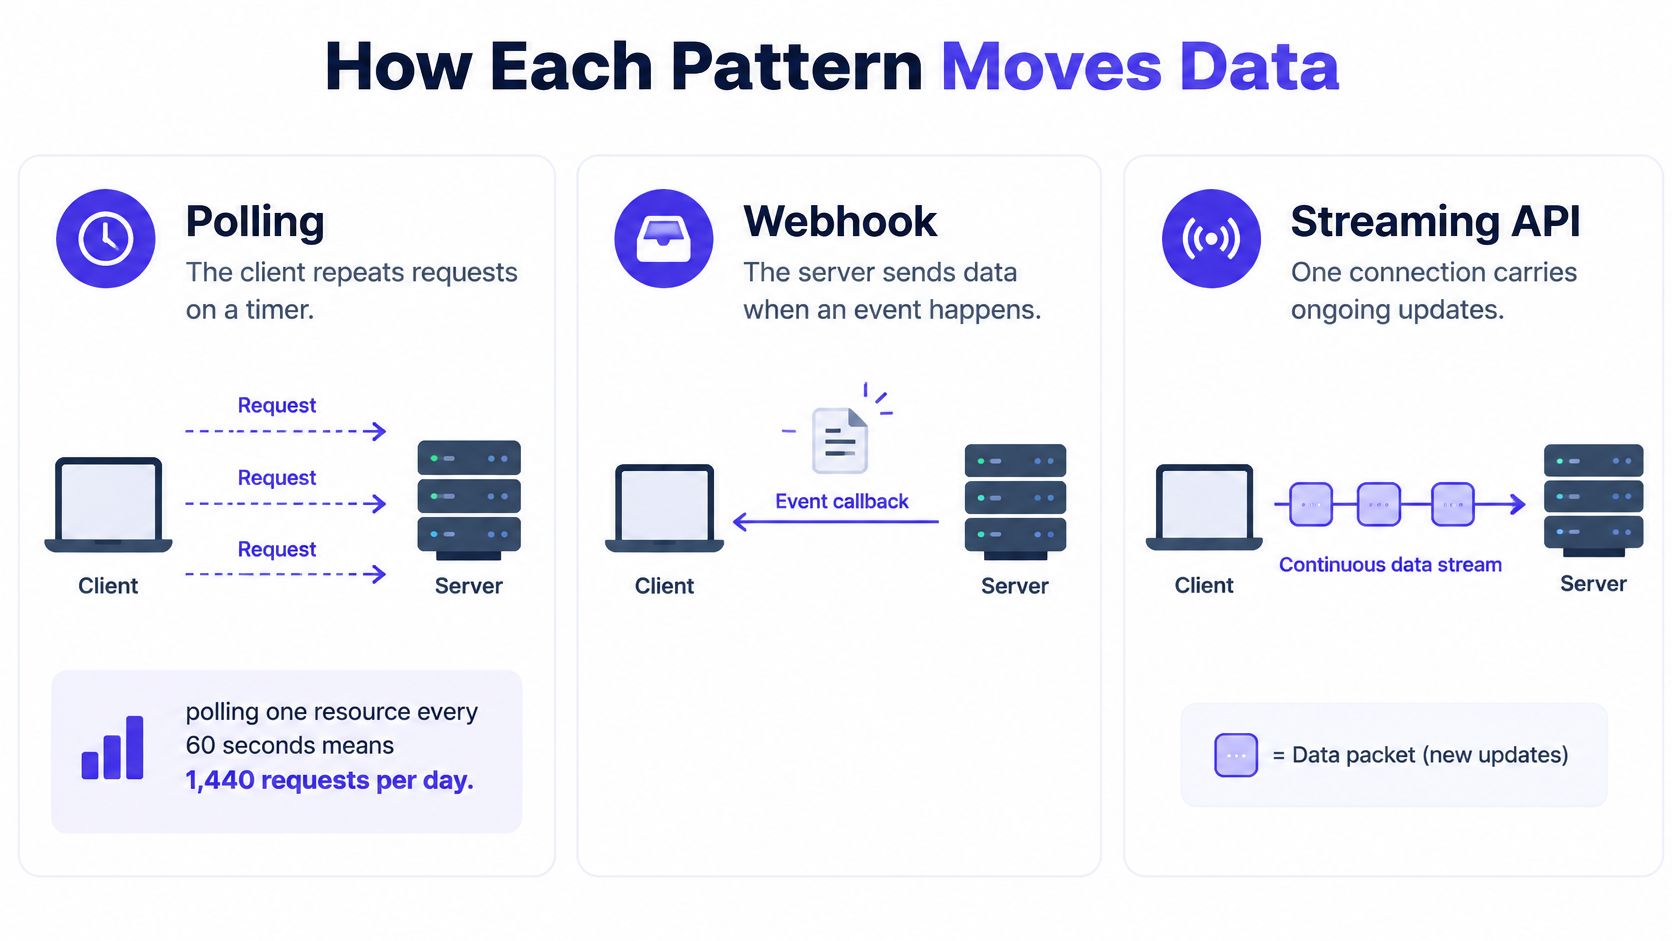
Beim Polling wiederholt der Client eine Statusanfrage nach einem Zeitplan, unabhängig davon, ob sich etwas geändert hat oder nicht. Bei einem Webhook initiiert der Anbieter eine Anfrage nach einem Ereignis, sodass der Benachrichtigungsverkehr der Aktivität und nicht der Uhrzeit folgt.
Der Nylas Webhook-versus-Polling-Leitfaden liefert die zugrunde liegenden Verkehrsbeispiele: Das Polling einer Ressource alle 60 Sekunden bedeutet 1,440 Anfragen pro Tag, während der Vergleich von 10,000 Konten 2.88 Millionen tägliche Polling-Anfragen gegenüber etwa 500,000 Webhook-Zustellungen erzeugt.
Verkehr und Verzögerung nach Polling-Intervall und Ereignisrate
| Szenario | Anfragen oder Zustellungen pro Tag | Erkennungsverzögerung |
|---|---|---|
| Eine Ressource alle 60 Sekunden pollen | 1,440 Anfragen | Durchschnittlich 30 Sekunden |
| Eine Ressource alle 5 Minuten pollen | 288 Anfragen, basierend auf dem Intervall berechnet | Durchschnittlich 2.5 Minuten |
| 10,000 Konten pollen alle 5 Minuten | 2.88 Millionen Anfragen | Durchschnittlich 2.5 Minuten |
| 10,000 Konten erhalten jeweils etwa 50 Ereignisbenachrichtigungen | Etwa 500,000 Zustellungen | Ereignisversandzeit plus etwaige Wiederholungsverzögerung |
| Textantwort Token für Token gestreamt | Eine Anfrage pro Generierung | Tokens kommen an, sobald sie generiert werden |
Die Polling-Durchschnittswerte gehen davon aus, dass Änderungen unabhängig vom Polling-Zeitplan auftreten. Sie beschreiben die Wartezeit bis zur nächsten Überprüfung, nicht die Zeit, die der Anbieter für die Ausführung der Arbeit aufwendet.
Das kürzere Intervall verbessert die Erkennungszeit durch mehr Anfragen. Das längere Intervall reduziert den Verkehr, lässt aber abgeschlossene Arbeiten unentdeckt. Auf Kontoebene erzeugt selbst ein bescheidener Zeitplan erheblichen Verkehr, da jedes inaktive Konto weiterhin überprüft wird.
Die Webhook-Zustellung eliminiert diesen festen Überprüfungszeitplan, aber die Anzahl der Zustellungen ist keine vollständige Infrastrukturrechnung. API-Abfragen nach Benachrichtigungen, Zustellungswiederholungen, Empfängerspeicher und Worker-Ausführung verbrauchen weiterhin Ressourcen.
Dies sind unterschiedliche Kommunikationsmuster, keine austauschbaren Bezeichnungen.
Streaming löst ein anderes Problem
Eine gestreamte Textantwort hält die Anfrage offen und gibt Tokens zurück, sobald sie generiert werden. Für einen interaktiven Coding-Assistenten sind die Zeit bis zum ersten Token und die Kontinuität der Ausgabe wichtiger als der Empfang eines separaten Abschluss-Callbacks.
Unsere Textantworten streamen Token für Token, während Bild- und Videoaufträge eine Aufgabe zurückgeben, die Sie pollen oder über die Sie eine Webhook-Benachrichtigung erhalten, wenn sie bereit ist. Die media API documentation ist der Ausgangspunkt für die Implementierung dieses aufgabenorientierten Anfragepfads.
Schätzen Sie Ihre Ereignisrate pro Ressource, bevor Sie ein Polling-Intervall wählen. Eine ruhige Ressource und eine sich ständig ändernde Ressource sollten nicht automatisch denselben Zeitplan teilen.
Beim Polling tauschen kürzere Intervalle mehr Verkehr gegen weniger Erkennungsverzögerung ein. Webhooks vermeiden diesen speziellen Austausch, ersetzen ihn aber durch die Kosten für den Betrieb eines zuverlässigen Empfängers.
Zuverlässigkeits-Kompromisse, die Sie berücksichtigen müssen
Die Webhook-Zustellung erfolgt normalerweise mindestens einmal, nicht genau einmal. Das beschreibt das Zustellmodell, nicht das Versprechen, dass ein Anbieter ewig wiederholt. Begrenzte Wiederholungsversuche können immer noch mit einem nicht zugestellten Ereignis enden, entwerfen Sie den Empfänger also für den schlimmsten Fall und nicht für den Idealfall.
Ein Timeout sagt dem Sender nichts darüber, was downstream passiert ist. Ihr Empfänger könnte das Ereignis in den Speicher schreiben, dann aber die Bestätigung im Netzwerk verlieren. Wenn der Sender wiederholt, empfängt Ihre Anwendung dasselbe Ereignis erneut und muss es elegant verarbeiten.
Jede Fehlerart mit einer Schutzmaßnahme abgleichen
- Doppelte Zustellung: Speichern Sie einen stabilen Ereignisbezeichner unter einer Unique Constraint. Wo Anbieter Ereignisse von Zustellversuchen unterscheiden, deduplizieren Sie die Geschäftsverarbeitung nach Ereignisidentität, nicht nach Versuchsidentität.
- Wiederholte Nebeneffekte: Machen Sie die Veröffentlichung von Assets, Kontoaktualisierungen und Kundenbenachrichtigungen idempotent. Die Deduplizierung des Eingangs nützt nichts, wenn ein Worker nach Ausführung einer Aktion, aber vor der Aufzeichnung des Erfolgs abstürzt.
- Ereignisse außerhalb der Reihenfolge: Überprüfen Sie den autoritativen Status oder eine dokumentierte Ressourcenversion, bevor Sie eine Transition anwenden. Ein verzögertes "Verarbeitungs"-Ereignis darf niemals eine abgeschlossene Aufgabe überschreiben.
- Langsame Verarbeitung: Verifizieren, dauerhaft akzeptieren und bestätigen Sie das Ereignis, bevor Sie aufwendige Arbeit an einen Queue Worker übergeben.
Die Wiederholungsrichtlinien der Anbieter sind nicht austauschbar. Die Supabase Webhook-Dokumentation erfordert eine 2xx-Antwort innerhalb von 20 Sekunden, verwendet exponentielles Backoff und stoppt nach fünf fehlgeschlagenen Versuchen. Der Svix Zustellgarantien-Leitfaden dokumentiert Dynamics ersten Versuch plus fünf Wiederholungen über etwa einen Tag, zusammen mit Gleans statusspezifischen Wiederholungsregeln.
Dokumentiertes Webhook-Wiederholungsverhalten nach Anbieter
| Anbieter | Was als Erfolg zählt | Wiederholungsverhalten |
|---|---|---|
| Supabase | 2xx-Antwort innerhalb von 20 Sekunden | Exponentielles Backoff, stoppt nach fünf fehlgeschlagenen Versuchen |
| Dynamic | 2xx-Antwort | Erster Versuch plus fünf Wiederholungen über etwa einen Tag |
| Glean | 2xx-Antwort | Wiederholt Verbindungsfehler, Timeouts, 408, 429 und 5xx; andere Nicht--2xx-Antworten sind terminal |
Eine Bestätigung definiert die Grenze der Dauerhaftigkeit
Eine Erfolgsmeldung vor der dauerhaften Speicherung schafft ein Verlustfenster: Der Sender stoppt die Wiederholungsversuche, aber Ihre Anwendung hat nichts Wiederherstellbares. Eine Erfolgsmeldung erst nach der Medienverarbeitung schafft das gegenteilige Problem: unnötige Timeouts und doppelte Zustellungen. Bestätigen Sie die dauerhafte Akzeptanz, nicht die abgeschlossene Geschäftsarbeit.
Die Signaturprüfung gehört vor das Vertrauen in die Payload. Bewahren Sie den rohen Request Body auf, wenn das Signaturschema dies erfordert, und folgen Sie dem dokumentierten Verifizierungsverfahren des Anbieters, anstatt ein reserialisiertes Objekt zu signieren.
Fügen Sie eine Dead-Letter-Behandlung für erschöpfte Worker-Wiederholungen und eine Zustellungs-Observability hinzu, die Ereignis-IDs, Task-IDs, Bestätigungsfehler und Verarbeitungsergebnisse miteinander verbindet. Für den Polling-Teil desselben Workflows klassifizieren Sie Fehler mit den zurückgegebenen Statuscodes: Die API von UberLLM lehnt Aufrufe mit Fehlercodes wie 402, 404, 429 und 503 ab, was einem Abgleichsjob ermöglicht, eine Abrechnungsablehnung von Drosselung oder einem vorübergehend nicht verfügbaren Verkäufer zu trennen.
Ein verpasster Poll wird durch erneutes Prüfen wiederhergestellt. Ein verpasster Webhook benötigt eine weitere Zustellung oder einen unabhängigen Abgleichslauf, der den autoritativen Task-Status nach einem Zeitplan erneut liest. Erstellen Sie diesen Lauf, unabhängig davon, ob Sie einen Empfänger exponieren oder nicht; er ist es, der die mindestens einmalige Zustellung in eine effektive genau einmalige Verarbeitung verwandelt.
Wann Polling die sicherere Wahl ist
Webhooks sind ein Problem der Zustellzuverlässigkeit, nicht nur eine schnellere API. Wenn Ihre Anwendung den Empfängervertrag nicht unterstützen kann, ist Polling möglicherweise die zuverlässigere Wahl.
Der operative Unterschied ist an der Konsumentengrenze am einfachsten zu erkennen.
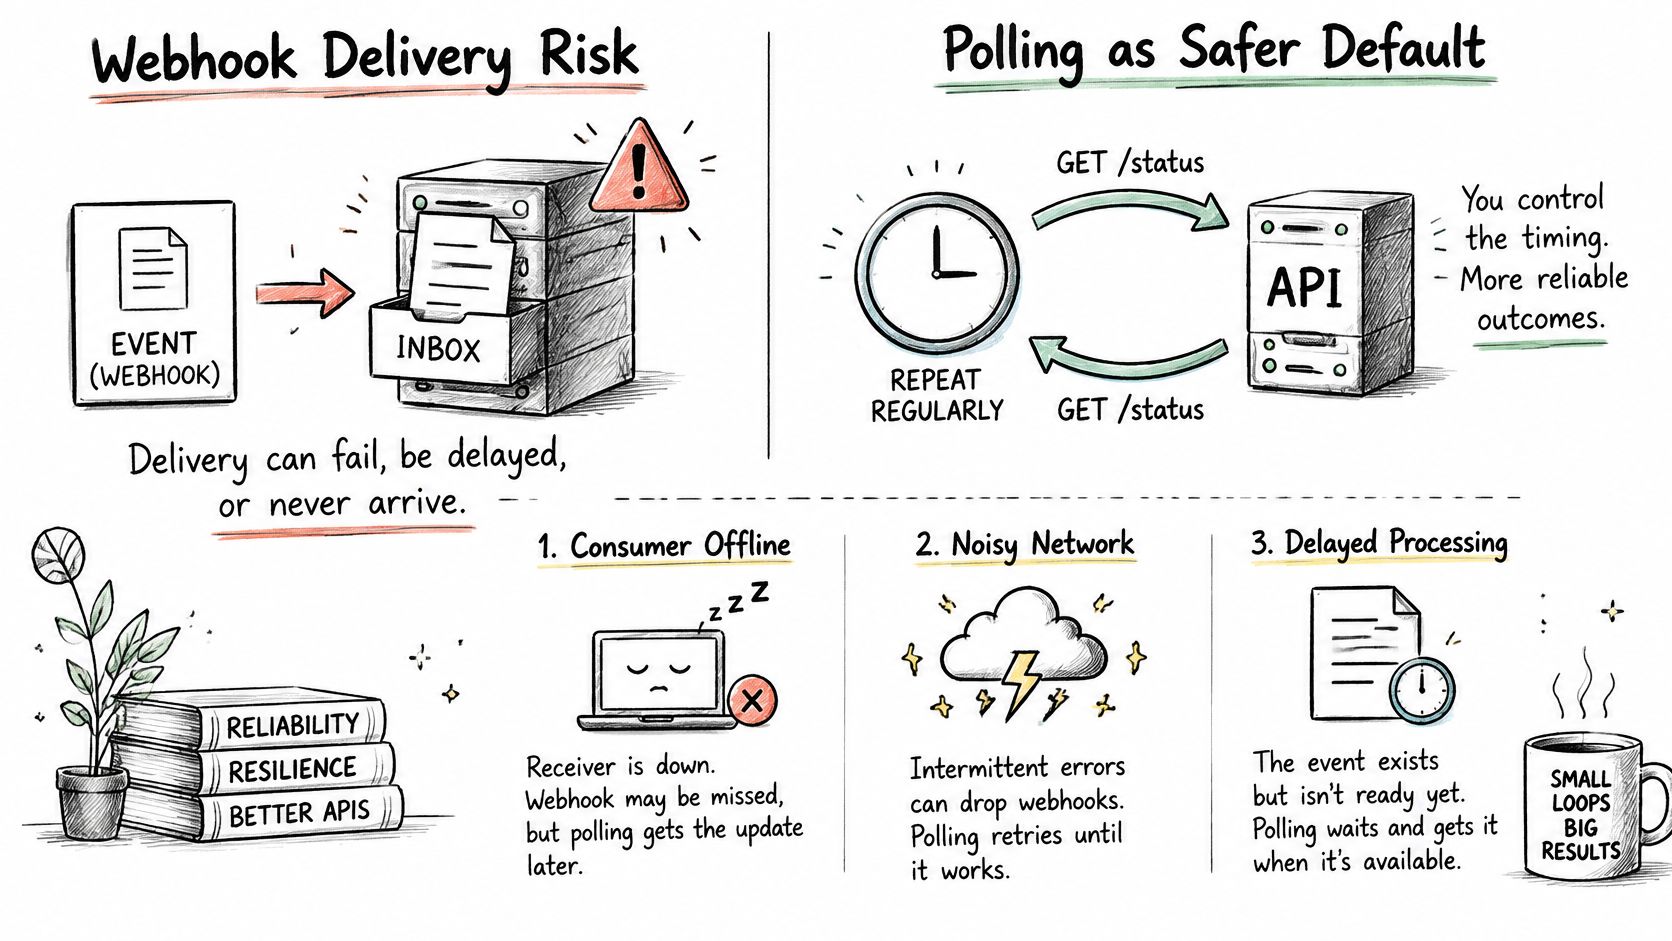
Ein Desktop-Agent, ein internes Tool hinter einer Firewall oder ein kurzlebiger CI-Runner haben möglicherweise ausgehenden Zugriff ohne eine stabile eingehende Adresse. Damit diese Clients Rückrufe empfangen können, sind möglicherweise ein zusätzlicher gehosteter Dienst, eine Authentifizierung zwischen Komponenten und eine dauerhafte Übergabe an den ursprünglichen Aufrufer erforderlich. Das ist Infrastruktur, keine geringfügige Konfigurationsänderung.
Erkennen Sie die Einschränkungen, die Polling begünstigen
- Kein stabiler öffentlicher endpoint: Halten Sie die Kommunikation ausgehend, anstatt eine temporäre Entwicklungsumgebung freizulegen.
- Kein dauerhafter Event-Konsument: Fragen Sie den autoritativen Status ab, während Sie eine sichere Speicherung und Verarbeitung aufbauen. Ein Empfänger, der akzeptierte Events vergisst, ist keine Verbesserung.
- Konsumentengesteuerte Wiederherstellung: Planen Sie Überprüfungen gemäß Ihren eigenen Parallelitätsgrenzen, Wartungsfenstern und Anwendungsfristen.
Angenommen, ein Build-Tool auf dem Laptop eines Entwicklers übermittelt eine Remote-Medienaufgabe. Es kann regelmäßig bis zur Fertigstellung prüfen, stoppen, wenn der Entwickler abbricht, und mit dem gespeicherten Aufgaben-identifier fortfahren. Für eine kleine Anzahl aktiver Jobs kann das einfacher und billiger sein, als einen ständig verfügbaren Empfänger zu unterhalten.
Polling erfordert dennoch Disziplin. Ziehen Sie sich bei vorübergehenden Fehlern zurück, vermeiden Sie die Synchronisierung der Überprüfungen jedes Clients und beenden Sie die Überprüfung von terminalen Aufgaben. Ein Retry-Storm ist auch bei ausgehenden Anfragen möglich.
Das begleitende Video bietet eine weitere Möglichkeit, die Unterscheidung zwischen Anfrage und Callback zu visualisieren.
Wählen Sie das Muster, das Ihr Konsument zuverlässig wiederherstellen kann, nicht das Muster mit der schnellsten erfolgreichen Demonstration.
Eingehender Webhook-Traffic fügt endpoint-Sicherheit, Signaturprüfungen, Queueing, Duplikatsunterdrückung und Verfügbarkeitsanforderungen hinzu. Polling gibt Ihnen explizite Kontrolle darüber, wann die nächste Operation stattfindet, obwohl die rate limits des Anbieters weiterhin gelten.
Verwenden Sie einen Webhook mit einem Polling-Fallback, wenn die eingehende Zustellung praktisch ist und häufige Events dies rechtfertigen; andernfalls pollen Sie mit Ihrer eigenen Kadenz, concurrency und timeout.
So erstellen Sie den hybriden Workflow für Medienaufträge
Eine hybride Integration behandelt Callbacks als Aufforderungen zur Überprüfung der Arbeit, nicht als einzigen Nachweis, dass Arbeit existiert. Persistente Aufgabenidentität verbindet die ursprüngliche Anfrage, eingehende Benachrichtigungen, Wiederherstellungsprüfungen und das letztendliche Kundenergebnis.
Wir nutzen asynchrones Aufgaben-Tracking und Webhook-Callbacks, um hochvolumige Medien-Workflows am Laufen zu halten. Für Bild- und Videoaufträge bedeutet dieses Tracking, dass eine Unterbrechung bei einem Anbieter den Auftrag des Kunden nicht verloren gehen lässt.
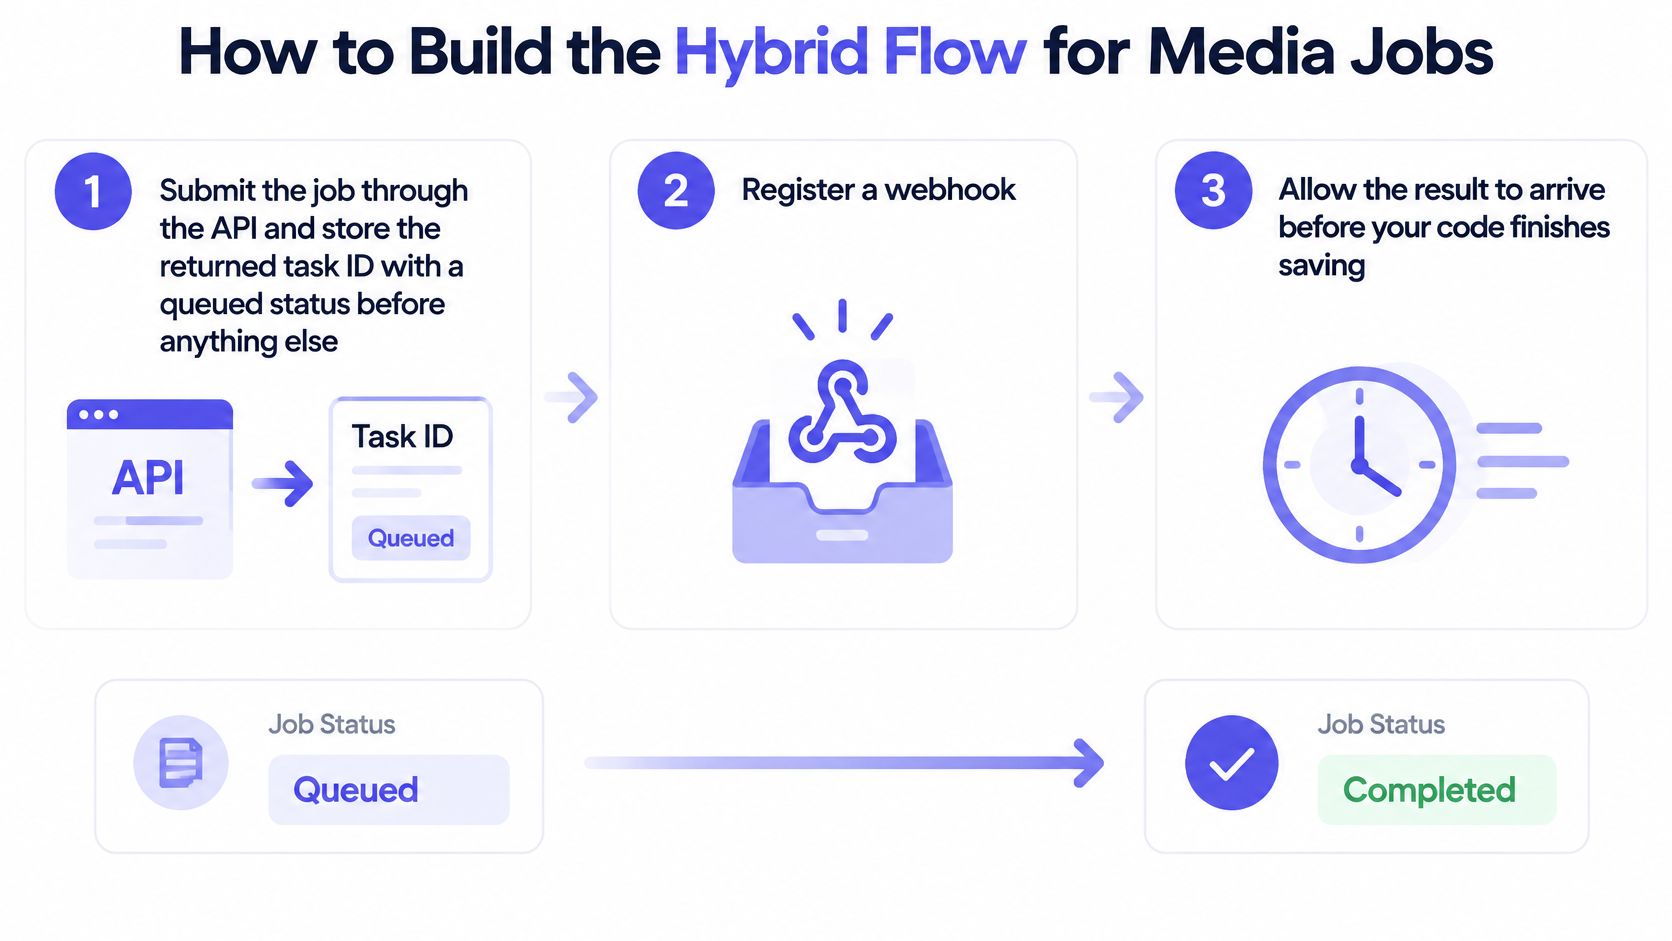
Der Workflow hält Einreichung, Benachrichtigung und Statuswiederherstellung getrennt.
Dauerhafte Inhaberschaft der Aufgabe etablieren
Über die API einreichen und die zurückgegebene task ID speichern. Persistieren Sie sie mit einem 'queued' Status, bevor Sie nachgelagerte Arbeiten beginnen. Erstellen Sie nach Möglichkeit vorher einen lokalen Einreichungsdatensatz, da ein schneller Callback die Einreichungsantwort überholen kann. Der häufige Fehler ist die Annahme, dass Callbacks immer nach dem Datenbank-Commit eintreffen. Behalten Sie nicht zugeordnete Ereignisse für eine spätere Zuordnung bei.
Einen Receiver registrieren, der akzeptierte Ereignisse dauerhaft in eine Warteschlange stellt. Halten Sie den Request Handler klein und bestätigen Sie umgehend nach sicherer Annahme. Geben Sie keinen Erfolg zurück, bevor die Speicherung erfolgt ist, und laden oder transformieren Sie das fertige Asset nicht innerhalb des Handlers.
Authentizität überprüfen, dann die Verarbeitung deduplizieren. Die Signaturprüfung muss am Ingress erfolgen, bevor ein Ereignis vertraut oder bestätigt wird; der Worker prüft dann die persistente Ereignisidentität, bevor Effekte angewendet werden. Der häufige Fehler ist, dies als optionale Bereinigung nach der Verarbeitung zu behandeln. Halten Sie den Akzeptanz- und Verarbeitungsstatus getrennt, damit ein unterbrochener Worker sicher fortfahren kann.
Autoritative Fertigstellung erreichen
Den autoritativen Status der Aufgabe abrufen. Verwenden Sie die gespeicherte task ID, bevor Sie den Kundenauftrag als abgeschlossen markieren. Ein Ereignis kann nur einen Identifier enthalten, und eine verzögerte Benachrichtigung kann einen älteren Übergang beschreiben. Für eine Bildbearbeitungs-Implementierung bietet der API-Leitfaden für die Fotobearbeitung einen konkreten Request Workflow, um den herum aufgebaut werden kann.
Aufgaben pollen, die über ihr erwartetes Zeitfenster hinaus 'pending' bleiben. Verwenden Sie Backoff, Jitter und eine maximale Anzahl von Versuchen für jeden Prüfzyklus. Reichen Sie die Generierung nicht blind erneut ein, wenn ein Callback fehlt, da die ursprüngliche Aufgabe möglicherweise bereits abgeschlossen ist.
Eine Anwendungsfrist festlegen und veraltete Aufgaben täglich abgleichen. Unterscheiden Sie eine fehlgeschlagene Generierung von einem Statusprüfungsfehler. Wenn der Provider-Status zu Ihrer Frist unbekannt bleibt, zeichnen Sie ein explizites Wiederherstellungs- oder Fehlerergebnis auf, anstatt die Kundenschnittstelle unbegrenzt in der Warteschlange zu lassen.
Gesundheitscheck: Jede gespeicherte task ID muss zu einem terminalen Anwendungsergebnis führen, abgeschlossen oder fehlgeschlagen, innerhalb Ihres Timeouts. Halten Sie ungelösten Provider-Status für Operatoren sichtbar, damit ein Anwendungs-Timeout kein Ergebnis aufgibt, das noch wiederhergestellt werden muss.
Wählen Sie nach Arbeitslast und Einschränkung
Beginnen Sie mit der Arbeitslast und lehnen Sie dann jedes Muster ab, das Ihre Bereitstellung nicht unterstützen kann. Der schnellste Benachrichtigungsmechanismus hilft nicht, wenn der empfangende Client keine eingehenden Anfragen akzeptieren kann oder das Team die unterbrochene Verarbeitung nicht wiederherstellen kann.
Zuordnung von Arbeitslast zu Muster
| Arbeitslast | Empfohlenes Muster | Hauptgrund |
|---|---|---|
| Kurze Texterstellung oder Code-Antwort | Synchroner API-Aufruf mit streaming | Eine schnelle Antwort erforderlich |
| Bild-, Video-, Musik- oder Sprachauftrag | Über API einreichen, webhook bei Abschluss, Polling als Fallback | Abschlusszeit ist unvorhersehbar |
| Mobiler oder Browser-Client ohne öffentlichen endpoint | Polling | Kann keine vom Anbieter initiierten eingehenden Anfragen akzeptieren |
| Nachfüllen oder Abgleich vergangener Datensätze | API-Listenaufrufe | Benötigt aktuellen und historischen Zustand |
| Ereignis-Feed mit hohem Volumen, z. B. Bestellstatus | Webhook mit idempotentem consumer und Abgleich | Geeignet, wenn die Ereignisrate weit unter der vorgeschlagenen Polling-Rate liegt |
Ein Browser kann Anwendungsaktualisierungen weiterhin über sein eigenes Backend empfangen, aber dieses Backend ist der Eigentümer des webhook-receivers. Legen Sie keine Anbieter-credentials oder callback-Verifizierungs-secrets in den Browser, um diese Verantwortung zu umgehen.
Die Arbeitslast und die Bereitstellungseinschränkung sollten zusammen bewertet werden.
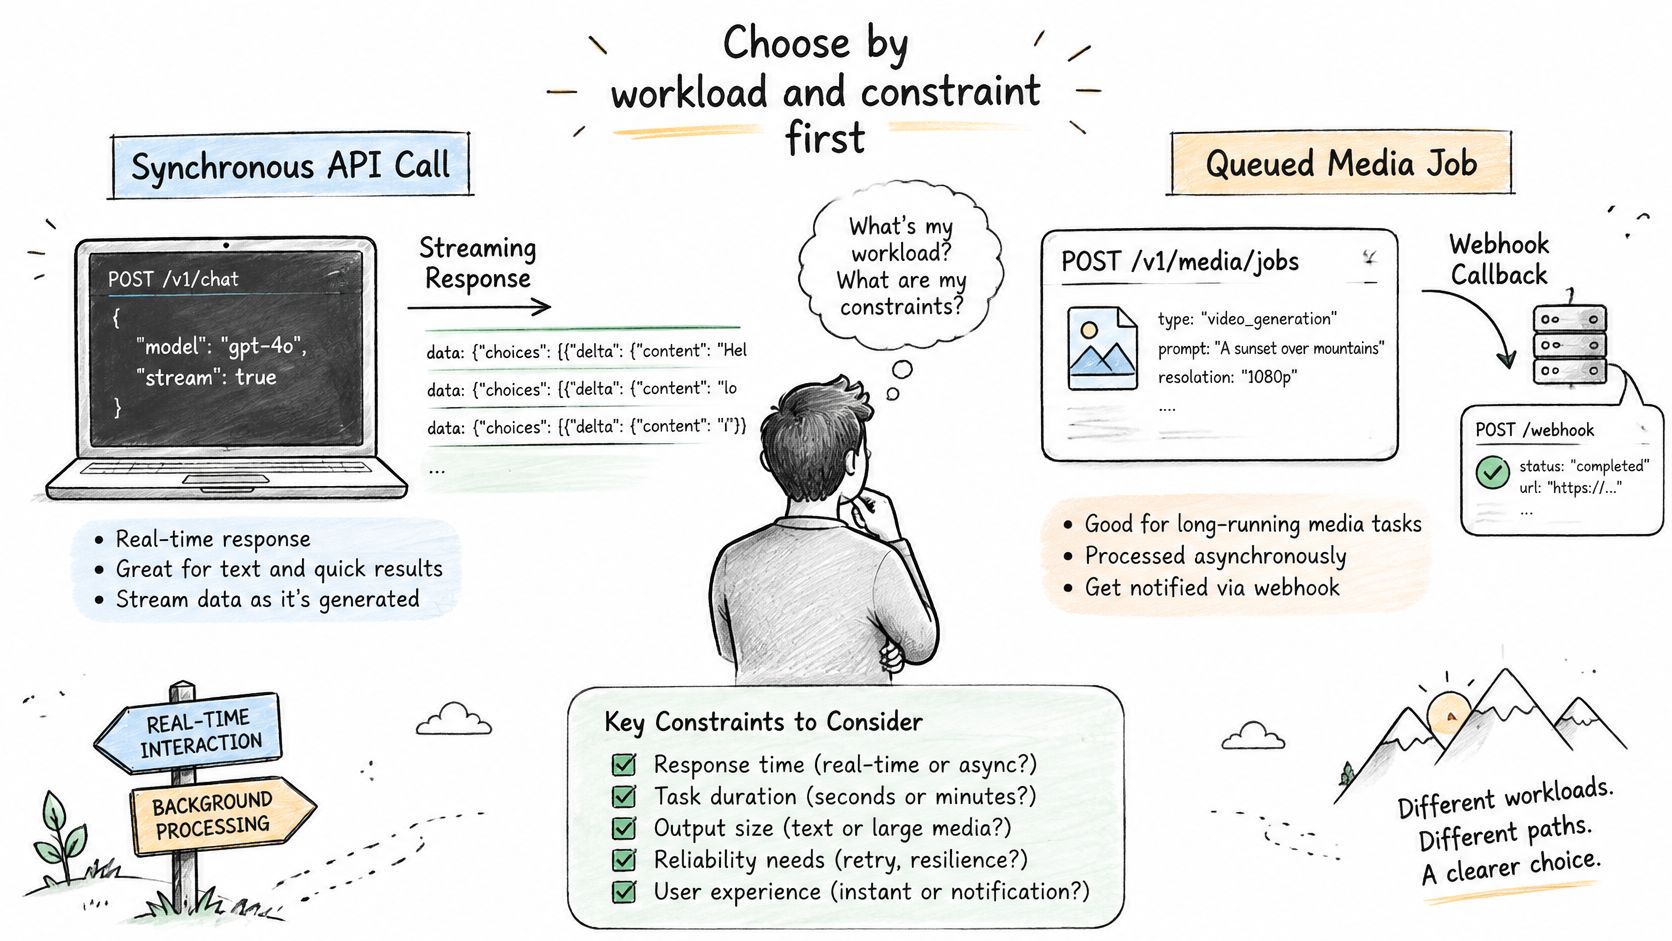
Gesamte Betriebskosten als Entscheidungskriterium nutzen
Eine in Xictrons Artikel zur webhook-Architektur zitierte Analyse ergab, dass nur 1.5% von 30 Millionen Polling-Anfragen ein Update zurückgaben. Das veranschaulicht, wie schlecht abgestimmtes Polling Traffic verschwenden kann, nicht dass jede webhook-Integration weniger kosten wird.
Vergleichen Sie Polling-Intervall, Ereignisfrequenz, payload size und Anbieterlimits mit receiver hosting, queue storage, monitoring und incident response. Zählen Sie auch die API-reads, die Ihr webhook-worker noch benötigt. Eine leichte Benachrichtigung, gefolgt von einem autoritativen fetch, ist keine anfragenfreie Architektur.
Für eine Multi-Provider-Anwendung überprüfen Sie die event-schema consistency und das fallback behavior. Die Normalisierung des Aufgabenstatus in Ihr eigenes Anwendungsmodell kann wichtiger sein als geringe Unterschiede in der Benachrichtigungsgeschwindigkeit.
Auswahlregel: Bevorzugen Sie den einfachsten primären Pfad, der die benutzerseitigen Anforderungen erfüllt, und finanzieren Sie dann den Wiederherstellungspfad, bevor Sie die latency optimieren.
Verwenden Sie eine API, wenn die Anwendung eine Antwort auf eine Anfrage benötigt. Verwenden Sie webhooks, wenn sie auf Änderungen reagieren muss und einen sicheren, dauerhaften receiver betreiben kann. Fügen Sie unabhängige Statusprüfungen für langlaufende Aufträge hinzu und halten Sie Polling konsumentengesteuert, wenn eine eingehende Lieferung nicht möglich ist.
Schreiben Sie vor der Implementierung Ihre erwartete Ereignisrate pro Ressource auf, ob Sie einen stabilen endpoint bereitstellen können und wie Sie mit doppelter Verarbeitung umgehen werden. Führen Sie dann eine einfache API-Anfrage aus und überprüfen Sie, ob Sie die resultierende Aufgabe speichern und abrufen können, bevor Sie callbacks hinzufügen.
UberLLM bietet alle Modelle über einen API key an und akzeptiert OpenAI- und Anthropic-wire formats, sodass bestehende Clients die entsprechende base URL und credentials verwenden können. Für Bild- und Video-workflows wählen Sie task polling oder webhook notification, wenn das Ergebnis bereit ist. Besuchen Sie UberLLM, um den request path zu testen, und fügen Sie dann die completion und recovery paths hinzu, die Ihre Anwendung benötigt.