Webhook vs. API: Push, Polling y Cuándo Usar Cada Uno
Webhook vs. API comparados en dirección, tráfico, fiabilidad y coste, con cuándo usar cada uno y cómo combinarlos para trabajos de medios de IA asíncronos.
El consejo popular sobre webhook vs API es incompleto: usa webhooks para actualizaciones en tiempo real y APIs para todo lo demás. Eso se salta la parte más difícil. Un receptor de webhook es un consumidor de mensajes asíncrono, y elegir la entrega push significa aceptar la responsabilidad por duplicados, notificaciones perdidas, autenticación y recuperación. La comparación útil no es push versus pull. Es economía del tráfico versus control operativo, con una ruta de recuperación para cualquier canal que falle.
Tabla de Contenidos
- Webhook vs API de un Vistazo
- Cómo Cada Patrón Mueve Datos
- Compromisos de Fiabilidad que Debes Diseñar
- Cuando el Polling es la Opción Más Segura
- Cómo Construir el Flujo Híbrido para Trabajos de Medios
- Elige por Carga de Trabajo y Restricción
Webhook vs API de un vistazo
| Criterio | API (solicitud-respuesta o sondeo) | Webhook (notificación push) |
|---|---|---|
| Dirección | El cliente envía la solicitud, el servidor responde | El proveedor envía una solicitud HTTP a la URL del cliente |
| Quién inicia | Cliente | Proveedor, cuando ocurre un evento |
| Momento | Cuando el cliente pregunta | Cuando ocurre el evento |
| Mejor para | Estado actual, historial, rellenos de datos (backfills), conciliación | Notificar a las aplicaciones cuando el estado cambia o un trabajo termina |
| Necesidades del cliente | Solo acceso HTTP saliente | endpoint HTTPS público, verificación de firma, almacenamiento |
| Entrega | Respuesta directa a cada solicitud, si el transporte tiene éxito | Normalmente entrega "al menos una vez" con reintentos limitados, posibles duplicados y reordenación |
| Recuperación de fallos | El cliente reintenta y vuelve a comprobar | El proveedor reintenta; el consumidor desduplica y concilia a través de la API |
| Patrón de coste | El tráfico crece con la frecuencia de sondeo | El tráfico crece con el volumen de eventos |
Un webhook es un mecanismo de entrega de eventos construido sobre APIs HTTP, no un reemplazo para ellas. La mayoría de las integraciones en producción necesitan ambos: una ruta de solicitud para comandos y lecturas autorizadas, además de una ruta de notificación para cambios.
Imagina que tu aplicación envía un trabajo de generación de vídeo. Con una API, tu backend envía una solicitud GET usando el identificador de tarea guardado y recibe el estado actual del trabajo. Tu aplicación elige cuándo preguntar, cuánto tiempo esperar y qué hacer si la solicitud falla.
Con un webhook, el proveedor envía un evento de "trabajo completado" a un endpoint que registraste. Tu backend acepta esa notificación y programa la siguiente acción, como recuperar el activo terminado. La sesión original del navegador no necesita permanecer conectada.
Separa el comando de la notificación
Enviar un trabajo y saber que ha terminado son operaciones diferentes. Una API puede aceptar una tarea inmediatamente sin mantener la conexión abierta hasta que finalice el cálculo subyacente. Un webhook proporciona entonces una señal de finalización separada.
Esa distinción evita un error de diseño común: tratar cada operación asíncrona como una solicitud HTTP que debe permanecer abierta. También evita el error opuesto, intentar usar las notificaciones de eventos como un registro completo del estado actual.
Primera decisión: ¿Tu aplicación necesita reaccionar cuando algo cambia, o solo necesita la respuesta cuando alguien pregunta?
Si un usuario abre una pantalla de historial de trabajos, recupera los registros actuales. Si un trabajo completado debe activar la entrega de un activo mientras nadie está viendo esa pantalla, usa una ruta basada en eventos. Ninguno de los patrones elimina la necesidad de manejar fallos de red, pero cada uno sitúa al que llama en una posición diferente para recuperarse.
Cómo Cada Patrón Mueve Datos
Con polling, el cliente repite una solicitud de estado en un temporizador, haya cambiado algo o no. Con un webhook, el proveedor inicia una solicitud después de un evento, por lo que el tráfico de notificaciones sigue la actividad en lugar del reloj.
La guía de Nylas sobre webhook versus polling ofrece ejemplos del tráfico subyacente: hacer polling a un recurso cada 60 segundos significa 1,440 solicitudes al día, mientras que su comparación de 10,000 cuentas produce 2.88 millones de solicitudes de polling diarias frente a aproximadamente 500,000 entregas de webhook.
Tráfico y latencia por intervalo de polling y tasa de eventos
| Escenario | Solicitudes o entregas al día | Latencia de detección |
|---|---|---|
| Hacer polling a un recurso cada 60 segundos | 1,440 solicitudes | 30 segundos de media |
| Hacer polling a un recurso cada 5 minutos | 288 solicitudes, calculadas a partir del intervalo | 2.5 minutos de media |
| 10,000 cuentas haciendo polling cada 5 minutos | 2.88 millones de solicitudes | 2.5 minutos de media |
| 10,000 cuentas recibiendo aproximadamente 50 notificaciones de eventos cada una | Aproximadamente 500,000 entregas | Tiempo de envío del evento más cualquier retraso de reintento |
| Respuesta de texto en streaming token por token | Una solicitud por generación | Los tokens llegan a medida que se generan |
Los promedios de polling asumen que los cambios ocurren independientemente del cronograma de polling. Describen la espera hasta la siguiente verificación, no el tiempo que el proveedor dedica a realizar el trabajo.
El intervalo más corto mejora el tiempo de descubrimiento al consumir más solicitudes. El intervalo más largo reduce el tráfico, pero hace que el trabajo completado permanezca sin ser descubierto. A escala de cuenta, incluso un cronograma modesto crea un tráfico sustancial porque cada cuenta inactiva sigue siendo verificada.
La entrega de webhook elimina ese cronograma de verificación fijo, pero el recuento de entregas no es una factura de infraestructura completa. Las búsquedas de API después de las notificaciones, los reintentos de entrega, el almacenamiento del receptor y la ejecución del worker siguen consumiendo recursos.
Estos son patrones de comunicación distintos, no etiquetas intercambiables.
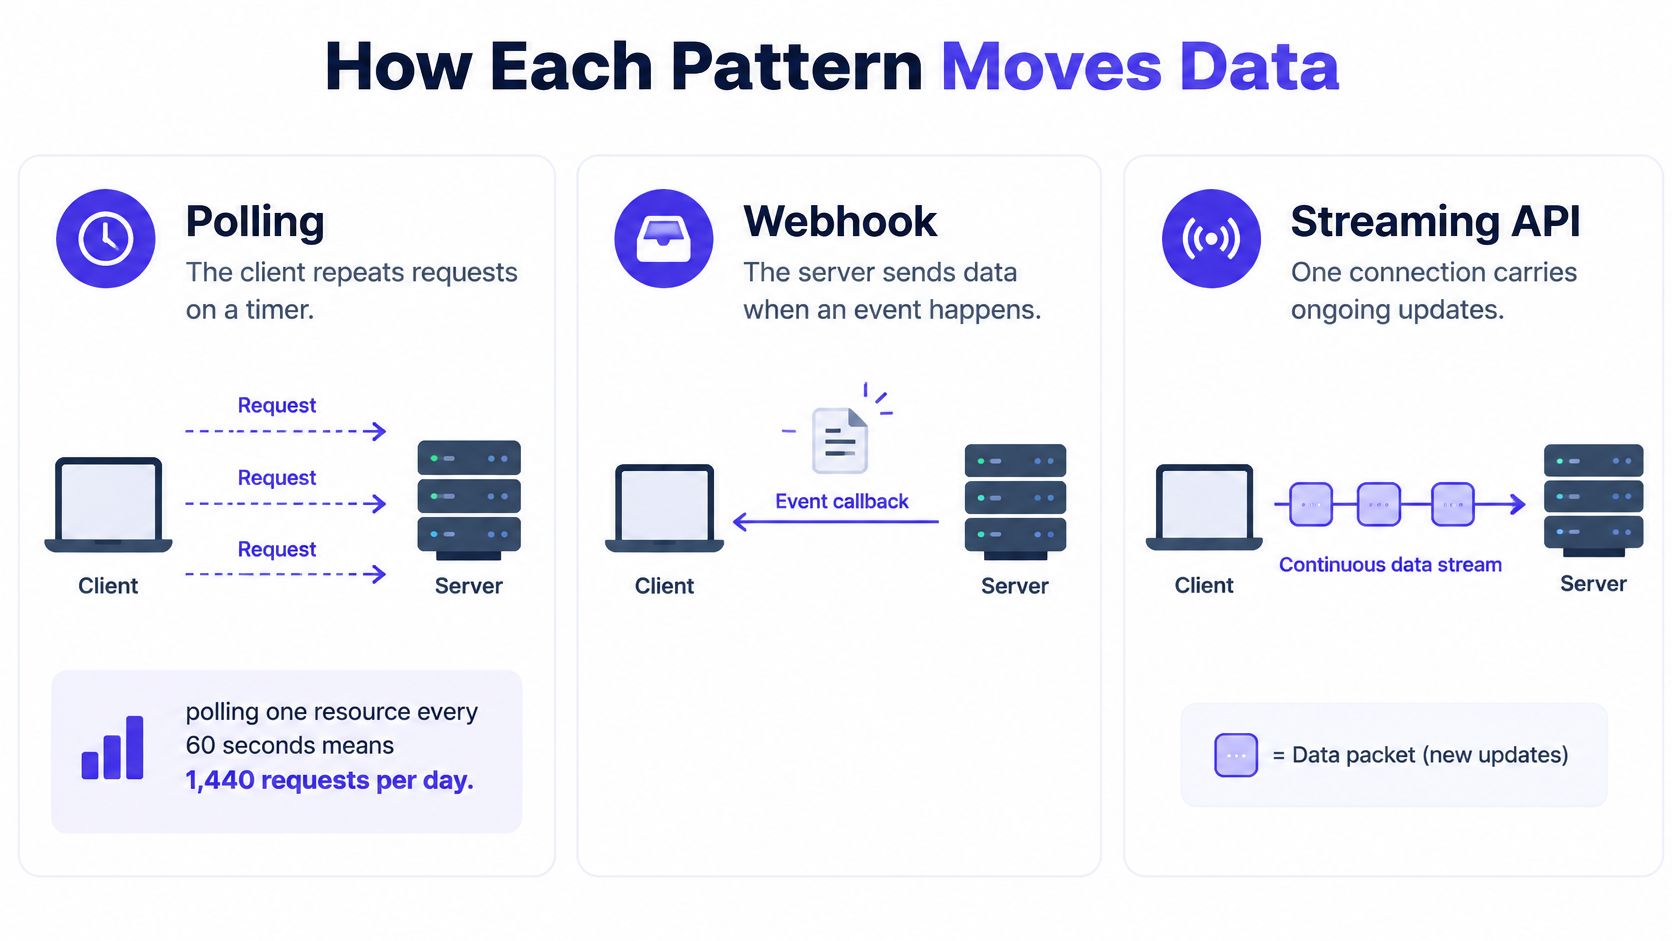
Streaming resuelve un problema diferente
Una respuesta de texto en streaming mantiene la solicitud abierta y devuelve los tokens a medida que se generan. Para un asistente de codificación interactivo, el tiempo hasta el primer token y la continuidad de la salida importan más que recibir una devolución de llamada de finalización separada.
Nuestras respuestas de texto se transmiten token por token, mientras que los trabajos de imagen y video devuelven una tarea sobre la cual puedes hacer polling o recibir una notificación de webhook cuando esté lista. La documentación de la API de medios es el punto de partida para implementar esa ruta de solicitud orientada a tareas.
Estima tu tasa de eventos por recurso antes de elegir un intervalo de polling. Un recurso inactivo y un recurso en cambio continuo no deberían compartir automáticamente el mismo cronograma.
Para el polling, los intervalos más cortos intercambian más tráfico por menos retraso de detección. Los webhooks evitan ese intercambio particular, pero lo reemplazan con el costo de operar un receptor confiable.
Compensaciones de fiabilidad que debes considerar en el diseño
La entrega de webhooks es normalmente al menos una vez, no exactamente una vez. Esto describe el modelo de entrega, no una promesa de que un proveedor reintentará indefinidamente. Los reintentos limitados aún pueden terminar con un evento no entregado, así que diseña el receptor para el peor de los casos en lugar del escenario ideal.
Un tiempo de espera no le dice nada al remitente sobre lo que ocurrió en el flujo descendente. Tu receptor podría registrar el evento en el almacenamiento y luego perder la confirmación en la red. Cuando el remitente reintenta, tu aplicación recibe el mismo evento de nuevo y tiene que gestionarlo de forma elegante.
Asocia cada fallo con una protección
- Entrega duplicada: Almacena un identificador de evento estable bajo una restricción única. Cuando los proveedores distinguen eventos de intentos de entrega, deduplica el procesamiento de negocio por identidad de evento, no por identidad de intento.
- Efectos secundarios repetidos: Haz que la publicación de activos, las actualizaciones de cuentas y las notificaciones a clientes sean idempotentes. La deduplicación de la entrada no sirve de nada para un trabajador que falla después de realizar una acción pero antes de registrar el éxito.
- Eventos fuera de orden: Verifica el estado autoritativo o una versión de recurso documentada antes de aplicar una transición. Un evento de "procesamiento" retrasado nunca debe sobrescribir una tarea completada.
- Procesamiento lento: Verifica, acepta de forma duradera y confirma el evento antes de entregar el trabajo costoso a un trabajador de cola.
Las políticas de reintento del proveedor no son intercambiables. La documentación de webhooks de Supabase requiere una respuesta 2xx en 20 segundos, utiliza retroceso exponencial y se detiene después de cinco intentos fallidos. La guía de garantías de entrega de Svix documenta el intento inicial de Dynamic más cinco reintentos durante aproximadamente un día, junto con las reglas de reintento específicas de estado de Glean.
Comportamiento documentado de reintento de webhook por proveedor
| Proveedor | Qué cuenta como éxito | Comportamiento de reintento |
|---|---|---|
| Supabase | Respuesta 2xx en 20 segundos | Retroceso exponencial, se detiene después de cinco intentos fallidos |
| Dynamic | Respuesta 2xx | Intento inicial más cinco reintentos durante aproximadamente un día |
| Glean | Respuesta 2xx | Reintenta fallos de conexión, tiempos de espera, 408, 429 y 5xx; otras respuestas que no sean -2xx son terminales |
La confirmación es un límite de durabilidad
Devolver el éxito antes del almacenamiento duradero crea una ventana de pérdida: el remitente deja de reintentar, pero tu aplicación no tiene nada recuperable. Devolver el éxito solo después del procesamiento de medios crea el problema opuesto: tiempos de espera innecesarios y entregas duplicadas. Confirma la aceptación duradera, no el trabajo de negocio completado.
La verificación de la firma debe realizarse antes de confiar en la carga útil. Conserva el cuerpo de la solicitud en bruto cuando el esquema de firma lo requiera y sigue el procedimiento de verificación documentado del proveedor en lugar de firmar un objeto reserializado.
Añade manejo de mensajes fallidos para reintentos de trabajador agotados y observabilidad de entrega que conecte IDs de evento, IDs de tarea, fallos de confirmación y resultados de procesamiento. Para la etapa de sondeo del mismo flujo de trabajo, clasifica los fallos con los códigos de estado devueltos: la API de UberLLM rechaza llamadas con códigos de error como 402, 404, 429 y 503, lo que permite a un trabajo de conciliación separar un rechazo de facturación de la limitación de velocidad o de un vendedor temporalmente no disponible.
Un sondeo perdido se recupera comprobando de nuevo. Un webhook perdido necesita otra entrega o un paso de conciliación independiente que relea el estado autoritativo de la tarea según un cronograma. Construye ese paso expongas o no un receptor; es lo que convierte la entrega "al menos una vez" en un procesamiento efectivo "exactamente una vez".
Cuando el Polling es la Opción Más Segura
Los webhooks son un problema de fiabilidad en la entrega, no solo una API más rápida. Si tu aplicación no puede soportar el contrato del receptor, el polling puede ser la opción más fiable.
La diferencia operativa es más fácil de ver en el límite del consumidor.
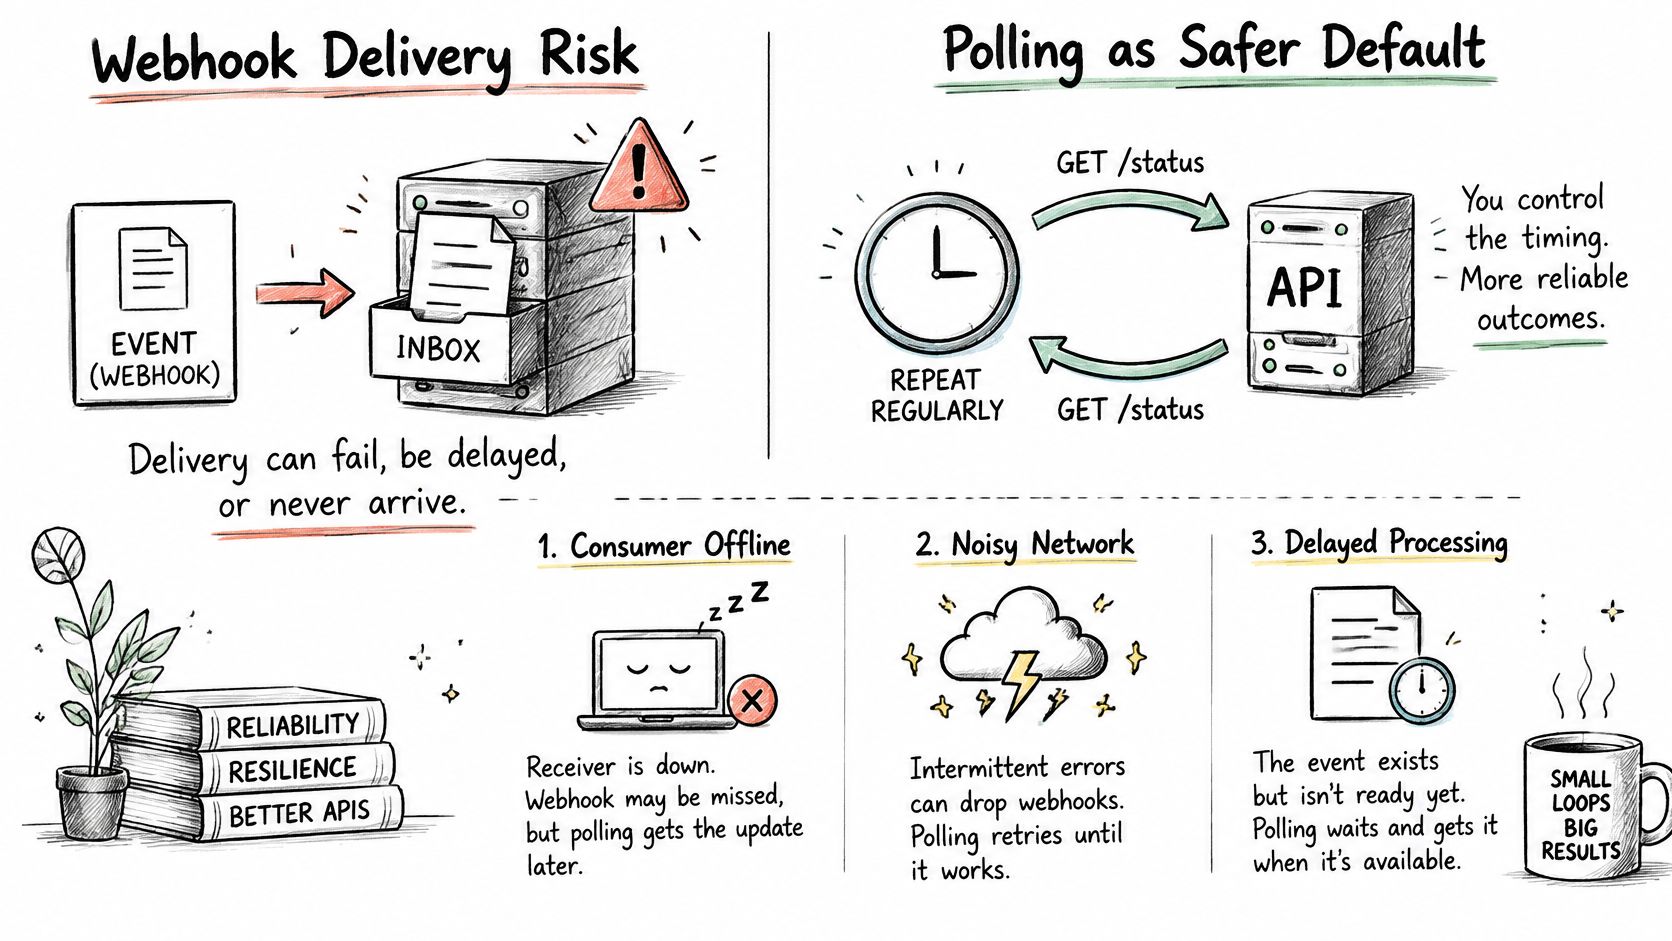
Un agente de escritorio, una herramienta interna detrás de un firewall, o un CI runner efímero pueden tener acceso de salida sin una dirección de entrada estable. Hacer que esos clientes reciban callbacks puede requerir un servicio alojado adicional, autenticación entre componentes y una entrega duradera de vuelta al llamador original. Eso es infraestructura, no un cambio de configuración menor.
Reconoce las limitaciones que favorecen el polling
- Sin endpoint público estable: Mantén la comunicación de salida en lugar de exponer un entorno de desarrollo temporal.
- Sin consumidor de eventos duradero: Consulta el estado autoritativo mientras construyes un almacenamiento y procesamiento seguros. Un receptor que olvida los eventos aceptados no es una mejora.
- Recuperación controlada por el consumidor: Programa las comprobaciones según tus propios límites de concurrencia, ventanas de mantenimiento y plazos de la aplicación.
Imagina que una herramienta de compilación en el portátil de un desarrollador envía una tarea de medios remota. Puede comprobar periódicamente hasta su finalización, detenerse cuando el desarrollador cancela y reanudar desde el identificador de tarea guardado. Para un pequeño número de trabajos activos, eso puede ser más simple y económico que mantener un receptor siempre disponible.
El polling aún requiere disciplina. Retrocede en fallos transitorios, evita sincronizar las comprobaciones de cada cliente y deja de comprobar tareas terminales. Una tormenta de reintentos también es posible con solicitudes de salida.
El video adjunto ofrece otra forma de visualizar la distinción entre solicitud y callback.
Elige el patrón que tu consumidor pueda recuperar de forma fiable, no el patrón con la demostración exitosa más rápida.
El tráfico de webhooks entrantes añade seguridad de endpoint, comprobaciones de firma, cola, supresión de duplicados y requisitos de disponibilidad. El polling te da un control explícito sobre cuándo ocurre la siguiente operación, aunque los rate limits del proveedor siguen aplicándose.
Usa un webhook con un fallback de polling cuando la entrega entrante sea práctica y los eventos frecuentes lo justifiquen; de lo contrario, haz polling con tu propia cadencia, concurrencia y timeout.
Cómo construir el flujo híbrido para trabajos de medios
Una integración híbrida trata los callbacks como avisos para verificar el trabajo, no como la única prueba de que el trabajo existe. La identidad de tarea persistente conecta la solicitud inicial, la notificación entrante, las comprobaciones de recuperación y el resultado final para el cliente.
Utilizamos el seguimiento de tareas asíncronas y los callbacks de webhook para mantener en marcha los flujos de trabajo de medios de alto volumen. Para los trabajos de imagen y video, ese seguimiento significa que una interrupción en un vendedor no hace que se pierda el trabajo del cliente.
El flujo de trabajo mantiene la presentación, la notificación y la recuperación del estado por separado.
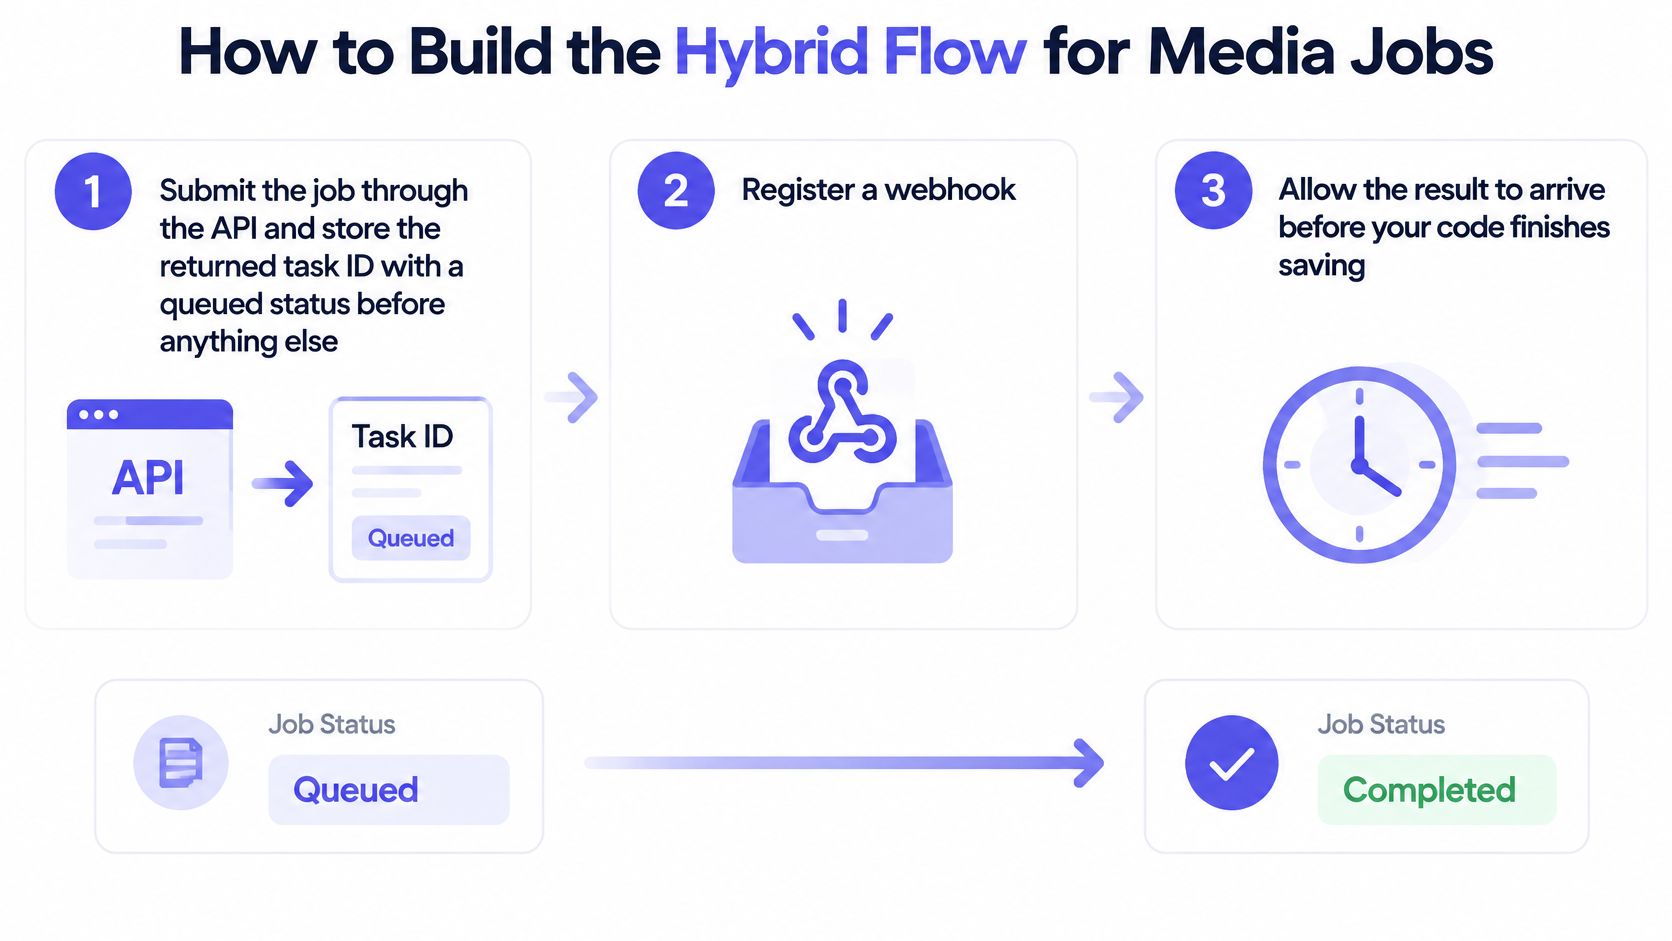
Establecer la propiedad duradera de la tarea
Envía a través de la API y guarda el ID de tarea devuelto. Persístelo con un estado de 'en cola' antes de iniciar el trabajo posterior. Crea un registro de envío local de antemano siempre que sea posible, porque un callback rápido puede adelantarse a la respuesta de envío. El error común es asumir que los callbacks siempre llegan después de la confirmación de la base de datos. Retén los eventos no coincidentes para su posterior asociación.
Registra un receptor que ponga en cola de forma duradera los eventos aceptados. Mantén el request handler pequeño y acusa recibo rápidamente después de una aceptación segura. No devuelvas el éxito antes del almacenamiento, y no descargues ni transformes el activo finalizado dentro del handler.
Verifica la autenticidad y luego deduplica el procesamiento. La verificación de la firma debe ocurrir en el ingress antes de que un evento sea confiable o reconocido; el worker luego verifica la identidad del evento persistente antes de aplicar los efectos. El error común es tratarlos como una limpieza opcional después del procesamiento. Mantén el estado de aceptación y procesamiento separados para que un worker interrumpido pueda reanudarse de forma segura.
Converger en la finalización autorizada
Obtén el estado autorizado de la tarea. Usa el ID de tarea guardado antes de marcar el trabajo del cliente como completado. Un evento puede contener solo un identificador, y una notificación retrasada puede describir una transición anterior. Para una implementación de edición de imágenes, la guía de la API de edición de fotos proporciona un flujo de trabajo de solicitud concreto sobre el cual construir.
Sondea las tareas que permanecen pendientes más allá de su ventana esperada. Usa backoff, jitter y un recuento máximo de intentos para cada ciclo de verificación. No reenvíes ciegamente la generación cuando falte un callback, porque la tarea original ya podría estar completa.
Establece una fecha límite de aplicación y concilia las tareas obsoletas diariamente. Distingue una generación fallida de un fallo en la verificación de estado. Si el estado del proveedor sigue siendo desconocido en tu fecha límite, registra un resultado explícito de recuperación o fallo en lugar de dejar la interfaz del cliente en cola indefinidamente.
Verificación de estado: Cada ID de tarea guardado debe conducir a un resultado de aplicación terminal, completo o fallido, dentro de tu tiempo de espera (timeout). Mantén el estado del proveedor no resuelto visible para los operadores para que un tiempo de espera de la aplicación no abandone un resultado que aún necesita recuperación.
Elige por Carga de Trabajo y Restricción
Comienza con la carga de trabajo, luego rechaza cualquier patrón que tu despliegue no pueda soportar. El mecanismo de notificación más rápido no ayudará si el cliente receptor no puede aceptar solicitudes entrantes o el equipo no puede recuperar el procesamiento interrumpido.
Mapeo de carga de trabajo a patrón
| Carga de trabajo | Patrón recomendado | Razón principal |
|---|---|---|
| Generación de texto corto o respuesta de codificación | API síncrona con streaming | Se necesita una respuesta rápidamente |
| Trabajo de imagen, video, música o voz | Enviar vía API, webhook al finalizar, sondeo de respaldo | El tiempo de finalización es impredecible |
| Cliente móvil o de navegador sin endpoint público | Sondeo | No puede aceptar llamadas entrantes iniciadas por el proveedor |
| Relleno o conciliación de registros pasados | Llamadas a la API de lista | Necesita estado actual e histórico |
| Fuente de eventos de alto volumen como el estado de un pedido | Webhook con consumidor idempotente y conciliación | Apropiado cuando la tasa de eventos está muy por debajo de la tasa de sondeo propuesta |
Un navegador aún puede recibir actualizaciones de la aplicación a través de su propio backend, pero ese backend es el propietario del receptor del webhook. No coloques credenciales del proveedor ni secretos de verificación de callback en el navegador para eludir esa responsabilidad.
La carga de trabajo y la restricción de despliegue deben evaluarse conjuntamente.
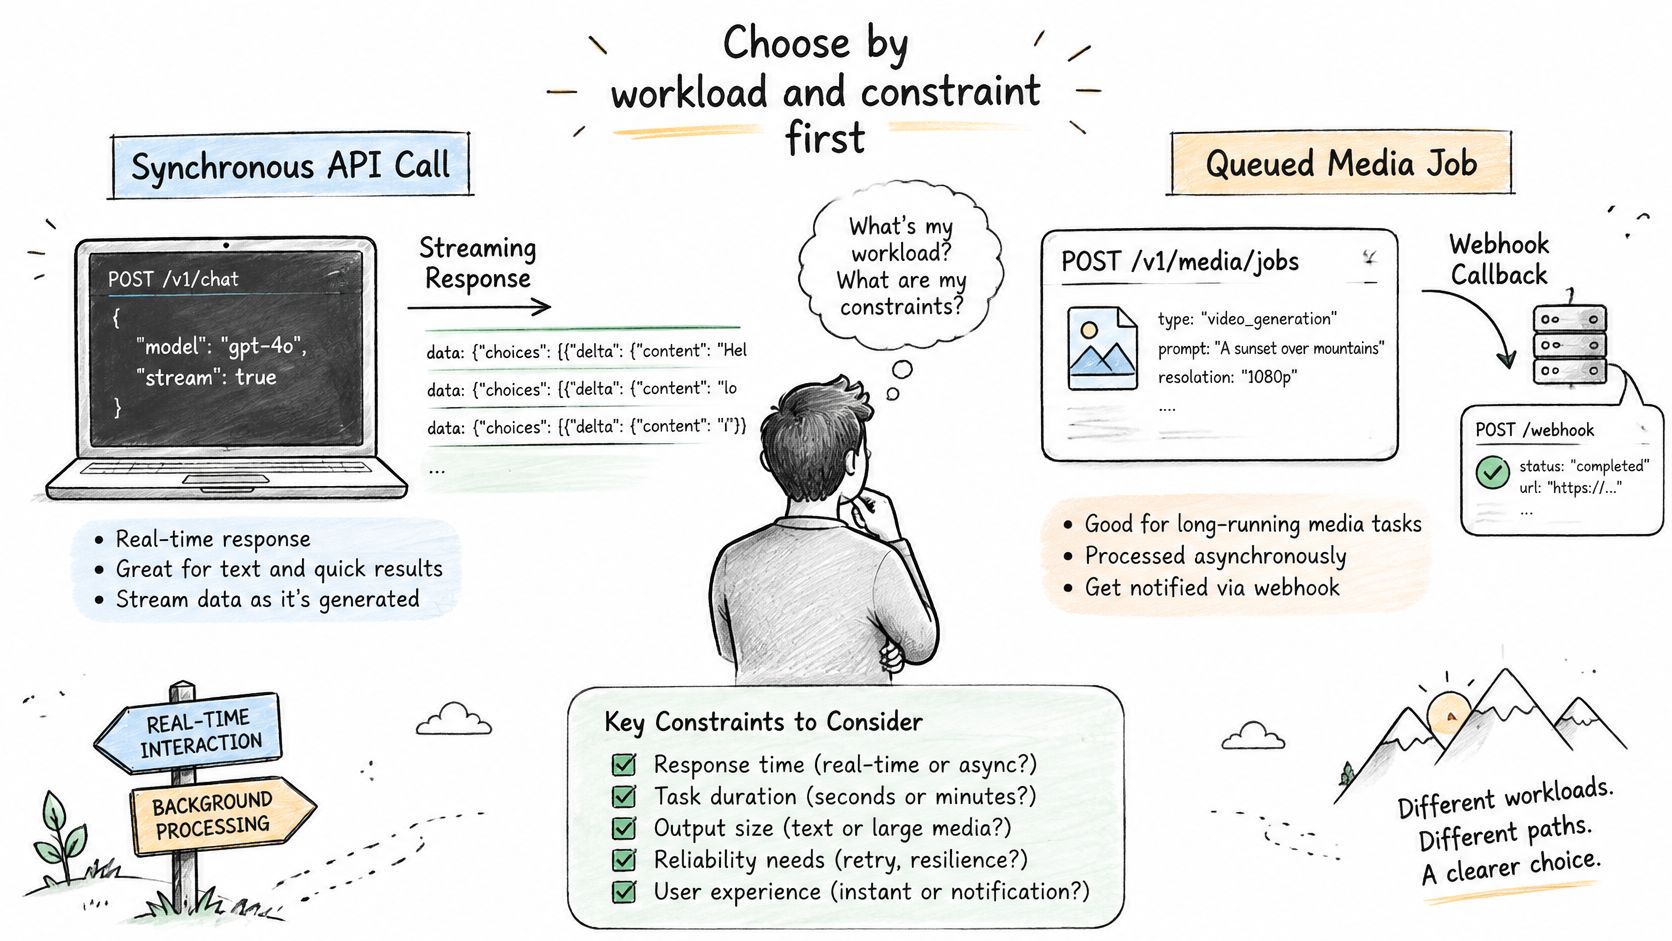
Usa el costo operativo total como desempate
Un análisis citado en el artículo sobre arquitectura de webhooks de Xictron encontró que solo 1.5% de 30 millones de solicitudes de sondeo devolvieron una actualización. Esto ilustra cómo un sondeo mal ajustado puede desperdiciar tráfico, no que cada integración de webhook costará menos.
Compara el intervalo de sondeo, la frecuencia de eventos, el tamaño de la carga útil y los límites del proveedor con el alojamiento del receptor, el almacenamiento en cola, la monitorización y la respuesta a incidentes. También cuenta las lecturas de la API que tu trabajador de webhook aún necesita. Una notificación ligera seguida de una recuperación autorizada no es una arquitectura sin solicitudes.
Para una aplicación multiproveedor, inspecciona la consistencia del esquema de eventos y el comportamiento de respaldo. Normalizar el estado de la tarea en tu propio modelo de aplicación puede importar más que pequeñas diferencias en la velocidad de notificación.
Regla de selección: Prefiere la ruta principal más simple que cumpla con el requisito de cara al usuario, luego financia la ruta de recuperación antes de optimizar la latencia.
Usa una API cuando la aplicación necesite una respuesta a una solicitud. Usa webhooks cuando deba reaccionar a cambios y pueda operar un receptor seguro y duradero. Agrega verificaciones de estado independientes para trabajos de larga duración y mantén el sondeo controlado por el consumidor cuando la entrega entrante no sea posible.
Antes de la implementación, anota tu tasa de eventos esperada por recurso, si puedes exponer un endpoint estable y cómo manejarás el procesamiento duplicado. Luego, haz una solicitud de API simple y verifica que puedes guardar y recuperar la tarea resultante antes de agregar callbacks.
UberLLM ofrece todos los modelos a través de una única API key y acepta los formatos de cable de OpenAI y Anthropic, por lo que los clientes existentes pueden usar la base URL y las credenciales apropiadas. Para flujos de trabajo de imagen y video, elige el sondeo de tareas o la notificación por webhook cuando el resultado esté listo. Visita UberLLM para probar la ruta de solicitud, luego agrega las rutas de finalización y recuperación que tu aplicación necesita.