Webhook vs API : Push, Polling et quand utiliser chacun
Webhook vs API comparés sur la direction, le trafic, la fiabilité et le coût, avec quand utiliser chacun et comment les combiner pour les tâches média d'IA asynchrones.
L'avis répandu sur webhook vs API est incomplet : utilisez les webhooks pour les mises à jour en temps réel et les API pour tout le reste. Cela omet la partie la plus difficile. Un récepteur de webhook est un consommateur de messages asynchrone, et choisir la livraison push signifie accepter la responsabilité des doublons, des notifications manquées, de l'authentification et de la récupération. La comparaison utile n'est pas push versus pull. C'est l'économie du trafic contre le contrôle opérationnel, avec une voie de récupération pour le canal défaillant.
Table des matières
- Webhook vs API en un coup d'œil
- Comment chaque modèle déplace les données
- Compromis de fiabilité à prendre en compte lors de la conception
- Quand le polling est le choix le plus sûr
- Comment construire le flux hybride pour les tâches média
- Choisir en fonction de la charge de travail et des contraintes
Webhook vs API en un coup d'œil
| Critère | API (requête-réponse ou interrogation) | Webhook (notification push) |
|---|---|---|
| Direction | Le client envoie une requête, le serveur répond | Le fournisseur envoie une requête HTTP à l'URL du client |
| Qui initie | Le client | Le fournisseur, lorsqu'un événement se produit |
| Moment | Lorsque le client le demande | Lorsque l'événement se produit |
| Idéal pour | État actuel, historique, rattrapages (backfills), réconciliation | Notifier les applications lorsque l'état change ou qu'une tâche est terminée |
| Besoins du client | Accès HTTP sortant uniquement | Point de terminaison HTTPS public, vérification de signature, stockage |
| Livraison | Réponse directe à chaque requête, si le transport réussit | Normalement, livraison au moins une fois avec des tentatives limitées, doublons et réordonnancement possibles |
| Récupération après échec | Le client réessaie et vérifie à nouveau | Le fournisseur réessaie ; le consommateur déduplique et réconcilie via l'API |
| Modèle de coût | Le trafic augmente avec la fréquence d'interrogation | Le trafic augmente avec le volume d'événements |
Un webhook est un mécanisme de livraison d'événements basé sur les API HTTP, et non un remplacement pour celles-ci. La plupart des intégrations en production ont besoin des deux : un chemin de requête pour les commandes et les lectures faisant autorité, plus un chemin de notification pour les changements.
Supposons que votre application soumette une tâche de génération de vidéo. Avec une API, votre backend envoie une requête GET en utilisant l'identifiant de tâche enregistré et reçoit le statut actuel de la tâche. Votre application choisit quand demander, combien de temps attendre et que faire si la requête échoue.
Avec un webhook, le fournisseur envoie un événement de fin de tâche à un endpoint que vous avez enregistré. Votre backend accepte cette notification et planifie l'action suivante, comme la récupération de l'actif terminé. La session de navigateur originale n'a pas besoin de rester connectée.
Séparer la commande de la notification
Soumettre du travail et apprendre qu'il est terminé sont des opérations différentes. Une API peut accepter une tâche immédiatement sans maintenir la connexion ouverte jusqu'à ce que le calcul sous-jacent soit terminé. Un webhook fournit alors un signal de complétion distinct.
Cette distinction prévient une erreur de conception courante : traiter chaque opération asynchrone comme une requête HTTP qui doit rester ouverte. Elle prévient également l'erreur inverse, essayer d'utiliser les notifications d'événements comme un enregistrement complet de l'état actuel.
Première décision : Votre application doit-elle réagir lorsque quelque chose change, ou n'a-t-elle besoin de la réponse que lorsque quelqu'un la demande ?
Si un utilisateur ouvre un écran d'historique des tâches, récupérez les enregistrements actuels. Si une tâche terminée doit déclencher la livraison d'un actif alors que personne ne regarde cet écran, utilisez un chemin basé sur les événements (event-driven path). Aucun des deux modèles n'élimine la nécessité de gérer les pannes réseau, mais chacun place l'appelant dans une position différente pour récupérer.
Comment chaque modèle déplace les données
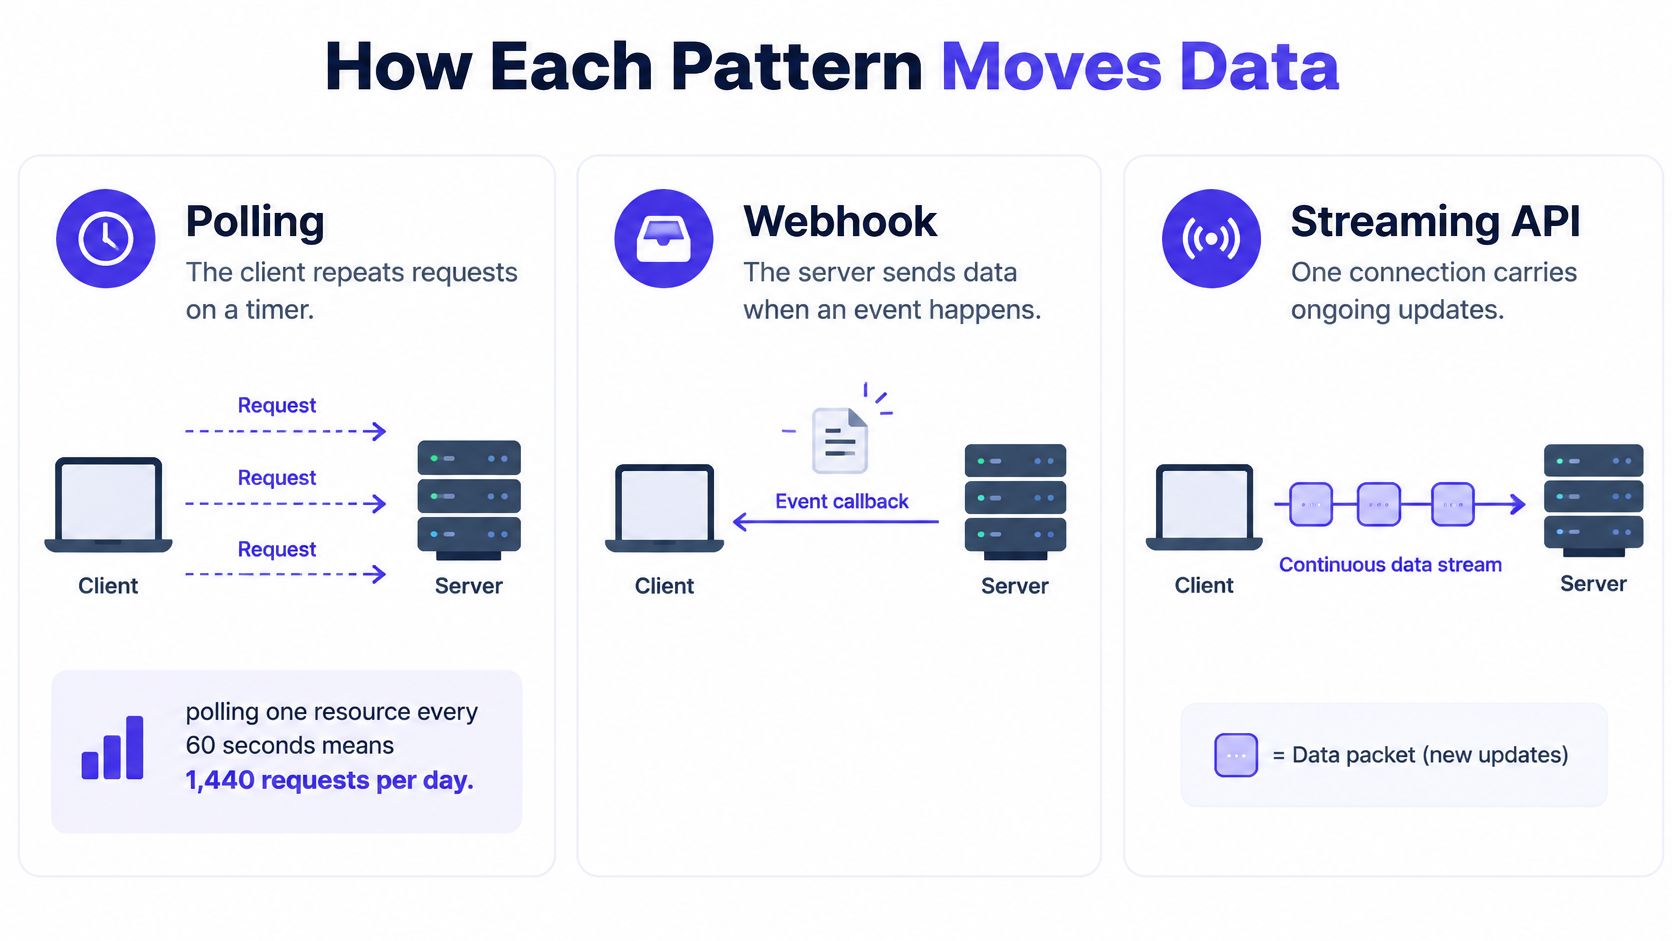
Avec le polling, le client répète une requête de statut selon un minuteur, que quelque chose ait changé ou non. Avec un webhook, le fournisseur initie une requête après un événement, de sorte que le trafic de notification suit l'activité plutôt que l'horloge.
Le guide Nylas sur les webhooks versus le polling donne des exemples de trafic sous-jacents : le polling d'une ressource toutes les 60 secondes signifie 1,440 requêtes par jour, tandis que sa comparaison de 10,000 comptes produit 2.88 millions de requêtes de polling quotidiennes contre environ 500,000 livraisons de webhooks.
Trafic et latence par intervalle de polling et taux d'événements
| Scénario | Requêtes ou livraisons par jour | Latence de détection |
|---|---|---|
| Polling d'une ressource toutes les 60 secondes | 1,440 requêtes | 30 secondes en moyenne |
| Polling d'une ressource toutes les 5 minutes | 288 requêtes, calculées à partir de l'intervalle | 2.5 minutes en moyenne |
| 10,000 comptes en polling toutes les 5 minutes | 2.88 millions de requêtes | 2.5 minutes en moyenne |
| 10,000 comptes recevant environ 50 notifications d'événements chacun | Environ 500,000 livraisons | Temps de dispatch de l'événement plus tout délai de retry |
| Réponse texte streamed token par token | Une requête par génération | Les tokens arrivent au fur et à mesure de leur génération |
Les moyennes de polling supposent que les changements se produisent indépendamment du calendrier de polling. Elles décrivent l'attente jusqu'à la prochaine vérification, et non le temps que le fournisseur passe à effectuer le travail.
L'intervalle plus court améliore le temps de découverte en dépensant plus de requêtes. L'intervalle plus long réduit le trafic mais laisse le travail terminé non découvert. À l'échelle d'un compte, même un calendrier modeste crée un trafic substantiel car chaque compte inactif est toujours vérifié.
La livraison par webhook supprime ce calendrier de vérification fixe, mais le nombre de livraisons n'est pas une facture d'infrastructure complète. Les recherches API après les notifications, les retries de livraison, le stockage du récepteur et l'exécution des workers consomment toujours des ressources.
Ce sont des modèles de communication distincts, pas des étiquettes interchangeables.
Le streaming résout un problème différent
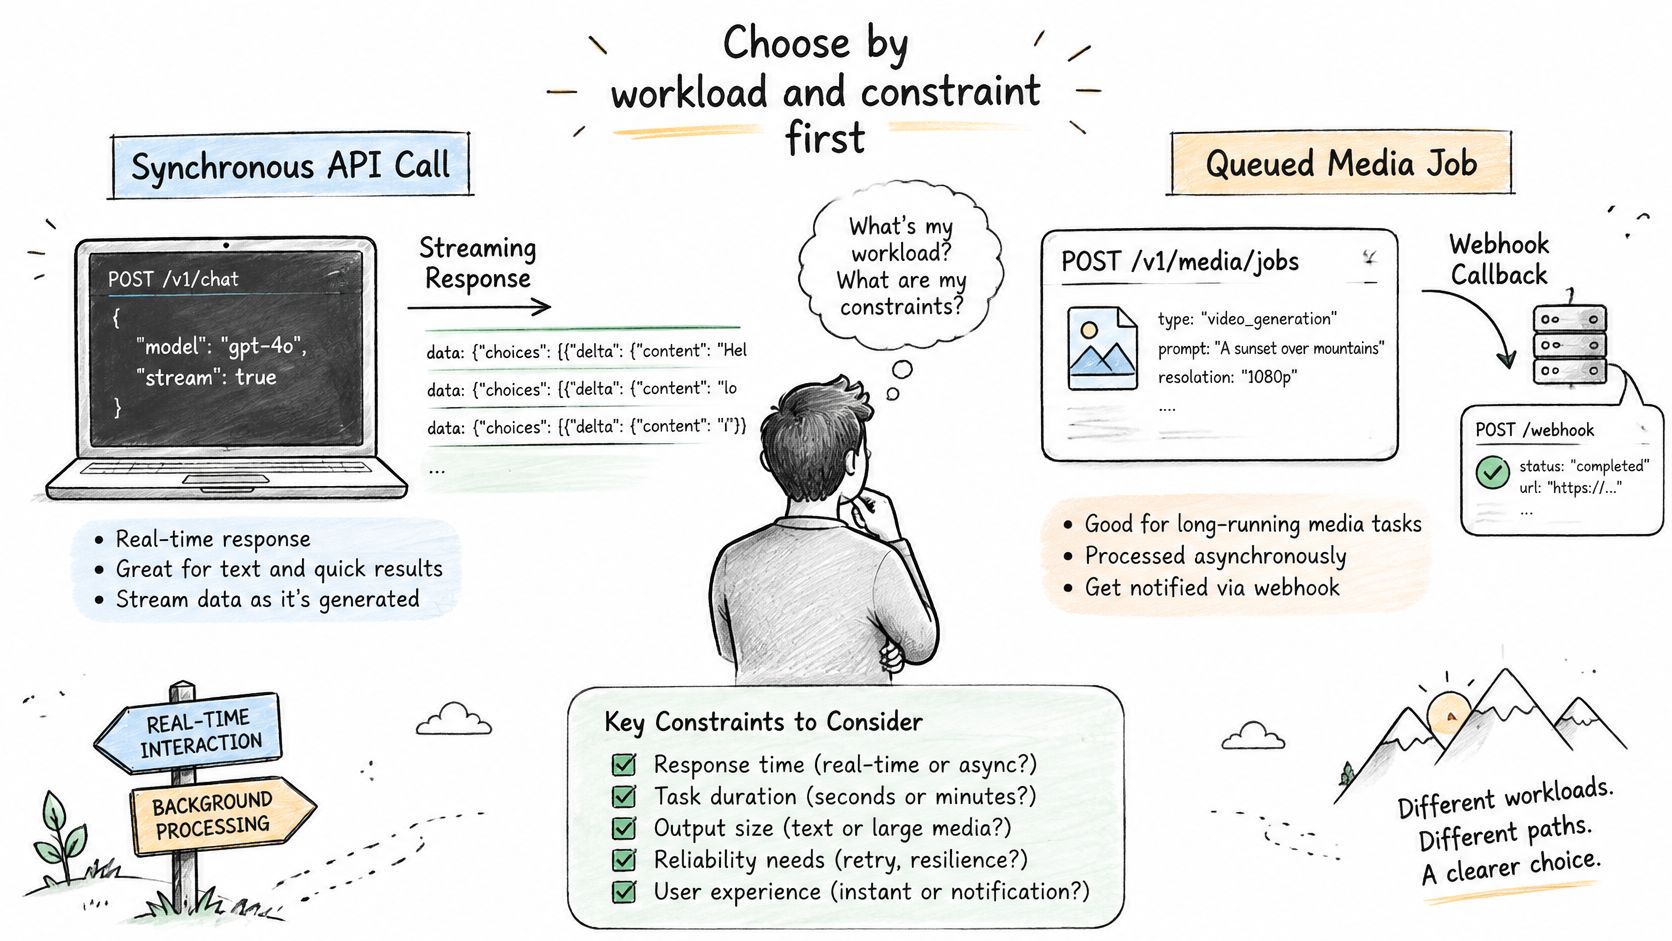
Une réponse texte en streaming maintient la requête ouverte et renvoie les tokens au fur et à mesure de leur génération. Pour un assistant de codage interactif, le temps jusqu'au premier token et la continuité de la sortie importent plus que la réception d'un callback de complétion séparé.
Nos réponses texte sont streamées token par token, tandis que les tâches d'image et de vidéo renvoient une tâche que vous pouvez interroger (poll) ou pour laquelle vous recevez une notification webhook lorsqu'elle est prête. La documentation de l'API média est le point de départ pour implémenter ce chemin de requête orienté tâche.
Estimez votre taux d'événements par ressource avant de choisir un intervalle de polling. Une ressource inactive et une ressource en constante évolution ne devraient pas automatiquement partager le même calendrier.
Pour le polling, des intervalles plus courts échangent plus de trafic contre moins de délai de détection. Les webhooks évitent cet échange particulier, mais le remplacent par le coût d'exploitation d'un récepteur fiable.
Compromis de fiabilité à prendre en compte dans votre conception
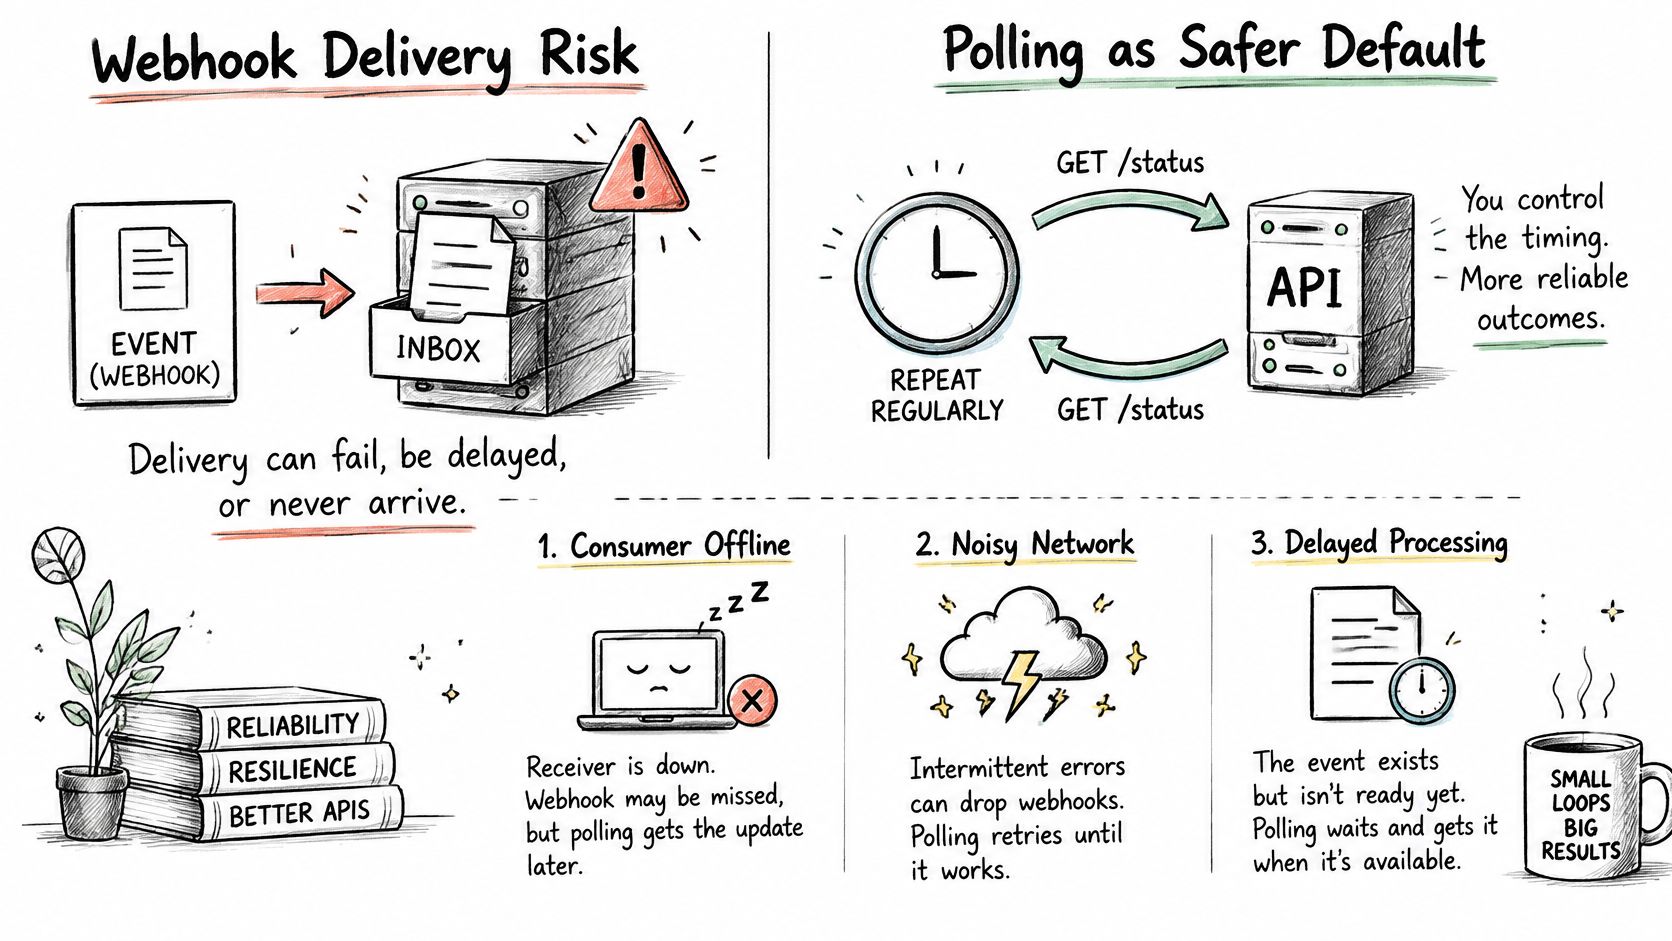
La livraison de webhooks est normalement au moins une fois, pas exactement une fois. Cela décrit le modèle de livraison, pas une promesse qu'un fournisseur réessayera indéfiniment. Des tentatives limitées peuvent toujours aboutir à un événement non livré, alors concevez le récepteur pour le pire cas plutôt que pour le scénario idéal.
Un timeout n'informe en rien l'expéditeur de ce qui s'est passé en aval. Votre récepteur pourrait enregistrer l'événement dans le stockage, puis perdre l'accusé de réception sur le réseau. Lorsque l'expéditeur réessaie, votre application reçoit le même événement à nouveau et doit l'absorber avec élégance.
Associez chaque défaillance à une protection
- Livraison en double : Stockez un identifiant d'événement stable sous une contrainte d'unicité. Lorsque les fournisseurs distinguent les événements des tentatives de livraison, dédupliquez le traitement métier par identité d'événement, et non par identité de tentative.
- Effets secondaires répétés : Rendez la publication d'actifs, les mises à jour de comptes et les notifications clients idempotentes. La déduplication de l'entrée ne sert à rien pour un worker qui plante après avoir effectué une action mais avant d'enregistrer le succès.
- Événements désordonnés : Vérifiez l'état faisant autorité ou une version de ressource documentée avant d'appliquer une transition. Un événement de "traitement" retardé ne doit jamais écraser une tâche terminée.
- Traitement lent : Vérifiez, acceptez durablement et accusez réception de l'événement avant de confier un travail coûteux à un worker de file d'attente.
Les politiques de réessai des fournisseurs ne sont pas interchangeables. La documentation des webhooks Supabase exige une réponse 2xx dans les 20 secondes, utilise un backoff exponentiel et s'arrête après cinq tentatives échouées. Le guide des garanties de livraison Svix documente la tentative initiale de Dynamic plus cinq réessais sur environ une journée, ainsi que les règles de réessai spécifiques au statut de Glean.
Comportement de réessai des webhooks documenté par fournisseur
| Fournisseur | Ce qui compte comme succès | Comportement de réessai |
|---|---|---|
| Supabase | Réponse 2xx dans les 20 secondes | Backoff exponentiel, s'arrête après cinq tentatives échouées |
| Dynamic | Réponse 2xx | Tentative initiale plus cinq réessais sur environ une journée |
| Glean | Réponse 2xx | Réessais en cas d'échecs de connexion, de timeouts, 408, 429 et 5xx ; les autres réponses non--2xx sont terminales |
L'accusé de réception est une limite de durabilité
Retourner un succès avant un stockage durable crée une fenêtre de perte : l'expéditeur arrête de réessayer, mais votre application n'a rien de récupérable. Retourner un succès seulement après le traitement des médias crée le problème inverse : des timeouts inutiles et des livraisons en double. Accusez réception de l'acceptation durable, pas du travail métier terminé.
La vérification de la signature doit précéder la confiance accordée à la charge utile. Préservez le corps de la requête brut lorsque le schéma de signature l'exige, et suivez la procédure de vérification documentée par le fournisseur plutôt que de signer un objet resérialisé.
Ajoutez une gestion des lettres mortes (dead-letter handling) pour les réessais de workers épuisés et une observabilité de la livraison qui connecte les IDs d'événement, les IDs de tâche, les échecs d'accusé de réception et les résultats de traitement. Pour la partie de polling du même workflow, classez les échecs avec les codes de statut retournés : l'API d'UberLLM refuse les appels avec des codes d'erreur tels que 402, 404, 429 et 503, ce qui permet à un travail de réconciliation de séparer un refus de facturation d'un étranglement (throttling) ou d'un vendeur temporairement indisponible.
Un polling manqué est récupéré en vérifiant à nouveau. Un webhook manqué nécessite une autre livraison ou un passage de réconciliation indépendant qui relit le statut de tâche faisant autorité selon un calendrier. Construisez ce passage que vous exposiez ou non un récepteur ; c'est ce qui transforme la livraison "au moins une fois" en un traitement effectif "exactement une fois".
Quand le Polling est le Choix le Plus Sûr
Les webhooks sont un problème de fiabilité de livraison, pas seulement une API plus rapide. Si votre application ne peut pas prendre en charge le contrat de réception, le polling peut être le choix le plus fiable.
La différence opérationnelle est la plus facile à voir à la limite du consommateur.
Un agent de bureau, un outil interne derrière un pare-feu, ou un runner CI éphémère peuvent avoir un accès sortant sans adresse entrante stable. Faire en sorte que ces clients reçoivent des callbacks peut nécessiter un service hébergé supplémentaire, une authentification entre les composants, et un transfert durable vers l'appelant d'origine. C'est de l'infrastructure, pas un changement de configuration mineur.
Reconnaître les contraintes qui favorisent le polling
- Pas de point de terminaison public stable : Maintenez la communication sortante au lieu d'exposer un environnement de développement temporaire.
- Pas de consommateur d'événements durable : Interrogez le statut faisant autorité pendant que vous construisez un stockage et un traitement sécurisés. Un récepteur qui oublie les événements acceptés n'est pas une amélioration.
- Récupération contrôlée par le consommateur : Planifiez les vérifications selon vos propres limites de concurrence, fenêtres de maintenance et délais d'application.
Supposons qu'un outil de build sur l'ordinateur portable d'un développeur soumette une tâche média à distance. Il peut vérifier périodiquement jusqu'à l'achèvement, s'arrêter lorsque le développeur annule, et reprendre à partir de l'identifiant de tâche enregistré. Pour un petit nombre de tâches actives, cela peut être plus simple et moins cher que de maintenir un récepteur toujours disponible.
Le polling nécessite toujours de la discipline. Reculez en cas d'échecs transitoires, évitez de synchroniser les vérifications de chaque client, et arrêtez de vérifier les tâches terminales. Une tempête de réessais est également possible avec les requêtes sortantes.
La vidéo d'accompagnement offre une autre façon de visualiser la distinction entre requête et callback.
Choisissez le modèle que votre consommateur peut récupérer de manière fiable, pas le modèle avec la démonstration réussie la plus rapide.
Le trafic webhook entrant ajoute la sécurité des points de terminaison, les vérifications de signature, la mise en file d'attente, la suppression des doublons et les exigences de disponibilité. Le polling vous donne un contrôle explicite sur le moment où la prochaine opération se produit, bien que les limites de débit du fournisseur s'appliquent toujours.
Utilisez un webhook avec un mécanisme de repli (fallback) par polling lorsque la livraison entrante est pratique et que des événements fréquents le justifient ; sinon, faites du polling avec votre propre cadence, concurrence et délai d'attente (timeout).
Comment créer le flux hybride pour les tâches multimédias
Une intégration hybride traite les callbacks comme des invites pour vérifier le travail, et non comme la seule preuve de son existence. L'identité de tâche persistante relie la requête initiale, la notification entrante, les vérifications de récupération et le résultat final pour le client.
Nous utilisons le suivi asynchrone des tâches et les callbacks de webhook pour assurer le bon déroulement des flux de travail multimédias à volume élevé. Pour les tâches d'images et de vidéos, ce suivi signifie qu'une interruption chez un vendeur ne fait pas perdre la tâche du client.
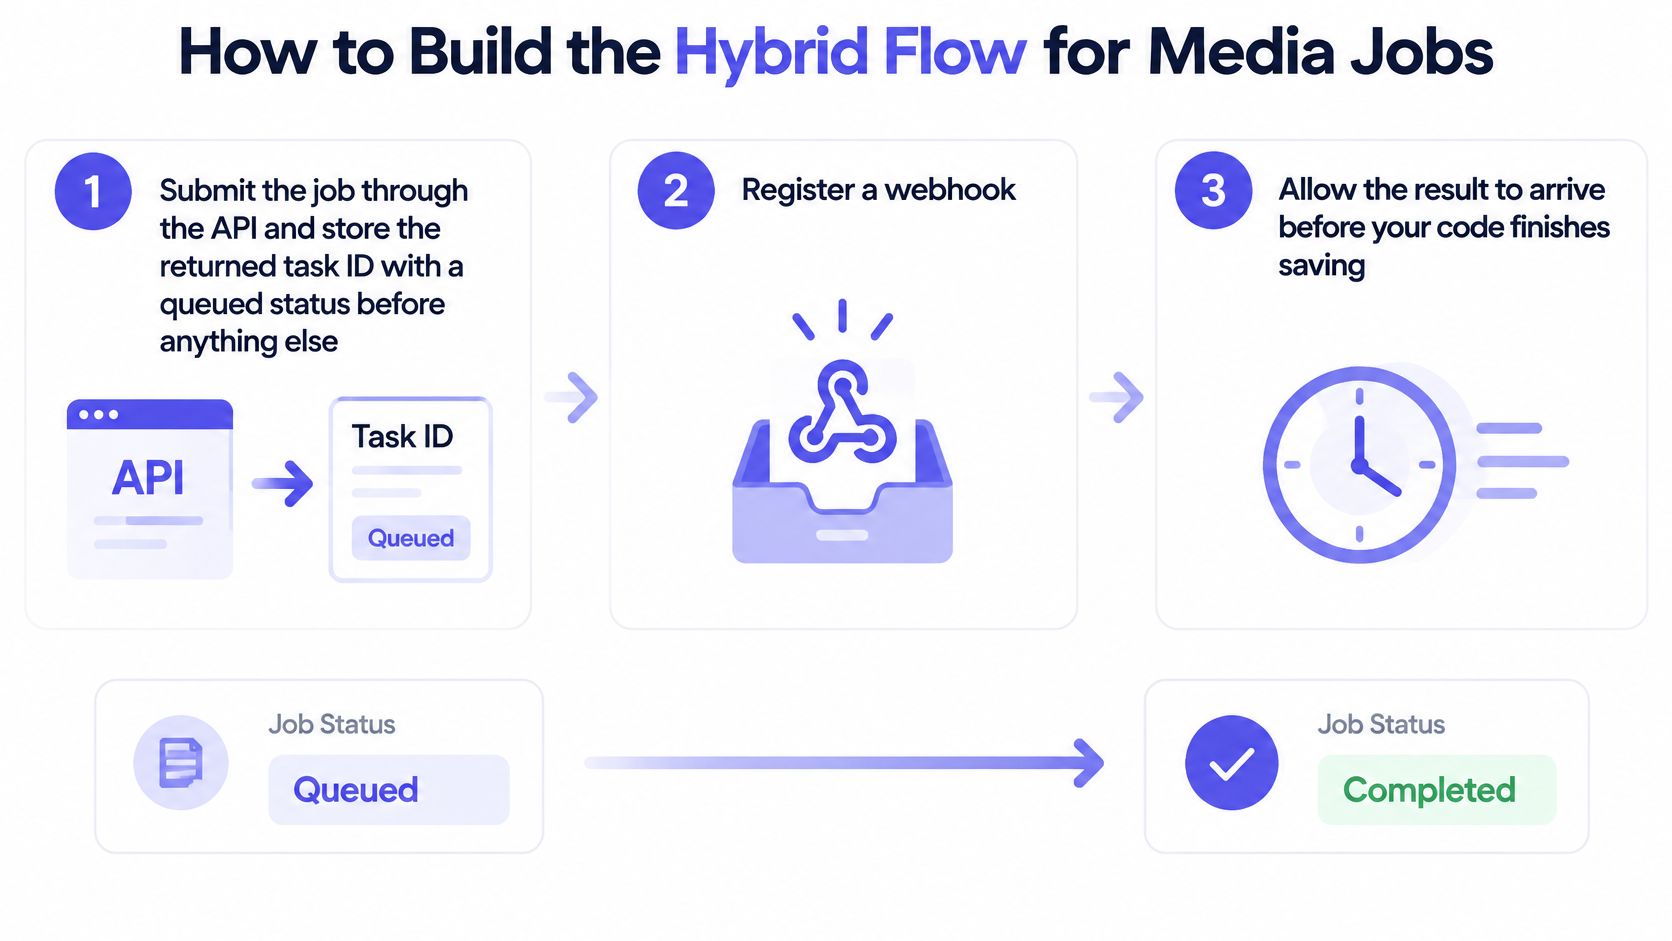
Le flux de travail maintient la soumission, la notification et la récupération du statut séparées.
Établir la propriété durable de la tâche
Soumettez via l'API et enregistrez l'ID de tâche retourné. Persistez-le avec un statut 'en file d'attente' avant de commencer le travail en aval. Créez un enregistrement de soumission local au préalable lorsque c'est possible, car un callback rapide peut devancer la réponse de soumission. L'erreur courante est de supposer que les callbacks arrivent toujours après le database commit. Conservez les événements non appariés pour une association ultérieure.
Enregistrez un récepteur qui met durablement en file d'attente les événements acceptés. Gardez le request handler petit et accusez réception rapidement après une acceptation sécurisée. Ne renvoyez pas de succès avant le stockage, et ne téléchargez ni ne transformez l'actif terminé à l'intérieur du handler.
Vérifiez l'authenticité, puis dédupliquez le traitement. La vérification de la signature doit avoir lieu à l'ingress avant qu'un événement ne soit approuvé ou accusé de réception ; le worker vérifie ensuite l'identité de l'événement persistante avant d'appliquer les effets. L'erreur courante est de les traiter comme un nettoyage facultatif après le traitement. Gardez les statuts d'acceptation et de traitement séparés afin qu'un worker interrompu puisse reprendre en toute sécurité.
Converger vers l'achèvement faisant autorité
Récupérez le statut faisant autorité de la tâche. Utilisez l'ID de tâche enregistré avant de marquer la tâche client comme terminée. Un événement peut ne contenir qu'un identifiant, et une notification retardée peut décrire une transition plus ancienne. Pour une implémentation d'édition d'images, le guide de l'API d'édition de photos fournit un flux de travail de requête concret sur lequel s'appuyer.
Interrogez les tâches qui restent en attente au-delà de leur fenêtre prévue. Utilisez le backoff, le jitter et un nombre maximal de tentatives pour chaque cycle de vérification. Ne soumettez pas aveuglément une nouvelle génération lorsqu'un callback est manquant, car la tâche originale peut déjà être terminée.
Définissez une date limite d'application et réconciliez les tâches obsolètes quotidiennement. Distinguez une génération échouée d'un échec de vérification de statut. Si l'état du fournisseur reste inconnu à votre date limite, enregistrez un résultat de récupération ou d'échec explicite plutôt que de laisser l'interface client en file d'attente indéfiniment.
Vérification de l'état de santé : Chaque ID de tâche enregistré doit aboutir à un résultat d'application terminal, complet ou échoué, dans les délais impartis. Gardez l'état du fournisseur non résolu visible pour les opérateurs afin qu'un timeout d'application n'abandonne pas un résultat qui nécessite encore une récupération.
Choisir par Charge de Travail et Contrainte
Commencez par la charge de travail, puis rejetez tout modèle que votre déploiement ne peut pas prendre en charge. Le mécanisme de notification le plus rapide ne sera d'aucune utilité si le client récepteur ne peut pas accepter les requêtes entrantes ou si l'équipe ne peut pas récupérer un traitement interrompu.
Correspondance charge de travail / modèle
| Charge de travail | Modèle recommandé | Raison principale |
|---|---|---|
| Génération de texte court ou réponse de codage | API synchrone avec streaming | Une réponse nécessaire rapidement |
| Tâche d'image, vidéo, musique ou parole | Soumettre via API, webhook à la fin, repli par polling | Le temps d'achèvement est imprévisible |
| Client mobile ou navigateur sans endpoint public | Polling | Ne peut pas accepter les appels entrants initiés par le fournisseur |
| Remplissage ou réconciliation d'enregistrements passés | Appels de liste API | Nécessite l'état actuel et historique |
| Flux d'événements à volume élevé tel que le statut de commande | Webhook avec consommateur idempotent et réconciliation | Approprié lorsque le taux d'événements est bien inférieur au taux de polling proposé |
Un navigateur peut toujours recevoir des mises à jour d'application via son propre backend, mais ce backend est propriétaire du récepteur de webhook. Ne placez pas les identifiants du fournisseur ou les secrets de vérification de rappel dans le navigateur pour contourner cette responsabilité.
La charge de travail et la contrainte de déploiement doivent être évaluées ensemble.
Utiliser le coût total d'exploitation comme critère de départage
Une analyse citée dans l'article sur l'architecture de webhook de Xictron a révélé que seulement 1.5% des 30 millions de requêtes de polling ont renvoyé une mise à jour. Cela illustre à quel point un polling mal réglé peut gaspiller du trafic, et non que chaque intégration de webhook coûtera moins cher.
Comparez l'intervalle de polling, la fréquence des événements, la taille de la charge utile et les limites du fournisseur par rapport à l'hébergement du récepteur, le stockage de la file d'attente, la surveillance et la réponse aux incidents. Comptez également les lectures API dont votre worker de webhook a encore besoin. Une notification légère suivie d'une récupération faisant autorité n'est pas une architecture sans requêtes.
Pour une application multi-fournisseurs, examinez la cohérence du schéma d'événements et le comportement de repli. La normalisation du statut des tâches dans votre propre modèle d'application peut être plus importante que de petites différences de vitesse de notification.
Règle de sélection : Préférez le chemin principal le plus simple qui répond aux exigences de l'utilisateur, puis financez le chemin de récupération avant d'optimiser la latence.
Utilisez une API lorsque l'application a besoin d'une réponse à une requête. Utilisez des webhooks lorsqu'elle doit réagir aux changements et peut opérer un récepteur sécurisé et durable. Ajoutez des vérifications de statut indépendantes pour les tâches de longue durée, et maintenez le polling contrôlé par le consommateur lorsque la livraison entrante n'est pas possible.
Avant l'implémentation, notez votre taux d'événements attendu par ressource, si vous pouvez exposer un endpoint stable, et comment vous gérerez le traitement des doublons. Ensuite, faites une simple requête API et vérifiez que vous pouvez enregistrer et récupérer la tâche résultante avant d'ajouter des rappels.
UberLLM propose tous les modèles via une seule API key et accepte les formats filaires d'OpenAI et d'Anthropic, de sorte que les clients existants peuvent utiliser l'API base URL et les identifiants appropriés. Pour les workflows d'image et de vidéo, choisissez le polling de tâche ou la notification par webhook lorsque le résultat est prêt. Visitez UberLLM pour tester le chemin de requête, puis ajoutez les chemins d'achèvement et de récupération dont votre application a besoin.