Webhook vs API: Push, Polling e Quando Usar Cada Um
Webhook vs API comparados em direção, tráfego, confiabilidade e custo, com quando usar cada um e como combiná-los para trabalhos de mídia de IA assíncronos.
O conselho popular sobre webhook vs API está incompleto: use webhooks para atualizações em tempo real e APIs para todo o resto. Isso pula a parte mais difícil. Um receptor de webhook é um consumidor de mensagens assíncronas, e escolher a entrega push significa aceitar a responsabilidade por duplicatas, notificações perdidas, autenticação e recuperação. A comparação útil não é push versus pull. É economia de tráfego versus controle operacional, com um caminho de recuperação para qualquer canal que falhe.
Sumário
- Webhook vs API em um Relance
- Como Cada Padrão Move Dados
- Compromissos de Confiabilidade Que Você Deve Projetar
- Quando o Polling é a Escolha Mais Segura
- Como Construir o Fluxo Híbrido para Trabalhos de Mídia
- Escolha por Carga de Trabalho e Restrição
Webhook vs API: Visão Geral
| Critério | API (requisição-resposta ou polling) | Webhook (notificação push) |
|---|---|---|
| Direção | Cliente envia requisição, servidor responde | Provedor envia requisição HTTP para a URL do cliente |
| Quem inicia | Cliente | Provedor, quando um evento ocorre |
| Momento | Quando o cliente pergunta | Quando o evento ocorre |
| Melhor para | Estado atual, histórico, preenchimento de dados retroativos, reconciliação | Notificar aplicativos quando o estado muda ou um trabalho termina |
| Necessidades do cliente | Acesso HTTP de saída apenas | Endpoint HTTPS público, verificação de assinatura, armazenamento |
| Entrega | Resposta direta a cada requisição, se o transporte for bem-sucedido | Normalmente entrega "pelo menos uma vez" com retentativas limitadas, possíveis duplicatas e reordenação |
| Recuperação de falhas | Cliente tenta novamente e verifica | Provedor tenta novamente; consumidor deduplica e reconcilia através da API |
| Padrão de custo | O tráfego cresce com a frequência de polling | O tráfego cresce com o volume de eventos |
Um webhook é um mecanismo de entrega de eventos construído sobre APIs HTTP, não um substituto para elas. A maioria das integrações em produção precisa de ambos: um caminho de requisição para comandos e leituras autoritativas, além de um caminho de notificação para mudanças.
Digamos que seu aplicativo envie um trabalho de geração de vídeo. Com uma API, seu backend envia uma requisição GET usando o identificador de tarefa salvo e recebe o status atual do trabalho. Seu aplicativo escolhe quando perguntar, quanto tempo esperar e o que fazer se a requisição falhar.
Com um webhook, o provedor envia um evento de "trabalho concluído" para um endpoint que você registrou. Seu backend aceita essa notificação e agenda a próxima ação, como recuperar o ativo finalizado. A sessão original do navegador não precisa permanecer conectada.
Separe o comando da notificação
Enviar um trabalho e saber que ele terminou são operações diferentes. Uma API pode aceitar uma tarefa imediatamente sem manter a conexão aberta até que a computação subjacente termine. Um webhook então fornece um sinal de conclusão separado.
Essa distinção evita um erro de design comum: tratar cada operação assíncrona como uma requisição HTTP que deve permanecer aberta. Também evita o erro oposto, tentar usar notificações de eventos como um registro completo do estado atual.
Primeira decisão: Seu aplicativo precisa reagir quando algo muda, ou ele só precisa da resposta quando alguém pergunta?
Se um usuário abre uma tela de histórico de trabalhos, busque os registros atuais. Se um trabalho concluído deve acionar a entrega de um ativo enquanto ninguém está olhando para essa tela, use um caminho orientado a eventos. Nenhum dos padrões elimina a necessidade de lidar com falhas de rede, mas cada um coloca o chamador em uma posição diferente para se recuperar.
Como Cada Padrão Move Dados
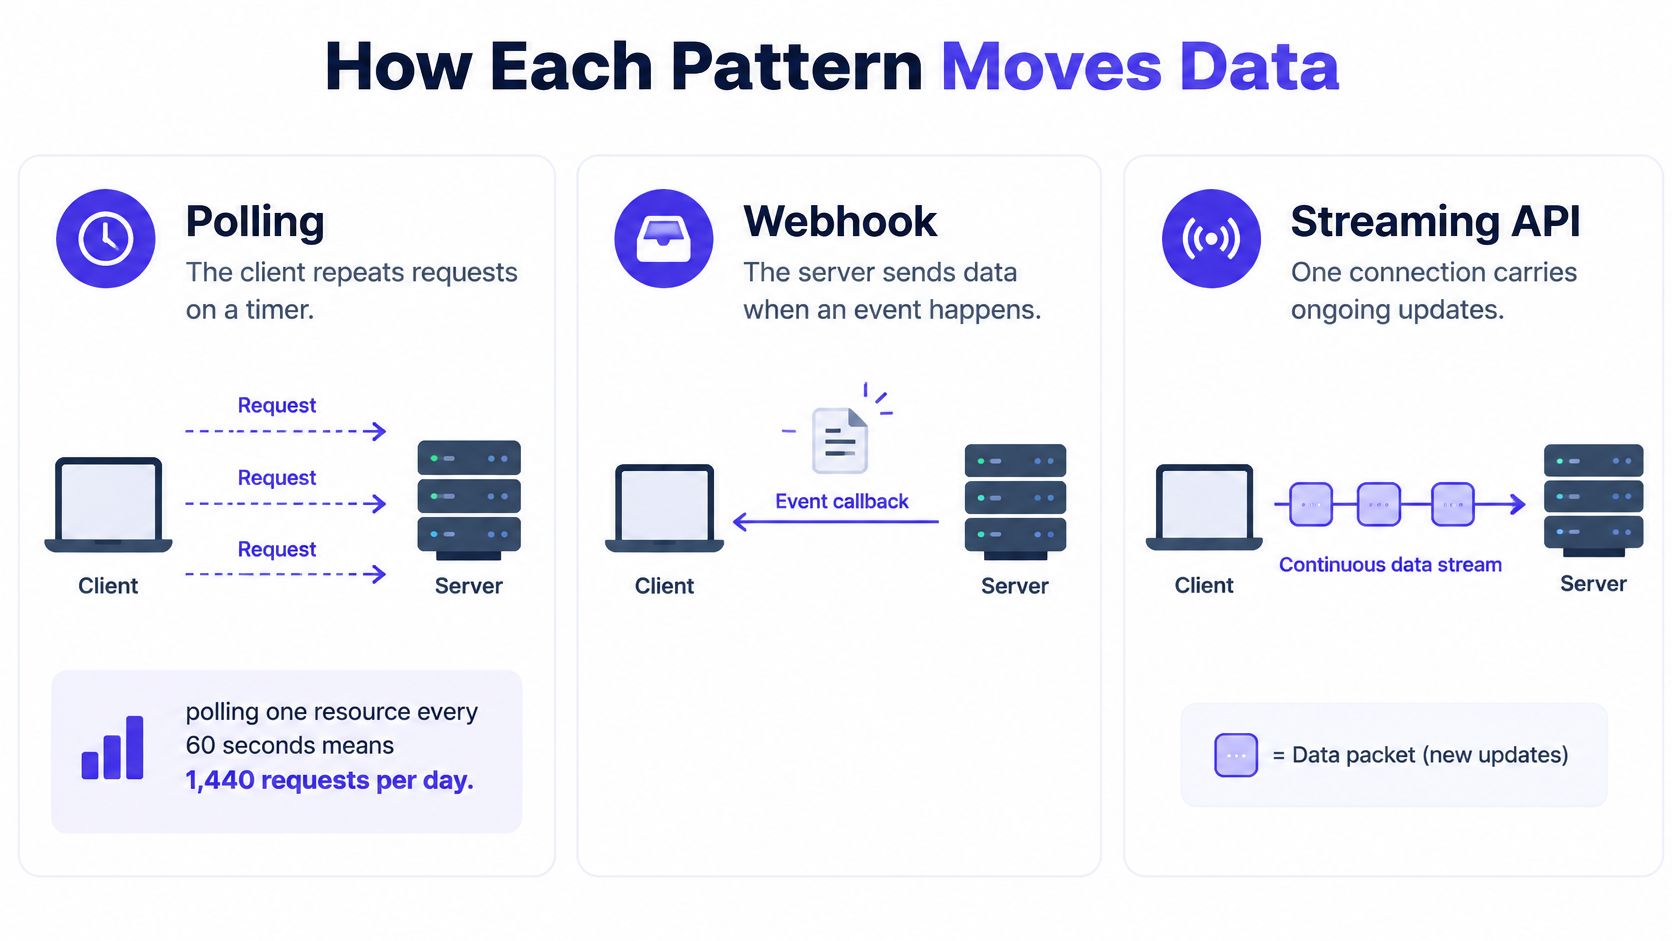
Com polling, o cliente repete uma solicitação de status em um temporizador, independentemente de algo ter mudado ou não. Com um webhook, o provedor inicia uma solicitação após um evento, então o tráfego de notificação segue a atividade em vez do relógio.
O guia Nylas de webhook versus polling fornece os exemplos de tráfego subjacentes: fazer polling de um recurso a cada 60 segundos significa 1,440 solicitações por dia, enquanto sua comparação de 10,000 contas produz 2.88 milhões de solicitações diárias de polling versus aproximadamente 500,000 entregas de webhook.
Tráfego e latência por intervalo de polling e taxa de eventos
| Cenário | Solicitações ou entregas por dia | Latência de detecção |
|---|---|---|
| Fazer polling de um recurso a cada 60 segundos | 1,440 solicitações | 30 segundos em média |
| Fazer polling de um recurso a cada 5 minutos | 288 solicitações, calculadas a partir do intervalo | 2.5 minutos em média |
| 10,000 contas fazendo polling a cada 5 minutos | 2.88 milhões de solicitações | 2.5 minutos em média |
| 10,000 contas recebendo cerca de 50 notificações de eventos cada | Cerca de 500,000 entregas | Tempo de despacho do evento mais qualquer atraso de nova tentativa |
| Resposta de texto transmitida token por token | Uma solicitação por geração | Tokens chegam conforme gerados |
As médias de polling assumem que as mudanças ocorrem independentemente do cronograma de polling. Elas descrevem a espera até a próxima verificação, não o tempo que o provedor gasta realizando o trabalho.
O intervalo mais curto melhora o tempo de descoberta gastando mais solicitações. O intervalo mais longo reduz o tráfego, mas faz com que o trabalho concluído permaneça sem ser descoberto. Em escala de contas, mesmo um cronograma modesto cria um tráfego substancial porque toda conta inativa ainda é verificada.
A entrega de webhook remove esse cronograma de verificação fixo, mas a contagem de entregas não é uma conta de infraestrutura completa. Consultas de API após notificações, novas tentativas de entrega, armazenamento do receptor e execução de workers ainda consomem recursos.
Estes são padrões de comunicação distintos, não rótulos intercambiáveis.
Streaming resolve um problema diferente
Uma resposta de texto em streaming mantém a solicitação aberta e retorna tokens à medida que são gerados. Para um assistente de codificação interativo, o tempo para o primeiro token e a continuidade da saída importam mais do que receber um callback de conclusão separado.
Nossas respostas de texto são transmitidas token por token, enquanto trabalhos de imagem e vídeo retornam uma tarefa que você pode fazer polling ou receber uma notificação de webhook quando estiver pronta. A documentação da API de mídia é o ponto de partida para implementar esse caminho de solicitação orientado a tarefas.
Estime sua taxa de eventos por recurso antes de escolher um intervalo de polling. Um recurso inativo e um recurso em constante mudança não devem compartilhar automaticamente o mesmo cronograma.
Para polling, intervalos mais curtos trocam mais tráfego por menos atraso de detecção. Webhooks evitam essa troca particular, mas a substituem pelo custo de operar um receptor confiável.
Compromissos de Confiabilidade Que Você Deve Projetar
A entrega de webhooks é normalmente pelo menos uma vez, não exatamente uma vez. Isso descreve o modelo de entrega, não uma promessa de que um provedor tentará novamente para sempre. Tentativas limitadas ainda podem resultar em um evento não entregue, então projete o receptor para o pior caso, em vez do caminho feliz.
Um timeout não informa ao remetente nada sobre o que aconteceu a jusante. Seu receptor pode registrar o evento no armazenamento e, em seguida, perder o reconhecimento na rede. Quando o remetente tenta novamente, sua aplicação recebe o mesmo evento de novo e precisa absorvê-lo de forma elegante.
Associe cada falha a uma proteção
- Entrega duplicada: Armazene um identificador de evento estável sob uma restrição única. Onde os provedores distinguem eventos de tentativas de entrega, deduplique o processamento de negócios pela identidade do evento, não pela identidade da tentativa.
- Efeitos colaterais repetidos: Torne a publicação de ativos, atualizações de conta e notificações de clientes idempotentes. A deduplicação de entrada não ajuda um worker que falha após realizar uma ação, mas antes de registrar o sucesso.
- Eventos fora de ordem: Verifique o estado autoritativo ou uma versão documentada do recurso antes de aplicar uma transição. Um evento de "processamento" atrasado nunca deve sobrescrever uma tarefa concluída.
- Processamento lento: Verifique, aceite duravelmente e reconheça o evento antes de entregar trabalho caro a um worker de fila.
As políticas de repetição do provedor não são intercambiáveis. A documentação de webhook do Supabase exige uma resposta 2xx em 20 segundos, usa backoff exponencial e para após cinco tentativas falhas. O guia de garantias de entrega do Svix documenta a tentativa inicial da Dynamic mais cinco repetições ao longo de aproximadamente um dia, juntamente com as regras de repetição específicas de status da Glean.
Comportamento documentado de repetição de webhook por provedor
| Provedor | O que conta como sucesso | Comportamento de repetição |
|---|---|---|
| Supabase | Resposta 2xx em 20 segundos | Backoff exponencial, para após cinco tentativas falhas |
| Dynamic | Resposta 2xx | Tentativa inicial mais cinco repetições ao longo de cerca de um dia |
| Glean | Resposta 2xx | Tenta novamente falhas de conexão, timeouts, 408, 429 e 5xx; outras respostas não--2xx são terminais |
O reconhecimento é um limite de durabilidade
Retornar sucesso antes do armazenamento durável cria uma janela de perda: o remetente para de tentar novamente, mas sua aplicação não tem nada recuperável. Retornar sucesso apenas após o processamento de mídia cria o problema oposto: timeouts desnecessários e entregas duplicadas. Reconheça a aceitação durável, não o trabalho de negócios concluído.
A verificação de assinatura deve vir antes de confiar no payload. Preserve o corpo da requisição bruto quando o esquema de assinatura exigir, e siga o procedimento de verificação documentado do provedor em vez de assinar um objeto resserializado.
Adicione tratamento de dead-letter para tentativas de worker esgotadas e observabilidade de entrega que conecta IDs de evento, IDs de tarefa, falhas de reconhecimento e resultados de processamento. Para a etapa de polling do mesmo fluxo de trabalho, classifique as falhas com os códigos de status retornados: a API da UberLLM recusa chamadas com códigos de erro como 402, 404, 429 e 503, o que permite que um trabalho de reconciliação separe uma recusa de faturamento de um throttling ou de um vendedor temporariamente indisponível.
Um polling perdido é recuperado verificando novamente. Um webhook perdido precisa de outra entrega ou de uma passagem de reconciliação independente que releia o status autoritativo da tarefa em um cronograma. Construa essa passagem independentemente de você expor um receptor ou não; é isso que transforma a entrega "pelo menos uma vez" em processamento efetivo "exatamente uma vez".
Quando o Polling É a Escolha Mais Segura
Webhooks são um problema de confiabilidade de entrega, não apenas uma API mais rápida. Se sua aplicação não consegue suportar o contrato do receptor, o polling pode ser a escolha mais confiável.
A diferença operacional é mais fácil de ver no limite do consumidor.
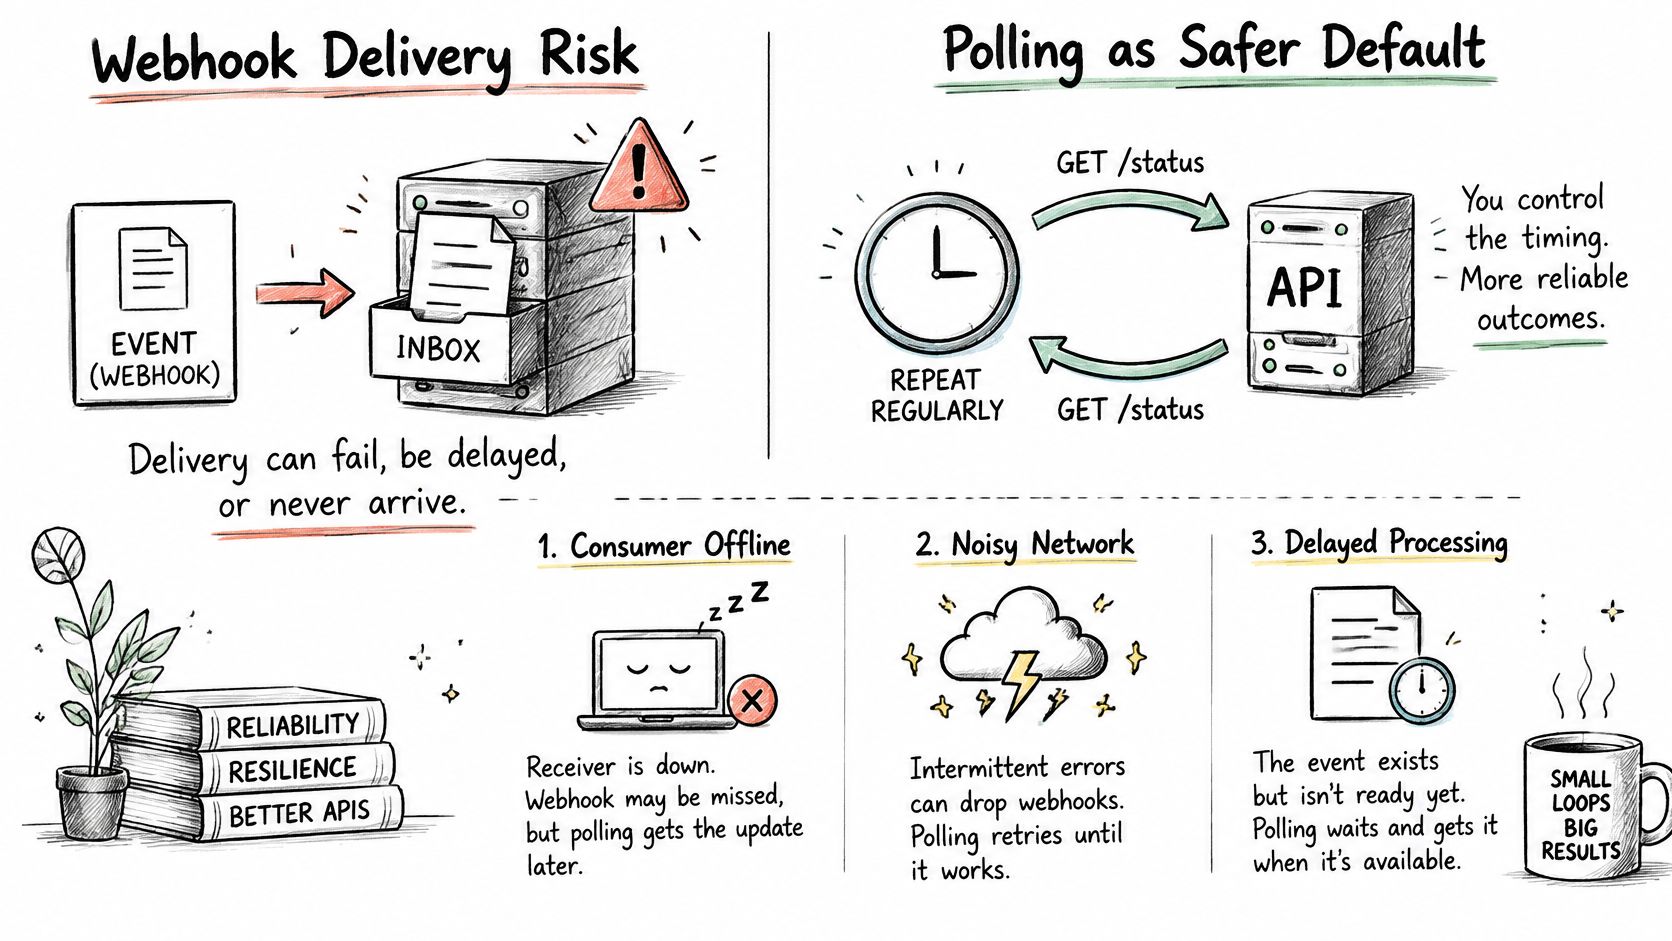
Um agente de desktop, uma ferramenta interna atrás de um firewall, ou um runner de CI efêmero pode ter acesso de saída sem um endereço de entrada estável. Fazer com que esses clientes recebam callbacks pode exigir um serviço hospedado adicional, autenticação entre componentes e uma entrega durável de volta ao chamador original. Isso é infraestrutura, não uma pequena mudança de configuração.
Reconheça as restrições que favorecem o polling
- Sem endpoint público estável: Mantenha a comunicação de saída em vez de expor um ambiente de desenvolvimento temporário.
- Sem consumidor de eventos durável: Faça polling do status autoritativo enquanto você constrói armazenamento e processamento seguros. Um receptor que esquece eventos aceitos não é uma melhoria.
- Recuperação controlada pelo consumidor: Agende verificações de acordo com seus próprios limites de concorrência, janelas de manutenção e prazos da aplicação.
Digamos que uma ferramenta de build em um laptop de desenvolvedor envie uma tarefa de mídia remota. Ela pode verificar periodicamente até a conclusão, parar quando o desenvolvedor cancelar e retomar a partir do identificador de tarefa salvo. Para um pequeno número de trabalhos ativos, isso pode ser mais simples e barato do que manter um receptor sempre disponível.
Polling ainda exige disciplina. Faça back off em falhas transitórias, evite sincronizar as verificações de todos os clientes e pare de verificar tarefas concluídas. Uma tempestade de retentativas também é possível com requisições de saída.
O vídeo que acompanha oferece outra maneira de visualizar a distinção entre requisição e callback.
Escolha o padrão que seu consumidor pode recuperar de forma confiável, não o padrão com a demonstração de sucesso mais rápida.
O tráfego de webhook de entrada adiciona segurança de endpoint, verificações de assinatura, enfileiramento, supressão de duplicatas e requisitos de disponibilidade. O polling oferece controle explícito sobre quando a próxima operação acontece, embora os limites de taxa do provedor ainda se apliquem.
Use um webhook com um fallback de polling quando a entrega de entrada for prática e eventos frequentes a justificarem; caso contrário, faça polling com sua própria cadência, concorrência e timeout.
Como Construir o Fluxo Híbrido para Trabalhos de Mídia
Uma integração híbrida trata os callbacks como prompts para verificar o trabalho, não como a única evidência de que o trabalho existe. A identidade de tarefa persistida conecta a solicitação inicial, a notificação recebida, as verificações de recuperação e o resultado final para o cliente.
Usamos rastreamento de tarefas assíncronas e callbacks de webhook para manter os fluxos de trabalho de mídia de alto volume em andamento. Para trabalhos de imagem e vídeo, esse rastreamento significa que uma interrupção em um vendedor não faz com que o trabalho do cliente seja perdido.
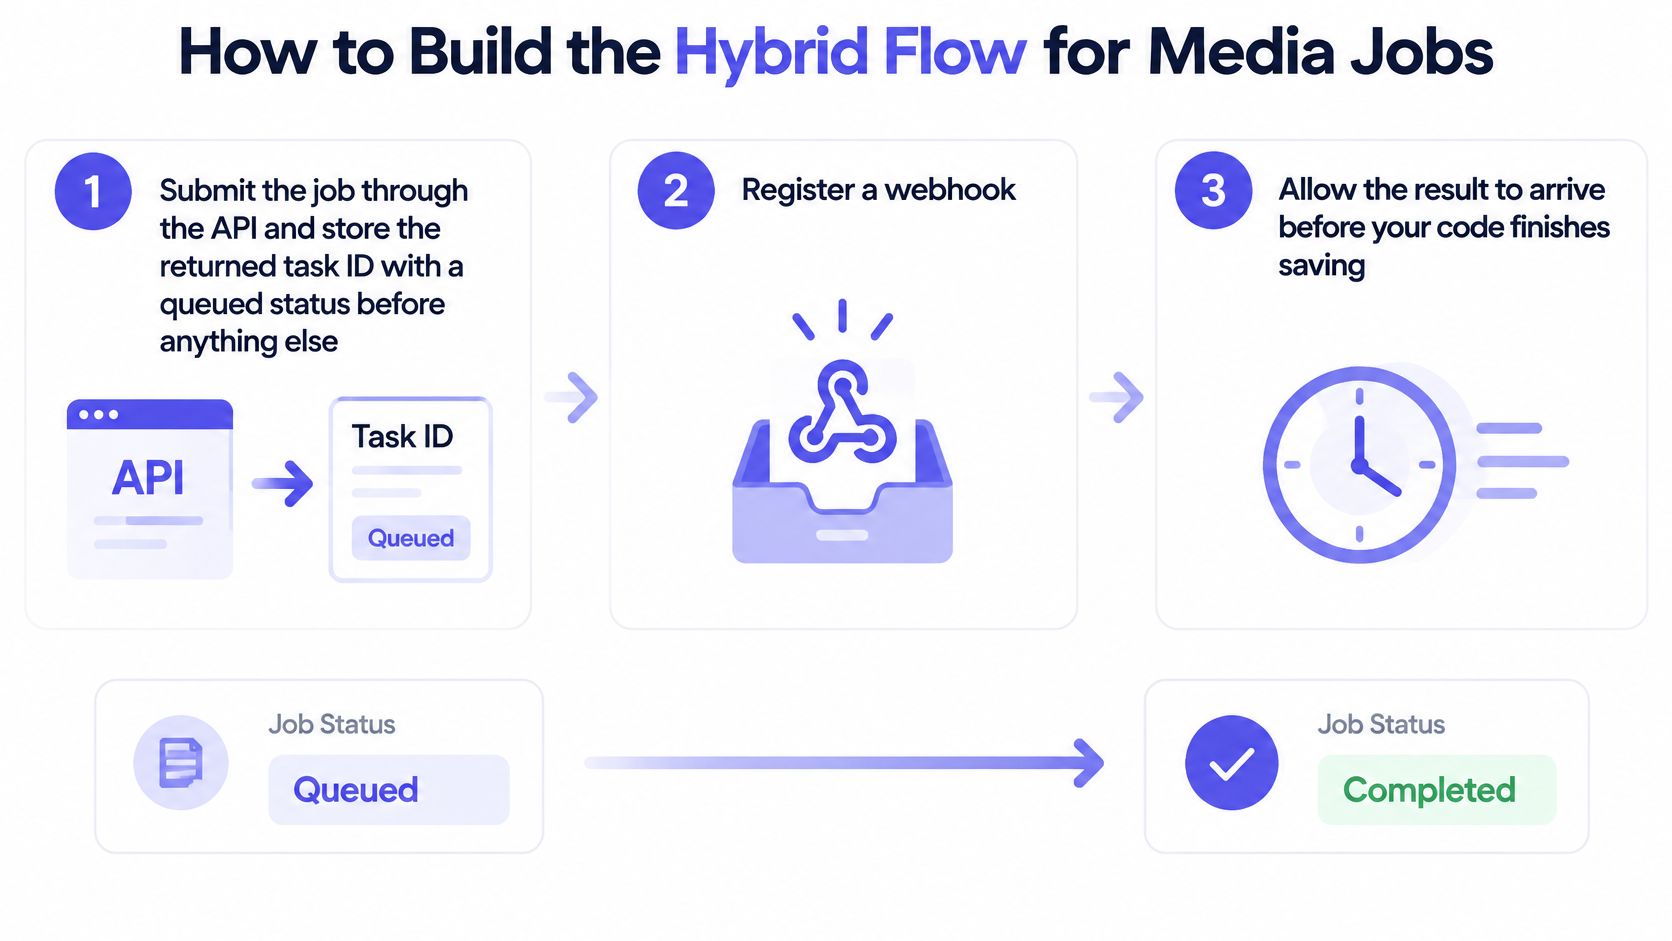
O fluxo de trabalho mantém a submissão, a notificação e a recuperação de status separadas.
Estabeleça a propriedade durável da tarefa
Envie via API e salve o ID da tarefa retornado. Persista-o com um status de "em fila" antes de iniciar o trabalho subsequente. Crie um registro de submissão local antecipadamente, sempre que possível, pois um callback rápido pode chegar antes da resposta de submissão. O erro comum é assumir que os callbacks sempre chegam após o commit do banco de dados. Mantenha eventos não correspondidos para associação posterior.
Registre um receptor que enfileira duravelmente os eventos aceitos. Mantenha o request handler pequeno e confirme prontamente após a aceitação segura. Não retorne sucesso antes do armazenamento, e não baixe ou transforme o ativo finalizado dentro do handler.
Verifique a autenticidade e, em seguida, deduplique o processamento. A verificação de assinatura deve ocorrer na entrada antes que um evento seja confiável ou reconhecido; o worker então verifica a identidade do evento persistido antes de aplicar os efeitos. O erro comum é tratar isso como uma limpeza opcional após o processamento. Mantenha o status de aceitação e processamento separados para que um worker interrompido possa retomar com segurança.
Convergir para a conclusão autoritativa
Busque o status autoritativo da tarefa. Use o ID da tarefa salvo antes de marcar o trabalho do cliente como concluído. Um evento pode conter apenas um identificador, e uma notificação atrasada pode descrever uma transição mais antiga. Para uma implementação de edição de imagem, o guia da API de edição de fotos fornece um fluxo de trabalho de solicitação concreto para construir.
Sonde as tarefas que permanecem pendentes além do seu período esperado. Use backoff, jitter e uma contagem máxima de tentativas para cada ciclo de verificação. Não reenvie cegamente a geração quando um callback estiver faltando, pois a tarefa original pode já estar completa.
Defina um prazo de aplicação e reconcilie tarefas obsoletas diariamente. Distinga uma geração falha de uma falha na verificação de status. Se o estado do provedor permanecer desconhecido no seu prazo, registre um resultado explícito de recuperação ou falha, em vez de deixar a interface do cliente em fila indefinidamente.
Verificação de saúde: Cada ID de tarefa salvo deve levar a um resultado de aplicação terminal, completo ou falho, dentro do seu timeout. Mantenha o estado do provedor não resolvido visível para os operadores para que um timeout da aplicação não abandone um resultado que ainda precisa de recuperação.
Escolha por Carga de Trabalho e Restrição
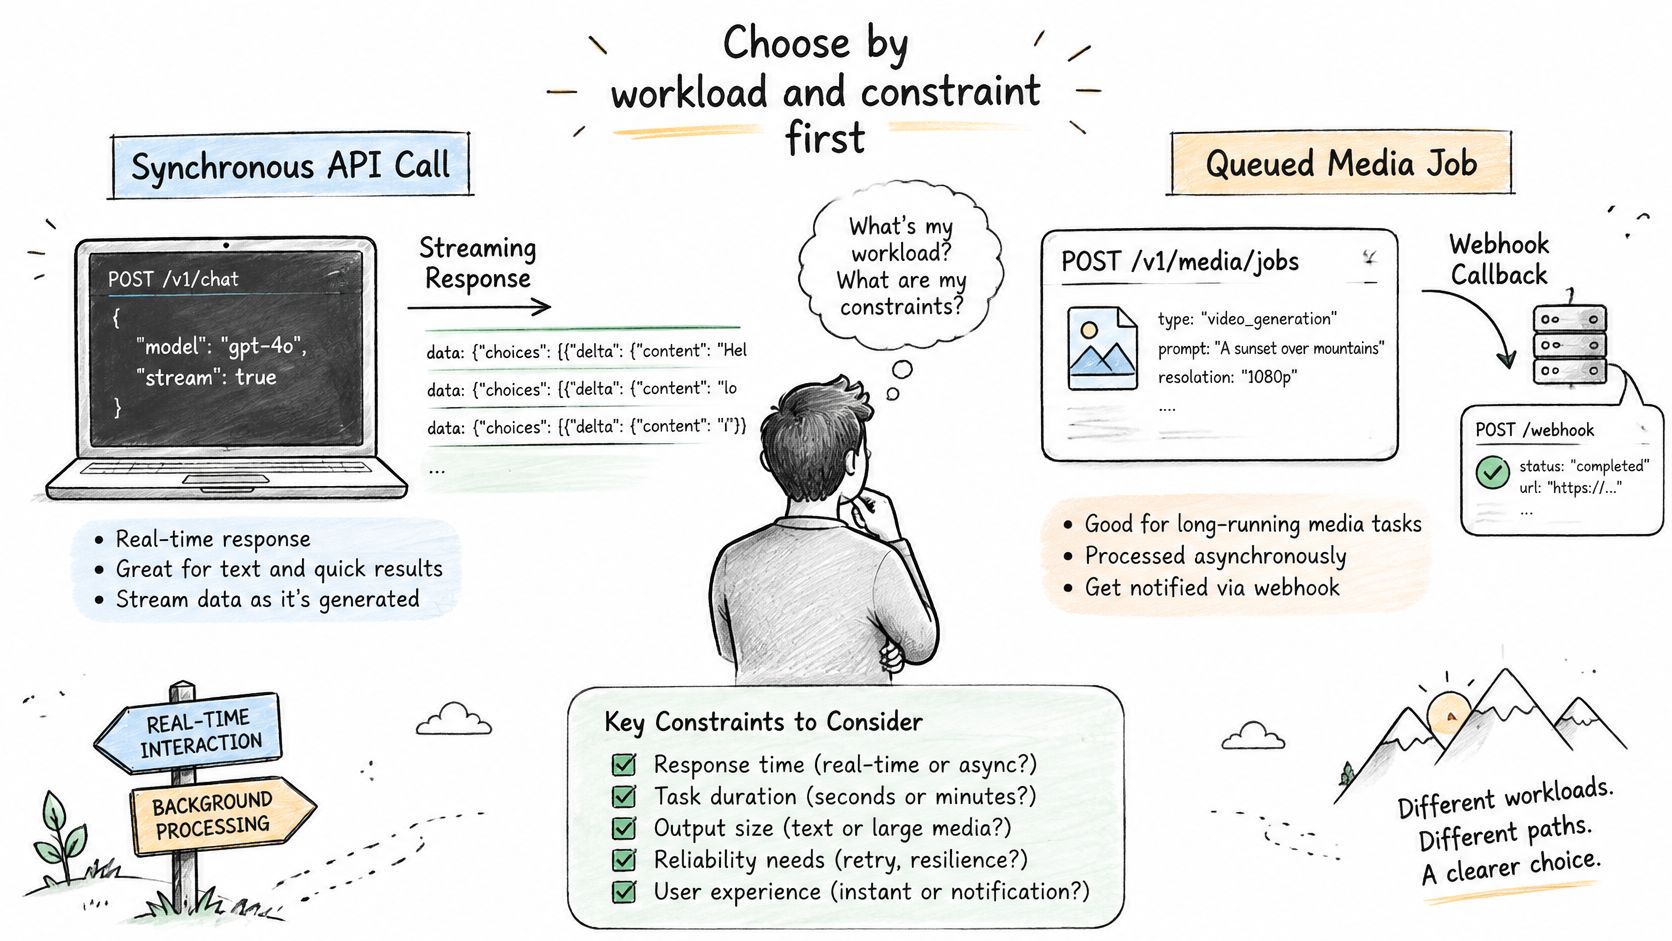
Comece pela carga de trabalho e, em seguida, rejeite qualquer padrão que sua implantação não possa suportar. O mecanismo de notificação mais rápido não ajudará se o cliente receptor não puder aceitar solicitações de entrada ou se a equipe não puder recuperar o processamento interrompido.
Mapeamento de carga de trabalho para padrão
| Carga de trabalho | Padrão recomendado | Principal motivo |
|---|---|---|
| Geração de texto curto ou resposta de codificação | API síncrona com streaming | Uma resposta necessária rapidamente |
| Trabalho de imagem, vídeo, música ou fala | Enviar via API, webhook na conclusão, fallback de polling | Tempo de conclusão imprevisível |
| Cliente móvel ou de navegador sem endpoint público | Polling | Não pode aceitar chamadas de entrada iniciadas pelo provedor |
| Preenchimento ou reconciliação de registros passados | Chamadas de lista da API | Precisa de estado atual e histórico |
| Feed de eventos de alto volume, como status de pedido | Webhook com consumidor idempotente e reconciliação | Apropriado quando a taxa de eventos está muito abaixo da taxa de polling proposta |
Um navegador ainda pode receber atualizações de aplicativos através de seu próprio backend, mas esse backend é o proprietário do receptor do webhook. Não coloque credenciais de provedor ou segredos de verificação de callback no navegador para ignorar essa responsabilidade.
A carga de trabalho e a restrição de implantação devem ser avaliadas em conjunto.
Use o custo operacional total como critério de desempate
Uma análise citada no artigo sobre arquitetura de webhook da Xictron descobriu que apenas 1.5% de 30 milhões de solicitações de polling retornaram uma atualização. Isso ilustra como o polling mal ajustado pode desperdiçar tráfego, não que toda integração de webhook custará menos.
Compare o intervalo de polling, a frequência de eventos, o tamanho do payload e os limites do provedor com a hospedagem do receptor, o armazenamento da fila, o monitoramento e a resposta a incidentes. Conte também as leituras de API que seu worker de webhook ainda precisa. Uma notificação leve seguida por uma busca autoritativa não é uma arquitetura sem solicitações.
Para um aplicativo multiprovedor, inspecione a consistência do esquema de eventos e o comportamento de fallback. Normalizar o status da tarefa em seu próprio modelo de aplicativo pode ser mais importante do que pequenas diferenças na velocidade de notificação.
Regra de seleção: Prefira o caminho primário mais simples que atenda ao requisito voltado para o usuário, então financie o caminho de recuperação antes de otimizar a latência.
Use uma API quando o aplicativo precisar de uma resposta a uma solicitação. Use webhooks quando ele precisar reagir a mudanças e puder operar um receptor seguro e durável. Adicione verificações de status independentes para trabalhos de longa duração e mantenha o polling controlado pelo consumidor quando a entrega de entrada não for possível.
Antes da implementação, anote sua taxa de eventos esperada por recurso, se você pode expor um endpoint estável e como você lidará com o processamento duplicado. Em seguida, faça uma solicitação de API simples e verifique se você pode salvar e recuperar a tarefa resultante antes de adicionar callbacks.
UberLLM oferece todos os modelos através de uma API key e aceita os formatos de wire da OpenAI e Anthropic, para que os clientes existentes possam usar a base URL e as credenciais apropriadas. Para fluxos de trabalho de imagem e vídeo, escolha polling de tarefas ou notificação de webhook quando o resultado estiver pronto. Visite UberLLM para testar o caminho da solicitação e, em seguida, adicione os caminhos de conclusão e recuperação que seu aplicativo precisa.