Webhook vs API: Push, Polling e Quando Usare Ciascuno
Webhook vs API confrontati su direzione, traffico, affidabilità e costo, con quando usarli e come combinarli per lavori multimediali AI asincroni.
Il consiglio popolare su webhook vs API è incompleto: usa i webhook per gli aggiornamenti in tempo reale e le API per tutto il resto. Questo tralascia la parte più difficile. Un ricevitore di webhook è un consumatore di messaggi asincrono, e scegliere la consegna push significa accettare la responsabilità per duplicati, notifiche perse, autenticazione e recupero. Il confronto utile non è push contro pull. È economia del traffico contro controllo operativo, con un percorso di recupero per qualsiasi canale fallisca.
Indice
- Webhook vs API a colpo d'occhio
- Come ogni pattern sposta i dati
- Compromessi di affidabilità da considerare nella progettazione
- Quando il polling è la scelta più sicura
- Come costruire il flusso ibrido per i lavori multimediali
- Scegliere in base al carico di lavoro e ai vincoli
Webhook vs API a colpo d'occhio
| Criterio | API (richiesta-risposta o polling) | Webhook (notifica push) |
|---|---|---|
| Direzione | Il client invia la richiesta, il server risponde | Il provider invia una richiesta HTTP all'URL del client |
| Chi avvia | Client | Provider, quando si verifica un evento |
| Tempistica | Quando il client lo chiede | Quando si verifica l'evento |
| Ideale per | Stato attuale, cronologia, riempimenti (backfills), riconciliazione | Notificare le app quando lo stato cambia o un lavoro termina |
| Esigenze del client | Solo accesso HTTP in uscita | Endpoint HTTPS pubblico, verifica della firma, archiviazione |
| Consegna | Risposta diretta a ogni richiesta, se il trasporto ha successo | Normalmente consegna "almeno una volta" con tentativi limitati, possibili duplicati e riordino |
| Recupero da errori | Il client riprova e ricontrolla | Il provider riprova; il consumer deduplica e riconcilia tramite l'API |
| Modello di costo | Il traffico cresce con la frequenza di polling | Il traffico cresce con il volume degli eventi |
Un webhook è un meccanismo di consegna di eventi basato su API HTTP, non un loro sostituto. La maggior parte delle integrazioni di produzione necessita di entrambi: un percorso di richiesta per comandi e letture autorevoli, più un percorso di notifica per le modifiche.
Supponiamo che la tua applicazione invii un lavoro di generazione video. Con un'API, il tuo backend invia una richiesta GET utilizzando l'identificatore del task salvato e riceve lo stato attuale del lavoro. La tua applicazione sceglie quando chiedere, quanto aspettare e cosa fare se la richiesta fallisce.
Con un webhook, il provider invia un evento di completamento del lavoro a un endpoint che hai registrato. Il tuo backend accetta quella notifica e pianifica l'azione successiva, come il recupero dell'asset finito. La sessione originale del browser non ha bisogno di rimanere connessa.
Separare il comando dalla notifica
Inviare un lavoro e sapere che è terminato sono operazioni diverse. Un'API può accettare un task immediatamente senza mantenere la connessione aperta finché il calcolo sottostante non termina. Un webhook fornisce quindi un segnale di completamento separato.
Questa distinzione previene un errore di progettazione comune: trattare ogni operazione asincrona come una richiesta HTTP che deve rimanere aperta. Previene anche l'errore opposto, cercare di usare le notifiche di eventi come un registro completo dello stato attuale.
Prima decisione: La tua applicazione deve reagire quando qualcosa cambia, o ha bisogno della risposta solo quando qualcuno la chiede?
Se un utente apre una schermata di cronologia dei lavori, recupera i record attuali. Se un lavoro completato deve attivare la consegna dell'asset mentre nessuno sta guardando quella schermata, usa un percorso basato su eventi. Nessuno dei due modelli elimina la necessità di gestire i fallimenti di rete, ma ognuno mette il chiamante in una posizione diversa per recuperare.
Come ogni modello sposta i dati
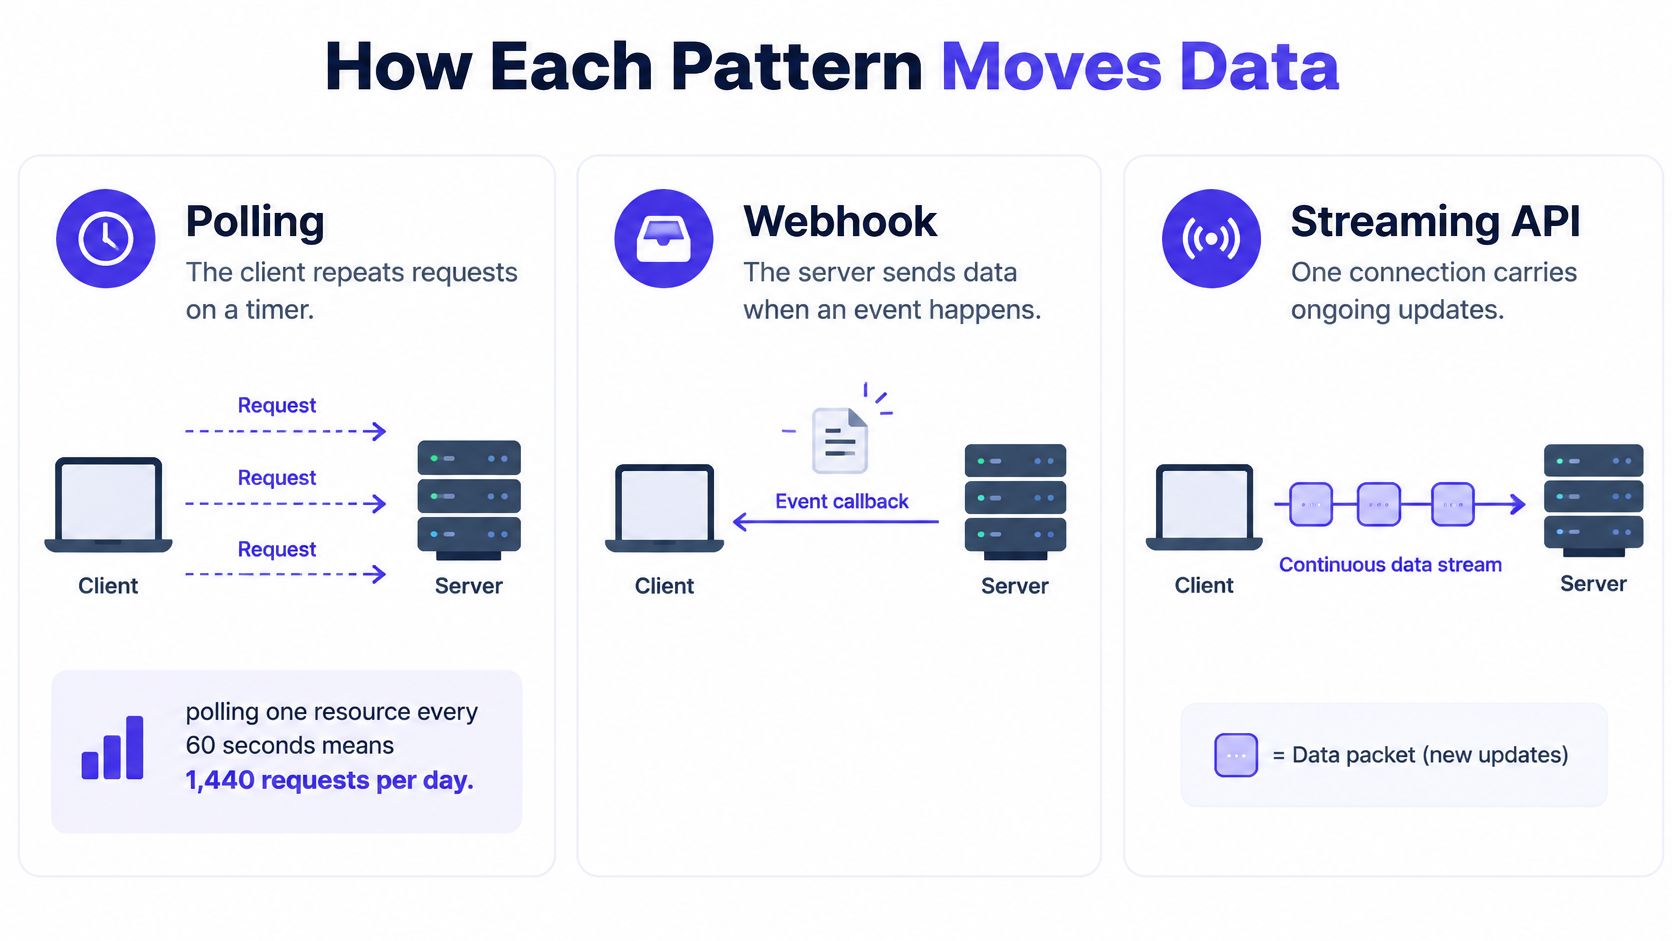
Con il polling, il client ripete una richiesta di stato a intervalli regolari, indipendentemente dal fatto che qualcosa sia cambiato o meno. Con un webhook, il provider avvia una richiesta dopo un evento, quindi il traffico di notifica segue l'attività piuttosto che l'orologio.
La [guida di Nylas su webhook e polling]](https://developer.nylas.com/docs/cookbook/use-cases/build/webhooks-vs-polling/) fornisce esempi di traffico sottostante: il polling di una risorsa ogni 60 secondi significa 1,440 richieste al giorno, mentre il suo confronto di 10,000 account produce 2.88 milioni di richieste di polling giornaliere contro circa 500,000 consegne di webhook.
Traffico e latenza per intervallo di polling e frequenza degli eventi
| Scenario | Richieste o consegne al giorno | Latenza di rilevamento |
|---|---|---|
| Polling di una risorsa ogni 60 secondi | 1,440 richieste | 30 secondi in media |
| Polling di una risorsa ogni 5 minuti | 288 richieste, calcolate dall'intervallo | 2.5 minuti in media |
| 10,000 account che eseguono il polling ogni 5 minuti | 2.88 milioni di richieste | 2.5 minuti in media |
| 10,000 account che ricevono circa 50 notifiche di eventi ciascuno | Circa 500,000 consegne | Tempo di invio dell'evento più eventuali ritardi di riprovo |
| Risposta testuale in streaming token per token | Una richiesta per generazione | I token arrivano man mano che vengono generati |
Le medie del polling presuppongono che i cambiamenti avvengano indipendentemente dalla pianificazione del polling. Descrivono l'attesa fino al controllo successivo, non il tempo che il provider impiega per eseguire il lavoro.
L'intervallo più breve migliora il tempo di scoperta a costo di più richieste. L'intervallo più lungo riduce il traffico ma lascia il lavoro completato non rilevato. Su scala di account, anche una pianificazione modesta crea un traffico sostanziale perché ogni account inattivo viene comunque controllato.
La consegna tramite webhook elimina quella pianificazione di controllo fissa, ma il conteggio delle consegne non è un conto completo dell'infrastruttura. Le ricerche API dopo le notifiche, i tentativi di consegna, l'archiviazione del ricevitore e l'esecuzione del worker consumano comunque risorse.
Questi sono modelli di comunicazione distinti, non etichette intercambiabili.
Lo streaming risolve un problema diverso
Una risposta testuale in streaming mantiene la richiesta aperta e restituisce i token man mano che vengono generati. Per un assistente di codifica interattivo, il tempo al primo token e la continuità dell'output contano più che ricevere una callback di completamento separata.
Le nostre risposte testuali vengono trasmesse in streaming token per token, mentre i lavori di immagini e video restituiscono un task che puoi interrogare (poll) o per il quale ricevi una notifica webhook quando è pronto. La [documentazione dell'API multimediale]](https://uberllm.dev/docs/media) è il punto di partenza per implementare quel percorso di richiesta orientato ai task.
Stima la frequenza degli eventi per risorsa prima di scegliere un intervallo di polling. Una risorsa inattiva e una risorsa in continuo cambiamento non dovrebbero condividere automaticamente la stessa pianificazione.
Per il polling, intervalli più brevi scambiano più traffico per un minore ritardo di rilevamento. I webhook evitano quello scambio particolare, ma lo sostituiscono con il costo di gestire un ricevitore affidabile.
Compromessi di affidabilità che devi considerare nella progettazione
La consegna dei webhook è normalmente almeno una volta, non esattamente una volta. Questo descrive il modello di consegna, non una promessa che un provider ritenterà all'infinito. I tentativi limitati possono comunque terminare con un evento non consegnato, quindi progetta il ricevitore per il caso peggiore piuttosto che per il percorso felice.
Un timeout non dice nulla al mittente su ciò che è successo a valle. Il tuo ricevitore potrebbe salvare l'evento nello storage, quindi perdere l'acknowledgment sulla rete. Quando il mittente ritenta, la tua applicazione riceve di nuovo lo stesso evento e deve gestirlo con eleganza.
Abbina ogni errore a una protezione
- Consegna duplicata: Archivia un identificatore di evento stabile sotto un vincolo di unicità. Laddove i provider distinguono gli eventi dai tentativi di consegna, deduplica l'elaborazione aziendale per identità dell'evento, non per identità del tentativo.
- Effetti collaterali ripetuti: Rendi la pubblicazione di asset, gli aggiornamenti degli account e le notifiche ai clienti idempotenti. La deduplicazione dell'ingresso non serve a nulla per un worker che si blocca dopo aver eseguito un'azione ma prima di registrare il successo.
- Eventi fuori ordine: Controlla lo stato autorevole o una versione documentata della risorsa prima di applicare una transizione. Un evento di "elaborazione" ritardato non deve mai sovrascrivere un'attività completata.
- Elaborazione lenta: Verifica, accetta in modo duraturo e conferma l'evento prima di affidare un lavoro costoso a un worker della coda.
Le politiche di retry dei provider non sono intercambiabili. La documentazione sui webhook di Supabase richiede una risposta 2xx entro 20 secondi, utilizza un backoff esponenziale e si ferma dopo cinque tentativi falliti. La guida alle garanzie di consegna di Svix documenta il tentativo iniziale di Dynamic più cinque retry nell'arco di circa un giorno, insieme alle regole di retry specifiche per lo stato di Glean.
Comportamento di retry dei webhook documentato per provider
| Provider | Cosa conta come successo | Comportamento di retry |
|---|---|---|
| Supabase | Risposta 2xx entro 20 secondi | Backoff esponenziale, si ferma dopo cinque tentativi falliti |
| Dynamic | Risposta 2xx | Tentativo iniziale più cinque retry nell'arco di circa un giorno |
| Glean | Risposta 2xx | Ritenta i fallimenti di connessione, i timeout, 408, 429 e 5xx; altre risposte non--2xx sono terminali |
L'acknowledgment è un confine di durabilità
Restituire successo prima dello storage duraturo crea una finestra di perdita: il mittente smette di ritentare, ma la tua applicazione non ha nulla di recuperabile. Restituire successo solo dopo l'elaborazione dei media crea il problema opposto: timeout non necessari e consegne duplicate. Conferma l'accettazione duratura, non il lavoro aziendale completato.
La verifica della firma deve avvenire prima di fidarsi del payload. Conserva il corpo della richiesta raw quando lo schema di firma lo richiede e segui la procedura di verifica documentata dal provider piuttosto che firmare un oggetto riserializzato.
Aggiungi la gestione dei dead-letter per i retry esauriti dei worker e l'osservabilità della consegna che collega gli ID degli eventi, gli ID delle attività, i fallimenti di acknowledgment e gli esiti dell'elaborazione. Per la fase di polling dello stesso workflow, classifica i fallimenti con i codici di stato restituiti: l'API di UberLLM rifiuta le chiamate con codici di errore come 402, 404, 429 e 503, il che consente a un job di riconciliazione di separare un rifiuto di fatturazione da un throttling o da un venditore temporaneamente non disponibile.
Un polling mancato viene recuperato controllando di nuovo. Un webhook mancato necessita di un'altra consegna o di un passaggio di riconciliazione indipendente che rilegga lo stato autorevole dell'attività su base programmata. Costruisci quel passaggio sia che tu esponga o meno un ricevitore; è ciò che trasforma la consegna "almeno una volta" in un'elaborazione effettiva "esattamente una volta".
Quando il Polling è la Scelta Più Sicura
I webhook sono un problema di affidabilità della consegna, non solo un'API più veloce. Se la tua applicazione non può supportare il contratto del ricevitore, il polling può essere la scelta più affidabile.
La differenza operativa è più facile da vedere al confine del consumatore.
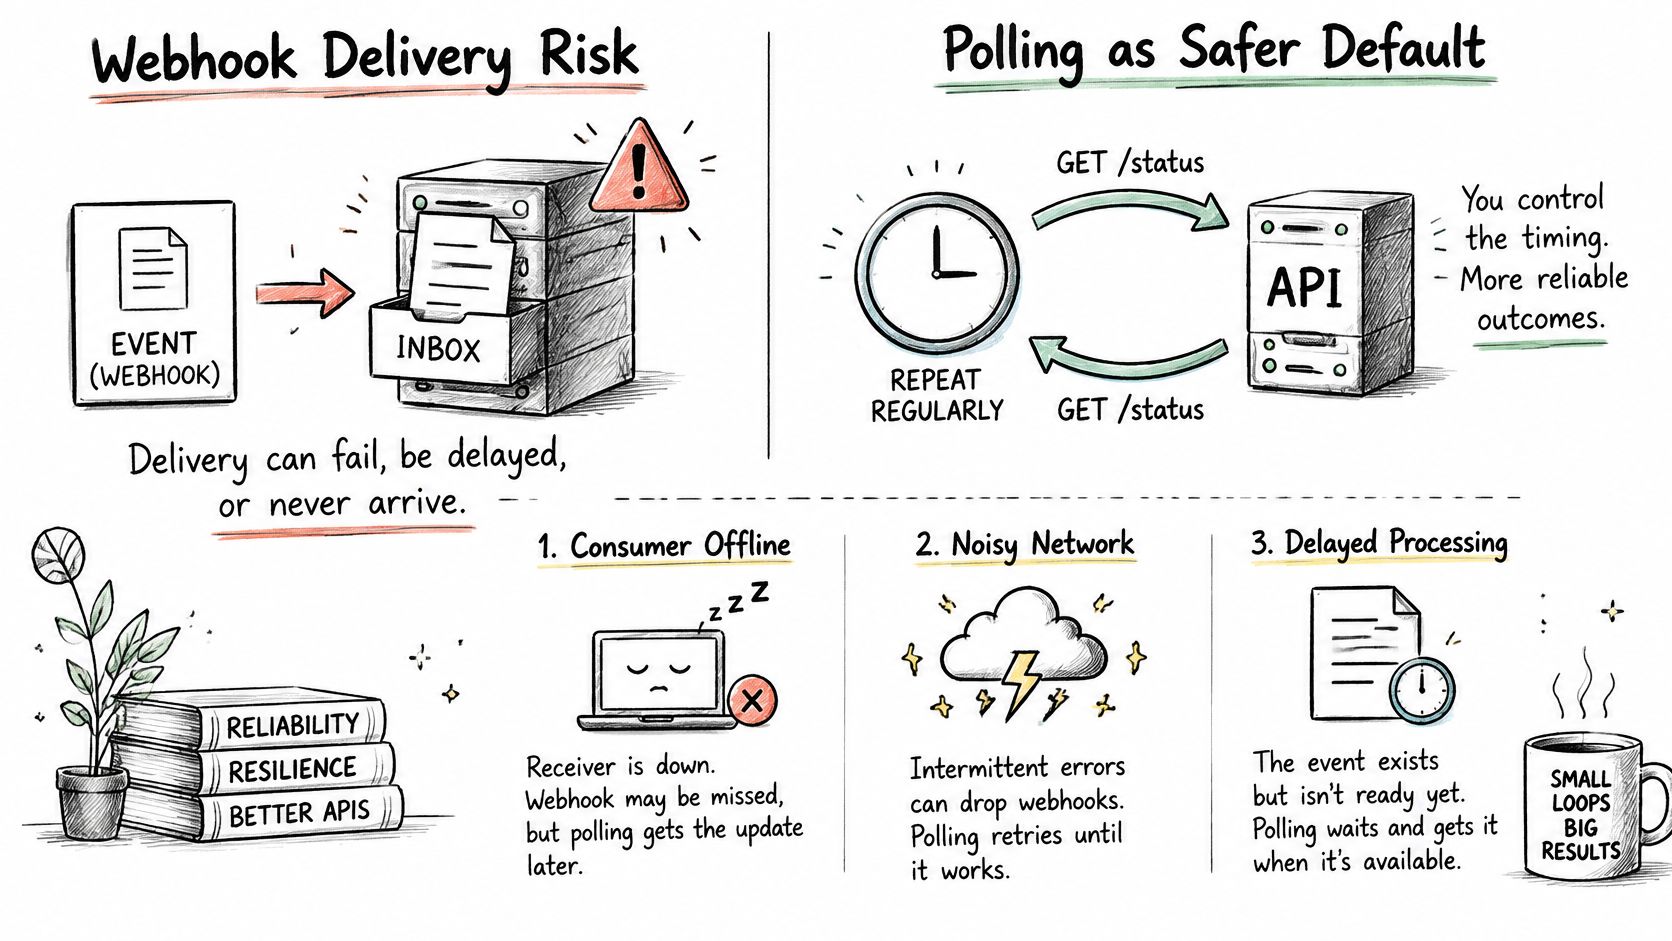
Un agente desktop, uno strumento interno dietro un firewall o un runner CI effimero possono avere accesso in uscita senza un indirizzo in entrata stabile. Far sì che questi client ricevano callback può richiedere un servizio ospitato aggiuntivo, l'autenticazione tra i componenti e un passaggio duraturo al chiamante originale. Questa è infrastruttura, non una modifica di configurazione minore.
Riconosci i vincoli che favoriscono il polling
- Nessun endpoint pubblico stabile: Mantieni la comunicazione in uscita invece di esporre un ambiente di sviluppo temporaneo.
- Nessun consumatore di eventi duraturo: Interroga lo stato autorevole mentre costruisci uno storage e un'elaborazione sicuri. Un ricevitore che dimentica gli eventi accettati non è un miglioramento.
- Ripristino controllato dal consumatore: Pianifica i controlli in base ai tuoi limiti di concorrenza, finestre di manutenzione e scadenze dell'applicazione.
Supponiamo che uno strumento di build su un laptop di uno sviluppatore invii un'attività multimediale remota. Può controllare periodicamente fino al completamento, fermarsi quando lo sviluppatore annulla e riprendere dall'identificatore dell'attività salvata. Per un piccolo numero di lavori attivi, questo può essere più semplice ed economico che mantenere un ricevitore sempre disponibile.
Il polling richiede comunque disciplina. Rallenta in caso di errori transitori, evita di sincronizzare i controlli di ogni client e smetti di controllare le attività terminali. Anche con le richieste in uscita è possibile una tempesta di tentativi.
Il video di accompagnamento offre un altro modo per visualizzare la distinzione tra richiesta e callback.
Scegli il modello che il tuo consumatore può recuperare in modo affidabile, non il modello con la dimostrazione di successo più veloce.
Il traffico webhook in entrata aggiunge sicurezza dell'endpoint, controlli di firma, accodamento, soppressione dei duplicati e requisiti di disponibilità. Il polling ti dà un controllo esplicito su quando avviene l'operazione successiva, anche se i limiti di frequenza del provider si applicano comunque.
Usa un webhook con un fallback di polling quando la consegna in entrata è pratica e gli eventi frequenti lo giustificano; altrimenti, esegui il polling con la tua cadenza, concorrenza e timeout.
Come costruire il flusso ibrido per i lavori multimediali
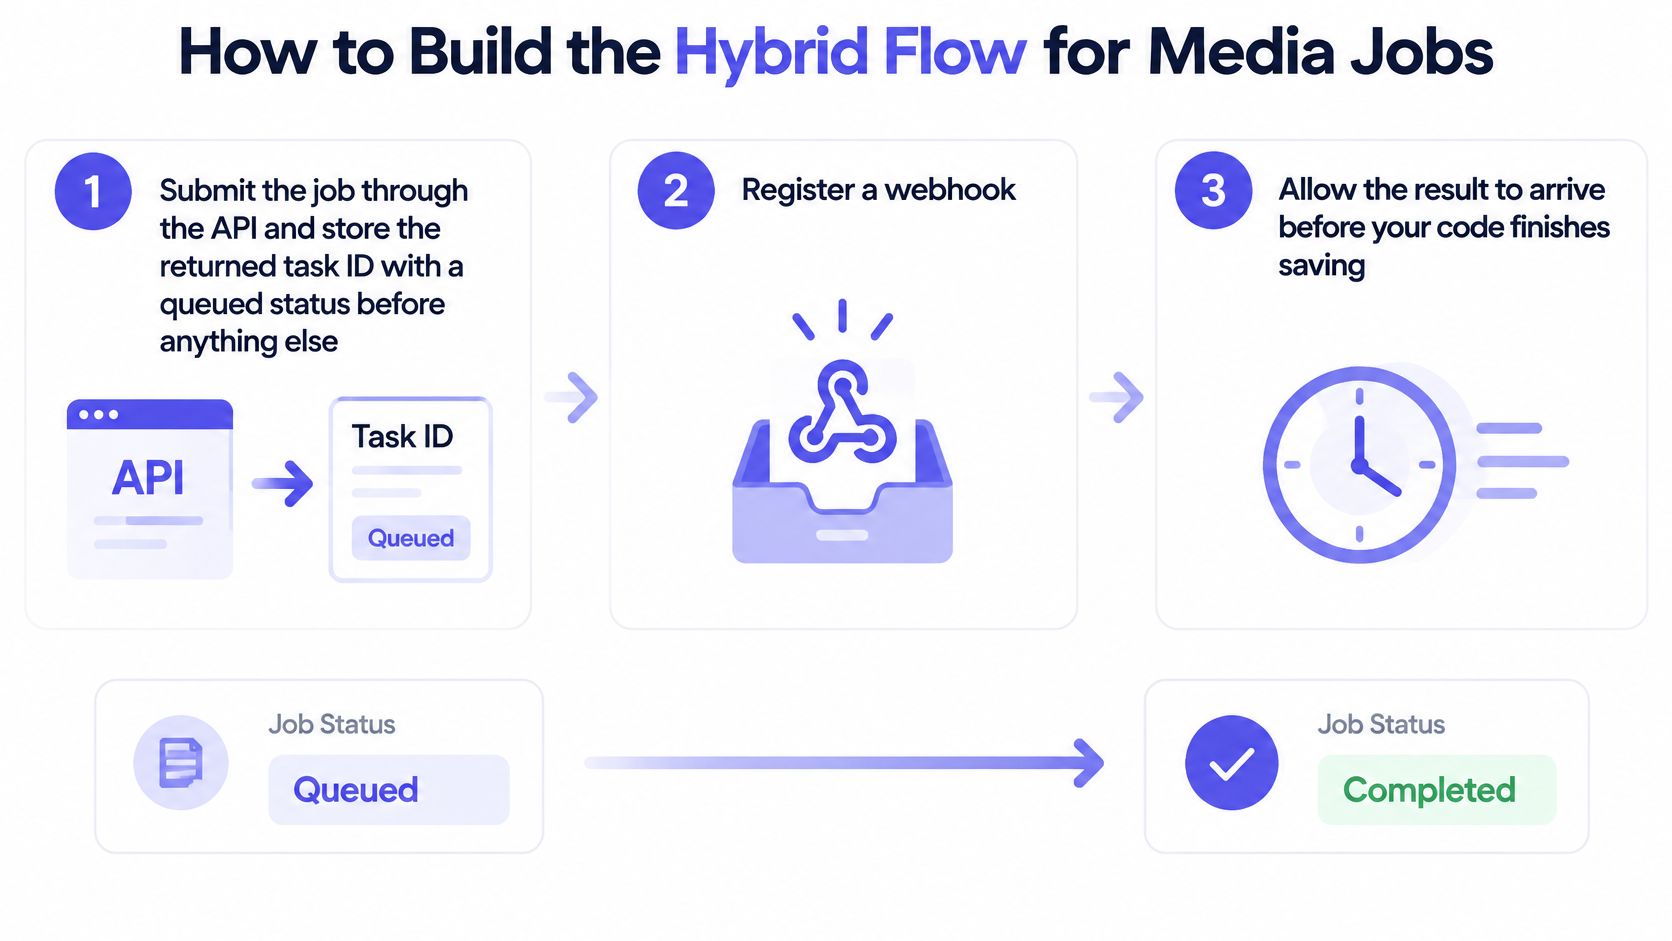
Un'integrazione ibrida tratta le callback come prompt per verificare il lavoro, non come l'unica prova dell'esistenza del lavoro. L'identità persistente del task collega la richiesta iniziale, la notifica in arrivo, i controlli di recupero e il risultato finale per il cliente.
Utilizziamo il tracciamento asincrono dei task e le callback webhook per mantenere in movimento i workflow multimediali ad alto volume. Per i lavori di immagini e video, questo tracciamento significa che un'interruzione su un venditore non comporta la perdita del lavoro del cliente.
Il workflow mantiene separate la submission, la notifica e il recupero dello stato.
Stabilire una proprietà duratura del task
Invia tramite l'API e salva l'ID del task restituito. Rendilo persistente con uno stato di coda prima di iniziare il lavoro a valle. Crea un record di submission locale in anticipo, ove possibile, perché una callback veloce può precedere la risposta di submission. L'errore comune è presumere che le callback arrivino sempre dopo il commit del database. Conserva gli eventi non corrispondenti per un'associazione successiva.
Registra un receiver che accoda in modo duraturo gli eventi accettati. Mantieni il request handler piccolo e invia un acknowledgement prontamente dopo l'accettazione sicura. Non restituire successo prima dello storage e non scaricare o trasformare l'asset finito all'interno dell'handler.
Verifica l'autenticità, quindi deduplica l'elaborazione. La verifica della firma deve avvenire all'ingress prima che un evento sia considerato affidabile o riconosciuto; il worker quindi controlla l'identità dell'evento persistente prima di applicare gli effetti. L'errore comune è trattare questi passaggi come una pulizia opzionale dopo l'elaborazione. Mantieni separati lo stato di accettazione e di elaborazione in modo che un worker interrotto possa riprendere in sicurezza.
Convergi sul completamento autorevole
Recupera lo stato autorevole del task. Usa l'ID del task salvato prima di contrassegnare il lavoro del cliente come completo. Un evento può contenere solo un identificatore e una notifica ritardata può descrivere una transizione più vecchia. Per un'implementazione di editing di immagini, la guida all'API di fotoritocco fornisce un workflow di richiesta concreto su cui basarsi.
Esegui il polling dei task che rimangono in sospeso oltre la loro finestra prevista. Utilizza backoff, jitter e un conteggio massimo di tentativi per ogni ciclo di controllo. Non risottomettere ciecamente la generazione quando manca una callback, perché il task originale potrebbe essere già completo.
Imposta una scadenza dell'applicazione e riconcilia i task obsoleti quotidianamente. Distingui una generazione fallita da un fallimento del controllo dello stato. Se lo stato del provider rimane sconosciuto alla tua scadenza, registra un esito esplicito di recupero o fallimento piuttosto che lasciare l'interfaccia del cliente in coda indefinitamente.
Controllo di integrità: Ogni ID di task salvato deve portare a un esito terminale dell'applicazione, completo o fallito, entro il tuo timeout. Mantieni lo stato del provider irrisolto visibile agli operatori in modo che un timeout dell'applicazione non abbandoni un risultato che necessita ancora di recupero.
Scegli in base al Carico di Lavoro e ai Vincoli
Inizia con il carico di lavoro, quindi scarta qualsiasi schema che la tua implementazione non può supportare. Il meccanismo di notifica più veloce non sarà d'aiuto se il client ricevente non può accettare richieste in entrata o se il team non può recuperare l'elaborazione interrotta.
Mappatura carico di lavoro-schema
| Carico di lavoro | Schema consigliato | Motivo principale |
|---|---|---|
| Generazione di testo breve o risposta di codice | API sincrona con streaming | Una risposta necessaria rapidamente |
| Lavoro di immagine, video, musica o parlato | Invia tramite API, webhook al completamento, fallback con polling | Il tempo di completamento è imprevedibile |
| Client mobile o browser senza endpoint pubblico | Polling | Non può accettare chiamate in entrata avviate dal provider |
| Rifornimento o riconciliazione di record passati | Chiamate API di elenco | Necessita dello stato attuale e storico |
| Feed di eventi ad alto volume come lo stato degli ordini | Webhook con consumer idempotente e riconciliazione | Appropriato quando la frequenza degli eventi è molto inferiore alla frequenza di polling proposta |
Un browser può comunque ricevere aggiornamenti dell'applicazione tramite il proprio backend, ma quel backend possiede il ricevitore webhook. Non inserire credenziali del provider o segreti di verifica del callback nel browser per aggirare tale responsabilità.
Il carico di lavoro e il vincolo di implementazione dovrebbero essere valutati insieme.
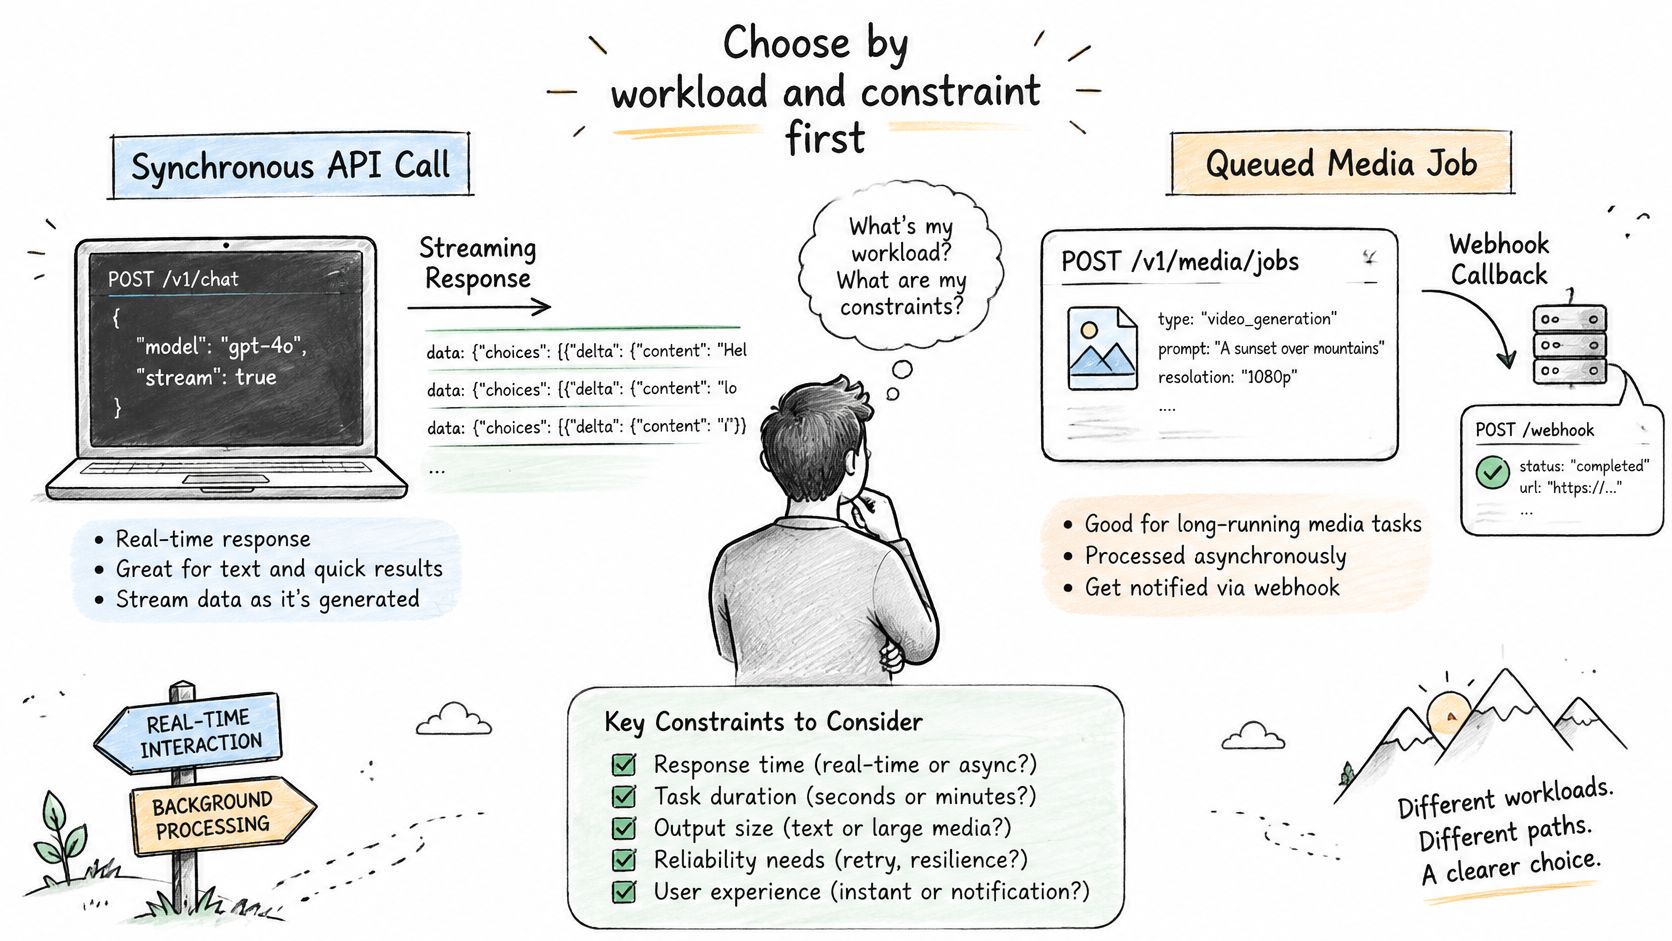
Usa il costo operativo totale come fattore decisivo
Un'analisi citata nell'articolo sull'architettura webhook di Xictron ha rilevato che solo 1.5% di 30 milioni di richieste di polling hanno restituito un aggiornamento. Ciò illustra come un polling mal sintonizzato possa sprecare traffico, non che ogni integrazione webhook costerà meno.
Confronta l'intervallo di polling, la frequenza degli eventi, la dimensione del payload e i limiti del provider con l'hosting del ricevitore, l'archiviazione della coda, il monitoraggio e la risposta agli incidenti. Conta anche le letture API di cui il tuo worker webhook ha ancora bisogno. Una notifica leggera seguita da un recupero autorevole non è un'architettura senza richieste.
Per un'applicazione multi-provider, ispeziona la coerenza dello schema degli eventi e il comportamento di fallback. Normalizzare lo stato delle attività nel tuo modello di applicazione può essere più importante di piccole differenze nella velocità di notifica.
Regola di selezione: Preferisci il percorso primario più semplice che soddisfi il requisito rivolto all'utente, quindi finanzia il percorso di recupero prima di ottimizzare la latenza.
Usa un'API quando l'applicazione ha bisogno di una risposta a una richiesta. Usa i webhook quando deve reagire ai cambiamenti e può operare un ricevitore sicuro e duraturo. Aggiungi controlli di stato indipendenti per i lavori a lunga esecuzione e mantieni il polling controllato dal consumer quando la consegna in entrata non è possibile.
Prima dell'implementazione, annota la frequenza degli eventi prevista per risorsa, se puoi esporre un endpoint stabile e come gestirai l'elaborazione duplicata. Quindi effettua una semplice richiesta API e verifica di poter salvare e recuperare l'attività risultante prima di aggiungere i callback.
UberLLM offre tutti i modelli tramite una singola API key e accetta i formati wire di OpenAI e Anthropic, quindi i client esistenti possono usare l'appropriato base URL e le credenziali. Per i workflow di immagini e video, scegli il task polling o la notifica webhook quando il risultato è pronto. Visita UberLLM per testare il percorso di richiesta, quindi aggiungi i percorsi di completamento e recupero di cui la tua applicazione ha bisogno.