Lijst van AI-modellen 2026: 10 Opties per Gebruiksscenario
Blader door deze praktische lijst van AI-modellen per modaliteit, capaciteit en gebruiksscenario, met 10 catalogi vergeleken op prijzen, toegang en meest geschikte workloads.
Stel dat je team een week besteedt aan het lezen van modelpagina's, het vergelijken van tokenprijzen en het opzetten van een prototype. Dan uploadt iemand een representatief document en ontdekt dat de goedkoopste kandidaat het document, de instructies en de verwachte respons niet in zijn context window past. De integratie werkt. De modelkeuze niet.
Een modelcatalogus is niet hetzelfde als een modelkeuze. Sommige catalogi helpen je bij het ontdekken van downloadbare weights. Andere vergelijken gemeten prestaties, verkopen hosted inference, verbinden modellen met cloud procurement, of verpakken modellen voor lokale uitvoering. Ze als uitwisselbaar behandelen verspilt tijd en kan de beperking verbergen die bepaalt of je applicatie werkt.
Een nuttige lijst van AI-modellen zou je moeten vertellen waar je moet beginnen voor een specifieke taak:
- Modellen ontdekken en aanpassen: Gebruik een directory met model cards, bestanden en licentie-informatie.
- Productiekandidaten vergelijken: Gebruik onafhankelijke metingen en test vervolgens je eigen workload.
- Hosted modellen aanroepen: Gebruik een API-catalogus met expliciete modelidentificaties en deployment details.
- Offline uitvoeren: Gebruik een lokale runtime catalogus en verifieer hardwarevereisten.
Voor tekstapplicaties kunnen context length en tool support kandidaten onmiddellijk elimineren. Voor beeld-, video- en audioapplicaties verdienen ondersteunde inputs, output controls en asynchronous task handling gelijke aandacht. De onderstaande opties dienen verschillende doelen, dus het juiste startpunt hangt minder af van welke catalogus het grootst lijkt en meer van wat je vervolgens moet doen.
Inhoudsopgave
- 1. UberLLM AI modelcatalogus
- 2. OpenRouter
- 3. Hugging Face Hub
- 4. Artificial Analysis
- 5. Replicate Explore
- 6. Microsoft Foundry Models
- 7. Amazon Bedrock modelcatalogus
- 8. Google Cloud Model Garden
- 9. Ollama Library
- 10. Google Gemini API modellijst
- Hoe de 10 modelcatalogi verschillen in toegang, prijstransparantie en limieten
- Een shortlist omzetten in een werkende integratie
1. UberLLM AI-modelcatalogus
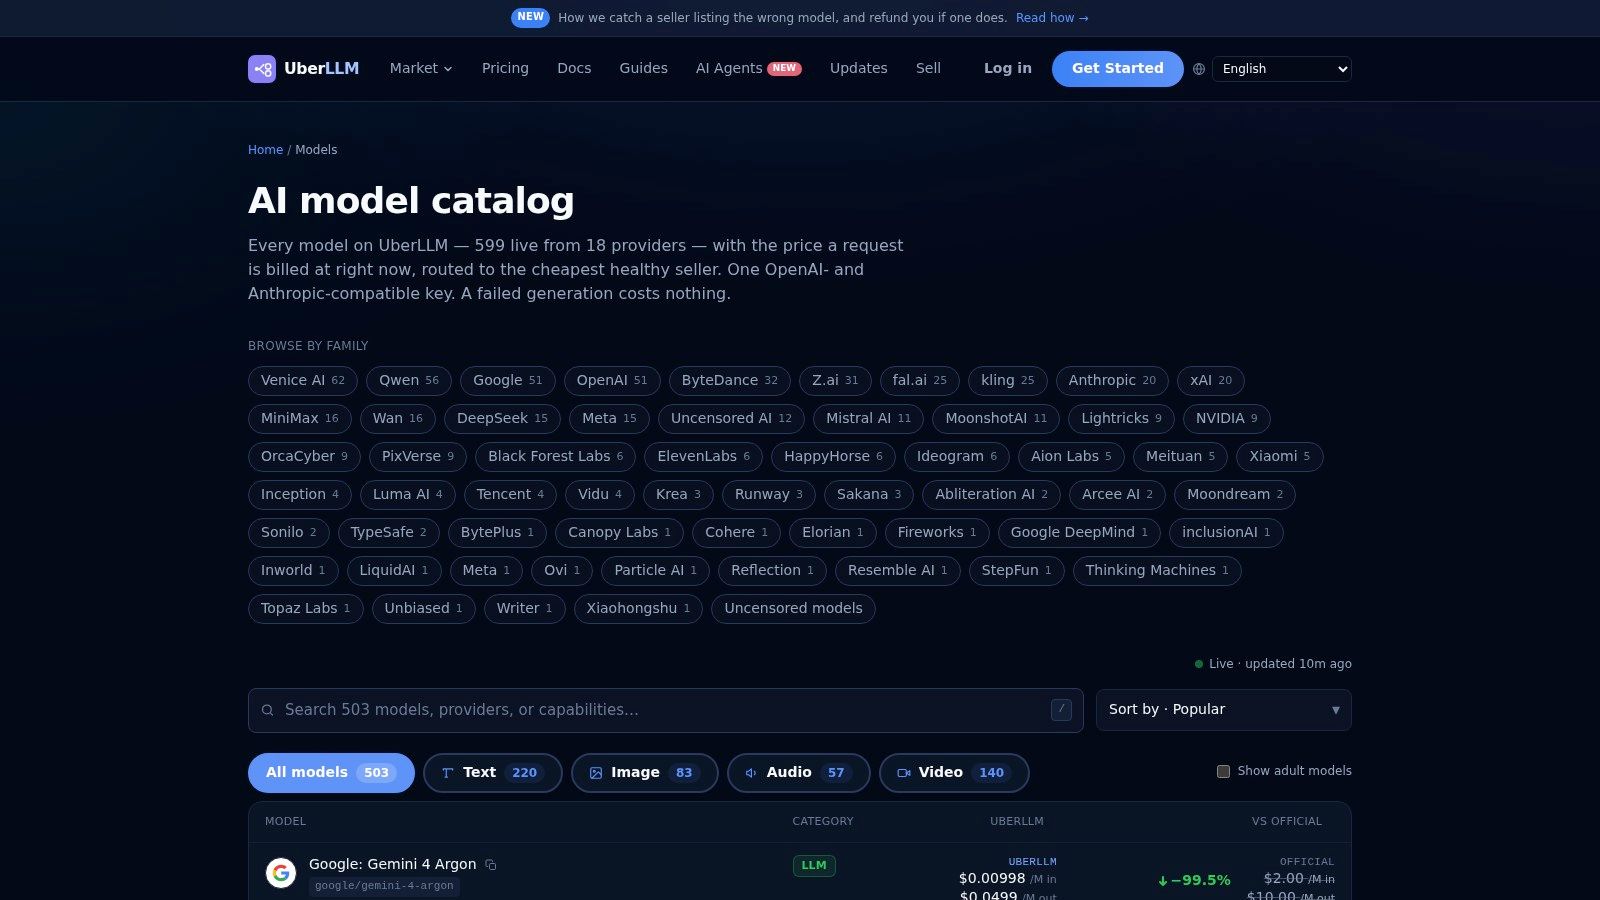
Het beste voor het vergelijken van gehoste opties voordat u een marketplace API integreert. De UberLLM AI-modelcatalogus brengt 457 modellen samen op een vergelijkingspagina met live prijzen, namen van providers, contextlengtes en modeltypes. Het is handig wanneer uw shortlist tekst en media omvat, in plaats van één enkele modelfamilie.
Bij UberLLM verbinden we dat ontdekkingsproces met een OpenAI- en Anthropic-compatibele endpoint. Ontwikkelaars selecteren een model identifier, terwijl marketplace routing een beschikbare verkoper selecteert voor het aangevraagde model. Dat onderscheid is belangrijk: u kiest zowel de mogelijkheden van een model als een gehost toegangspad.
Wat te inspecteren voordat u kiest
Voor documentverwerking, vergelijk context length en maximum output tokens afzonderlijk. Een model dat uw bronmateriaal accepteert, kan nog steeds een output limit hebben die voorkomt dat het het volledige resultaat genereert. Onze model metadata toont beide velden, en de catalogus markeert modellen die tools ondersteunen.
- Sterkte: Live prijzen en namen van providers maken cross-provider shortlisting minder gefragmenteerd.
- Handige workflow: Filter op modaliteit, inspecteer limits, vergelijk vervolgens representatieve outputs in de playground.
- Beperking: Een vermelding kan niet vaststellen of uw extraction schema, coding task of visual brief zal slagen.
Beschouw de laagst weergegeven prijs niet als het definitieve antwoord. Voor tekst, schat de input- en outputmix die uw applicatie produceert; voor media, inspecteer de aangevraagde generatieconfiguratie voordat u kosten vergelijkt.
Praktische regel: Kies een model pas nadat de limits, output quality en failure behavior voldoen aan de workload. Een goedkope aanvraag die een onbruikbaar resultaat oplevert, is geen nuttige besparing.
Prijzen en beschikbaarheid kunnen veranderen, dus noteer de identifier en configuratie die tijdens het testen zijn gebruikt, in plaats van uw shortlist te laten als een verzameling modelnamen.
2. OpenRouter
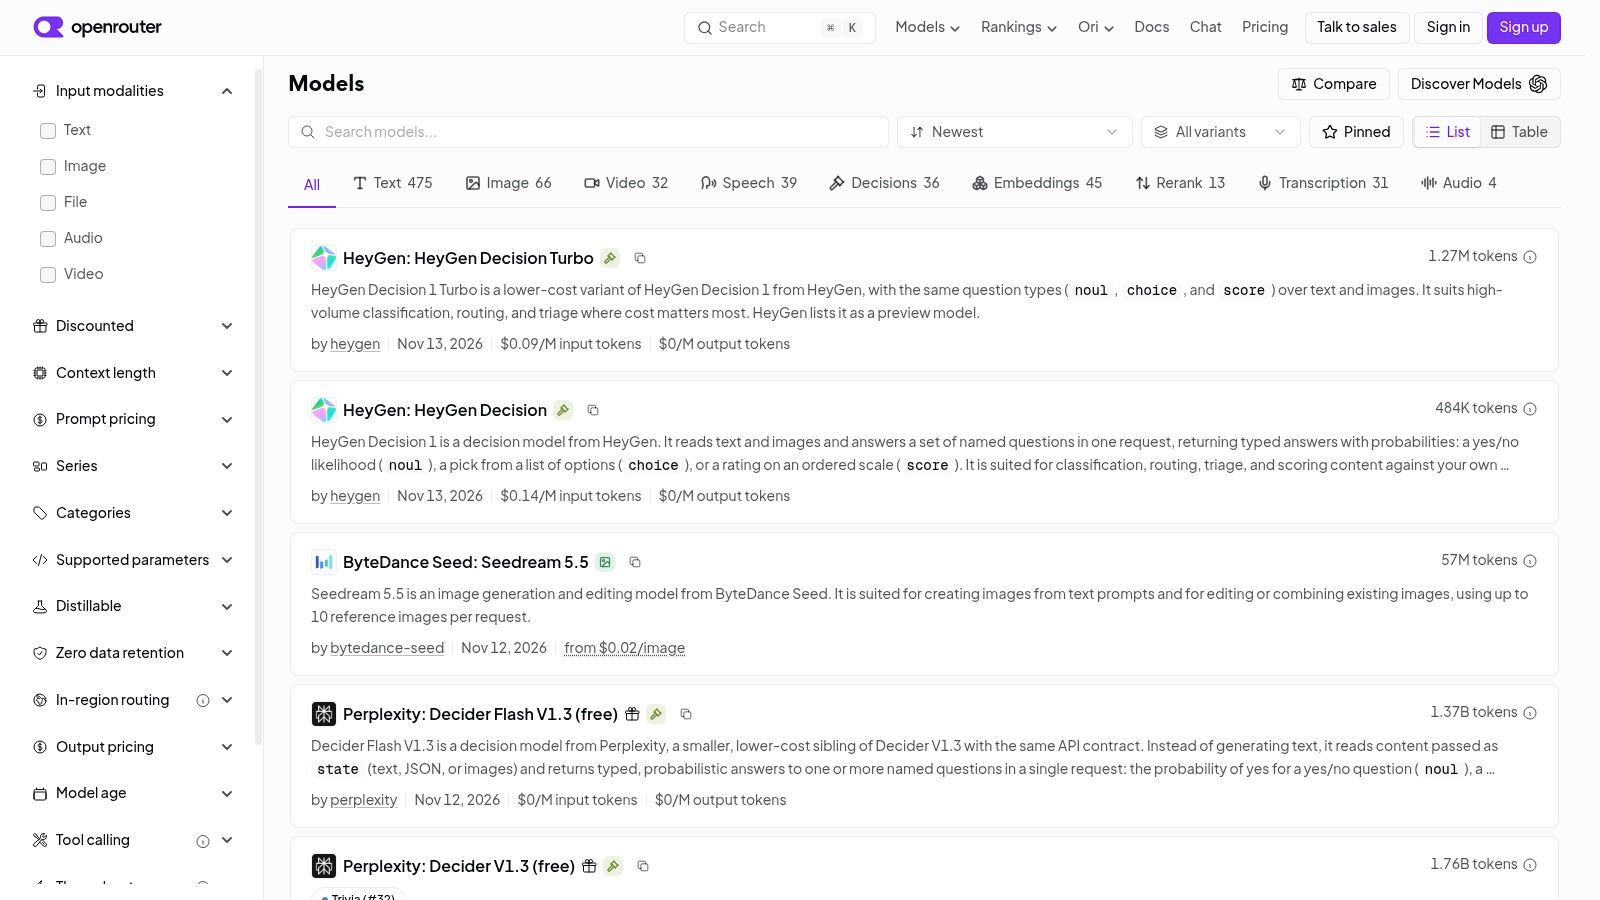
Als je directe taak is om gehoste modellen uit te proberen zonder afzonderlijke providerintegraties te bouwen, is de modelcatalogus van OpenRouter een praktisch startpunt. Het combineert doorzoekbare modelspecificaties met toegang via een gemeenschappelijke API.
De nuttige vergelijkingsvelden omvatten prijzen, contextlengte, modaliteiten en mogelijkheden. Deze helpen modellen te onderscheiden die enkel tekst accepteren van kandidaten die de aanvullende invoer of gedragingen ondersteunen die je applicatie vereist. Controleer de individuele modelpagina in plaats van aan te nemen dat elk model dat via dezelfde interface wordt aangeboden, dezelfde aanvraag accepteert.
Waar het past
OpenRouter is geschikt voor een ontwikkelaar die gehoste kandidaten vergelijkt binnen een bestaande applicatie. Je kunt het omringende evaluatiekader stabiel houden terwijl je het geselecteerde model wijzigt, hoewel ondersteunde parameters en uitvoergedrag nog steeds validatie vereisen.
- Wat werkt: Overgaan van ontdekking naar API-experimentatie zonder elke providerintegratie afzonderlijk te regelen.
- Wat niet werkt: De catalogus behandelen als een repository waar de gewichten van elk vermeld model kunnen worden gedownload.
- Wat te verifiëren: Huidige beschikbaarheid, modelspecifieke prijzen, contextlimieten en vereiste mogelijkheden.
Voor een coderingsagent, test tool-call argumenten en herstel na een mislukte tool-uitvoering, niet alleen de kwaliteit van een op zichzelf staand codeantwoord. Een gemeenschappelijke API maakt agentgedrag niet uitwisselbaar.
De vergelijking van OpenRouter-alternatieven is nuttig bij het evalueren van verschillende toegangsdiensten. Houd die beslissing gescheiden van modelselectie: het model en de dienst die het hosten introduceren verschillende operationele afwegingen.
3. Hugging Face Hub
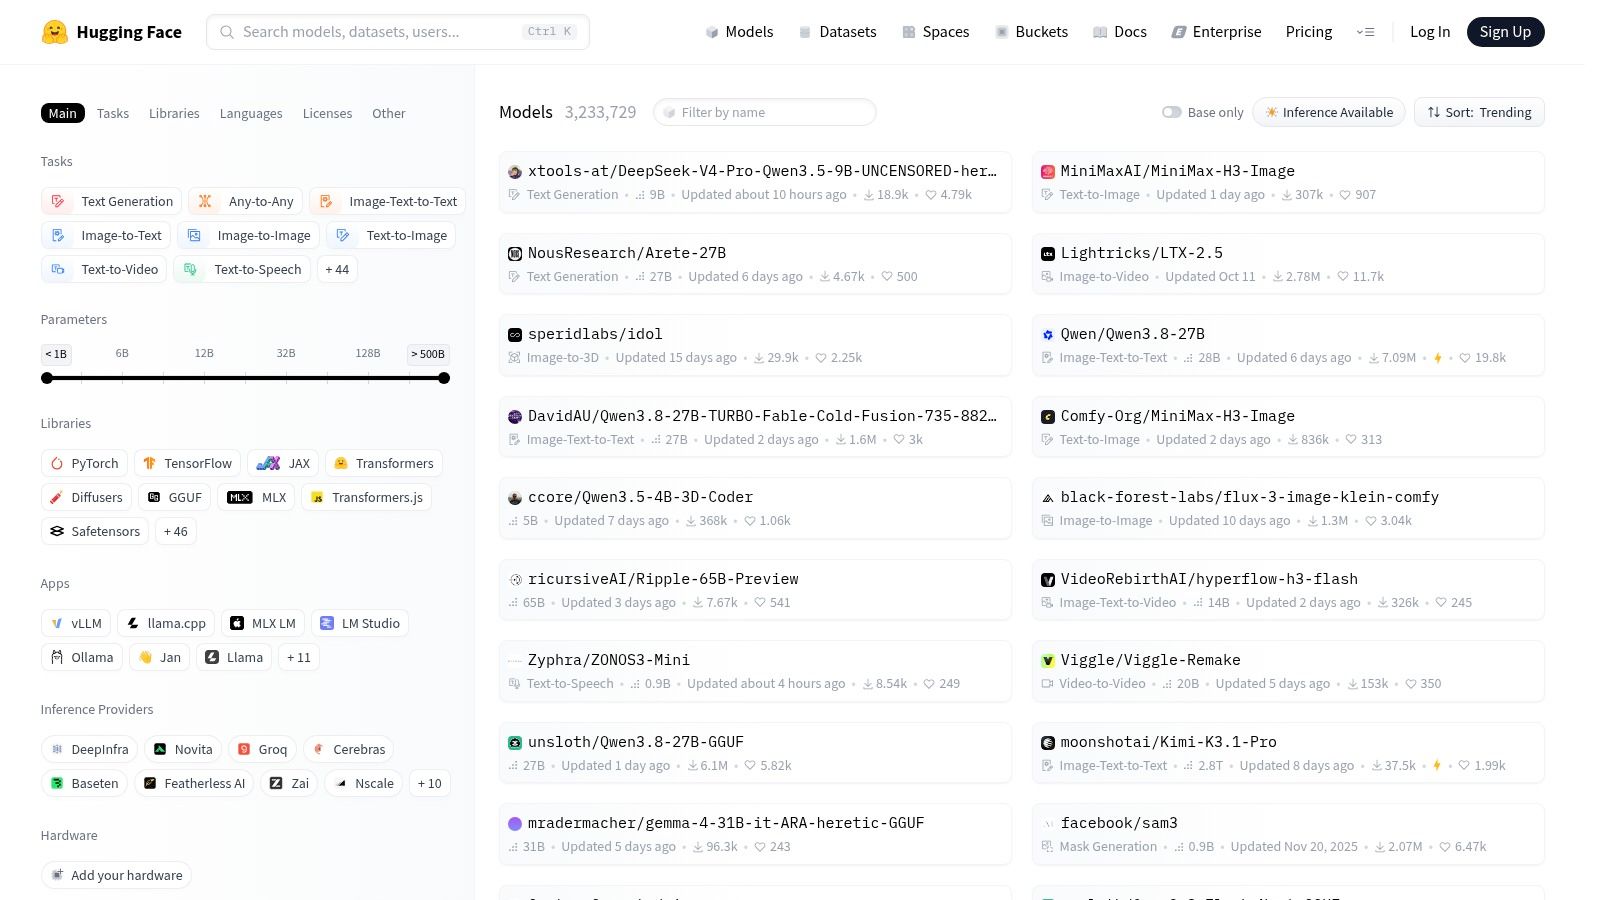
Begin met Hugging Face wanneer je weights nodig hebt, niet alleen een endpoint. De Hugging Face Hub is bijzonder nuttig voor het vinden van modellen die je zelf zou kunnen aanpassen, inspecteren of deployen.
De modelpagina's kunnen modelkaarten, downloadbare bestanden, implementatievoorbeelden en licentiegegevens combineren. Dat maakt het een ander soort bron dan een gehost API-menu: je onderzoekt het artefact en de vereisten ervan, niet alleen welke identifier je in een request moet sturen.
Lees verder dan de modelnaam
Controleer de taak, architectuur, het ondersteunde inference framework en de licentie voordat je downloadt. Inspecteer vervolgens of de voorbeelden overeenkomen met je beoogde gebruik, vooral voor fine-tuned modellen met gespecialiseerde prompt templates.
- Sterkte: Brede ontdekking voor tekst-, visie-, beeld- en audiotaken.
- Afweging: De kwaliteit van documentatie en evaluatie hangt af van de uitgever.
- Deployment beperking: Een downloadbaar model is niet automatisch beschikbaar als een beheerde API.
Een voorbeeld: een documentverwerkingsteam zou een veelbelovend visie-taalmodel kunnen vinden, maar moet nog steeds preprocessing, inference en outputvalidatie samenstellen. De repository helpt vast te stellen wat beschikbaar is; het neemt het deploymentwerk niet weg.
Open weights betekenen ook geen onbeperkt gebruik. Lees de daadwerkelijke licentie en bijbehorende voorwaarden in plaats van rechten af te leiden van de downloadknop.
Gebruik Hugging Face voor onderzoek en aanpassing wanneer toegang tot de onderliggende bestanden belangrijk is. Als je alleen gehoste responses wilt vergelijken vanmiddag, kan een API-catalogus je sneller naar een zinvolle test leiden.
4. Artificial Analysis
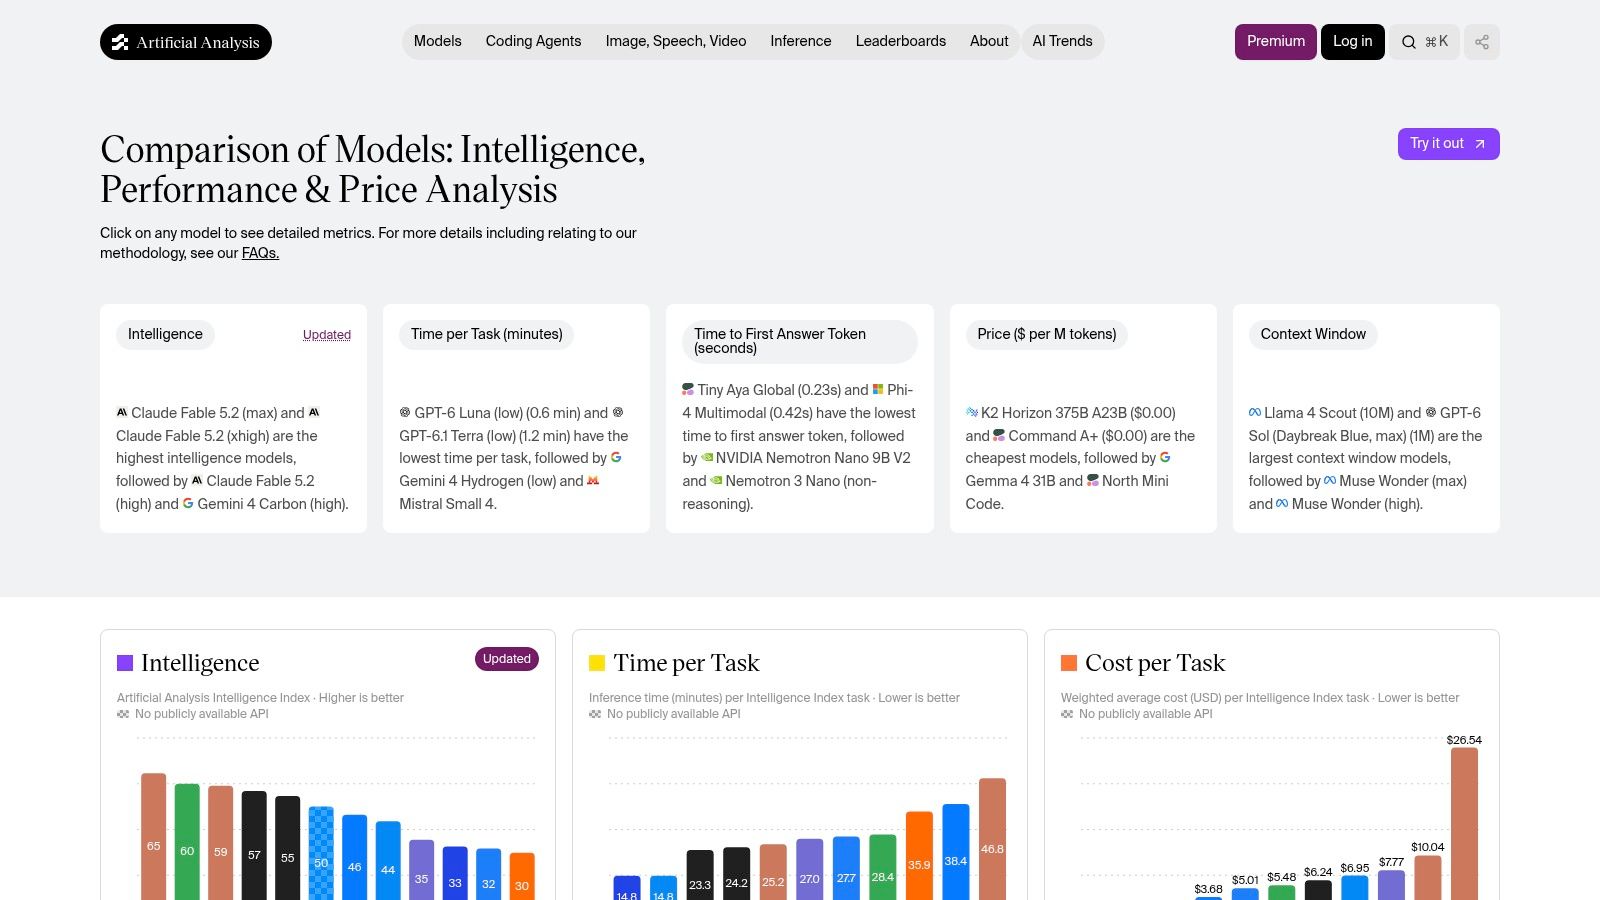
De moeilijke vraag is niet welk model de laagste geadverteerde tokenprijs heeft. Het is welke kandidaat voldoet aan jouw kwaliteitseisen tegen aanvaardbare totale kosten en voltooiingstijd.
Artificial Analysis vergelijkt modellen aan de hand van metingen, waaronder intelligentie, prijs, tijd per taak, latentie tot de eerste antwoord-token, en context-venstergrootte. De kosten-per-taak benadering is nuttiger voor het opstellen van een shortlist dan het afzonderlijk lezen van tokenprijzen, omdat het kosten koppelt aan een werklast.
Vergelijk de metriek die jouw gebruikers ervaren
Voor een interactieve assistent is de tijd tot de eerste token van belang, maar het vervangt de end-to-end voltooiingstijd niet. Voor een achtergrondextractietaak kunnen gevalideerde voltooiing en totale kosten belangrijker zijn dan de snelheid waarmee tekst voor het eerst verschijnt.
- Gebruik het voor: Het identificeren van afwegingen tussen capaciteit, kosten en snelheid vóór applicatietesten.
- Gebruik het niet voor: Aannemen dat een benchmarkleider zal winnen op jouw prompts of taal.
- Toegangswaarschuwing: Sommige datasets of functies vereisen mogelijk een account of betaalde toegang.
Vergelijk de kosten per succesvolle taak, niet alleen de kosten per verzoek. Neem herpogingen en afgewezen outputs mee in jouw eigen evaluatie.
De LLM prijsindex biedt een andere prijsreferentie bij het samenstellen van een shortlist. Houd de werklastaannames zichtbaar bij het vergelijken van welke index dan ook.
Artificial Analysis is niet de plek om elk model te downloaden of jouw applicatie te deployen. De taak ervan is om de shortlist te verbeteren, waarbij jouw eigen testomgeving moet bepalen of die kandidaten voldoen aan de productievereisten.
5. Replicate Explore
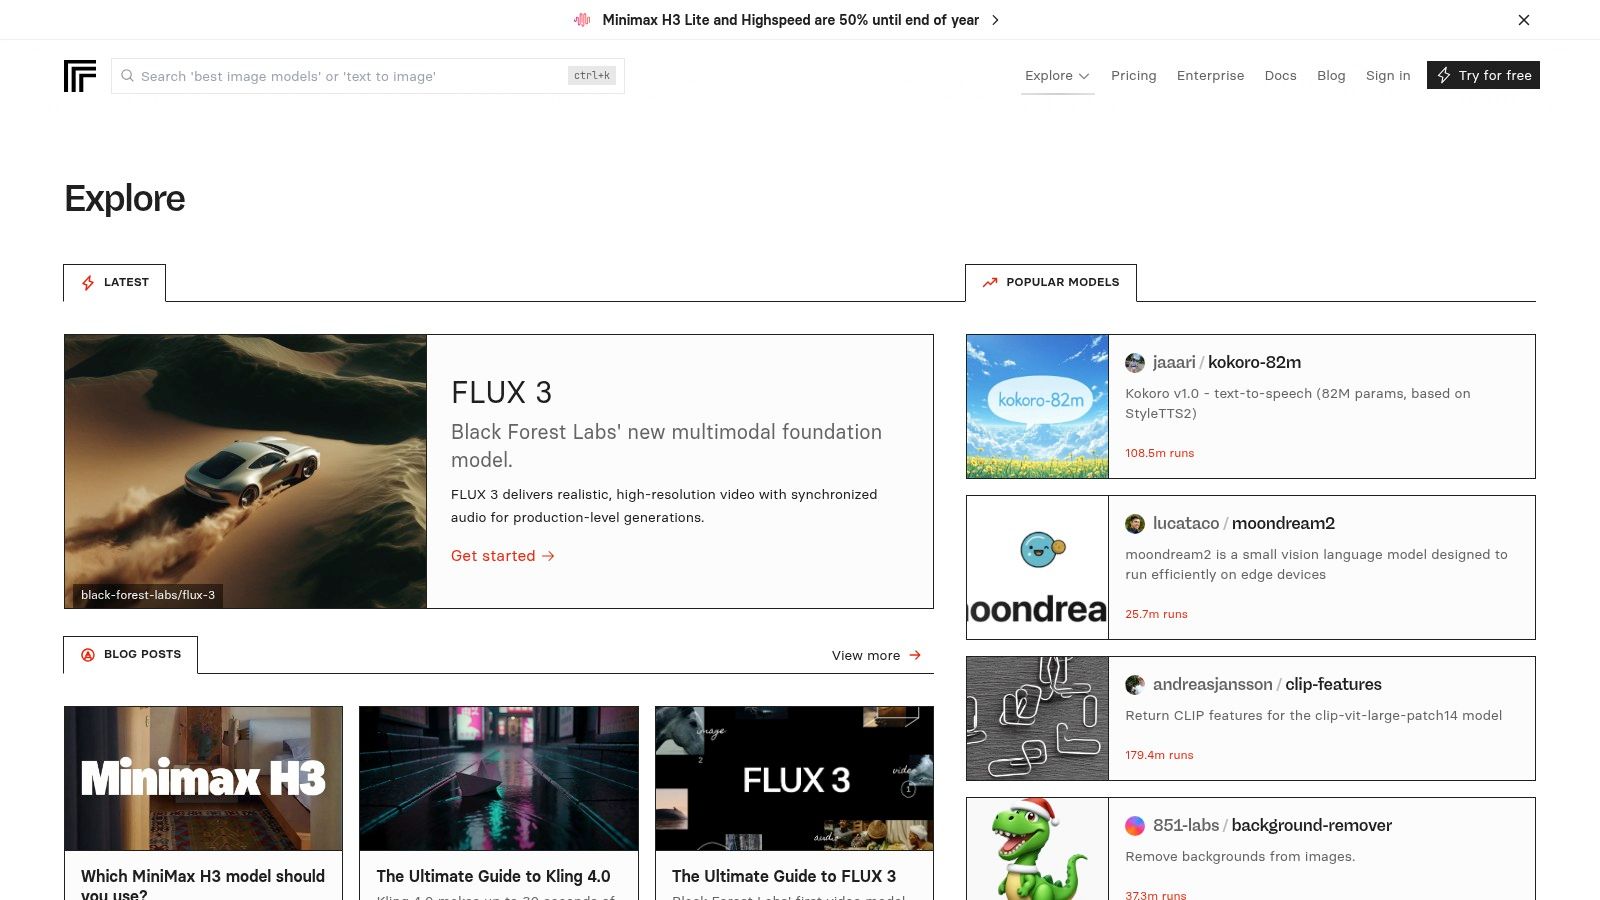
Het testen van een videomodel vereist meer dan het lezen van een leaderboard voor taalmodellen. Je moet geaccepteerde invoer, uitvoervoorbeelden, generatiecontroles en de manier waarop de applicatie een voltooid resultaat ophaalt inspecteren.
Replicate Explore is nuttig voor deze praktische ontdekking, met name voor beeld-, video- en audiogeneratie. Modelpagina's kunnen voorbeelden, invoerdefinities, gebruiksinstructies en prijzen bieden naast een gehost uitvoeringspad.
Test met je eigen bronmateriaal
Voor beeld-naar-video, gebruik een afbeelding die representatief is voor je applicatie, niet alleen de gepolijste voorbeelden van het model. Controleer de consistentie van het onderwerp, beweging, compositie en of de uitvoer de opdracht respecteert. Voor spraak, test namen, interpunctie en de talen die je gebruikers indienen.
- Sterkte: Je kunt experimenteren zonder eerst lokale inferentie in te stellen.
- Flexibiliteit: Aangepaste implementaties kunnen Cog gebruiken, de verpakkingstool van Replicate.
- Beperking: Door de community gepubliceerde modellen kunnen verschillen in onderhoud, documentatie en ondersteuning.
Controleer of een vermelding officieel en actief wordt onderhouden voordat je eromheen bouwt. Lees ook de factureringseenheid zorgvuldig, aangezien de modelprijzen kunnen afhangen van de looptijd of de gegenereerde uitvoer in plaats van een tokenberekening in tekststijl.
Replicate is een sterke keuze wanneer je moet zien of een generatief model acceptabele media kan produceren. Het is minder nuttig als een enkele genormaliseerde rangschikking over ongerelateerde modaliteiten: een spraakmodel en een videomodel hebben verschillende acceptatiecriteria nodig.
6. Microsoft Foundry Models
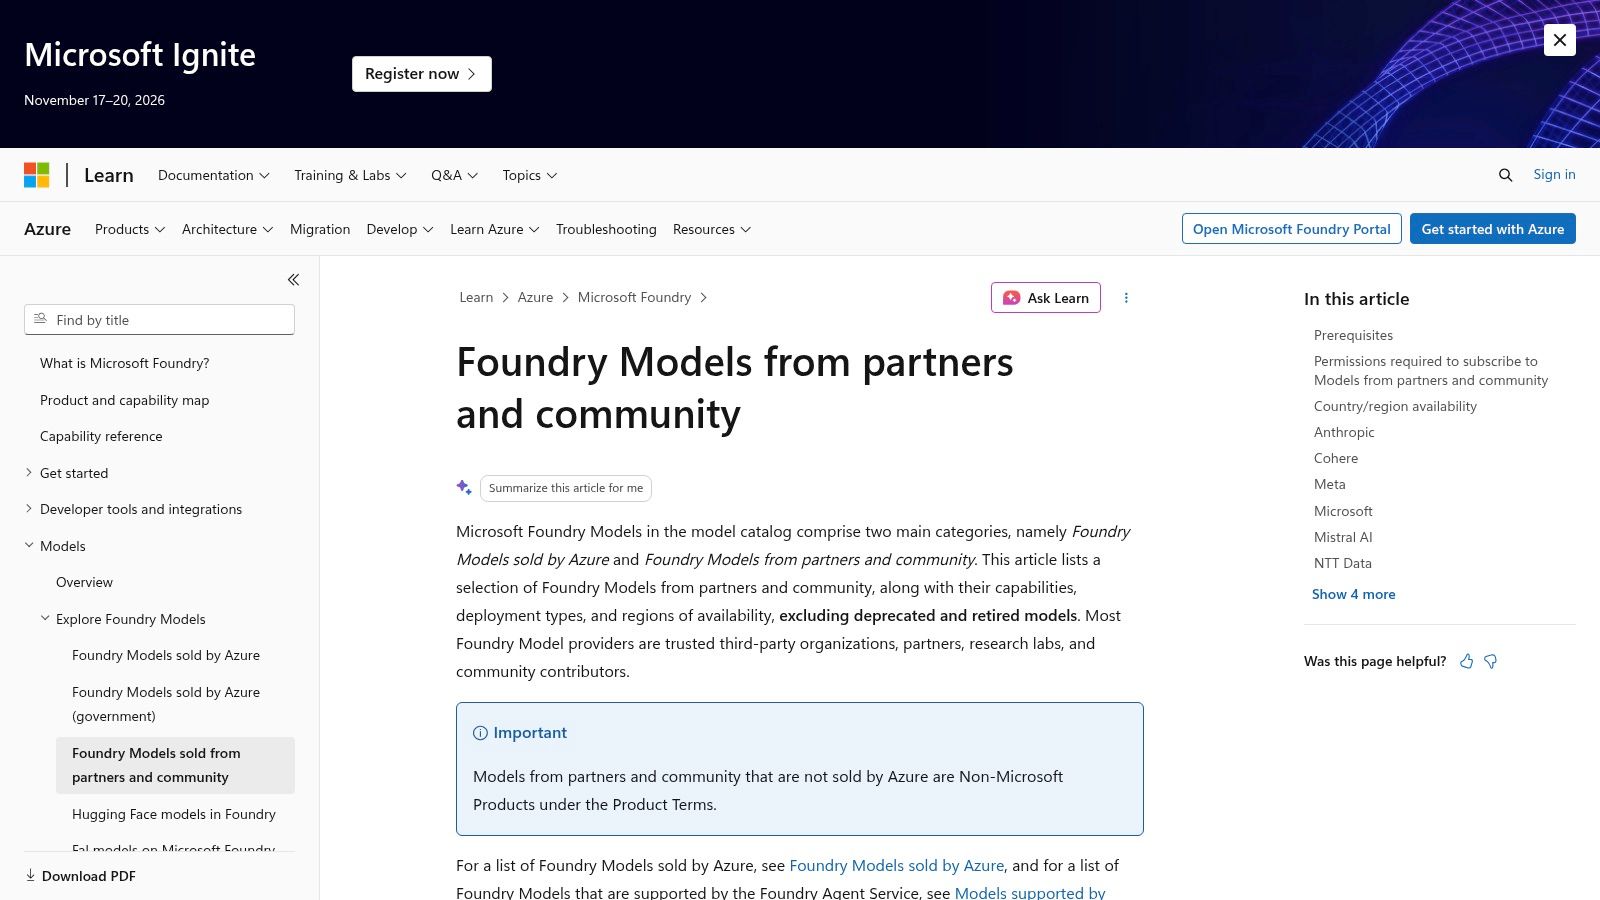
Voor een op Azure gebaseerde applicatie kan de geschiktheid voor implementatie net zo belangrijk zijn als de modelmogelijkheden. Een veelbelovende kandidaat is niet bruikbaar als de beschikbare implementatiemethode niet past bij uw architectuur of operationele regio.
Microsoft Foundry Models verbindt modelontdekking met de cloudomgeving van Microsoft. De catalogus omvat aanbiedingen van Microsoft, partners en de community, met informatie die relevant is voor taken, mogelijkheden, licenties en implementatiekeuzes.
Kies het implementatiepad naast het model
Geschikte modellen kunnen verschillende API-gebaseerde, batch-, provisioned- of managed-compute opties hebben. Ga er niet van uit dat het vinden van een model in de catalogus betekent dat elke hosting- en factureringsaanpak ervoor beschikbaar is.
- Geschikt voor: Teams die modelselectie moeten afstemmen op Azure-implementatiebeslissingen.
- Nuttige details: Modelspecifieke implementatie-informatie en geselecteerde benchmarkresultaten.
- Beperking: Beschikbaarheid, implementatiemethoden en prijzen kunnen verschillen per model en regio.
Een documentanalyse-team moet zowel de input support van het model als de endpoint configuratie die het zal implementeren onderzoeken. Het testen van een demonstratie-endpoint is niet voldoende als de productie een wezenlijk andere leveringsmethode zal gebruiken.
De catalogus is daarom zowel een architectuurbron als een ontdekkingstool. Gebruik het wanneer Azure-integratie een daadwerkelijke vereiste is, niet omdat een gewenst model daar toevallig verschijnt.
Voor provider-neutrale verkenning is een vergelijkingstool voor meerdere providers meestal een schoner startpunt. Keer terug naar Foundry wanneer u klaar bent om het praktische cloud-implementatiepad vast te stellen.
7. Amazon Bedrock modelcatalogus
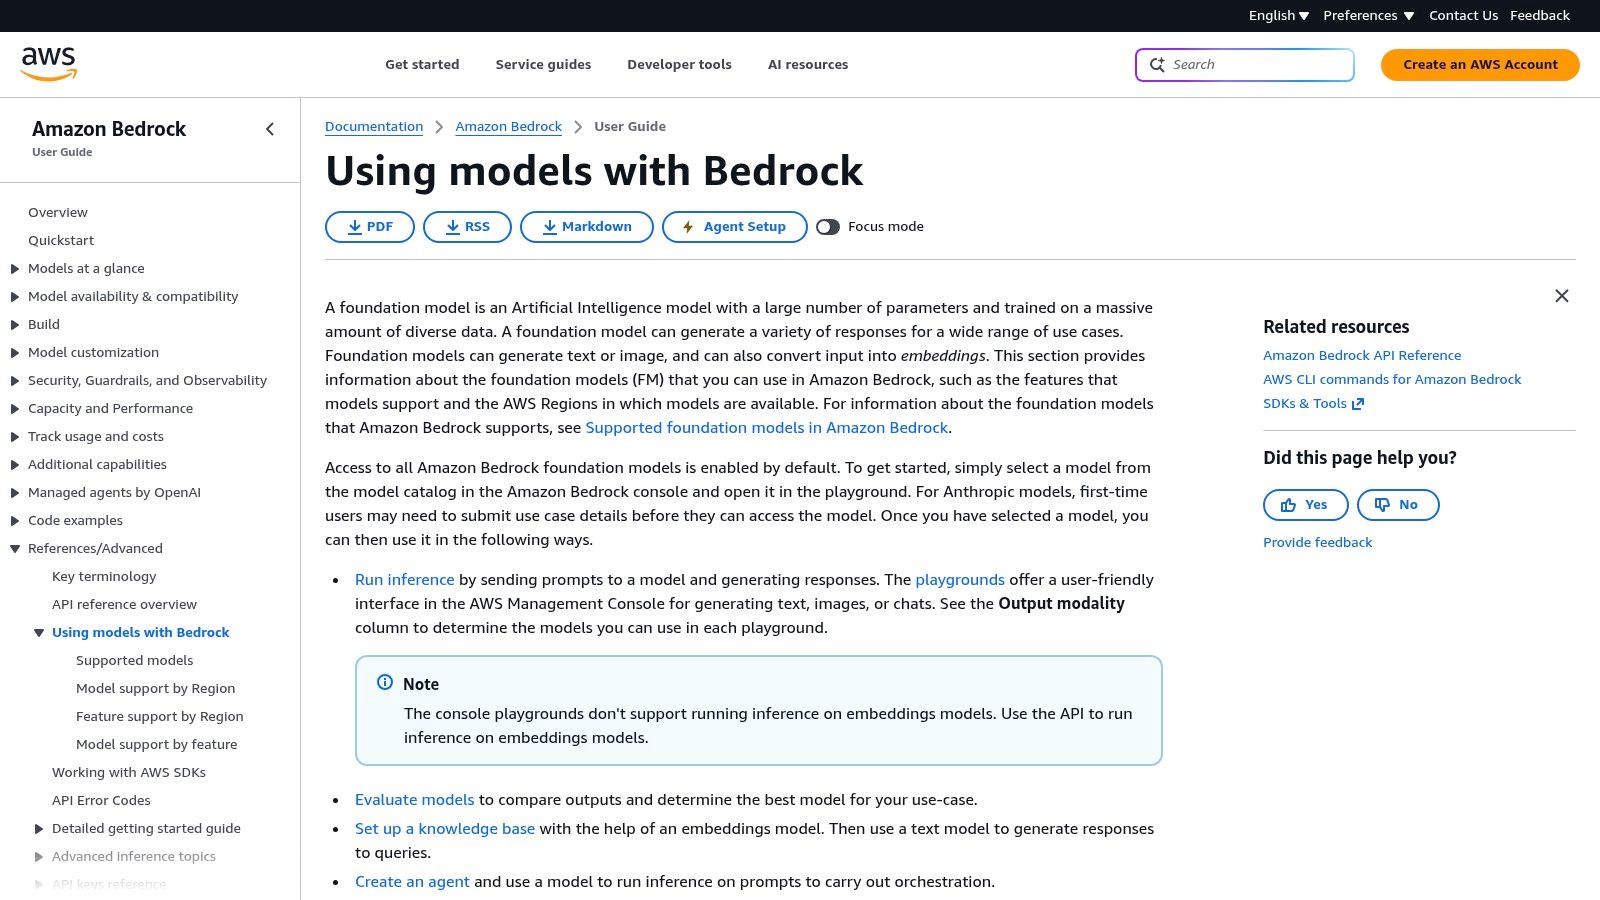
Controleer regionale beschikbaarheid voordat je het prototype bouwt. Dat is de meest nuttige gewoonte bij het gebruik van de Amazon Bedrock modelcatalogus voor een AWS-applicatie.
De catalogus identificeert ondersteunde foundation models en hun mogelijkheden. Teams kunnen de regionale beschikbaarheid inspecteren en geschikte models testen in de Bedrock console playground voordat ze deze integreren in een AWS-gebaseerde applicatie.
Inkoop en toegang maken deel uit van de keuze
Bedrock is bijzonder relevant wanneer de applicatie al binnen de AWS-infrastructuur opereert. Echter, accountinstellingen en regionale toegang kunnen beïnvloeden of het model dat je wilt bruikbaar is in de beoogde omgeving.
- Wat werkt: Overgaan van de ontdekking van ondersteunde models naar een AWS-implementatie.
- Wat te bevestigen: Accounttoegang, beoogde region, ondersteunde inputs en aanroepvereisten.
- Wat het niet is: Een neutrale inventaris van elk downloadbaar of commercieel verkrijgbaar AI model.
Voor een ondersteuningsassistent, test dezelfde retrieval passages en instructies die je van plan bent vanuit productie te versturen. Succes in de playground bevestigt dat een request kan werken; het bevestigt niet dat je retrieval pipeline, error handling en output parser correct zijn.
De kracht van Bedrock is de verbinding met de AWS-applicatiestack. Diezelfde oriëntatie is een beperking voor teams die alleen een breed overzicht van modelopties willen zonder zich te binden aan cloud-specifieke integratie.
Houd een record bij van het exacte model en de toegangsconfiguratie die bij de evaluatie zijn gebruikt. Een herkenbare model-familienaam is niet voldoende om een implementatiebeslissing te reproduceren.
8. Google Cloud Model Garden
Een team dat bouwt op Google Cloud moet het model en de bijbehorende serving-opstelling samen evalueren. Het vinden van de juiste modelfamilie is nog maar het begin; de implementatieconfiguratie bepaalt hoe het past bij de applicatie.
Google Cloud Model Garden biedt ontdekking van Google, externe en open modelaanbiedingen binnen de AI-omgeving van Google Cloud. Het is het meest nuttig wanneer de volgende stap cloud-gebaseerde ontwikkeling is, in plaats van het downloaden van een model voor een niet-gerelateerde lokale runtime.
Scheid ontdekking van implementatieaannames
Inspecteer het individuele aanbod voordat u de kosten of implementatie-inspanning schat. Beschikbaarheid en prijzen zijn afhankelijk van het model, de regio en de serviceconfiguratie, dus een catalogusvermelding alleen bepaalt de geschiktheid voor productie niet.
- Beste gebruik: Modellen verkennen voor een Google Cloud-applicatie.
- Voordeel: Google en geselecteerde externe aanbiedingen verschijnen binnen dezelfde cloud-georiënteerde ontdekkingsworkflow.
- Beperking: Het is minder handig voor een provider-neutraal overzicht of offline experimenten.
Voor een beeldanalyse-service, bevestig het geaccepteerde invoerformaat en test vervolgens de exacte preprocessing die uw applicatie uitvoert. Het wijzigen van de grootte, bijsnijden en documentconversie horen bij de evaluatie, niet alleen bij de uiteindelijke implementatie.
Verwar Model Garden niet met de smallere Gemini API-modellenlijst. De eerste helpt bij een bredere ontdekking van cloudmodellen; de laatste levert first-party details voor een specifiek API-ecosysteem.
Gebruik Model Garden zodra uw team weet dat Google Cloud deel uitmaakt van het implementatieplan. Anders, begin met de modelvereisten en voorkom dat een bestaande cloudconsole de shortlist voortijdig definieert.
9. Ollama Library
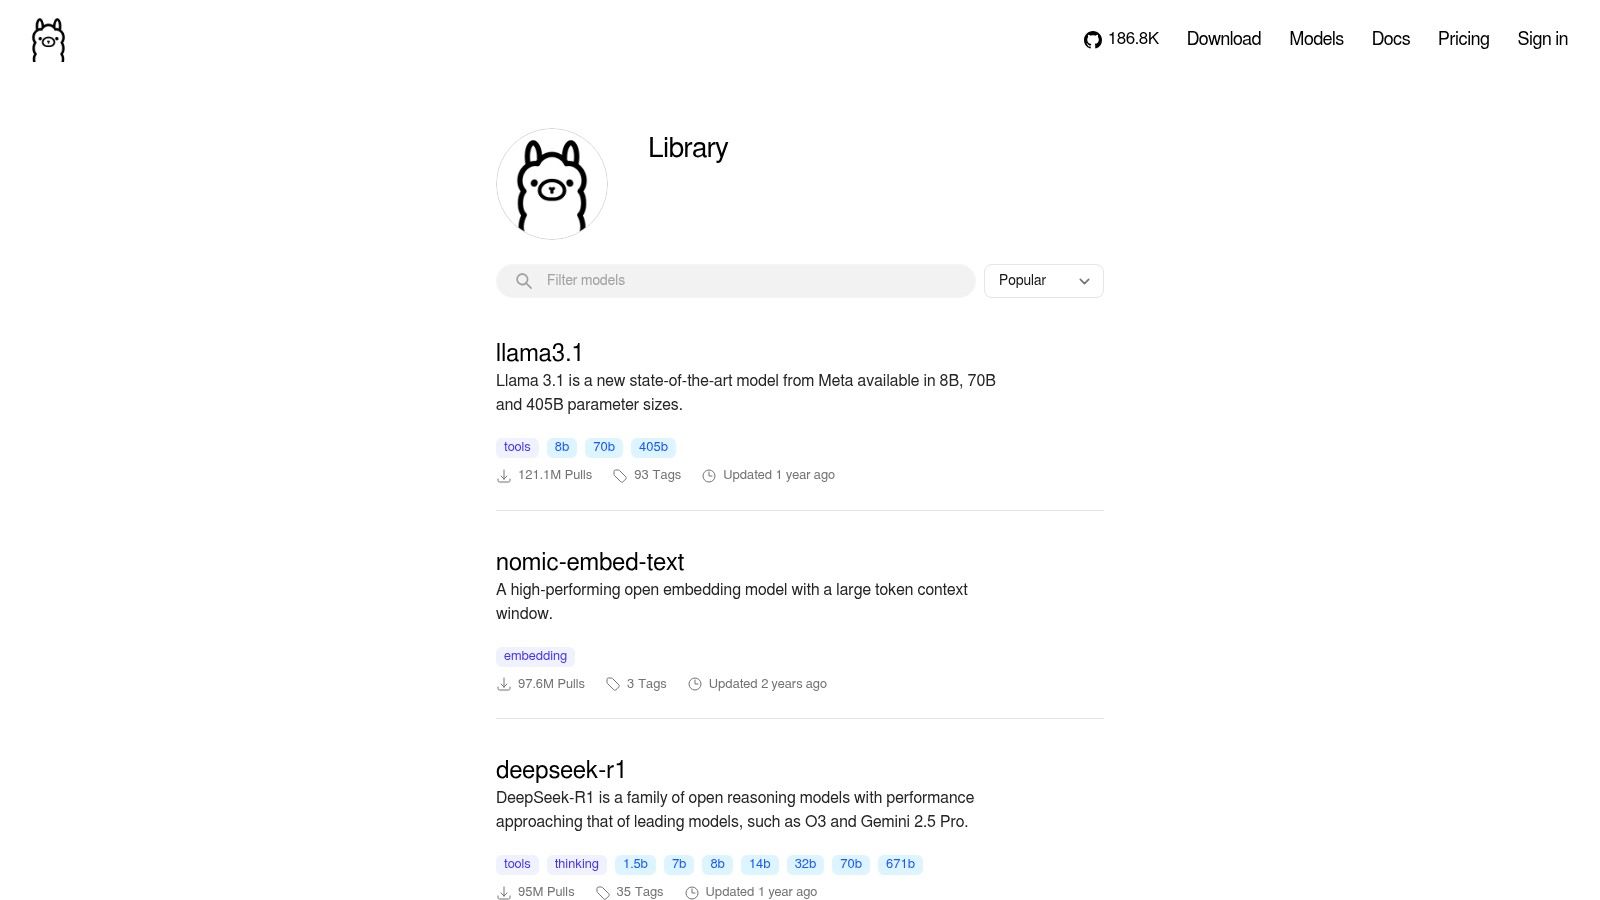
Als de vereiste is om een model op je eigen machine te draaien, begin dan met een runtime-georiënteerde catalogus in plaats van een gehoste API-marktplaats. De Ollama Library helpt gebruikers bij het vinden van ondersteunde modellen, groottes, varianten en mogelijkheden voor de lokale workflow van Ollama.
Modelgrootte is een nuttig eerste filter, maar het is geen volledige hardware-inschatting. Contextgebruik, runtime overhead en andere applicaties die om geheugen concurreren, beïnvloeden ook of de configuratie comfortabel draait.
Test de daadwerkelijke machine
Kies een kandidaat die bij je hardware past, en test deze vervolgens met representatieve invoerlengtes. Een model dat een korte chatprompt aankan, kan onpraktisch worden wanneer je opgehaalde documenten of een lang gesprek toevoegt.
Stanford's AI Index efficiëntiediscussie rapporteert dat Phi-3-mini, met 3.8 miljard parameters, dezelfde vermelde MMLU-drempel bereikte die voorheen 540 miljard parameters van PaLM vereiste. Die vergelijking ondersteunt een praktische les: het aantal parameters alleen is geen kwaliteitsrangschikking.
- Sterkte: Toegankelijke experimenten met lokaal uitvoerbare modellen.
- Kostenonderscheid: Lokale uitvoering vermijdt kosten voor het gebruik van gehoste API's, maar hardware en operatie kosten nog steeds geld.
- Beperking: Je machine en ondersteunde formaten beperken de shortlist.
Lokale uitvoering is niet automatisch een compleet offline systeem. Controleer of retrieval, logging, tools en andere applicatiecomponenten ook lokaal blijven.
Ollama is een nuttig startpunt voor offline prototypes en hardware-beperkte experimenten. Het elimineert de noodzaak niet om kwaliteit, geheugengebruik of end-to-end latency te valideren.
10. Google Gemini API-modellenlijst
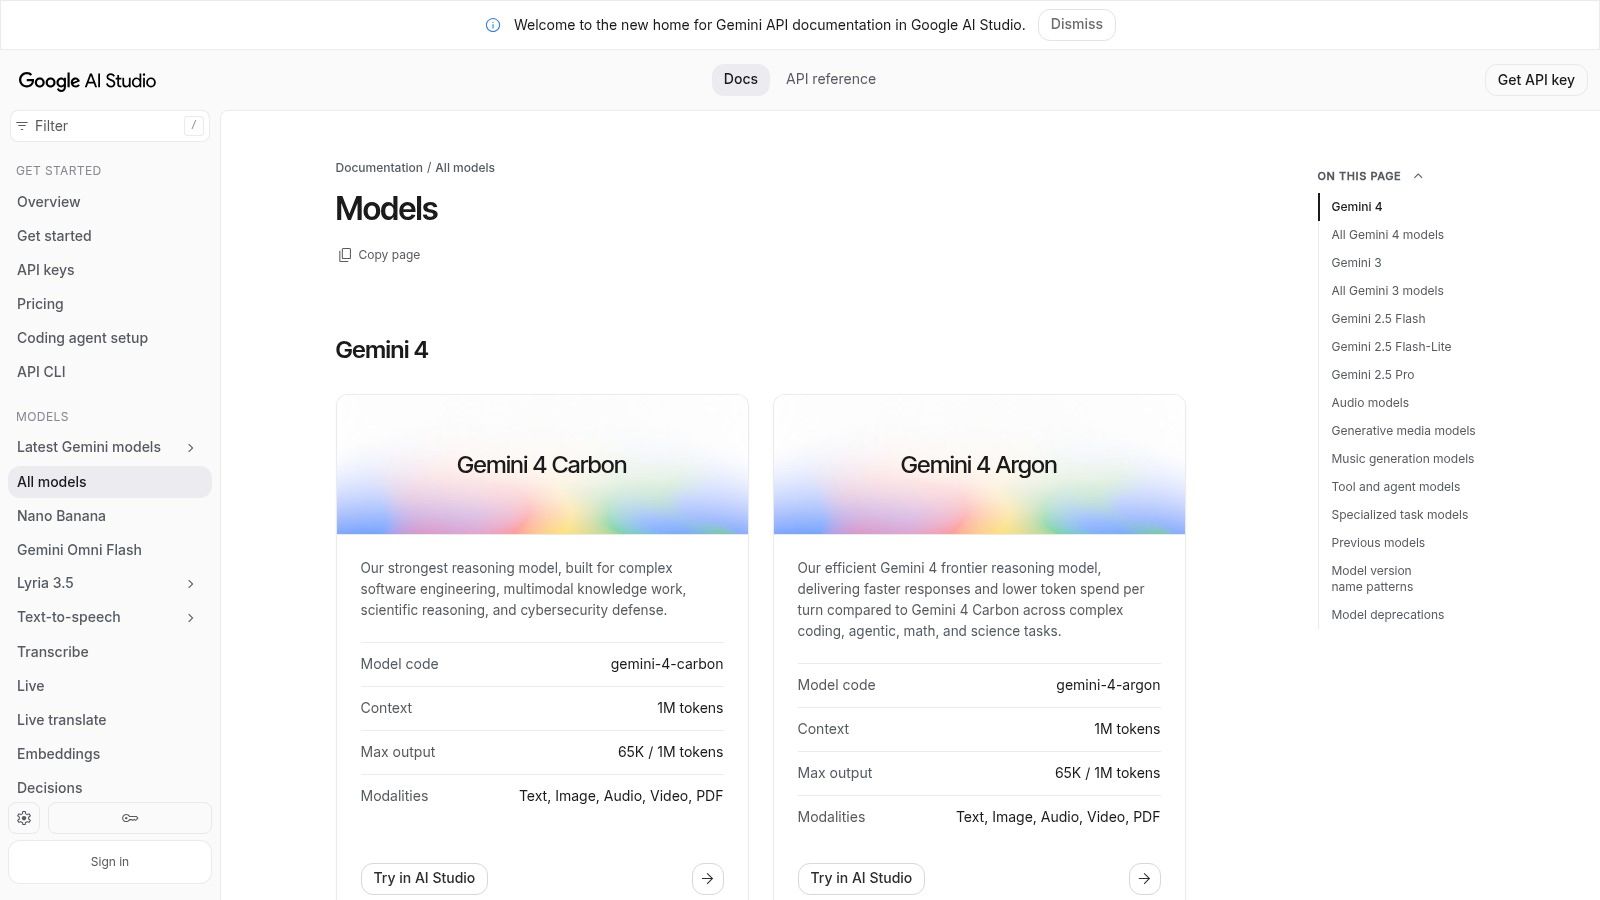
Soms is de juiste weg de smalste. Als je al voor de Gemini API hebt gekozen, gebruik dan de officiële Gemini API-modellenlijst om model-ID's, beschrijvingen en ondersteunde functionaliteiten te bevestigen.
Dit is eerstelijns implementatiedocumentatie, geen vergelijkingsdienst voor verschillende providers. Het verbindt modelontdekking met API-documentatie en Google AI Studio, waardoor het nuttig is wanneer je een gekozen modelfamilie wilt omzetten in een werkend verzoek.
Controleer de exacte ID
Bouw niet op basis van een modelfamilienaam die is gekopieerd uit een vergelijkingsartikel. Bevestig de specifieke ID en inspecteer de ondersteunde inputs, outputs en toegangscondities voordat je integreert.
- Sterkte: Directe modelinformatie voor ontwikkelaars die de Gemini API gebruiken.
- Bereikbeperking: Het helpt je niet om elke concurrerende provider te vergelijken.
- Commerciële kanttekening: Controleer de huidige prijzen, toegangsniveau en geschiktheidsvoorwaarden van het geselecteerde model.
Voor een audiogerelateerde applicatie, controleer of het specifieke model de vereiste audioworkflow ondersteunt, in plaats van aan te nemen dat elk Gemini-model identieke functionaliteit biedt. Pas dezelfde zorg toe op multimodale inputs en tool use.
Neem ook lifecycle checks op in je onderhoudsproces. De Veo en Gemini API-shutdowngids is relevant bij het beoordelen van endpoint-afhankelijkheden en migratiewerkzaamheden.
De officiële lijst kan het beste worden gebruikt als implementatiereferentie na een voorselectie. Het biedt de details die nodig zijn om een geldig verzoek te doen, terwijl je eigen evaluatie bepaalt of de geretourneerde resultaten voldoen aan de vereisten van het product.
Hoe de 10 Modelcatalogi Verschillen qua Toegang, Prijstransparantie en Limieten
| Item | Het Best Voor | Toegangsmodel | Prijstransparantie | Belangrijkste Beperking |
|---|---|---|---|---|
| UberLLM AI-modelcatalogus (Aanbevolen) | Modellen van verschillende providers vergelijken | Uniforme API en marktplaats | Live prijzen vermeld | Catalogi voorspellen geen workload-specifieke prestaties |
| OpenRouter | Modellen van verschillende providers vergelijken en openen | Gehoste API met één key | Modelprijzen getoond; controleer huidige tarieven | Gehoste API, geen downloadbare modelgewichten |
| Hugging Face Hub | Onderzoek, aanpassing en zelf-hosting | Modeldownloads; hosting varieert | Prijzen niet consistent vermeld | Modelkwaliteit en documentatie variëren |
| Artificial Analysis | Benchmarks, kosten en snelheid vergelijken | Onderzoeks- en vergelijkingsbron; data API | API-prijzen getoond; sommige toegang kan betaald zijn | Benchmarks weerspiegelen mogelijk niet uw workload |
| Replicate Explore | Gehoste generatieve modellen testen en uitvoeren | Gehoste model-API's en aangepaste implementaties | Modelspecifieke prijzen; kan variëren per gebruik | Kwaliteit en ondersteuning van communitymodellen variëren |
| Microsoft Foundry Models | Modellen selecteren voor Azure-applicaties | Azure-implementatieopties | Varieert per model en regio | Het meest geschikt voor Azure-gebruikers |
| Amazon Bedrock modelcatalogus | Modellen vinden voor AWS-applicaties | Bedrock-services binnen AWS | Varieert per model en regio | AWS- en regio-afhankelijke toegang |
| Google Cloud Model Garden | Modellen vinden voor Google Cloud-implementatie | Google Cloud AI-services | Varieert per model en configuratie | Gericht op Google Cloud |
| Ollama Library | Modellen lokaal uitvoeren | Lokale inferentie met Ollama | Geen gehoste prijs; gebruikt uw hardware | Vereist installatie en geschikte hardware |
| Google Gemini API-modellijst | Bouwen met Google-modellen | Gemini API en Google AI Studio | Aparte prijspagina; lagen variëren | Omvat alleen Google-modellen |
Een Shortlist Omzetten in een Werkende Integratie
Stop met zoeken zodra je twee of drie plausibele modellen per modaliteit hebt. Meer kandidaten helpen niet als je team niet heeft gedefinieerd hoe een acceptabel resultaat eruitziet. Noteer de vereiste contextlengte, uitvoerlimieten, toolondersteuning, invoerformaten en implementatiebeperkingen voordat je vergelijkingen uitvoert.
Stuur vervolgens de zelfde prompts of generatietaken door elke kandidaat. Voor tekstextractie, valideer het geretourneerde schema en vergelijk geëxtraheerde waarden met verwachte antwoorden. Voor codering, voer tests uit op de gegenereerde wijzigingen; voor media, beoordeel de uitvoer aan de hand van een consistente briefing in plaats van het meest indrukwekkende voorbeeld te kiezen.
Evalueer het complete applicatiepad
Neem het werk rondom inferentie mee. Documentconversie, retrieval, tooluitvoering, polling, retries en uitvoervalidatie kunnen allemaal bepalen of een verder capabel model bruikbaar is.
- Kwaliteit: Registreer geaccepteerde resultaten, niet slechts voltooide verzoeken.
- Latentie: Meet zowel de initiële respons als de end-to-end voltooiing waar relevant.
- Kosten: Inclusief retries, afgewezen generaties en noodzakelijke vervolgoproepen.
- Betrouwbaarheid: Test timeouts, onjuist geformatteerde uitvoer en onbeschikbare endpoints.
De Brookings discussie over AI-model evaluatie legt uit waarom benchmarkscores praktische overwegingen zoals latency, compute requirements, kosten en veiligheid kunnen weglaten. Je evaluatie moet deze overwegingen expliciet maken in plaats van een openbaar leaderboard te behandelen als een productie-acceptatietest.
Voor teams die één endpoint willen voor tekst-, beeld-, video- en audioworkflows, start de UberLLM-integratie door de base URL in je bestaande OpenAI- of Anthropic SDK-configuratie in te stellen op het compatibele API endpoint. Gebruik een UberLLM key en behoud de bestaande SDK interface en omliggende code, wissel vervolgens van kandidaten door de model identifier te wijzigen. Valideer de ondersteunde parameters van elke kandidaat en gebruik de juiste asynchrone taakworkflow voor media in plaats van aan te nemen dat elke modaliteit zich gedraagt als een streaming chatrespons.
Houd de beslissing reproduceerbaar
Sla de model identifier, promptversie, generatie-instellingen, evaluatie-inputs en acceptatieresultaten samen op. Dat verslag stelt een andere engineer in staat de test te herhalen en maakt latere modelwijzigingen gemakkelijker te beoordelen. Vermijd te vertrouwen op een niet-geversiede screenshot of een herinnerde indruk van uitvoerkwaliteit.
Kies een standaardmodel en definieer wanneer de applicatie moet escaleren of veilig moet falen. Een fallback is alleen nuttig als deze voldoet aan dezelfde essentiële vereisten, inclusief privacybeperkingen en toolondersteuning. De beste lijst met AI-modellen is degene die je helpt een verdedigbare integratiebeslissing te nemen, en vervolgens plaatsmaakt voor herhaalbare tests.
UberLLM verbindt ontwikkelaars met externe tekst-, beeld-, video-, muziek- en spraakmodellen via een uniforme API en prepaid saldo. Bezoek UberLLM om modellimieten en live prijzen te vergelijken, je shortlist te testen in de playground en de kandidaten te integreren die voldoen aan de vereisten van je applicatie.