Liste des modèles d'IA 2026 : 10 Options par cas d'utilisation
Parcourez cette liste pratique de modèles d'IA par modalité, capacité et cas d'utilisation, avec 10 catalogues comparés sur les prix, l'accès et les charges de travail les mieux adaptées.
Imaginez que votre équipe passe une semaine à lire des pages de modèles, à comparer les prix des tokens et à câbler un prototype. Puis quelqu'un télécharge un document représentatif et découvre que le candidat le moins cher ne peut pas faire tenir le document, les instructions et la réponse attendue dans sa fenêtre de contexte. L'intégration fonctionne. Le choix du modèle, non.
Un catalogue de modèles n'est pas la même chose qu'un choix de modèle. Certains catalogues vous aident à découvrir des poids téléchargeables. D'autres comparent les performances mesurées, vendent de l'inférence hébergée, connectent des modèles à l'approvisionnement cloud ou packagent des modèles pour une exécution locale. Les traiter comme interchangeables fait perdre du temps et peut masquer la contrainte qui détermine si votre application fonctionne.
Une liste de modèles d'IA utile devrait vous dire par où commencer pour un travail particulier :
- Découvrir et personnaliser des modèles : Utilisez un répertoire avec des fiches de modèle, des fichiers et des informations de licence.
- Comparer les candidats pour la production : Utilisez des mesures indépendantes, puis testez votre propre charge de travail.
- Appeler des modèles hébergés : Utilisez un catalogue d'API avec des identifiants de modèle explicites et des détails de déploiement.
- Exécuter hors ligne : Utilisez un catalogue d'exécution local et vérifiez les exigences matérielles.
Pour les applications textuelles, la longueur du contexte et le support des outils peuvent éliminer des candidats immédiatement. Pour les applications d'image, de vidéo et d'audio, les entrées prises en charge, les contrôles de sortie et la gestion des tâches asynchrones méritent une attention égale. Les options ci-dessous servent des objectifs différents, de sorte que le bon point de départ dépend moins du catalogue qui semble le plus grand et plus de ce que vous devez faire ensuite.
Table des matières
- 1. Catalogue de modèles d'IA UberLLM
- 2. OpenRouter
- 3. Hugging Face Hub
- 4. Artificial Analysis
- 5. Replicate Explore
- 6. Microsoft Foundry Models
- 7. Catalogue de modèles Amazon Bedrock
- 8. Google Cloud Model Garden
- 9. Ollama Library
- 10. Liste des modèles de l'API Google Gemini
- Comment les 10 catalogues de modèles diffèrent par l'accès, la visibilité des prix et les limites
- Transformer une liste restreinte en une intégration fonctionnelle
1. Catalogue de modèles d'IA UberLLM
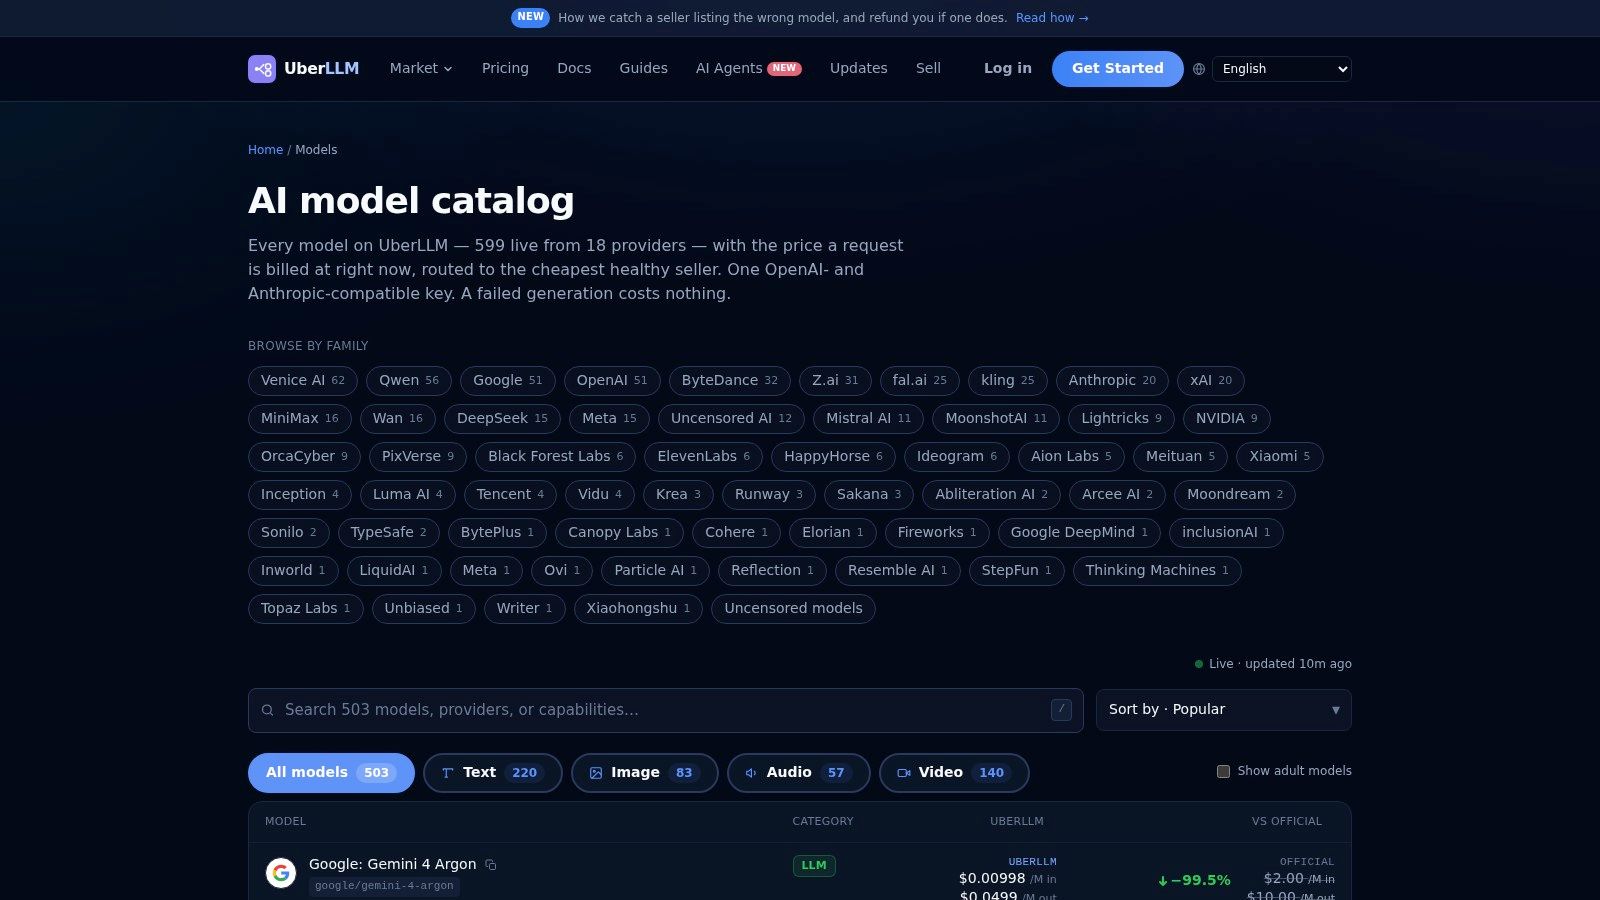
Idéal pour comparer les options hébergées avant d'intégrer une API de marketplace. Le catalogue de modèles d'IA UberLLM rassemble 457 modèles sur une page de comparaison avec les prix en direct, les noms des fournisseurs, les longueurs de contexte et les types de modèles. Il est utile lorsque votre présélection couvre le texte et les médias plutôt qu'une seule famille de modèles.
Chez UberLLM, nous connectons ce processus de découverte à un endpoint compatible OpenAI et Anthropic. Les développeurs sélectionnent un identifiant de modèle, tandis que le routage de la marketplace sélectionne un vendeur disponible pour le modèle demandé. Cette distinction est importante : vous choisissez à la fois les capacités d'un modèle et un chemin d'accès hébergé.
Ce qu'il faut inspecter avant de choisir
Pour le traitement de documents, comparez séparément la longueur de contexte et le nombre maximal de tokens de sortie. Un modèle qui accepte votre matériel source pourrait tout de même avoir une limite de sortie qui l'empêche de générer le résultat complet. Nos métadonnées de modèle exposent les deux champs, et le catalogue marque les modèles qui prennent en charge les outils.
- Point fort : Les prix en direct et les noms des fournisseurs rendent la présélection multi-fournisseurs moins fragmentée.
- Flux de travail utile : Filtrez par modalité, inspectez les limites, puis comparez les sorties représentatives dans le playground.
- Limitation : Une liste ne peut pas établir si votre schéma d'extraction, votre tâche de codage ou votre brief visuel réussira.
Ne considérez pas le prix le plus bas affiché comme la réponse finale. Pour le texte, estimez le mélange d'entrée et de sortie que votre application produit ; pour les médias, inspectez la configuration de génération demandée avant de comparer les coûts.
Règle pratique : Choisissez un modèle seulement après que ses limites, sa qualité de sortie et son comportement en cas d'échec satisfont la charge de travail. Une requête bon marché qui produit un résultat inutilisable n'est pas une économie utile.
Les prix et la disponibilité peuvent changer, alors enregistrez l'identifiant et la configuration utilisés lors des tests plutôt que de laisser votre présélection comme une collection de noms de modèles.
2. OpenRouter
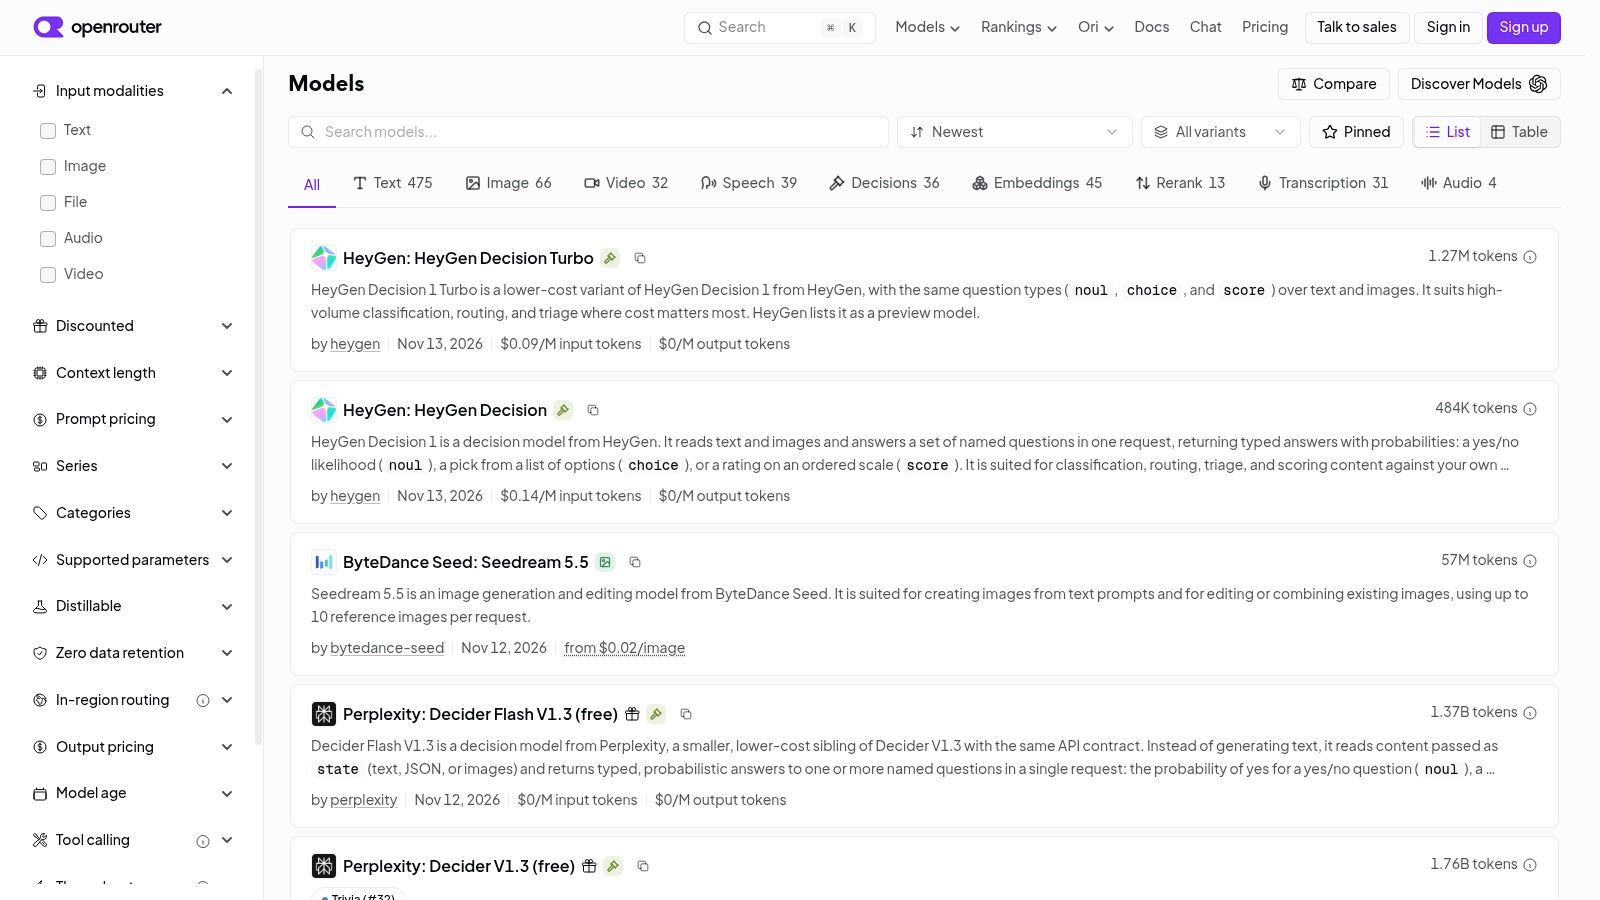
Si votre tâche immédiate est d'essayer des modèles hébergés sans construire d'intégrations de fournisseurs séparées, le catalogue de modèles d'OpenRouter est un point de départ pratique. Il combine des spécifications de modèles consultables avec un accès via une API commune.
Les champs de comparaison utiles incluent le pricing, la context length, les modalities et les capabilities. Ceux-ci aident à distinguer les modèles qui acceptent simplement du texte des candidats qui prennent en charge les entrées ou comportements supplémentaires requis par votre application. Consultez la page de chaque modèle plutôt que de supposer que chaque modèle exposé via la même interface accepte la même requête.
Où il s'intègre
OpenRouter convient à un développeur comparant des candidats hébergés au sein d'une application existante. Vous pouvez maintenir stable le cadre d'évaluation environnant tout en changeant le modèle sélectionné, bien que les paramètres pris en charge et le comportement de sortie nécessitent toujours une validation.
- Ce qui fonctionne : Passer de la découverte à l'expérimentation d'API sans organiser chaque intégration de fournisseur séparément.
- Ce qui ne fonctionne pas : Traiter le catalogue comme un dépôt où les poids de chaque modèle listé peuvent être téléchargés.
- Ce qu'il faut vérifier : La disponibilité actuelle, le pricing spécifique au modèle, les limites de context et les capabilities requises.
Pour un agent de codage, testez les arguments d'appel d'outil et la récupération après une exécution d'outil échouée, pas seulement la qualité d'une réponse de code autonome. Une API commune ne rend pas le comportement de l'agent interchangeable.
La comparaison des alternatives à OpenRouter est utile lors de l'évaluation de différents services d'accès. Gardez cette décision séparée de la sélection du modèle : le modèle et le service qui l'héberge introduisent des compromis opérationnels différents.
3. Hugging Face Hub
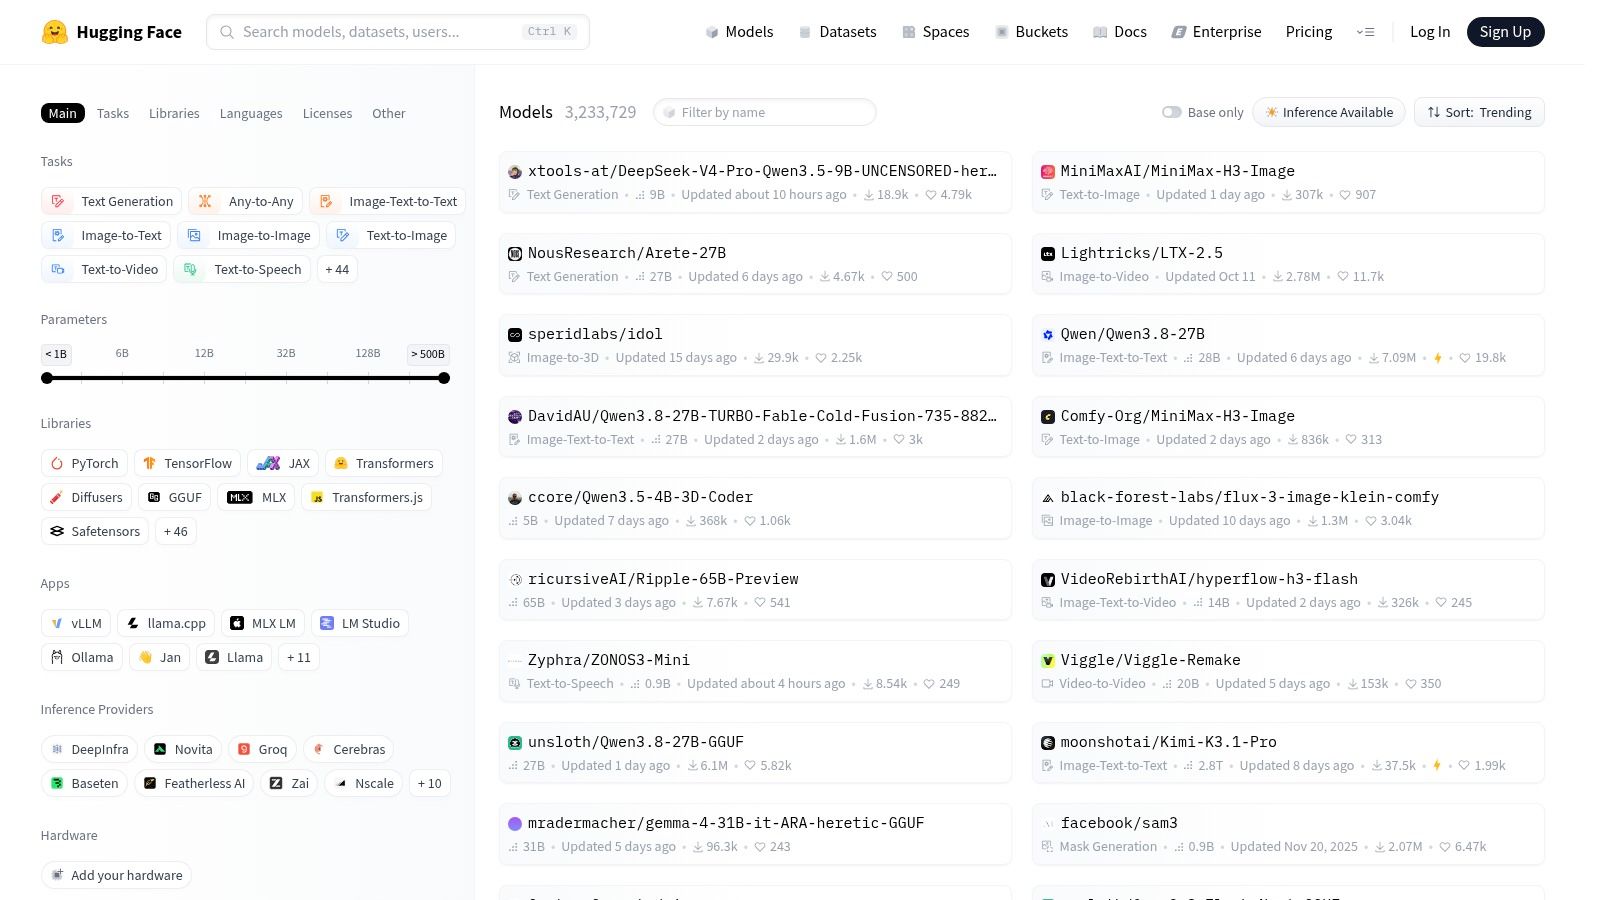
Commencez par Hugging Face lorsque vous avez besoin de weights, pas seulement d'un endpoint. Le Hugging Face Hub est particulièrement utile pour trouver des modèles que vous pourriez personnaliser, inspecter ou déployer vous-même.
Ses pages de modèles peuvent combiner des model cards, des fichiers téléchargeables, des exemples d'implémentation et des détails de licence. Cela en fait un type de ressource différent d'un menu d'API hébergée : vous étudiez l'artefact et ses exigences, pas seulement en décidant quel identifiant envoyer dans une requête.
Lisez au-delà du nom du modèle
Vérifiez la tâche, l'architecture, le framework d'inférence pris en charge et la licence avant de télécharger. Ensuite, vérifiez si les exemples correspondent à votre utilisation prévue, en particulier pour les modèles fine-tuned avec des prompt templates spécialisés.
- Point fort : Large découverte à travers les tâches de texte, vision, image et audio.
- Compromis : La qualité de la documentation et de l'évaluation dépend de l'éditeur.
- Contrainte de déploiement : Un modèle téléchargeable n'est pas automatiquement disponible en tant qu'API gérée.
Par exemple, une équipe de traitement de documents pourrait trouver un modèle vision-langage prometteur mais aurait toujours besoin d'assembler le preprocessing, l'inference et la validation de sortie. Le repository aide à établir ce qui est disponible ; il ne supprime pas le travail de déploiement.
Les open weights ne signifient pas non plus une utilisation illimitée. Lisez la licence réelle et les conditions associées plutôt que d'inférer les permissions à partir du bouton de téléchargement.
Utilisez Hugging Face pour la recherche et la personnalisation lorsque l'accès aux fichiers sous-jacents est important. Si vous avez seulement besoin de comparer des réponses hébergées cet après-midi, un catalogue d'API pourrait vous mener à un test significatif plus rapidement.
4. Artificial Analysis
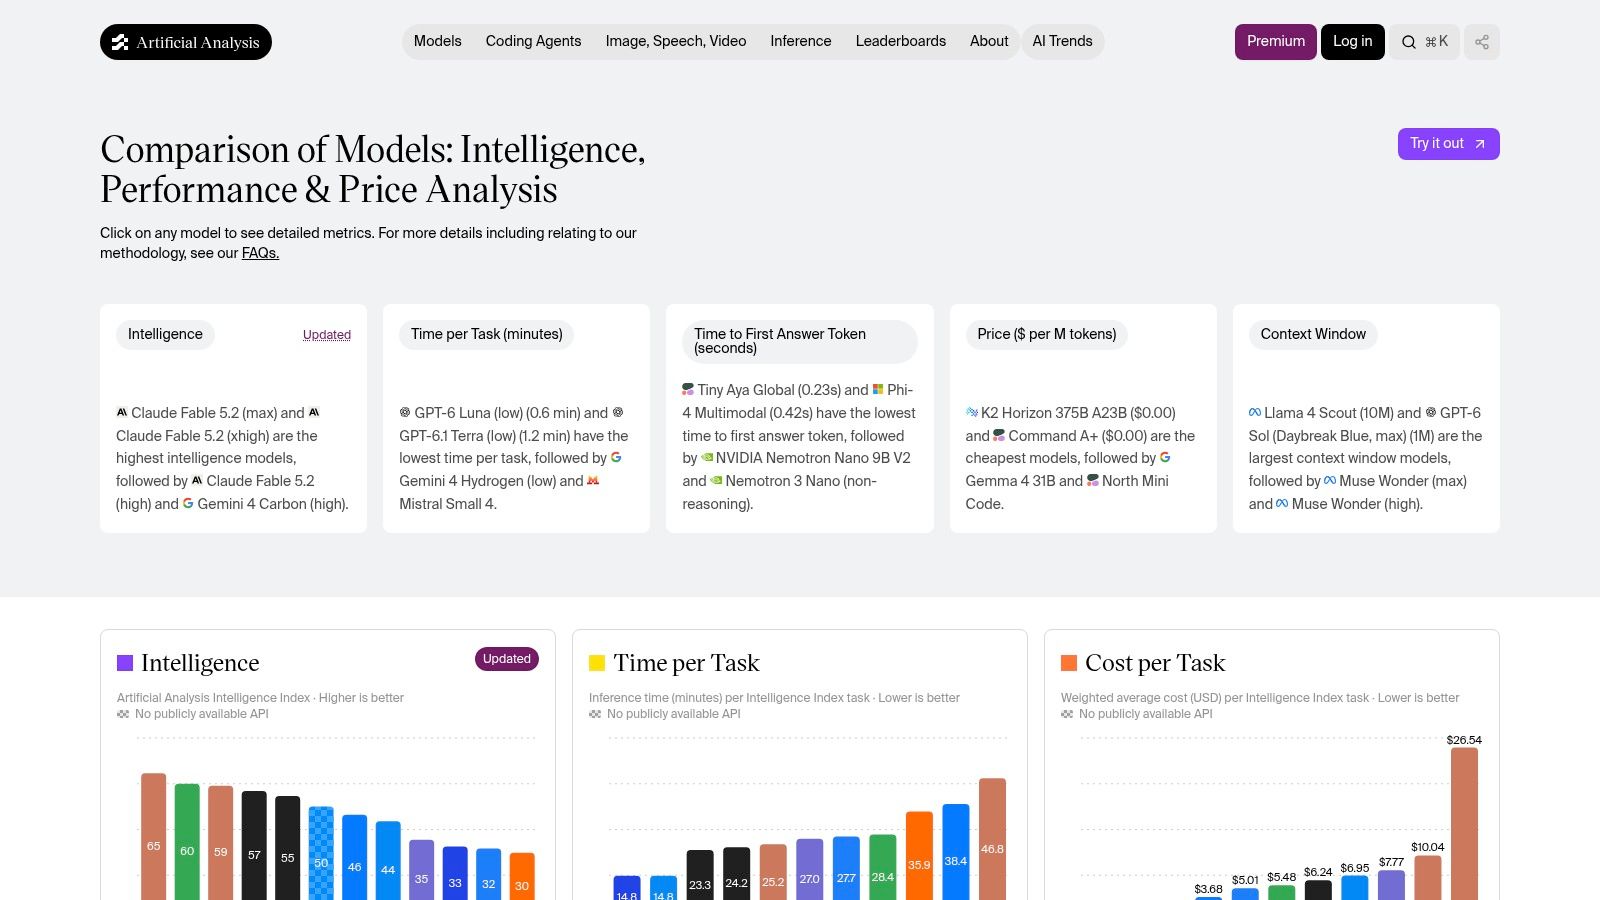
La question difficile n'est pas quel modèle a le prix de token annoncé le plus bas. C'est quel candidat répond à votre exigence de qualité à un coût total et un temps d'achèvement acceptables.
Artificial Analysis compare les modèles en utilisant des mesures incluant l'intelligence, le prix, le temps par tâche, la latence jusqu'au premier token de réponse, et la taille de la fenêtre de contexte. Son approche de coût par tâche est plus utile pour la présélection que de lire les prix des tokens isolément car elle relie les coûts à une charge de travail.
Comparez la métrique vécue par vos utilisateurs
Pour un assistant interactif, le temps jusqu'au premier token compte, mais il ne remplace pas le temps d'achèvement de bout en bout. Pour un travail d'extraction en arrière-plan, l'achèvement validé et la dépense totale peuvent importer plus que la vitesse à laquelle le texte apparaît pour la première fois.
- Utilisez-le pour : Identifier les compromis entre capacité, coût et vitesse avant les tests d'application.
- Ne l'utilisez pas pour : Supposer qu'un leader de benchmark gagnera sur vos prompts ou votre langue.
- Mise en garde concernant l'accès : Certains ensembles de données ou fonctionnalités peuvent nécessiter un compte ou un accès payant.
Comparez le coût par tâche réussie, pas seulement le coût par requête. Incluez les tentatives et les sorties rejetées dans votre propre évaluation.
Le LLM price index fournit une autre référence de prix lors de l'établissement d'une présélection. Gardez les hypothèses de charge de travail visibles lors de la comparaison de tout indice.
Artificial Analysis n'est pas l'endroit pour télécharger chaque modèle ou déployer votre application. Son rôle est d'améliorer la présélection, laissant votre propre banc d'essai déterminer si ces candidats répondent aux exigences de production.
5. Replicate Explore
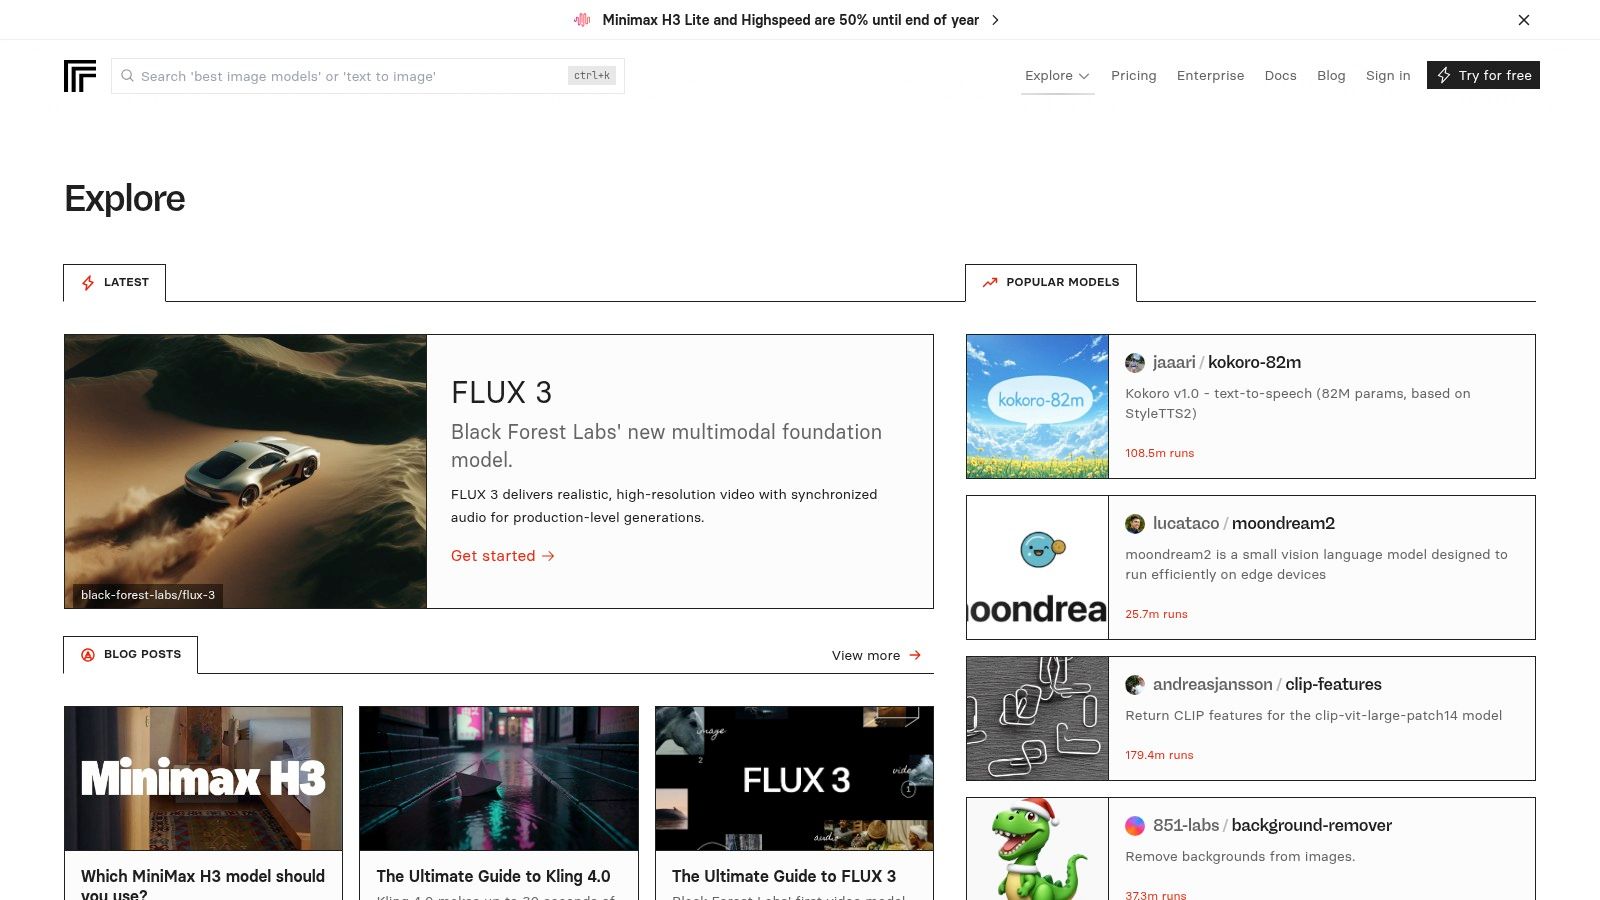
Tester un modèle vidéo demande plus que la lecture d'un classement de modèles de langage. Vous devez examiner les entrées acceptées, les exemples de sortie, les contrôles de génération et la manière dont l'application récupère un résultat complet.
Replicate Explore est utile pour cette découverte pratique, en particulier pour la génération d'images, de vidéos et d'audio. Les pages des modèles peuvent fournir des exemples, des définitions d'entrée, des instructions d'utilisation et des tarifs ainsi qu'un chemin d'exécution hébergé.
Testez avec votre propre matériel source
Pour l'image-vers-vidéo, utilisez une image représentative de votre application, pas seulement les exemples peaufinés du modèle. Vérifiez la cohérence du sujet, le mouvement, la composition et si la sortie respecte le cahier des charges. Pour la parole, testez les noms, la ponctuation et les langues que vos utilisateurs soumettent.
- Point fort : Vous pouvez expérimenter sans avoir à configurer l'inférence locale au préalable.
- Flexibilité : Les déploiements personnalisés peuvent utiliser Cog, l'outil de packaging de Replicate.
- Limitation : Les modèles publiés par la communauté peuvent différer en termes de maintenance, de documentation et de support.
Vérifiez si une annonce est officielle et activement maintenue avant de construire autour. Lisez également attentivement l'unité de facturation, car la tarification du modèle peut dépendre du temps d'exécution ou du résultat généré plutôt que d'un calcul de token de style texte.
Replicate est un excellent choix lorsque vous avez besoin de voir si un modèle génératif peut produire des médias acceptables. Il est moins utile comme classement normalisé unique à travers des modalités non liées : un modèle de parole et un modèle vidéo nécessitent des critères d'acceptation différents.
6. Modèles Microsoft Foundry
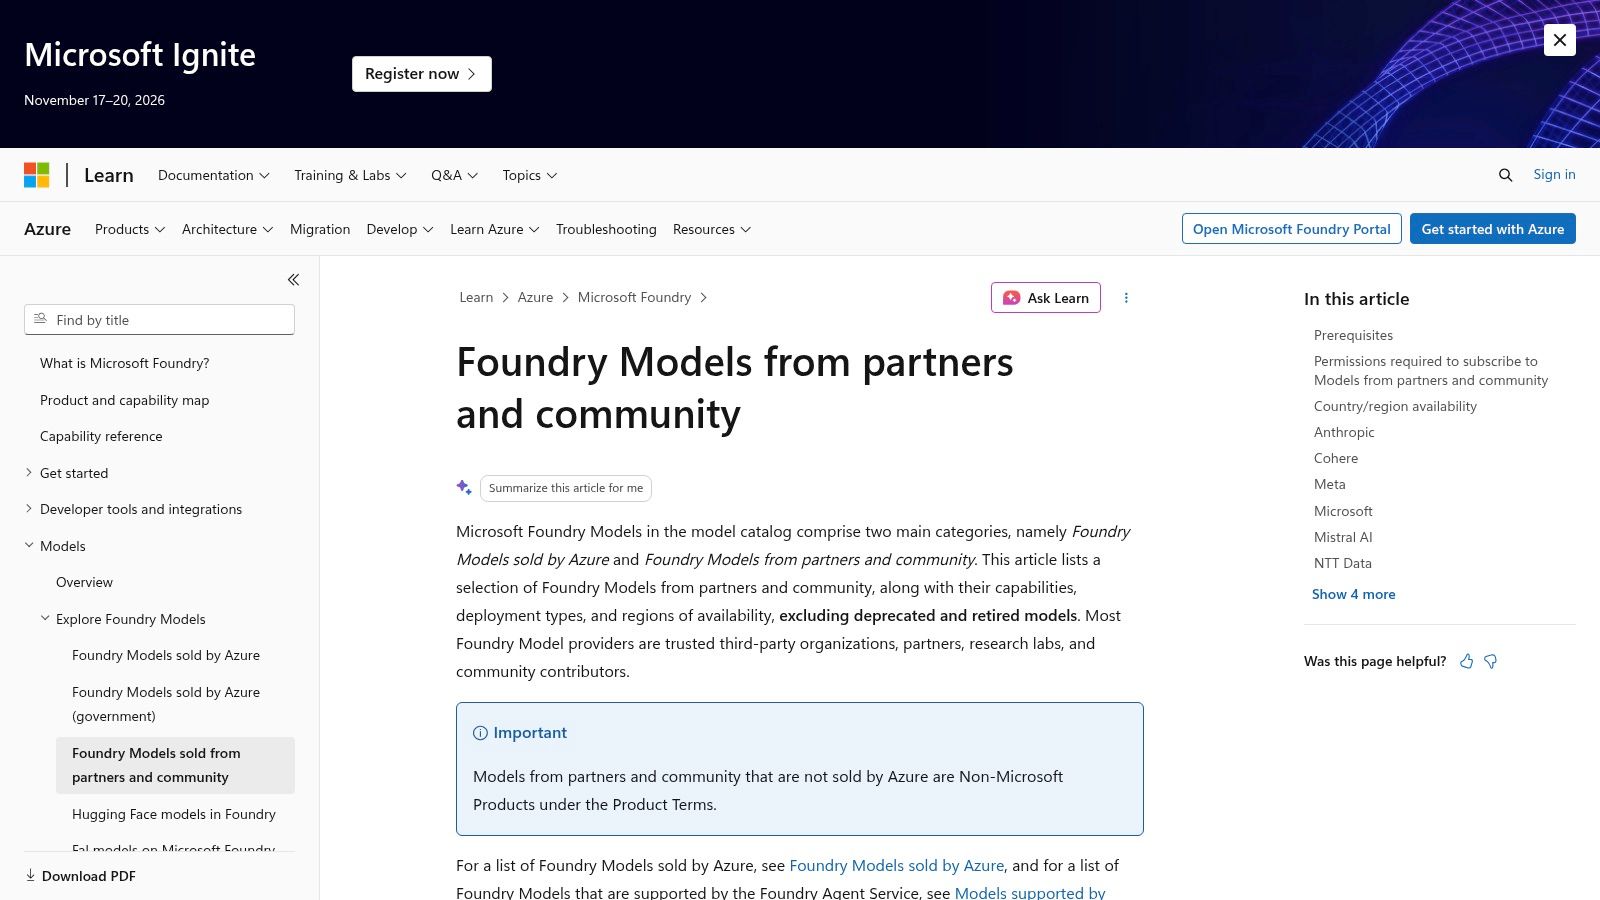
Pour une application basée sur Azure, la compatibilité de déploiement peut être aussi importante que la capacité du modèle. Un candidat prometteur n'est pas utile si sa méthode de déploiement disponible ne correspond pas à votre architecture ou à votre région d'exploitation.
Modèles Microsoft Foundry connecte la découverte de modèles à l'environnement cloud de Microsoft. Le catalogue comprend des offres de Microsoft, de partenaires et de la communauté, avec des informations pertinentes sur les tâches, les capacités, les licences et les choix de déploiement.
Choisissez le chemin de déploiement en même temps que le modèle
Les modèles éligibles peuvent avoir différentes options basées sur API, par lots, provisionnées ou de calcul géré. Ne supposez pas que trouver un modèle dans le catalogue signifie que chaque approche d'hébergement et de facturation est disponible pour celui-ci.
- Idéal pour : Les équipes qui ont besoin que la sélection de modèles s'aligne sur les décisions de déploiement Azure.
- Détail utile : Informations de déploiement spécifiques au modèle et résultats de benchmark sélectionnés.
- Contrainte : La disponibilité, les méthodes de déploiement et la tarification peuvent différer selon le modèle et la région.
Une équipe d'analyse de documents devrait étudier à la fois le support d'entrée du modèle et la configuration de l'endpoint qu'elle déploiera. Tester un endpoint de démonstration ne suffit pas si la production utilisera un arrangement de service matériellement différent.
Le catalogue est donc une ressource d'architecture autant qu'un outil de découverte. Utilisez-le lorsque l'intégration Azure est une exigence réelle, et non parce qu'un modèle souhaité s'y trouve par hasard.
Pour une exploration neutre vis-à-vis des fournisseurs, un outil de comparaison inter-fournisseurs est généralement un point de départ plus clair. Revenez à Foundry lorsque vous êtes prêt à établir le chemin de déploiement cloud pratique.
7. Catalogue de modèles Amazon Bedrock
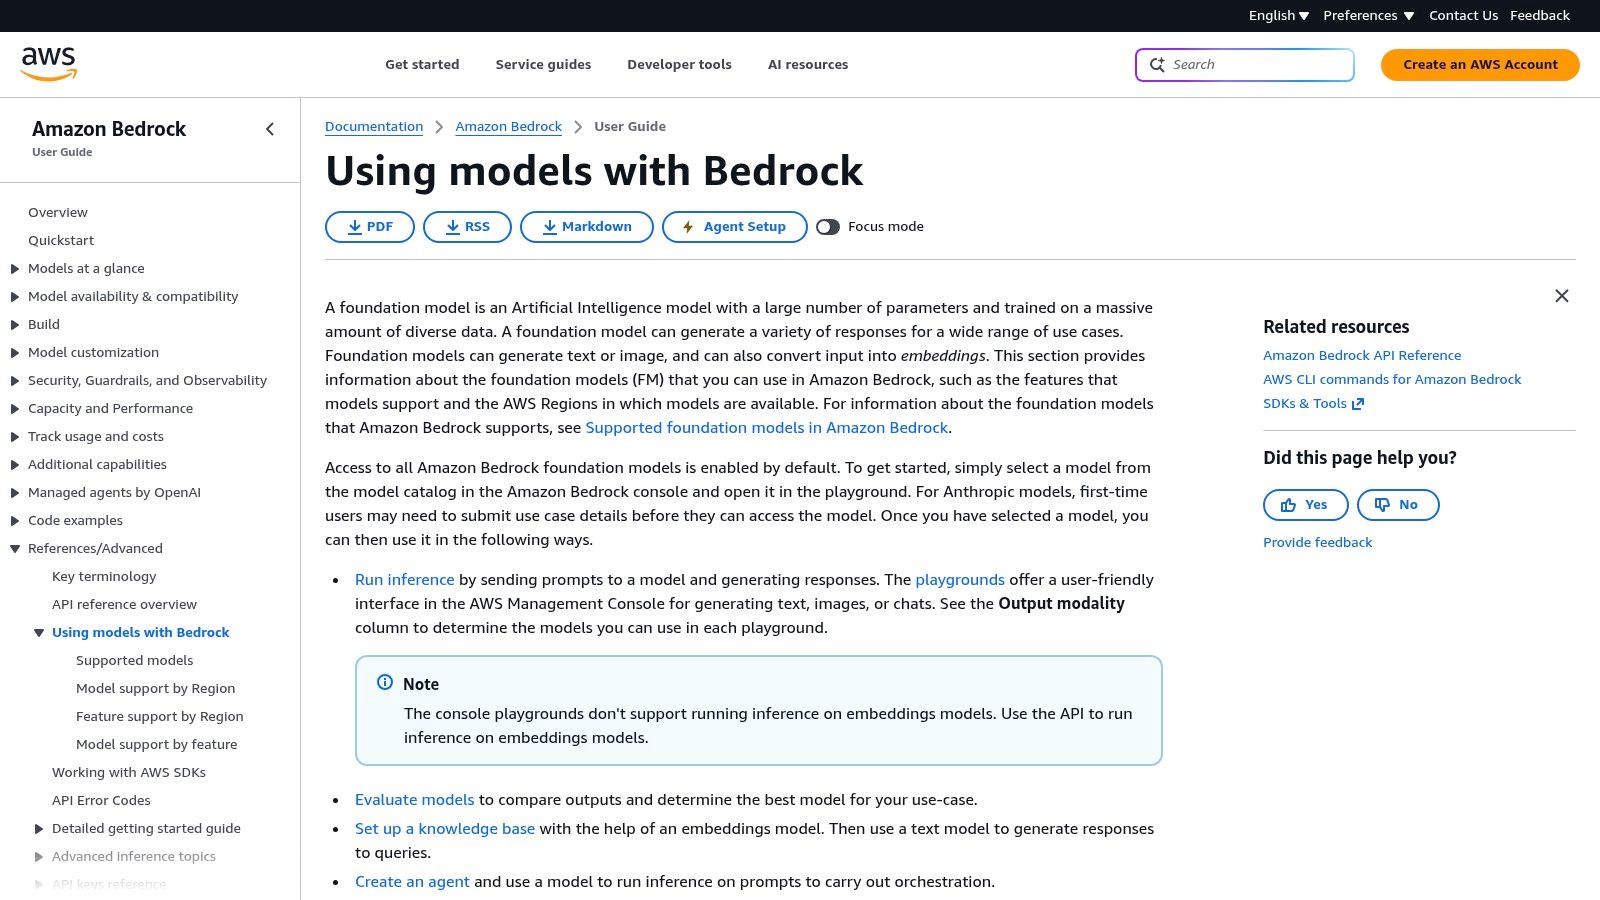
Vérifiez la disponibilité régionale avant de construire le prototype. C'est le réflexe le plus utile lorsque vous utilisez le catalogue de modèles Amazon Bedrock pour une application AWS.
Le catalogue identifie les modèles de fondation pris en charge et leurs capacités. Les équipes peuvent vérifier la disponibilité régionale et tester les modèles éligibles dans le playground de la console Bedrock avant de les intégrer dans une application basée sur AWS.
L'approvisionnement et l'accès font partie du choix
Bedrock est particulièrement pertinent lorsque l'application fonctionne déjà au sein de l'infrastructure AWS. Cependant, la configuration du compte et l'accès régional peuvent influencer la possibilité d'utiliser le modèle souhaité dans l'environnement prévu.
- Ce qui fonctionne : Passer de la découverte de modèles pris en charge à un déploiement AWS.
- Ce qu'il faut confirmer : L'accès au compte, la région visée, les entrées prises en charge et les exigences d'invocation.
- Ce que ce n'est pas : Un inventaire neutre de chaque modèle d'IA téléchargeable ou disponible commercialement.
Pour un assistant de support, testez les mêmes passages de récupération et instructions que vous prévoyez d'envoyer depuis la production. Le succès dans le playground établit qu'une requête peut fonctionner ; il n'établit pas que votre pipeline de récupération, votre gestion des erreurs et votre analyseur de sortie sont corrects.
La force de Bedrock réside dans sa connexion à la pile d'applications AWS. Cette même orientation est une limitation pour les équipes qui souhaitent seulement un aperçu général des options de modèles sans s'engager dans une intégration spécifique au cloud.
Conservez un enregistrement du modèle exact et de la configuration d'accès utilisés lors de l'évaluation. Un nom de famille de modèle reconnaissable ne suffit pas à reproduire une décision de déploiement.
8. Google Cloud Model Garden
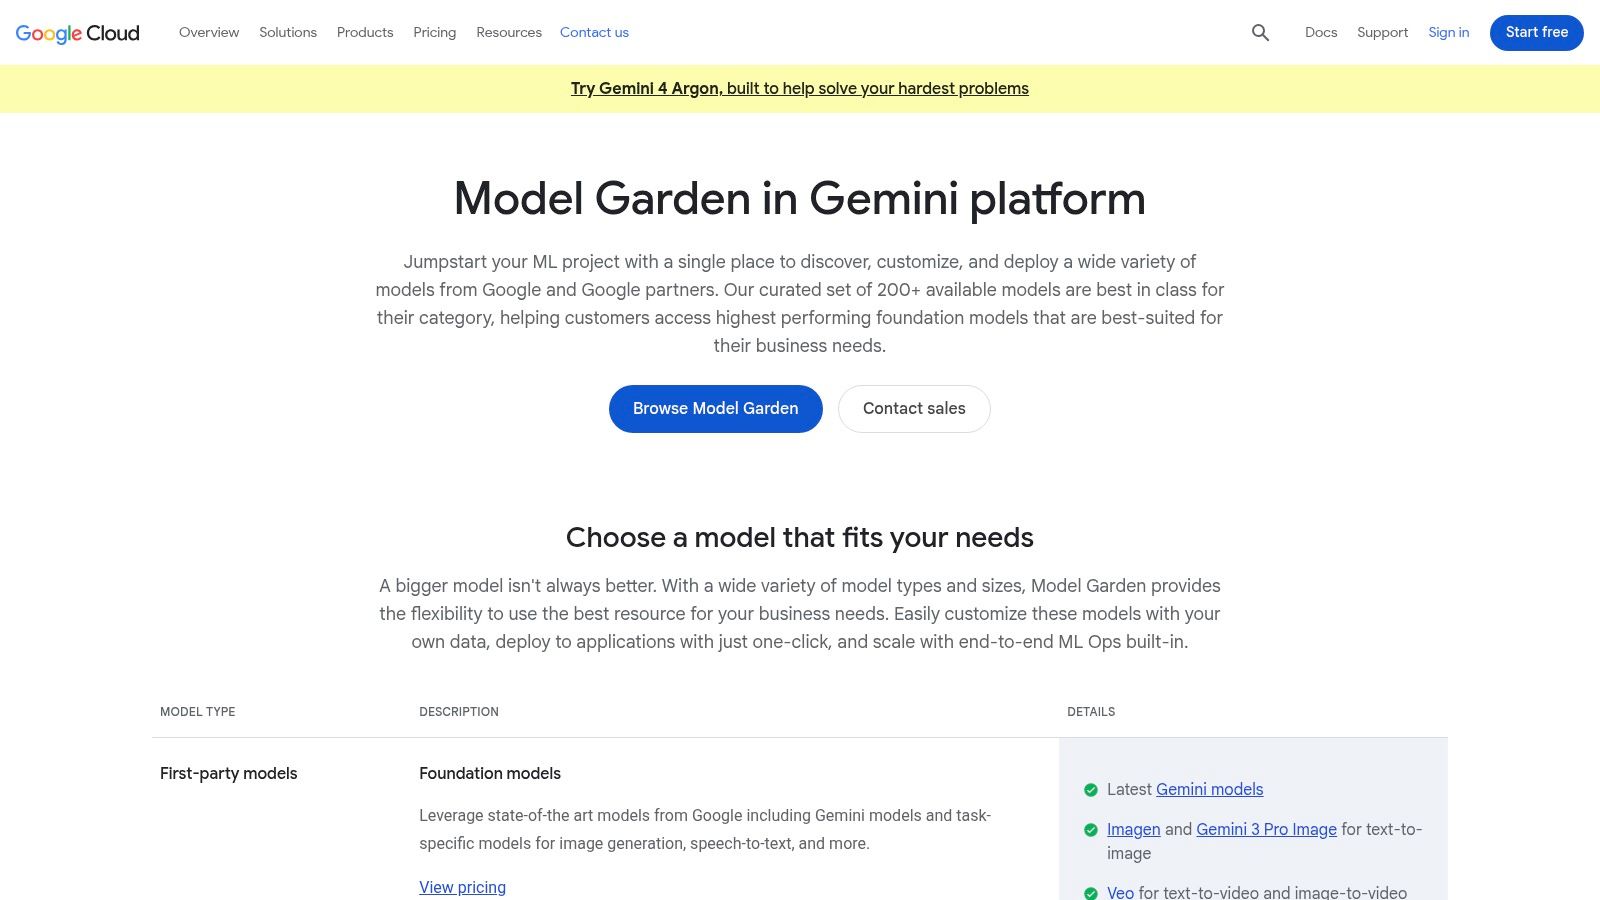
Une équipe qui développe sur Google Cloud devrait évaluer le modèle et son arrangement de service ensemble. Trouver la bonne famille de modèles n'est que le début ; la configuration de déploiement détermine comment il s'intègre à l'application.
Google Cloud Model Garden permet la découverte d'offres de modèles Google, tierces et open source au sein de l'environnement d'IA de Google Cloud. Il est le plus utile lorsque l'étape suivante est le développement basé sur le cloud plutôt que de télécharger un modèle pour un runtime local non lié.
Séparer la découverte des hypothèses de déploiement
Inspectez l'offre individuelle avant d'estimer le coût ou l'effort de mise en œuvre. La disponibilité et la tarification dépendent du modèle, de la région et de la configuration du service, donc une entrée de catalogue seule n'établit pas l'adéquation à la production.
- Meilleure utilisation : Explorer des modèles pour une application Google Cloud.
- Avantage : Les offres Google et externes sélectionnées apparaissent dans le même flux de travail de découverte orienté cloud.
- Limitation : C'est moins pratique pour une étude neutre vis-à-vis des fournisseurs ou une expérimentation hors ligne.
Pour un service d'analyse d'images, confirmez le format d'entrée accepté, puis testez le prétraitement exact que votre application effectue. Le redimensionnement, le recadrage et la conversion de documents font partie de l'évaluation, pas seulement du déploiement éventuel.
Ne confondez pas Model Garden avec la liste de modèles Gemini API plus restreinte. Le premier aide à une découverte plus large des modèles cloud ; le second fournit des détails de première partie pour un écosystème API spécifique.
Utilisez Model Garden une fois que votre équipe sait que Google Cloud fait partie du plan de déploiement. Sinon, commencez par les exigences du modèle et évitez de laisser une console cloud existante définir la liste restreinte prématurément.
9. Ollama Library
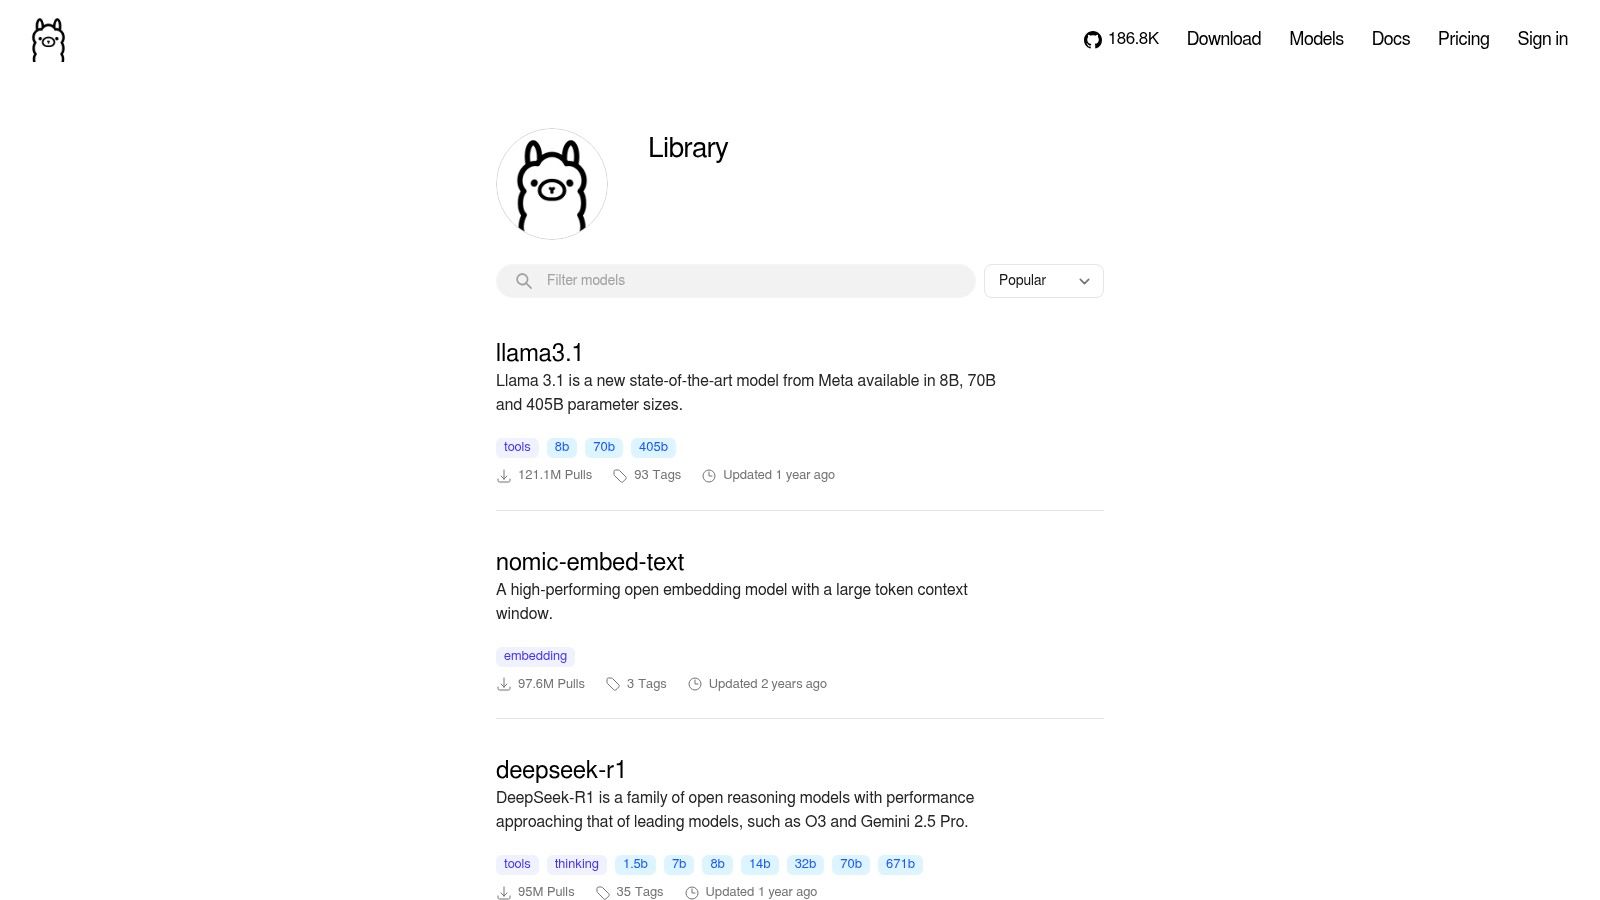
Si l'exigence est d'exécuter un modèle sur votre propre machine, commencez par un catalogue orienté exécution plutôt qu'une place de marché d'API hébergées. L'Ollama Library aide les utilisateurs à trouver les modèles pris en charge, leurs tailles, variantes et capacités pour le flux de travail local d'Ollama.
La taille du modèle est un filtre initial utile, mais ce n'est pas une estimation matérielle complète. L'utilisation du contexte, la surcharge d'exécution et d'autres applications en concurrence pour la mémoire affectent également le bon fonctionnement de la configuration.
Testez la machine réelle
Choisissez un candidat qui correspond à votre matériel, puis testez-le avec des longueurs d'entrée représentatives. Un modèle qui gère une courte invite de chat peut devenir impraticable lorsque vous ajoutez des documents récupérés ou une longue conversation.
La discussion sur l'efficacité de l'AI Index de Stanford rapporte que Phi-3-mini, avec 3.8 milliards de paramètres, a atteint le même seuil MMLU déclaré qui nécessitait auparavant 540 milliards de paramètres de PaLM. Cette comparaison soutient une leçon pratique : le nombre de paramètres seul n'est pas un classement de qualité.
- Point fort : Expérimentation accessible avec des modèles exécutables localement.
- Différence de coût : L'exécution locale évite les frais d'utilisation d'API hébergées, mais le matériel et l'exploitation coûtent toujours de l'argent.
- Limitation : Votre machine et les formats pris en charge limitent la sélection.
L'exécution locale n'est pas automatiquement un système hors ligne complet. Vérifiez si la récupération, la journalisation, les outils et les autres composants de l'application restent également locaux.
Ollama est un point de départ utile pour les prototypes hors ligne et les expériences contraintes par le matériel. Cela n'élimine pas la nécessité de valider la qualité, l'utilisation de la mémoire ou la latence de bout en bout.
10. Liste des modèles de l'API Google Gemini
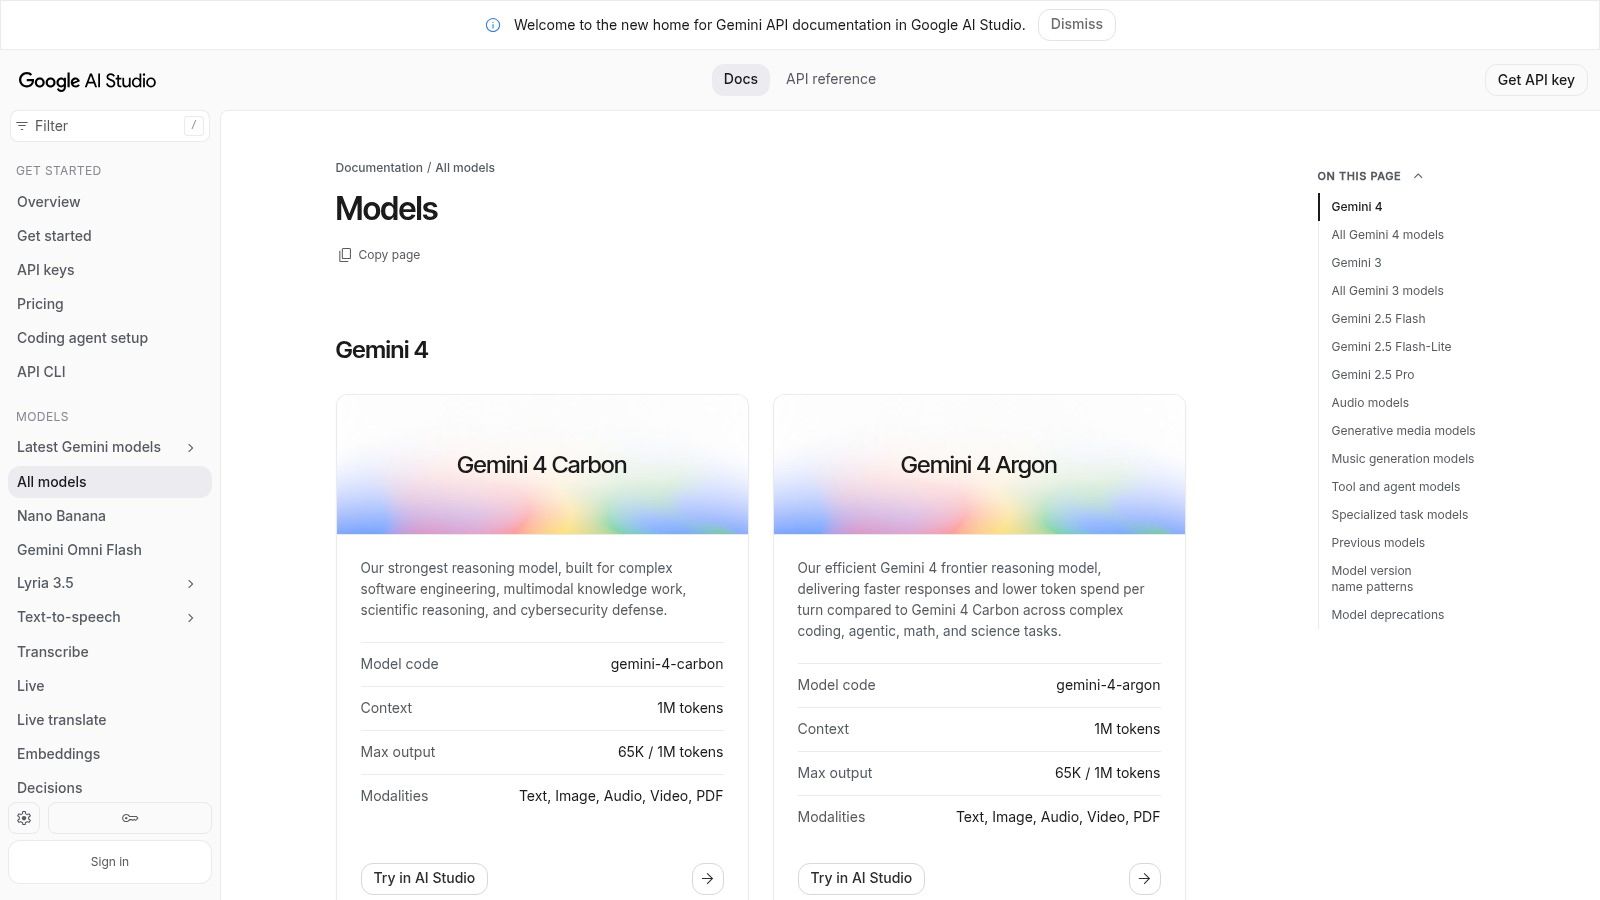
Parfois, le bon chemin est le plus direct. Si vous avez déjà choisi l'API Gemini, utilisez la liste officielle des modèles de l'API Gemini pour confirmer les identifiants de modèle, les descriptions et les capacités prises en charge.
Ceci est une documentation d'implémentation de première partie, pas un service de comparaison entre fournisseurs. Elle relie la découverte de modèles à la documentation de l'API et à Google AI Studio, ce qui la rend utile lorsque vous devez transformer une famille de modèles choisie en une requête fonctionnelle.
Vérifier l'identifiant exact
Ne développez pas en vous basant sur un nom de famille de modèles copié d'un article de comparaison. Confirmez l'identifiant spécifique et examinez ses entrées, sorties et conditions d'accès prises en charge avant l'intégration.
- Point fort : Informations directes sur les modèles pour les développeurs utilisant l'API Gemini.
- Limite de portée : Cela ne vous aidera pas à comparer tous les fournisseurs concurrents.
- Mise en garde commerciale : Vérifiez la tarification actuelle, le niveau d'accès et les conditions d'éligibilité du modèle sélectionné.
Pour une application liée à l'audio, vérifiez si le modèle particulier prend en charge le workflow audio requis plutôt que de supposer que chaque modèle Gemini expose des fonctionnalités identiques. Appliquez la même rigueur aux entrées multimodales et à l'utilisation d'outils.
Intégrez également des vérifications de cycle de vie dans votre processus de maintenance. Le guide d'arrêt des API Veo et Gemini est pertinent lors de l'examen des dépendances des endpoints et des travaux de migration.
La liste officielle est mieux utilisée comme référence d'implémentation après une présélection. Elle fournit les détails nécessaires pour effectuer une requête valide, tandis que votre propre évaluation détermine si les résultats renvoyés répondent aux exigences du produit.
Comment les 10 catalogues de modèles diffèrent par l'accès, la visibilité des prix et les limites
| Élément | Idéal pour | Modèle d'accès | Visibilité des prix | Principale limitation |
|---|---|---|---|---|
| Catalogue de modèles d'IA UberLLM (Recommandé) | Comparer les modèles de différents fournisseurs | API unifiée et marketplace | Prix en direct affichés | Les catalogues ne prédisent pas les performances spécifiques à la charge de travail |
| OpenRouter | Comparer et accéder aux modèles de différents fournisseurs | API hébergée avec une seule clé | Prix des modèles affichés ; vérifier les tarifs actuels | API hébergée, pas de poids de modèle téléchargeables |
| Hugging Face Hub | Recherche, personnalisation et auto-hébergement | Téléchargements de modèles ; l'hébergement varie | Prix non listés de manière cohérente | La qualité des modèles et la documentation varient |
| Artificial Analysis | Comparer les benchmarks, le coût et la vitesse | Ressource de recherche et de comparaison ; API de données | Prix de l'API affichés ; certains accès peuvent être payants | Les benchmarks peuvent ne pas refléter votre charge de travail |
| Replicate Explore | Tester et exécuter des modèles génératifs hébergés | API de modèles hébergés et déploiements personnalisés | Prix spécifiques aux modèles ; peut varier selon l'utilisation | La qualité et le support des modèles communautaires varient |
| Microsoft Foundry Models | Sélectionner des modèles pour les applications Azure | Options de déploiement Azure | Varie selon le modèle et la région | Mieux adapté aux utilisateurs Azure |
| Amazon Bedrock model catalog | Trouver des modèles pour les applications AWS | Services Bedrock au sein d'AWS | Varie selon le modèle et la région | Accès dépendant d'AWS et de la région |
| Google Cloud Model Garden | Trouver des modèles pour le déploiement Google Cloud | Services d'IA Google Cloud | Varie selon le modèle et la configuration | Orienté autour de Google Cloud |
| Ollama Library | Exécuter des modèles localement | Inférence locale avec Ollama | Pas de prix d'hébergement ; utilise votre matériel | Nécessite une configuration et un matériel adapté |
| Google Gemini API model list | Développer avec les modèles Google | API Gemini et Google AI Studio | Page de tarification séparée ; les niveaux varient | Couvre uniquement les modèles Google |
Transformer une présélection en une intégration fonctionnelle
Arrêtez de chercher une fois que vous avez deux ou trois modèles plausibles par modalité. Un plus grand nombre de candidats n'est pas utile si votre équipe n'a pas défini ce qu'est un résultat acceptable. Notez la longueur de contexte requise, les limites de sortie, le support d'outils, les formats d'entrée et les contraintes de déploiement avant d'effectuer les comparaisons.
Envoyez ensuite les mêmes prompts ou tâches de génération à chaque candidat. Pour l'extraction de texte, validez le schéma retourné et comparez les valeurs extraites aux réponses attendues. Pour le codage, exécutez des tests sur les modifications générées ; pour les médias, examinez les sorties par rapport à un brief cohérent plutôt que de choisir l'échantillon qui semble le plus impressionnant.
Évaluez le chemin d'application complet
Incluez le travail entourant l'inférence. La conversion de documents, la récupération, l'exécution d'outils, le polling, les tentatives et la validation des sorties peuvent tous déterminer si un modèle par ailleurs capable est utilisable.
- Qualité : Enregistrez les résultats acceptés, pas seulement les requêtes complétées.
- Latence : Mesurez à la fois la réponse initiale et la complétion de bout en bout lorsque pertinent.
- Coût : Incluez les tentatives, les générations rejetées et les appels de suivi nécessaires.
- Fiabilité : Testez les timeouts, les sorties malformées et les endpoints indisponibles.
La discussion de Brookings sur l'évaluation des modèles d'IA explique pourquoi les scores de benchmark peuvent omettre des préoccupations pratiques telles que la latence, les exigences de calcul, le coût et la sécurité. Votre évaluation devrait rendre ces préoccupations explicites au lieu de traiter un classement public comme un test d'acceptation en production.
Pour les équipes qui souhaitent un seul endpoint pour les workflows de texte, d'image, de vidéo et d'audio, commencez l'intégration d'UberLLM en définissant la base URL dans la configuration de votre SDK OpenAI ou Anthropic existant vers l'API endpoint compatible. Utilisez une clé UberLLM et conservez l'interface SDK existante et le code environnant, puis changez de candidat en modifiant l'identifiant du modèle. Validez les paramètres pris en charge par chaque candidat et utilisez le workflow de tâche asynchrone approprié pour les médias plutôt que de supposer que chaque modalité se comporte comme une réponse de chat en streaming.
Gardez la décision reproductible
Stockez l'identifiant du modèle, la version du prompt, les paramètres de génération, les entrées d'évaluation et les résultats d'acceptation ensemble. Cet enregistrement permet à un autre ingénieur de répéter le test et facilite l'évaluation des changements ultérieurs du modèle. Évitez de vous fier à une capture d'écran non versionnée ou à une impression mémorisée de la qualité de la sortie.
Choisissez un modèle par défaut et définissez quand l'application doit escalader ou échouer en toute sécurité. Un fallback n'est utile que s'il répond aux mêmes exigences essentielles, y compris les contraintes de confidentialité et le support d'outils. La meilleure liste de modèles d'IA est celle qui vous aide à prendre une décision d'intégration défendable, puis cède la place à des tests reproductibles.
UberLLM connecte les développeurs à des modèles tiers de texte, d'image, de vidéo, de musique et de parole via une API unifiée et un solde prépayé. Visitez UberLLM pour comparer les limites des modèles et les prix en direct, tester votre présélection dans le playground et intégrer les candidats qui répondent aux exigences de votre application.