Elenco di modelli AI 2026: 10 Opzioni per caso d'uso
Sfoglia questo pratico elenco di modelli AI per modalità, capacità e caso d'uso, con 10 cataloghi confrontati su prezzi, accesso e carichi di lavoro più adatti.
Immagina che il tuo team passi una settimana a leggere pagine di modelli, a confrontare prezzi dei token e a configurare un prototipo. Poi qualcuno carica un documento rappresentativo e scopre che il candidato più economico non riesce a far entrare il documento, le istruzioni e la risposta attesa nella sua finestra di contesto. L'integrazione funziona. La scelta del modello no.
Un catalogo di modelli non è la stessa cosa di una scelta di modello. Alcuni cataloghi ti aiutano a scoprire pesi scaricabili. Altri confrontano le prestazioni misurate, vendono inferenza ospitata, collegano i modelli all'approvvigionamento cloud o impacchettano i modelli per l'esecuzione locale. Trattarli come intercambiabili fa perdere tempo e può nascondere il vincolo che determina se la tua applicazione funziona.
Un utile elenco di modelli AI dovrebbe dirti da dove iniziare per un lavoro specifico:
- Scopri e personalizza i modelli: Usa una directory con schede modello, file e informazioni sulla licenza.
- Confronta i candidati per la produzione: Usa misurazioni indipendenti, quindi testa il tuo carico di lavoro.
- Chiama modelli ospitati: Usa un catalogo API con identificatori di modello espliciti e dettagli di distribuzione.
- Esegui offline: Usa un catalogo di runtime locale e verifica i requisiti hardware.
Per le applicazioni testuali, la lunghezza del contesto e il supporto degli strumenti potrebbero eliminare immediatamente i candidati. Per le applicazioni di immagini, video e audio, gli input supportati, i controlli di output e la gestione asincrona delle attività meritano uguale attenzione. Le opzioni seguenti servono a scopi diversi, quindi il punto di partenza giusto dipende meno da quale catalogo sembra più grande e più da ciò che devi fare dopo.
Indice
- 1. Catalogo di modelli AI UberLLM
- 2. OpenRouter
- 3. Hugging Face Hub
- 4. Artificial Analysis
- 5. Replicate Explore
- 6. Microsoft Foundry Models
- 7. Catalogo di modelli Amazon Bedrock
- 8. Google Cloud Model Garden
- 9. Libreria Ollama
- 10. Elenco di modelli API Google Gemini
- Come i 10 cataloghi di modelli differiscono per accesso, visibilità dei prezzi e limiti
- Trasformare una rosa di candidati in un'integrazione funzionante
1. Catalogo modelli AI UberLLM
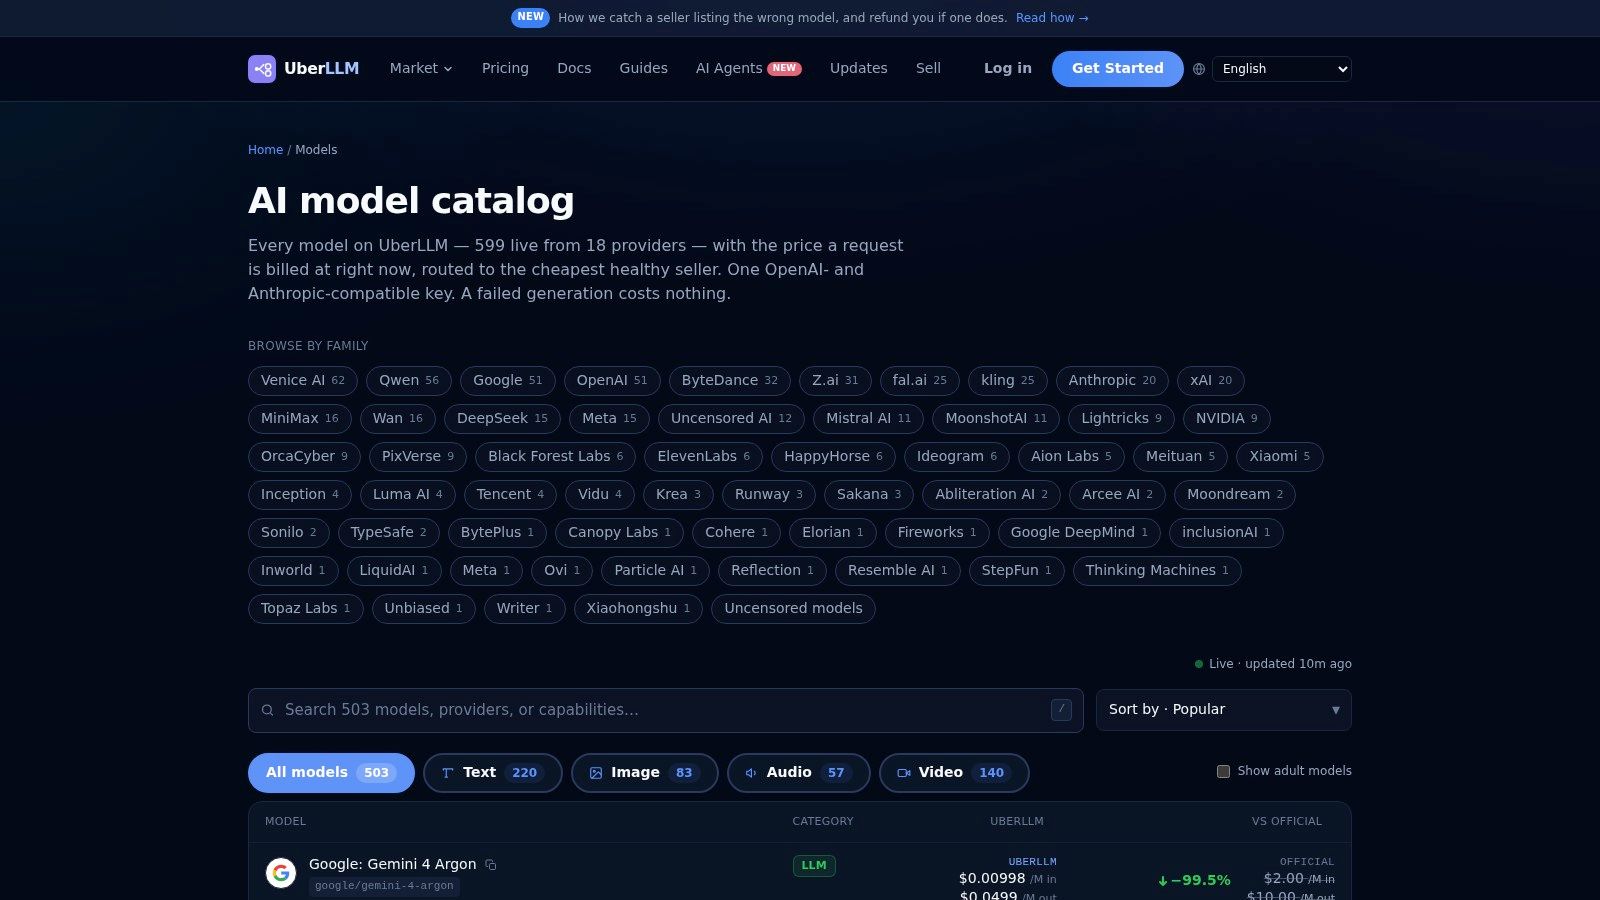
Ideale per confrontare le opzioni ospitate prima di integrare un'API di marketplace. Il catalogo modelli AI UberLLM raccoglie 457 modelli in una pagina di confronto con prezzi in tempo reale, nomi dei provider, lunghezze del contesto e tipi di modello. È utile quando la tua lista ristretta comprende testo e media piuttosto che una singola famiglia di modelli.
In UberLLM, colleghiamo questo processo di scoperta a un endpoint compatibile con OpenAI e Anthropic. Gli sviluppatori selezionano un identificatore di modello, mentre il routing del marketplace seleziona un venditore disponibile per il modello richiesto. Questa distinzione è importante: stai scegliendo sia le capacità di un modello sia un percorso di accesso ospitato.
Cosa ispezionare prima di scegliere
Per l'elaborazione dei documenti, confronta separatamente la lunghezza del contesto e il numero massimo di token di output. Un modello che accetta il tuo materiale sorgente potrebbe comunque avere un limite di output che gli impedisce di generare il risultato completo. I nostri metadati del modello espongono entrambi i campi e il catalogo contrassegna i modelli che supportano gli strumenti.
- Punto di forza: I prezzi in tempo reale e i nomi dei provider rendono la selezione tra provider meno frammentata.
- Flusso di lavoro utile: Filtra per modalità, ispeziona i limiti, quindi confronta gli output rappresentativi nel playground.
- Limitazione: Un'inserzione non può stabilire se il tuo schema di estrazione, il compito di codifica o il brief visivo avranno successo.
Non trattare il prezzo più basso visualizzato come la risposta definitiva. Per il testo, stima il mix di input e output che la tua applicazione produce; per i media, ispeziona la configurazione di generazione richiesta prima di confrontare i costi.
Regola pratica: Scegli un modello solo dopo che i suoi limiti, la qualità dell'output e il comportamento in caso di errore soddisfano il carico di lavoro. Una richiesta economica che produce un risultato inutilizzabile non è un risparmio utile.
Prezzi e disponibilità possono cambiare, quindi registra l'identificatore e la configurazione utilizzati nei test piuttosto che lasciare la tua lista ristretta come una collezione di nomi di modelli.
2. OpenRouter
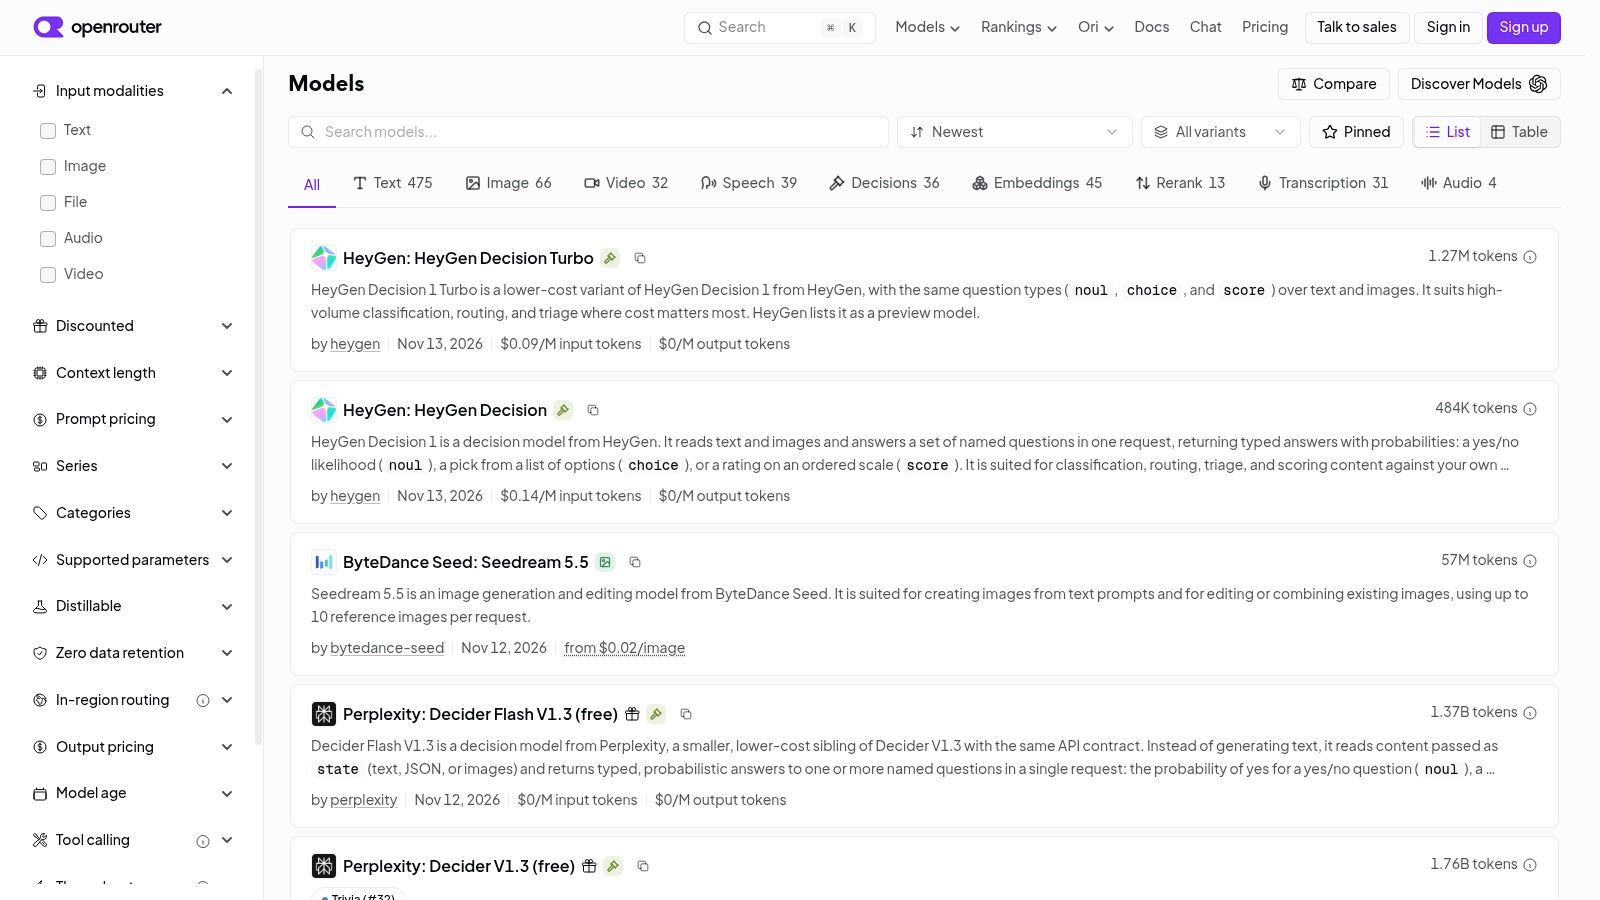
Se il tuo compito immediato è provare modelli ospitati senza costruire integrazioni separate con i provider, il catalogo di modelli di OpenRouter è un punto di partenza pratico. Combina specifiche di modelli ricercabili con accesso tramite una API comune.
I campi di confronto utili includono pricing, context length, modalities e capabilities. Questi aiutano a distinguere i modelli che accettano solo testo dai candidati che supportano gli input o i comportamenti aggiuntivi richiesti dalla tua applicazione. Controlla la pagina del singolo modello piuttosto che presumere che ogni modello esposto tramite la stessa interfaccia accetti la stessa richiesta.
Dove si inserisce
OpenRouter è adatto a uno sviluppatore che confronta candidati ospitati all'interno di un'applicazione esistente. Puoi mantenere stabile l'ambiente di valutazione circostante mentre cambi il modello selezionato, sebbene i parametri supportati e il comportamento dell'output necessitino ancora di convalida.
- Cosa funziona: Passare dalla scoperta alla sperimentazione API senza organizzare ogni integrazione con i provider separatamente.
- Cosa non funziona: Trattare il catalogo come un repository dove i pesi di ogni modello elencato possono essere scaricati.
- Cosa verificare: Disponibilità attuale, pricing specifico del modello, limiti di contesto e capabilities richieste.
Per un agente di codifica, testa gli argomenti delle chiamate agli strumenti e il recupero dopo un'esecuzione fallita dello strumento, non solo la qualità di una risposta di codice autonoma. Una API comune non rende il comportamento dell'agente intercambiabile.
Il confronto delle alternative a OpenRouter è utile quando si valutano diversi servizi di accesso. Mantieni questa decisione separata dalla selezione del modello: il modello e il servizio che lo ospita introducono diversi compromessi operativi.
3. Hugging Face Hub
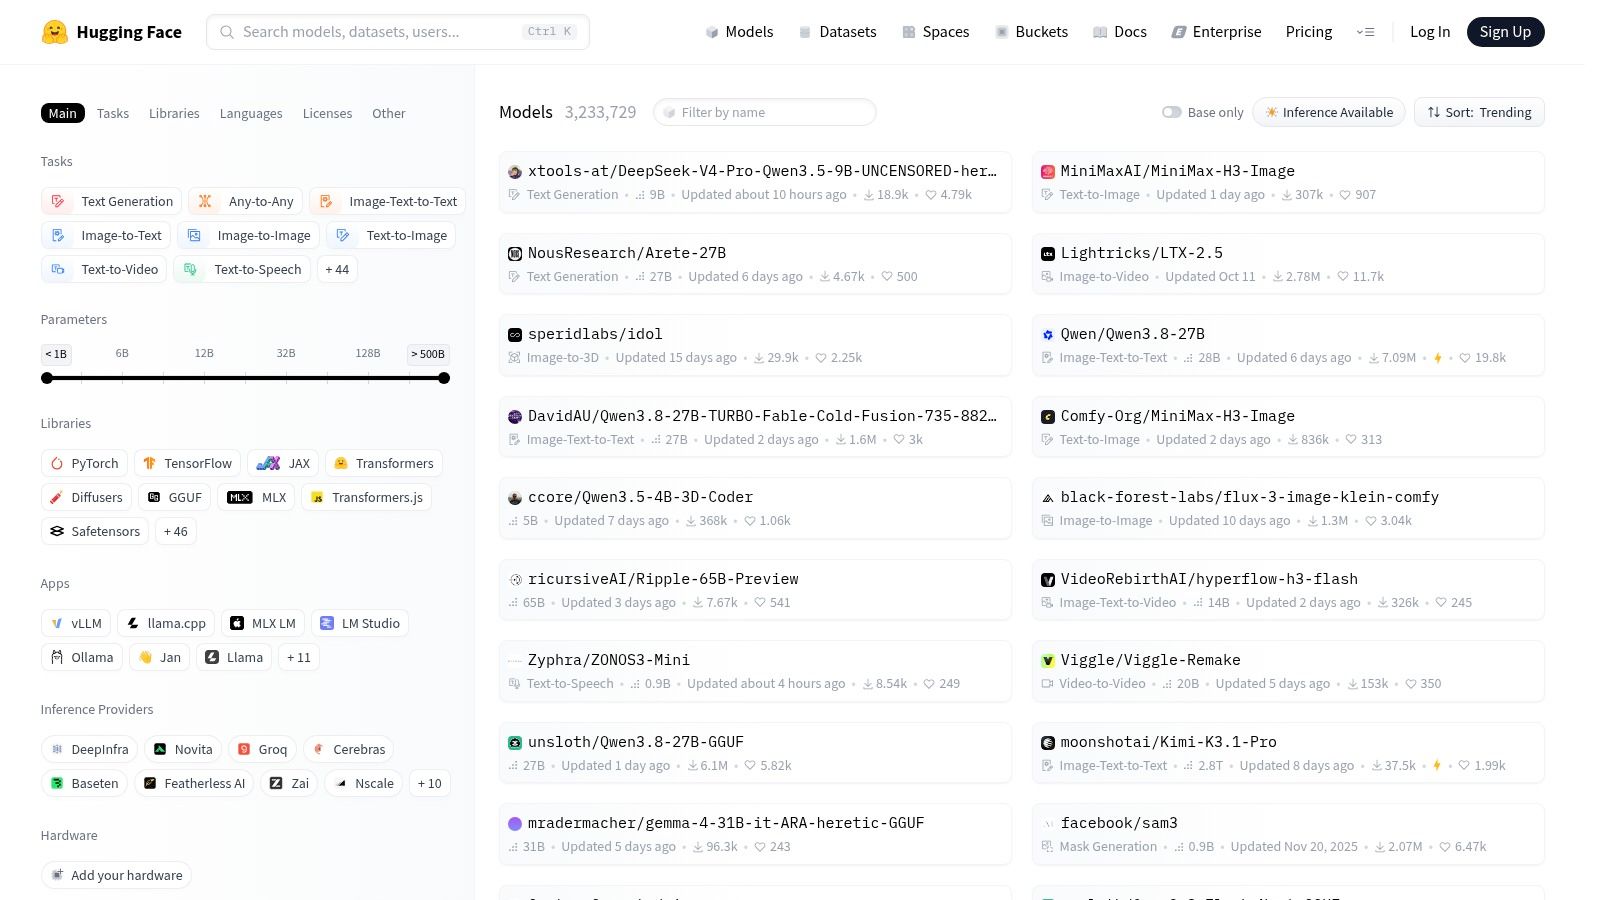
Inizia con Hugging Face quando ti servono i weights, non solo un endpoint. L'Hugging Face Hub è particolarmente utile per trovare modelli che potresti personalizzare, ispezionare o deployare tu stesso.
Le sue pagine modello possono combinare model cards, file scaricabili, esempi di implementazione e dettagli di licenza. Questo lo rende un tipo di risorsa diverso da un menu API ospitato: stai investigando l'artefatto e i suoi requisiti, non semplicemente decidendo quale identificatore inviare in una richiesta.
Leggi oltre il nome del modello
Controlla il task, l'architettura, il framework di inferenza supportato e la licenza prima di scaricare. Poi ispeziona se gli esempi corrispondono al tuo uso previsto, specialmente per i modelli fine-tuned con prompt templates specializzati.
- Punto di forza: Ampia scoperta tra task di testo, visione, immagine e audio.
- Compromesso: La qualità della documentazione e della valutazione dipende dall'editore.
- Vincolo di deployment: Un modello scaricabile non è automaticamente disponibile come API gestita.
Ad esempio, un team di elaborazione documenti potrebbe trovare un promettente modello vision-language ma avere comunque bisogno di assemblare preprocessing, inference e validazione dell'output. Il repository aiuta a stabilire cosa è disponibile; non elimina il lavoro di deployment.
Open weights non significa nemmeno uso illimitato. Leggi la licenza effettiva e le condizioni associate piuttosto che inferire i permessi dal pulsante di download.
Usa Hugging Face per ricerca e personalizzazione quando l'accesso ai file sottostanti è importante. Se hai solo bisogno di confrontare risposte ospitate questo pomeriggio, un catalogo API potrebbe portarti a un test significativo più velocemente.
4. Analisi Artificiale
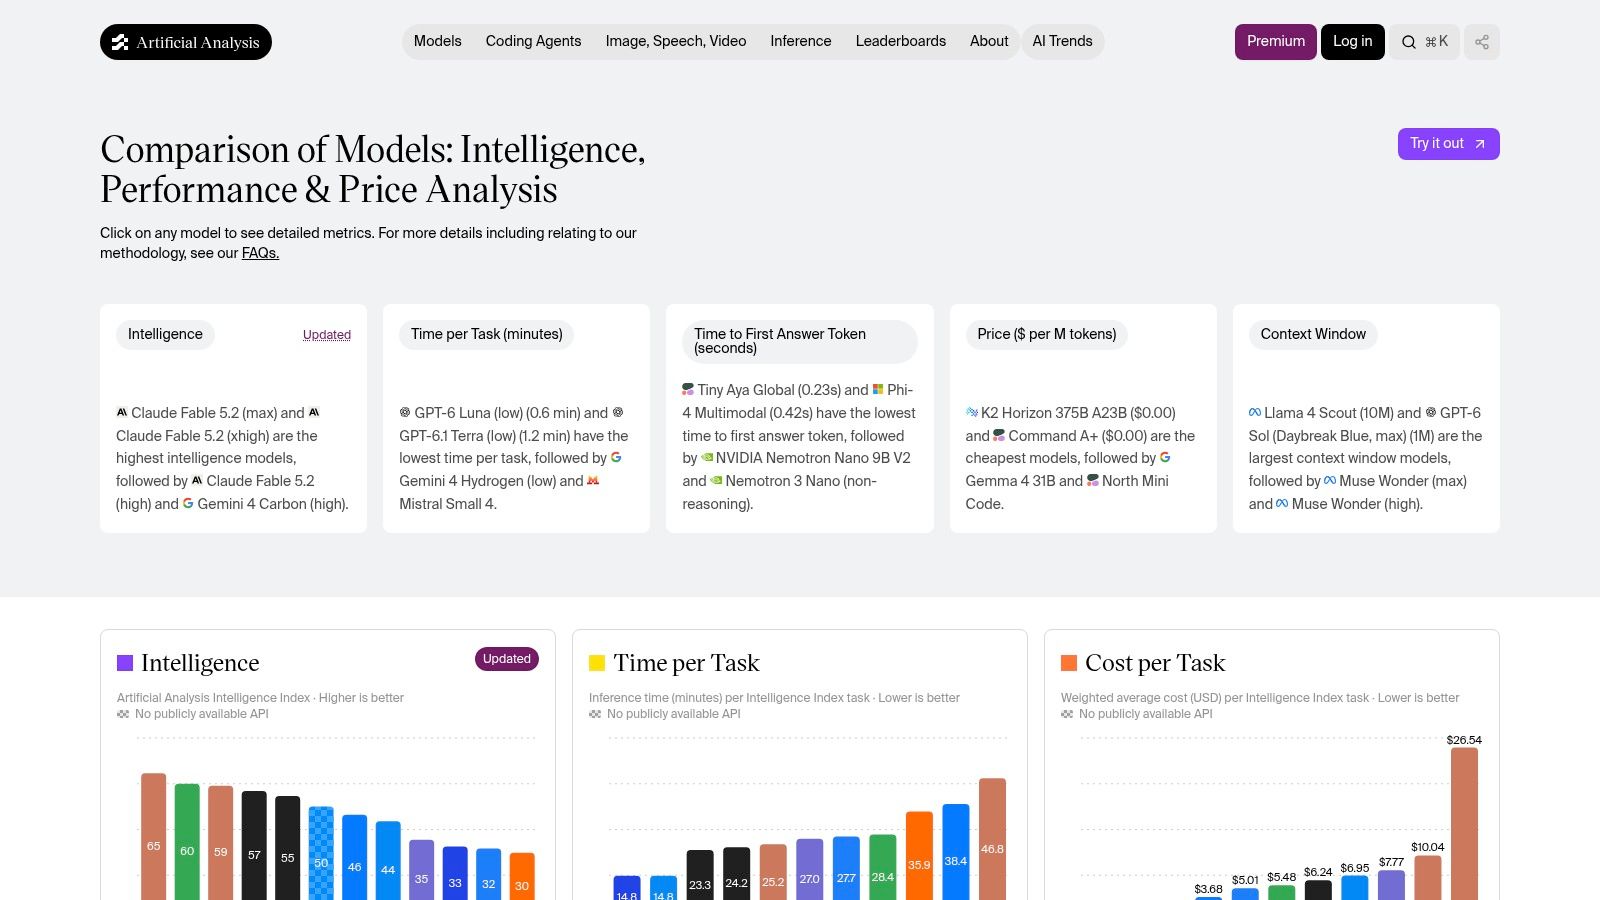
La domanda difficile non è quale modello abbia il prezzo token pubblicizzato più basso. È quale candidato soddisfa i tuoi requisiti di qualità a un costo totale e un tempo di completamento accettabili.
Analisi Artificiale confronta i modelli utilizzando misure che includono intelligenza, prezzo, tempo per attività, latenza al primo token di risposta e dimensione della finestra di contesto. Il suo approccio al costo per attività è più utile per la selezione preliminare rispetto alla lettura isolata dei prezzi dei token, perché collega i costi a un carico di lavoro.
Confronta la metrica che i tuoi utenti sperimentano
Per un assistente interattivo, il tempo al primo token è importante, ma non sostituisce il tempo di completamento end-to-end. Per un lavoro di estrazione in background, il completamento validato e la spesa totale potrebbero essere più importanti della velocità con cui il testo appare per la prima volta.
- Usalo per: Identificare i compromessi tra capacità, costo e velocità prima del test dell'applicazione.
- Non usarlo per: Assumere che un leader del benchmark vincerà sui tuoi prompt o sulla tua lingua.
- Avvertenza sull'accesso: Alcuni set di dati o funzionalità potrebbero richiedere un account o un accesso a pagamento.
Confronta il costo per attività riuscita, non solo il costo per richiesta. Includi i tentativi e gli output rifiutati nella tua valutazione.
L'indice dei prezzi LLM fornisce un altro riferimento di prezzo quando si prepara una selezione preliminare. Mantieni visibili le ipotesi sul carico di lavoro quando confronti qualsiasi indice.
Analisi Artificiale non è il posto dove scaricare ogni modello o distribuire la tua applicazione. Il suo compito è migliorare la selezione preliminare, lasciando al tuo sistema il compito di determinare se quei candidati soddisfano i requisiti di produzione.
5. Replicate Explore
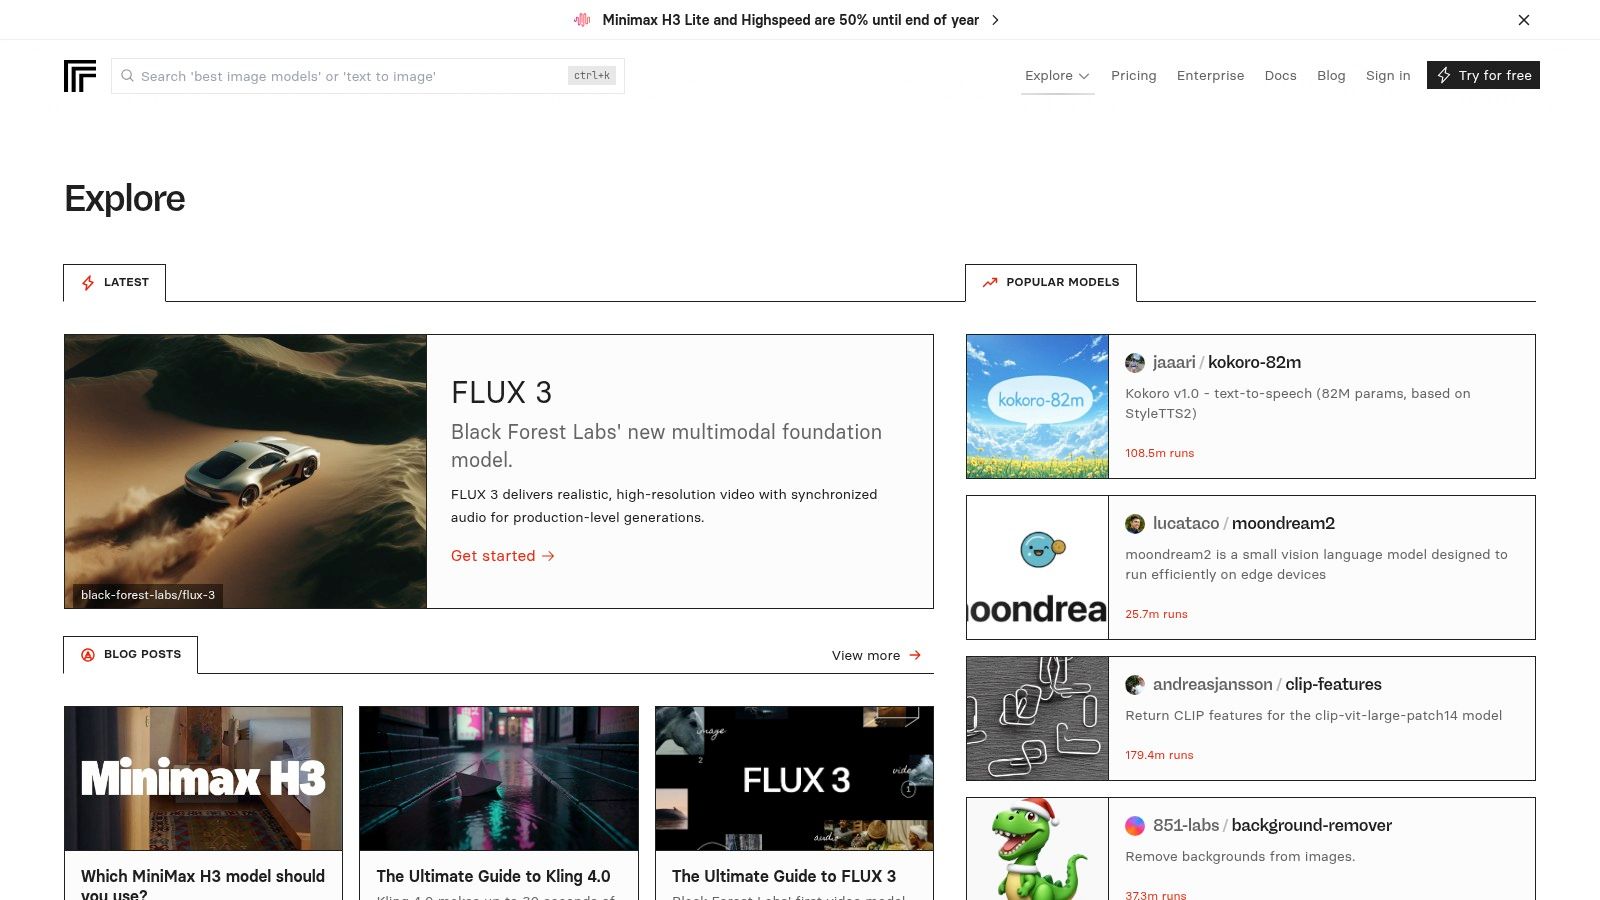
Testare un modello video richiede più che leggere una classifica di modelli linguistici. Devi ispezionare gli input accettati, gli esempi di output, i controlli di generazione e come l'applicazione recupera un risultato completato.
Replicate Explore è utile per questa scoperta pratica, in particolare per la generazione di immagini, video e audio. Le pagine dei modelli possono fornire esempi, definizioni degli input, istruzioni per l'uso e prezzi insieme a un percorso di esecuzione ospitato.
Testa con il tuo materiale sorgente
Per l'image-to-video, usa un'immagine rappresentativa della tua applicazione, non solo gli esempi raffinati del modello. Verifica la coerenza del soggetto, il movimento, la composizione e se l'output rispetta il brief. Per il parlato, testa nomi, punteggiatura e le lingue che i tuoi utenti inviano.
- Punto di forza: Puoi sperimentare senza prima configurare l'inferenza locale.
- Flessibilità: Le distribuzioni personalizzate possono usare Cog, lo strumento di packaging di Replicate.
- Limitazione: I modelli pubblicati dalla community possono differire in termini di manutenzione, documentazione e supporto.
Verifica se un'offerta è ufficiale e attivamente mantenuta prima di basarci il tuo lavoro. Leggi anche attentamente l'unità di fatturazione, poiché il prezzo del modello potrebbe dipendere dal tempo di esecuzione o dall'output generato piuttosto che da un calcolo di token in stile testo.
Replicate è un'ottima scelta quando devi verificare se un modello generativo può produrre media accettabili. È meno utile come singola classifica normalizzata tra modalità non correlate: un modello vocale e un modello video necessitano di criteri di accettazione diversi.
6. Microsoft Foundry Models
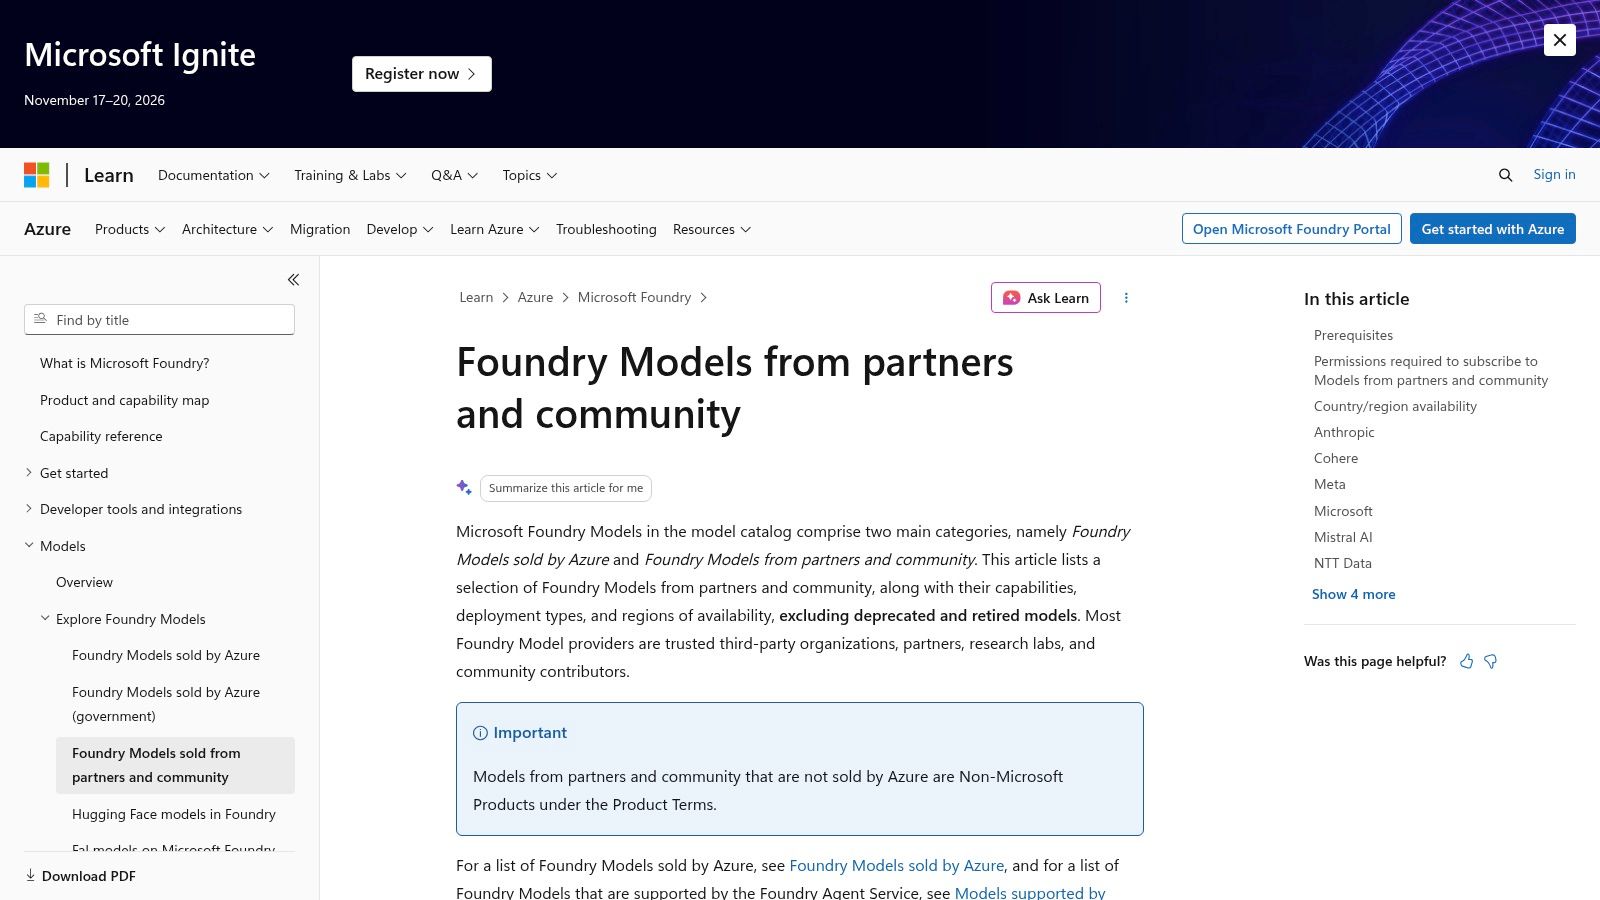
Per un'applicazione basata su Azure, l'idoneità al deployment può essere importante quanto la capacità del modello. Un candidato promettente non è utile se il suo metodo di deployment disponibile non si adatta alla tua architettura o regione operativa.
Microsoft Foundry Models collega la scoperta di modelli all'ambiente cloud di Microsoft. Il catalogo include offerte di Microsoft, partner e della community, con informazioni rilevanti per attività, capacità, licenze e scelte di deployment.
Scegli il percorso di deployment insieme al modello
I modelli idonei possono avere diverse opzioni basate su API, batch, provisioned o managed-compute. Non dare per scontato che trovare un modello nel catalogo significhi che ogni approccio di hosting e fatturazione sia disponibile per esso.
- Ideale per: Team che necessitano che la selezione del modello si allinei alle decisioni di deployment di Azure.
- Dettaglio utile: Informazioni di deployment specifiche del modello e risultati di benchmark selezionati.
- Vincolo: Disponibilità, metodi di deployment e prezzi possono differire per modello e regione.
Un team di analisi documentale dovrebbe esaminare sia il supporto di input del modello sia la configurazione dell'endpoint che verrà deployata. Testare un endpoint dimostrativo non è sufficiente se la produzione utilizzerà una disposizione di serving materialmente diversa.
Il catalogo è quindi una risorsa per l'architettura oltre che uno strumento di scoperta. Usalo quando l'integrazione con Azure è un requisito effettivo, non perché un modello desiderato vi appaia per caso.
Per un'esplorazione neutrale rispetto al provider, uno strumento di confronto tra provider è solitamente un punto di partenza più pulito. Torna a Foundry quando sei pronto a stabilire il percorso pratico di deployment nel cloud.
7. Catalogo modelli Amazon Bedrock
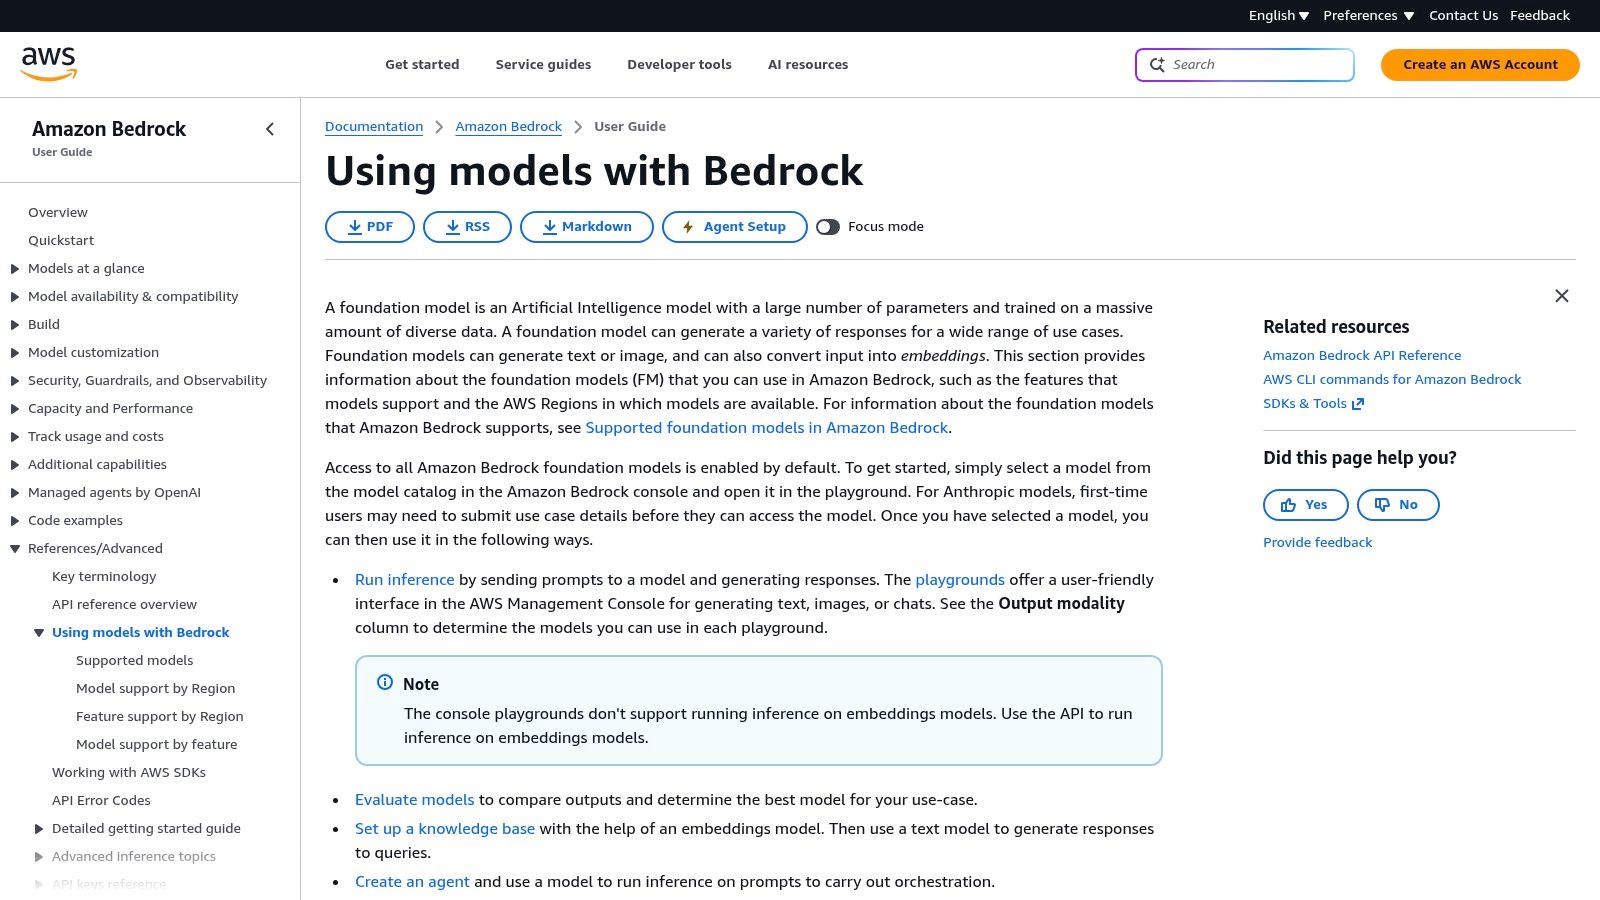
Verifica la disponibilità regionale prima di costruire il prototipo. Questa è l'abitudine più utile quando si utilizza il catalogo modelli Amazon Bedrock per un'applicazione AWS.
Il catalogo identifica i modelli di base supportati e le loro capacità. I team possono verificare la disponibilità regionale e testare i modelli idonei nel playground della console Bedrock prima di integrarli in un'applicazione basata su AWS.
L'approvvigionamento e l'accesso fanno parte della scelta
Bedrock è particolarmente rilevante quando l'applicazione opera già all'interno dell'infrastruttura AWS. Tuttavia, la configurazione dell'account e l'accesso regionale possono influenzare l'usabilità del modello desiderato nell'ambiente previsto.
- Cosa funziona: Passare dalla scoperta dei modelli supportati a una distribuzione AWS.
- Cosa confermare: Accesso all'account, regione prevista, input supportati e requisiti di invocazione.
- Cosa non è: Un inventario neutro di ogni modello AI scaricabile o commercialmente disponibile.
Per un assistente di supporto, testa gli stessi passaggi di recupero e istruzioni che intendi inviare dalla produzione. Il successo nel playground stabilisce che una richiesta può funzionare; non stabilisce che la tua pipeline di recupero, la gestione degli errori e il parser di output siano corretti.
La forza di Bedrock è la sua connessione allo stack di applicazioni AWS. Questo stesso orientamento è una limitazione per i team che desiderano solo un'ampia panoramica delle opzioni di modello senza impegnarsi in un'integrazione specifica per il cloud.
Conserva un registro del modello esatto e della configurazione di accesso utilizzati nella valutazione. Un nome di famiglia di modelli riconoscibile non è sufficiente per riprodurre una decisione di distribuzione.
8. Google Cloud Model Garden
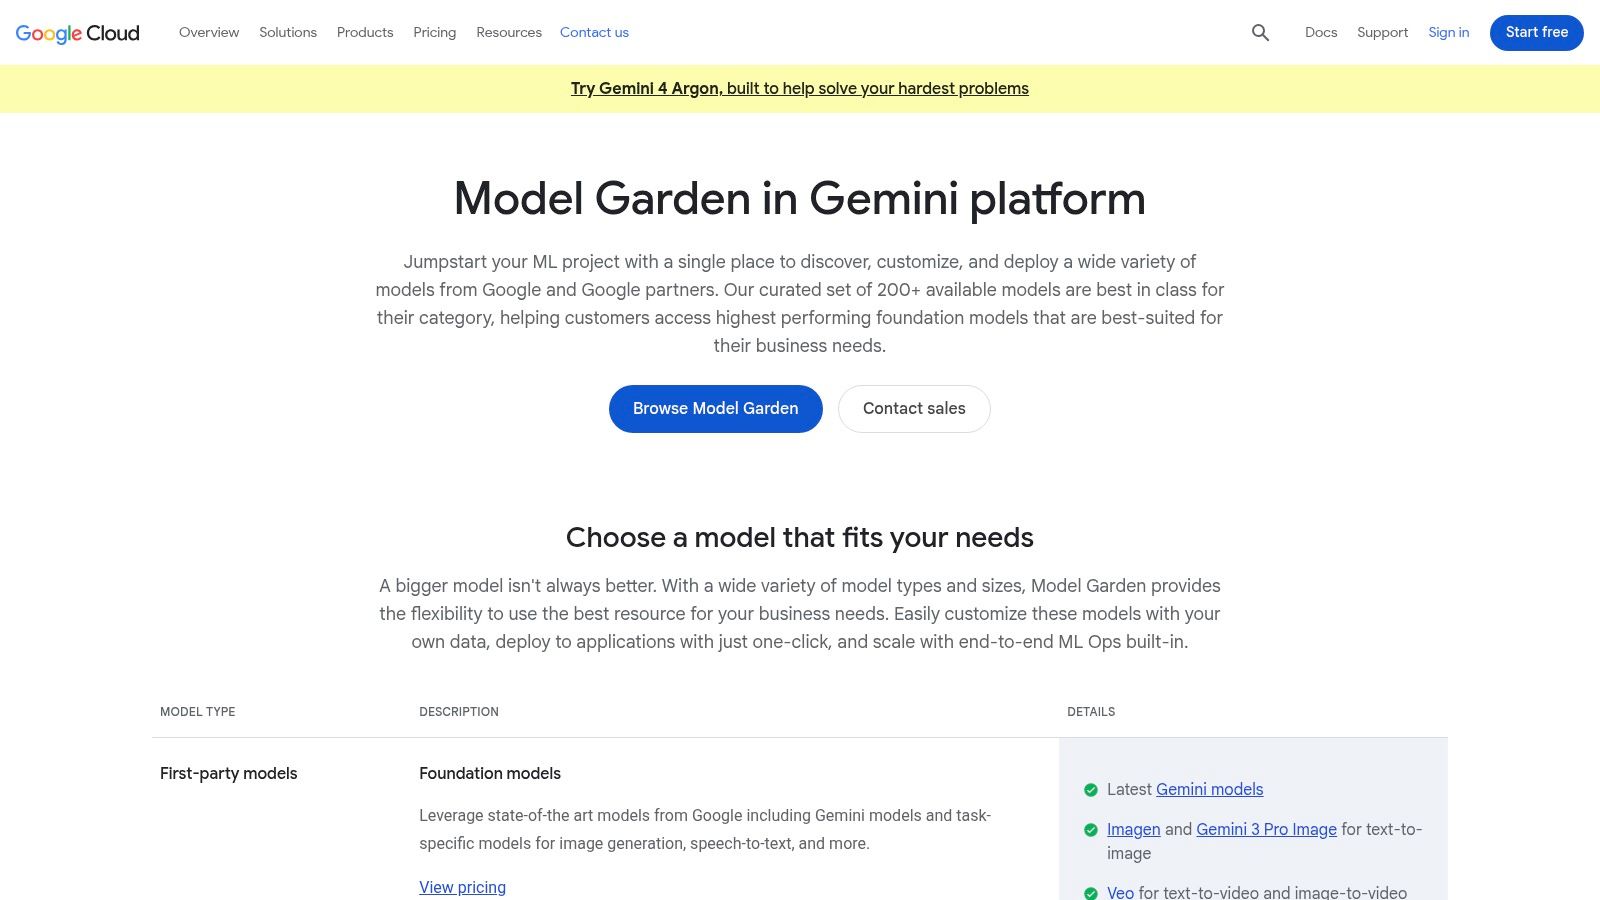
Un team che sviluppa su Google Cloud dovrebbe valutare il modello e la sua configurazione di servizio insieme. Trovare la famiglia di modelli giusta è solo l'inizio; la configurazione di deployment determina come si adatta all'applicazione.
Google Cloud Model Garden offre la scoperta di modelli di Google, di terze parti e open all'interno dell'ambiente AI di Google Cloud. È più utile quando il passo successivo è lo sviluppo basato su cloud piuttosto che scaricare un modello per un runtime locale non correlato.
Separa la scoperta dalle ipotesi di deployment
Esamina la singola offerta prima di stimare i costi o lo sforzo di implementazione. Disponibilità e prezzi dipendono dal modello, dalla regione e dalla configurazione del servizio, quindi una voce di catalogo da sola non stabilisce l'idoneità alla produzione.
- Miglior uso: Esplorare modelli per un'applicazione Google Cloud.
- Vantaggio: Le offerte di Google e quelle esterne selezionate appaiono nello stesso flusso di lavoro di scoperta orientato al cloud.
- Limitazione: È meno conveniente per un'indagine neutrale rispetto al provider o per la sperimentazione offline.
Per un servizio di analisi delle immagini, conferma il formato di input accettato e poi testa l'esatto preprocessing che la tua applicazione esegue. Ridimensionamento, ritaglio e conversione di documenti rientrano nella valutazione, non solo nel deployment finale.
Non confondere Model Garden con la più ristretta lista di modelli Gemini API. Il primo aiuta con una più ampia scoperta di modelli cloud; il secondo fornisce dettagli di prima parte per uno specifico ecosistema API.
Usa Model Garden una volta che il tuo team sa che Google Cloud fa parte del piano di deployment. Altrimenti, inizia con i requisiti del modello ed evita di lasciare che una console cloud esistente definisca la rosa dei candidati prematuramente.
9. Libreria Ollama
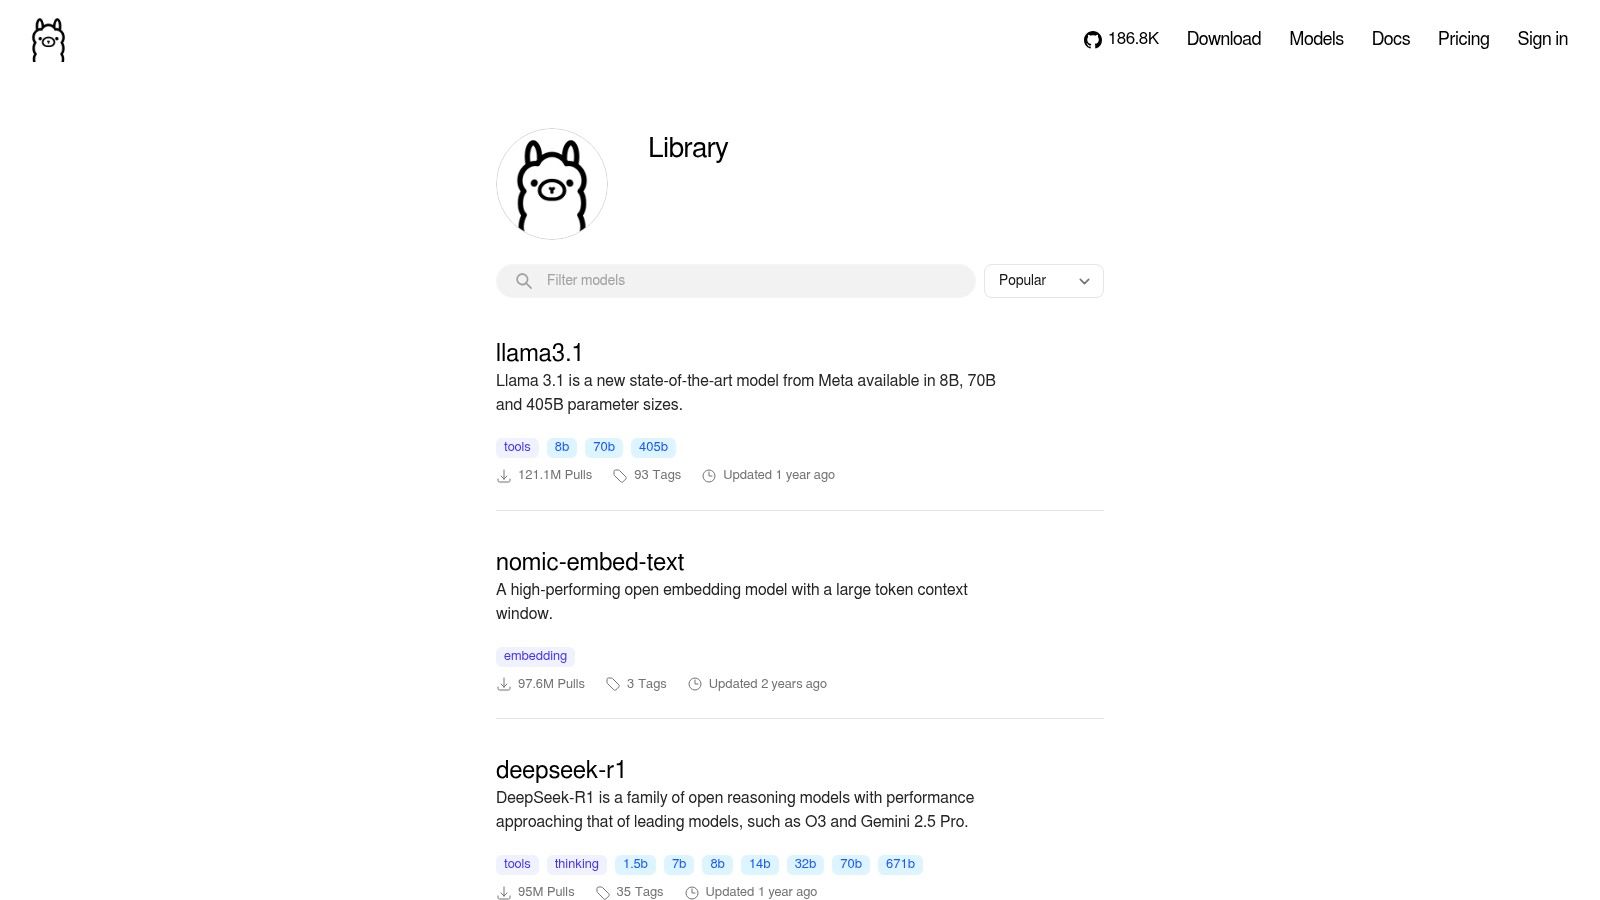
Se il requisito è eseguire un modello sulla tua macchina, inizia con un catalogo orientato al runtime piuttosto che con un marketplace di API ospitate. La Libreria Ollama aiuta gli utenti a trovare modelli supportati, dimensioni, varianti e capacità per il flusso di lavoro locale di Ollama.
La dimensione del modello è un filtro iniziale utile, ma non è una stima hardware completa. L'utilizzo del contesto, l'overhead del runtime e altre applicazioni che competono per la memoria influenzano anche se la configurazione funziona comodamente.
Testa la macchina reale
Scegli un candidato che si adatti al tuo hardware, quindi testalo con lunghezze di input rappresentative. Un modello che gestisce un breve prompt di chat potrebbe diventare impraticabile quando aggiungi documenti recuperati o una lunga conversazione.
La discussione sull'efficienza dell'AI Index di Stanford riporta che Phi-3-mini, con 3.8 miliardi di parametri, ha raggiunto la stessa soglia MMLU dichiarata che in precedenza richiedeva i 540 miliardi di parametri di PaLM. Questo confronto supporta una lezione pratica: il solo conteggio dei parametri non è una classifica di qualità.
- Punto di forza: Sperimentazione accessibile con modelli eseguibili localmente.
- Differenza di costo: L'esecuzione locale evita i costi di utilizzo delle API ospitate, ma l'hardware e l'operatività costano comunque denaro.
- Limitazione: La tua macchina e i formati supportati limitano la rosa dei candidati.
L'esecuzione locale non è automaticamente un sistema offline completo. Verifica se anche il recupero, la registrazione, gli strumenti e altri componenti dell'applicazione rimangono locali.
Ollama è un utile punto di partenza per prototipi offline ed esperimenti con vincoli hardware. Non elimina la necessità di convalidare qualità, utilizzo della memoria o latenza end-to-end.
10. Elenco dei modelli API di Google Gemini
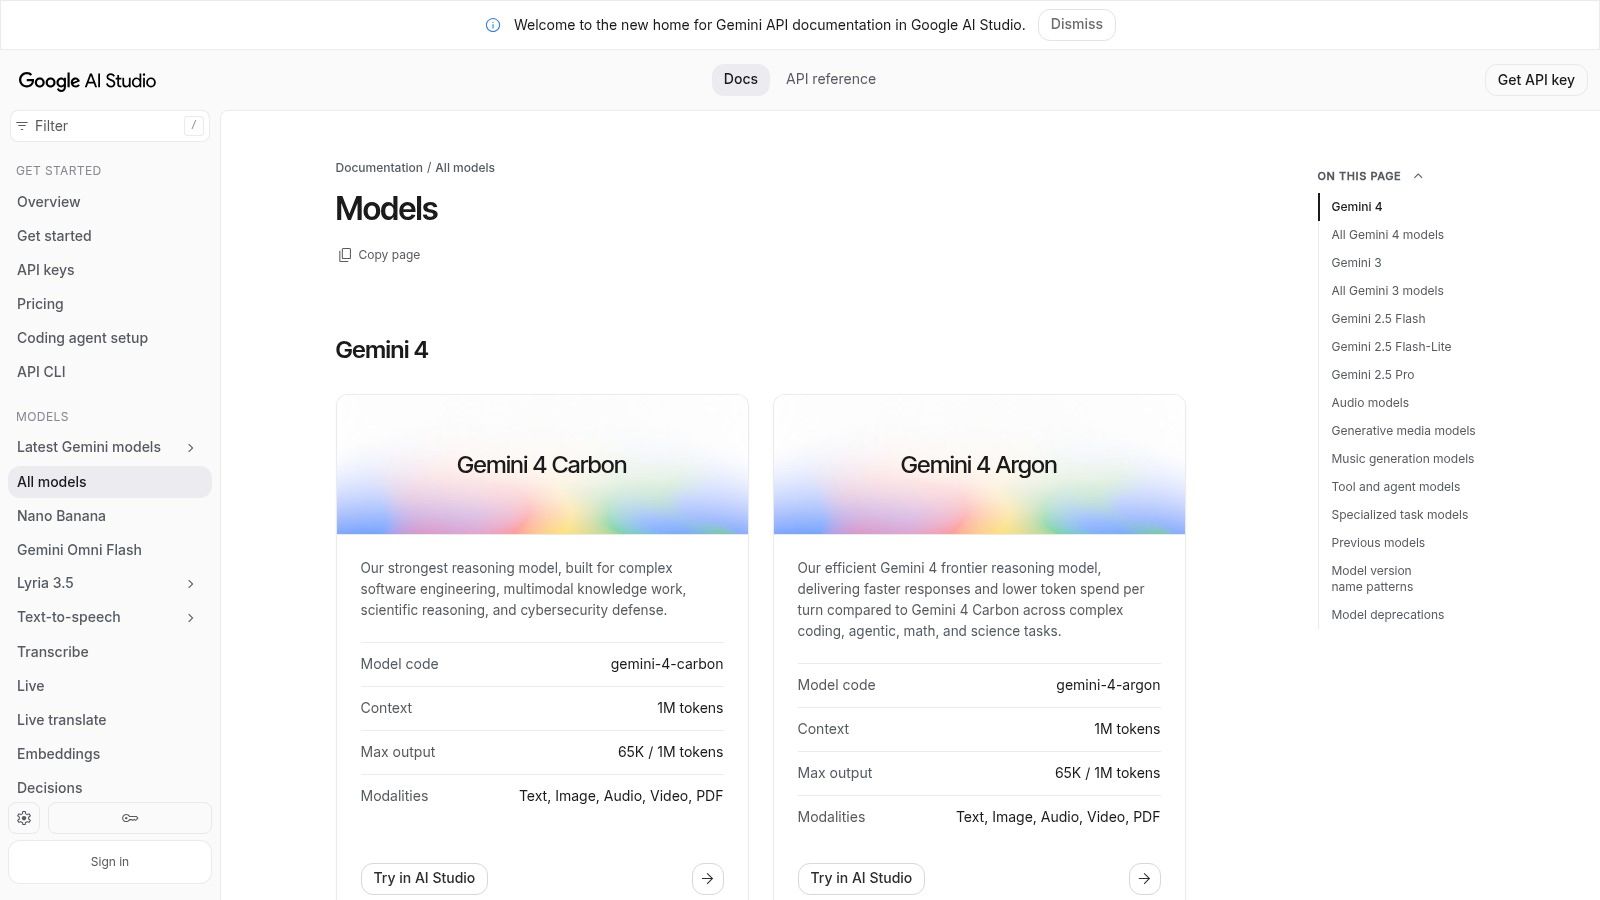
A volte la strada giusta è la più diretta. Se hai già scelto l'API Gemini, usa l'elenco ufficiale dei modelli API di Gemini per confermare identificatori del modello, descrizioni e funzionalità supportate.
Questa è documentazione di implementazione di prima parte, non un servizio di confronto tra provider. Collega la scoperta dei modelli con la documentazione API e Google AI Studio, rendendola utile quando devi trasformare una famiglia di modelli scelta in una richiesta funzionante.
Verifica l'identificatore esatto
Non sviluppare basandoti su un nome di famiglia di modelli copiato da un articolo di confronto. Conferma l'identificatore specifico e ispeziona i suoi input, output e condizioni di accesso supportati prima di integrare.
- Punto di forza: Informazioni dirette sul modello per gli sviluppatori che usano l'API Gemini.
- Ambito limitato: Non ti aiuterà a confrontare ogni provider concorrente.
- Avvertenza commerciale: Verifica il prezzo attuale, il livello di accesso e le condizioni di idoneità del modello selezionato.
Per un'applicazione legata all'audio, verifica se il modello specifico supporta il flusso di lavoro audio richiesto piuttosto che presumere che ogni modello Gemini esponga funzionalità identiche. Applica la stessa attenzione agli input multimodali e all'uso degli strumenti.
Mantieni i controlli del ciclo di vita anche nel tuo processo di manutenzione. La guida alla disattivazione delle API Veo e Gemini è pertinente quando si esaminano le dipendenze degli endpoint e il lavoro di migrazione.
L'elenco ufficiale è meglio utilizzato come riferimento per l'implementazione dopo una preselezione. Fornisce i dettagli necessari per effettuare una richiesta valida, mentre la tua valutazione determina se i risultati restituiti soddisfano i requisiti del prodotto.
Come i 10 cataloghi di modelli differiscono per accesso, visibilità dei prezzi e limiti
| Voce | Ideale per | Modello di Accesso | Visibilità dei Prezzi | Limitazione Principale |
|---|---|---|---|---|
| Catalogo modelli AI UberLLM (Consigliato) | Confrontare modelli tra diversi provider | API unificata e marketplace | Prezzi in tempo reale elencati | I cataloghi non prevedono le prestazioni specifiche del carico di lavoro |
| OpenRouter | Confrontare e accedere a modelli tra diversi provider | API ospitata con una sola key | Prezzi dei modelli mostrati; verificare le tariffe attuali | API ospitata, non pesi del modello scaricabili |
| Hugging Face Hub | Ricerca, personalizzazione e self-hosting | Download di modelli; l'hosting varia | Prezzi non elencati in modo coerente | La qualità e la documentazione dei modelli variano |
| Artificial Analysis | Confrontare benchmark, costi e velocità | Risorsa di ricerca e confronto; data API | Prezzi API mostrati; alcuni accessi potrebbero essere a pagamento | I benchmark potrebbero non riflettere il tuo carico di lavoro |
| Replicate Explore | Testare ed eseguire modelli generativi ospitati | API di modelli ospitati e deployment personalizzati | Prezzi specifici per modello; possono variare in base all'utilizzo | La qualità e il supporto dei modelli della community variano |
| Microsoft Foundry Models | Selezione di modelli per applicazioni Azure | Opzioni di deployment Azure | Varia in base al modello e alla regione | Più adatto agli utenti Azure |
| Catalogo modelli Amazon Bedrock | Trovare modelli per applicazioni AWS | Servizi Bedrock all'interno di AWS | Varia in base al modello e alla regione | Accesso dipendente da AWS e dalla regione |
| Google Cloud Model Garden | Trovare modelli per il deployment su Google Cloud | Servizi AI di Google Cloud | Varia in base al modello e alla configurazione | Orientato a Google Cloud |
| Ollama Library | Eseguire modelli localmente | Inferenza locale con Ollama | Nessun prezzo di hosting; utilizza il tuo hardware | Richiede configurazione e hardware adeguato |
| Elenco modelli API Google Gemini | Costruire con modelli Google | API Gemini e Google AI Studio | Pagina prezzi separata; i livelli variano | Copre solo i modelli Google |
Trasformare una Shortlist in un'Integrazione Funzionante
Smetti di navigare una volta che hai due o tre modelli plausibili per modalità. Più candidati non aiutano se il tuo team non ha definito come appare un risultato accettabile. Annota la lunghezza del contesto richiesta, i limiti di output, il supporto degli strumenti, i formati di input e i vincoli di deployment prima di eseguire i confronti.
Poi invia gli stessi prompt o task di generazione attraverso ogni candidato. Per l'estrazione di testo, convalida lo schema restituito e confronta i valori estratti con le risposte attese. Per la codifica, esegui test sulle modifiche generate; per i media, rivedi gli output rispetto a un brief coerente piuttosto che scegliere il campione che sembra più impressionante.
Valuta il percorso completo dell'applicazione
Includi il lavoro che circonda l'inferenza. La conversione di documenti, il recupero, l'esecuzione di strumenti, il polling, i tentativi e la convalida dell'output possono tutti determinare se un modello altrimenti capace è utilizzabile.
- Qualità: Registra i risultati accettati, non solo le richieste completate.
- Latenza: Misura sia la risposta iniziale che il completamento end-to-end, dove pertinente.
- Costo: Includi i tentativi, le generazioni rifiutate e le chiamate di follow-up necessarie.
- Affidabilità: Esercita timeout, output malformati ed endpoint non disponibili.
La discussione di Brookings sulla valutazione dei modelli AI spiega perché i punteggi di benchmark possono omettere preoccupazioni pratiche come la latenza, i requisiti di calcolo, il costo e la sicurezza. La tua valutazione dovrebbe rendere esplicite queste preoccupazioni invece di trattare una classifica pubblica come un test di accettazione in produzione.
Per i team che desiderano un unico endpoint per i flussi di lavoro di testo, immagini, video e audio, avvia l'integrazione di UberLLM impostando il base URL nella configurazione SDK esistente di OpenAI o Anthropic sull'endpoint API compatibile. Usa una chiave UberLLM e mantieni l'interfaccia SDK esistente e il codice circostante, quindi cambia i candidati modificando l'identificatore del modello. Convalida i parametri supportati da ciascun candidato e usa il flusso di lavoro di task asincroni appropriato per i media, invece di presumere che ogni modalità si comporti come una risposta di chat in streaming.
Mantieni la decisione riproducibile
Archivia insieme l'identificatore del modello, la versione del prompt, le impostazioni di generazione, gli input di valutazione e i risultati di accettazione. Questo record consente a un altro ingegnere di ripetere il test e rende più facili da valutare le successive modifiche al modello. Evita di affidarti a uno screenshot senza versione o a un'impressione ricordata della qualità dell'output.
Scegli un modello predefinito e definisci quando l'applicazione dovrebbe scalare o fallire in sicurezza. Un fallback è utile solo se soddisfa gli stessi requisiti essenziali, incluse le restrizioni sulla privacy e il supporto degli strumenti. La migliore lista di modelli AI è quella che ti aiuta a raggiungere una decisione di integrazione difendibile, quindi lascia il posto a test ripetibili.
UberLLM connette gli sviluppatori a modelli di testo, immagini, video, musica e voce di terze parti tramite un'API unificata e un saldo prepagato. Visita UberLLM per confrontare i limiti dei modelli e i prezzi in tempo reale, testare la tua shortlist nel playground e integrare i candidati che soddisfano i requisiti della tua applicazione.