Lista de Modelos de IA 2026: 10 Opções por Caso de Uso
Navegue por esta lista prática de modelos de IA por modalidade, capacidade e caso de uso, com 10 catálogos comparados em termos de preços, acesso e cargas de trabalho ideais.
Imagine sua equipe passa uma semana lendo páginas de modelos, comparando preços de token e configurando um protótipo. Então alguém carrega um documento representativo e descobre que o candidato mais barato não consegue encaixar o documento, as instruções e a resposta esperada em sua context window. A integração funciona. A escolha do modelo, não.
Um catálogo de modelos não é o mesmo que uma escolha de modelo. Alguns catálogos ajudam você a descobrir downloadable weights. Outros comparam performance medida, vendem hosted inference, conectam modelos a cloud procurement ou empacotam modelos para local execution. Tratá-los como intercambiáveis desperdiça tempo e pode esconder a restrição que determina se sua aplicação funciona.
Uma lista útil de AI models deve dizer onde começar para um trabalho específico:
- Descobrir e personalizar modelos: Use um diretório com model cards, arquivos e informações de licenciamento.
- Comparar candidatos para produção: Use medições independentes, depois teste sua própria workload.
- Chamar hosted models: Use um API catalog com model identifiers explícitos e detalhes de deployment.
- Executar offline: Use um local runtime catalog e verifique os requisitos de hardware.
Para aplicações de texto, context length e tool support podem eliminar candidatos imediatamente. Para aplicações de imagem, vídeo e áudio, supported inputs, output controls e asynchronous task handling merecem igual atenção. As opções abaixo servem a propósitos diferentes, então o ponto de partida certo depende menos de qual catálogo parece maior e mais do que você precisa fazer em seguida.
Sumário
- 1. Catálogo de modelos de IA UberLLM
- 2. OpenRouter
- 3. Hugging Face Hub
- 4. Artificial Analysis
- 5. Replicate Explore
- 6. Microsoft Foundry Models
- 7. Catálogo de modelos Amazon Bedrock
- 8. Google Cloud Model Garden
- 9. Ollama Library
- 10. Lista de modelos da API Google Gemini
- Como os 10 Catálogos de Modelos Diferem por Acesso, Visibilidade de Preços e Limites
- Transformando uma Lista Curta em uma Integração Funcional
1. Catálogo de modelos de IA UberLLM
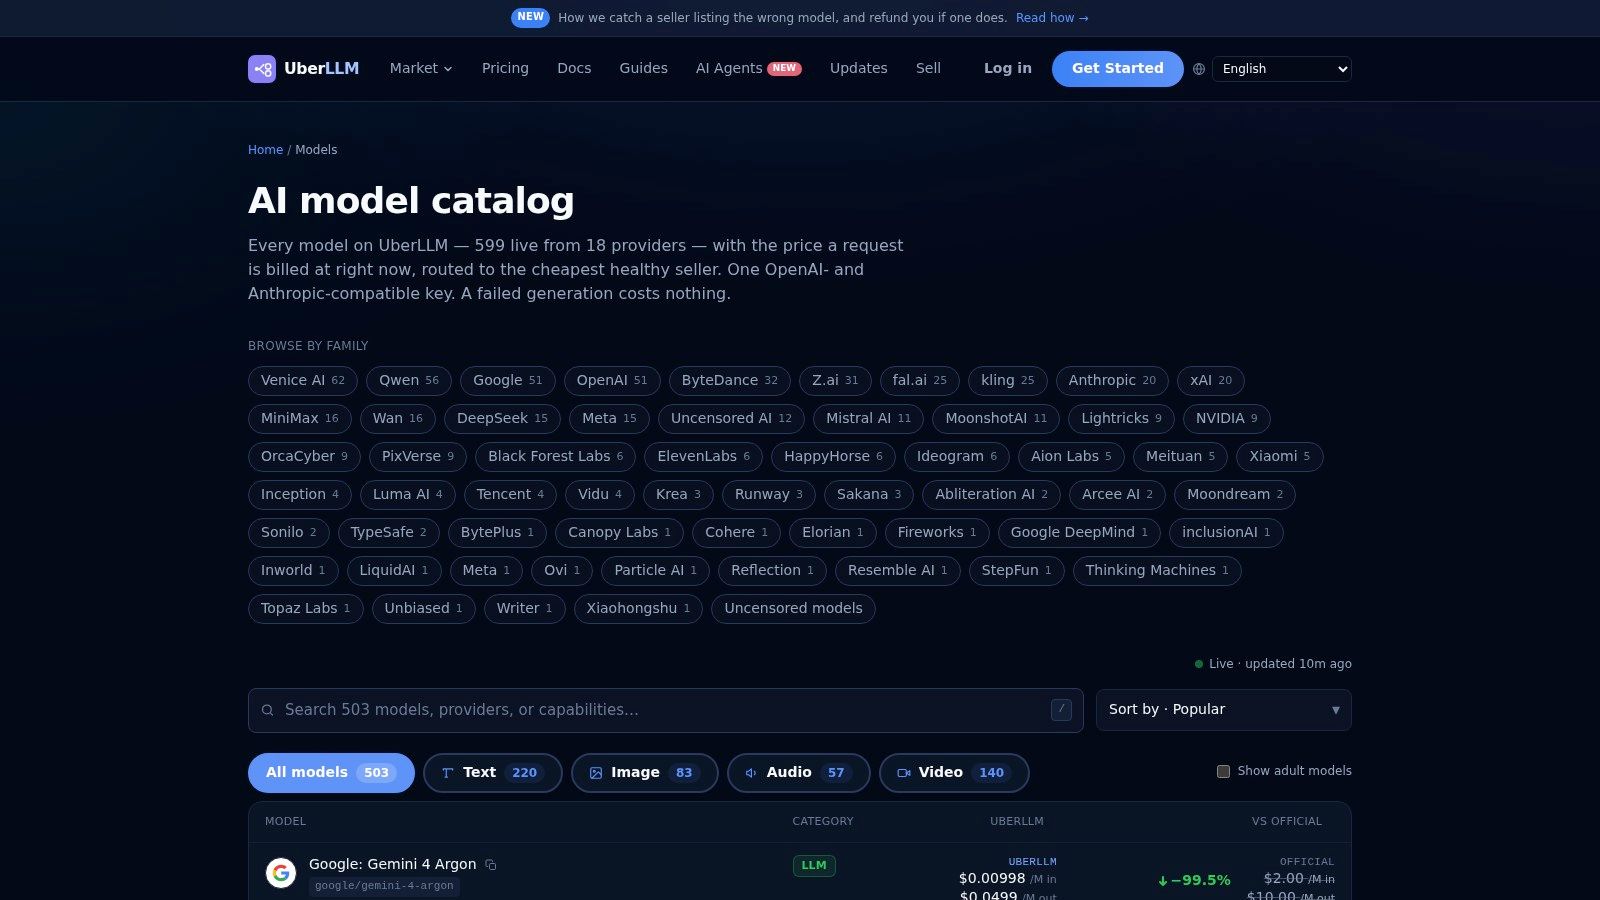
Melhor para comparar opções hospedadas antes de integrar uma API de marketplace. O catálogo de modelos de IA UberLLM reúne 457 modelos em uma página de comparação com preços em tempo real, nomes de provedores, comprimentos de contexto e tipos de modelo. É útil quando sua lista restrita abrange texto e mídia, em vez de uma única família de modelos.
Na UberLLM, conectamos esse processo de descoberta a um endpoint compatível com OpenAI e Anthropic. Os desenvolvedores selecionam um identificador de modelo, enquanto o roteamento do marketplace seleciona um vendedor disponível para o modelo solicitado. Essa distinção é importante: você está escolhendo tanto as capacidades de um modelo quanto um caminho de acesso hospedado.
O que inspecionar antes de escolher
Para processamento de documentos, compare o comprimento do contexto e o número máximo de tokens de saída separadamente. Um modelo que aceita seu material de origem ainda pode ter um limite de saída que o impede de gerar o resultado completo. Nossos metadados de modelo expõem ambos os campos, e o catálogo marca os modelos que suportam ferramentas.
- Ponto forte: Preços em tempo real e nomes de provedores tornam a seleção entre provedores menos fragmentada.
- Fluxo de trabalho útil: Filtre por modalidade, inspecione os limites e, em seguida, compare as saídas representativas no playground.
- Limitação: Uma listagem não pode determinar se seu esquema de extração, tarefa de codificação ou briefing visual será bem-sucedido.
Não trate o preço mais baixo exibido como a resposta final. Para texto, estime a combinação de entrada e saída que sua aplicação produz; para mídia, inspecione a configuração de geração solicitada antes de comparar os custos.
Regra prática: Escolha um modelo somente depois que seus limites, qualidade de saída e comportamento de falha satisfizerem a carga de trabalho. Uma solicitação barata que produz um resultado inutilizável não é uma economia útil.
Os preços e a disponibilidade podem mudar, então registre o identificador e a configuração usados nos testes, em vez de deixar sua lista restrita como uma coleção de nomes de modelos.
2. OpenRouter
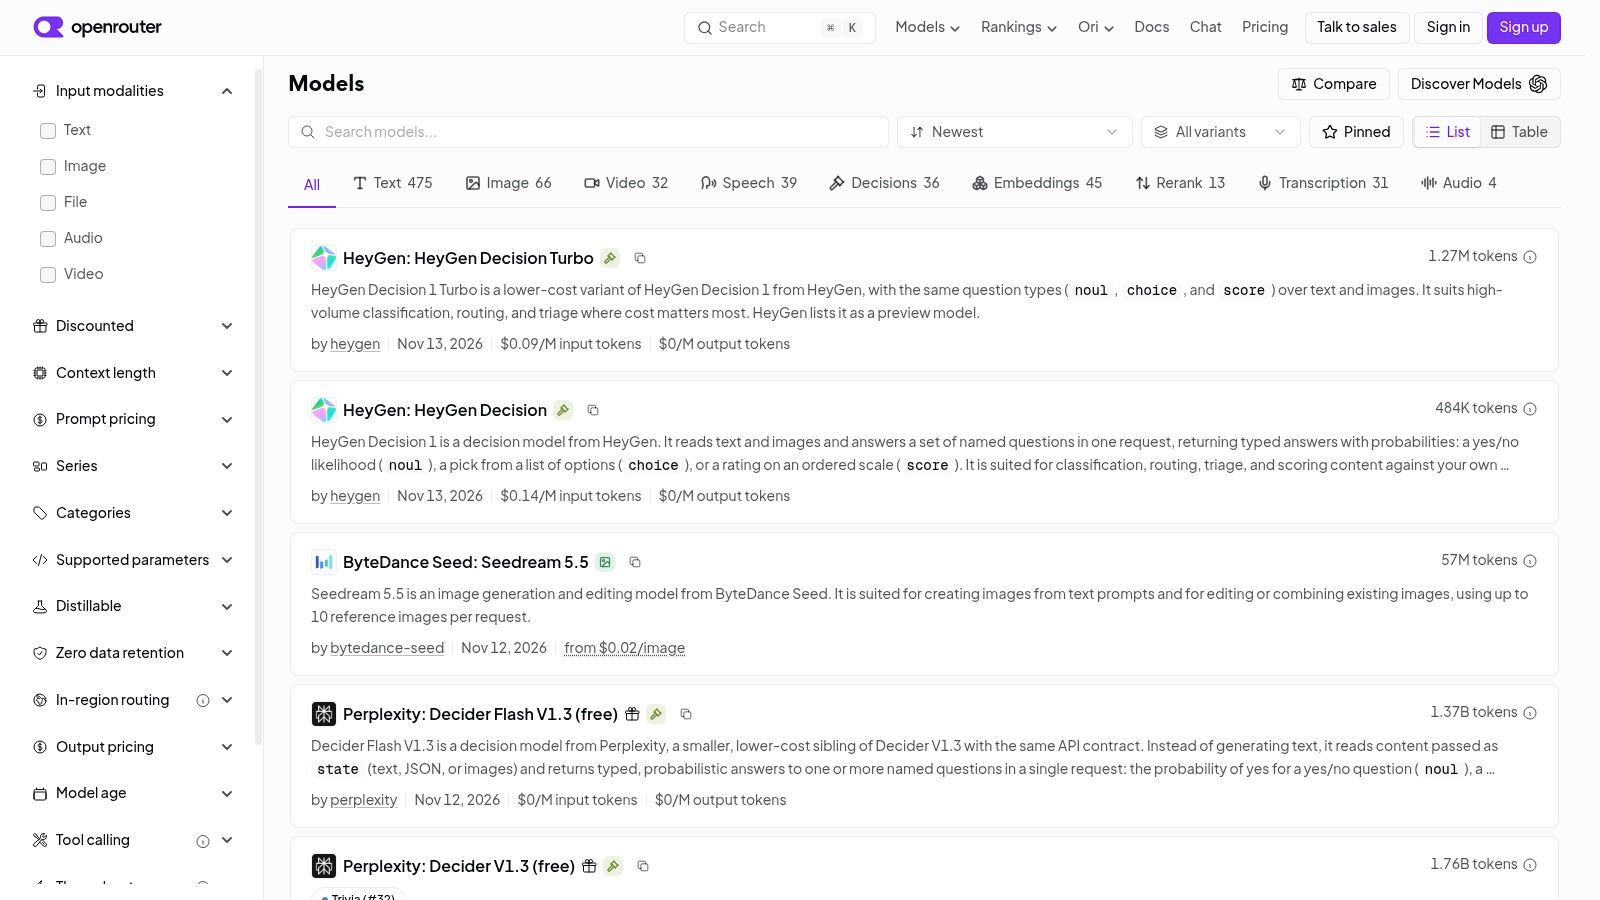
Se sua tarefa imediata é experimentar modelos hospedados sem construir integrações de provedores separadas, o catálogo de modelos do OpenRouter é um ponto de partida prático. Ele combina especificações de modelos pesquisáveis com acesso através de uma API comum.
Os campos de comparação úteis incluem preços, comprimento do contexto, modalidades e capacidades. Eles ajudam a distinguir modelos que apenas aceitam texto de candidatos que suportam as entradas ou comportamentos adicionais que sua aplicação exige. Verifique a página individual do modelo em vez de presumir que todo modelo exposto através da mesma interface aceita a mesma requisição.
Onde se encaixa
O OpenRouter é adequado para um desenvolvedor que compara candidatos hospedados dentro de uma aplicação existente. Você pode manter o ambiente de avaliação estável enquanto muda o modelo selecionado, embora os parâmetros suportados e o comportamento de saída ainda precisem de validação.
- O que funciona: Passar da descoberta para a experimentação de API sem organizar cada integração de provedor separadamente.
- O que não funciona: Tratar o catálogo como um repositório onde os pesos de cada modelo listado podem ser baixados.
- O que verificar: Disponibilidade atual, preços específicos do modelo, limites de contexto e capacidades necessárias.
Para um agente de codificação, teste os argumentos de chamada de ferramenta e a recuperação após uma execução de ferramenta falha, não apenas a qualidade de uma resposta de código autônoma. Uma API comum não torna o comportamento do agente intercambiável.
A comparação de alternativas ao OpenRouter é útil ao avaliar diferentes serviços de acesso. Mantenha essa decisão separada da seleção do modelo: o modelo e o serviço que o hospeda introduzem diferentes compensações operacionais.
3. Hugging Face Hub
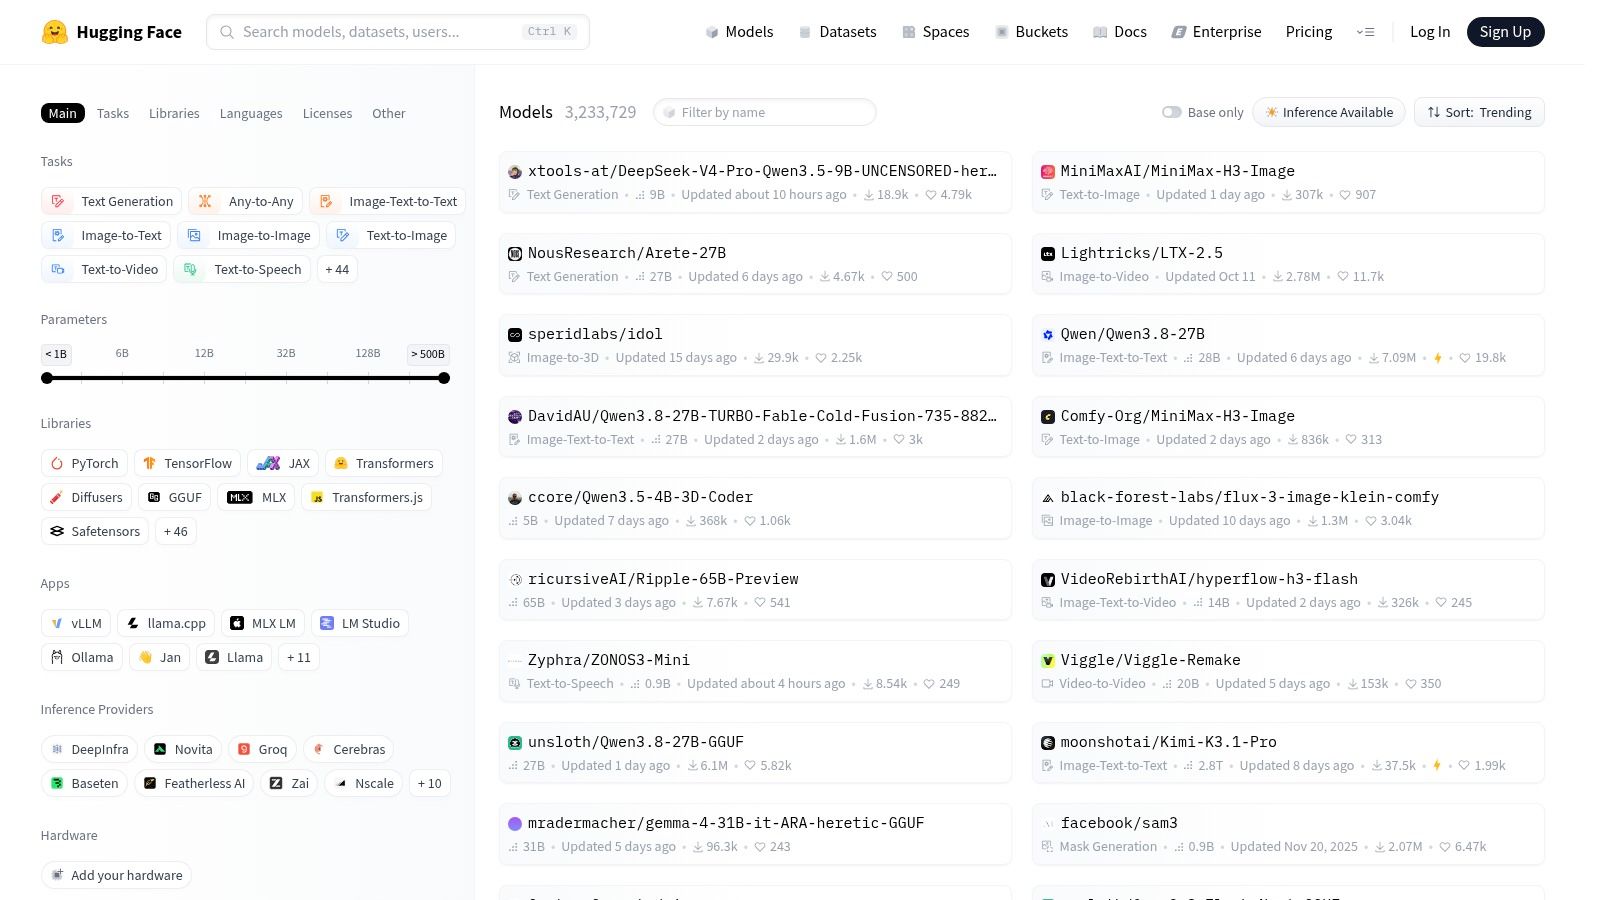
Comece com o Hugging Face quando precisar de pesos, não apenas de um endpoint. O Hugging Face Hub é particularmente útil para encontrar modelos que você pode personalizar, inspecionar ou implantar por conta própria.
Suas páginas de modelo podem combinar model cards, arquivos para download, exemplos de implementação e detalhes de licença. Isso o torna um tipo diferente de recurso em comparação com um menu de API hospedada: você está investigando o artefato e seus requisitos, não apenas decidindo qual identificador enviar em uma solicitação.
Vá além do nome do modelo
Verifique a tarefa, arquitetura, framework de inferência suportado e licença antes de fazer o download. Em seguida, inspecione se os exemplos correspondem ao seu uso pretendido, especialmente para modelos fine-tuned com prompt templates especializados.
- Força: Ampla descoberta em tarefas de texto, visão, imagem e áudio.
- Compromisso: A qualidade da documentação e avaliação depende do editor.
- Restrição de implantação: Um modelo para download não está automaticamente disponível como uma API gerenciada.
Por exemplo, uma equipe de processamento de documentos pode encontrar um modelo promissor de visão-linguagem, mas ainda precisará montar o pré-processamento, inferência e validação de saída. O repositório ajuda a estabelecer o que está disponível; ele não elimina o trabalho de implantação.
Pesos abertos também não significam uso irrestrito. Leia a licença real e as condições associadas em vez de inferir permissões do botão de download.
Use o Hugging Face para pesquisa e personalização quando o acesso aos arquivos subjacentes for importante. Se você só precisa comparar respostas hospedadas esta tarde, um catálogo de API pode levá-lo a um teste significativo mais rapidamente.
4. Análise Artificial
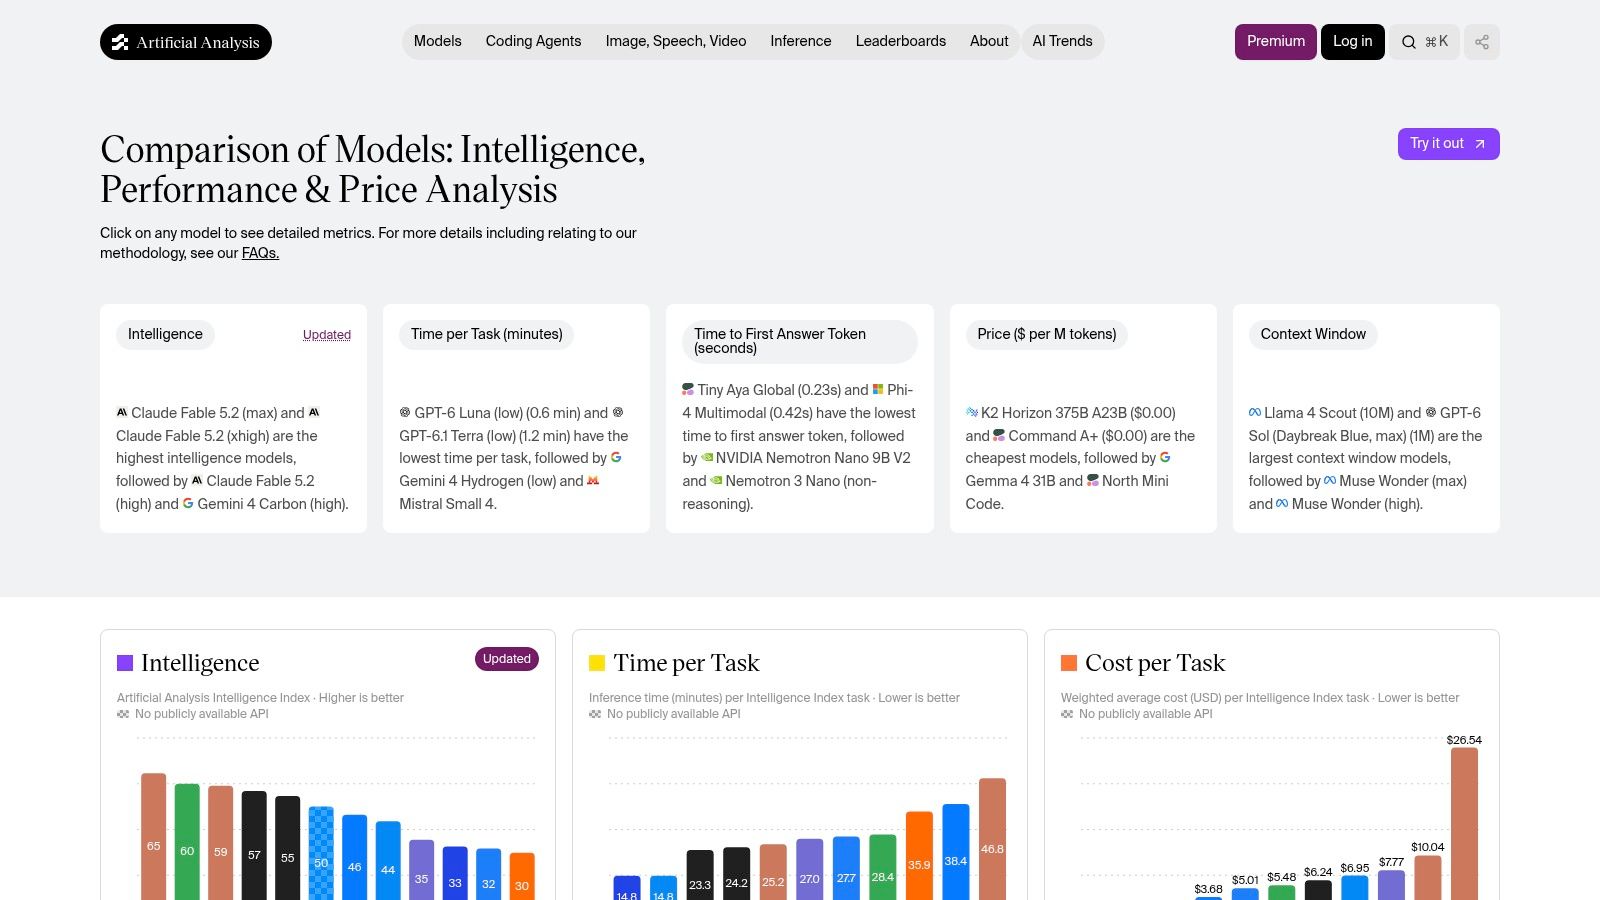
A pergunta difícil não é qual modelo tem o menor preço de token anunciado. É qual candidato atende ao seu requisito de qualidade a um custo total e tempo de conclusão aceitáveis.
Análise Artificial compara modelos usando medidas que incluem inteligência, preço, tempo por tarefa, latência para o primeiro token de resposta e tamanho da janela de contexto. Sua abordagem de custo por tarefa é mais útil para a seleção inicial do que ler preços de tokens isoladamente, pois conecta os custos a uma carga de trabalho.
Compare a métrica que seus usuários experimentam
Para um assistente interativo, o tempo para o primeiro token importa, mas não substitui o tempo de conclusão de ponta a ponta. Para um trabalho de extração em segundo plano, a conclusão validada e a despesa total podem importar mais do que a velocidade com que o texto aparece pela primeira vez.
- Use para: Identificar compensações entre capacidade, custo e velocidade antes dos testes da aplicação.
- Não use para: Assumir que um líder de benchmark vencerá em seus prompts ou idioma.
- Ressalva de acesso: Alguns conjuntos de dados ou recursos podem exigir uma conta ou acesso pago.
Compare o custo por tarefa bem-sucedida, não apenas o custo por solicitação. Inclua novas tentativas e saídas rejeitadas em sua própria avaliação.
O índice de preços de LLM fornece outra referência de preços ao montar uma lista de candidatos. Mantenha as suposições de carga de trabalho visíveis ao comparar qualquer índice.
Análise Artificial não é o lugar para baixar todos os modelos ou implantar sua aplicação. Seu trabalho é melhorar a lista de candidatos, deixando para sua própria estrutura determinar se esses candidatos atendem aos requisitos de produção.
5. Replicate Explore
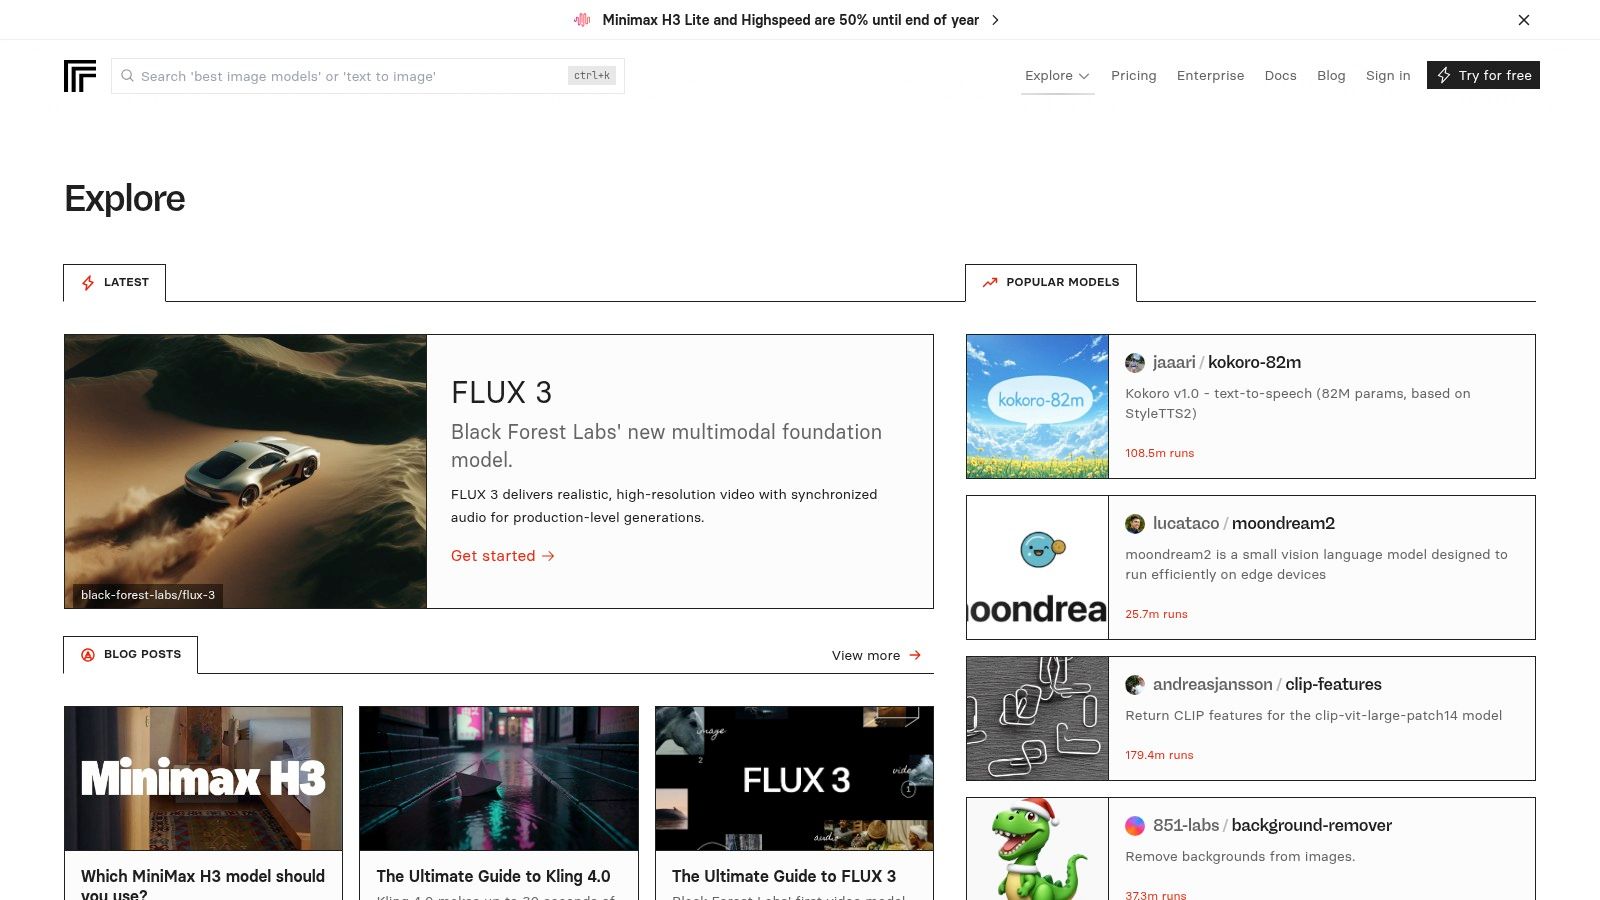
Testar um modelo de vídeo requer mais do que ler um ranking de modelos de linguagem. É preciso inspecionar as entradas aceitas, exemplos de saída, controles de geração e como o aplicativo recupera um resultado concluído.
Replicate Explore é útil para essa descoberta prática, especialmente para a geração de imagens, vídeos e áudios. As páginas dos modelos podem fornecer exemplos, definições de entrada, instruções de uso e preços, juntamente com um caminho de execução hospedado.
Teste com seu próprio material de origem
Para imagem para vídeo, use uma imagem representativa do seu aplicativo, não apenas os exemplos polidos do modelo. Verifique a consistência do assunto, movimento, composição e se a saída respeita o briefing. Para fala, teste nomes, pontuação e os idiomas que seus usuários enviam.
- Ponto forte: Você pode experimentar sem antes configurar a inferência local.
- Flexibilidade: Implantações personalizadas podem usar Cog, a ferramenta de empacotamento do Replicate.
- Limitação: Modelos publicados pela comunidade podem diferir em manutenção, documentação e suporte.
Inspecione se uma listagem é oficial e ativamente mantida antes de construir algo em torno dela. Leia também a unidade de faturamento cuidadosamente, já que o preço do modelo pode depender do tempo de execução ou da saída gerada, em vez de um cálculo de token no estilo de texto.
Replicate é uma escolha forte quando você precisa ver se um modelo generativo pode produzir mídia aceitável. É menos útil como um único ranking normalizado entre modalidades não relacionadas: um modelo de fala e um modelo de vídeo precisam de diferentes critérios de aceitação.
6. Modelos Microsoft Foundry
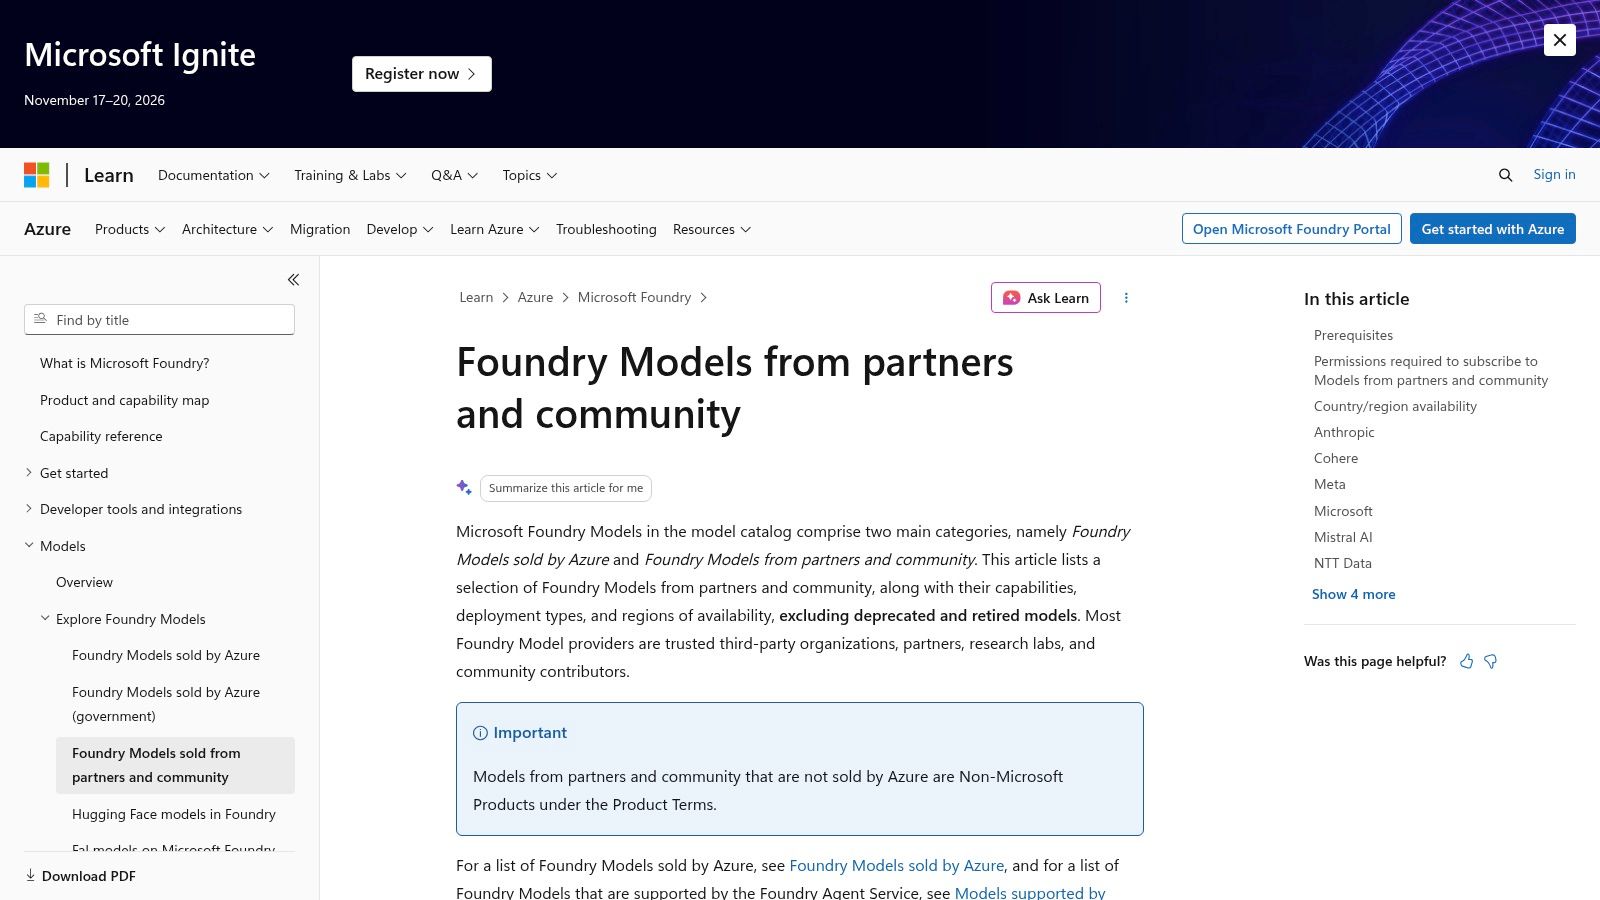
Para uma aplicação baseada em Azure, a elegibilidade de implantação pode ser tão importante quanto a capacidade do modelo. Um candidato promissor não é útil se o seu método de implantação disponível não se adequar à sua arquitetura ou região operacional.
Modelos Microsoft Foundry conecta a descoberta de modelos ao ambiente de nuvem da Microsoft. O catálogo inclui ofertas da Microsoft, de parceiros e da comunidade, com informações relevantes para tarefas, capacidades, licenciamento e opções de implantação.
Escolha o caminho de implantação junto com o modelo
Modelos elegíveis podem ter diferentes opções baseadas em API, batch, provisionadas ou de computação gerenciada. Não presuma que encontrar um modelo no catálogo significa que todas as abordagens de hospedagem e faturamento estão disponíveis para ele.
- Ideal para: Equipes que precisam que a seleção do modelo se alinhe com as decisões de implantação do Azure.
- Detalhe útil: Informações de implantação específicas do modelo e resultados de benchmark selecionados.
- Restrição: A disponibilidade, os métodos de implantação e os preços podem variar por modelo e região.
Uma equipe de análise de documentos deve investigar tanto o suporte de entrada do modelo quanto a configuração do endpoint que será implantado. Testar um endpoint de demonstração não é suficiente se a produção usar um arranjo de serviço materialmente diferente.
O catálogo é, portanto, um recurso de arquitetura, bem como uma ferramenta de descoberta. Use-o quando a integração com o Azure for um requisito real, não porque um modelo desejado apareça lá por acaso.
Para exploração neutra em relação ao provedor, uma ferramenta de comparação entre provedores é geralmente um ponto de partida mais limpo. Retorne ao Foundry quando estiver pronto para estabelecer o caminho prático de implantação na nuvem.
7. Catálogo de modelos do Amazon Bedrock
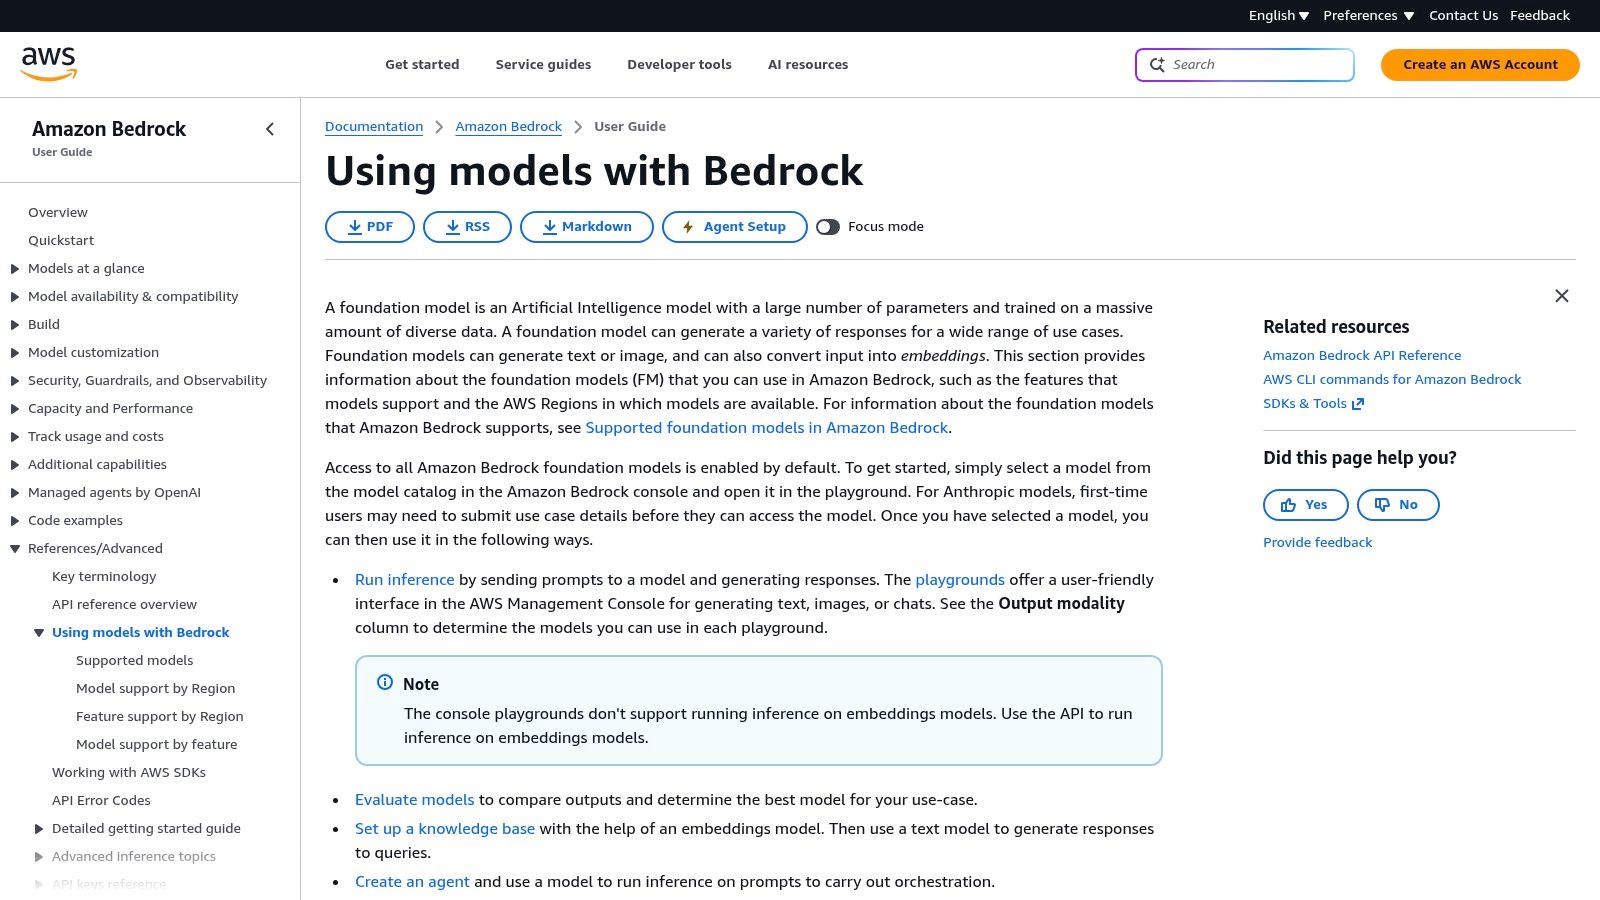
Verifique a disponibilidade regional antes de construir o protótipo. Esse é o hábito mais útil ao usar o catálogo de modelos do Amazon Bedrock para uma aplicação AWS.
O catálogo identifica modelos de base suportados e suas capacidades. As equipes podem inspecionar a disponibilidade regional e testar modelos elegíveis no playground do console do Bedrock antes de integrá-los em uma aplicação baseada em AWS.
Aquisição e acesso fazem parte da escolha
O Bedrock é particularmente relevante quando a aplicação já opera dentro da infraestrutura AWS. No entanto, a configuração da conta e o acesso regional podem afetar se o modelo que você deseja é utilizável no ambiente pretendido.
- O que funciona: Mover da descoberta de modelos suportados para uma implantação AWS.
- O que confirmar: Acesso à conta, região pretendida, entradas suportadas e requisitos de invocação.
- O que não é: Um inventário neutro de todos os modelos de IA disponíveis para download ou comercialmente.
Para um assistente de suporte, teste as mesmas passagens de recuperação e instruções que você planeja enviar da produção. O sucesso no playground estabelece que uma requisição pode funcionar; não estabelece que seu pipeline de recuperação, tratamento de erros e analisador de saída estejam corretos.
A força do Bedrock é sua conexão com a pilha de aplicações AWS. Essa mesma orientação é uma limitação para equipes que apenas desejam uma ampla pesquisa de opções de modelos sem se comprometer com uma integração específica da nuvem.
Mantenha um registro do modelo exato e da configuração de acesso usados na avaliação. Um nome de família de modelo reconhecível não é suficiente para reproduzir uma decisão de implantação.
8. Google Cloud Model Garden
Uma equipe desenvolvendo no Google Cloud deve avaliar o modelo e sua configuração de serviço juntos. Encontrar a família de modelos certa é apenas o começo; a configuração de implantação determina como ele se encaixa na aplicação.
Google Cloud Model Garden oferece descoberta de modelos do Google, de terceiros e abertos dentro do ambiente de IA do Google Cloud. É mais útil quando o próximo passo é o desenvolvimento baseado em nuvem, em vez de baixar um modelo para um runtime local não relacionado.
Separe a descoberta das suposições de implantação
Inspecione a oferta individual antes de estimar o custo ou o esforço de implementação. A disponibilidade e o preço dependem do modelo, da região e da configuração do serviço, portanto, uma entrada de catálogo por si só não estabelece a adequação para produção.
- Melhor uso: Explorar modelos para uma aplicação Google Cloud.
- Vantagem: Ofertas do Google e externas selecionadas aparecem no mesmo fluxo de trabalho de descoberta orientado para a nuvem.
- Limitação: É menos conveniente para uma pesquisa neutra em relação ao provedor ou experimentação offline.
Para um serviço de análise de imagem, confirme o formato de entrada aceito e então teste o pré-processamento exato que sua aplicação realiza. Redimensionamento, corte e conversão de documentos pertencem à avaliação, não apenas na implantação eventual.
Não confunda o Model Garden com a lista mais restrita de modelos da Gemini API. O primeiro ajuda na descoberta mais ampla de modelos na nuvem; o segundo fornece detalhes próprios para um ecossistema de API específico.
Use o Model Garden assim que sua equipe souber que o Google Cloud faz parte do plano de implantação. Caso contrário, comece com os requisitos do modelo e evite que um console de nuvem existente defina a lista de finalistas prematuramente.
9. Biblioteca Ollama
Se o requisito é executar um modelo na sua própria máquina, comece com um catálogo orientado a tempo de execução em vez de um marketplace de API hospedada. A Biblioteca Ollama ajuda os usuários a encontrar modelos, tamanhos, variantes e capacidades suportados para o fluxo de trabalho local do Ollama.
O tamanho do modelo é um filtro inicial útil, mas não é uma estimativa completa de hardware. O uso de contexto, a sobrecarga de tempo de execução e outros aplicativos que competem por memória também afetam se a configuração roda confortavelmente.
Teste a máquina real
Escolha um candidato que se adapte ao seu hardware, então exercite-o com comprimentos de entrada representativos. Um modelo que lida com um prompt de chat curto pode se tornar impraticável quando você adiciona documentos recuperados ou uma conversa longa.
A discussão sobre eficiência do AI Index de Stanford relata que o Phi-3-mini, com 3.8 bilhões de parâmetros, atingiu o mesmo limite MMLU declarado que anteriormente exigia os 540 bilhões de parâmetros do PaLM. Essa comparação apoia uma lição prática: a contagem de parâmetros por si só não é um ranking de qualidade.
- Força: Experimentação acessível com modelos executáveis localmente.
- Diferença de custo: A execução local evita taxas de uso de API hospedada, mas hardware e operação ainda custam dinheiro.
- Limitação: Sua máquina e os formatos suportados restringem a lista de opções.
A execução local não é automaticamente um sistema offline completo. Verifique se a recuperação, o registro (logging), as ferramentas e outros componentes do aplicativo também permanecem locais.
Ollama é um ponto de partida útil para protótipos offline e experimentos com restrições de hardware. Não elimina a necessidade de validar qualidade, uso de memória ou latência de ponta a ponta.
10. Lista de modelos da API Google Gemini
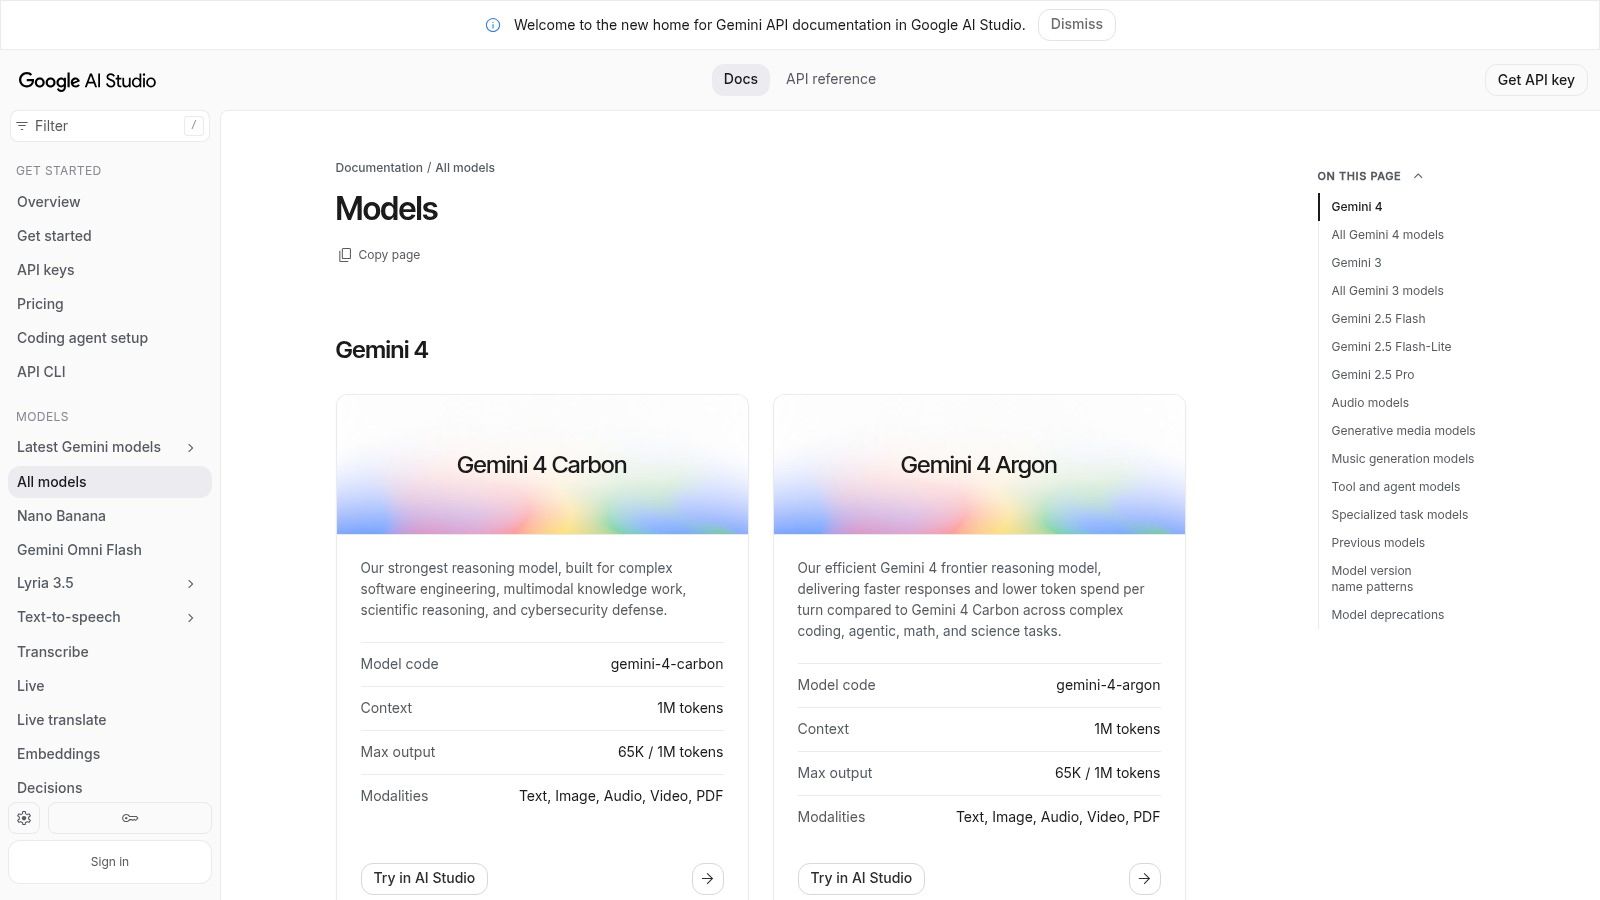
Às vezes, o caminho certo é o mais direto. Se você já escolheu a API Gemini, use a lista oficial de modelos da API Gemini para confirmar identificadores de modelo, descrições e capacidades suportadas.
Esta é uma documentação de implementação de primeira parte, não um serviço de comparação entre provedores. Ela conecta a descoberta de modelos com a documentação da API e o Google AI Studio, tornando-a útil quando você precisa transformar uma família de modelos escolhida em uma requisição funcional.
Verifique o identificador exato
Não desenvolva com base em um nome de família de modelos copiado de um artigo de comparação. Confirme o identificador específico e inspecione suas entradas, saídas e condições de acesso suportadas antes de integrar.
- Ponto forte: Informações diretas sobre modelos para desenvolvedores que usam a API Gemini.
- Limite de escopo: Não o ajudará a comparar todos os provedores concorrentes.
- Advertência comercial: Verifique o preço atual, o nível de acesso e as condições de elegibilidade do modelo selecionado.
Para uma aplicação relacionada a áudio, verifique se o modelo específico suporta o fluxo de trabalho de áudio necessário, em vez de assumir que todo modelo Gemini expõe funcionalidades idênticas. Aplique o mesmo cuidado a entradas multimodais e ao uso de ferramentas.
Mantenha também as verificações de ciclo de vida em seu processo de manutenção. O guia de desativação da API Veo e Gemini é relevante ao revisar dependências de endpoint e trabalho de migração.
A lista oficial é melhor utilizada como referência de implementação após a pré-seleção. Ela fornece os detalhes necessários para fazer uma requisição válida, enquanto sua própria avaliação determina se os resultados retornados atendem aos requisitos do produto.
Como os 10 Catálogos de Modelos Diferem por Acesso, Visibilidade de Preços e Limites
| Item | Melhor Para | Modelo de Acesso | Visibilidade de Preços | Principal Limitação |
|---|---|---|---|---|
| Catálogo de modelos de IA da UberLLM (Recomendado) | Comparar modelos entre provedores | API unificada e marketplace | Preços ao vivo listados | Os catálogos não preveem o desempenho específico da carga de trabalho |
| OpenRouter | Comparar e acessar modelos entre provedores | API hospedada com uma chave | Preços dos modelos exibidos; verificar taxas atuais | API hospedada, não pesos de modelo para download |
| Hugging Face Hub | Pesquisa, personalização e auto-hospedagem | Downloads de modelos; hospedagem varia | Preços não listados consistentemente | Qualidade e documentação do modelo variam |
| Artificial Analysis | Comparar benchmarks, custo e velocidade | Recurso de pesquisa e comparação; API de dados | Preços da API exibidos; alguns acessos podem ser pagos | Benchmarks podem não refletir sua carga de trabalho |
| Replicate Explore | Testar e executar modelos generativos hospedados | APIs de modelos hospedados e implantações personalizadas | Preços específicos do modelo; podem variar por uso | Qualidade e suporte da comunidade do modelo variam |
| Microsoft Foundry Models | Selecionar modelos para aplicações Azure | Opções de implantação Azure | Varia por modelo e região | Mais adequado para usuários Azure |
| Catálogo de modelos Amazon Bedrock | Encontrar modelos para aplicações AWS | Serviços Bedrock dentro da AWS | Varia por modelo e região | Acesso dependente da AWS e da região |
| Google Cloud Model Garden | Encontrar modelos para implantação no Google Cloud | Serviços de IA do Google Cloud | Varia por modelo e configuração | Orientado para o Google Cloud |
| Ollama Library | Executar modelos localmente | Inferência local com Ollama | Sem preço de hospedagem; usa seu hardware | Requer configuração e hardware adequado |
| Lista de modelos da API Google Gemini | Construir com modelos Google | API Gemini e Google AI Studio | Página de preços separada; níveis variam | Cobre apenas modelos Google |
Transformando uma Lista Curta em uma Integração Funcional
Pare de pesquisar assim que tiver dois ou três modelos plausíveis por modalidade. Mais candidatos não ajudam se sua equipe não definiu como um resultado aceitável se parece. Anote o comprimento de contexto necessário, limites de saída, suporte a ferramentas, formatos de entrada e restrições de implantação antes de executar as comparações.
Em seguida, envie os mesmos prompts ou tarefas de geração para cada candidato. Para extração de texto, valide o esquema retornado e compare os valores extraídos com as respostas esperadas. Para codificação, execute testes contra as alterações geradas; para mídia, revise as saídas em relação a um briefing consistente, em vez de escolher a amostra que pareça mais impressionante.
Avalie o caminho completo da aplicação
Inclua o trabalho em torno da inferência. Conversão de documentos, recuperação, execução de ferramentas, polling, retentativas e validação de saída podem determinar se um modelo, de outra forma capaz, é utilizável.
- Qualidade: Registre os resultados aceitos, não apenas as requisições concluídas.
- Latência: Meça tanto a resposta inicial quanto a conclusão de ponta a ponta, quando relevante.
- Custo: Inclua retentativas, gerações rejeitadas e chamadas de acompanhamento necessárias.
- Confiabilidade: Exercite timeouts, saídas malformadas e endpoints indisponíveis.
A discussão da Brookings sobre avaliação de modelos de IA explica por que as pontuações de benchmark podem omitir preocupações práticas como latência, requisitos de computação, custo e segurança. Sua avaliação deve tornar essas preocupações explícitas, em vez de tratar uma classificação pública como um teste de aceitação em produção.
Para equipes que desejam um único endpoint para fluxos de trabalho de texto, imagem, vídeo e áudio, inicie a integração do UberLLM definindo a base URL na configuração do seu SDK existente da OpenAI ou Anthropic para o endpoint de API compatível. Use uma chave do UberLLM e mantenha a interface do SDK existente e o código circundante, então troque os candidatos alterando o identificador do modelo. Valide os parâmetros suportados por cada candidato e use o fluxo de trabalho de tarefa assíncrona apropriado para mídia, em vez de assumir que toda modalidade se comporta como uma resposta de chat em streaming.
Mantenha a decisão reproduzível
Armazene o identificador do modelo, a versão do prompt, as configurações de geração, as entradas de avaliação e os resultados de aceitação juntos. Esse registro permite que outro engenheiro repita o teste e facilita a avaliação de futuras alterações no modelo. Evite depender de uma captura de tela sem versão ou de uma impressão lembrada da qualidade da saída.
Escolha um modelo padrão e defina quando a aplicação deve escalar ou falhar de forma segura. Um fallback só é útil se atender aos mesmos requisitos essenciais, incluindo restrições de privacidade e suporte a ferramentas. A melhor lista de modelos de IA é aquela que o ajuda a tomar uma decisão de integração defensável e, em seguida, abre caminho para testes repetíveis.
O UberLLM conecta desenvolvedores a modelos de texto, imagem, vídeo, música e fala de terceiros através de uma API unificada e saldo pré-pago. Visite UberLLM para comparar limites de modelos e preços em tempo real, testar sua lista curta no playground e integrar os candidatos que atendem aos requisitos da sua aplicação.