AI生成ミュージックビデオ:仕組みと使用ツール
AI生成ミュージックビデオとは何か、4段階のパイプラインがどのように構築するか、そしてどのモデルとチェックがそれを機能させるかを知りましょう。
音楽クリエイターは、GEMA]が要約したCISACの経済影響調査によると、2028年までに収益の**24%**が危険に晒されると予測されています。この予測は、AI生成のミュージックビデオを異なる視点で見せています。それらは単なる視覚的な実験ではなく、アーティスト、編集者、そして視聴者に影響を与える制作上の選択肢なのです。
責任を持って制作するには、魅力的なプロンプト以上のものが必要です。楽曲に基づいた制作計画、個別に修正可能なクリップ、測定可能な同期チェック、そして人間とモデルが何に貢献したかを明確に説明することが求められます。
目次
- AI生成ミュージックビデオとは何か
- 曲から完成ビデオまでの4つの段階
- プロンプトと画像を動きに変えるモデル
- リップシンクとビートアライメントの確認
- よくある問題とその解決策
- 信頼を失わずにAIの関与を開示する
- 全曲にコミットする前に最初のクリップをテストする
AI生成ミュージックビデオとは
AI生成ミュージックビデオとは、映像、サウンドトラック、またはその両方が、完全に録音または撮影されるのではなく、生成モデルで制作されるミュージックビデオのことです。例えば、故郷を離れる歌を録音したとします。その場合、電車の窓からの風景を生成したり、歌手のポートレートをアニメーション化したりして、それらのショットを既存の録音に合わせて組み立てることができます。
米国に焦点を当てた2026の調査で、1,003のビデオクリエイター、ミュージシャン、マーケター、音楽スーパーバイザーのうち、Berklee]によると、19%が生成AIを使用してビデオ用の音楽を見つけたり作成したりし、32.7%が公開コンテンツの最終オーディオとしてAI生成音楽を使用しました。これらの数値は、ビデオワークフロー内の音楽に関するものであり、AIによって完全に生成されたミュージックビデオの割合ではありません。
プロジェクトがAIを使用できる3つの方法
- 完全合成: 楽曲と動画の両方が生成モデルから作成され、人が結果を指示し選択します。
- ハイブリッド: 人が録音したトラックが、電車の窓からのシーケンスなどの生成されたシーンに付随します。
- AIアシスト: パフォーマンスを撮影し、AIを編集やエフェクトに使用します。これは狭義のAI生成ビデオとは限りません。
楽曲を楽譜、プロンプトをモデルが解釈するショットリストと考えてください。画面に何を表示するかを決定するのは、依然としてあなたの責任です。
Text-to-videoは、書かれた指示をクリップに変換します。Image-to-videoは、提供された静止画をアニメーション化します。セグメントは楽曲の区切られた部分であり、ショットプロンプトはそのイメージを指示し、最終編集は選択された素材を組み合わせます。
ツールを選択する前に、プロジェクトの各部分(録音、ボーカル、歌詞、参照画像、生成されたショット、編集)を特定してください。どれが人間が作成したもので、どれを生成するかをマークしてください。その簡単な目録が、あなたがどのバージョンを作成しているかを教えてくれます。
曲から完成動画までの4つのステージ
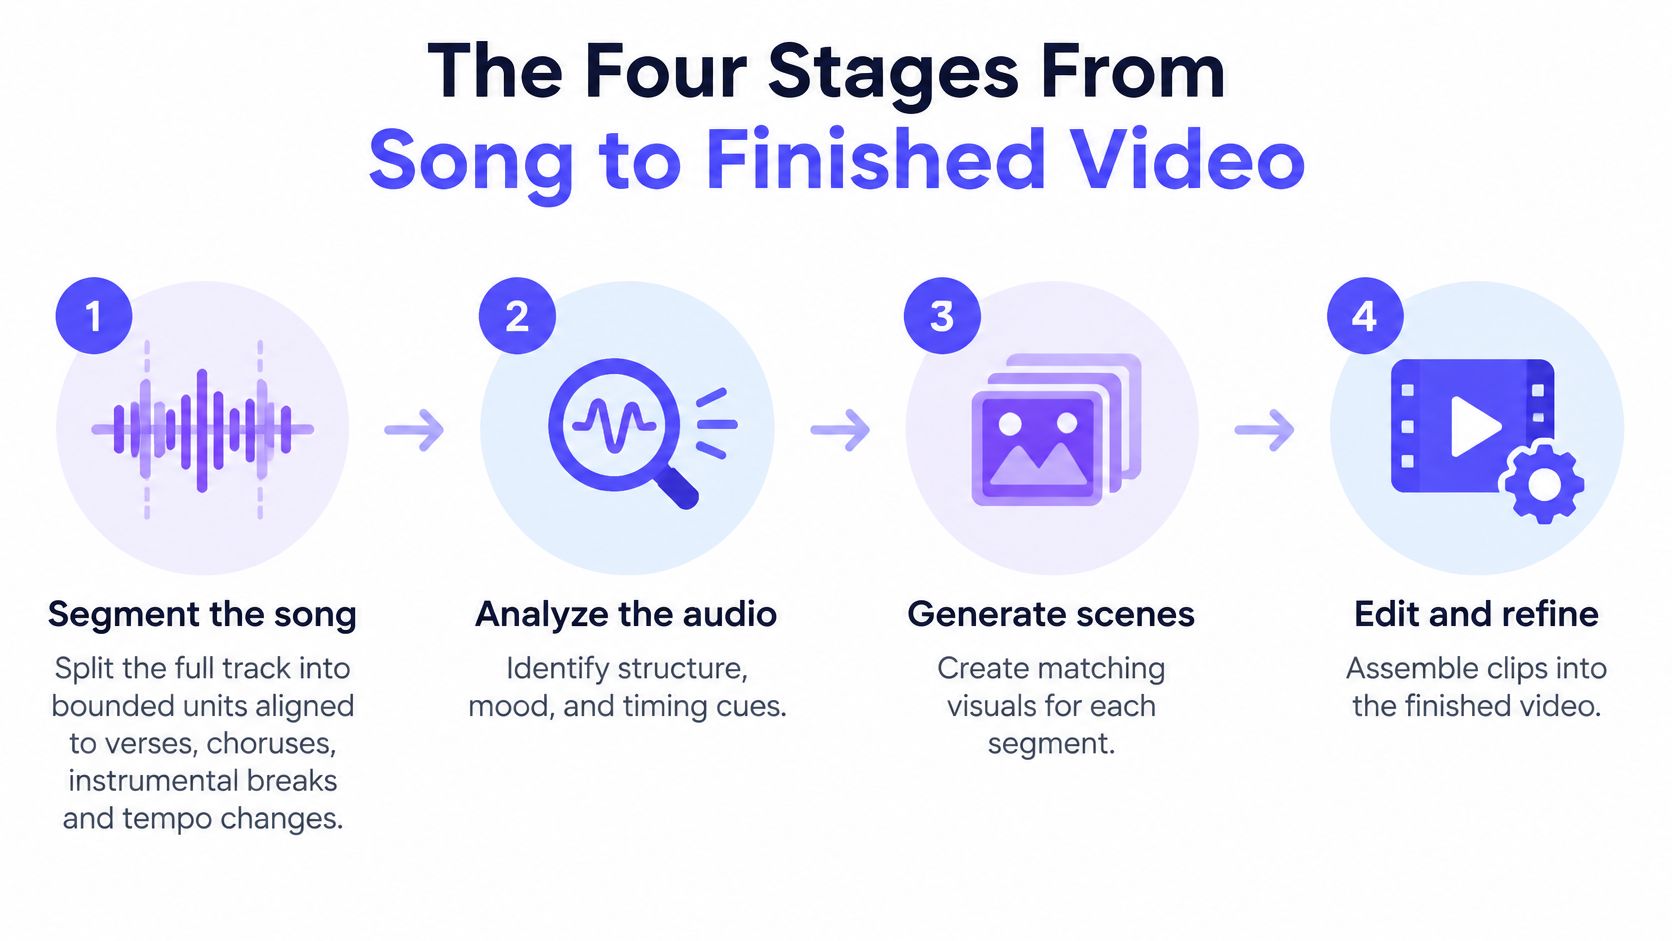
曲1曲分の制作は、扱いやすい作業の集まりとして捉えると、コントロールしやすくなります。公開されているサウンドから映像へのパイプラインは、曲のセグメント化、音声分析とスクリプト生成、text-to-video生成、最終的な組み立てをたどります。
以下のワークフローでは、クリエイティブな判断とレンダリング作業を分けています。
音楽構造を軸に組み立てる
曲をセグメント化する。 ヴァース、コーラス、音楽のみのブレイク、テンポチェンジをマークし、それらを範囲が限定された生成単位に分割します。1つの音楽セクションに複数のショットを含められるので、コーラスというラベルを、1つの連続したクリップを生成しなければならない要件と混同しないでください。
音声を分析し、ビジュアルスクリプトを書く。 テンポ、エネルギー、ボーカルのパッセージ、気分の変化を特定し、各セグメントにショットプロンプトを割り当てます。家を出る歌の場合、静かなヴァースでは静止したプラットフォームのシーンを使い、コーラスでは前へ進む動きを導入するかもしれません。
クリップを生成する。 独立して説明されたシーンにはtext-to-videoを、提供されたビジュアル参照が重要な場合にはimage-to-videoを使います。編集に採用する前に、各結果を割り当てられた目的に照らして確認します。
最終編集を組み立てる。 承認されたクリップをマスタートラックに対して決定論的な順序で配置します。フレームレート、解像度、アスペクト比、最終ラウドネスを標準化して、混在した出力が1つの制作物のように振る舞うようにします。
パイプラインのステージ、入力、出力
| ステージ | 入力 | 出力 |
|---|---|---|
| 1. 曲をセグメント化する | タイムスタンプ付きのフルトラック | タイムコードとラベル付きの範囲が限定されたセグメント |
| 2. 音声を分析してスクリプトを書く | セグメント、テンポ、ボーカルキュー | セグメントごとに1つのショットプロンプト |
| 3. クリップを生成する | ショットプロンプト、任意の参照静止画 | セグメントごとに1つの短いクリップ。seedとモデルバージョンを保存 |
| 4. 最終編集を組み立てる | クリップとオリジナルトラック | 一定のフレームレートでラウドネスを正規化した1つのレンダー |
すべてのセグメントを復元可能にする
範囲が限定されたクリップは、生成されたシーケンスが続くにつれてオブジェクト、アイデンティティ、アクションが変化する時間的ドリフトを抑えるのに役立ちます。また、成功したシーケンスを捨てずに、弱いショットを差し替えられます。
各セグメントのタイムコード、歌詞または音楽のみのラベル、テンポ、エネルギー、ショットプロンプト、seed、モデルバージョン、出力場所を含む制作マニフェストを保存します。該当する場合は、その記録と一緒に参照画像の識別子も保持します。seedは実行を記録するのに役立ちますが、モデルの更新をまたいで同一の結果を保証するものではありません。
制作ルール: セグメントマニフェストを、完了したダウンロードのログではなく、編集可能なプロジェクトとして扱いましょう。
計画と組み立ての実践的な参考として、AIMVGのミュージックビデオ制作ウォークスルーは役立つワークフローの参考になります。レンダリング層を実装する開発者は、AI動画生成APIガイドを使って、それらのセグメント記録を生成タスクに接続できます。
プロンプトと画像を動きに変えるモデル
Text-to-videoは創造の余地を与え、image-to-videoは視覚的な出発点を提供します。 この違いは、曲全体に一つのモデルを選ぶことよりも重要です。
Text-to-videoでは、被写体、設定、アクション、カメラ、照明を記述します。これは、風景、象徴的なイメージ、そして正確な繰り返し登場する顔が不可欠ではない確立されたショットに役立ちます。独立した生成は同じ記述を異なる方法で解釈する可能性があるため、単に言葉を繰り返すだけではアイデンティティ制御戦略にはなりません。
Image-to-videoは、あなたが提供する静止画から始まります。服装、構図、顔の表情を固定できますが、その後のすべてのフレームを固定するわけではありません。難しい動きやカメラアングルは、依然として望ましくない変化を生み出す可能性があります。
入力をショットに合わせる
繰り返し登場する歌手の場合、顔が遮られておらず、読み取り可能な服装のきれいな参照画像を準備してください。image-to-videoに関するSynchronicity Labsは、静止画を指示された動きのあるショットに変える方法を決定する際に役立つ情報源です。
以下のファミリーは、品質ランキングではなく、開始候補を提供します。各役割を自分の素材でテストするものとして扱い、提出する前に現在のendpointがサポートする入力を確認してください。
入力モードとミュージックビデオでの役割別モデルファミリー
| モデル | 入力モード | ミュージックビデオでの典型的な役割 | 注意点 |
|---|---|---|---|
| Kling 3.0 Standard | Text to videoまたはimage to video | 汎用ショットと初期候補 | セグメントを計画する前にクリップの長さ制限を確認してください |
| Veo 3.1 Fast | Text to video | ムードと確立されたショットの反復 | 現在の解像度とオーディオオプションを確認してください |
| Seedance 2.0 | Image to video | 静止画に固定されたアーティストまたはキャラクターショット | きれいな参照画像が必要です |
| Wan 2.6 | Text to video | インストゥルメンタルおよび抽象的なセグメント | 承認する前にモーションの連続性を確認してください |
| PixVerse V5.6 | Text to video | スタイライズされたまたは実験的なセグメント | スタイライズが必須の詳細を保持していることを確認してください |
外見とパフォーマンスを分ける
視覚的に一貫した顔が、自動的に歌唱パフォーマンスになるわけではありません。リップシンクおよびオーディオ駆動モデルは、提供されたオーディオに対する口の動きを処理します。通常の画像アニメーションがその役割を果たすと仮定すべきではありません。
実用的な組み合わせは、雰囲気のある場面にはtext-to-video、繰り返し登場するアーティストのショットにはimage-to-video、そして目に見える歌唱にはオーディオ駆動のステップを使用することです。コンセプトがナラティブまたはビジュアライザーとしてより効果的であれば、パフォーマンスのクローズアップを完全に避けることもできます。
プロンプトは観察可能なアクションに焦点を当ててください。text-to-videoプロンプトガイドは、抽象的なムードをカメラの方向と被写体の動きに変換するのに役立ちます。クリップの制限、解像度オプション、生成時間はリリースごとに変更されるため、ブランドの知名度ではなく、セグメントの要件に基づいてモデルを選択してください。
リップシンクとビートアライメントの確認
美しい顔でも、間違った音節を歌うことがあります。視覚的な忠実度と視聴覚的な同期は、別々の受入基準です。リップシンク評価論文]では、615個の生成されたクリップを調査し、口の動きと音声の一致を評価するために、ランドマーク距離 (LMD) や リップシンクエラー信頼度 (LSE-C) などの測定基準を使用しています。
LMDは、口領域のランドマークエラーを期待される動きと比較して測定します。LSE-Cは、唇の動きがスピーチトラックと一致しているという信頼度を推定します。どちらも完全な芸術的スコアとして扱われるべきではなく、スピーチ指向の測定基準は、持続的な歌唱、バッキングボーカル、または表現豊かな口の形に適用する際には慎重な解釈が必要です。
順番にチェックを実行する
- ビートとオンセットのタイムスタンプを抽出します。 音声分析ツールを使用して、リズムの位置と音の立ち上がりを特定します。すべてのビートをトランジションに強制するのではなく、どのイベントがカットまたは動きのアクセントを必要とするかをマークします。
- ボーカルセグメントをマークします。 視覚的なパフォーマーが歌っているべき場所を特定します。正しいボーカル抜粋を使用し、マスタートラックに対するオフセットを保持します。
- 各クリップを採点し、検査します。 視覚的な歌唱に口関連の測定基準を適用し、タイミングと音楽的な適合性を評価します。通常速度とフレームバイフレームの両方で視聴します。
- 失敗したセグメントのみを再生成します。 交換を要求する前に、失敗がタイミング、発音、画質、または音楽的解釈のいずれに関するものかを記録します。
同期チェックとそれぞれの適用箇所
| チェック | 測定内容 | 適用対象 |
|---|---|---|
| 口のランドマークエラー (LMD) | 口領域のランドマークと期待される動きとの距離 | ボーカルセグメント |
| リップシンク信頼度 (LSE-C) | 唇の動きがスピーチトラックと一致しているか | ボーカルセグメント |
| ビートまたはオンセットのアライメント | カットや動きのアクセントが音楽イベントに合致しているか | すべてのセグメント境界 |
| リズムとムードの一致 | 動きのペースとトーンがトラックに沿っているか | インストゥルメンタルセグメント |
最終レンダリング前にゲートを定義する
すべての歌手、スタイル、またはモデルに適用できる普遍的な合格スコアは提供されていません。レビューして承認したクリップを使用してゲートを調整し、プロジェクト内でそれらの設定を一貫して維持してください。
- 口の動きゲート: 許容できない発音エラーや同期信頼度が低い視覚的な歌唱を却下します。
- タイミングゲート: 指定された音楽イベントでの意図しないミスを却下します。
- 動きの一貫性ゲート: 意図されたペース、ムード、または主題に反する動きを却下します。
- 知覚ゲート: 数値スコアが許容範囲に見えても、注意をそらす顔の歪みを却下します。
歌手の口が正しい言葉を追っているのに、パフォーマンス全体が遅れて始まる場合を想定します。新しいパフォーマンスを依頼する前に、クリップのオフセットを修正してください。タイミングは正しいのに口が異なる音を発している場合、編集だけでは修正できません。
ビートの前の意図的なカットは機能することがあります。意図したアクセントの後の偶発的なカットは制作上のエラーです。
スコアとレビューメモをセグメント記録と一緒に保存してください。それにより、各却下の理由が明確になり、代替品の選択がより恣意的でなくなります。
よくある問題とその解決策
ショット間でキャラクターの服装や顔が変わる場合は、まずソース素材と生成指示を確認してください。すべての同一性の不一致をトランジションで隠そうとしないでください。問題が参照、生成されたパフォーマンス、またはアセンブリのいずれに属するかを判断してください。
再生成する前に診断する
よくある制作上の問題、原因、解決策
| 症状 | 考えられる原因 | 解決策 |
|---|---|---|
| ショット間でキャラクターが変わる | 独立したセグメント間でプロンプトがずれる | キャラクターごとに1つの固定参照静止画を使用して画像から動画を生成する |
| 口がボーカルと同期していない | セグメントのタイミングがボーカルステムと一致しない | 修正されたタイムコードでセグメントを再生成し、リップシンクの信頼性を再確認する |
| カットがビートから外れる | 境界が目測で設定され、検出されたオンセットではない | アセンブリ中にオンセットのタイムスタンプで再カットする |
| 長いクリップでのちらつきやモーフィング | モデルが安定して保持できるよりもクリップが長い | 短いセグメントを使用し、編集で結合する |
| クリップ間で色やフレームレートが異なる | 出力設定が混在している | アセンブリでフレームレート、解像度、アスペクト比を正規化する。色合わせは別途行う |
| カット間で音量が不均一 | 最終ミックスでラウドネス正規化が行われていない | 編集全体でラウドネスを正規化する |
| クラッシュ後に1つのクリップが失敗した | セグメント回復の代わりにプロジェクト全体の再実行が使用された | 保存されたシードとメタデータからそのセグメントのみを再生成する |
編集の修正とデザインの変更を区別する
アセンブリの修正には、カットの移動、オフセットの修正、色合わせ、エクスポート設定の修正などが含まれます。新しいイメージに費用をかける前に、これらを試してください。クロッピングはフレーミングの不一致を解決できますが、歌手の手を削除したり、重要なアクションをカットしたりしないように、結果を注意深くプレビューしてください。
生成の修正は、実際のコンテンツが間違っているため、新しいクリップが必要です。例としては、モーフィングする顔、不正確なアーティキュレーション、被写体を隠すカメラの動きなどがあります。プロンプト全体を書き直すのではなく、特定の失敗した指示を変更してください。
コンセプトの修正には、より広範な再検討が必要です。すべてのショットが、選択したアプローチでは維持できない複雑な振り付けに依存している場合、パフォーマンスを簡素化するか、物語的な処理に切り替えてください。
参照主導の作業の場合、スクリーンショットから動画へのガイドは、準備された画像を動画に変換するための有用な出発点となります。まず静止画を検査してください。焼き付けられたぼかし、遮られた顔、混乱を招く解剖学的特徴は、アニメーションの基盤としては不適切です。
アレンジが意図的に変更されない限り、曲は連続したマスタートラックとして保持してください。偶発的なクリップオーディオは、元の録音が一貫していてもラウドネスの急上昇を引き起こす可能性があります。クラッシュ後、完了したファイルを回復し、制作全体が失われたものとして扱うのではなく、失敗したセグメントから再開してください。
信頼を失わずにAIの関与を開示する
AIアシストとAI生成は、異なる貢献を意味します。AIによるクリーンアップを伴う人間のパフォーマンスは、合成ボーカリストと同じではありません。包括的なラベルは、その区別を明確にするどころか、曖昧にしてしまう可能性があります。
作業中は、録音および編集の貢献を記録しておきましょう。
視聴覚著作権に関する研究によると、2025の実験で120人の参加者に同じオーディオを聞かせたところ、人間のピアニストによるものとされた場合に、好感度、エンゲージメント、感情的インパクト、品質の評価が高くなり、79%が違いに気づいたと報告されています。これは、開示を慎重に行うべき理由であり、重要な貢献を隠蔽する正当化ではありません。
プロジェクトだけでなく貢献を明記する
- 音楽と歌詞: 作曲または作詞が生成されたものかどうかを個別に明記します。
- ボーカル: 録音された人間のパフォーマンスを暗示するのではなく、合成された歌声を特定します。
- ビジュアル: 生成されたシーンと撮影された映像を区別します。
- 編集: AIによるクリーンアップやエフェクトについて説明する際、元のパフォーマンスが合成されたものであったかのように示唆しないようにします。
ハイブリッドプロジェクトの場合、アーティストが曲を書き、演奏し、ビジュアルはAI生成され、人間が編集したと説明できます。合成シンガーの場合、視聴者がそのパフォーマンスを、描写された人物の録音と間違えないように、その事実を十分に目立つようにします。
開示の原則: 何が生成されたのかを具体的に述べ、人々が何を作成したのかについても同様に具体的に述べます。
合成による著作権が前提の中心である場合はタイトルを、貢献の詳細には説明を、より完全な制作記録にはクレジットまたはエンドカードを使用します。配置を純粋なマーケティング上の選択として扱うのではなく、適用されるプラットフォームの要件に従ってください。
追加の視聴参考資料として、埋め込み動画を以下に掲載しています。
視聴時間、完了率、コメント、視聴者の信頼に対して、市場ごとに真実の表現をテストします。テスト全体で根本的な事実は変更しないでください。クリック数を向上させるものの、視聴者がボーカリストについて混乱するようなラベルは、成功した開示とは言えません。
全曲制作に取り掛かる前に、最初のクリップをテストする
最も困難な制作上の問題が露呈する可能性のある箇所から始めましょう。完成した動画がパフォーマンスのクローズアップに依存する場合、歌唱がはっきりと見え、明確なリズムのアクセントがあるコーラスは、雰囲気のある風景よりも多くの情報を提供します。
小規模な受け入れテストを実行する
代表的な抜粋を選びましょう。 例えば、選択したendpointがその長さをサポートしている場合、10秒から15秒のコーラス部分をテストすることができます。強調したいボーカルフレーズと音楽的イベントの両方を含めてください。
入力アプローチを選びましょう。 最初のビデオモデルとして、text-to-videoまたはimage-to-videoを使用するKling 3.0 Standardをお勧めします。認識性が不可欠な場合は、リファレンス主導のショットを選択してください。
焦点を絞ったショットプロンプトを1つ作成しましょう。 被写体、アクション、フレーミング、カメラの動き、照明を指定してください。場所の変更、衣装の変更、複雑なパフォーマンスを同じ試行に組み合わせることは避けてください。
タスクを生成し、追跡しましょう。 当社の画像およびビデオジョブは、ポーリング可能なタスクを返します。または、結果が準備できたときにアプリに通知するwebhookを設定することもできます。ウェブツールでは、待機中に重複するジョブを送信するのではなく、その進捗ビューを使用してください。
受け入れチェックを適用しましょう。 歌唱の見え方、指定されたビートのアクセント、同一性、および邪魔なアーティファクトを検査してください。クリップが見事に見えるからといって受け入れるのではなく、失敗のカテゴリを記録してください。
受け入れ後にのみスケールしましょう。 成功したプロンプト構造とリファレンスの選択をセグメント計画に持ち込んでください。テスト結果を後のショットとの比較のために保存してください。
生成リクエストをコミットする前に、インターフェースを使用して利用可能なコントロールを確認してください。
スケールする前にコストを確認する
送信する前に、料金と失敗ポリシーを確認してください。ビデオリクエストに対する当社の返答には、生成が開始される前にかかる最大コストが記載されています。完成したビデオは最終価格で請求され、失敗した生成は請求されません。
テストが関連するリップシンクチェックと指定されたビートチェックの両方に合格した場合、フルセグメント計画に進んでください。失敗した場合は、まずタイミングエラーを修正し、次に生成されたコンテンツに問題がある場合はモデルまたはリファレンス画像を変更してください。その選択を曲全体に適用する前に、再テストしてください。
UberLLMは、統一されたAPIを通じてビデオ、画像、音楽、音声モデルへのアクセスを提供するため、プロバイダーごとに異なる統合を維持することなく、ミュージックビデオパイプラインの個別のステージを構築できます。モデルオプションを比較し、全曲制作に取り掛かる前に代表的なクリップを実行するには、UberLLM]にアクセスしてください。