Video musical generado por IA: Cómo funciona y herramientas utilizadas
Aprende qué es un video musical generado por IA, cómo la pipeline de cuatro etapas lo construye, y qué modelos y verificaciones lo hacen funcionar.
Se proyecta que los creadores de música verán 24% de sus ingresos en riesgo para 2028, según el estudio de impacto económico de la CISAC resumido por GEMA. Esa proyección sitúa los videos musicales generados por IA bajo una luz diferente: no son solo experimentos visuales, sino decisiones de producción con consecuencias para artistas, editores y audiencias.
Crear uno de forma responsable requiere más que un prompt convincente. Necesitas un plan de producción basado en la canción, clips que puedas reparar de forma independiente, verificaciones de sincronización medibles y un registro claro de lo que contribuyeron las personas y los modelos.
Tabla de Contenidos
- Qué es realmente un videoclip generado por IA
- Las cuatro etapas desde la canción hasta el vídeo terminado
- Modelos que convierten prompts e imágenes en movimiento
- Comprobación de la sincronización labial y la alineación del ritmo
- Problemas comunes y cómo solucionarlos
- Revelar la participación de la IA sin perder la confianza
- Prueba tu primer clip antes de comprometerte con una canción completa
Qué es realmente un video musical generado por IA
Un video musical generado por IA es un video musical cuyos elementos visuales, banda sonora, o ambos, se producen con modelos generativos en lugar de ser grabados o filmados por completo. Imagina que has grabado una canción sobre dejar tu hogar: podrías generar paisajes de ventana de tren, animar un retrato del cantante y ensamblar esas tomas alrededor de tu grabación existente.
En una encuesta centrada en EE. UU. 2026 a 1,003 creadores de video, músicos, especialistas en marketing y supervisores musicales, 19% usó IA generativa para encontrar o crear música para video, mientras que 32.7% había usado música generada por IA como audio final en contenido publicado, según Berklee. Esas medidas se refieren a la música dentro de los flujos de trabajo de video, no a la proporción de videos musicales generados completamente por IA.
Tres formas en que un proyecto puede usar la IA
- Totalmente sintético: Tanto la canción como las imágenes en movimiento provienen de modelos generativos, con una persona dirigiendo y seleccionando los resultados.
- Híbrido: Una pista grabada por humanos acompaña escenas generadas, como la secuencia de la ventana del tren.
- Asistido por IA: Filmas la actuación y luego usas la IA para la edición o los efectos. Esto no es necesariamente un video generado por IA en el sentido más estricto.
Piensa en la canción como la partitura y en los prompts como una lista de tomas que un modelo interpreta. Sigues siendo responsable de decidir qué aparece en pantalla.
Text-to-video convierte instrucciones escritas en un clip. Image-to-video anima una imagen fija proporcionada. Un segmento es una parte delimitada de la canción, un prompt de toma dirige sus imágenes, y la edición final combina el material seleccionado.
Antes de elegir herramientas, nombra las partes de tu proyecto: grabación, voces, letras, imágenes de referencia, tomas generadas y edición. Marca cuáles son hechas por humanos y cuáles generarás. Ese simple inventario te dirá qué versión estás creando.
Las Cuatro Etapas Desde la Canción Hasta el Video Terminado
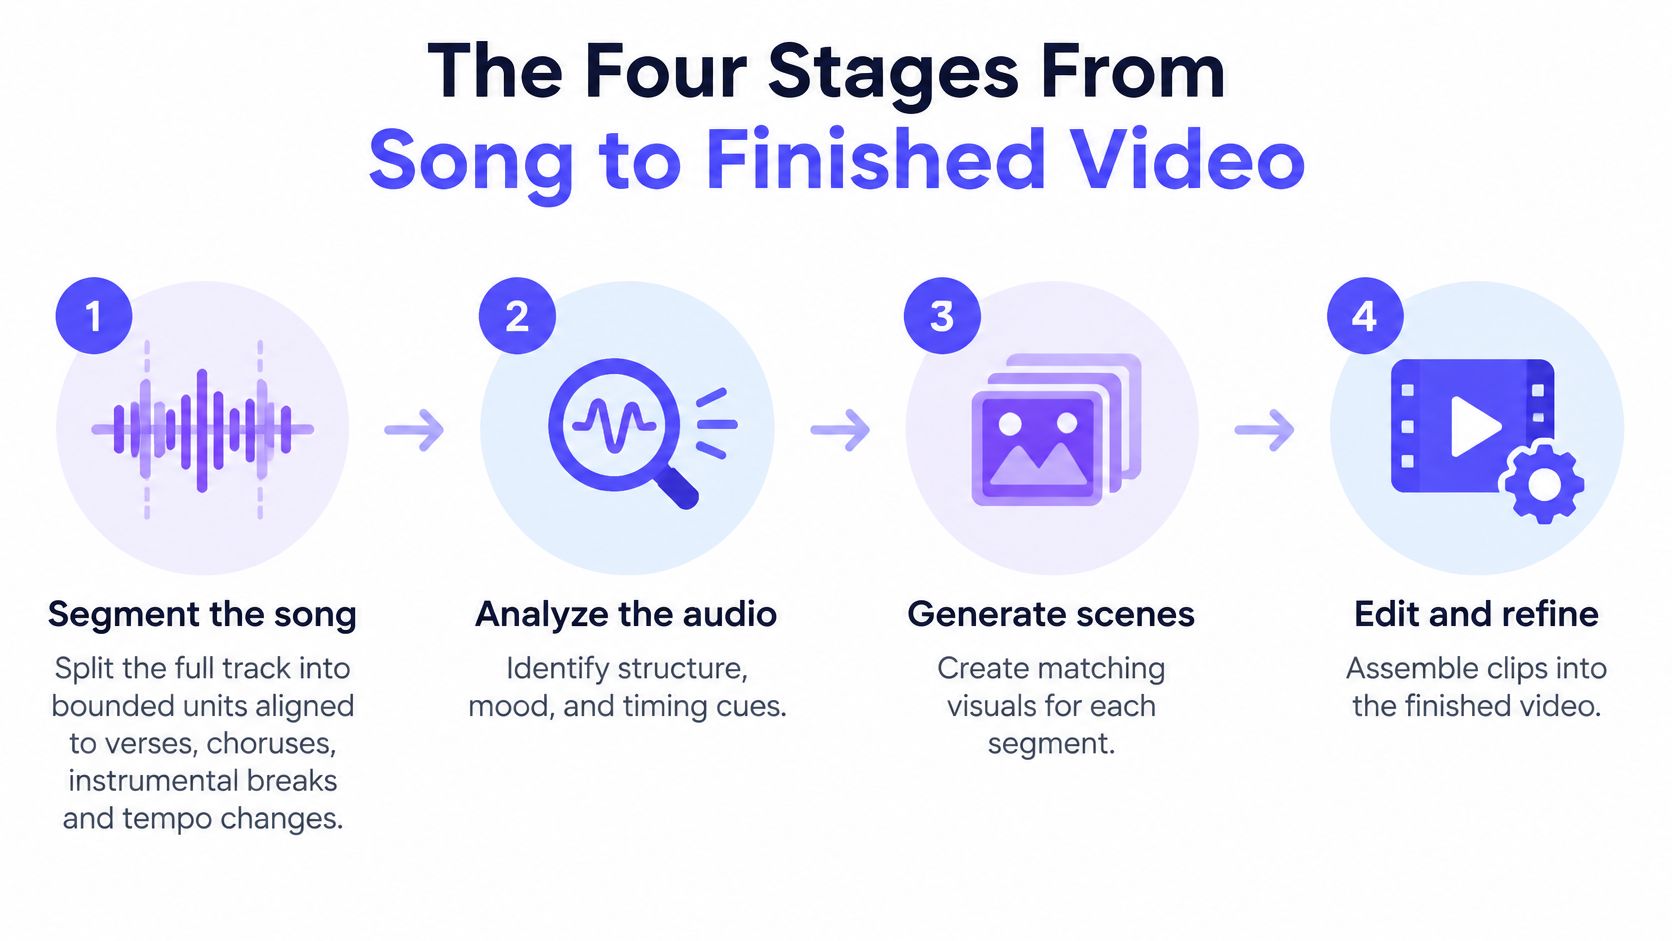
Una producción de la duración de una canción es más fácil de controlar cuando la tratas como una colección de tareas manejables. El flujo de trabajo De Sonido a Imagen publicado sigue la segmentación de la canción, el análisis de audio y la generación de guiones, la generación de texto a video y el montaje final.
El flujo de trabajo a continuación separa las decisiones creativas de las tareas de renderizado.
Construye alrededor de la estructura musical
Segmenta la canción. Marca versos, estribillos, pausas solo musicales y cambios de tempo, luego divídelos en unidades de generación delimitadas. Una sección musical puede contener varias tomas, así que no confundas una etiqueta de estribillo con el requisito de generar un clip continuo.
Analiza el audio y escribe el guion visual. Identifica el tempo, la energía, los pasajes vocales y los cambios de humor, luego asigna un shot prompt a cada segmento. Para la canción de despedida, un verso tranquilo podría usar una escena de plataforma estática, mientras que el estribillo introduce movimiento hacia adelante.
Genera los clips. Usa text-to-video para escenas descritas de forma independiente o image-to-video donde una referencia visual proporcionada sea importante. Revisa cada resultado en función de su propósito asignado antes de aceptarlo en la edición.
Ensambla la edición final. Coloca los clips aprobados en orden determinista contra la pista maestra. Estandariza la frame rate, la resolución, la relación de aspecto y la sonoridad final para que las salidas mezcladas se comporten como una sola producción.
Etapas del flujo de trabajo, entradas y salidas
| Etapa | Entrada | Salida |
|---|---|---|
| 1. Segmenta la canción | Pista completa con marcas de tiempo | Segmentos delimitados con códigos de tiempo y etiquetas |
| 2. Analiza el audio y escribe el guion | Segmentos, tempo, señales vocales | Un shot prompt por segmento |
| 3. Genera los clips | Shot prompts, imágenes de referencia opcionales | Un clip corto por segmento, con seed y versión del modelo almacenados |
| 4. Ensambla la edición final | Clips y la pista original | Un renderizado a frame rate constante con sonoridad normalizada |
Haz que cada segmento sea recuperable
Los clips delimitados ayudan a limitar la deriva temporal, donde los objetos, identidades o acciones cambian a medida que una secuencia generada continúa. También te permiten reemplazar una toma débil sin descartar una secuencia exitosa.
Almacena un manifiesto de producción que contenga el código de tiempo, la etiqueta de letra o solo música, el tempo, la energía, el shot prompt, el seed, la versión del modelo y la ubicación de salida de cada segmento. Mantén los identificadores de imágenes de referencia junto a ese registro cuando sea aplicable. Un seed ayuda a documentar una ejecución, pero no es una garantía de resultados idénticos entre actualizaciones del modelo.
Regla de producción: Trata el manifiesto de segmentos como tu proyecto editable, no solo como un registro de descargas completadas.
Como complemento práctico para la planificación y el montaje, el tutorial de producción de videos musicales de AIMVG proporciona una referencia útil del flujo de trabajo. Los desarrolladores que implementen la capa de renderizado pueden usar la guía de la API de generación de video con IA para conectar esos registros de segmentos a las tareas de generación.
Modelos que convierten prompts e imágenes en movimiento
El texto a video te da espacio para inventar; la imagen a video te da un punto de partida visual. Esa distinción importa más que elegir un solo modelo para una canción entera.
Con el texto a video, describes el sujeto, el escenario, la acción, la cámara y la iluminación. Es útil para paisajes, imágenes simbólicas y tomas de establecimiento donde una cara recurrente exacta no es esencial. Las generaciones independientes pueden interpretar la misma descripción de manera diferente, por lo que la repetición de palabras por sí sola no debería ser tu estrategia de control de identidad.
La imagen a video comienza con una imagen fija que proporcionas. Puede anclar la ropa, la composición y la apariencia facial, pero no fija cada fotograma posterior. Un movimiento o ángulo de cámara difícil aún puede producir cambios no deseados.
Adapta la entrada a la toma
Para un cantante recurrente, prepara una imagen de referencia limpia con una cara despejada y ropa legible. Synchronicity Labs sobre imagen a video es un compañero útil al decidir cómo convertir una imagen fija en una toma en movimiento dirigida.
Las siguientes familias proporcionan candidatos iniciales, no una clasificación de calidad. Trata cada rol como algo a probar con tu propio material, y verifica las entradas compatibles del endpoint actual antes de enviar.
Familias de modelos por modo de entrada y rol en videos musicales
| Modelo | Modo de entrada | Rol típico en un video musical | A tener en cuenta |
|---|---|---|---|
| Kling 3.0 Standard | Texto a video o imagen a video | Tomas de propósito general y un candidato inicial | Verifica los límites de duración del clip antes de planificar segmentos |
| Veo 3.1 Fast | Texto a video | Iteración sobre el ambiente y tomas de establecimiento | Verifica la resolución actual y las opciones de audio |
| Seedance 2.0 | Imagen a video | Tomas de artista o personaje ancladas a una imagen fija | Necesita una imagen de referencia limpia |
| Wan 2.6 | Texto a video | Segmentos instrumentales y abstractos | Inspecciona la continuidad del movimiento antes de aceptar |
| PixVerse V5.6 | Texto a video | Segmentos estilizados o experimentales | Verifica que la estilización preserve los detalles requeridos |
Separa la apariencia del rendimiento
Una cara visualmente consistente no es automáticamente una interpretación de canto. Los modelos de sincronización labial y controlados por audio abordan el movimiento de la boca con respecto al audio suministrado; no se debe asumir que la animación de imagen ordinaria haga ese trabajo.
Una combinación práctica es texto a video para pasajes atmosféricos, imagen a video para tomas de artistas recurrentes y un paso controlado por audio para el canto visible. También puedes evitar los primeros planos de la actuación por completo si el concepto funciona mejor como narrativa o visualizador.
Mantén los prompts enfocados en la acción observable. La guía de prompts de texto a video puede ayudar a traducir un estado de ánimo abstracto en dirección de cámara y movimiento del sujeto. Los límites de clip, las opciones de resolución y el tiempo de generación cambian entre lanzamientos, así que elige el modelo según los requisitos del segmento, no por familiaridad con la marca.
Comprobación de la Sincronización Labial y la Alineación del Ritmo
Una cara bonita aún puede cantar la sílaba equivocada. La fidelidad visual y la sincronización audiovisual son criterios de aceptación separados: el documento de evaluación de sincronización labial examina 615 clips generados y utiliza medidas que incluyen Distancia de Puntos Clave (LMD) y Error de Sincronización Labial–Confianza (LSE-C) para evaluar el movimiento de la boca y la correspondencia de audio.
LMD mide el error de los puntos clave de la región de la boca en comparación con el movimiento esperado. LSE-C estima la confianza de que el movimiento labial coincide con la pista de voz. Ninguna de las dos debe tratarse como una puntuación artística completa, y una medida orientada al habla necesita una interpretación cuidadosa cuando se aplica a canto sostenido, coros o formas de boca expresivas.
Ejecuta las comprobaciones en orden
- Extrae las marcas de tiempo de ritmo y ataque. Usa una herramienta de análisis de audio para identificar posiciones rítmicas y ataques de notas. Marca qué eventos requieren un corte o un acento de movimiento, en lugar de forzar cada ritmo a una transición.
- Marca los segmentos vocales. Identifica dónde debería estar cantando un intérprete visible. Usa el extracto vocal correcto y conserva su desplazamiento relativo a la pista maestra.
- Puntúa e inspecciona cada clip. Aplica medidas relacionadas con la boca al canto visible, luego evalúa la sincronización y el ajuste musical. Míralo a velocidad normal, así como fotograma a fotograma.
- Regenera solo los segmentos fallidos. Registra si el fallo se refiere a la sincronización, la articulación, la calidad de la imagen o la interpretación musical antes de solicitar un reemplazo.
Comprobaciones de sincronización y dónde se aplica cada una
| Comprobación | Qué Mide | Se Aplica A |
|---|---|---|
| Error de puntos clave de la boca (LMD) | Distancia de los puntos clave de la región de la boca respecto al movimiento esperado | Segmentos vocales |
| Confianza de sincronización labial (LSE-C) | Si el movimiento labial coincide con la pista de voz | Segmentos vocales |
| Alineación de ritmo o ataque | Si los cortes y los acentos de movimiento caen en eventos musicales | Cada límite de segmento |
| Coincidencia de ritmo y estado de ánimo | Si el ritmo y el tono del movimiento siguen la pista | Segmentos instrumentales |
Define umbrales antes del renderizado final
No existe una puntuación de aprobación universal suministrada para cada cantante, estilo o modelo. Calibra tus umbrales usando clips que hayas revisado y aceptado, luego mantén esos ajustes consistentes dentro del proyecto.
- Umbral de movimiento labial: Rechaza el canto visible con un error de articulación inaceptable o una confianza de sincronización débil.
- Umbral de sincronización: Rechaza fallos no intencionados en eventos musicales designados.
- Umbral de consistencia de movimiento: Rechaza el movimiento que contradiga el ritmo, el estado de ánimo o el sujeto previsto.
- Umbral perceptual: Rechaza la distorsión facial que distraiga, incluso cuando una puntuación numérica parezca aceptable.
Supón que la boca del cantante sigue las palabras correctas, pero toda la actuación comienza tarde. Corrige el desplazamiento del clip antes de encargar una nueva actuación. Si la sincronización es correcta pero la boca articula sonidos diferentes, una edición por sí sola no lo reparará.
Un corte deliberado antes del ritmo puede funcionar. Un corte accidental después del acento previsto es un error de producción.
Guarda las puntuaciones y las notas de revisión con el registro del segmento. Eso te da una razón para cada rechazo y hace que la selección de reemplazo sea menos arbitraria.
Problemas Comunes y Cómo Solucionarlos
Cuando un personaje cambia de vestuario o rostro entre tomas, primero inspecciona el material de origen y las instrucciones de generación. No intentes ocultar cada inconsistencia de identidad con una transición. Decide si el problema pertenece a la referencia, al rendimiento generado o al montaje.
Diagnostica antes de regenerar
Problemas comunes de producción, causas y soluciones
| Síntoma | Causa probable | Solución |
|---|---|---|
| Los personajes cambian entre tomas | Deriva del prompt en segmentos independientes | Usa imagen-a-video con una imagen de referencia fija por personaje |
| Boca desincronizada con las voces | La temporización del segmento no coincide con la pista vocal | Regenera el segmento con códigos de tiempo corregidos y vuelve a verificar la confianza de la sincronización labial |
| Los cortes no caen a tiempo | Límites establecidos a ojo, no por inicios detectados | Vuelve a cortar según las marcas de tiempo de inicio durante el montaje |
| Parpadeo o transformación (morphing) en clips largos | Clip más largo de lo que el modelo mantiene estable | Usa segmentos más cortos y únelos en la edición |
| El color o la velocidad de fotogramas difieren entre clips | Configuraciones de salida mezcladas | Normaliza la velocidad de fotogramas, la resolución y la relación de aspecto en el montaje; iguala el color por separado |
| Volumen desigual entre cortes | Sin normalización de volumen en la mezcla final | Normaliza el volumen en toda la edición |
| Un clip falló después de un fallo | Se usó una nueva ejecución de todo el proyecto en lugar de la recuperación del segmento | Regenera solo ese segmento a partir de su seed y metadatos almacenados |
Separa las reparaciones de edición de los cambios de diseño
Las reparaciones de montaje incluyen mover un corte, corregir un desplazamiento, igualar el color o arreglar una configuración de exportación. Prueba estas opciones antes de pagar por nuevas imágenes. El recorte puede solucionar una desalineación de encuadre, pero previsualiza el resultado con cuidado para no eliminar las manos de un cantante o cortar una acción importante.
Las reparaciones de generación requieren un nuevo clip porque el contenido real es incorrecto. Ejemplos incluyen un rostro que se transforma (morphing), una articulación incorrecta o un movimiento de cámara que oscurece al sujeto. Cambia la instrucción fallida específica en lugar de reescribir todo el prompt.
Las reparaciones de concepto requieren un replanteamiento más amplio. Si cada toma depende de una coreografía compleja que tu enfoque elegido no puede preservar, simplifica la actuación o cambia a un tratamiento narrativo.
Para trabajos basados en referencias, la guía de captura de pantalla a video ofrece un punto de partida útil para convertir una imagen preparada en movimiento. Inspecciona primero la imagen fija: el desenfoque incorporado, los rostros obstruidos y la anatomía confusa son bases deficientes para la animación.
Mantén la canción como una pista maestra continua a menos que tu arreglo cambie intencionalmente. El audio accidental del clip puede introducir saltos de volumen incluso cuando la grabación original es consistente. Después de un fallo, recupera los archivos completados y reanuda desde el segmento fallido en lugar de tratar toda la producción como perdida.
Revelar la participación de la IA sin perder la confianza
Asistido por IA y generado por IA describen contribuciones diferentes. Una interpretación humana con retoques por IA no es lo mismo que un vocalista sintético, y una etiqueta general puede oscurecer esa distinción en lugar de aclararla.
Mantén un registro de las contribuciones de grabación y edición mientras trabajas.
En un 2025 experimento con 120 participantes, audio idéntico recibió calificaciones más altas de agrado, compromiso, impacto emocional y calidad cuando se atribuyó a un pianista humano, y 79% informaron haber notado diferencias, según el estudio de autoría audiovisual. Esa es una razón para redactar la divulgación con cuidado, no una justificación para ocultar contribuciones materiales.
Etiqueta la contribución, no solo el proyecto
- Música y letras: Indica por separado si la composición o las palabras fueron generadas.
- Voces: Identifica una voz de canto sintética en lugar de implicar una interpretación humana grabada.
- Elementos visuales: Distingue las escenas generadas del metraje filmado.
- Edición: Describe la limpieza o los efectos por IA sin sugerir que la interpretación subyacente fue sintética.
Para un proyecto híbrido, una descripción podría indicar que el artista escribió e interpretó la canción, mientras que los elementos visuales fueron generados por IA y editados por humanos. Para un cantante sintético, haz que ese hecho sea lo suficientemente prominente para que los espectadores no confundan la interpretación con una grabación de la persona representada.
Principio de divulgación: Sé específico sobre lo que fue generado e igualmente específico sobre lo que las personas crearon.
Usa el título cuando la autoría sintética sea central para la premisa, la descripción para los detalles de la contribución, y los créditos o una tarjeta final para el registro de producción completo. Sigue los requisitos de la plataforma aplicables en lugar de tratar la ubicación como una elección puramente de marketing.
Para una referencia de visualización adicional, el video incrustado está disponible a continuación.
Prueba la redacción veraz frente a tiempo de visualización, finalización, comentarios y confianza de la audiencia, mercado por mercado. Mantén los hechos subyacentes sin cambios en todas las pruebas. Una etiqueta que mejora los clics pero deja a los espectadores confundidos sobre el vocalista no es una divulgación exitosa.
Prueba tu primer clip antes de comprometerte con una canción completa
Empieza con un pasaje que pueda exponer tu problema de producción más difícil. Un estribillo con canto visible y un acento rítmico claro es más informativo que un paisaje atmosférico si el video final depende de primeros planos de la actuación.
Realiza una pequeña prueba de aceptación
Elige un fragmento representativo. Por ejemplo, podrías probar un pasaje de estribillo de diez a quince segundos, siempre que el endpoint seleccionado admita esa duración. Incluye tanto una frase vocal como un evento musical que quieras enfatizar.
Elige el enfoque de entrada. Recomendamos Kling 3.0 Standard como el primer modelo de video para empezar, usando text-to-video o image-to-video. Elige una toma guiada por referencia cuando la reconocibilidad sea esencial.
Escribe un prompt de toma enfocado. Especifica el sujeto, la acción, el encuadre, el movimiento de cámara y la iluminación. Evita combinar un cambio de ubicación, un cambio de vestuario y una actuación compleja en la misma prueba.
Genera y rastrea la tarea. Nuestros trabajos de imagen y video devuelven una tarea que puedes consultar (poll), o puedes configurar un webhook para notificar a tu aplicación cuando el resultado esté listo. En una herramienta web, usa su vista de progreso en lugar de enviar trabajos duplicados mientras esperas.
Aplica las comprobaciones de aceptación. Inspecciona el canto visible, los acentos de ritmo designados, la identidad y los artefactos que distraen. Registra la categoría de fallo en lugar de aceptar un clip porque parezca impresionante.
Escala solo después de la aceptación. Lleva la estructura de prompt exitosa y las elecciones de referencia a tu plan de segmento. Conserva el resultado de la prueba como comparación para tomas posteriores.
Usa la interfaz para inspeccionar los controles disponibles antes de enviar una solicitud de generación.
Verifica el costo antes de escalar
Revisa los precios y las políticas de fallo antes de enviar. Nuestra respuesta a una solicitud de video indica lo máximo que puede costar antes de que comience la generación; un video completado se factura a su precio final, y las generaciones fallidas no se facturan.
Si la prueba pasa tanto la verificación de sincronización labial relevante como tus verificaciones de ritmo designadas, procede al plan de segmento completo. Si falla, corrige primero los errores de tiempo, luego cambia el modelo o la imagen de referencia donde el contenido generado sea el problema. Vuelve a probar antes de multiplicar esa elección en toda la canción.
UberLLM ofrece acceso a modelos de video, imagen, música y voz a través de una API unificada, para que puedas construir las etapas separadas de una pipeline de video musical sin mantener una integración diferente para cada proveedor. Visita UberLLM para comparar opciones de modelos y ejecutar un clip representativo antes de comprometerte con la producción de una canción completa.